MegaMemory は、コーディングエージェントの「セッションをまたいだ記憶」をプロジェクト単位の知識グラフとして残すMCPサーバーだ。star 615、fork 62、MIT、TypeScript製。この領域には既にいくつも実装があるが、MegaMemory の立ち位置はREADMEの一文にはっきり出ている——「LLMが索引器である。ASTのパースもしない。静的解析もしない」。エージェントがコードを読み、自分の言葉で概念を書き、次のタスクの前にそれを引く。つまり索引の品質はパーサーではなくエージェント自身に委ねられる。この割り切りが実際にどう動くのか、v1.6.2 を導入してMCPの口を直接叩いて確かめた。
- ・コードではなく「概念」を貯めるMCPサーバー。feature・module・pattern・config・decision・component の6種
- ・MCPツールは9本。stdioで実取得した tools/list は6,929バイト・約1,732トークン
- ・静的解析を一切使わない。索引を書くのはエージェント自身で、書き戻しを怠れば古くなる
- ・埋め込みはプロセス内実行(Transformers.js+ONNX)。npm導入後の node_modules は300MB
- ・**初回はネットワークが要る**。モデル本体は Hugging Face から取得し、到達できないと concept 作成が失敗する
- ・DBは起動ディレクトリ直下の `.megamemory/knowledge.db`(SQLite・WAL)。テーブルは nodes・edges・timeline の3つ
MCPサーバーそのものの作り方はMCPサーバーの作り方2026年完全ガイド:TypeScript・Python両対応チュートリアルにまとめてある。本記事はその応用として、「エージェントの記憶をMCPで持つ」実装を1つ分解する。
MegaMemoryとは:コードではなく概念を貯める
多くの「コードベース記憶」系ツールは、ソースを解析して構造を索引にする。MegaMemory はそこを通らない。保存するのは関数やクラスではなく概念で、READMEが挙げる種類は feature module pattern config decision component の6つ。概念どうしは connects_to depends_on implements calls configured_by の5種類の関係で結ばれる。
つまりこのグラフに入るのは「UserService というクラスがある」ではなく、「認証はトークンをRedisに置く方式で、理由はセッション共有のため」といった説明と判断だ。decision という種類が用意されていることがその意図を表している。
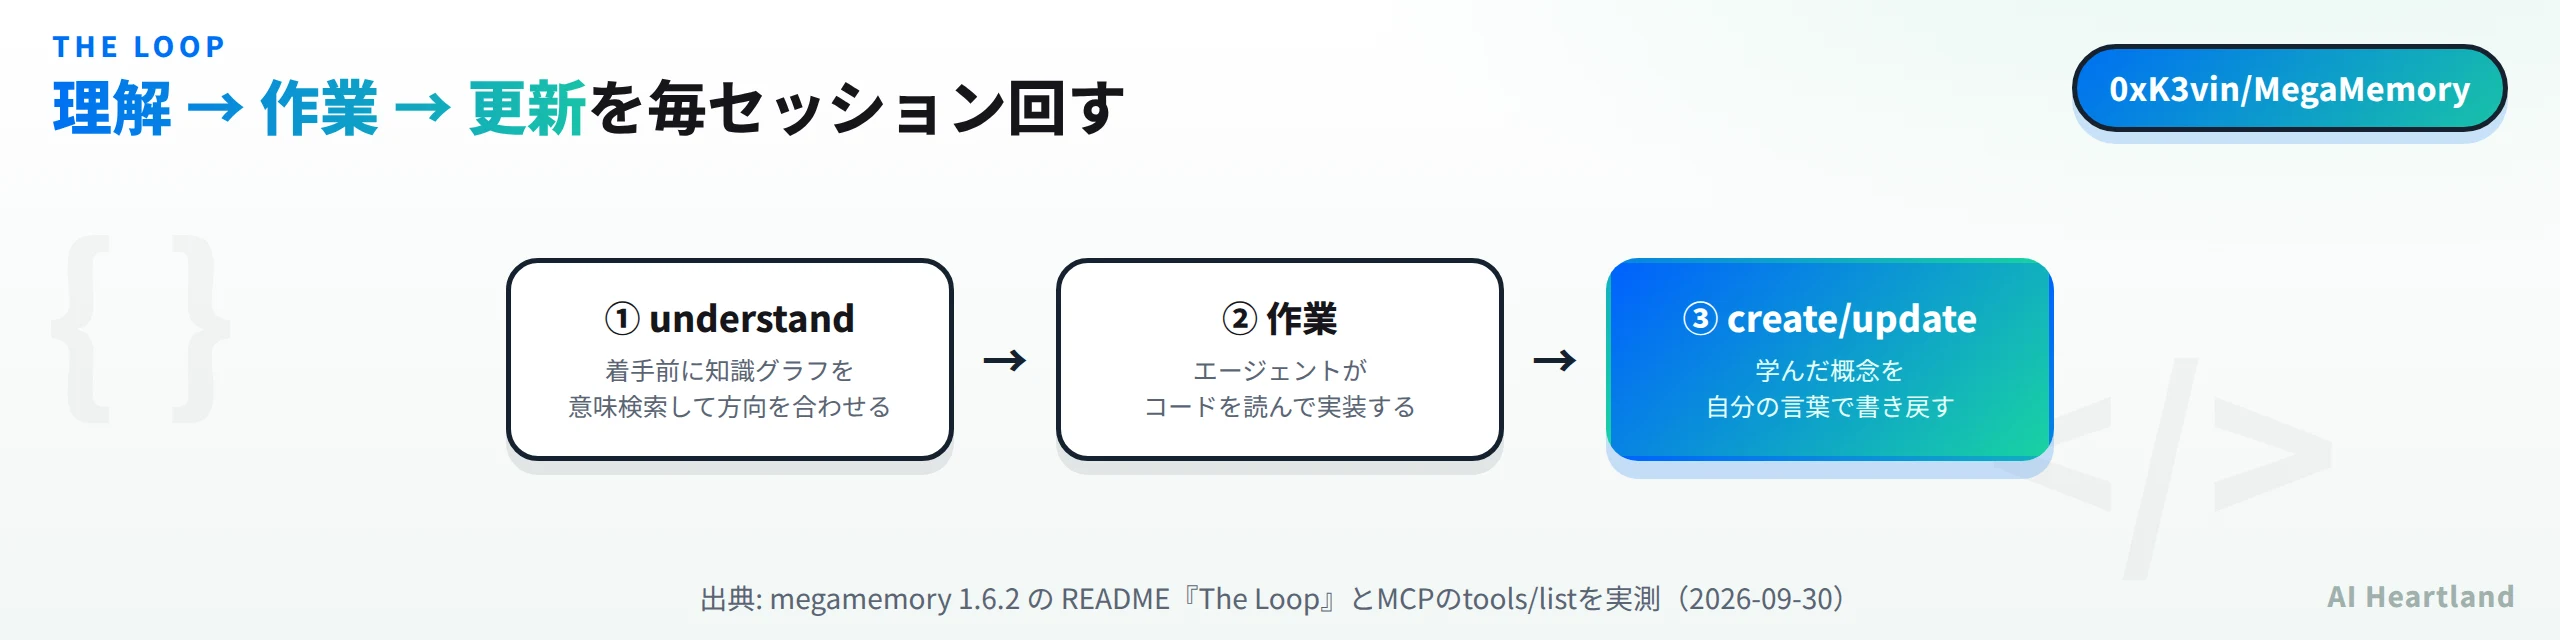
READMEが提案する使い方は3拍子のループになっている。セッションの開始時に understand で方向を合わせ、作業し、終わったら create_concept / update_concept で学んだことを書き戻す。CLAUDE.md や AGENTS.md に「まずMegaMemoryを引け」と書いておく運用が前提だ。
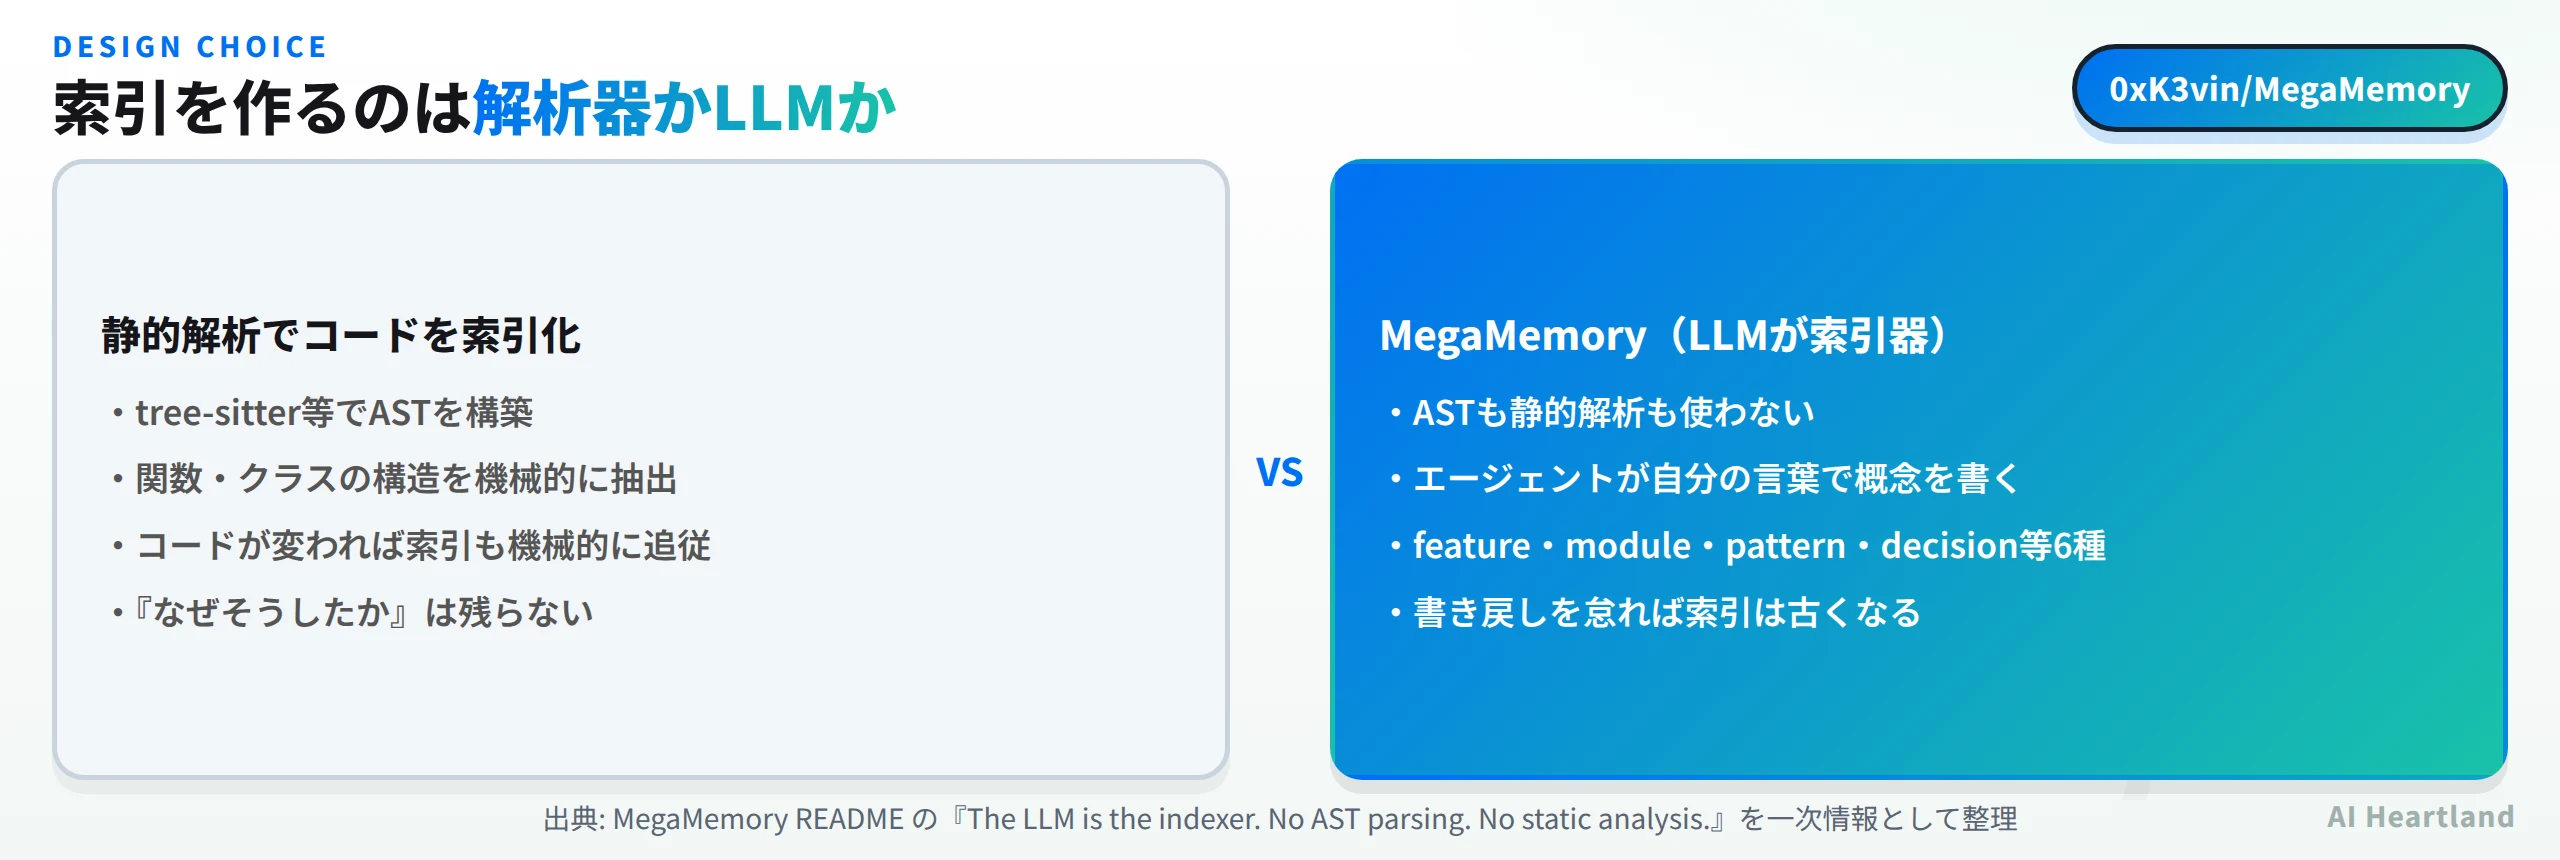
対になる設計を見ると違いが分かりやすい。当サイトで以前扱ったcodebase-memory-mcpとは|複数AIエージェントが索引を共有するMCPサーバーは tree-sitter でコードを解析して永続グラフを作る。コードが変われば索引も機械的に追従するが、「なぜその設計にしたか」は構文木には書かれていない。MegaMemory はその逆で、判断の理由は残せるが、書き戻しをサボれば静かに古くなる。どちらが優れているというより、索引の鮮度を機械に担保させるか人とエージェントの規律に委ねるか、の選択だ。
3通りのやり方を並べると、費用と責任の置き場所がはっきりする。
| 索引の作り方 | 索引を書くのは誰か | 鮮度の担保 | 残るもの | 常駐コスト |
|---|---|---|---|---|
| MegaMemory(LLMが索引器) | エージェント自身が自然文で書く | 運用の規律(書き戻しを忘れると古びる) | 概念・判断の理由・概念間の関係 | MCP 9ツール・約1,732トークン(実測) |
| 静的解析型(例: codebase-memory-mcp) | tree-sitter などの解析器 | コード変更で機械的に追従 | 関数・クラス・呼び出し構造 | MCPツール定義+索引の再構築時間 |
| CLAUDE.md などに手書き | 人間 | 人間が直すまで古いまま | 決め事・禁止事項 | ファイル全文が毎ターン文脈に載る |
MegaMemory が狙っているのは3行目の置き換えに近い。「毎ターン全文を読ませる代わりに、必要な概念だけ意味検索で引く」という発想で、だから引く側のツール(understand)が軽く、書く側のツールが重いという非対称なスキーマになっている。
実測:9ツール・約1,732トークン
MCPサーバーとして常駐させる以上、エージェントの文脈に載るコストを知っておきたい。stdioで直接ハンドシェイクして tools/list を取った。
npm install megamemory        # 1.6.2
du -sm node_modules           # 300
# MCPのstdioで initialize → notifications/initialized → tools/list を送る
# tools: 9
# names: understand get_concept create_concept update_concept link
#        remove_concept list_roots list_conflicts resolve_conflict
# wire bytes: 6929
9ツール・6,929バイト。ASCII換算の heuristic 近似トークナイザ(tools/token_audit.py、ASCII 4文字=1トークン)で約1,732トークンになる。
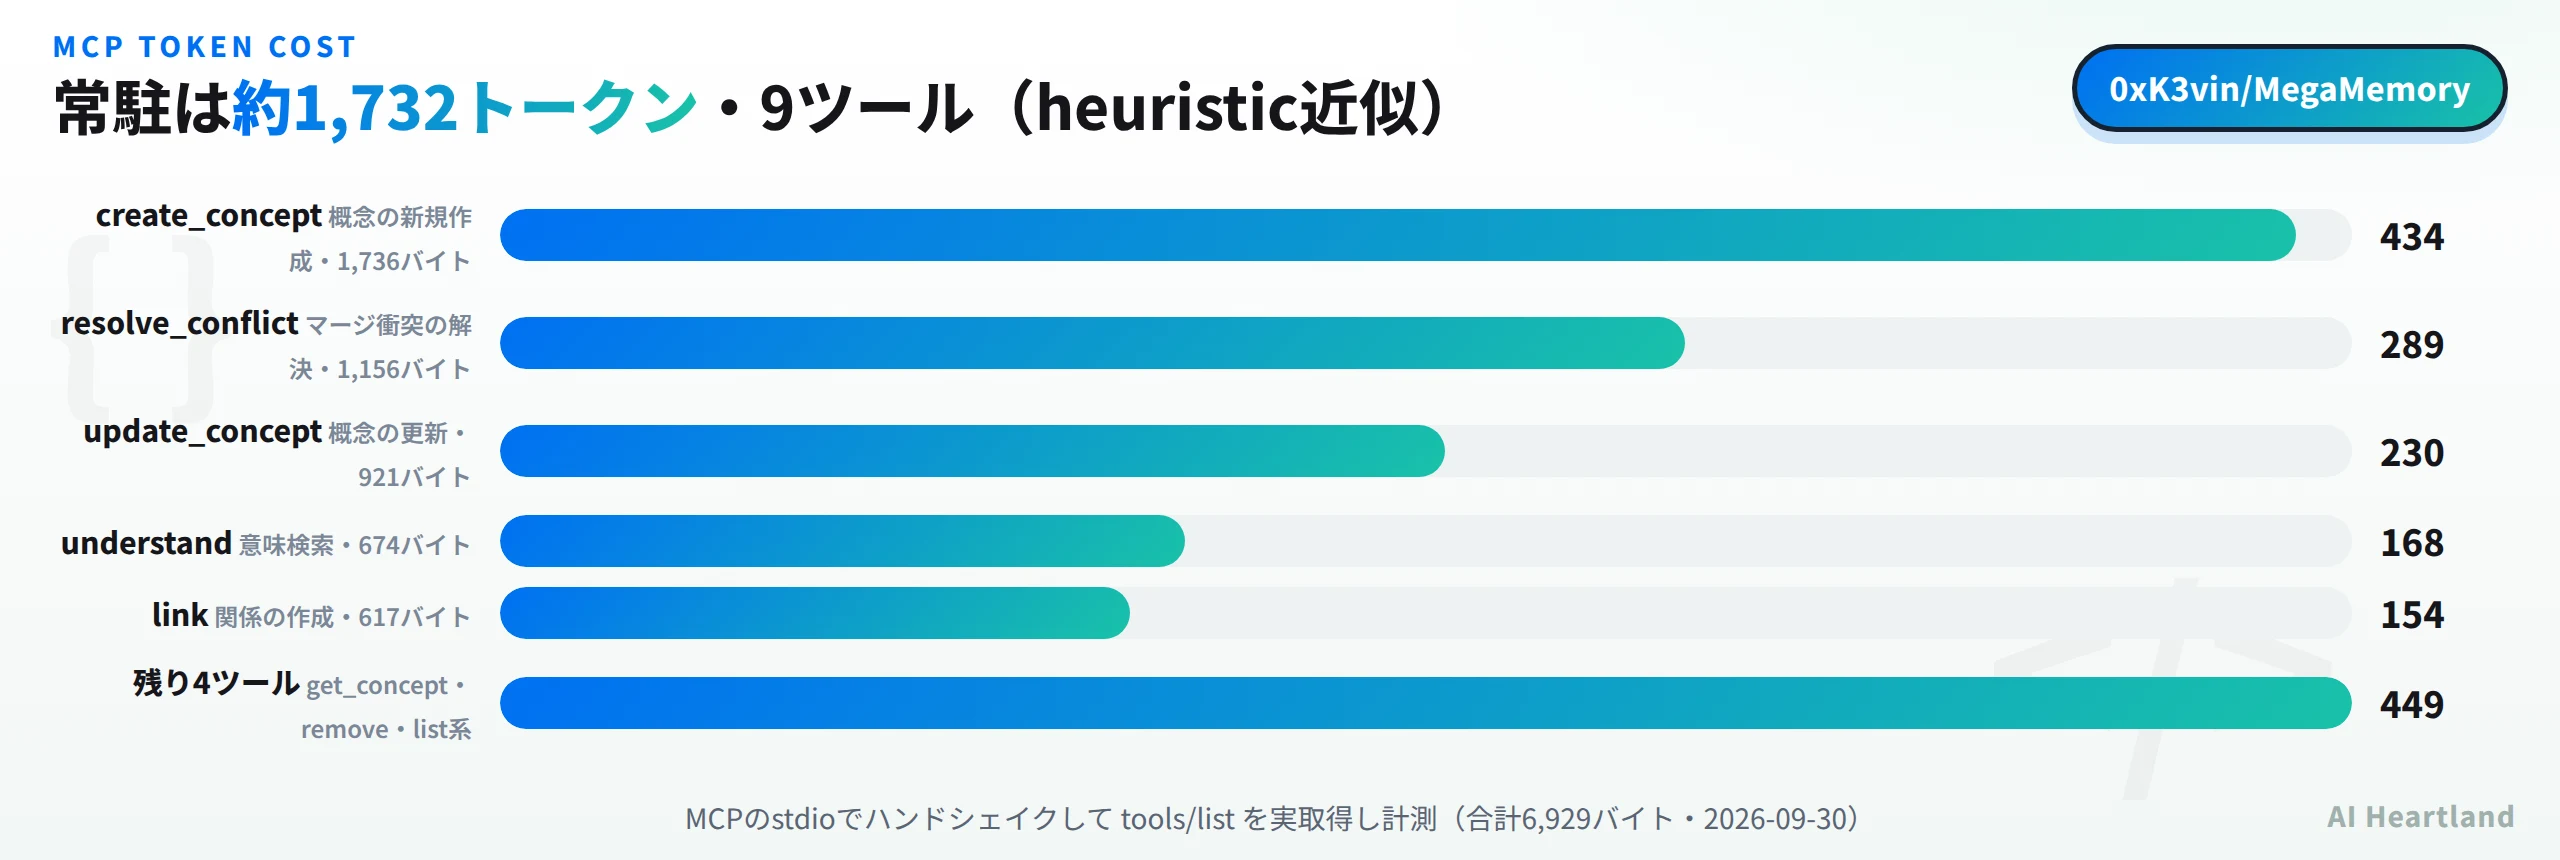
内訳を見ると、重いのは書き込み側だ。create_concept が1,736バイトで最大、次いで resolve_conflict が1,156バイト。読み取りの understand は674バイト、list_roots に至っては330バイトしかない。概念を正しく作らせるための説明——どの種類を選ぶか、どう関係を張るか——にスキーマの分量を割いている構造になっている。
比較の目安として、当サイトで同じ物差しで測ったMCPサーバーを並べると、25ツールのBlender MCPとは|25ツール6,480トークンとテレメトリ既定ONを実測で確かめるが約6,480トークン、24ツールのNotion MCPとは|ホスト版とローカル版の違いを24ツール・21,831トークン実測で解説が約21,831トークン。MegaMemory の1,732トークンは、常時入れておいても痛くない部類に収まる。記憶系は常駐が前提なので、この軽さは設計上の美点だと思う。
MegaMemoryのCLIは7コマンド:SQLiteに何が入るのか
MCPサーバーは入口のひとつで、同じバイナリがCLIとしても動く。--help を叩くと全体像が出る。megamemory stats は知識グラフの統計を返すコマンドだ。
$ megamemory --help
megamemory v1.6.2 — persistent project knowledge graph for coding agents
Commands:
  (no command)    Start the MCP stdio server (invoked by your editor)
  install         Configure editor/agent integration (interactive)
  serve           Start the web graph explorer
  stats           Show knowledge graph statistics
  merge           Merge two knowledge.db files
  conflicts       List unresolved merge conflicts
  resolve         Resolve a merge conflict

$ megamemory stats
  Database
    Path:           /tmp/mm/.megamemory/knowledge.db
    File size:      4.00 KB (4,096 bytes)
  Graph
    Nodes:          0 (0 root, 0 children)
    Edges:          0
    Timeline:       1 entries
  list_roots
    Nodes:          0 (0 roots + 0 children)
    Response size:  ~47 tokens (185 chars)
面白いのは stats の出力に list_roots の応答サイズがトークン数で入っていることだ。グラフが育つほど「まず概念一覧を読ませる」呼び出しが重くなるため、トークン予算を見ながらグラフを整理する前提でツールが作られている。記憶系MCPで一番怖いのは「思い出す側が文脈を食い潰す」ことなので、この計器がCLIに最初から付いているのは実務的に良い設計だ。
データの置き場所は起動ディレクトリ直下の .megamemory/。knowledge.db 本体と、WALモードの -shm -wal が並ぶ。ここで一点注意がある。筆者の環境では本体が4,096バイトのままで、-wal だけが111,272バイトまで膨らんでいた。WALはチェックポイント時に本体へ取り込まれるので異常ではないが、DBファイルだけをコピーして別マシンへ持っていく運用は取りこぼす。merge でDBを持ち回るつもりなら、サーバーを止めてからコピーするのが安全だ。
中身は node:sqlite で開いて確認した。テーブルは3つしかない。
・nodes(概念):id name kind summary why file_refs parent_id created_by_task embedding(BLOB)ほか。parent_id が自己参照の外部キーになっており、概念は木構造に入れ子にできる
・edges(関係):from_id to_id relation description。relation に前述の5種類が入る
・timeline(履歴):seq tool params result_summary is_write is_error affected_ids
注目すべきは nodes と edges の両方に merge_group needs_merge source_branch merge_timestamp が付いていることだ。ブランチ由来の知識をどう合流させるかが最初からスキーマに織り込まれている。list_conflicts / resolve_conflict がMCPツール側にも生えているのは、エージェントが作業中に衝突を見つけて自分で解消できるようにするためだろう。
timeline はもっと直接的に役に立った。筆者が失敗した create_concept 呼び出しが、そのままエラーとして記録されていた。
意味検索で方向を合わせる"] --> B["エージェントが
コードを読んで実装する"] B --> C["create_concept / update_concept
学んだ概念を自分の言葉で書き戻す"] C --> E["Transformers.js + ONNX
all-MiniLM-L6-v2 で
プロセス内で埋め込み"] E --> D["SQLite
.megamemory/knowledge.db
nodes / edges / timeline"] D --> A D --> F["megamemory serve
Webエクスプローラ(既定4321)"] D --> G["megamemory merge / conflicts / resolve
別ブランチのDBと合流"]
tool に create_concept、params に name と kind、is_write が1、is_error が1、result_summary に Hugging Face への到達失敗がそのまま入っている。つまり MegaMemory は成功も失敗もグラフと同じDBに時系列で残す。エージェントが何を思い出そうとして何を書いたかの監査ログになるので、暴走の事後検証には使える。逆に言えば、params に書いた内容がDBに平文で残るということでもあるので、秘密情報を概念名に入れる運用は避けたい。
衝突の一覧には機械可読の出口も用意されている。megamemory conflicts --json を叩くと、未解決が無い状態では {"conflicts": []} が返った。--db PATH でDBを指定できるので、ブランチをマージするCIに「知識グラフ側の未解決衝突が残っていないか」を混ぜる使い方はできる。resolve は --keep left|right|both で解決方針を指定する形なので、機械的に片側へ寄せる運用も選べる。ここまで揃えてあるのは、DBをリポジトリに入れて共有する運用を実際に想定しているからだろう。
エディタ連携は megamemory install --target が受け持ち、受け付ける値は opencode claudecode antigravity codex の4つだった。引数なしなら対話形式で聞かれる。Claude Code なら claudecode、Codex なら codex を渡す。MCPサーバーの登録先ファイルを自分で書く必要はない。
300MBの正体と、初回にネットワークが要る話
導入コストはトークンだけではない。npm install megamemory の直後に node_modules を測ると300MBあった。
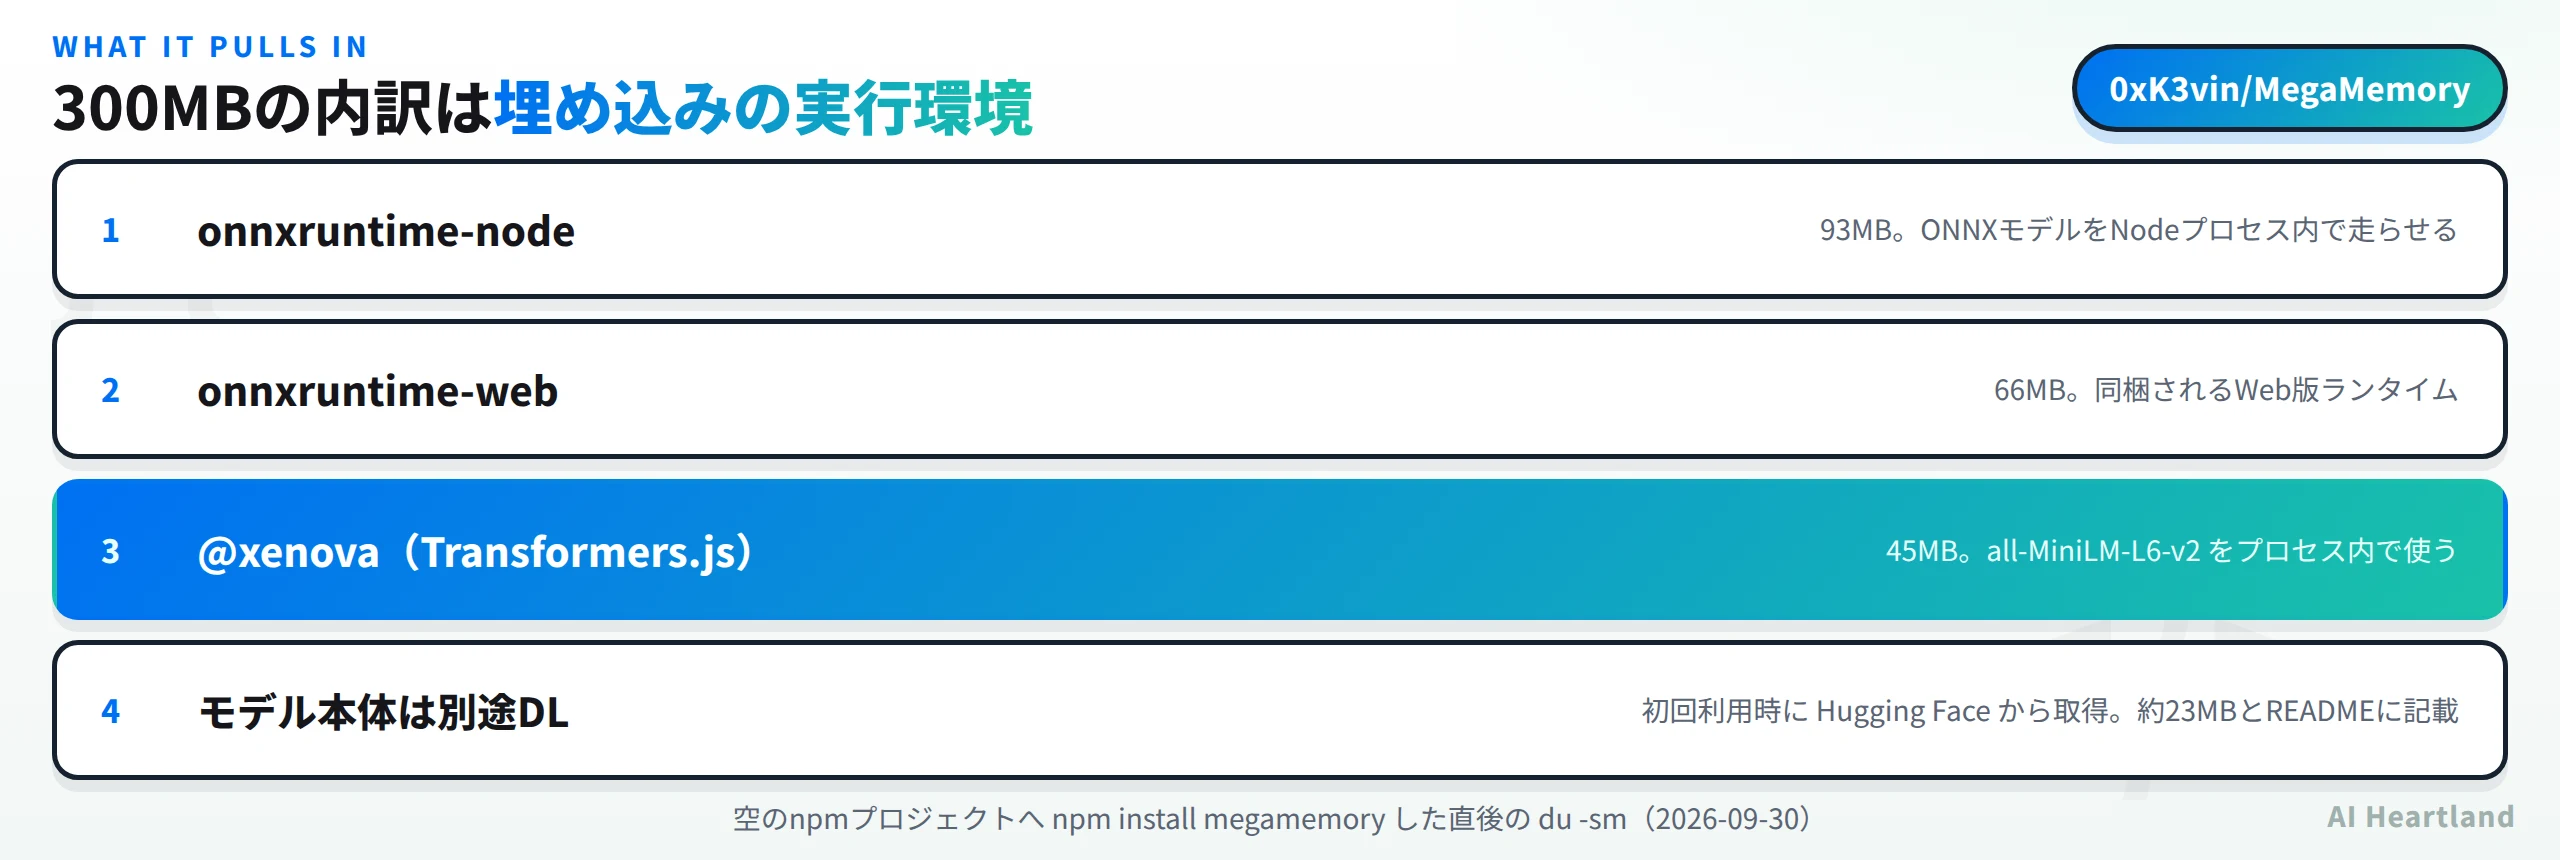
内訳は onnxruntime-node が93MB、onnxruntime-web が66MB、@xenova(Transformers.js)が45MB。意味検索の埋め込みをプロセス内で回すための実行環境が大半を占める。外部の埋め込みAPIに投げない設計なので、APIキーもネットワークも不要——と言いたいところだが、ここに落とし穴がある。
モデルの重みはパッケージに同梱されていない。READMEも「埋め込みモデル(約23MB)は初回利用時に自動ダウンロードされる」と注記している。当記事の環境は外向き通信が絞られているため、実際に create_concept を呼んでみるとこうなった。
MEGAMEMORY_ERROR: Forbidden access to file:
"https://huggingface.co/Xenova/all-MiniLM-L6-v2/resolve/main/tokenizer.json".
初回の1回だけはネットワークが要る。エアギャップ環境やCIの制限下で使うなら、モデルキャッシュを事前に配置する手当てが必要になる。逆に言えば、一度取得してしまえば以降は外部APIを呼ばずに埋め込みを作れるので、コードの内容が外へ出ない構成にはできる。この「初回だけ外に出る」型の依存は、社内ネットワークで動かすときに最も見落としやすい要件なので、評価の最初に潰しておくのがいい。
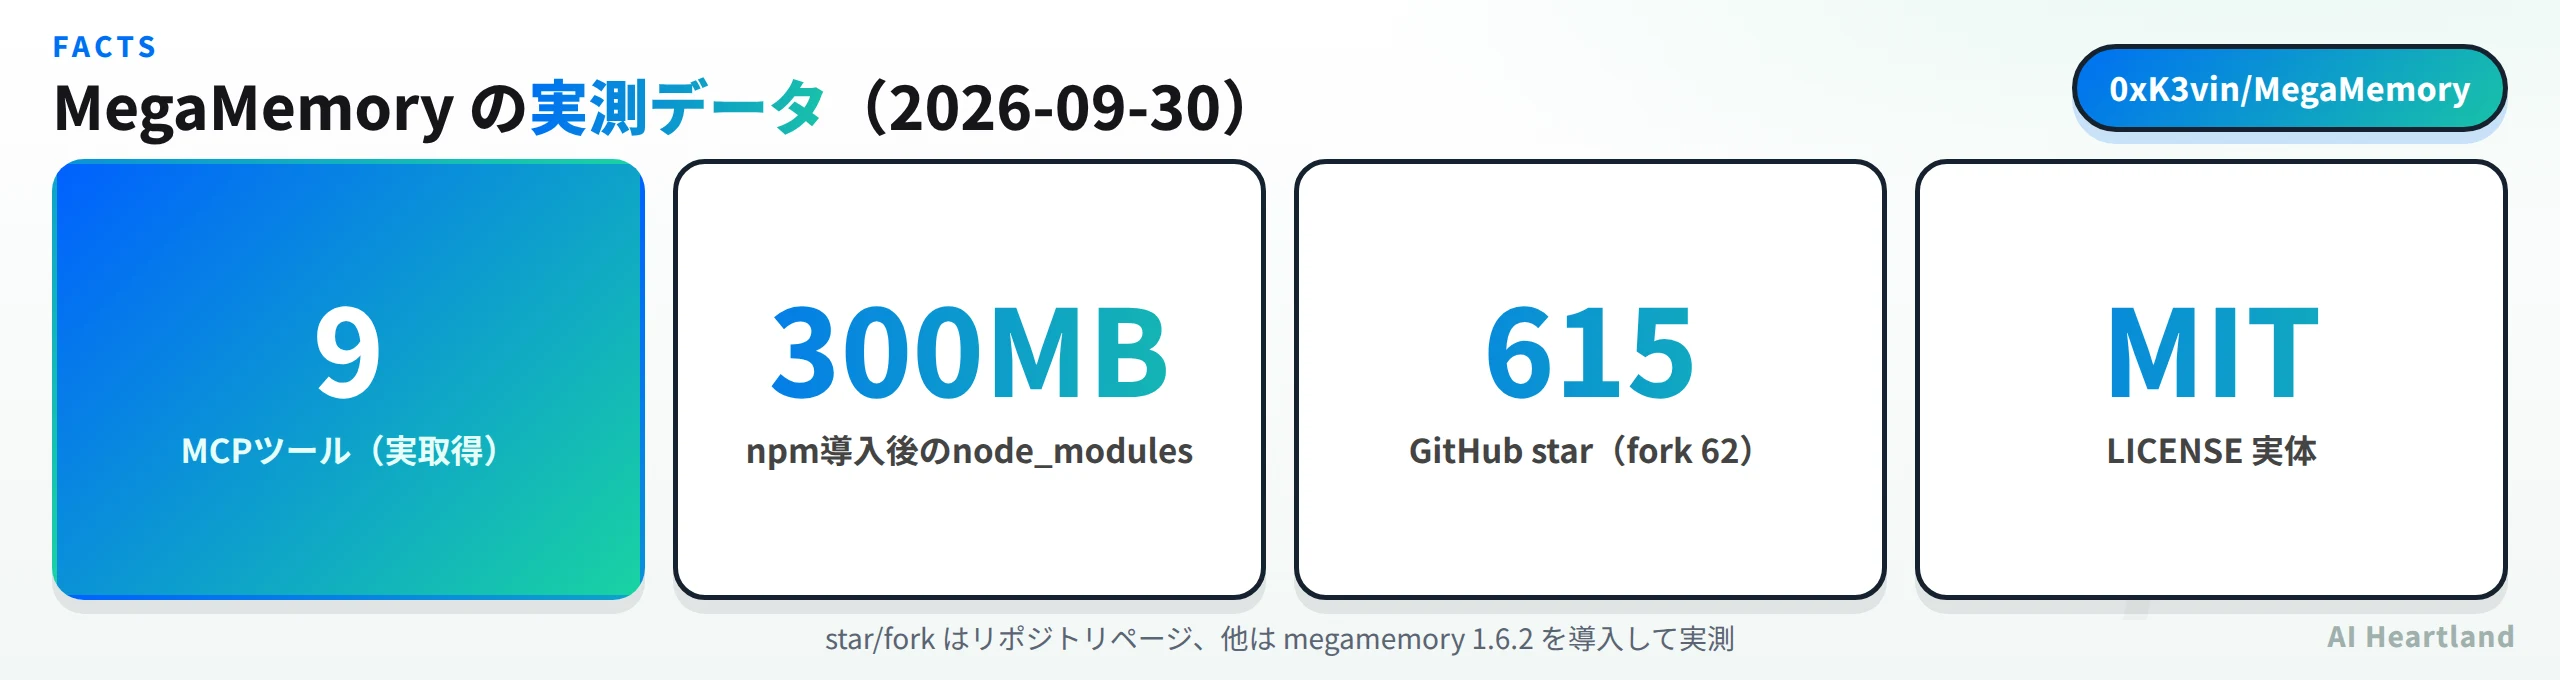
検証環境:Linux 6.18.44/Node.js 24.21.0/2026-09-29。npm から megamemory 1.6.2 を空のプロジェクトへ導入し、megamemory --help でコマンド一覧を確認、MCPのstdioで initialize → notifications/initialized → tools/list を送って応答を実取得した。tools/call で create_concept を実行し、megamemory stats と megamemory conflicts --json も叩いている。生成された .megamemory/knowledge.db は node:sqlite で開いてテーブル定義と timeline の行を確認した。トークン量は tools/token_audit.py の heuristic 近似トークナイザ(ASCII 4字=1)で計測し、tiktoken の cl100k_base はBPE辞書を取得できないため使っていない。未検証:知識グラフを実際に育てていない。埋め込みモデルを取得できなかったため、概念の作成以降の意味検索・グラフ探索・Webエクスプローラ(serve)・マージの実挙動はいずれも未実行。索引の質、検索の当たり具合、エージェントに書き戻させる運用の実効性も測っていない。star 615・fork 62 はリポジトリページの表示値。
書き戻させる運用をどう設計するか
索引器がLLMである以上、このツールの成否は「エージェントに概念を書かせ続けられるか」に一本化される。スキーマと9ツールの構成から、設計者が想定している運用はかなり具体的に読み取れる。
粒度はファイルではなく判断に合わせる。 nodes の列は name kind summary why file_refs という並びで、file_refs が「概念に紐づく参考ファイル」という従属的な位置にある。つまり「このファイルには何が書いてある」を1概念にすると設計と逆を向く。「リトライはジッタ付き指数バックオフで、理由は上流のレート制限」のような、why が書ける単位に切るのが素直だ。kind に decision があるのはそのための受け皿である。
同名を増やさない。 意味検索で引く仕組みなので、似た概念が二重三重に貯まると検索結果が濁り、understand の応答が長くなる。ツール側に update_concept と remove_concept が別々に用意され、nodes に removed_at removed_reason 列があるのは、消すことを前提に作られているという意思表示だ。論理削除なので履歴は残り、なぜ消したかも書ける。新しく作る前に既存を引く、という順番を運用ルールに落としておきたい。
入れ子でルートを絞る。 parent_id が自己参照になっており、list_roots はルートとその子を返す。ルートが増えるほど「まず全体を見る」呼び出しが重くなるので、機能単位のルートを数個だけ置き、その下に概念を吊るす形が想定されているはずだ。前述のとおり stats がその応答サイズをトークンで教えてくれるため、育ってきたら再構成の判断材料になる。
書き戻しのタイミングを決める。 nodes には created_by_task 列がある。タスク単位で概念の出自を追えるようにする列で、「1タスク終わったら書き戻す」という運用を前提にした設計に見える。CLAUDE.md や AGENTS.md に書くなら、「着手前に understand、完了時に create_concept または update_concept」まで具体的に指示するのが確実だ。
ここは設計の読み取りであって、実際にグラフを育てて検証したわけではない(埋め込みモデルを取得できなかった)。1スプリント回してから答え合わせをしたい部分だ。
導入前に押さえる点
・索引の鮮度は運用次第:静的解析が無いということは、コードが変わってもグラフは自動では変わらない。update_concept を呼ばせる規律が要る
・初回のネットワーク:Hugging Face から約23MBを取得。社内プロキシや制限環境では事前準備が必要
・DBの置き場所:起動ディレクトリ直下の .megamemory/。共有するのかしないのかを最初に決める
・WALを忘れない:本体4KBに対し -wal が111KBという状態が普通に起きる。DBを持ち運ぶならサーバーを止めてから
・平文で残る:timeline に呼び出しの引数と結果が入る。秘密情報を概念名や要約に書かない
・対応エディタ:megamemory install --target が受けるのは opencode・claudecode・antigravity・codex。対話形式の設定コマンドもある
・Webエクスプローラ同梱:megamemory serve(既定ポート4321)でグラフを見られる。CLIには stats merge conflicts resolve もある
・Node.js 18以上:engines の指定。本記事は24.21.0で検証した
・まだ1.6.2:MITで読める規模(src/ のTypeScriptは24ファイル、うち約半分がテスト)なので、挙動が気になるなら実装を読むのが早い
総括。 MegaMemory の賭けは明快で、「コードの構造は読めば分かる。分からないのは判断の理由のほうだ」という一点に集約される。だから索引器をパーサーではなくLLMに置き、decision という種類を用意した。常駐1,732トークンという軽さはその割り切りの結果でもあり、9ツールしかないのは書き戻しと引き出しに必要な最小限に絞ったからだ。stats がトークン数を表示し、スキーマにブランチ合流の列が最初から入っているあたりも、「文脈の予算」と「チームで持ち回る現実」を見て作られている印象を受ける。
一方で、この設計はエージェントが真面目に書き戻す限りにおいて成立する。書かなければ空のグラフが残るだけで、静的解析のように勝手に埋まってはくれない。導入するなら、CLAUDE.md なり AGENTS.md なりに「作業後に概念を更新する」を明記して、ループを運用側で閉じるところまでがセットになる。評価するなら、まず1スプリント分の作業を通して stats の Nodes が実際に増えるかを見るのが早い。増えなければ、ツールの問題ではなく運用の問題だと分かる。記憶系のMCPサーバーは「入れた」時点では何の効果も出ないので、この確認手段が最初から同梱されていることは評価に値する。
参照ソース
・0xK3vin/MegaMemory(公式リポジトリ) — README・src/・LICENSE を 2026-09-29 に確認
・megamemory(npmレジストリ) — 実際に導入した 1.6.2 の配布メタデータ
・Model Context Protocol 公式サイト — READMEが参照しているMCPの仕様