RAGを本番に載せたことがあるなら、あの感覚を知っているはずだ。デモでは完璧に答えるのに、実運用に入った途端、関係のない文書が上位に来てモデルがそれを真に受ける。チャンクサイズを変え、top-kをいじり、リランカーを足す。しかしどれが効いたのか誰も説明できない。waku-agent(MIT・★1,713)は、その「説明できなさ」への一つの回答だ。フレームワークを使わず、記憶と検索の全経路が素のPythonで書いてある。RAGライブラリではなく、RAGの部品が隠されずに置いてある解剖標本である。前提となる全体像はRAGとは?仕組み・構築・ベクトルDB選定までの2026年実装マップにまとめてある。
30秒でわかる waku-agent のRAG
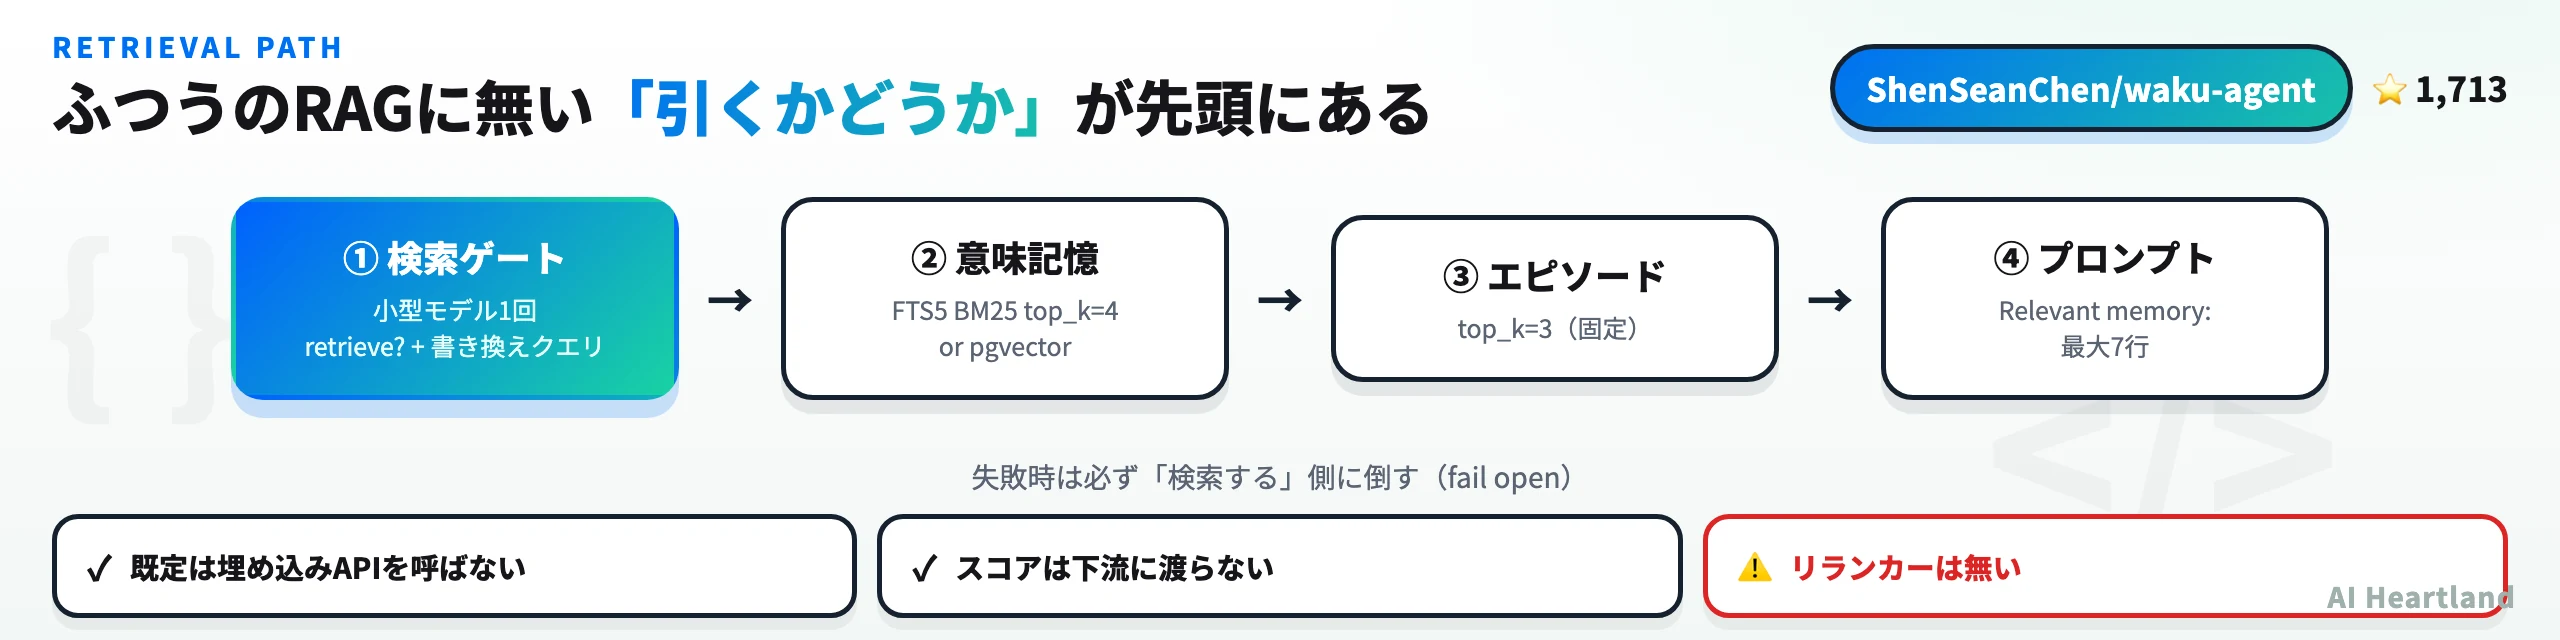
・検索する前に「検索するか」を判定する——waku/memory/retrieval_gate.py が安価な小型モデルに1回だけ問い、{"retrieve": bool, "query": str, "reason": str} を返させる。失敗時は必ず True に倒す
・既定はベクトルではなくSQLite FTS5のBM25——WAKU_RETRIEVAL_TOP_K=4。埋め込みAPIすら呼ばない
・ベクトル版は差し替え式——WAKU_SEMANTIC_STORE=supabase で text-embedding-3-small(1536次元)+pgvectorに切り替わる。呼び出し側は search(query, top_k) のまま
・チャンク分割器が存在しない——「チャンク」の単位は1文の事実。分割戦略の代わりに、会話を1文へ蒸留する consolidation.py がある
・リランカーが無い——BM25の rank かコサイン距離の昇順が、そのまま最終順位になる
・日本語は「壊れない」が「当たらない」——ASCII限定だった正規表現は修正済み。ただしFTS5の unicode61 は日本語を分割しないため、実測では文頭の語しかヒットしなかった(本記事で検証)
waku-agentとは——RAGフレームワークではなく記憶レイヤの解剖標本
設計の柱は4つ、Harness・Loop・Memory・Eval/LLM-Ops。2026年9月10日時点でスター1,713・フォーク329・コミット325、2026年7月10日作成で直近のpushは8月29日。MITライセンス(アーキテクチャ図のみCC BY-NC-SA 4.0と明記)、言語構成はPythonが約8割を占める。
重要なのは、このリポジトリが自分を何と呼んでいないかだ。docs/architecture.md の末尾にこうある。
Not a framework, not multi-agent, not production.
本番用ではないと自分から書いてある。だから本記事も「本番で使え」とは書かない。読んで盗む対象として扱う。作者はYouTubeチャンネル Sean’s AI Stories の @ShenSeanChen で、解説動画も公開されている。
waku/memory/__init__.py のdocstringが構造を最も簡潔に示す。
procedural  SKILL.md files      how to act
semantic    facts table (FTS5)  what is durably true
episodic    episodes table      what happened, when

retrieval_gate   decides IF a turn needs memory
consolidation    distills chats into facts, every N exchanges
RAG実装者の目で見れば、知識ベース3種+読み込み判定+書き込み判定という構成だ。多くのRAG実装が持っていないのは後ろ2つ、「引くかどうか」と「入れるかどうか」を決める層である。記憶レイヤを製品として使いたいならsupermemory入門|AI時代のMemory APIをmem0・cognee・Lettaと比較で読み解くの比較が近い。
セットアップは uv 一本と鍵ひとつで済む。
git clone https://github.com/ShenSeanChen/waku-agent && cd waku-agent
uv venv && uv pip install -e .          # 環境作成 + waku コマンド
cp .env.example .env                    # プロバイダを選び、鍵を1本貼る
uv run waku dashboard                   # ブラウザのコックピット → localhost:7777
プロバイダは WAKU_PROVIDER= で切り替える。waku/loop/models.py の PROVIDERS に登録されているのは11種(anthropic が既定で、openai/openrouter/gemini/deepseek/minimax/kimi/glm/xai/opencode_zen/opencode_go)。ダッシュボードの Data タブは state.db への読み取り専用SQLコンソールだ。RAGのデバッグで最も欲しいのは「実際に何が引かれたか」の可視化なので、この構成は正しい。
waku-agentの検索経路を実コードで追う——ゲート・FTS5・pgvector
1. 検索するかどうかを決める
retrieval_gate.py のdocstringが設計意図を率直に書いている。
Default-on retrieval is (a) slow — an extra search before every reply — and (b) worse: irrelevant memories bias the answer (“over-interpretation”).
実装は関数1つ、should_retrieve(client, small_model, message) -> tuple[bool, str, str]。押さえるべきは3点だ。max_tokens=600——コメントに理由がある。推論モデル(Kimi K3など)はJSONの前にthinkingブロックを吐くため、当初の100トークンでは答えが切り落とされていた。JSON契約の判定器で実際に起きる事故である。JSONパースが寛容——text.index("{") から text.rindex("}") までを切り出すので、前後に散文が付いても壊れない。そして失敗は必ず「検索する」側に倒す。例外時も、{ が本文に無い場合も return True, message, ...。docstringの表現がすべてだ——“a stale memory beats a lost one”。
2. 何を引くか——既定はBM25
既定の意味記憶は SQLite FTS5 のBM25 である。
def search(self, query: str, top_k: int = 4) -> list[str]:
    fts = _fts_query(query)
    if not fts:
        return []
    rows = self.conn.execute(
        "SELECT f.subject, f.content FROM facts_fts JOIN facts f ON f.id = facts_fts.rowid "
        "WHERE facts_fts MATCH ? ORDER BY rank LIMIT ?", (fts, top_k)).fetchall()
    return [f"[{r['subject']}] {r['content']}" for r in rows]
クエリはユーザー文をそのまま渡さず、トークンを重複除去して AND ではなく OR で連結する。再現率を優先し、適合率をBM25の rank に任せる設計だ。返り値は [subject] content の文字列で、メタデータはsubjectだけが下流に届く。source(user か consolidation か)も created_at もモデルには渡らない。そしてスコアが返らないので、閾値フィルタが構造的にできない。
3. ベクトル版に切り替えると何が変わるか
WAKU_SEMANTIC_STORE=supabase で semantic/supabase_store.py に切り替わる。選定の勘所はベクトルデータベース比較2026|Qdrant・Milvus・pgvectorをRAG用途で選ぶ完全ガイドにまとめてある。
| 項目 | 実装値 |
|---|---|
| 埋め込みモデル / 次元 | text-embedding-3-small / 1536 |
| テーブル | rag_chunks(id BIGSERIAL/chunk_id/source/text/embedding/created_at) |
| インデックス | ivfflat (embedding vector_cosine_ops) WITH (lists = 100) |
| 距離演算子 | <=>(コサイン距離) |
| RPC | match_chunks(query_embedding, match_count int DEFAULT 6, min_similarity float DEFAULT 0.0) |
| 実際に渡すtop_k | 4(settings.retrieval_top_k) |
ここに非対称性が1つある。書き込みは self._embed(f"{subject}: {content}") とラベルを連結して埋め込むのに、検索は self._embed(query) とユーザー文を素で埋め込む。数百件規模なら実害は出にくいが、非対称埋め込みは意図してやるもので、事故で入るものではない。
min_similarity の既定が 0.0 である点も見逃せない。RPCは閾値を受け取れるのに search は match_count しか渡していない。つまりどれだけ無関係でも必ず上位4件が返る。ベクトル検索が「常に何かを返す」検索であることの教科書的な現れだ。
4. プロンプトへの組み立てと、書き込み側
waku/runtime/session.py の build_system() が毎ターン作業記憶を組む。SOUL.md → 現在時刻 → 自身のモデル名 → Relevant memory: → Relevant skill instructions: の順だ。記憶の合流は waku/memory/__init__.py にある。
found = self.facts.search(query, self.settings.retrieval_top_k)   # 最大4件
found += self.episodes.search(query, top_k=3)                     # 最大3件(ハードコード)
プロンプトに入る記憶は1ターン最大7行。書き込み側は consolidation.py が担う。WAKU_CONSOLIDATE_EVERY=6、1往復が2行なので未統合行が12行たまるまで走らない。そして例外時の挙動が良い。
except Exception:
    return 0  # never lose the log — it stays unconsolidated for next time
要約に失敗してもログは消えない。 consolidated = 1 の更新はJSONパース成功後にしか走らない。取り込みパイプラインの冪等性として正しい形だ。
日本語クエリは通るのか——FTS5トークナイザを実測した
日本語で使えるかは、日本語話者にとって最初の判断材料になる。ここは上流が最近直した箇所なので、現在の main を読んだうえで手元で動かして確かめた。
_fts_query は以前 [a-zA-Z0-9]{2,} というASCII限定の正規表現だった。現在は [^\W_]{2,} に変わり、さらにCJK・かなを含むトークンだけを前方一致(token*)に変換する。修正理由はdocstringに書かれており、旧実装の失敗は「0件になること」ではなかった。
every non-Latin script reduced to “” — and an empty query is not a no-op.
空クエリは SqliteEpisodeStore.search() では recent(top_k) にフォールバックする。つまり非ラテン文字のユーザーは、検索が空振りした結果として無関係な直近エピソードを「Relevant memory」という見出しで渡されていた。取りこぼしではなく、他人の記憶を自信満々に供給していたわけだ。RAGの障害としては最悪の部類で、これが直っているのは大きい。
では現在は日本語で当たるのか。SQLite 3.53.0 に同じ構成のFTS5テーブルを作り、fts5vocab で索引の実際の語彙を覗いた。
python3 - <<'PY'
import sqlite3
con = sqlite3.connect(":memory:")
con.execute("CREATE VIRTUAL TABLE f USING fts5(subject, content)")
con.execute("INSERT INTO f VALUES (?,?)",
            ("アレックス", "アレックスは共同創業者で、毎週金曜に打ち合わせがある"))
con.execute("CREATE VIRTUAL TABLE v USING fts5vocab(f, row)")
print([t for t, in con.execute("SELECT term FROM v ORDER BY term")])
PY
# ['アレックス', 'アレックスは共同創業者で', '毎週金曜に打ち合わせがある']
unicode61 は読点と数字・ASCIIの境界では切るが、日本語の単語の間では切らない。結果、一続きの文がまるごと1語として索引される。前方一致がどこまで救うかを同じテーブルで測った。
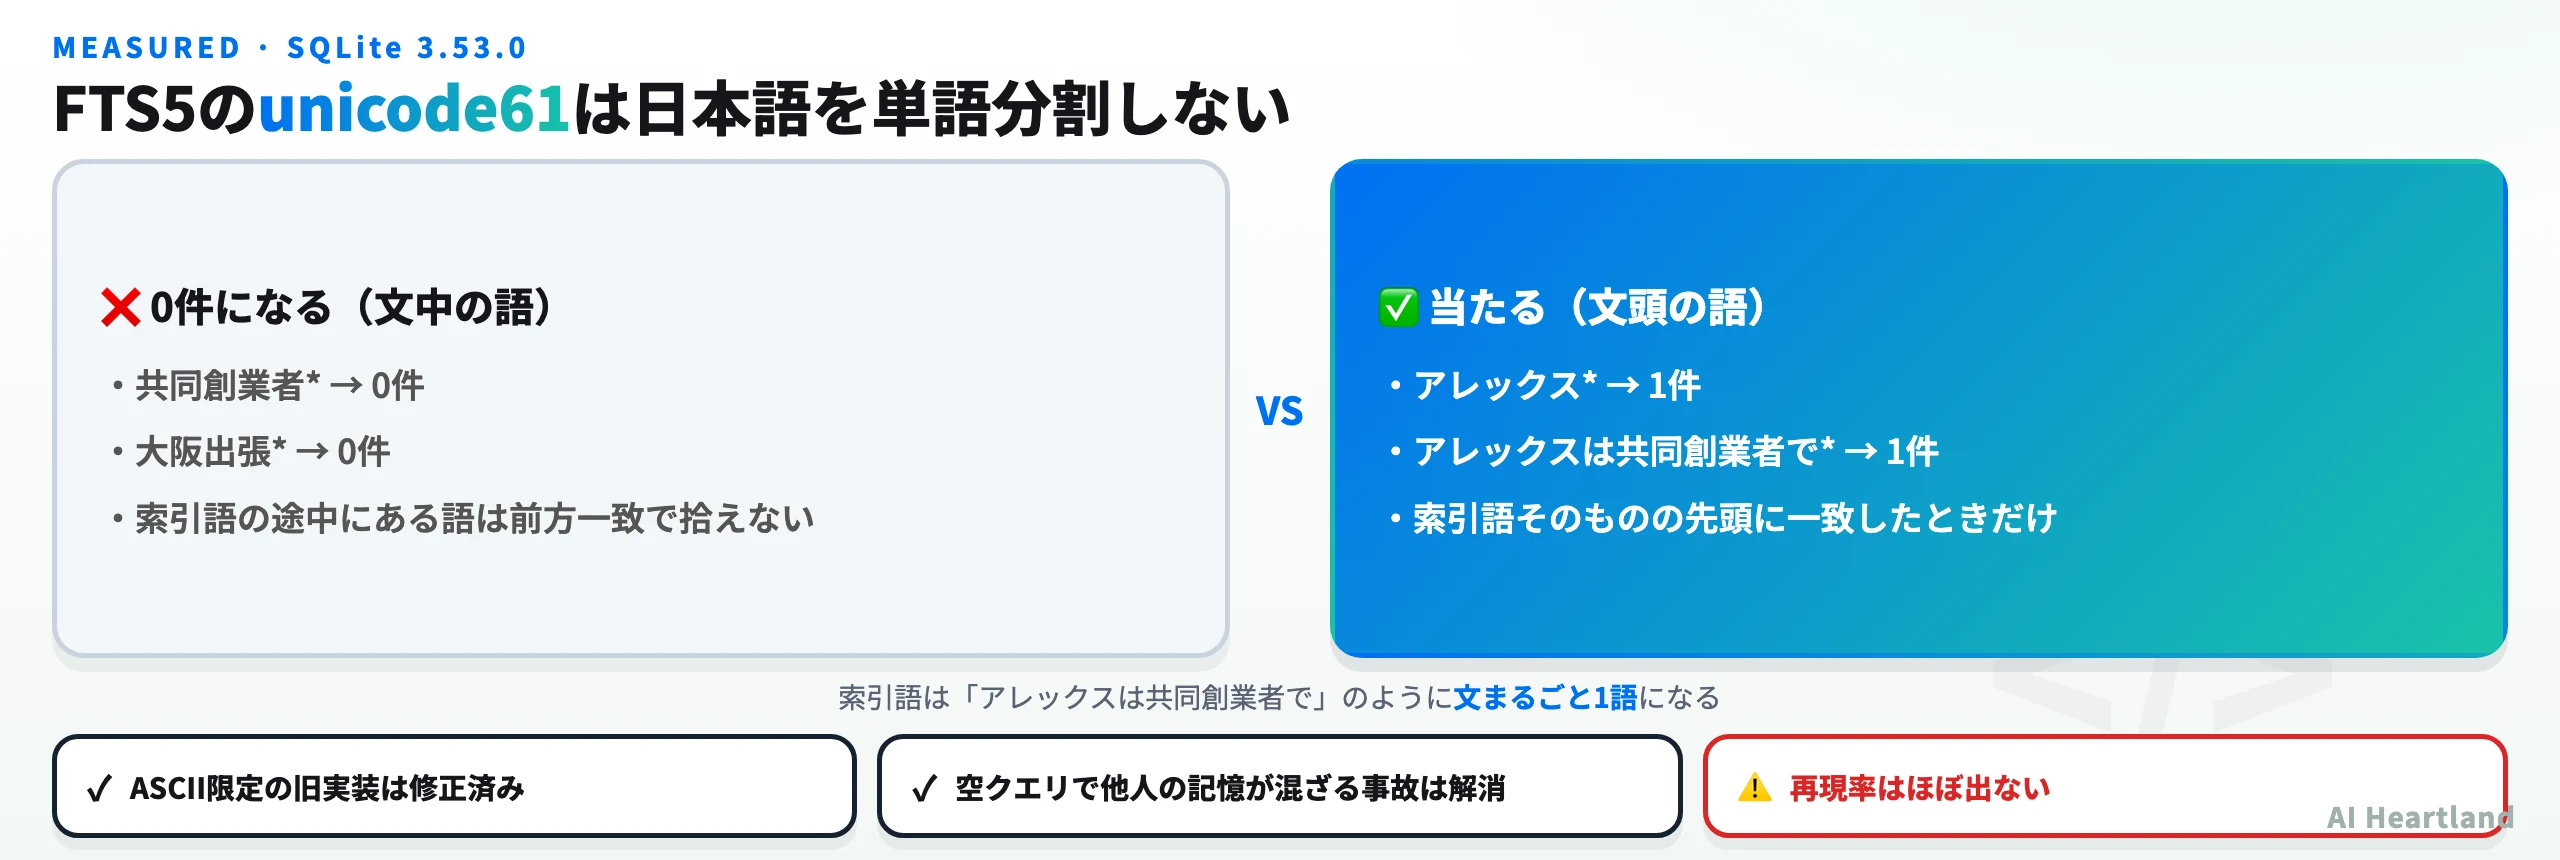
| 検索クエリ(前方一致) | ヒット | なぜそうなるか |
|---|---|---|
アレックス* |
1件 | 索引語 アレックス の先頭に一致 |
アレックスは共同創業者で* |
1件 | 索引語そのものの先頭に一致 |
共同創業者* |
0件 | 索引語の途中にある語は前方一致で拾えない |
大阪出張* |
0件 | 同上。来月の大阪出張は9月20日から2泊の予定 が1語 |
実際のユーザー文はさらに不利だ。「アレックスとの予定は?」は アレックスとの予定は* という1語になり、索引語 アレックスは共同創業者で とは先頭が食い違うので0件になる。結論は「壊れないが当たらない」——0件は返るが、旧実装のように他人の記憶が混ざることはもう無い。誤答より無回答のほうがましなので、これは正しい方向の劣化だ。日本語で実用するなら、FTS5側のトークナイザを差し替える必要がある。同じ表に tokenize='trigram' を指定して作り直したところ、前方一致に頼らず 共同創業者 で1件ヒットした(trigramは3文字ずつの部分列を索引するので語境界を必要としない)。実用にはMeCab等の形態素解析を挟む手もあるが、SQLite標準の範囲で済ませたいならtrigramが最短の変更点だ。ここは WAKU_SEMANTIC_STORE=supabase でベクトル側へ逃がすほうが早い。
RAG実装のコツ——チャンク設計からリランキングまで
ここからが本題だ。読んで確認できた事実を出発点に、このリポジトリがやっていることと、やっていないが本番では必要になることを分けて書く。
コツ1: チャンク分割は「答えの単位」で切る
waku-agent にはチャンク分割器が存在しない。rag_chunks に入るのは要約器が生成した1文の事実だ。長文を機械的に切るのではなく、最初から検索単位で書く。
これは怠慢ではなく回避である。チャンク分割が難しいのは「埋め込みたい単位」と「モデルに渡したい単位」がズレるからで、事実を1文に正規化すれば両者は一致する。
一般のRAGへの持ち帰りはこうだ。固定長分割は出発点であって最適解ではないが、凝った分割にすれば勝てるわけでもない——意味的リチャンキングや文書レベルチャンキングが固定窓を一貫して上回るとは限らないという報告がある。確実に効くのは見出し構造を保つ分割だ。## や <h2> で切り、見出しパスを各チャンクに残す。構造情報は無料のメタデータである。
現実解は「埋め込む単位」と「渡す単位」の分離だ。埋め込みは小さく(1〜3文)、LLMには前後を含む親チャンクを渡す。small-to-big/parent-document方式。waku-agent の「1文の事実」は、このsmall側だけを極端に推し進めた形と読める。オーバーラップは境界事故の保険であって精度向上の主役ではない。10〜20%で足りることが多い。
コツ2: メタデータ設計——検索に効くのは本文よりフィルタ
waku-agent が下流に渡すメタデータは subject 1つだけだ。DBには source も created_at もあるのに、検索結果には乗らない。ここが本番RAGとの最大の差である。
| メタデータ | 用途 | waku-agent での有無 |
|---|---|---|
| 出典ID・URL | 出典表示、ハルシネーション検証 | subject のみ。URLは無い |
| 更新日時 | 古い情報の減点・除外 | 保持しているが検索に未使用 |
| 権限スコープ | テナント/ユーザー分離 | 単一ユーザー前提で無し |
| 見出しパス・文書種別 | 事前フィルタで候補集合を縮小 | 無し |
| 生成元 | 人手入力か自動要約か | user/consolidation を保持(未使用) |
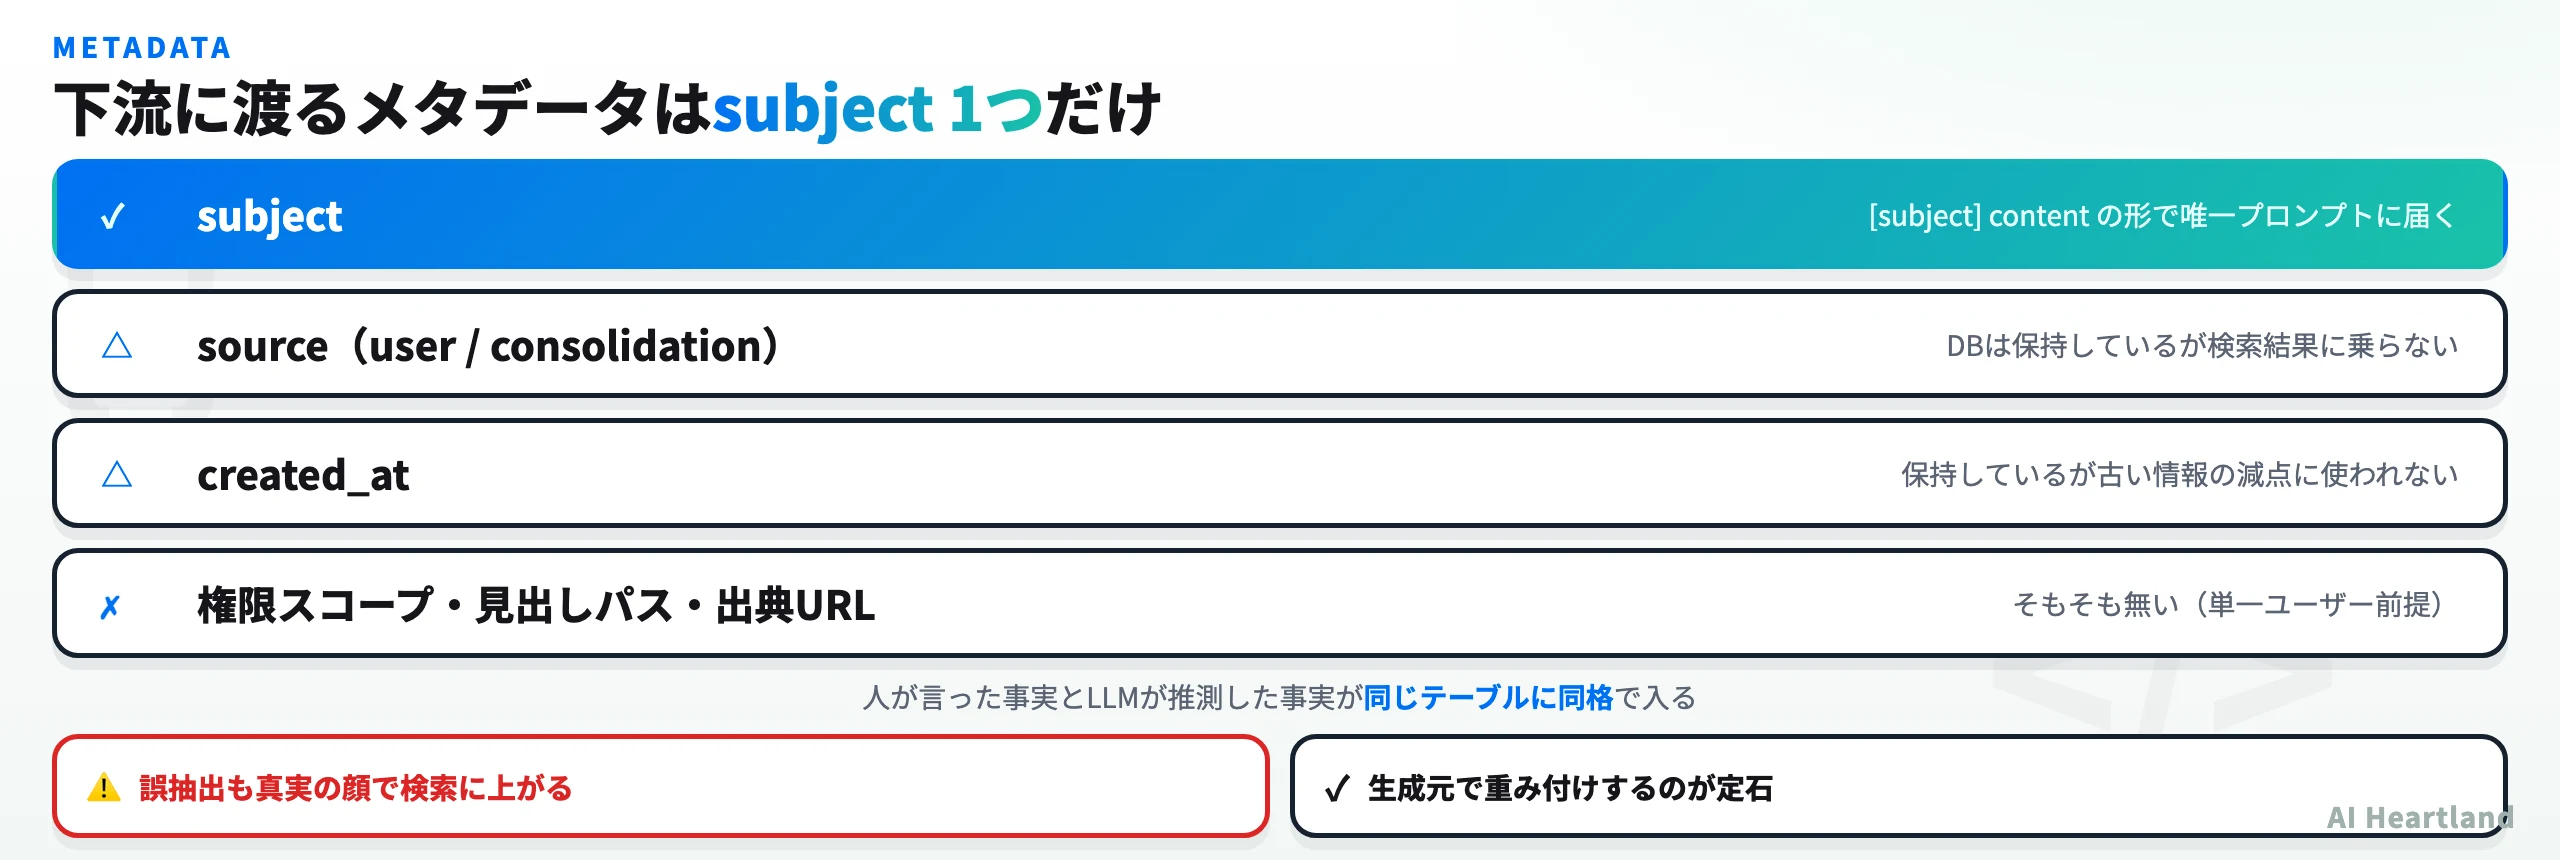
最後の行が特に重要だ。waku-agent は人間が言った事実とLLMが会話から推測した事実を同じテーブルに同格で入れている。要約器が誤抽出した「事実」は、以後ずっと真実の顔で検索に上がる。自動生成された知識には必ず生成元フラグを立て、検索時に減点するか、少なくともプロンプト上で区別できるようにするべきだ。ここは素直には盗めない部分である。
コツ3: ハイブリッド検索——BM25とベクトルは競合ではなく補完
waku-agent は BM25 とベクトルを排他的に切り替える。両方を走らせて統合する経路は、読んだ範囲に無かった。
しかし supabase_store.py のdocstring自体が、なぜハイブリッドが要るかを説明してしまっている。
When is this worth it over FTS5? When phrasing diverges from wording: “my business partner” should find “Alex is my cofounder”.
逆も真である。固有名詞、型番、エラーコード、社内略語——語彙が一致するクエリではBM25が強い。ベクトル検索は「XR-4200のトルク仕様」の XR-4200 を平気で取りこぼす。
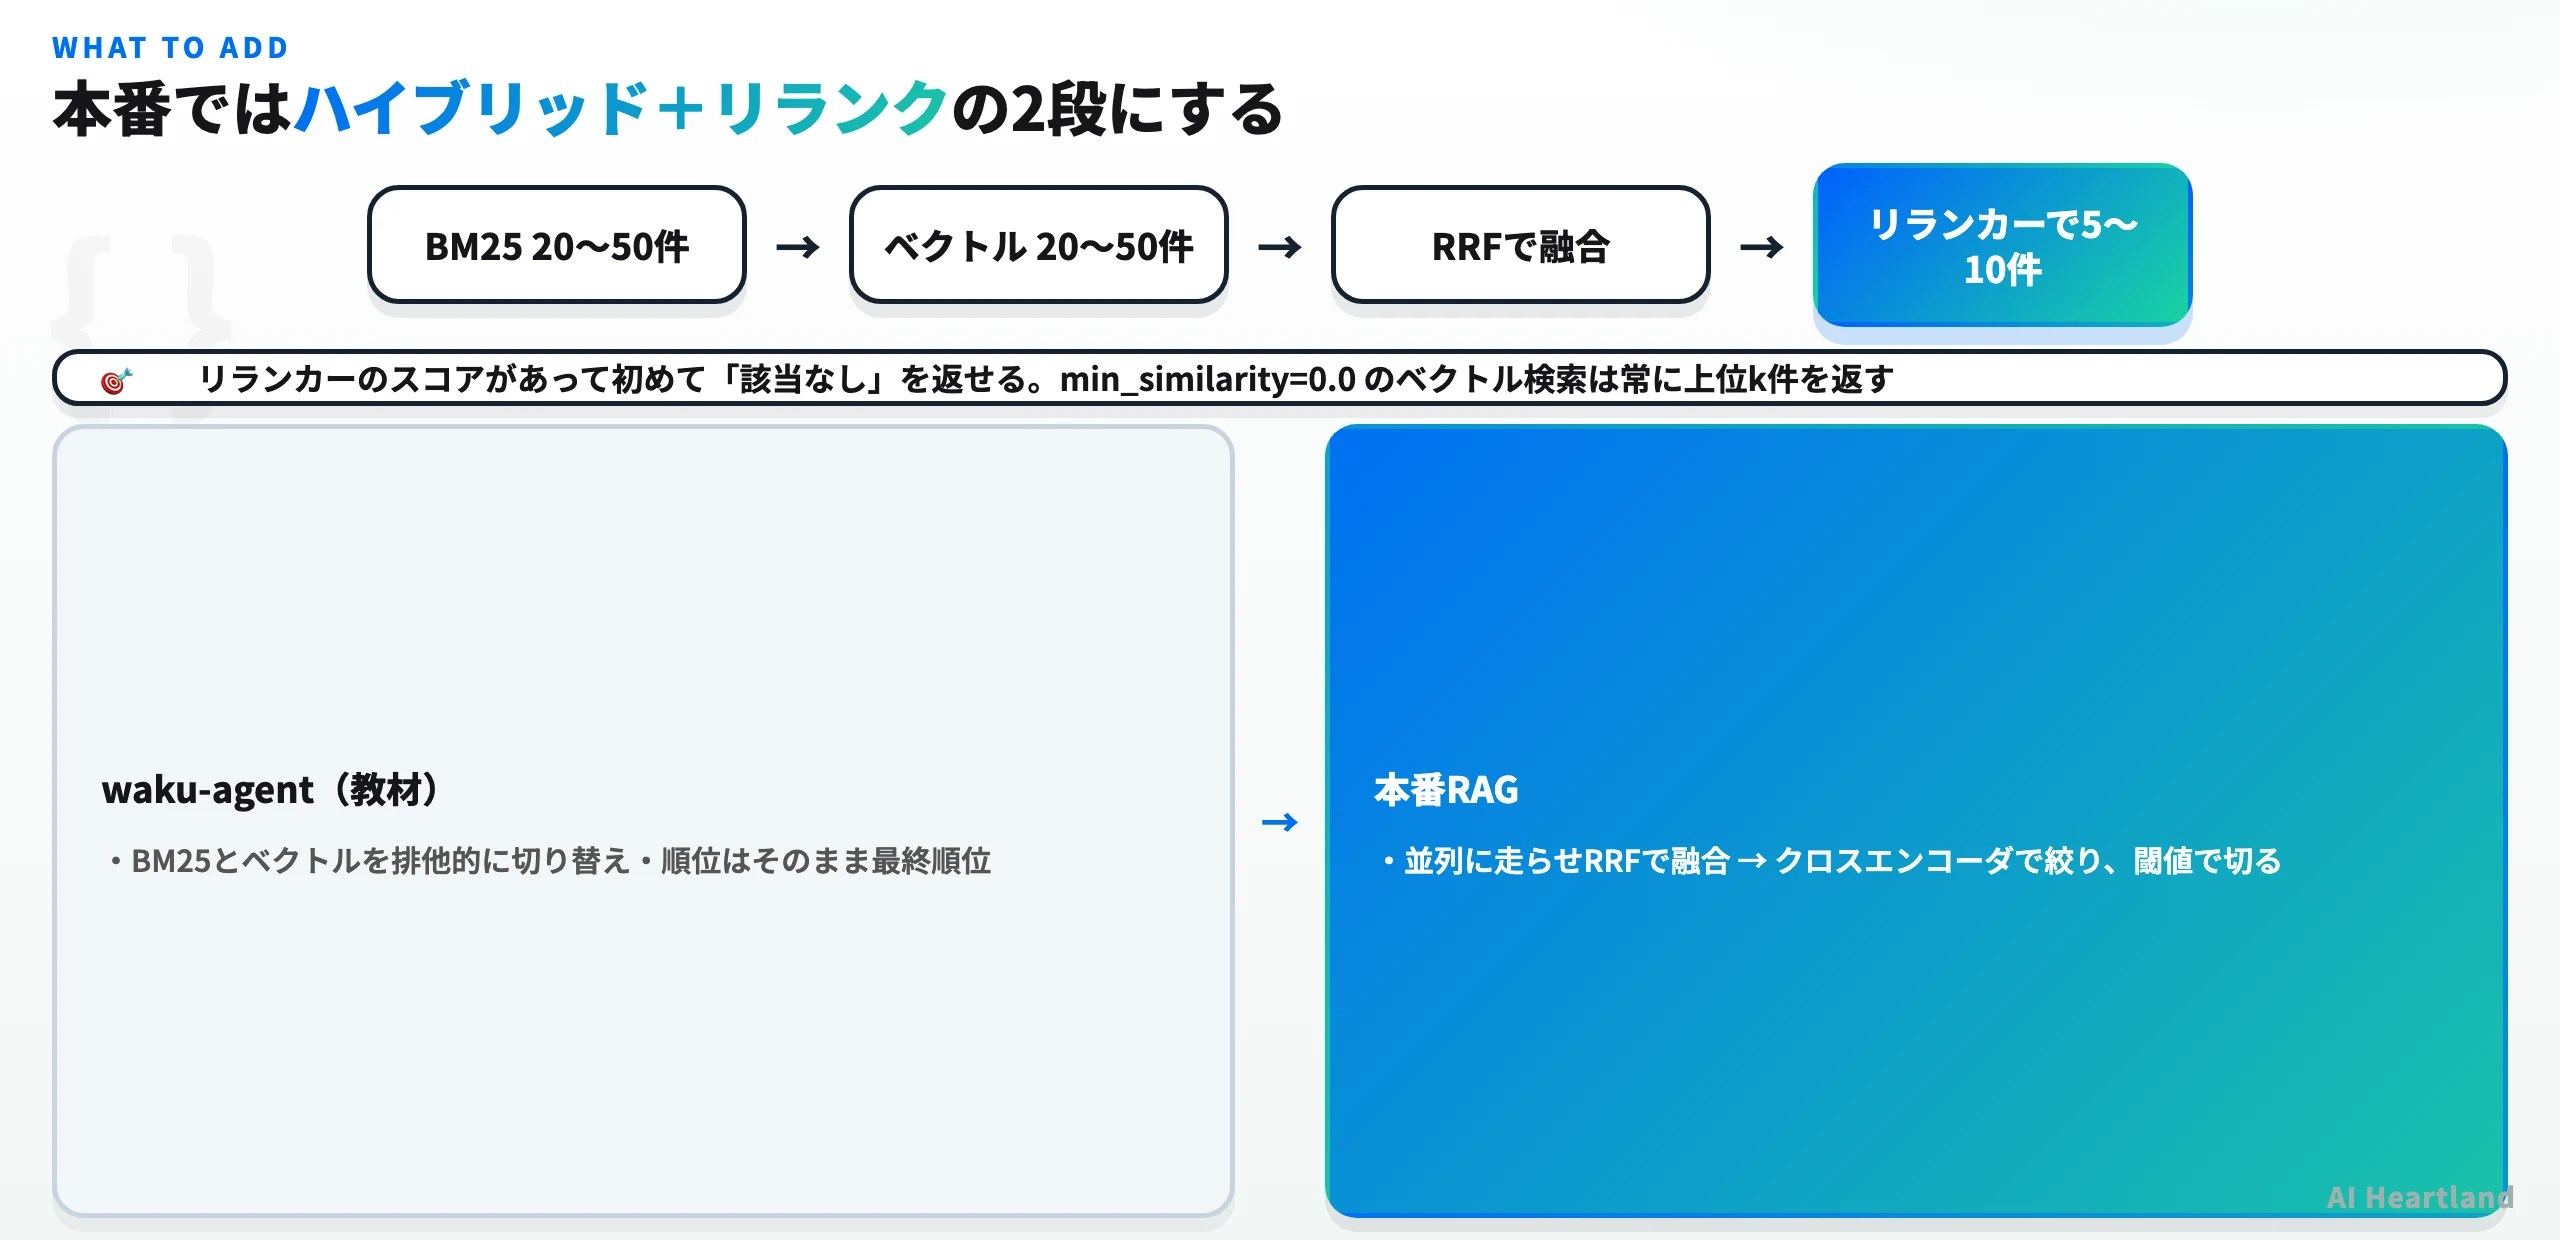
実装指針は3つ。BM25とベクトルを並列に走らせ Reciprocal Rank Fusion(RRF)で統合する(数十行で済み、スコア正規化が不要なのがRRFの利点)。統合前の各系統は広めに取る(各20〜50件、融合後に絞る)。そしてメタデータによる事前フィルタを先に効かせる——検索空間を1/10にする権限フィルタや期間フィルタは、どんなランキング改善よりも効く。
waku-agent でこれをやるなら、Memory._make_fact_store に hybrid 分岐を足し、2つの search 結果をRRFで融合する HybridFactStore を書けばいい。semantic/base.py に FactStore という Protocol が定義されていて search(query, top_k) -> list[str] を含むので、差し込みやすい設計にはなっている。
コツ4: リランキング——「順位」と「関連性」は別物である
waku-agent にリランカーは無い。 教材としては正しい省略だが、本番でここを省くと精度が頭打ちになる。
理由は構造的だ。埋め込みはクエリと文書を独立にベクトル化する(bi-encoder)ので、両者の相互作用を見ていない。クロスエンコーダ型のリランカーは両方を同時に入力し、「この文書はこのクエリに答えているか」を直接判定する。
実務上の型はこうだ。2段構成にする——1段目のハイブリッド検索で候補を50〜100件取り、リランカーで上位5〜10件に絞ってLLMに渡す。そしてリランカーのスコアを閾値に使う。これがベクトル検索単体との決定的な差だ。前述の通り min_similarity=0.0 のベクトル検索は常に上位k件を返すが、リランカーのスコアがあれば「該当なし」を返せる。RAGにおける「該当なし」は失敗ではなく正解である。
同時にレイテンシを計測すること。リランカーは1リクエストで数十〜数百msを足す。waku-agent のダッシュボードが Overview タブにコスト・レイテンシとゲートのskip/retrieve比を、Loop タブに1ターンごとのトークンとコストを出しているのは、この種の判断のためのインフラだ。
RAG実装のコツ(続)——ゲート・評価・コンテキスト長・ハルシネーション
コツ5: 「検索するか」を判定するゲート——最大の持ち帰り
このリポジトリから盗むべき単一の設計があるとすればこれだ。毎ターン検索する実装は、遅いだけでなく品質を下げる。「2+2は?」に過去の会話が3件入れば、モデルはそれを使おうとする。検索精度の問題ではなく、そもそも検索すべきでなかった問題だ。
コードから直接読み取れる実装ポイントを挙げる。
検索ゲートを自作するときの4点(retrieval_gate.py から抽出)
・安価な小型モデル1回で済ませる。 WAKU_SMALL_MODEL を専用に持つ。判定器に本番モデルを使うとコスト構造が崩れる
・retrieve と同時に query も返させる。 これが地味に効く。ゲートがクエリ書き換えを兼ねている。ユーザー文そのままより、抽出されたキーワードの方がBM25でもベクトルでも通りが良い
・必ずfail openにする。 逆にすると障害時に「知りません」を量産する
・判定を必ず記録する。 gated_retrieve は notify("gate", ...) を発火し、OpsタブとJSONLトレースに残る。skip/retrieve比が可視化されていない判定器は、チューニングできない
マルチターン対話では、ゲートの query にクエリ書き換えの責任を持たせると特に効く。「それいつだっけ?」のような照応表現は単体では検索不能だからだ。waku-agent のゲートは直近メッセージ1本しか見ておらず、ここは素直な拡張ポイントになる。エージェント側の記憶設計を掘るならBrainAPIとは|エージェントが自分でナレッジグラフを描くAIメモリ層をmem0・cogneeと比較も参考になる。
コツ6: 評価——決定論的テストとLLM審査を絶対に混ぜない
waku-agent の評価設計はRAGにそのまま移植できる。
make eval          # 決定論的: 「正しいツールが発火したか」——0か1、モデルは判定しない
make eval-judge    # LLM審査: 「返答は役に立ったか」——スコア%
make gate          # リリースゲート: 決定論的は100%必須、審査は閾値クリア必須
決定論的テストは evals/deterministic/ の素のpytest、審査側は evals/judge/ のDeepEval。READMEはこの分離を “the most common eval mistake” を避けるためだと明言している。
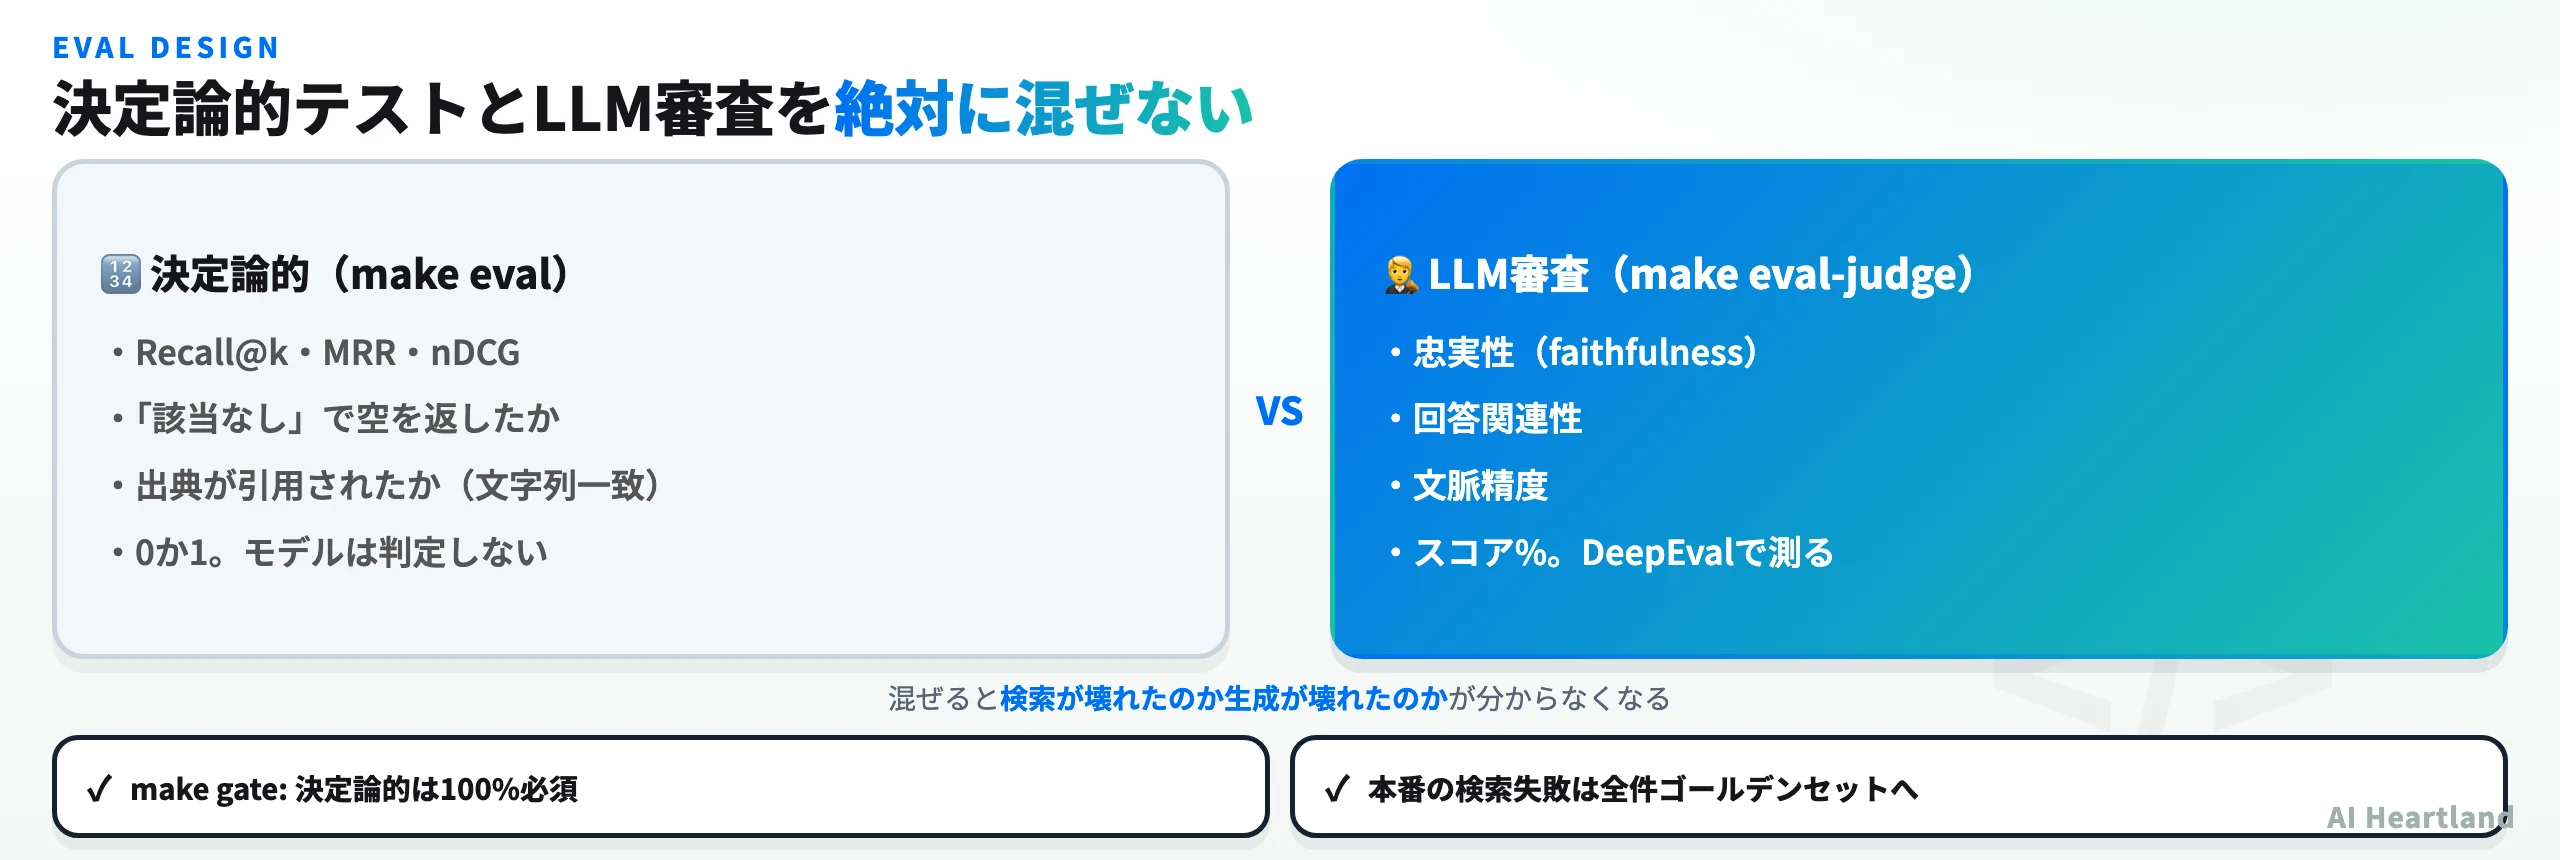
RAGに翻訳するとこうなる。決定論的に測れるもの——正解文書が上位k件に入ったか(Recall@k)、その順位(MRR、nDCG)、「該当なし」であるべきクエリで空を返したか、出典が引用されたか(引用の存在は文字列一致で測れる)。LLM審査が必要なもの——忠実性、回答関連性、文脈精度。
この2つを1つの数値に混ぜてはいけない。 混ぜると、検索が壊れたのか生成が壊れたのかが分からなくなる。RAGのデバッグで最も時間を溶かすのがこの切り分けで、スイートを分けるだけで切り分けが自動で終わる。
さらに良いのはバグ修正の作法が明文化されている点だ。READMEの実例——エージェントが現在時刻を知らず「30分後」の予定を組めなかった → session.py で修正 → evals/deterministic/test_working_memory.py で恒久的に固定。RAGでも同じことをやる。本番で見つかった検索失敗は、1件残らずゴールデンセットに追加する。 100件積み上げたゴールデンセットは、どんな汎用ベンチマークよりも自分のシステムを正確に表す。
コツ7: コンテキスト長とコスト——上限は「モデルの上限」ではなく「効く上限」
waku-agent の数値は保守的だ。WAKU_RETRIEVAL_TOP_K=4、エピソード top_k=3(ハードコード)、WAKU_HISTORY_TURNS=12、WAKU_MAX_ITERATIONS=10、WAKU_MAX_TOKENS=8192。効いているのは会話履歴側の上限で、config.py は history_turns をスライディングウィンドウ(コンテキストRAM)と呼び、理由をこう書いている。
Without this cap a long thread (esp. the always-on Telegram session) resends its whole history every turn until it explodes.
窓から出た古いターンは失われるわけではない。state.db に残り、consolidation が事実へ蒸留し、検索ゲートが必要なときに引き戻す——捨てるのではなく置き場所を移す設計だ。なお max_tokens が 2048 から 8192 へ引き上げられた理由は別で、推論モデルが thinking の途中で stop_reason=max_tokens に当たり空の返答を返す事故を避けるため、とコメントに書かれている。
教訓は、「コンテキストが大きいから全部入れる」は最悪の選択だということ。理由は3つある。コストが線形に増える(waku-agent は全呼び出しのトークンを .waku/usage.jsonl に追記専用で残す。トークンが計測されていないRAGはコストを最適化できない)。精度が上がるとは限らない(top-kを増やすと再現率は上がるが適合率は下がり、無関係な文書が増えるほどモデルはそれを使おうとする)。そしてレイテンシが増える。
現実的な手順は、まず top_k=3〜5 で動かし、Recall@k が足りないことを測定で示してから増やす。増やすときは、候補を広く取ってリランカーで絞る方が、単純にkを上げるより常に良い。
コツ8: ハルシネーション対策——「信じろ」と書いてはいけない
session.py のシステムプロンプト(DEFAULT_SOUL)にはこうある。
If memory context is provided below, trust it — it came from your own store.
単一ユーザーの自己申告メモリでは合理的だ。ユーザー本人が言ったのだから疑う理由がない。だが外部文書RAGにこの行を持ち込むと事故になる。検索が失敗して無関係な文書が入ったとき、モデルがそれを無理やり使うからだ。RAGのハルシネーションの大半は、モデルの創作ではなく間違った文脈を真面目に使った結果である。
対策は、同じ DEFAULT_SOUL の別の指示——「ツール出力が言っていない同期先を主張するな」という出所を偽らせない方針の延長線上にある。RAGでは次の形で実装する。
・各チャンクに出典IDを付けてプロンプトに入れ、回答文に引用を義務づける。 引用できない主張は出させない。引用の有無は決定論的に検証できる(コツ6)
・「文脈に無ければ『分かりません』と答えよ」を明示する。 ただしこれ単体では不十分で、リランカーによる閾値カット(コツ4)とセットで初めて機能する。文脈が常に7件入る構成では、モデルは「分かりません」を言いにくい
・忠実性を別スイートで測る。 回答の各文が検索文脈のどのチャンクから導けるかをLLM審査で判定する
小型モデル1回"} B -->|"skip"| P["記憶なしで応答"] B -->|"retrieve + 書き換えクエリ"| C{"WAKU_SEMANTIC_STORE"} C -->|"sqlite(既定)"| D["FTS5 BM25
top_k=4"] C -->|"supabase"| E["pgvector コサイン
match_count=4"] D --> F["エピソード検索 top_k=3"] E --> F F --> G["最大7行を Relevant memory: へ"] G --> H["LLM 応答"] H --> I{"未統合ログ 12行?"} I -->|"はい"| J["consolidation
会話を1文の事実へ蒸留"] I -->|"いいえ"| K["次のターンへ"] J --> K
実装時の落とし穴と、向く/向かない用途
抽象論ではなく、読んだコードから確認できた具体例だ。
| 落とし穴 | waku-agent での現れ方 | 対処 |
|---|---|---|
| トークナイザが言語を想定していない | unicode61 は日本語を分割せず一続きの文が1語になる。前方一致では文頭の語しか当たらない(本記事で実測) |
FTS5側にトークナイザを足すか、ベクトル側へ逃がす |
| IVFFlatを空テーブルに張る | init_supabase.sql は投入前に lists = 100 でインデックスを作る |
IVFFlatはデータ投入後に構築する。数百件なら lists を小さく、あるいはHNSWか全走査 |
| 類似度の閾値が使われない | RPCは min_similarity を受け取るが search は渡さない(既定0.0) |
閾値を必ず通し、「該当なし」を返せる構成にする |
| 埋め込みが非対称 | 書き込みは f"{subject}: {content}"、検索はクエリ素のまま |
前処理を揃えるか、非対称にするなら意図的に設計する |
| 検索結果にスコアが乗らない | search の戻り値は list[str]。順位も距離も失われる |
戻り値を構造体にする。スコアが無いとフィルタもRRFもリランクもできない |
| 自動生成の知識が人手入力と同格 | source に user/consolidation を持つが検索では無視 |
生成元で重み付けするか、プロンプト上で区別する |
| 空クエリが「無検索」にならない | SqliteEpisodeStore.search() は空クエリで recent(top_k) を返す |
空クエリは明示的に0件で返す。フォールバックは黙って効かせない |
| 権限設定が開発用のまま | init_supabase.sql は "Allow anonymous read access" ... USING (true) を作る(スクリプト内に「本番では削除」と注記あり) |
RLSポリシーは本番投入前に必ず見直す |
向く——RAGとエージェント記憶の内部構造を学ぶ/教える教材として。「検索ゲート」「バッチ統合」「決定論的評価とLLM審査の分離」の3パターンを自分の実装に移植したいとき。単一ユーザー・数百件規模のプロトタイプ。ローカル完結が要件のとき(既定構成では埋め込みAPIすら呼ばない)。
向かない——日本語ドキュメントのRAG(上記のトークナイザ問題で再現率が出ない)。大規模文書コーパス(チャンク分割器も取り込みパイプラインも無い)。マルチテナントや権限分離が要る用途(メタデータフィルタが無い)。精度が要件の本番システム(ハイブリッド検索もリランカーも閾値カットも無く、docs/architecture.md 自身が “not production” と書いている)。
参照ソース
・ShenSeanChen/waku-agent — GitHubリポジトリ
・waku/memory/retrieval_gate.py / semantic/store.py / semantic/supabase_store.py / semantic/base.py
・waku/memory/consolidation.py / waku/memory/episodic/store.py / waku/config.py
・waku/runtime/session.py / README.md / Makefile
・sql/init_supabase.sql / docs/architecture.md
・SQLite FTS5 — unicode61 トークナイザ公式ドキュメント
・9 advanced RAG techniques to know & how to implement them — Meilisearch
・検証方法: 2026年9月10日、raw.githubusercontent.com の main ブランチから上記Python/SQLファイルの全文を直接取得して原文を読んだ。本文中の数値(retrieval_top_k=4、エピソード top_k=3、consolidate_every=6、history_turns=12、max_iterations=10、max_tokens=8192、VECTOR(1536)、lists=100、match_count DEFAULT 6、min_similarity DEFAULT 0.0)はすべてソース上の記述である。リポジトリのメタ情報(★1,713・フォーク329・コミット325)はGitHub APIから同日取得した。日本語トークナイザの節は、SQLite 3.53.0 に同構成のFTS5テーブルを作り fts5vocab で索引語彙を確認したうえで、前方一致クエリを1件ずつ実行した結果である