grep で当たるのは、探している語をすでに知っているときだけだ。「認証まわりの検証をしている場所」「あの時ベンチマークの数字を書いた記事」のように、語ではなく意味しか手元にないとき、正規表現は空振りする。かといって全文をLLMに読ませればトークンが飛ぶ。
zvec-grep(コマンド名 zg・★1,751・Apache-2.0・2026-09-04時点)は、この隙間を1つの索引で埋めにいくツールだ。ripgrep(正規表現)・BM25(語の重み付き全文検索)・ベクトル検索(意味)を同じワークスペース索引の上に載せ、人間はCLIから、AIエージェントはMCPツールから、同じ索引を引く。Alibaba の zvec をベクトルストアに使っている。
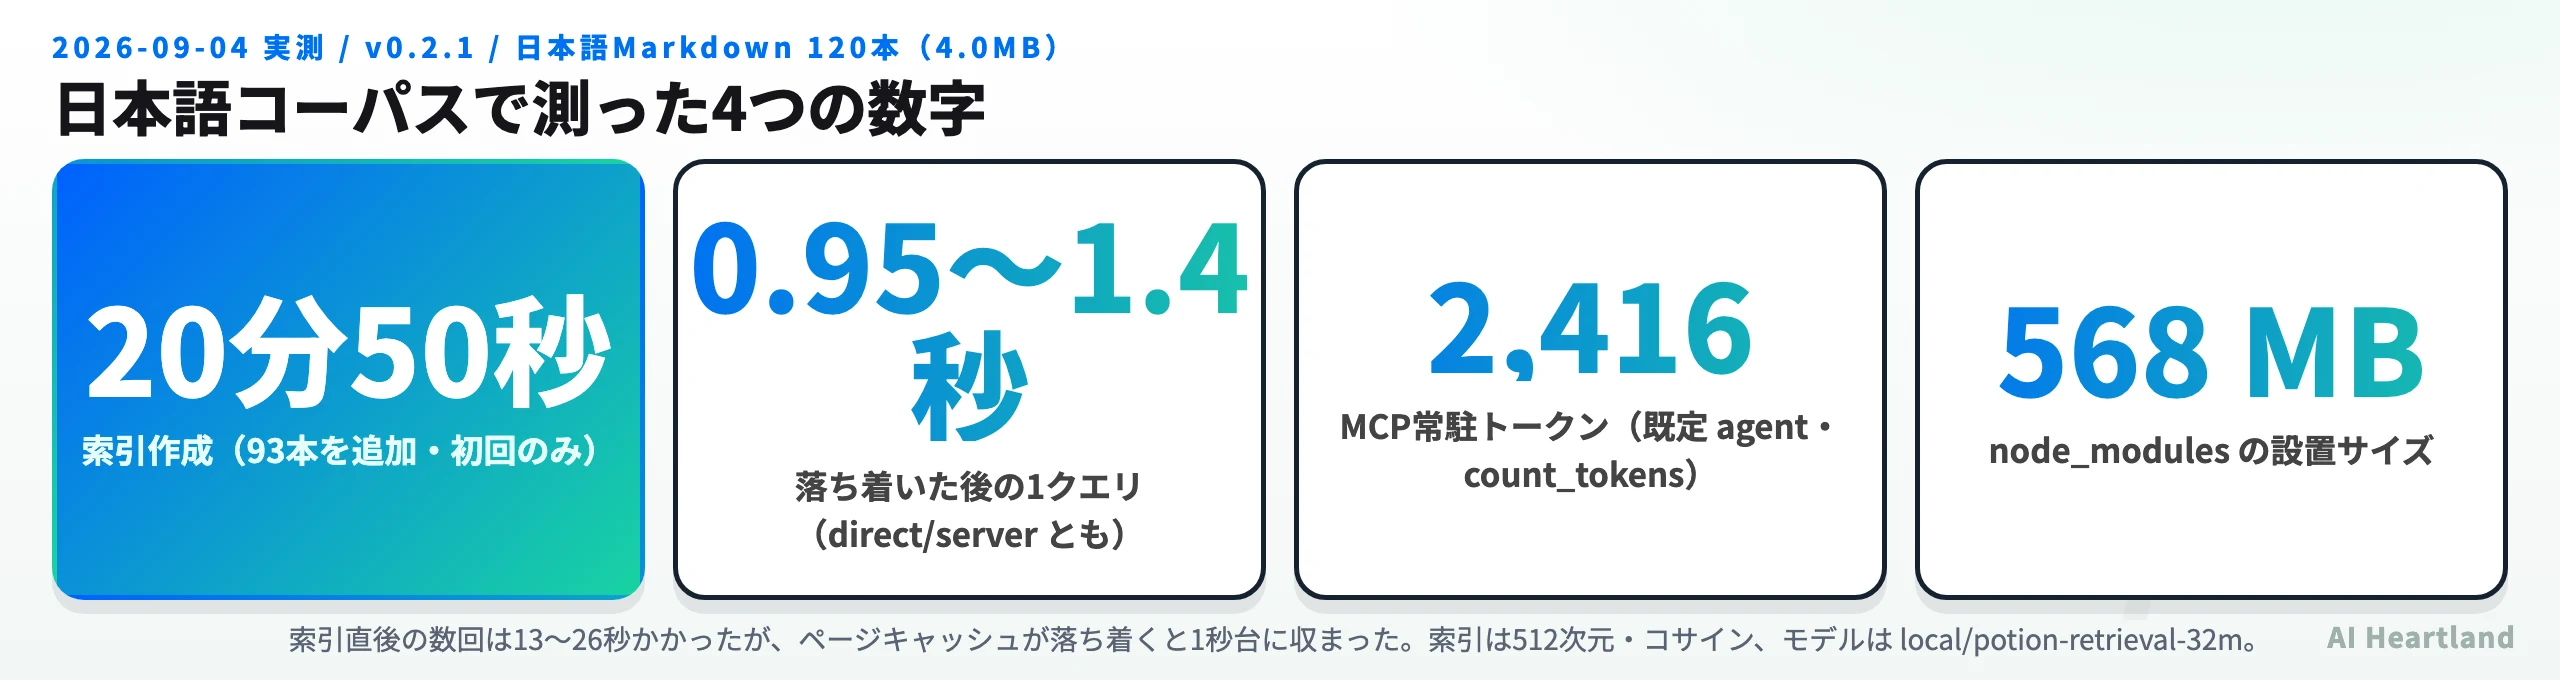
この記事は公称値の紹介ではなく、2026-09-04に v0.2.1 を実際にインストールし、日本語のMarkdown 120本を索引して測った結果を軸にしている。結論から言うと、この道具の評価は「検索が速いかどうか」ではなく「その20分の索引作成に見合う探索をするかどうか」で決まる。検索自体は1秒前後で返る。
・
zg index で作った1つの索引を、正規表現・BM25・ベクトルの3経路から引く・埋め込みは既定でローカル実行。リモート埋め込みは明示的に許可したときだけ使われる
・MCPサーバーとして立てると、既定ではツール1個・2,416トークンしか常駐しない
・代償は設置サイズ568MBと索引作成の遅さ。日本語93本で20分50秒。検索自体は1秒前後
検索そのものをAIの文脈供給に使う設計の全体像はRAGとは?仕組み・構築・ベクトルDB選定までの2026年実装マップにまとめている。
zvec-grepとは:3種類の検索を1つの索引に束ねるCLI
zg は「探し方を選ばせない」ことを設計の中心に置いている。同じクエリを投げると、内部で複数の経路に分岐して結果を統合する。実際に実行すると、応答の先頭にどの経路を使ったかが出る。
# インストール(Node.js 22 以上が必要)
npm install -g @zvec/zvec-grep

# ワークスペースを索引する(ローカル埋め込みモデルを指定)
zg index --embedding local/potion-retrieval-32m

# 意味で引く
zg query --human "ヘッドレスブラウザでスクレイピングを高速化する方法" --limit 3
手元での実際の出力は次のようになった(抜粋)。
Routes: fts:ヘッドレスブラウザでスクレイピングを高速化する方法, vector:ヘッドレスブラウザで…
Coverage: ranked_sample
Files: 3   Hits: 3

  #1 heading ヘッドレスモード(無頭模式)が主線 matchedBy=fts+vector score=0.0301
  Heading level: 3
  Scope: 導入時の注意点と現在の開発ステータス
注目すべきは matchedBy=fts+vector の表示だ。全文検索とベクトル検索の両方に当たったことが結果ごとに明示されるため、「意味で拾えたのか、語がたまたま一致しただけなのか」を利用者側で判別できる。ランキングをブラックボックスにしない点は、検索結果をそのままエージェントに渡す用途では地味に効く。
返ってくるのはファイル全体ではなく、見出し・行範囲・その見出しが属する上位セクション(Scope)の単位だ。上の例では 464〜467 行という4行だけが返っている。LLMに渡す文脈量を抑えるための設計がここに出ている。
索引は何を持っているか
索引の状態は zg status で見える。実測では次の通りだった。
✓ Workspace index is ready
  Coverage    ████████████████████ 100%  120 / 120 files
  Entities    2,579
  Embedding   local/potion-retrieval-32m
              512 dimensions · cosine
  Storage     .zvec-grep/index.zvec
120ファイルから 2,579エンティティが切り出され、512次元のベクトルとしてコサイン類似度で引かれる。索引の実体は対象ディレクトリ直下の .zvec-grep/index.zvec に置かれるので、リポジトリごとに独立し、.gitignore で外せば共有もされない。
インストールの実コスト:npmの2.16MBに対し、展開後は568MB
READMEは軽さを売りにしていないが、「ローカルファースト」という言葉から受ける印象と実際の設置サイズには開きがある。実測すると次のようになった。
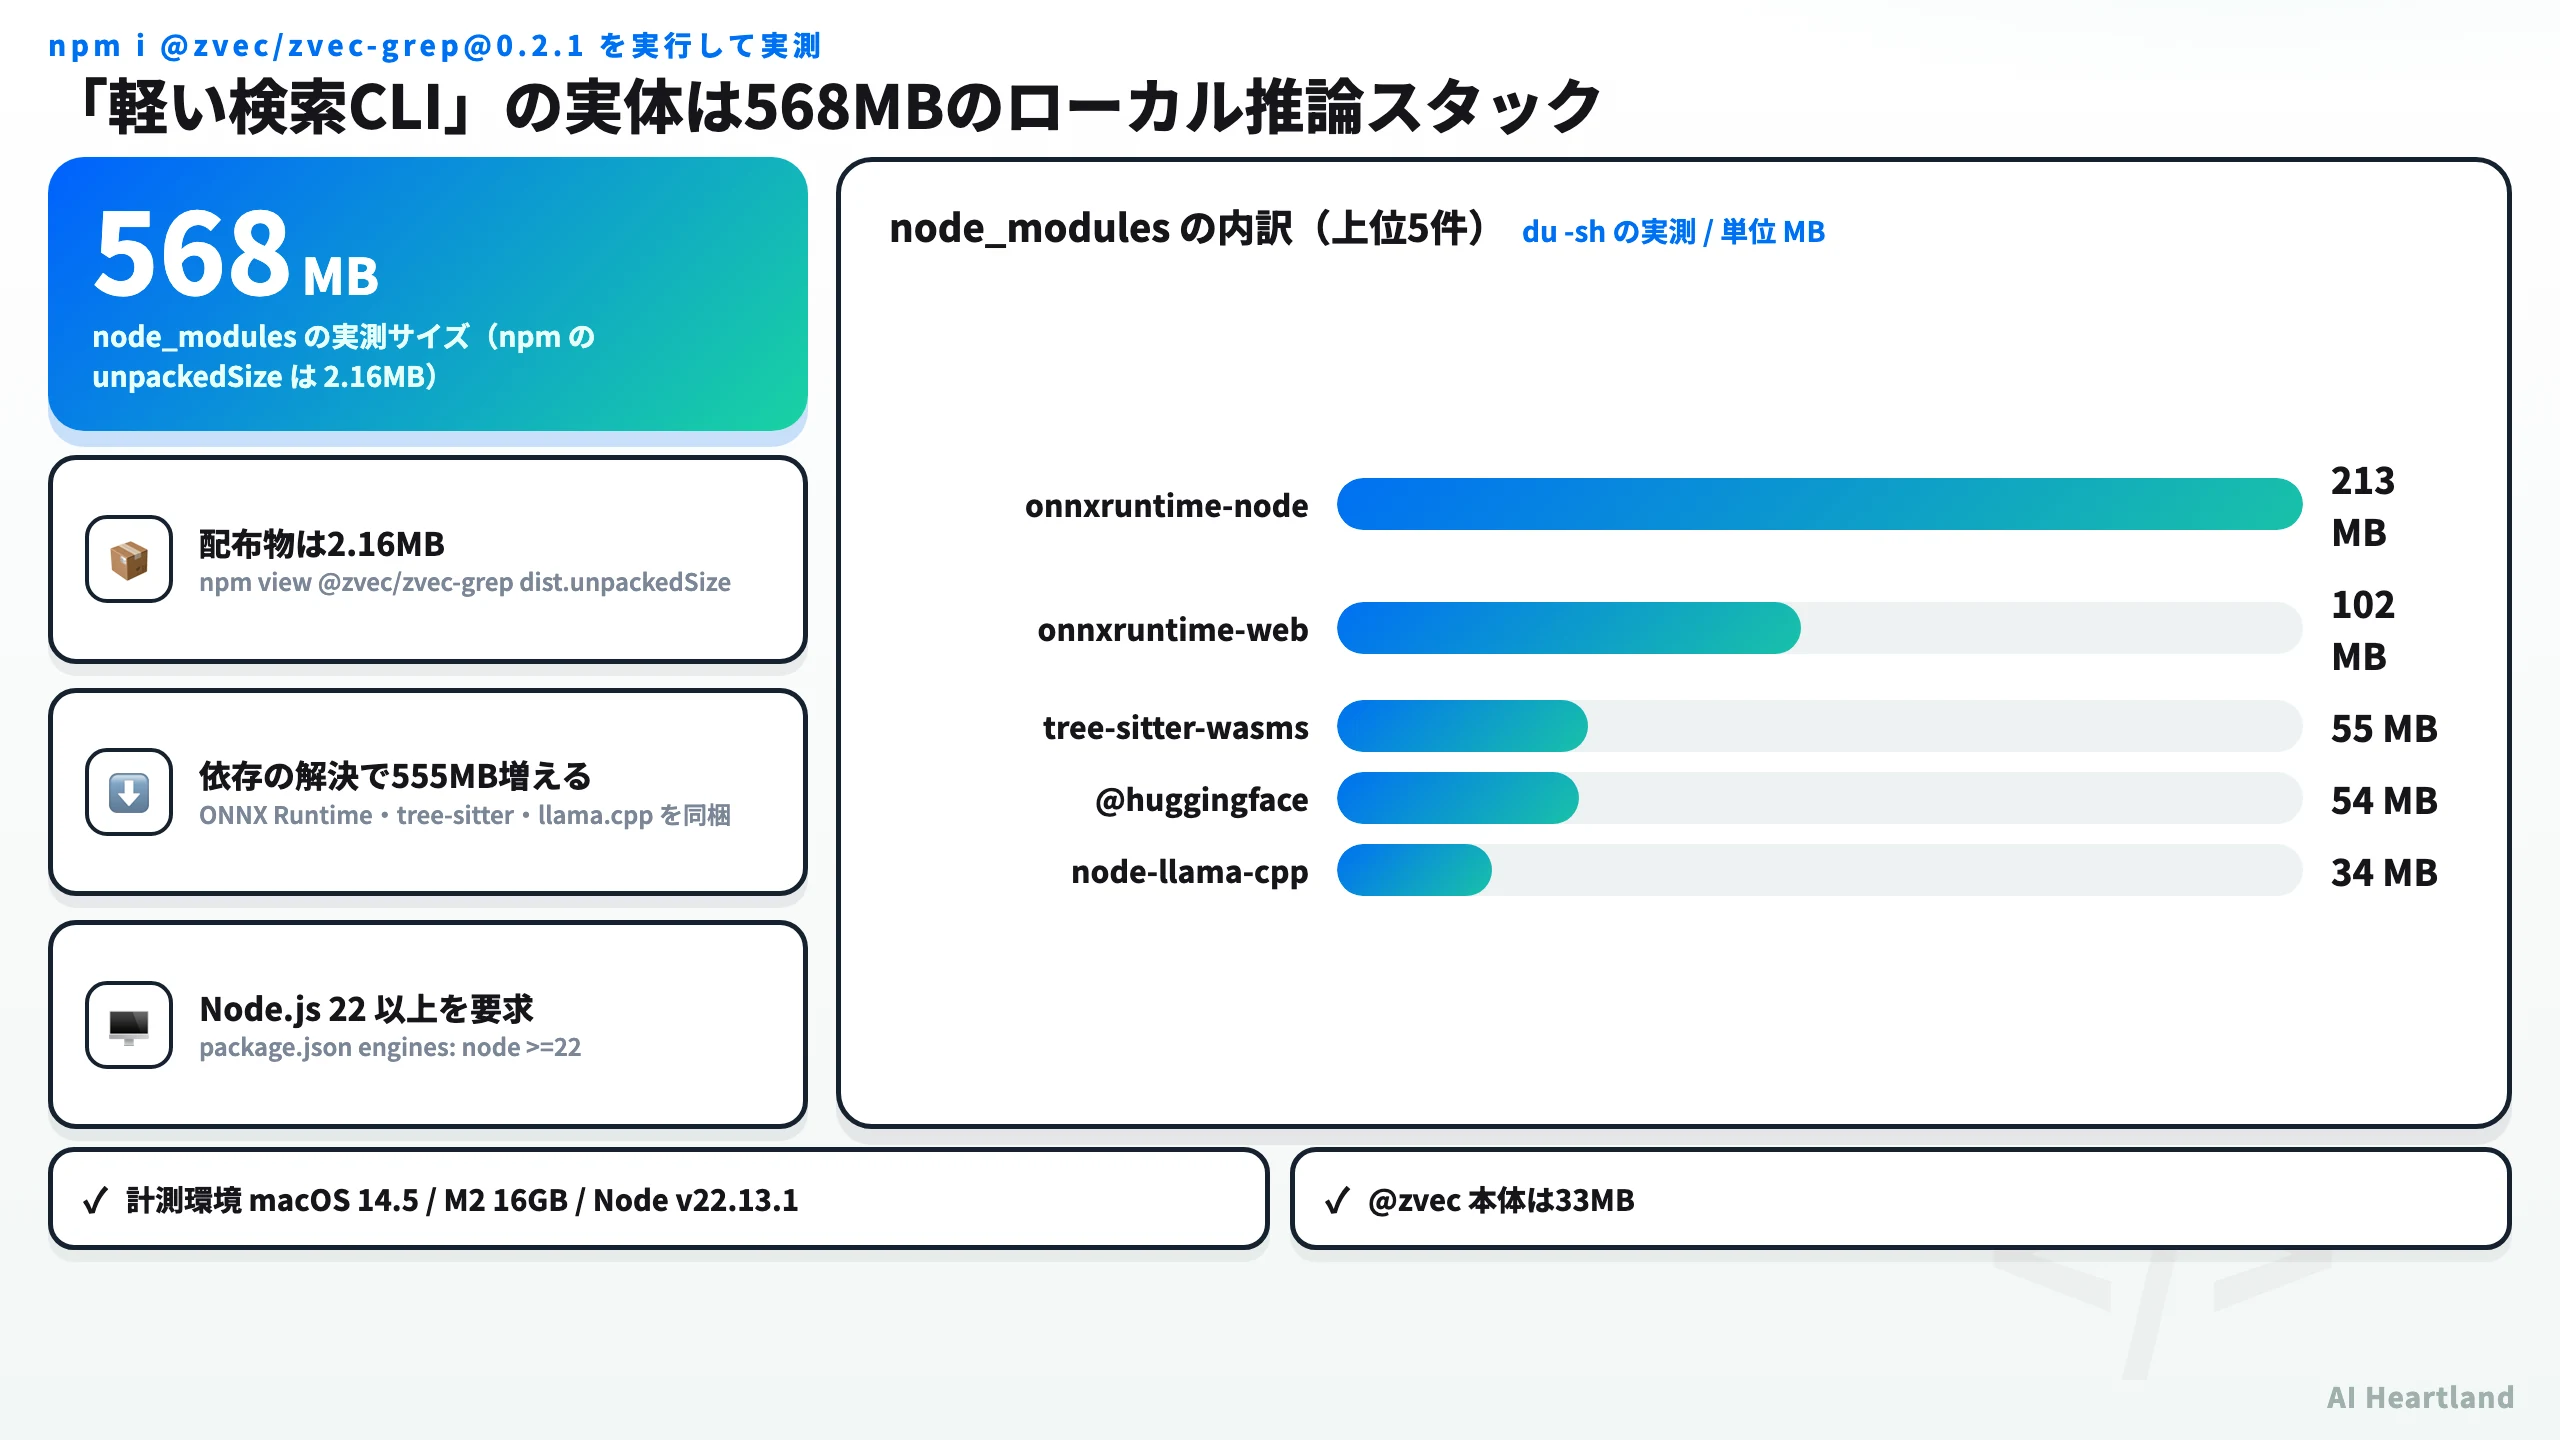
npm view @zvec/zvec-grep dist.unpackedSize は 2,155,651 バイト。実際に npm i した node_modules は du -sh で 568MB だった。| 項目 | 値 | 確認方法 |
|---|---|---|
| npm 配布物(unpackedSize) | 2.16 MB | npm view @zvec/zvec-grep dist.unpackedSize |
依存解決後の node_modules |
568 MB | du -sh node_modules |
| うち onnxruntime-node | 213 MB | du -sh node_modules/* |
| うち onnxruntime-web | 102 MB | 同上 |
| うち tree-sitter-wasms | 55 MB | 同上 |
| うち @huggingface | 54 MB | 同上 |
| うち node-llama-cpp | 34 MB | 同上 |
この555MBは「無駄」ではなく、ローカルファーストという設計の請求書だ。埋め込みをクラウドAPIに投げる設計なら ONNX Runtime も llama.cpp も要らない。だがそれをやめて手元で完結させると決めた以上、推論ランタイムと構文解析器を丸ごと抱えることになる。「ローカルで動く」と「軽い」は同時に成立しないという、この種のツールに共通する取引がそのまま出ている。
Node.js のバージョン要件は package.json の engines に {"node": ">=22"} として宣言されている。ただし npm は既定で engines を助言としてしか扱わない(engine-strict が有効なときだけインストールを止める)ため、古いNodeでも入ってしまい実行時に落ちる可能性がある点は注意しておきたい。手元の Node v22.13.1 では問題なく動作した。
索引作成の実測:日本語Markdown 120本で20分50秒
ここが導入判断の分かれ目になる。日本語の技術記事Markdown 120本(合計4.0MB)を zg index --embedding local/potion-retrieval-32m で索引した結果は次の通りだった。
Workspace index
files      120 scanned, 93 added, 0 modified, 1 retried, 26 unchanged, 0 deleted, 0 failed
entities   1939
duration   20m 50s (1249677ms)
1ファイルあたり約13.4秒。ファイルサイズが平均33KBのMarkdownであることを考えると、体感としてはかなり遅い。ピークRSSは213MB、ピークメモリフットプリントは678MBだった。
モデルのダウンロードは含まれない(先行する実行で取得済み)。一方、この回は途中で中断した前回実行の分 26ファイルが
unchanged として再利用されているため、20分50秒は120本ぶんではなく93本ぶんの実測である。120本をゼロから索引すれば、単純計算でさらに数分伸びる。
差分更新は効く。同じディレクトリで再実行すると変更のないファイルは unchanged として飛ばされるので、初回だけが重く、以後は触ったファイルぶんで済む。CIで毎回まっさらな環境から索引を作る使い方には向かない。
検索の実測:測り直したら1秒台だった(そして最初の測定は間違っていた)
ここは一度誤った数字を出しかけたので、経緯ごと書く。索引作成の直後に測ったクエリ所要時間は次のようになっていた。
| 実行モード | 1回目 | 2回目 | 3回目 |
|---|---|---|---|
| 直接モード(索引直後) | 33.3秒(モデル読込を含む初回) | 21.6秒 | 25.6秒 |
| サーバーモード(索引直後) | 33.3秒(デーモン暖機) | 13.2秒 | 13.4秒 |
この時点では「1クエリ13秒。サーバーモードで半分になる」と書けそうに見える。ところが同じマシン・同じ索引・同じクエリで、しばらく置いてから測り直すと結果が変わった。
| 実行モード | 1回目 | 2回目 | 3回目 |
|---|---|---|---|
| 直接モード(落ち着いた後) | 1.25秒 | 1.42秒 | 1.36秒 |
| サーバーモード(落ち着いた後) | 1.37秒 | 1.06秒 | 1.02秒 |
| 直接モード(別クエリで再確認) | 1.21秒 | 1.07秒 | 0.95秒 |
# 実際に回した計測(クエリ・索引・マシンはすべて同一)
for i in 1 2 3; do /usr/bin/time -p zg query --human "MCPサーバーの常駐トークン" --limit 1 >/dev/null; done
索引作成はピークメモリフットプリント678MBを使い、568MBぶんのネイティブモジュールをディスクから読む。その直後はページキャッシュもメモリ圧も落ち着いておらず、Nodeプロセスの起動そのものが重い。落ち着いた状態では direct 0.95〜1.42秒 / server 1.02〜1.37秒 で、両モードに実質的な差は無かった。
つまり「サーバーモードで半分になる」という当初の観察は交絡であって効果ではない。デーモンの本来の役割は速度ではなく、複数クライアント(CLIとエージェント)で1つの索引と1つのモデルを共有することにある。
なお「ローカルファースト」の主張については、HTTPS_PROXY / HTTP_PROXY / ALL_PROXY をすべて閉じたポート(127.0.0.1:9)に向けて外向き通信を落とした状態でも、終了コード0で通常どおりヒットが返った。この条件下の3回の所要時間は 1.73 / 1.04 / 0.97 秒で、通信が通る状態(1.25 / 1.42 / 1.36 秒)と差が無い。既定のローカル埋め込みで索引済みのワークスペースを引く限り、検索経路に外部依存は無いと言ってよい。ただしこれは「通信を必要としない」ことの確認であって、「一切通信しない」ことの証明ではない(リモート埋め込みを明示的に許可した場合は当然外に出る)。
デーモンのMCPエンドポイントに直接HTTPで tools/call を投げた場合の応答は0.03秒だった。CLI経由の1秒前後はほぼNodeプロセスの起動コストで、常時つなぎっぱなしのエージェントから使う分にはそれも掛からない。
# 共有デーモンを立てる(CLIとエージェントで索引とモデルを共有する)
zg server on
# → Server: ready / URL: http://127.0.0.1:7999/mcp / MCP toolset: agent
zvec-grepを日本語で使うなら埋め込みモデルの選択がいちばん効く
zg help models が列挙する埋め込みモデルは、ローカル11種・リモート3種だった(v0.2.1・実行して確認)。
| モデル | 実行 | 次元 | 最大トークン | バックエンド |
|---|---|---|---|---|
local/potion-retrieval-32m |
ローカル | 512 | 1,024 | model2vec |
local/potion-multilingual-128m |
ローカル | 256 | 1,024 | model2vec |
local/multilingual-e5-small |
ローカル | 384 | 512 | transformers-js |
local/jina-embeddings-v2-base-code |
ローカル | 768 | 8,192 | transformers-js |
local/qwen3-embedding-0.6b |
ローカル | 1,024 | 8,192 | llama-cpp |
local/embeddinggemma-300m |
ローカル | 768 | 2,048 | llama-cpp |
qwen/qwen3.7-text-embedding |
リモート | 1,024 | 128,000 | qwen |
qwen/qwen3-vl-embedding |
リモート | 2,560 | 32,000 | qwen(画像入力可) |
この記事の計測で使った local/potion-retrieval-32m は、名前のとおり多言語向けではない。それでも日本語のクエリは通ったが、日本語のドキュメントを本気で引くなら local/potion-multilingual-128m か local/multilingual-e5-small を明示的に選ぶほうが素直だ。READMEのクイックスタートが potion-retrieval-32m を例示しているため、何も考えずに写すと英語向けモデルで日本語の索引ができあがる。
# 日本語コーパスなら多言語モデルを明示する
zg index --embedding local/potion-multilingual-128m

# 既定モデルを設定として固定する(--device metal で Apple GPU を使う)
zg config model set local/potion-multilingual-128m --device metal
公式ヘルプは「Existing indexes keep their stored model」と明記している。つまり後からモデルだけ差し替えることはできず、作り直しになる。前節のとおり日本語93ファイルで20分50秒かかる作業なので、モデルの選択は索引を作る前に済ませておきたい。リモートモデル(Qwen系)は認証情報に加えて
--allow-remote か明示的なワークスペース認可が要るので、うっかり外に出る作りにはなっていない。
MCPサーバーとしての常駐コスト:既定なら1ツール2,416トークン
zg server --stdio でMCPサーバーになる。zg install --target claude などでエージェント側の設定も書き込める(対応先は codex / claude / qwen / qoder / opencode / cursor)。
MCPサーバーは、ツールを1つも呼ばなくても接続しているだけで tools/list のツール定義がコンテキストに常駐する。当サイトが同じ物差しで測っている値と並べると次のようになった。
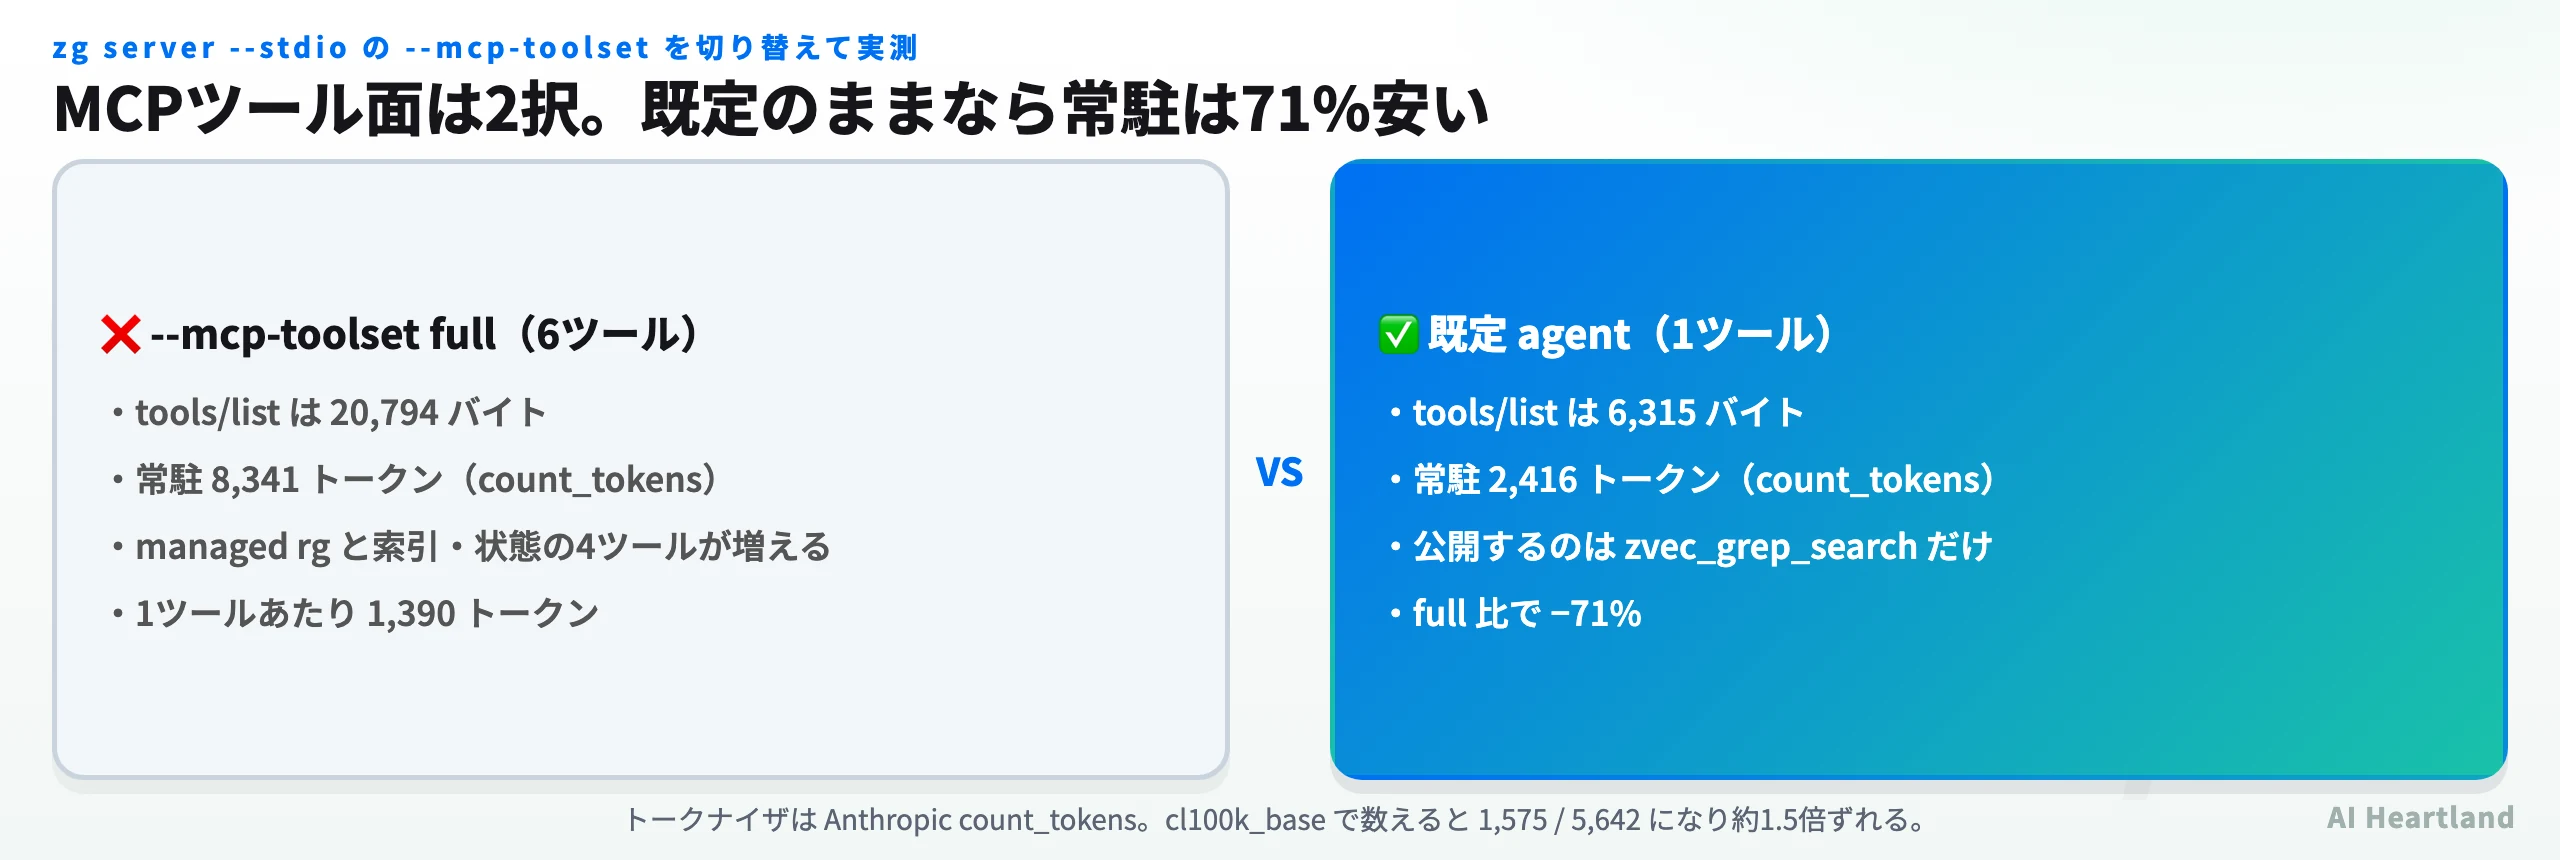
zg server --stdio に --mcp-toolset を渡して実測。デーモンはツールセット単位のシングルトンで、別の設定で起動しようとすると「すでに agent で動いている」と拒否される。| サーバー | 版 | ツール数 | バイト | トークン | 1ツールあたり |
|---|---|---|---|---|---|
| Notion MCP (local) | 2.5.1 | 24 | 81,951 | 33,459 | 1,394 |
| Backlog MCP | 0.18.0 | 62 | 42,363 | 16,555 | 267 |
| Supabase MCP (local) | 0.11.0 | 29 | 22,117 | 8,585 | 296 |
zvec-grep(--mcp-toolset full) |
0.2.1 | 6 | 20,794 | 8,341 | 1,390 |
| Chrome DevTools MCP | 1.8.0 | 29 | 25,806 | 6,561 | 311 |
zvec-grep(既定 agent) |
0.2.1 | 1 | 6,315 | 2,416 | 2,416 |
| Microsoft Learn MCP | remote | 3 | 5,012 | 1,810 | 603 |
トークナイザは Anthropic の count_tokens で統一している。同じ入力を cl100k_base(tiktoken)で数えると 2,416 → 1,575、8,341 → 5,642 になり、約1.5倍ずれる。トークン数を比較する記事を読むときは、必ずトークナイザ名が書かれているか確認したほうがよい。
既定の agent ツールセットが公開するのは zvec_grep_search の1つだけで、--mcp-toolset full にすると managed ripgrep と索引・状態系の4ツールが加わって6ツール・8,341トークンになる。差は −71%。「エージェントには検索さえできればよい」なら既定のまま触らないのが正解で、索引の作り直しまでエージェントにやらせたいときだけ full にする、という切り分けになる。
なお serverInfo は {"name":"zvec-grep","version":"0.2.1"} を返し、CLIの zg --version と一致していた。npm の最新は 0.2.1 だが、GitHub Releases の最新タグは v0.2.0(2026-08-27)で、パッケージ側が半歩先に出ている点は把握しておきたい。
READMEのベンチマークをどう読むか(この記事では再現していない)
READMEには2種類のベンチマークが載っている。ここは自分では再現していないので、何が主張されていて何が確かめられていないかだけを整理しておく。
| ベンチマーク | 使用エージェント/モデル | 主張されている効果 | この記事での検証 |
|---|---|---|---|
| SWE-QA-Bench(コード理解) | Claude Code + Claude Opus 5(high reasoning) | 回答品質の向上、入力トークン・ツール呼び出し・所要時間の削減 | 未検証 |
| BrowseComp-Plus(一般テキスト検索) | Codex gpt-5.6-sol(medium reasoning) | 同上 | 未検証 |
| 実リポジトリ3件(Pylint / Matplotlib / Django) | 同上 | Judge スコア・トークン・ツール呼び出し・実時間で改善 | 未検証 |
いずれも開発元自身によるA/Bで、「タスク・エージェント・プロンプト・環境・上限を固定し、zgへのアクセスと使用ガイダンスだけを変えた」と明記されている。方法論として不誠実な書き方はしていないが、「zgを使ってよい」と伝えたエージェントと、伝えていないエージェントの比較であって、他の検索手段(素のripgrep+手動での絞り込み等)との比較ではない点は読み分けが要る。ベンチマークで使われている埋め込みは両プロファイルとも Qwen3.7 Text Embedding(リモートモデル)で、この記事が使ったローカルの potion-retrieval-32m とは条件が違う。
再現には Claude Opus 5 や Codex を回すAPI費用と、リモート埋め込みの認証情報が要る。手元での再現は今回のスコープに入れていないので、「効果があった」も「無かった」も本記事は主張しない。
何に向いていて、何に向いていないか
実測を踏まえた向き不向きを整理する。
| 使い方 | 判定 | 理由(実測に基づく) |
|---|---|---|
| エージェントに社内ドキュメントを引かせる | ◎ | MCP常駐2,416トークンで済み、HTTP経由の検索応答は0.03秒 |
| 外部にデータを出せない環境での検索 | ◎ | 全proxyを閉じても終了コード0で結果が返ることを実測 |
| 語が思い出せないコード・記事の探索 | ○ | matchedBy=fts+vector で当たり方が見えるので誤爆を判別できる |
| 大量ファイルの初回索引をCIで毎回作る | ✕ | 日本語93ファイルで20分50秒。使い捨て環境には重すぎる |
grep の日常的な置き換え |
△ | 落ち着いた状態でも1回1秒前後。rg の数十ミリ秒とは体感が違う |
| 埋め込みを外部に出したくない環境 | ◎ | 既定でローカル実行。リモート埋め込みは明示許可が要る |
| ディスクに余裕がないマシン | △ | node_modules だけで568MB、索引が別途数十MB |
設置サイズが気になるなら、埋め込みそのものを保存しない設計のLEANN徹底解説|埋め込みを保存しないローカルRAGで最大97%省ストレージ|仕組み・使い方・実測が対極にある。逆に索引をサーバー側のデータベースに寄せるならベクトルデータベース比較2026|Qdrant・Milvus・pgvectorをRAG用途で選ぶ完全ガイドの選択肢になる。なお zvec-grep が内部でベクトルストアとして使っている本体(package.json の依存に @zvec/zvec が入っている)そのものを自分のアプリに組み込みたい場合は、zvecとは|Alibaba製インプロセスベクトルDBを実測。索引が作られない罠と日本語FTSの初期設定で実測している。zvec-grepはそのどちらでもなく、既存の grep の使い勝手を保ったまま意味検索の層だけを足す位置にいる。
①小さいディレクトリ(数十ファイル)でまず
zg index を回して所要時間の体感を掴む②
zg server on を先に立ててから ZVEC_GREP_MODE=server で叩く(起動コストが半分になる)③エージェントに繋ぐなら
--mcp-toolset は既定のままにする④索引は対象ディレクトリ直下の
.zvec-grep/ に出るので .gitignore に足しておく
まとめ:zvec-grepは20分の索引に見合う探索をするかどうかで決まる
zvec-grepは「速い検索」ではなく「探し方を選ばなくていい検索」を作ろうとしている。ripgrepで当たるものはripgrepで、当たらないものはBM25とベクトルで、という切り替えを利用者から隠し、当たった経路だけは結果に明示する。この設計は、検索結果をそのままエージェントに食わせる用途と相性がいい。
一方で実測が示したコストは小さくない。設置568MB、日本語93ファイルの索引に20分50秒。逆に検索そのものは1秒前後で、ここは当初の測定(13〜25秒)が誤りだった。払うのは「置く場所」と「最初の20分」であって、日々の待ち時間ではない。この2つを払ってでも「語を思い出せないまま探す」場面が日常的にあるかどうかが、導入判断の実質になる。
なお本記事の数値はすべて macOS 14.5 / M2 MacBook Air 16GB / Node v22.13.1 での1台の実測であり、SSDとCPUの速いマシンでは索引時間は縮む。絶対値ではなく「オーダーとして分単位か秒単位か」の目安として読んでほしい。 上に書いたとおり、同じマシンでも測るタイミングで1桁変わることがある。