製造ラインで「この部品、微妙に傷がついていないか?」を人の目で1つずつ確かめる作業は、2026年になっても多くの工場で続いている。anomalib(アノマリブ)は、この異常検知をAIで自動化するためのオープンソースライブラリだ。
WHAT IT REPLACES何を代替するか
不良品を集めなくても、正常画像だけで異常検知が組める
従来の外観検査
ルールベース・論文ごとの実装
- 閾値と輪郭抽出を手で調整
- 異常のサンプルを大量に集める
- 論文ごとに別リポジトリ
anomalib
統一API・Apache 2.0
- 正常画像だけで学習外れたものをピクセル単位で検出
- モデルは1行で差し替え画像30種+動画2種
- OpenVINO で CPU 推論GPU なしのエッジPCで回る
30秒でわかる anomalib
- ・何ができる:正常画像だけを学習し、傷・汚れ・欠け・変形など「正常から外れたもの」を画像・動画からピクセル単位で検出する
- ・何を解決:不良品サンプルが集まらない現場でも異常検知AIを組める(教師あり分類では代替できない)
- ・何を代替:ルールベースの画像処理検査/論文ごとの個別実装/商用外観検査ソフトの一部用途/GPU前提の重い推論(OpenVINOでCPU化)
- ・3行で動く:
pip install anomalib→Patchcore()→engine.fit()。CLI とノーコードの Anomalib Studio も同梱
anomalibは検査ワークフローを自動化する部品として使われることが多い。検査を人手からエージェント的な自動処理に置き換える文脈では AIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証 も参考になる。
anomalibとは — 正常データだけで学習する異常検知ライブラリ
anomalibは、Intel系の open-edge-platform チーム(旧OpenVINOチーム)が開発する異常検知(Anomaly Detection)ライブラリだ。学術論文の画像・動画向けアルゴリズムを「すぐ使える実装」として集め、ベンチマーク・開発・デプロイまでを1つのAPIで扱える。
下の画像が、anomalibが出す「答え」だ。左からプリント基板の入力画像、正解マスク、異常ヒートマップ、予測した異常領域、元画像への重ね合わせ。どこがどれだけ異常かをピクセル単位で示す。
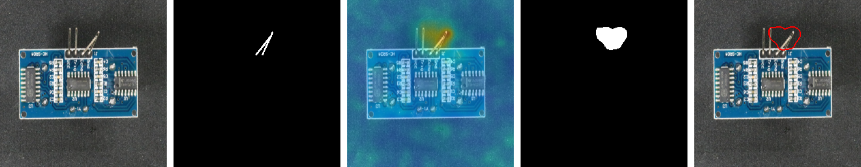
最大の特徴は「正常データだけで学習できる」点だ。製造業では不良品のデータを大量に集めるのが難しい。anomalibのアルゴリズムは正常パターンを学習し、そこから外れたものを異常として検出するので、不良品のサンプルが1枚もなくてもモデルを組める。
| 項目 | 内容 |
|---|---|
| リポジトリ | open-edge-platform/anomalib(旧 openvinotoolkit/anomalib から移管・旧URLは自動リダイレクト) |
| スター | 5,991(2026年7月30日時点) |
| ライセンス | Apache 2.0(商用利用可) |
| 依存 | PyTorch 2.6+、PyTorch Lightning 2.2+、OpenVINO 2024.0+ |
| 対応環境 | CPU、CUDA、ROCm、Intel XPU |
| 対応モデル | 画像30種+動画2種(src/anomalib/models/ 実測) |
| 最新バージョン | lib/v2.6.0(2026年7月25日リリース) |
v2.5.0では INP-Former(正常プロトタイプによる汎用異常検知)、GLASS(異常サンプル合成で局在化精度を上げる手法)、AnomalyVFM(Vision Foundation Modelによるゼロショット異常検知)、CFM(クロスモーダル特徴マッピングによる3D異常検知)の4モデルが追加された。
インストールと初回実行 — 3行のPythonで異常検知が動く
anomalibはPyPIから入る。
# uv(高速)または pip でインストール
uv pip install anomalib
# もしくは
pip install anomalib
ハードウェアに合わせて「extra」を付けると依存が最適化される。複数指定もでき、uv pip install "anomalib[openvino,cu130]" ならOpenVINO推論とCUDA学習を両立できる。
| extra 指定 | 用途 |
|---|---|
anomalib[cpu] |
CPUのみ(全プラットフォーム・デフォルト) |
anomalib[cu130] |
NVIDIA GPU(CUDA 13.0) |
anomalib[rocm] |
AMD GPU(ROCm・Linux) |
anomalib[xpu] |
Intel GPU(XPU・Linux) |
anomalib[openvino] |
Intel CPUでの推論高速化 |
anomalib[full] |
すべてのオプション依存 |
公式READMEどおりの最小コードで学習と推論が走る。製造業向けベンチマークの MVTecAD(ボトル・ケーブル・カプセルなど15カテゴリ)は初回実行時に自動ダウンロードされるので、データ準備は要らない。
from anomalib.data import MVTecAD
from anomalib.models import Patchcore
from anomalib.engine import Engine

datamodule = MVTecAD()      # ベンチマークデータ(初回に自動DL)
model = Patchcore()         # 使うアルゴリズム
engine = Engine()

engine.fit(datamodule=datamodule, model=model)              # 学習
predictions = engine.predict(datamodule=datamodule, model=model,
                             ckpt_path="path/to/model.ckpt")  # 推論
Patchcore() を Stfpm() や Padim() に差し替えるだけで別アルゴリズムに切り替わる。比較実験のコストが低いのが設計思想だ。Pythonを書かずにCLIでも同じことができる。
# 学習(カテゴリ指定も可能)
anomalib train --model Patchcore --data anomalib.data.MVTecAD --data.category transistor

# 推論
anomalib predict --model anomalib.models.Patchcore \
                 --data anomalib.data.MVTecAD \
                 --ckpt_path path/to/model.ckpt
Patchcore・STFPM・PaDiMの選び方 — 32モデルから何を選ぶか
リポジトリの src/anomalib/models/ を数えると、画像向け30種・動画向け2種の計32種が実装されている(2026年7月30日時点・README.md と __init__.py を除いた実ディレクトリ数)。手元の環境で一覧を出すには次を実行する。
python -c "import anomalib.models as m; print(len(m.__all__)); print(sorted(m.__all__))"
まずは定番の違いを押さえれば足りる。
| アルゴリズム | 方式 | 精度傾向 | 推論速度 | メモリ | 向いているケース |
|---|---|---|---|---|---|
| Patchcore | メモリバンク型 | 最高水準 | 中 | 大 | 精度最優先。正常データが十分にある |
| STFPM | 生徒-教師蒸留型 | 高 | 高速 | 小 | リアルタイム推論・エッジデバイス |
| PaDiM | 確率分布型 | 高 | 高速 | 中 | バランス型。最初の選択肢 |
| EfficientAd | 軽量特徴型 | 高 | 最速 | 小 | ライン速度に追従したい高速検査 |
| AnomalyVFM | ゼロショット | 中〜高 | 中 | 中 | 学習データを用意できない・試作段階 |
WHERE TO STARTモデルの選び方
32種に迷ったら、4方向の分岐だけ覚えておく
状況
選ぶモデル
状況: まず動く状態を作る
選ぶモデル: PaDiM / EfficientAd
状況: 精度が足りない
選ぶモデル: Patchcore
状況: 速度が足りない・エッジで動かす
選ぶモデル: STFPM
状況: 学習データがまだ無い
選ぶモデル: AnomalyVFM / WinCLIP
v2.5.0の AnomalyVFM や anomalib[clip] の WinCLIP は、正常画像すら用意せずに動く「ゼロショット」モデルだ。汎用の視覚基盤モデルの知識を流用するため、データ収集がこれからの立ち上げ段階で使える。精度は専用学習した Patchcore 等に劣る。
32種を方式ごとに分けると次のとおり。論文名がそのままクラス名になっており、各モデルディレクトリの README.md に元論文へのリンクがある。
| 系統 | モデル |
|---|---|
| メモリバンク型 | Patchcore、DFKDE、DFM |
| 蒸留・生徒教師型 | STFPM、Reverse Distillation、UniNet |
| 正規化フロー型 | FastFlow、CFlow、CS-Flow、U-Flow、PatchFlow |
| 確率分布型 | PaDiM、CFA |
| 再構成型 | DRAEM、DSR、GANomaly、FRE |
| 合成異常型 | GLASS、SuperSimpleNet、SuperADD |
| 基盤モデル/ゼロショット | AnomalyVFM、WinCLIP、VLM-AD、Dinomaly、AnomalyDINO、INP-Former |
| 3D/クロスモーダル | CFM |
| 動画 | AI-VAD、FUVAS |
| 汎用 | General AD、EfficientAd、L2BT |
v2.6.0へのアップグレード — 追加された1モデルと、消えた4つのAPI
anomalibは2026年7月25日に lib/v2.6.0 をリリースした。直前の v2.5.1(7月17日)から8日で、機能追加と同時に非推奨APIの削除が入っている。
追加されたのは、VAND 4.0(CVPRワークショップの異常検知チャレンジ)の優勝手法 SuperADD(anomalib.models.image.super_add)と、自動車部品の外観検査用データセット AutoVI(anomalib.data)だ。
| 対象 | 消えたAPI | 代替 |
|---|---|---|
| data | Kaputt の use_reference / reference_only |
image_mode=ImageMode.* |
| data | Kaputt の category='all' 疑似カテゴリ |
category=None または具体カテゴリ(既定は book_other) |
| metric | AUPRO のコンストラクタ引数 num_thresholds |
引数なしで構築 |
| utils | resolve_with_warning / _is_legacy_default_root |
resolve_dataset_root |
Kaputt datamodule の既定 category も all から book_other に変わった。カテゴリを明示していないスクリプトは、読み込むデータそのものが変わる。更新前に grep で当たりを付けられる。
grep -rnE "use_reference|reference_only|category=['\"]all['\"]|num_thresholds|resolve_with_warning" . --include="*.py" --include="*.yaml"
v2.6.0 にはパストラバーサルの修正(PR #3686)と、Dependabot アラート解消のための torch 引き上げ(PR #3681)も含まれる。上の破壊的変更に当たらない環境は上げてよい。
Anomalib StudioとOpenVINOデプロイ — コードなしの検査とCPU推論
Anomalib Studio は、ブラウザ上でデータのアップロード・学習・推論・デプロイまでを完結できるノーコード/ローコードのWebアプリだ。

画像フォルダのアップロードとUSBカメラ・IPカメラの接続に対応し、Patchcore/STFPM/PaDiM 等をUIで選んで「Train model」で学習する。Anomaly Map のトグルでヒートマップを表示し、推論デバイス(CPU/GPU)はプルダウンで切り替える。結果はROSメッセージ・MQTT等で製造ラインへ送れる。配布は Dockerコンテナ版 と スタンドアロン版。開発ビルドはバックエンド(uv sync)とフロントエンド(npm install)を起動して http://localhost:3000 を開く。ソースはリポジトリの application/ 配下にある。
本番では OpenVINO 形式への書き出しが効く。CLIなら anomalib export、Python APIなら engine.export() で IR(中間表現)を生成し、推論には OpenVINOInferencer を使う。GPUのないエッジPCで検査が回り、ネットワークなしでも動くので、データを外に出せない工場・防衛関連で利点になる。
TRAIN TO DEPLOY学習から本番まで
精度が出るまで回し、合格したらOpenVINO に書き出して配る
-
正常画像
50枚以上・本番と同じ照明
-
学習
anomalib train
-
評価
predict。不足ならデータ追加
-
書き出し
anomalib export で OpenVINO へ
-
配置
エッジPC・バッチ・APIサーバー
| 推論構成 | 相対速度 | 相対メモリ | 位置づけ |
|---|---|---|---|
| PyTorch(GPU) | 速い | 大 | 学習・実験フェーズ |
| PyTorch(CPU) | 遅い | 中 | GPUなし環境のベースライン |
| OpenVINO(CPU) | 速い | 小 | Intel CPUで加速。本番エッジ向け |
| OpenVINO + INT8量子化(CPU) | 最速 | 最小 | エッジ最適化。精度への影響は要検証 |
上表は相対的な傾向で、公式は絶対的な推論時間を保証していない。モデル・画像サイズ・CPU世代・バッチサイズで変わるので、導入前に自環境で計測する。配置先は、カメラ→エッジPC→アラートのエッジPC型、1日分をフォルダ単位で推論するバッチ処理型、FastAPI等で複数ラインを集約するAPIサーバー型の3つにおおむね集約される。
自社データでの活用と、導入前に知るべき限界
MVTecADで動いたら自社データだ。Folder データモジュールに次の構成で画像を置けば学習できる。異常画像フォルダは省略でき、正常画像だけでも学習が始められる。
data/my_product/
├── train/
│   └── normal/          # 正常画像(学習用)50枚以上推奨
├── test/
│   ├── normal/          # 正常画像(テスト用)
│   └── abnormal/        # 異常画像(テスト用・オプション)
└── ground_truth/
    └── abnormal/        # 異常箇所のマスク画像(Pixel精度評価用・オプション)
正常画像は最低50枚、理想は200〜500枚。照明・角度・背景のバリエーションを含め、本番と同じ条件で撮るのが最も効く。画像サイズは自動リサイズされる。異常画像があれば精度評価(AUROC)に使え、ground_truth は「どこが異常か」のピクセル評価にだけ要る。
用途別の始め方の目安は次のとおり(検出率は一般的な傾向で、実測は自データで確かめる)。
| 業務シナリオ | 推奨アルゴリズム | 学習画像枚数 | 推論ハード | 留意点 |
|---|---|---|---|---|
| 製造ラインの外観検査(ボトル・ネジ等) | Patchcore | 200〜500枚 | CPU+OpenVINO | 照明条件を本番と揃える |
| プリント基板の半田不良 | STFPM | 1,000枚〜 | GPU推奨 | カラーチャネル正規化 |
| 監視カメラ映像の異常行動 | 動画対応モデル+前処理 | 100クリップ〜 | GPU必須 | 動体検出と組合せ |
| 医療画像の病変検出 | PaDiM | 数千枚〜 | GPU推奨 | クラス別の閾値調整必須 |
| インフラ点検(ドローン空撮) | Patchcore | 300枚〜 | エッジCPU | 距離・スケール正規化が鍵 |
工場のエッジPCなら、PatchcoreをOpenVINO INT8で量子化する組み合わせがコスト・速度・精度の釣り合いで現実的だ。チューニングはハイパーパラメータ最適化(HPO)が内蔵され、anomalib hpo --backend WANDB --sweep_config tools/hpo/configs/wandb.yaml の形で W&B や Comet.ml と連携して探索できる。手で触るなら最も効くのは backbone で、wide_resnet50_2 は精度が高く重い、resnet18 は軽いが精度が下がる。Patchcore では coreset_sampling_ratio(0.01〜0.1)と num_neighbors(3〜15)、入力の image_size(224 / 256 / 384)も効く。
画像の異常検知で他のライブラリと比べると、守備範囲がはっきり分かれる。
| 項目 | anomalib | PyOD | scikit-learn |
|---|---|---|---|
| 対象データ | 画像・動画 | テーブルデータ | テーブルデータ |
| 手法 | 深層学習(CNN/VFM) | 統計・浅い学習 | 統計・浅い学習 |
| アルゴリズム数 | 十数種(画像特化) | 50以上(テーブル特化) | Isolation Forest等 |
| GPU対応 | CUDA / ROCm / XPU | 一部 | なし |
| デプロイ | OpenVINO / ONNX | なし | joblib |
| ノーコード | Studio あり | なし | なし |
| ライセンス | Apache 2.0 | BSD-2 | BSD-3 |
数値・ログのようなテーブルデータならPyODやscikit-learnのIsolation Forestが向く。クラウド型の商用検査AIと比べると、anomalibは無料でデータが自社に残る代わりに、Python の知識とセットアップの手間が要る。
導入前に押さえる限界
- ・正常の定義が曖昧だとモデルが混乱する。正常品の基準を決めてから集める
- ・照明・背景の変化に弱い。学習データに環境のバリエーションを含める
- ・ごく小さな欠陥は検出しにくい。高解像度カメラと拡大撮影で補う
- ・偽陽性が出る。閾値調整と人のレビューを併用し、想定外の異常には定期的な再学習で備える
異常検知AIは検査員を置き換えるものではなく、見落としを補うものとして入れるのが安定する。最終判断は人が行い、AIは「ここが怪しい」と知らせる役に徹する。
画像をAIに「解釈」させる方向では DeepEyesV2を徹底解説|コード実行×ウェブ検索×画像理解を統合するエージェント型マルチモーダルAI が詳しい。anomalibが「正常からの逸脱」を測るのに対し、あちらは画像の内容を言語で説明させる。画面の見た目を機械に判定させる点では ProofShot徹底解説|AIが書いたUIを動画で自動検証するCLIツールの使い方 も同じ系譜で、外観検査とUIの回帰検証は「正解画像との差分をどう定義するか」という課題を共有している。