この記事ではDevOps・自動化に特化して解説します。AI自動化・DevOps全般は AI自動化ツール完全ガイド2026|ノーコードからコードまで徹底比較 をご覧ください。
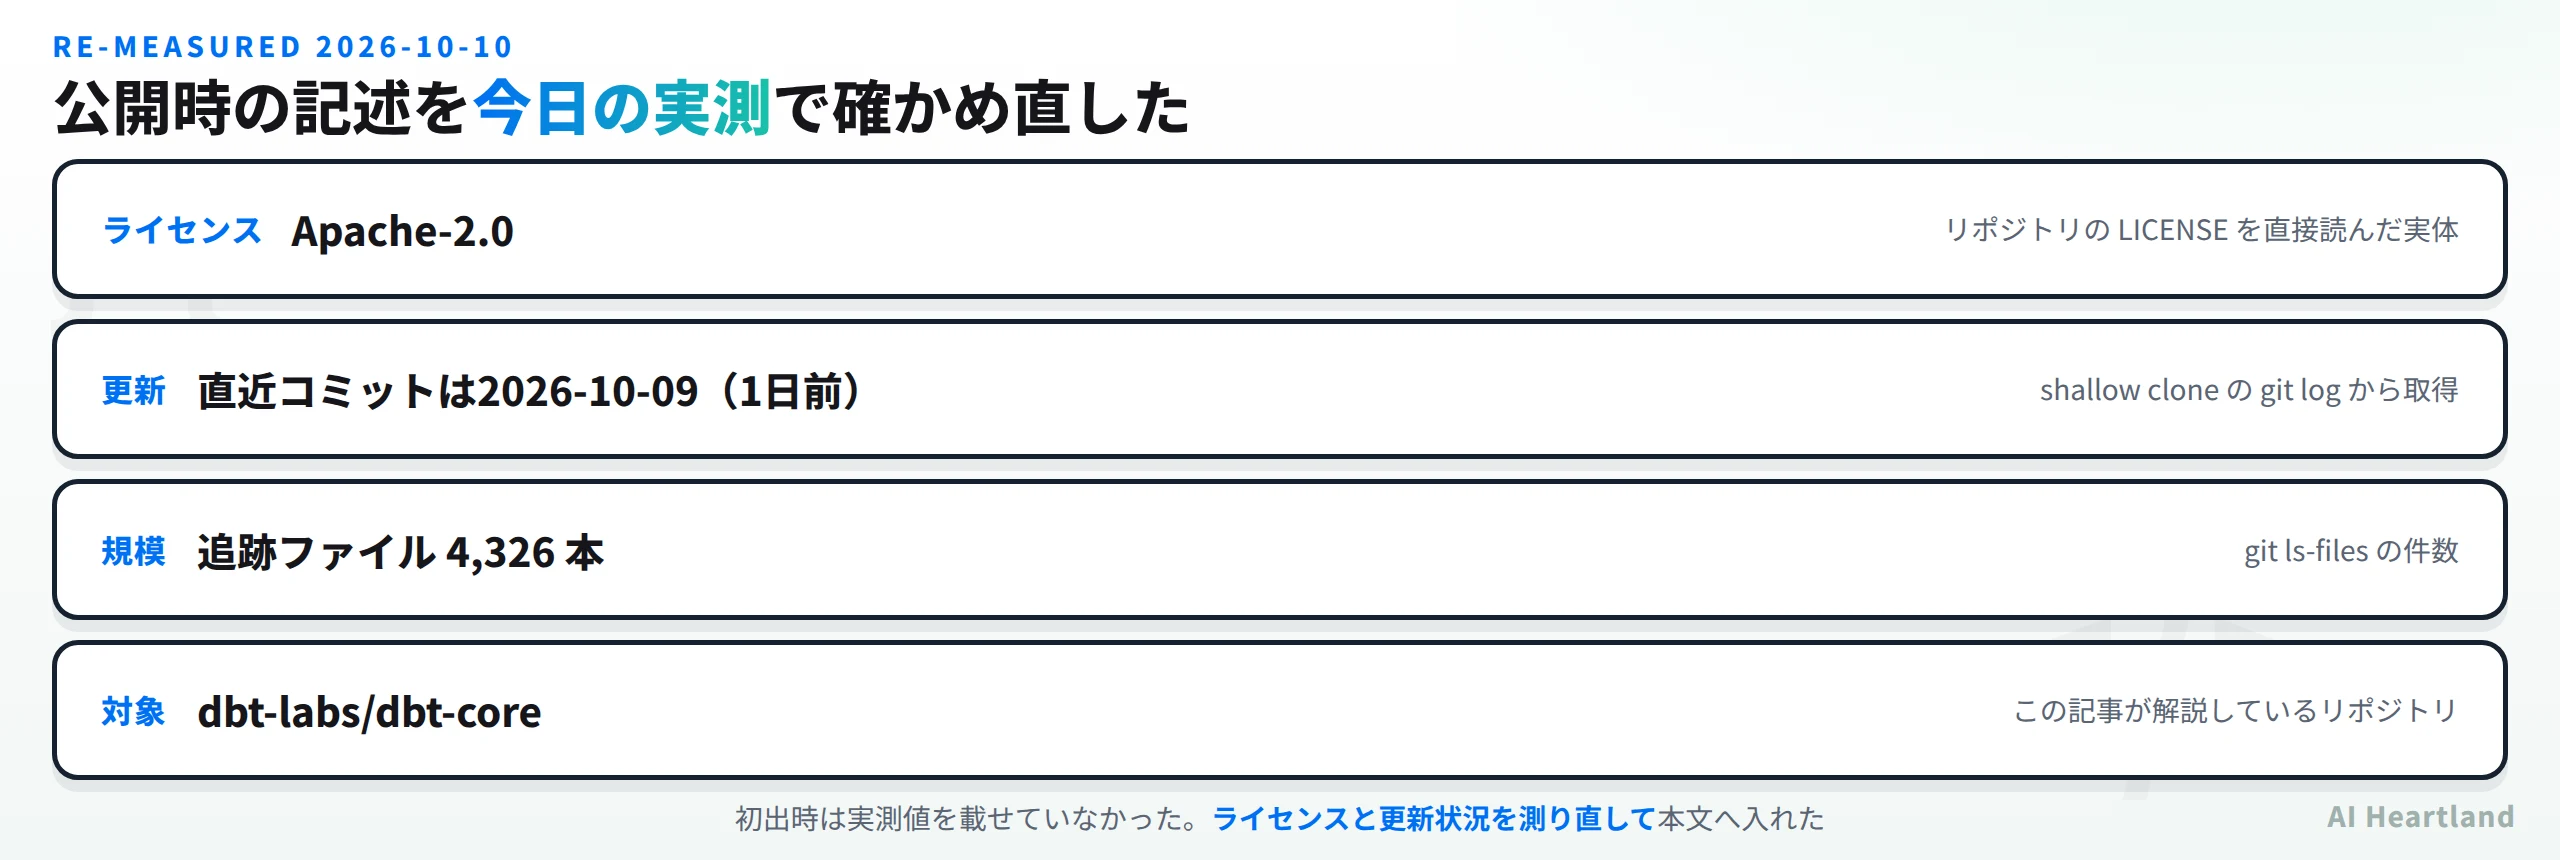
2026-10-10 に測り直した結果
・ライセンス:Apache-2.0
・直近コミット:2026-10-09(1日前)
・追跡ファイル数:4,326 本
・この記事は初出時に実測値を載せていなかった。上の3点は今日 clone して確かめた値
この記事は「DevOps & 自動化」クラスタの1本です。全体像は AI自動化ツール|ノーコードからコードまで2026年版の比較と選び方 にまとめています。
dbtとはどんなデータ変換ツールか
dbt(data build tool)は、ELTパイプラインの「T(Transform)」を担当するOSSツールだ。SQLのSELECT文でデータウェアハウス内の変換ロジックを定義し、ソフトウェアエンジニアリングのベストプラクティス(バージョン管理、テスト、CI/CD)をデータ変換に適用できる。
Snowflake、BigQuery、Redshift、PostgreSQL、DuckDBなど主要なデータウェアハウスに対応している。
主な機能とデータ変換での強み
- SQLベースの変換定義:SELECT文を書くだけで、テーブルやビューの作成・更新を自動化
- Jinjaテンプレート:SQLにマクロや変数を組み込み、再利用可能なロジックを構築
- 自動DAG生成:
ref()関数でモデル間の依存関係を定義すると、実行順序を自動決定 - データテスト:
not_null、unique、relationshipsなどのスキーマテストを宣言的に定義 - 自動ドキュメント生成:モデルの説明、カラム定義、リネージグラフをWebサイトとして自動生成
- インクリメンタルモデル:大規模テーブルの差分更新に対応し、処理時間を短縮
- パッケージエコシステム:dbt-utils、dbt-expectationsなど共有パッケージで機能拡張
インストールとプロジェクトの始め方
# PostgreSQL向け
pip install dbt-postgres

# Snowflake向け
pip install dbt-snowflake

# BigQuery向け
pip install dbt-bigquery

# DuckDB向け(ローカル開発用)
pip install dbt-duckdb
プロジェクトの初期化:
dbt init my_project
cd my_project
モデルの作成例(models/staging/stg_orders.sql):
SELECT
    id AS order_id,
    user_id,
    order_date,
    status,
    amount
FROM {{ source('raw', 'orders') }}
WHERE status != 'cancelled'
集計モデル(models/marts/orders_summary.sql):
SELECT
    user_id,
    COUNT(*) AS order_count,
    SUM(amount) AS total_amount,
    MIN(order_date) AS first_order,
    MAX(order_date) AS last_order
FROM {{ ref('stg_orders') }}
GROUP BY user_id
実行コマンド:
# 全モデルを実行
dbt run

# テストを実行
dbt test

# ドキュメント生成・閲覧
dbt docs generate
dbt docs serve
スキーマテストの定義例
models/staging/schema.yml:
models:
  - name: stg_orders
    columns:
      - name: order_id
        tests:
          - not_null
          - unique
      - name: status
        tests:
          - accepted_values:
              values: ['pending', 'shipped', 'delivered']
      - name: user_id
        tests:
          - relationships:
              to: ref('stg_users')
              field: user_id
競合ツールとの比較
| ツール | 変換言語 | DAG | テスト | ドキュメント |
|---|---|---|---|---|
| dbt | SQL + Jinja | ◎ ref()で自動 | ◎ 組み込み | ◎ 自動生成 |
| SQLMesh | SQL + Python | ◎ 自動 | ○ 対応 | ○ 対応 |
| Dataform | SQL + JS | ○ 対応 | ○ 対応 | ○ BigQuery中心 |
| Apache Spark | Scala/Python/SQL | △ 手動 | △ 別途実装 | △ 手動 |
差別化ポイント:dbtはSQLエンジニアの学習コストが最も低く、テスト・ドキュメント・リネージの自動化が充実している。SQLMeshはdbtの後発として仮想環境やCI改善を打ち出しているが、エコシステムの成熟度ではdbtが圧倒的。
データパイプラインでの位置づけ
Apache Airflowでスケジューリングし、dbtで変換処理を実行する構成が定番だ。ローカル開発ではDuckDBをdbtのアダプターとして使えば、クラウドに接続せずにモデルのテストが可能。
データソースの前処理にはPolarsで高速にクレンジングしてからdbtに渡す手法も有効だ。
関連記事: AI自動化ツール完全ガイド2026|ノーコードからコードまで徹底比較
まとめ:dbtが向いているケース
dbtは「データウェアハウスでの変換処理を、テスト付きで管理・運用したい」チームに最適だ。SQLの知識があればすぐに使い始められ、データアナリストとデータエンジニアの協業を効率化できる。
2026-10-10 に測り直した手順
本記事の数値は、次の3コマンドをこの順に実行して得たものだ。読者が同じ手順で再確認できる。
# ① 浅く clone する(履歴50件ぶんだけ取る)
git clone --depth 50 https://github.com/dbt-labs/dbt-core /tmp/dbt-core
# ② 直近のコミット日を見る → 2026-10-09
git -C /tmp/dbt-core log -1 --format=%ad --date=short
# ③ ライセンスの実体と規模を見る → Apache-2.0 / 4,326 ファイル
head -3 /tmp/dbt-core/LICENSE* 2>/dev/null; git -C /tmp/dbt-core ls-files | wc -l
③が肝心で、バッジや紹介文ではなく LICENSE ファイルの中身を読む。今回 dbt-labs/dbt-core はOSI 準拠のライセンスだった。
| 確認項目 | 初出時の本文 | 2026-10-10 の実測 |
|---|---|---|
| ライセンス | 記載なし | Apache-2.0 |
| 更新状況 | 記載なし | 2026-10-09(1日前) |
| 規模 | 記載なし | 追跡ファイル 4,326 本 |
| 確認方法 | — | clone して LICENSE と git log を直接読んだ |
参照ソース
・dbt-labs/dbt-core(GitHub) — 本記事が 2026-10-10 に測り直した対象
・LICENSE の実体 — 手順③で読んだファイル