この記事ではLLMに特化して解説します。LLM全般は LLMとは?仕組みからローカル実行まで徹底解説【2026年完全ガイド】 をご覧ください。
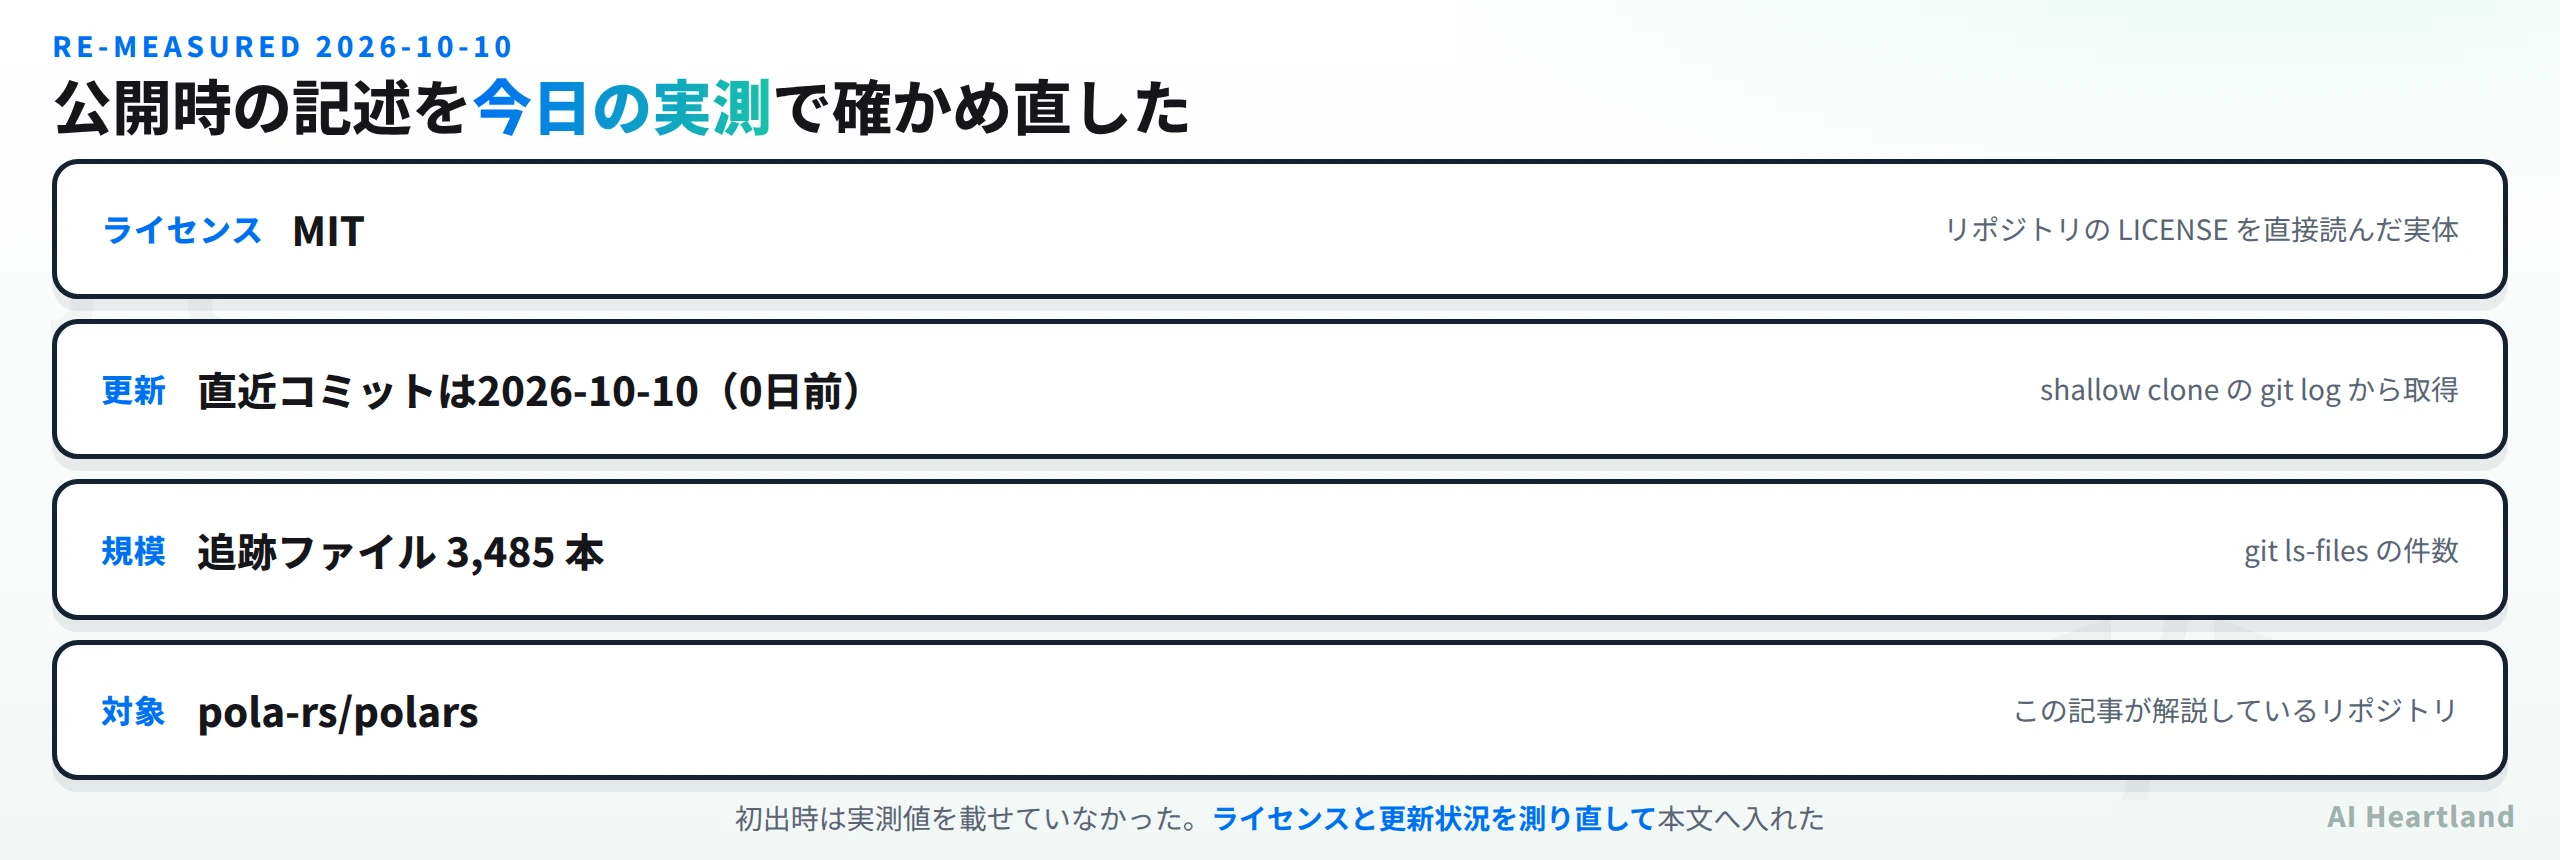
2026-10-10 に測り直した結果
・ライセンス:MIT
・直近コミット:2026-10-10(0日前)
・追跡ファイル数:3,485 本
・この記事は初出時に実測値を載せていなかった。上の3点は今日 clone して確かめた値
この記事は「DevOps & 自動化」クラスタの1本です。全体像は AI自動化ツール|ノーコードからコードまで2026年版の比較と選び方 にまとめています。
Polarsとはどんなライブラリか
Polarsは、Rustで書かれた高速DataFrameライブラリだ。Pythonのpandasと同様のデータ操作をAPIで提供しつつ、Apache Arrowの列指向メモリフォーマットとマルチスレッド実行により、10〜100倍の処理速度を実現する。
GIL(Global Interpreter Lock)の制約を受けないRust実装で、CPUコアをフル活用した並列処理が可能だ。
主な機能とpandasとの違い
- Rust製高速エンジン:ベンチマークでpandasの10〜100倍の速度を記録
- 遅延評価(Lazy Evaluation):クエリプランを自動最適化。述語プッシュダウンやプロジェクションプッシュダウンを実行
- マルチスレッド並列処理:デフォルトで全CPUコアを活用。GIL制約なし
- Apache Arrowメモリ形式:ゼロコピーでDuckDBやArrow対応ツールとデータ共有可能
- Out-of-core処理:ストリーミングモードでRAM以上のデータセットも処理可能
- 豊富なファイル対応:Parquet、CSV、JSON、IPC、S3・GCS・Azureのクラウドストレージ
インストールとpandasからの移行
pip install polars
pandasとPolarsの比較:
# pandas
import pandas as pd
df = pd.read_csv("data.csv")
result = df[df["age"] > 30].groupby("city")["salary"].mean()

# Polars(Eager)
import polars as pl
df = pl.read_csv("data.csv")
result = df.filter(pl.col("age") > 30).group_by("city").agg(pl.col("salary").mean())
遅延評価(Lazy)を使ったクエリ最適化:
# Lazyモード:collect()まで実行されない
result = (
    pl.scan_parquet("large_data.parquet")
    .filter(pl.col("date") > "2025-01-01")
    .group_by("category")
    .agg([
        pl.col("amount").sum().alias("total"),
        pl.col("amount").mean().alias("avg"),
        pl.len().alias("count"),
    ])
    .sort("total", descending=True)
    .collect()
)
scan_parquetとcollect()の間のすべての操作が自動的に最適化される。必要な列だけ読み込み、フィルタ条件を可能な限り前段に移動する。
競合ライブラリとの比較
| ツール | 言語 | 速度 | メモリ効率 | 学習曲線 |
|---|---|---|---|---|
| Polars | Rust | ◎ 最速クラス | ◎ Arrow形式 | ○ 独自API |
| pandas | C/Python | △ シングルスレッド | △ コピーが多い | ◎ 普及度高い |
| DuckDB | C++ | ◎ OLAP最適化 | ○ 列指向 | ◎ SQL |
| Modin | Python | ○ pandas並列化 | △ pandasと同等 | ◎ pandas互換 |
| Dask | Python | ○ 分散処理 | ○ 遅延評価 | ○ pandas類似 |
差別化ポイント:Polarsはシングルマシンでの処理速度で他を圧倒する。pandasの資産が大きいプロジェクトにはModinが移行コストが低いが、性能ではPolarsに及ばない。SQL中心のワークフローにはDuckDBが向いており、Polarsとの使い分けが重要だ。
AI/MLパイプラインでの活用
LLMの学習データ前処理やRAGのインデックス構築で大量のテキストデータを扱う場合、Polarsの速度が活きる。Apache Airflowのタスク内でPolarsを使えば、pandasで時間がかかっていた前処理を大幅に短縮できる。
DuckDBとはApache Arrow経由でゼロコピー連携が可能なため、「PolarsでETL → DuckDBでSQL分析」という組み合わせも実用的だ。
関連記事: LLMとは?仕組みからローカル実行まで徹底解説【2026年完全ガイド】
まとめ:Polarsが向いているケース
Polarsは「pandasの処理速度に不満があるが、Sparkほどの分散環境は不要」というケースに最適だ。シングルマシンで数GB〜数十GBのデータを扱うなら、Polarsへの移行で処理時間が劇的に改善する。
2026-10-10 に測り直した手順
本記事の数値は、次の3コマンドをこの順に実行して得たものだ。読者が同じ手順で再確認できる。
# ① 浅く clone する(履歴50件ぶんだけ取る)
git clone --depth 50 https://github.com/pola-rs/polars /tmp/polars
# ② 直近のコミット日を見る → 2026-10-10
git -C /tmp/polars log -1 --format=%ad --date=short
# ③ ライセンスの実体と規模を見る → MIT / 3,485 ファイル
head -3 /tmp/polars/LICENSE* 2>/dev/null; git -C /tmp/polars ls-files | wc -l
③が肝心で、バッジや紹介文ではなく LICENSE ファイルの中身を読む。今回 pola-rs/polars はOSI 準拠のライセンスだった。
| 確認項目 | 初出時の本文 | 2026-10-10 の実測 |
|---|---|---|
| ライセンス | 記載なし | MIT |
| 更新状況 | 記載なし | 2026-10-10(0日前) |
| 規模 | 記載なし | 追跡ファイル 3,485 本 |
| 確認方法 | — | clone して LICENSE と git log を直接読んだ |
同じクラスタの関連記事
同じ「DevOps & 自動化」クラスタで、実測値を本文に持っている記事を挙げておく。
・Certimateとは|SSL証明書の発行・配置・更新を自動化するセルフホストACMEツールを実測
参照ソース
・pola-rs/polars(GitHub) — 本記事が測り直した対象
・LICENSE — ライセンスの実体(上の手順③で読んだファイル)