ux-ui-agent-skills は、Claude(Claude CodeやClaudeを使うIDE)に読み込ませることで、Claudeを「シニア・デザインアーキテクト」として振る舞わせる オープンソースのスキル集です。 リポジトリの説明はずばり「Turn Claude into a Senior Design Architect」——DTCG設計トークン、42のコンポーネント、WCAG 2.2のアクセシビリティ、任意フレームワークへのコード生成、138のデザインシステム、そして実行可能なスキル群を束ねています。
「Claudeにデザインを任せると、なんとなく見た目は作れるが、色やサイズが場当たり的でアクセシビリティも怪しい」——この曖昧さを、構造化された設計基準とトークン で一貫させるのがこのプロジェクトの狙いです。 本稿は 2026年6月23日(JST)時点 で、公式GitHubリポジトリ(plugin87/ux-ui-agent-skills)をもとに、仕組み・構成・導入・使い方を整理します。
近年、Claudeの「Skills(スキル)」という仕組みが整い、特定領域の専門知識と実行手順をフォルダ単位でClaudeに与える ことが容易になりました。 ux-ui-agent-skillsは、この仕組みを“UX/UI設計”という領域に特化させた代表例です。 汎用的に賢いLLMを、デザインという専門職の作法で動く存在に“調教”する ——スキルというアプローチが何をもたらすのかを示す、分かりやすい実例だといえます。
そもそも「Claude Skills(スキル)」の仕組みを先に押さえたい方は Claude Skillsを徹底解説|スキルはフォルダ——Anthropicエンジニアが明かした仕組みと使い方 をご覧ください。 スキルを読み込ませる側の Claude Code そのものの導入・設定・運用は Claude Code|2026年版・インストールからCLAUDE.md・Hooks・本番運用までの実装手引き にまとめてあります。
- ・Claudeを「シニア設計者」に変えるOSSスキル集。設計の判断を基準化する知識レイヤ。
- ・DTCG設計トークン(3層)・42コンポーネント仕様・WCAG 2.2・138デザインシステムを内蔵。
- ・17のrunnable skills(トークン/コンポーネント/コード生成/アクセシビリティ監査/デザインレビュー/UXライティング)。
- ・Adapter ProtocolでReact/Vue/Svelte/SwiftUI/Flutterへコード生成。
- ・ランタイム依存なしの純粋な知識・指示レイヤ。Figma MCP・GitHub Actions連携も。
1. ux-ui-agent-skillsとは — 設計の判断を基準化する知識レイヤ
LLMにUIを作らせるとき、最大の問題は 「品質と一貫性がぶれる」 ことです。 同じ「ボタンを作って」でも、配色・余白・状態(hover/disabled)・アクセシビリティの扱いが毎回変わり、デザインシステムとして成立しません。
ux-ui-agent-skillsは、この問題に 「Claudeに渡す設計の教科書+実行スクリプト群」 という形で答えます。 ライブラリとしてアプリに組み込むのではなく、Claudeが参照する知識レイヤ として機能するのが特徴です。
主な構成要素は次のとおりです。
・DTCG設計トークン:色・タイポグラフィ・余白・影・モーションを、ツール非依存のJSONで3層構造(プリミティブ→セマンティック→コンポーネント)に整理
・42のコンポーネント仕様:Atomic Designに基づき、状態やアクセシビリティ要件まで含めて定義
・138のデザインシステム参照ライブラリ:ブランド級のデザインシステムを美的判断の参照に
・WCAG 2.2準拠:アクセシビリティ基準と監査ツールを内蔵
・17のrunnable skills:トークン生成・コンポーネント生成・コード生成・アクセシビリティ監査・デザインレビュー・UXライティングなどを実行可能なスキルとして提供
・検証スクリプト:トークン検証・コントラストチェック・品質ゲートをPython/Node.jsで実行
要するに、「Claudeの設計判断を、構造化された基準とトークンで固定する」 ためのキットです。
なぜこれが必要なのかは、デザインシステムの考え方を踏まえると分かりやすくなります。 プロのプロダクト開発では、ボタンや入力欄を「その都度デザインする」のではなく、トークン(色・余白などの最小単位)→ コンポーネント(部品)→ パターン(画面) という階層で、一貫したルールに基づいて組み立てます。 この“ルールの体系”がデザインシステムであり、SalesforceのLightningやGoogleのMaterialなど、各社が公開している成熟した体系が存在します。 LLMにUIを作らせると、この体系を無視して「それっぽい見た目」を毎回ゼロから作ってしまうため、プロダクト全体で見るとちぐはぐになります。 ux-ui-agent-skillsは、この“体系”をClaudeに与える ことで、生成物がデザインシステムの一部として成立するようにします。 42のコンポーネント仕様が Atomic Design(原子→分子→有機体…という部品の階層化手法)に基づいているのも、この“体系で考えさせる”という思想の表れです。
2. アーキテクチャ:知識レイヤ → スキル → フレームワーク・アダプタ
全体像を図にすると次のようになります。
ポイントは、設計の基準(知識レイヤ)と、実装ターゲット(フレームワーク)を分離 していることです。 コンポーネント仕様を共通の中間表現として持ち、Adapter Protocolで各フレームワークのコードへ落とします。 これにより「同じデザイン基準から、React版もFlutter版も一貫した部品を生成する」ことが可能になります。
そして生成物は、検証スクリプト(コントラスト比やトークン整合のチェック)と 品質ゲート を通すことで、アクセシビリティや一貫性が担保されます。 これがCI(GitHub Actions)に組み込まれている点が、単なる“プロンプト集”との大きな違いです。
Adapter Protocol(アダプタ層) の発想は、ソフトウェア設計でいう「関心の分離」に近いものです。
コンポーネントの“あるべき姿”——たとえば「primaryボタンは、hover/active/disabledの状態を持ち、フォーカスリングが見え、十分なコントラスト比を満たす」——という仕様を、特定のフレームワークから独立した形で定義しておきます。
その共通仕様を、Reactなら<button className=...>へ、SwiftUIならButton { }へ、と各アダプタが翻訳します。
この分離があることで、デザインの意思決定(何が正しいUIか)と、実装の都合(どのフレームワークか)が混ざらない のが利点です。
結果として、マルチプラットフォーム(Web+モバイル)で同じ設計言語を共有しやすくなり、片方だけ仕様がずれる事故を防げます。
一方で注意したいのは、こうした“共通仕様→各FW”の生成は、複雑なインタラクションやプラットフォーム固有の作法(iOSのヒューマンインターフェースガイドライン等)まで完璧に吸収できるわけではない点です。 あくまで「一貫した土台を高速に出す」ためのものであり、最終的な作り込みは人間のレビューと組み合わせる前提で使うのが現実的です。
3. 導入:Claudeにスキルとして読み込ませる
ux-ui-agent-skillsは知識・指示レイヤなので、導入は リポジトリを取得してClaude(Claude Code等)に参照させる のが基本です。
# リポジトリを取得(プロジェクトに取り込む or skills として配置)
git clone https://github.com/plugin87/ux-ui-agent-skills.git
「ランタイム依存がない」ことは、導入のハードルを大きく下げます。 npmパッケージのようにバージョン衝突やビルド設定で悩む必要がなく、リポジトリをプロジェクトに置いてClaudeに参照させるだけ で始められます。 知識レイヤなので、自社の設計ルールに合わせてMarkdownやJSONを編集すれば、そのままClaudeの振る舞いに反映されます。 チームで使う場合は、このリポジトリ自体をGitで管理し、トークンやコンポーネント仕様の変更履歴を追えるようにしておくと、「いつ・誰が・どの設計基準を変えたか」がレビュー可能になります。 デザインの意思決定が、コードと同じようにバージョン管理される——これも“設計をコード化する”この種のキットの利点です。
Claude Codeで使う場合は、スキル定義を読み込ませることで /skills(実行可能スキル)が利用できるようになります。
たとえば、設計トークンの生成やアクセシビリティ監査を、対話の中でスキルとして呼び出します(イメージ)。
/design-tokens  ブランドカラー #1D9E75 を基点に、セマンティックトークンを3層で生成して
/a11y-audit     いま作ったフォームのコントラスト比とフォーカス可視性をWCAG 2.2基準で監査して
/component       primary/secondary/disabled の状態を持つボタンを、アクセシブルに設計して
※ スキル名・呼び出し方法はリポジトリの定義に従ってください。重要なのは「設計の各工程(トークン→コンポーネント→コード→監査→レビュー)が、それぞれ実行可能なスキルとして用意されている」という点です。
ここで「runnable skills(実行可能スキル)」と「ただのプロンプト」の違いを補足します。 通常のプロンプトは“お願い”にすぎず、出力の検証は人間任せです。 一方このキットのスキルは、生成だけでなく検証スクリプト(トークン整合・コントラスト比など)まで含めて1つの工程 として定義されています。 つまり「ボタンを作って」で終わらず、「作ったうえでWCAG基準を満たすか機械的にチェックし、満たさなければ直す」ところまでが1スキルに収まっている、という設計です。 この“生成+検証”がセットになっていることが、AI生成にありがちな「それっぽいが基準を外している」状態を防ぐ鍵になります。
設計工程をスキルで分業するイメージは次のとおりです。
・トークン系スキル:ブランド値からDTCGトークンを3層生成し、整合を検証
・コンポーネント系スキル:状態・アクセシビリティ要件を含む部品仕様を起こす
・コード生成系スキル:仕様をAdapter経由で対象フレームワークのコードに落とす
・アクセシビリティ監査スキル:コントラスト比・フォーカス可視性・ARIAをWCAG 2.2で点検
・デザインレビュー系スキル:生成物をレビューし、品質ゲートの観点で指摘
・UXライティング系スキル:ボタン文言やエラーメッセージなどのマイクロコピーを整える
各工程を独立したスキルにすることで、「どこで品質を担保しているか」が明確 になり、CIに組み込んだときの“通過条件”も定義しやすくなります。
4. 設計トークン(DTCG)で一貫性を担保する
このキットの土台が DTCG(Design Tokens Community Group)形式の設計トークン です。 DTCGは、デザイン値をツール非依存のJSONで表現する標準で、Figmaや各種ツールとの相互運用に向いています。
3層構造の考え方は次のとおりです(イメージ)。
{
  "color": {
    "primitive": { "green-600": { "$value": "#1D9E75", "$type": "color" } },
    "semantic":  { "brand-primary": { "$value": "{color.primitive.green-600}", "$type": "color" } },
    "component": { "button-bg": { "$value": "{color.semantic.brand-primary}", "$type": "color" } }
  }
}
・プリミティブ:生の値(#1D9E75)
・セマンティック:意味づけ(brand-primary)
・コンポーネント:部品での用途(button-bg)
この3層により、「ブランドカラーを変えたい」ときに プリミティブを1か所変えるだけで全体に波及 します。 Claudeが生成するUIがこのトークンを参照することで、色・サイズ・余白が場当たり的にならず、デザインシステムとして一貫 します。 検証スクリプトはこのトークン整合やコントラスト比(WCAG基準)を機械的にチェックし、品質ゲートとして機能します。
DTCG形式を採用する意味は、ツールをまたいだ相互運用 にあります。 仮にトークンをCSS変数やJSの定数として“ベタ書き”すると、Figmaのデザインデータとコードが二重管理になり、すぐにズレます。 DTCGという標準JSONを“単一の真実の源(source of truth)”にしておけば、Figma(MCP連携)→トークン→各フレームワークのコード、という流れを一本化できます。 ux-ui-agent-skillsがFigmaのMCP連携をオプションで持つのも、この「デザインとコードを同じトークンで繋ぐ」思想に沿ったものです。
また、138のデザインシステム参照ライブラリ は、トークンやコンポーネントの“良い基準”をClaudeに示すための辞書のような役割を果たします。 ゼロから「美しい配色とは」「適切な余白とは」を毎回考えさせるのではなく、成熟したデザインシステム群を参照点として与えることで、生成物の美的な水準とアクセシビリティの土台を底上げします。 人間のデザイナーが優れた他社事例を参照しながら設計するのと、同じことをClaudeにやらせるイメージです。
トークンが扱う範囲は色だけではありません。 タイポグラフィ(フォントサイズ・行間・字間)、余白(スペーシングスケール)、影(エレベーション)、モーション(アニメーションの時間・イージング) まで含めて体系化します。 たとえば余白を「4の倍数(4/8/12/16…)」というスケールに固定しておけば、Claudeが生成するレイアウトの余白がバラつかず、視覚的なリズムが揃います。 モーションも「標準のトランジションは200ms・ease-out」とトークン化しておけば、画面ごとにアニメーションの速さが違う、といった違和感を防げます。 このように、「デザインの全要素を数値として定義し、その数値をClaudeに参照させる」 ことが、一貫性の正体です。 感覚的な「いい感じに」ではなく、再現可能な基準 に落とすからこそ、AIに任せても品質が崩れません。
5. 他の選択肢との違い(Claude単体・v0・他スキル集)
「Claudeにそのまま頼むのと何が違うのか」を整理します。
| 選択肢 | 強み | 弱み | 向き |
|---|---|---|---|
| ux-ui-agent-skills | トークン/コンポーネント/WCAG/デザインシステムで判断を基準化、CI品質ゲート | 知識レイヤゆえ初期の取り込み・運用が必要 | 一貫した設計システムを保ちたいチーム |
| Claude単体 | 手軽・自由 | 品質と一貫性がぶれる、a11yが抜けやすい | 単発のラフ生成 |
| v0 等のUI生成 | 見た目の生成が速い | 自社トークン/WCAG厳守は別途作り込み | プロトタイプUI |
| 汎用スキル集 | 幅広い用途 | 設計特化の深さは限定的 | 汎用エージェント強化 |
要するに、ux-ui-agent-skillsの価値は 「生成の派手さ」ではなく「一貫性と品質ゲート」 にあります。 派手なUIを一発で出すよりも、自社のデザインシステムに沿ったアクセシブルな部品を、繰り返し安定して出す ことに向いています。
この違いは「単発の制作」と「継続的なプロダクト開発」の差として現れます。 ランディングページを1枚作るだけなら、v0やClaude単体で十分なこともあります。 しかし、何十画面もあるプロダクトを複数人・複数プラットフォームで開発し続ける場合、バラつきは積み重なって“負債”になります。 ボタンの角丸が画面ごとに違う、エラーメッセージの語調が統一されていない、一部だけコントラスト比が足りない——こうした小さなズレが、ユーザー体験とブランドの信頼を少しずつ損ないます。 ux-ui-agent-skillsは、まさにこの“積み重なる負債”を、トークンと品質ゲートで未然に防ぐためのものだと理解すると、立ち位置がはっきりします。 言い換えれば、「速く作る」ためのツールではなく、「崩れずに作り続ける」ためのツール です。
Claudeのスキル/プラグインを広く強化したい場合は、claude-code-templates完全解説|エージェント100種をワンコマンドで導入するOSS や DAIR Academy Plugins完全解説 — Claude Codeをパワーアップする5つのOSSプラグイン と組み合わせる発想も有効です。
6. 想定ユースケースと運用のコツ
向いているのは、デザインシステムを持つ(or これから整える)チーム の実装支援です。
・デザインシステムの実装:トークンとコンポーネント仕様を基準に、Claudeで部品を量産
・アクセシビリティの底上げ:WCAG 2.2監査をスキルとして回し、コントラスト/フォーカスを担保
・マルチフレームワーク展開:同じ基準からReact版・Flutter版などを一貫生成
・デザインレビューの自動化:生成物をスキルでレビューし、品質ゲートをCIに組み込む
・UXライティング:ボタン文言・エラーメッセージ・空状態の文言など、マイクロコピーの一貫性をスキルで支援
・デザイン負債の棚卸し:既存UIを監査スキルに通し、トークン非準拠やコントラスト不足を洗い出す
具体的なシーンで考えると、効果がイメージしやすくなります。 たとえば、複数のプロダクトを持つ企業で「全社のボタンの見た目と挙動を揃えたい」とき。 従来はデザイナーがFigmaでガイドラインをつくりエンジニアがReact/SwiftUIで個別実装し、両者がずれるのが常でした。 ux-ui-agent-skillsを使えば、DTCGトークンを単一の基準にして、Claudeに各プラットフォームのボタンを生成させ、WCAG監査と品質ゲートを通す という流れを一本化できます。 あるいは、アクセシビリティ対応が後回しになりがちなスタートアップで、「リリース前にコントラスト比とフォーカス可視性をまとめて監査したい」というケースでも、監査スキルをCIに組み込んでおけば、人手の見落としを機械的に拾えます。
運用のコツは、自社のトークン・コンポーネント基準に“上書き”して使う ことです。 このキットはあくまで構造とベストプラクティスの土台であり、ブランドカラーや独自コンポーネントは自社仕様に差し替えてこそ真価が出ます。 また、検証スクリプトをCIに組み込み、「Claudeの生成物が品質ゲートを通らないとマージできない」 状態を作ると、AI生成のばらつきを仕組みで抑え込めます。
導入を成功させるための現実的なステップを挙げておきます。
・まず1コンポーネントで試す:いきなり全体に適用せず、ボタンやフォームなど1部品でトークン→生成→監査の流れを体験する
・自社トークンに差し替える:付属のトークンはあくまで土台。ブランドカラー・タイポグラフィを自社値に上書きする
・品質ゲートをCIに入れる:コントラスト比やトークン整合のチェックを必須化し、人手レビューと併用する
・対象フレームワークを絞る:最初はReactなど主力1つに絞り、安定したらマルチFW展開へ広げる
・人間のデザインレビューを残す:AIは土台の量産に使い、最終的なブランド表現や複雑なインタラクションは人が仕上げる
この順序で入れると、「AIに丸投げして品質が崩れる」のではなく、「AIで土台を高速化しつつ、品質は仕組みで守る」運用に着地できます。 特に、デザイナーとエンジニアが分業している組織では、トークンという共通言語が両者の橋渡しになり、コミュニケーションコストの削減にも効きます。
なお、このキットはClaudeの他のスキル・プラグインと併用できます。 コーディングエージェントとしての強化(テンプレートやプラグイン)と、設計品質の担保(ux-ui-agent-skills)を組み合わせれば、「仕様から実装、そして設計品質チェックまで」を一つのワークフローに乗せられます。 重要なのは、それぞれのスキルが「何を担保するのか」を明確にして役割を分けることです。 ux-ui-agent-skillsは“設計の一貫性と品質ゲート”を担う層、と位置づけて他ツールと重ねるのが、最も無理のない使い方になります。
まとめ
ux-ui-agent-skillsは、Claudeの設計判断を、トークン・コンポーネント仕様・アクセシビリティ基準・デザインシステムで“基準化”する オープンソースのスキル集です。
要点を整理すると次のようになります。
・Claudeを「シニア・デザインアーキテクト」として振る舞わせる知識・指示レイヤ
・DTCG設計トークン(3層)・42コンポーネント仕様・WCAG 2.2・138デザインシステムを内蔵
・17のrunnable skillsで、トークン→コンポーネント→コード→監査→レビューを実行
・Adapter ProtocolでReact/Vue/Svelte/SwiftUI/Flutterへ一貫生成
・ランタイム依存なし。Figma MCP・GitHub Actions(品質ゲート)連携
・トークンは色だけでなくタイポグラフィ・余白・影・モーションまで体系化し、再現可能な基準に落とす
このキットの本質は「生成の速さ」ではなく「一貫性と品質ゲート」だ。Claude単体のUI生成がぶれる、アクセシビリティが抜ける、という課題を、トークンと基準で仕組み化して解く。デザインシステムを持つ(or 整えたい)チームが、自社のトークンに上書きして使い、検証スクリプトをCIに組み込むと、AI生成のばらつきを抑えながら設計の質を底上げできる。まずはボタン1つから試し、トークン→生成→監査→品質ゲートの流れを体験してみるのがおすすめだ。
配信メモ
X投稿フック案(120〜200字、3案)
- Claudeにデザイン任せると見た目はできるが色もサイズも場当たり、a11yも怪しい——を解決するOSS「ux-ui-agent-skills」。DTCGトークン3層+42コンポーネント仕様+WCAG 2.2+138デザインシステムでClaudeの設計判断を基準化。React/Vue/SwiftUI/Flutterへ一貫生成。
- このキットの肝は「生成の派手さ」じゃなく「品質ゲート」。トークン整合とコントラスト比を検証スクリプトでチェックし、GitHub ActionsのCIに組み込める。AI生成のばらつきを“仕組み”で抑える設計。
- ランタイム依存なしの純粋な知識レイヤ。自社のブランドカラー/コンポーネントに上書きして使うのが正解。Figma MCP連携も。デザインシステムを持つチームの実装支援に効く。
内部リンク提案
- /explain/claude-skills-explained/(ピラー)
- /explain/claude-code-templates-davila7/(クラスタ)
- /tool/dair-academy-plugins/(クロス)
想定検索クエリ
- ux-ui-agent-skills / Claude デザイン スキル
- Claude デザイントークン DTCG 生成
- Claude WCAG アクセシビリティ 監査 –>
2026-10-14 に実測で確かめ直した:自分に0.674を付けて公開している
このリポジトリで一番見るべきは、スキルの中身そのものより自己採点の仕組みだった。evals/ に採点ハーネスが同梱されていて、実行すると自分のスコアを計算して出す。2026-10-14 に動かした結果を置く。
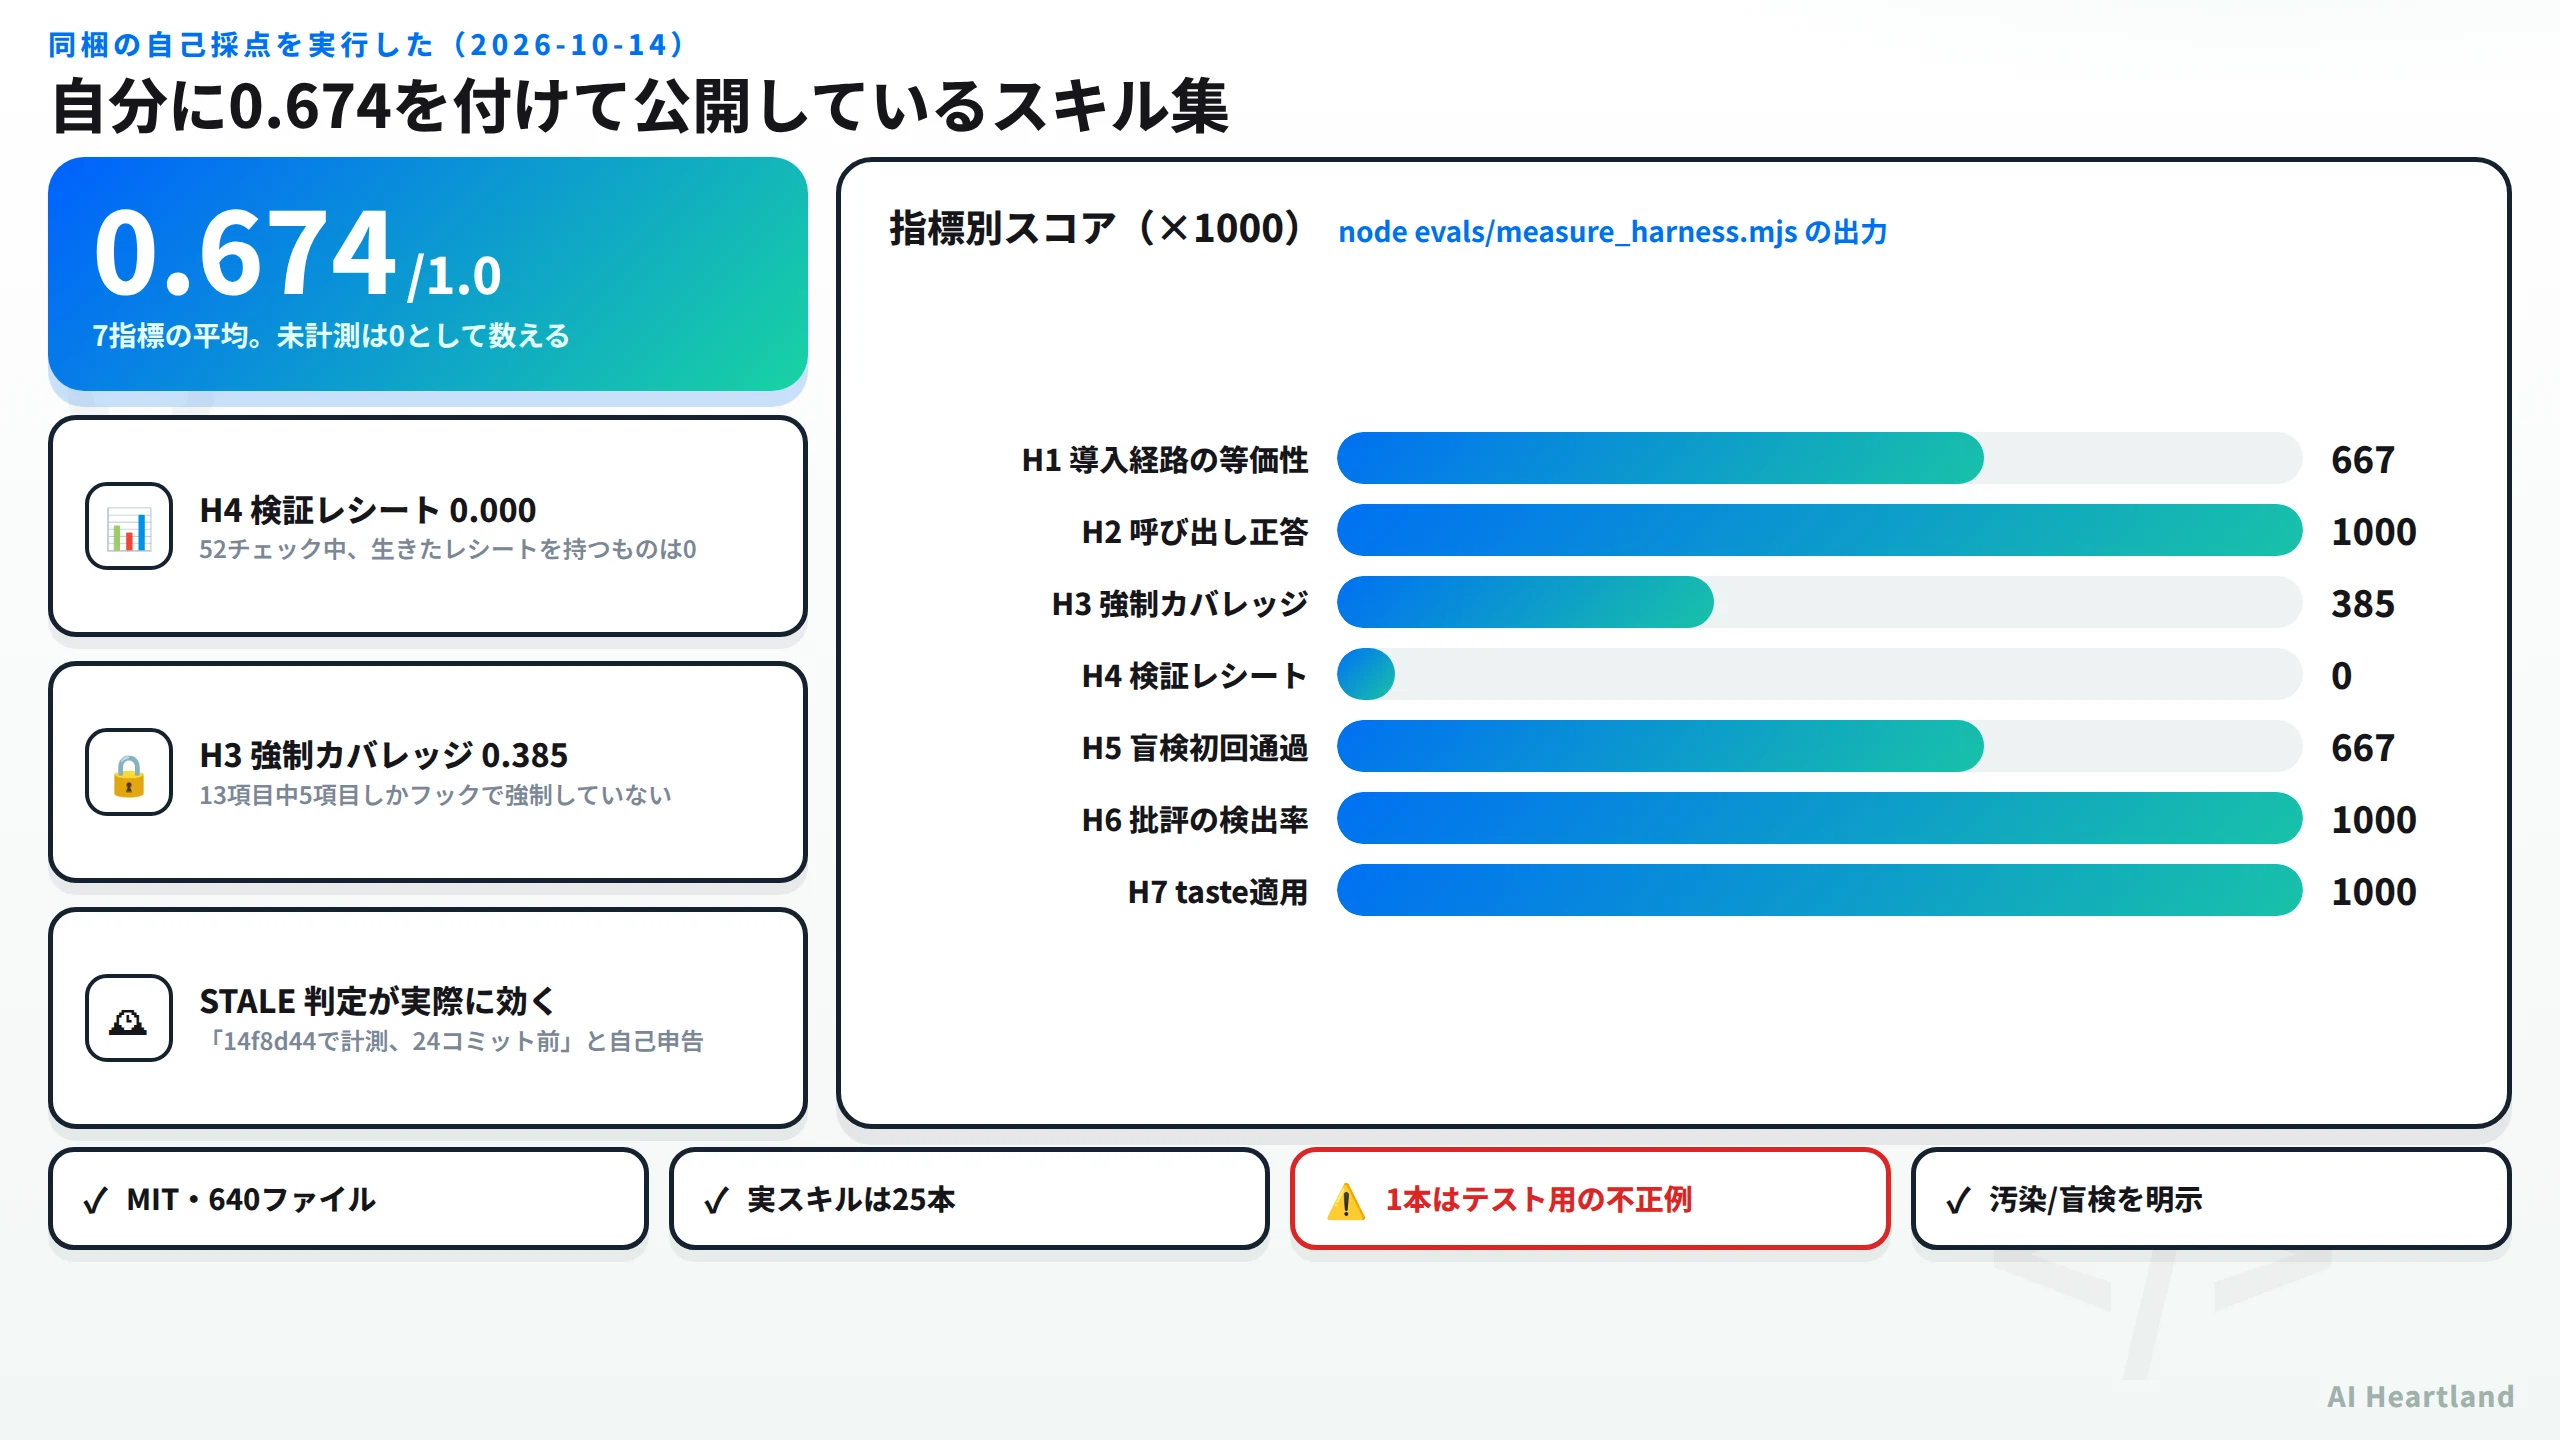
node evals/measure_harness.mjs の出力。環境は Ubuntu 24.04 / Node v22.22.2# ① clone して自己採点を実行する(全履歴が要る点に注意)
git clone https://github.com/plugin87/ux-ui-agent-skills
cd ux-ui-agent-skills && node evals/measure_harness.mjs
出てきたのが Harness Score = 0.6740(7指標の平均、未計測は0として数える)だった。内訳はこうだ。
| ID | 指標 | スコア | 根拠 |
|---|---|---|---|
| H1 | 導入経路の等価性 | 0.667 | plugin 170/170、init 170/170、skills-add 0/170 |
| H2 | 呼び出し正答 | 1.000 | 12/12 ケース、$4.34、682秒(STALE) |
| H3 | 強制カバレッジ | 0.385 | 13項目中5項目しかフックで強制していない |
| H4 | 検証レシート | 0.000 | 52チェック中、生きたレシートを持つものが0 |
| H5 | 盲検の初回通過 | 0.667 | 3経路中2経路(init・plugin) |
| H6 | 批評の検出率 | 1.000 | 仕込んだ欠陥 14/14 を検出(STALE) |
| H7 | taste の適用 | 1.000 | 5/5 で Brief Inference ブロックを出力(STALE) |
低い値を隠していない。 H4 が 0.000、H3 が 0.385 で、しかもそれを平均に入れて 0.674 として公開している。スキル集の宣伝文としては不利な数字だが、導入する側にとってはこれ以上ない判断材料だ。
STALE 判定が実際に効く
harness-measurements.json の $comment に、計測の取り扱い方針が書かれている。
Only record a value a command actually printed, and put that command in
commandso anyone can reproduce it. An entry with no command is a claim, not a measurement.
そして measure_harness.mjs は、記録時のコミットより HEAD が進んでいればその値を STALE と表示する。実際に出力にはこう出た。
H2   Invocation correctness   1.000   claude plugin eval . --runs 2 ...
     STALE: measured at 14f8d44, 24 commit(s) old
「24コミット前の値だ」と自分で申告してくる。 有料のモデル実行が要る指標(H2・H6・H7)は毎回測り直せないので、代わりに古さを明示するという解き方をしている。
ここで1つ注意がある。浅い clone(--depth 1)では、この仕組みが正しく動かない。 最初に --depth 1 で試したときは fatal: ambiguous argument '14f8d44..HEAD' が出て「commit unknown」と表示された。黙って通さず壊れた側に倒れるのは良い設計だが、再現するなら全履歴を取る必要がある。全履歴で 144 コミットだった。
汚染と盲検を書き分けている
evals/RESULTS.md は1実行1行の表で、評価者がキットの内部を見られる状態だったかを毎行ラベルしている。
| ラベル | 意味 |
|---|---|
| In-session (contaminated) | 同じセッション内で実行。キットの中身が見えている |
| BLIND subagent | 盲検。スキャフォールドされたプロジェクトから実行 |
| BLIND, plugin route | 盲検かつプラグイン経路。空ディレクトリで claude -p |
2026-10-08 の行には「The route the README recommends first had never been tested blind.」と書かれている。READMEが最初に勧める経路が、それまで一度も盲検で試されていなかったと自分で明かしている。
H6 の 1.000 にも注釈が付く。「fixtures and key written in the same session, and the keyword matcher was widened against these same four critiques after a hand-read of 14/14」——仕込みと答えを同じセッションで書き、判定器を同じ4件に合わせて広げた。満点だが信用するなと、採点した側が書いている。
H7 には「2/3 and 5/5 are not a significance test, they are the best evidence available at $1.51 a run of five」とある。有意差検定ではない、と断ったうえで単価まで書く。
スキルは25本。26本目はテスト用の不正例
数え方にも落とし穴があった。
# ② SKILL.md を数えると26だが、1本はテスト用のフィクスチャ
find . -name SKILL.md -not -path "./.git/*" | wc -l   # → 26
find . -name SKILL.md -not -path "./.git/*" | grep -c "tests/fixtures"   # → 1
26本目は tests/fixtures/bad/bare-paths/.claude/skills/leaky で、わざと壊してあるテスト用の検体だ。素朴に数えると水増しになる。実際に使えるスキルは .claude/skills/ 配下の 25本で、a11y-audit critique design-review design-tokens gate grill-me image-to-code migrate-design-system ship token-build ux-writing などが並ぶ。
| 確認項目 | 2026-10-14 の実測 | 確認方法 |
|---|---|---|
| ライセンス | MIT | head -3 LICENSE でファイル本文を読む |
| 直近コミット | 2026-10-10 | git log -1 --date=short |
| 全コミット | 144 | git rev-list --count HEAD |
| 追跡ファイル | 640 本 | git ls-files \| wc -l |
| 実スキル | 25 本(SKILL.md は26、うち1本は不正例) | find -name SKILL.md |
| 自己採点 | 0.6740 | node evals/measure_harness.mjs |
低い値も平均に入れる"] F --> H G --> H
この採点方式は当サイトの方針とほぼ同じだ。コマンドの無い値は計測ではない、古い値は古いと言う、汚染された評価は汚染と書く。スキル集そのものの良し悪しより、この測り方が同梱されていること自体が選ぶ理由になると考えている。
参照ソース
・plugin87/ux-ui-agent-skills(GitHub) — 本記事が 2026-10-11 に測り直した対象
・LICENSE — ライセンスの実体(手順③で読んだファイル)
・Design Tokens Community Group(DTCG)仕様
・WCAG 2.2(W3C)
・Claude Skillsを徹底解説|スキルはフォルダ(本サイト・ピラー)