gh-aw(GitHub Agentic Workflows)は、AIエージェントにやらせたいリポジトリ運用を Markdown で書いて GitHub Actions へコンパイルする公式のCLI拡張だ。YAMLフロントマターでトリガーと権限を宣言し、本文に日本語なり英語なりで指示を書く。star 5.2k、fork 564、MIT(Copyright GitHub, Inc.)、Goで3,229ファイル・約90万行。READMEの一行目が「Hello fellow agent!」で始まる、エージェントに読ませる前提のリポジトリでもある。実物を main からビルドして、書いたMarkdownが何に化けるのかを確かめた。
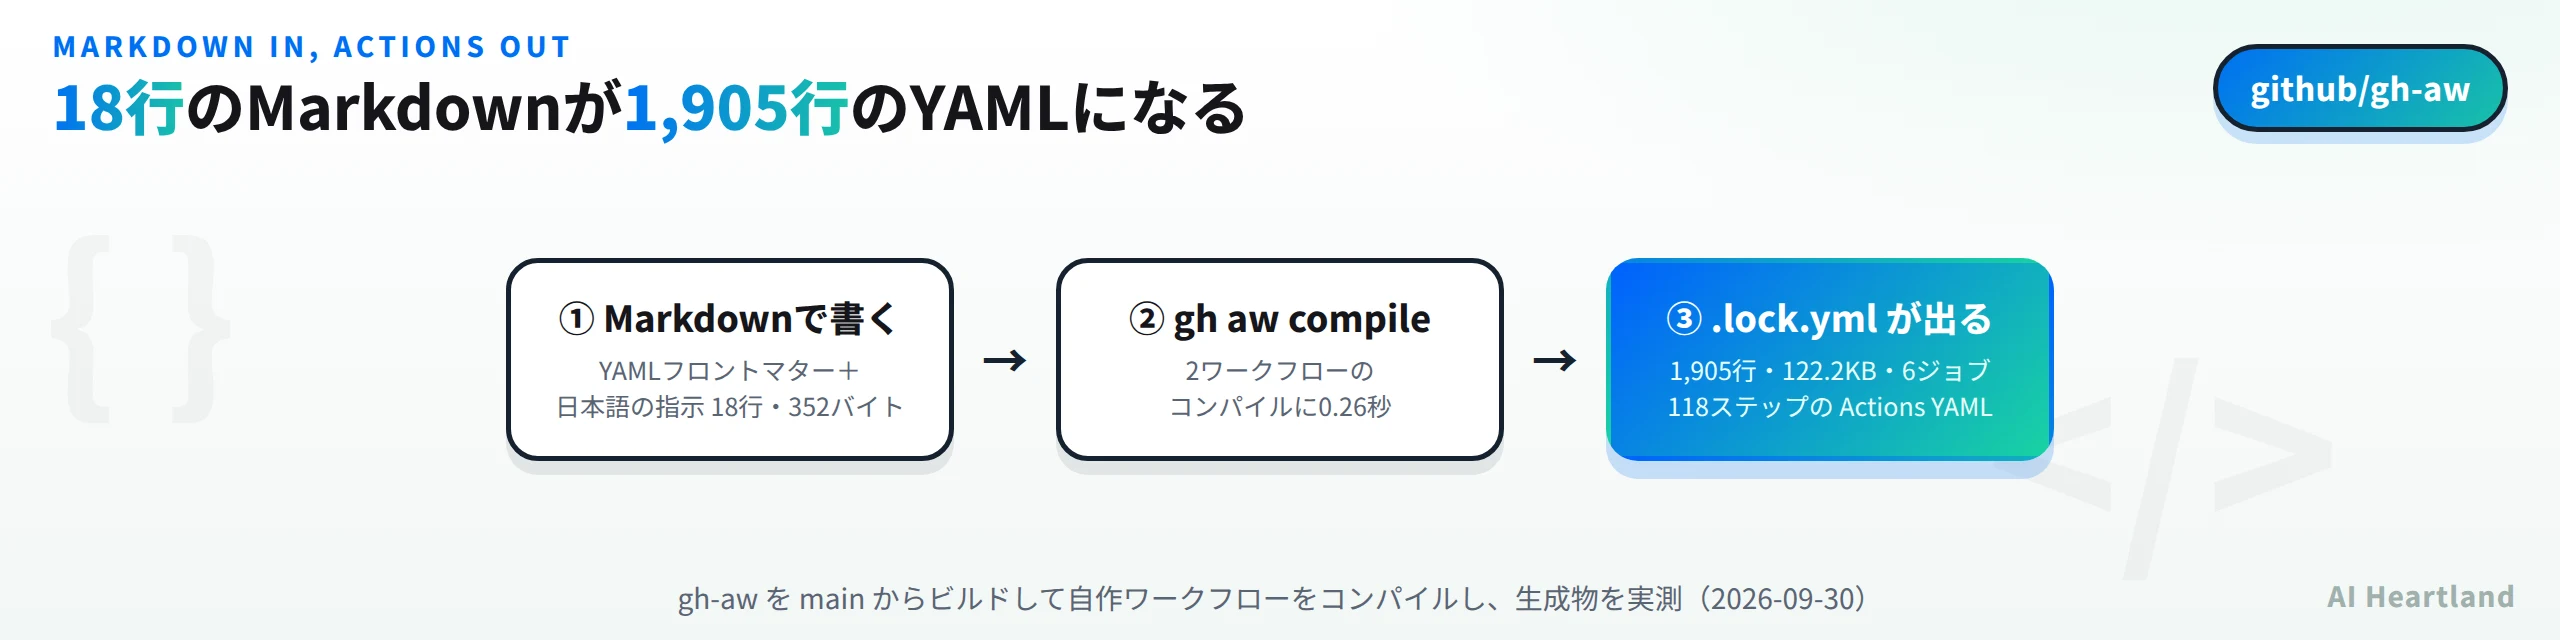
- ・Markdown+YAMLフロントマター → `.lock.yml`(GitHub Actions)へコンパイルする公式拡張
- ・**18行・352バイトが1,905行・122.2KBになった**。コンパイル自体は2本で0.26秒
- ・生成物は**6ジョブ118ステップ**。LLMが走る `agent` ジョブは **read 権限のみ**
- ・書き込みは `safe_outputs` ジョブに隔離。`safe-outputs` で宣言した種類しか通らない
- ・**tools も network も書かないのに** Squid のegressフィルタが付き、許可は35ドメインだけ
- ・Actions 5本はSHA固定、コンテナ6本はdigest固定。GitHub MCPは読み取り27ツールに限定
AI前提の自動化ツール全体の見取り図はAI自動化ツール|ノーコードからコードまで2026年版の比較と選び方にまとめてある。本記事はその中で「リポジトリ運用をエージェントに任せる」側の、GitHub公式の実装を1つ分解する。
gh-awとは:MarkdownをActionsへコンパイルする
構成はシンプルだ。.github/workflows/ に .md を置き、gh aw compile を叩くと同じ場所に .lock.yml が出る。Actionsが実行するのは後者で、前者はソースにあたる。生成物をコミットする方式なので、リポジトリには .md と .lock.yml が両方入る。
フロントマターで書くのは、トリガー(on:)、権限(permissions:)、エンジン(engine:)、制限時間、そしてエージェントに許す出力の種類(safe-outputs:)。本文はそのままエージェントへの指示になる。今回コンパイルしたのは、これだけのファイルだ。
---
on:
  issues:
    types: [opened]
permissions:
  contents: read
  issues: read
engine: copilot
timeout-minutes: 5
safe-outputs:
  add-comment:
    max: 1
---

# Issue の要約を1件コメントする

開かれた Issue の本文を読み、日本語で3行に要約してコメントしてください。
推測で情報を足さないこと。
18行・352バイト。 tools: も network: も書いていない。ここが後で効いてくるので、覚えておいてほしい。
エンジンは pkg/workflow/ に claude_engine.go codex_engine.go copilot_engine.go gemini_engine.go pi_engine.go が並んでいて、5種類が実装されている。リポジトリのCLIには compile のほかに init new add add-wizard deploy doctor run status logs audit secrets domains upgrade といったコマンドが生えている。domains が独立したコマンドになっているあたりに、この道具の性格が出ている——ネットワークをどこまで開けるかが設定項目として一級市民なのだ。audit で過去の実行を突き合わせられるのも、エージェントの仕事は「毎回同じ結果にならない」前提で作られていることの表れだろう。
リポジトリの作りも独特だ。ルートに AGENTS.md と .claude/ が置かれ、READMEの書き出しは人間にではなくエージェントに向けて「Hello fellow agent!」と呼びかけ、新規ワークフローの作り方として create.md の raw URL を提示する。この道具の説明書は、エージェントが読んで使うために書かれている。DICTATION.md や DEADCODE.md といった見慣れないファイルも並んでいて、開発プロセスごとエージェント前提に組み替えている様子がうかがえる。
実測:18行が1,905行・6ジョブになる
Go 1.26.8 でビルドして(バイナリは52.6MB)、空のリポジトリに先ほどの .md を1枚置いてコンパイルした。
go build -o gh-aw ./cmd/gh-aw     # 52.6MB
./gh-aw compile
# ✓ .github/workflows/hello-triage.md (122.2 KB)
# ✓ Compiled 1 workflow: 1 succeeded, 0 warnings
wc -l .github/workflows/hello-triage.lock.yml   # 1905
1,905行・122,146バイト。元が352バイトなので、バイト数で約355倍になっている。コンパイル自体は速く、2ワークフローで実時間0.26秒だった。
生成物の中身を数えると、トップレベルのジョブが6つ、- name: の付いたステップが118個、run: ブロックが54個。ジョブごとの permissions を抜き出すと、この道具の設計思想がそのまま出てくる。
== pre_activation   (3ステップ, ubuntu-slim)   contents: read
== activation       (22ステップ, ubuntu-slim)  actions: read / contents: read
== agent            (44ステップ, ubuntu-latest) contents: read / issues: read
== detection        (25ステップ, ubuntu-latest) contents: read
== safe_outputs     (8ステップ, ubuntu-slim)   issues: write / pull-requests: write
== conclusion       (16ステップ, ubuntu-slim)  actions: read / issues: write / pull-requests: write
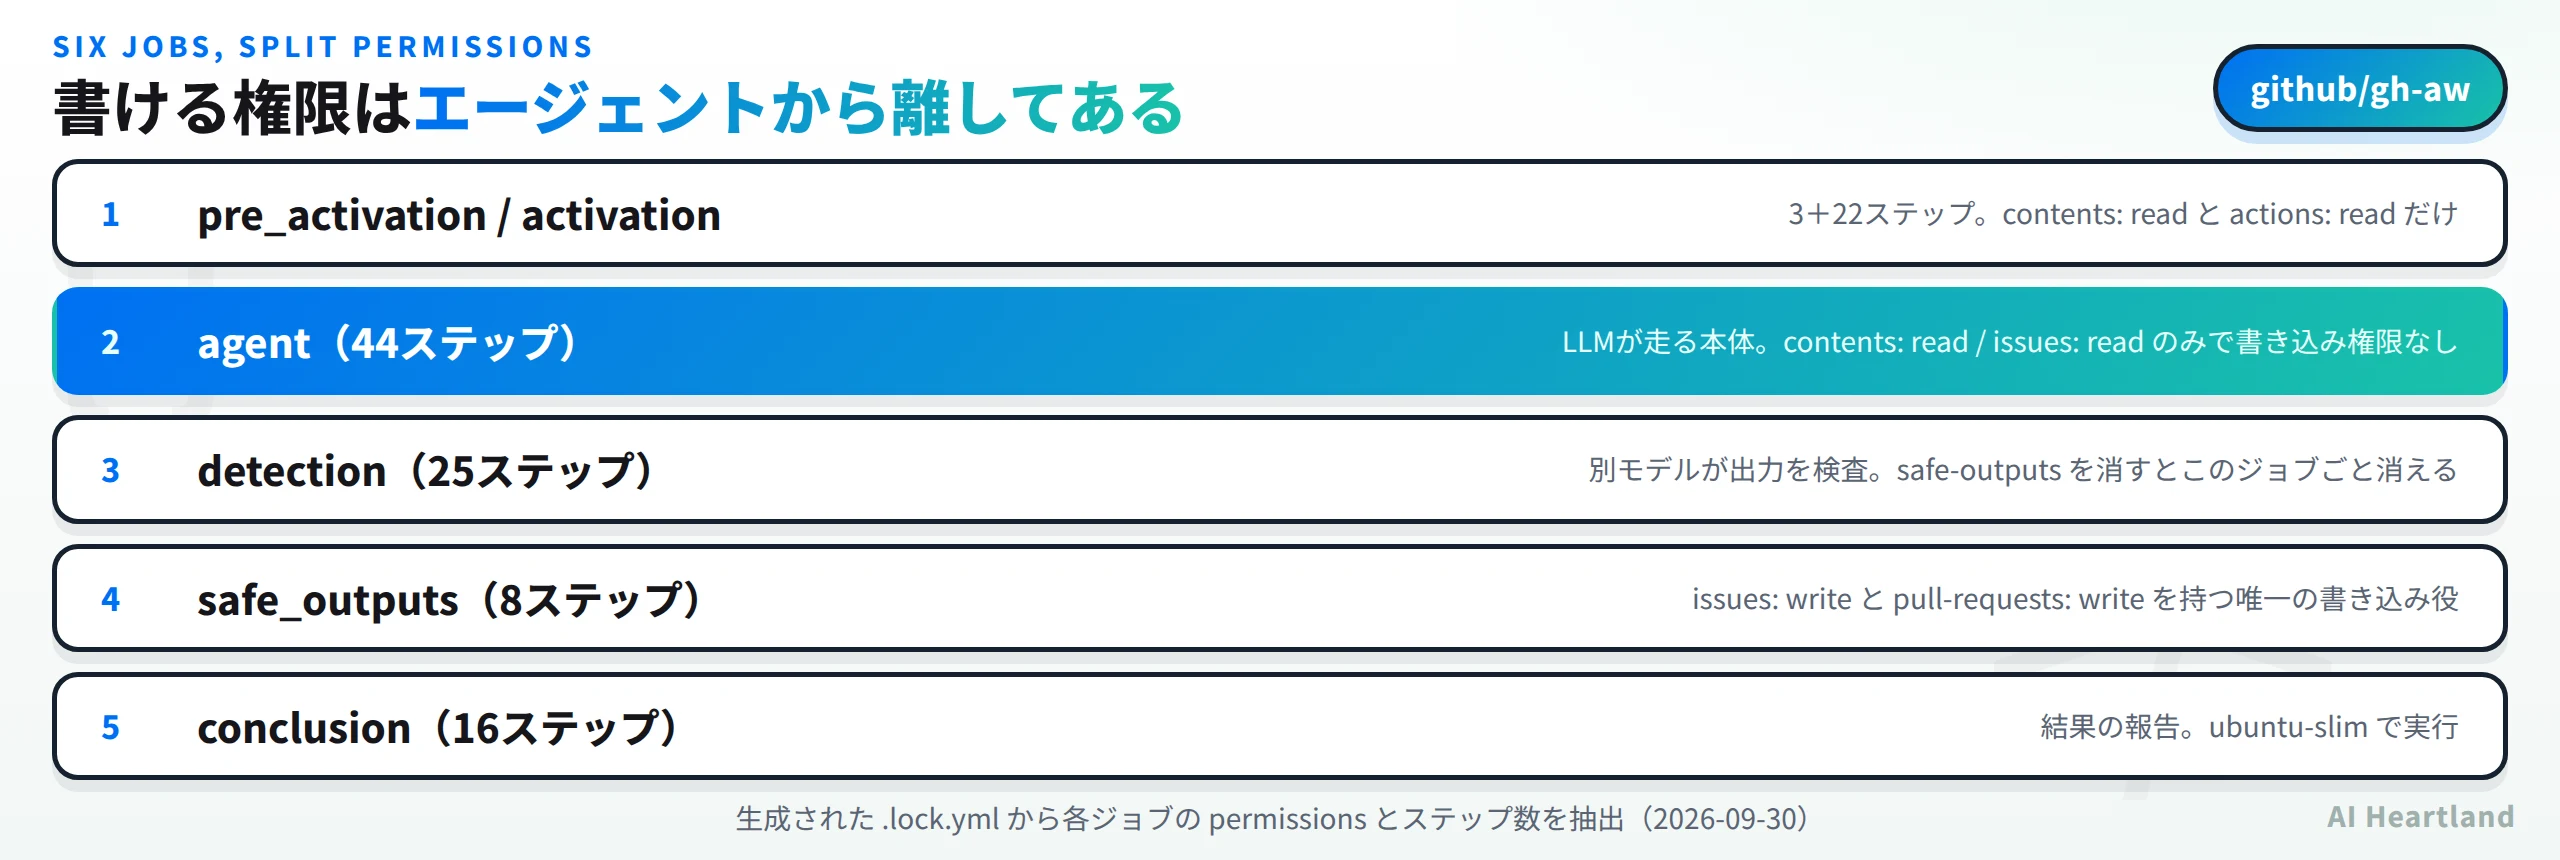
LLMが実際に走る agent ジョブに、書き込み権限が無い。 44ステップと最も重いジョブなのに、持っているのは contents: read と issues: read だけだ。コメントを書くのは safe_outputs という8ステップの別ジョブで、そこだけが issues: write を持つ。エージェントは「コメントを投稿する」のではなく、投稿してほしい内容を成果物として出す。実際に投稿するかどうかは別のジョブが決める、という構造になっている。
detection の25ステップを開くと、何をしているかがステップ名だけで分かる。「Download agent output artifact」「Prepare threat detection files」「Install threat-detect binary」「Execute threat detection with AWF」「Upload threat detection artifact」。エージェントの出力を、別のモデルで検査してから通す工程だ。生成物に埋め込まれたモデル割り当て表では、検査用の役割 detection には small クラス(haiku / gpt-5-mini / gemini-flash-lite など)が割り当てられている。本体には大きいモデル、検査には小さいモデル、という分担になっている。
面白いのは、safe-outputs: の3行をMarkdownから削って再コンパイルするとこの detection ジョブごと消えること(1,905行 → 1,418行、6ジョブ → 5ジョブ)。検査工程は、エージェントが何かを出力しうるときだけ足される。
宣言していない防御が勝手に付いてくる
ここが実測して一番驚いた部分だ。冒頭のMarkdownには tools: も network: も書いていない。それでも生成物には、ネットワークを閉じる仕掛けが丸ごと入っていた。
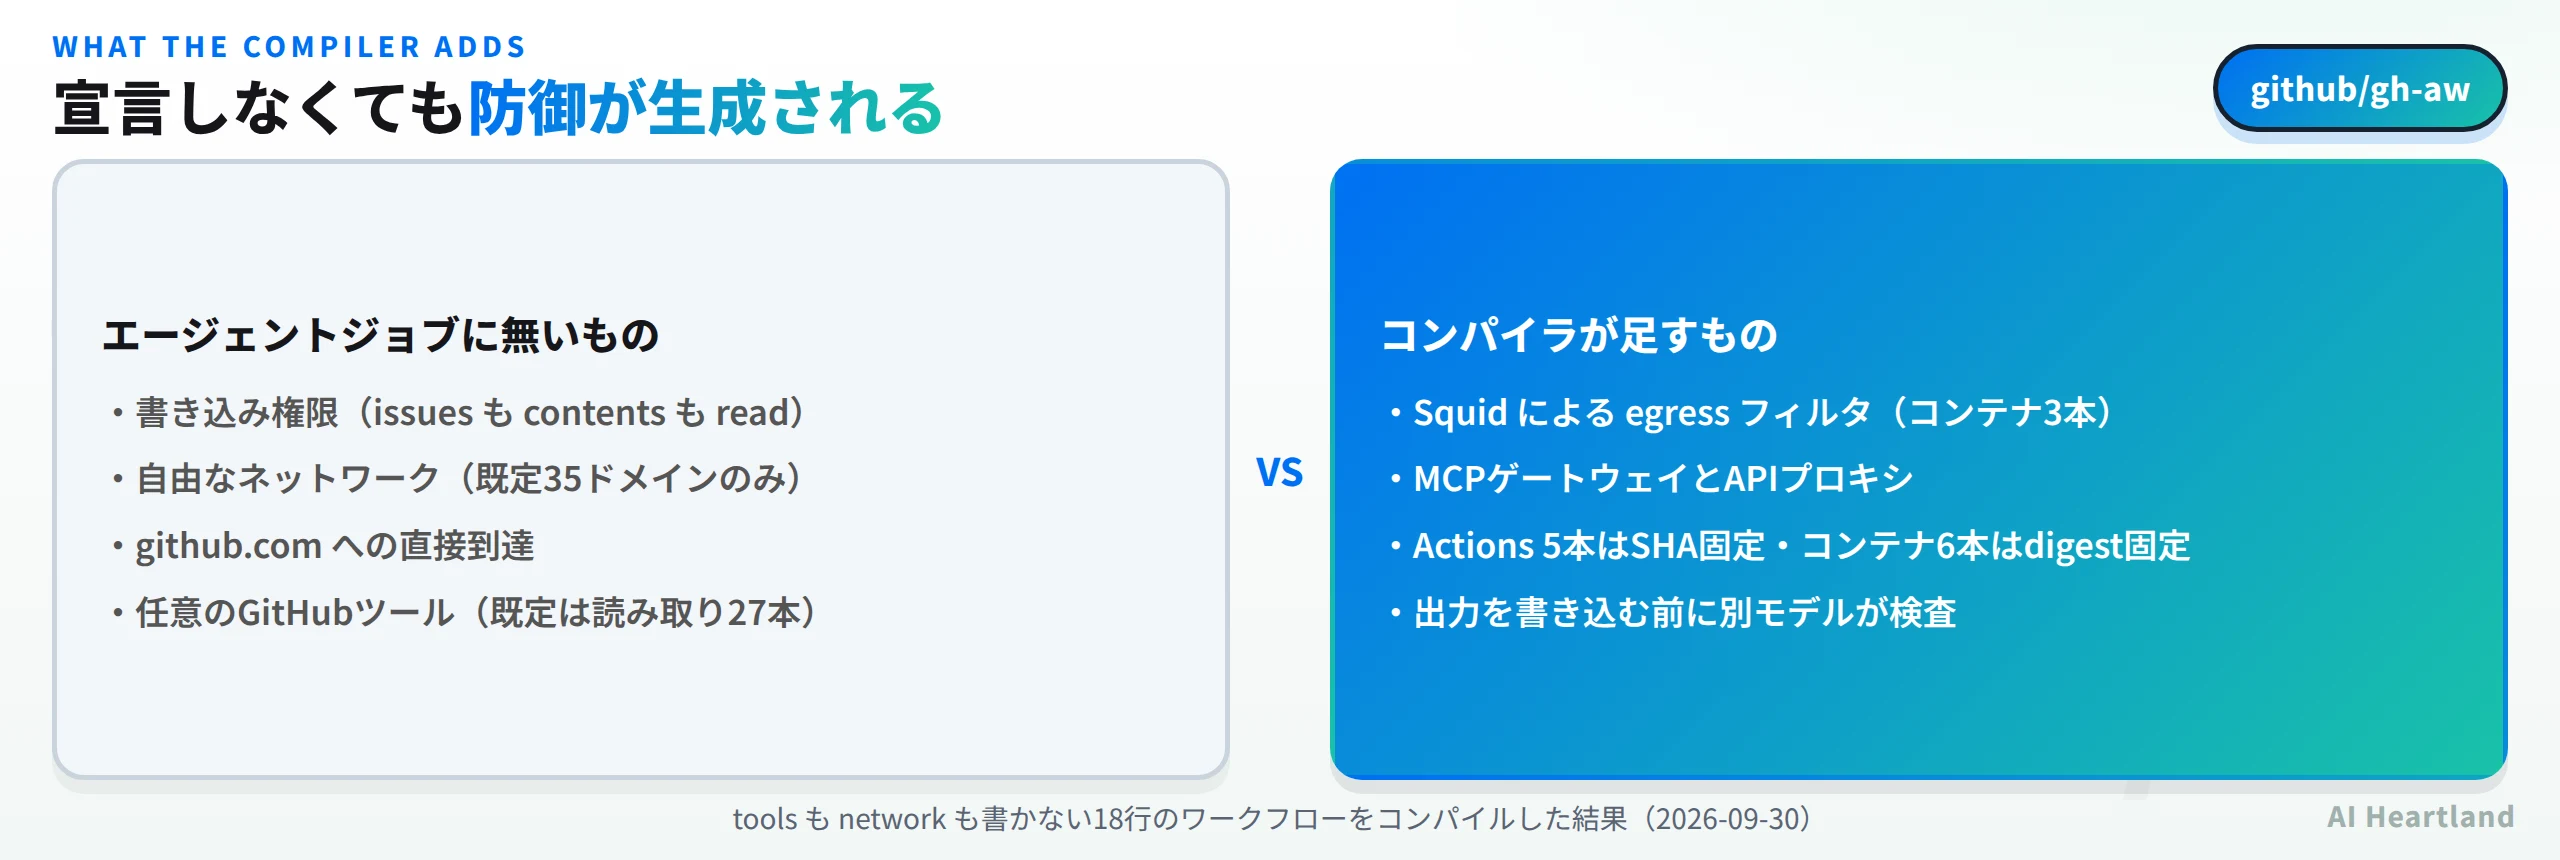
生成物の2行目には # gh-aw-manifest: というJSONのコメントがあり、そのワークフローが引くものが全部列挙されている。内訳はこうだった。
| 種類 | 件数 | 固定方法 | 中身 |
|---|---|---|---|
| GitHub Actions | 5 | SHA固定 | checkout v7.0.1 / download-artifact v8.0.1 / github-script v9.0.0 / setup-node v7.0.0 / upload-artifact v7.0.1 |
| コンテナ | 6 | digest固定 | firewall の agent・api-proxy・squid(いずれも 0.28.27)/MCPゲートウェイ gh-aw-mcpg/gh-aw-node/github-mcp-server:v1.12.2 |
| MCPサーバ | 2 | ツール名を列挙 | github(読み取り27ツール)と safeoutputs(add_comment missing_data missing_tool noop の4つ) |
| シークレット | 6 | 名前を列挙 | GITHUB_TOKEN ほか、Copilot・MCPサーバ・OTLP用 |
すべてのActionsがSHAで、すべてのコンテナがdigestで固定されている。タグ参照は1つも残っていない。 サプライチェーン側の基本を、書き手が意識しなくても生成側が守る作りだ。
GitHub MCP の27ツールも中身を見ると徹底している。get_commit get_file_contents get_pull_request_diff issue_read list_issues list_commits search_code search_issues search_repositories——動詞が get / list / search / read しかない。create_ も update_ も delete_ も1つも無い。エージェントがGitHubに対してできるのは読むことだけで、書き込みは前述のとおり safeoutputs という別のMCPサーバの4ツール(add_comment missing_data missing_tool noop)に限られる。missing_data と missing_tool が用意されているのが実務的で、「必要な情報が無い」「必要な道具が無い」をエージェントが構造化して報告できるようになっている。勝手に推測で埋めるより、足りないと言わせるほうが運用しやすい。
ネットワークは Squid のコンテナで挟まれ、許可ドメインの既定値は35件だった。中身は archive.ubuntu.com security.ubuntu.com packages.microsoft.com ppa.launchpad.net といった配布元と、ocsp.digicert.com crl3.digicert.com のような証明書の失効確認先ばかり。つまりランタイムを組み立てるのに要る通信しか開いていない。
そして、この35件に github.com は入っていない。GitHubへのアクセスは直接ではなく、digest固定された github-mcp-server と MCPゲートウェイ経由になる。だから「読み取り27ツール」という制限が実効性を持つ。エージェントが curl https://api.github.com/... を思いついても、そもそもegressで止まる設計だ。
APIプロキシ側にも上限が入っていた。maxRuns: 500、maxCacheMisses: 5、そして環境変数で渡される maxAiCredits。モデルの割り当て表は sonnet gpt-6 gemini-pro などのエイリアスをプロバイダのパターンへ展開する形で、どのモデルを呼べるかもプロキシ側で決まる。
なお、gh-aw は2026年8月に「GitLost」と名付けられたプロンプトインジェクションの実演対象になっている(当サイトでも「GitHub Agentic Workflows 脆弱性『GitLost』|公開Issueで漏洩する仕組みと対策」として扱った)。今回見た権限分離と検査ジョブが、その事案への対応として入ったものか元からの設計かは、当記事では確認できていない。分かるのは、2026-09-30時点の生成物には上記の防御が既定で入っているということだけだ。エージェントに何を読ませ何を触らせないかという設計の勘所は、Devtron Intelligence解説|K8sのSRE向けAIエージェントは何を読み何を触らないかで別の題材でも扱っている。
フロントマター+指示 18行"] --> B["gh aw compile
0.26秒"] B --> C[".lock.yml
1,905行・6ジョブ"] C --> D["agent ジョブ
read 権限のみ・44ステップ"] D --> E["成果物として出力
コメント本文など"] E --> F["detection ジョブ
小さいモデルで検査"] F --> G["safe_outputs ジョブ
issues write を持つ唯一の役"] H["Squid egress フィルタ
既定の許可は35ドメイン"] --> D I["MCPゲートウェイ
GitHub 読み取り27ツール"] --> D
300本のワークフローで測った生成量
自分で作った1本だけでは偏るので、GitHub自身のリポジトリで測った。.github/workflows/ には .md と .lock.yml が300組あり、加えて通常のActionsワークフローが38本入っている。gh-aw は自分自身を自分で運用している。
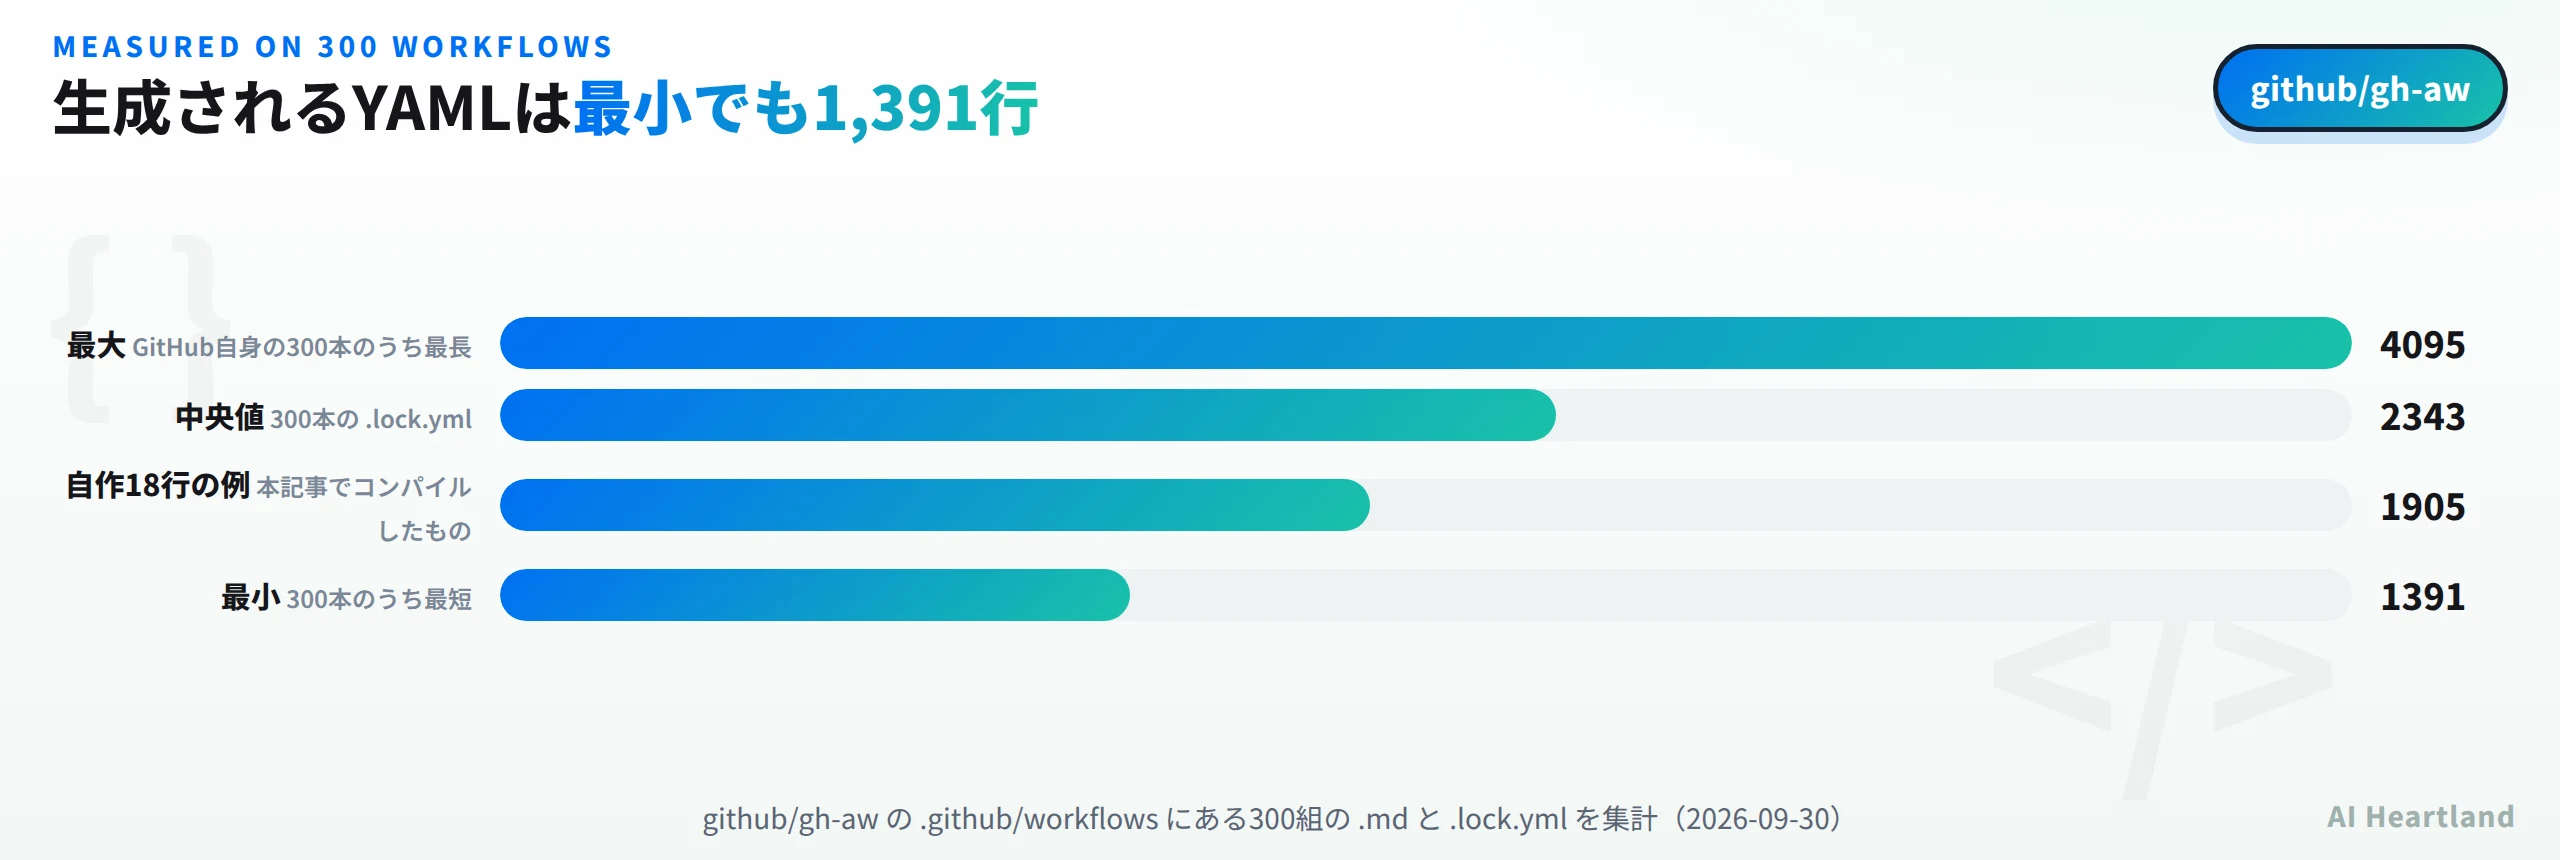
300組の合計は、Markdown 側が 84,520行、生成物側が 711,169行。行数の倍率は中央値で 9.9倍、最小2.4倍・最大44.8倍だった。生成物そのものの行数は中央値2,343行、最小でも1,391行、最大4,095行。倍率が大きく散るのは、元のMarkdownが長ければ倍率が下がるだけの話で、生成物には1,400行前後の固定費があると読むほうが実態に合う。実際、39行のMarkdownが1,407行になっている例があった。
300本のフロントマターを集計すると、実運用でどのキーが使われているかも見える。permissions が299本、on が298本、description 293本、tools 289本、timeout-minutes 288本、engine 284本、imports が284本、safe-outputs が261本、private 238本、strict 198本、そして network: を明示しているものが178本あった。つまりGitHub自身は、既定の35ドメインでは足りない仕事のほうが多く、そのたびに開ける先を書いている。imports が284本というのも示唆的で、共有の断片(shared/*.md)を読み込んで組み立てるのが標準的な書き方になっている。1本ずつ書き下ろす道具ではない。
エンジンの指定は、205本が engine: をオブジェクト形式(id: 以下でモデルやプロバイダまで指定)で書き、残りが文字列1行で claude 36本・pi 19本・copilot 19本・codex 4本という内訳だった。モデルを固定したい場面ではオブジェクト形式が使われているということで、engine: copilot の一行で済ませた本記事の例はむしろ最小構成にあたる。
ワークフロー名を眺めると、何に使っているかも分かる。auto-triage-issues(Issueの自動仕分け)、ci-coach・aw-failure-investigator(CI失敗の調査)、code-simplifier・breaking-change-checker(コードレビュー補助)、daily-action-setup-security-audit(Actions設定のセキュリティ監査)、そして agentic-token-audit・agentic-token-optimizer・agentic-token-trend-audit というトークン消費の監査系が3本。エージェントを走らせるコストを、エージェントに監査させている。当サイトがPR本文に工程別トークン消費の表を載せているのと同じ問題意識が、もっと自動化された形でここにある。
この数字の意味は、運用にそのまま跳ね返る。ワークフローを1本増やすたびに、レビューできないYAMLが2,000行前後リポジトリに入る。.lock.yml は人が読んで直すものではなく、gh aw compile の出力としてコミットされる生成物だ。差分レビューは実質「再生成した結果と一致するか」の確認になる。CIがPRへ成果物を貼る仕組みを持つ screenmapとは|Expo/React NativeのPRで変わった画面をCIが撮ってレビューに貼るOSS のような道具と同じで、生成物をどう扱うかを先に決めておく必要がある。
検証環境:Linux 6.18.44/Go 1.26.8/2026-09-30。github/gh-aw を git clone --depth 1 し(既定ブランチ main・最終コミット 122b405・2026-09-29)、go build -o gh-aw ./cmd/gh-aw でバイナリ(52.6MB)を作った。空のgitリポジトリに自作の18行のワークフローを置いて compile を実行し、生成された .lock.yml を行数・ジョブ数・ステップ数・ジョブ別 permissions・埋め込みマニフェストの観点で解析している。safe-outputs を削った版も同じ手順でコンパイルし、差分を取った(陰性対照)。300組の集計は .github/workflows のファイルをそのまま数えた。未検証:ワークフローを実際にGitHub Actions上で走らせていない。当環境からはActionsもモデルAPIも叩けないため、エージェントの実行結果、検査ジョブが実際に何を弾くか、Squidのフィルタが実行時に効くか、課金(maxAiCredits の実挙動)はいずれも未確認。プロンプトインジェクション耐性も攻撃入力での検証はしていない。star 5.2k・fork 564・open issues 436 はリポジトリページの表示値。
gh-awを入れる前に押さえる点
・生成物をコミットする方式:.md を直したら必ず gh aw compile して .lock.yml も一緒に入れる。片方だけのPRは動作が食い違う
・1本あたり2,000行前後:ワークフローが増えるとリポジトリの行数が急に膨らむ。レビュー方針(再生成一致の確認で足りるか)を先に決める
・エージェントに書かせない設計:既定で agent ジョブは read のみ。書き込みは safe-outputs に宣言した種類だけ。ここを緩めると設計の前提が崩れる
・ネットワークは既定で閉じている:許可35ドメインに github.com は無い。外部APIを叩かせたいなら network: で明示的に開ける(gh aw domains で一覧できる)
・検査ジョブは出力があるときだけ:safe-outputs を外すと detection も消える。読むだけのワークフローには検査が付かない
・エンジンは5種類:claude・codex・copilot・gemini・pi。既定のモデル割り当てはAPIプロキシ側の表で決まる
・open issues 436件:star 5.2k に対して未解決が多い。タグは497本あり、当記事時点の最新は v0.90.0。動きは速い
・Goで約90万行:3,229ファイル。挙動が気になるなら読める規模ではあるが、小さくはない
・課金はワークフロー側でも絞れる:APIプロキシに maxRuns maxCacheMisses maxAiCredits の上限が埋め込まれる
総括。 gh-aw の面白さは「MarkdownでAIの仕事を書ける」ことよりも、書き手が意識しない部分をコンパイラが埋めるところにある。権限を絞るのも、Actionsをコミットハッシュで固定するのも、外向き通信を閉じるのも、本来は人が忘れがちな作業だ。それを「宣言しなかったら安全側」に倒した生成器として実装したのが、この道具の本体だと思う。18行に対して1,905行という比率は、その固定費そのものだ。
裏返すと、読めないものを大量にコミットするという代償がある。生成物は人が直す対象ではないし、直せば次のコンパイルで消える。だから導入の判断は「Markdownが書きやすいか」ではなく、「2,000行の生成物をリポジトリに置き続ける運用に耐えられるか」で決まる。試すなら、まず本記事と同じことをやるのが早い。18行書いてコンパイルし、出てきた .lock.yml の permissions と GH_AW_ALLOWED_DOMAINS を自分の目で見る。それだけで、この道具が何を守ろうとしているかは分かる。そこで納得できなければ、Markdownの書き味がどれだけ良くても採用は見送ったほうがいい。
参照ソース
・github/gh-aw(公式リポジトリ) — README・cmd/gh-aw・pkg/workflow/・.github/workflows/ を 2026-09-30 に確認
・github/gh-aw-firewall — 生成物が digest 固定で引く Squid・api-proxy・agent イメージの出どころ
・github/github-mcp-server — 生成物が読み取り27ツールに限定して使うGitHub MCPサーバ