Decisions API は、OpenAI が 2026-09-29 の DevDay で発表した「文章を生成しないAPI」だ。開いたプロンプトに自由文で答えさせる代わりに、コンテキストとあらかじめ決めた選択肢を渡し、どれが最も確からしいかを確率つきで受け取る。狙いは明快で、TypeSafe AI の Jev(2026-09-15 発表の System One モデル)が作った市場への対抗馬だ。ただし調べ始めて最初に分かったのは、もっと手前の話だった——現時点では、書けるコードが無い。
- ・OpenAIが DevDay 2026-09-29 に発表。GPT-6 Luna 派生・限定プレビュー・**技術文書は未公開**
- ・対抗馬とされる Jev の System One は **OpenAPI 0.2.0 が公開済み**で、第三者実装もある
- ・**同じ名前で中身が違うものが複数ある**。SGLangの `/v1/decisions` は「OpenAI APIの一部ではない」と明記
- ・仕組みは共通:生成せず、回答位置のラベル1トークンの対数確率だけを読む。出力トークンは0
- ・SGLangのスキーマを抜き出して**15ケースの陰陽対照**で検証し、公称どおりの拒否を確認
- ・`confidence` は確率ではない。2択で0.7/0.3でも**0.40**になる
LLM全般の仕組みや使い分けはLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめてある。本記事はその枝として、「文章を返さないモデル」のAPI契約がいま何処まで揃っているかを見る。
Decisions APIとは:発表されたもの、まだ無いもの
まず確定している事実から。OpenAI は DevDay 2026(2026-09-29)で Decisions API を発表した。GPT-6 Luna の専用版で動き、テキストまたは画像のコンテキストと、開発者が定義した有限の選択肢を受け取る。返すのは自由文ではなく、どの選択肢が最も確からしいかと、その確信度。想定用途はコンテンツの分類、リクエストのルーティング、エージェントの次の一手の選択だ。発表時点では限定プレビューで、広い提供は「近日」とされている。
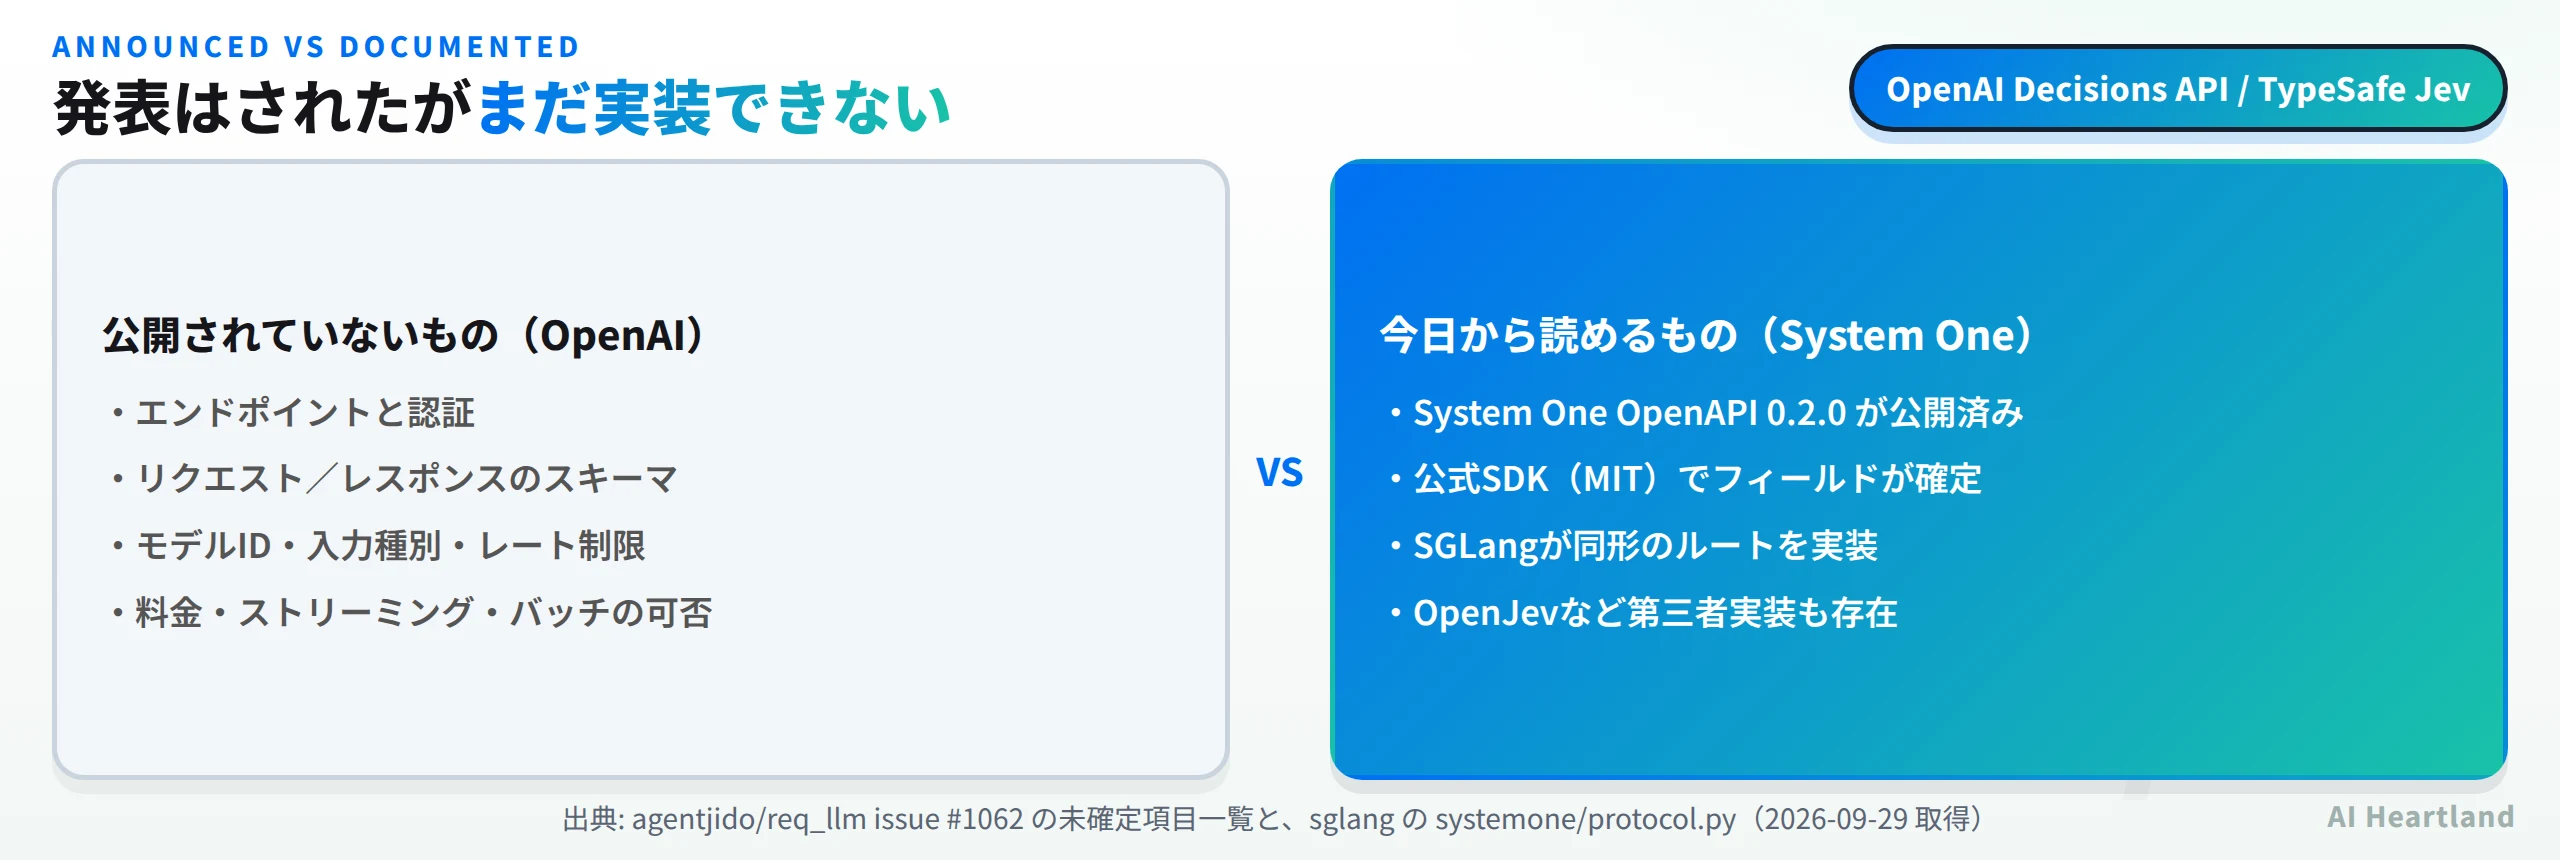
ここまでは発表の内容であって、実装に必要な情報ではない。その差がはっきり出ているのが、Elixir の LLM クライアント req_llm に立った課題だ。Decisions API 対応を追跡する issue #1062 は、着手前に必要なものとしてこう並べている——エンドポイントと認証、プレビューへのアクセス手順、モデル識別子と対応する入力種別、リクエストスキーマ、レスポンススキーマ・エラー・レート制限・usage フィールド、料金、ストリーミングとバッチの可否。そして課題本文には、実装者としての釘が刺してある。
他プロバイダの Decisions の契約をコピーしてはならない。通常の構造化生成を OpenAI Decisions 対応として提示してはならない。
つまり発表から契約公開までの間は、正直な実装者は待つしかない。当記事の環境からは openai.com へ到達できず公式ページそのものは読めていないが、少なくとも「公開された技術文書を見つけられていない」という判断は、独立して実装しようとした第三者の記録として残っている。
料金も不明だ。ここは後で効いてくる要素なので、先に触れておく。決定モデルの売りは1判定あたりの安さと速さで、生成モデルで同じことをやるより桁で安くなければ使う理由がない。その数字が出ていない以上、現時点では採用可否の判断材料が揃っていない。プレビュー枠に応募するかどうかも、そこを見てからで遅くない。
同じ名前で中身が違うものを切り分ける
調べていて一番厄介だったのが、「Decisions API」という語が指すものが複数あることだった。コード検索をかけると /v1/decisions の実装が大量に出てくるが、その大半は OpenAI のものではない。
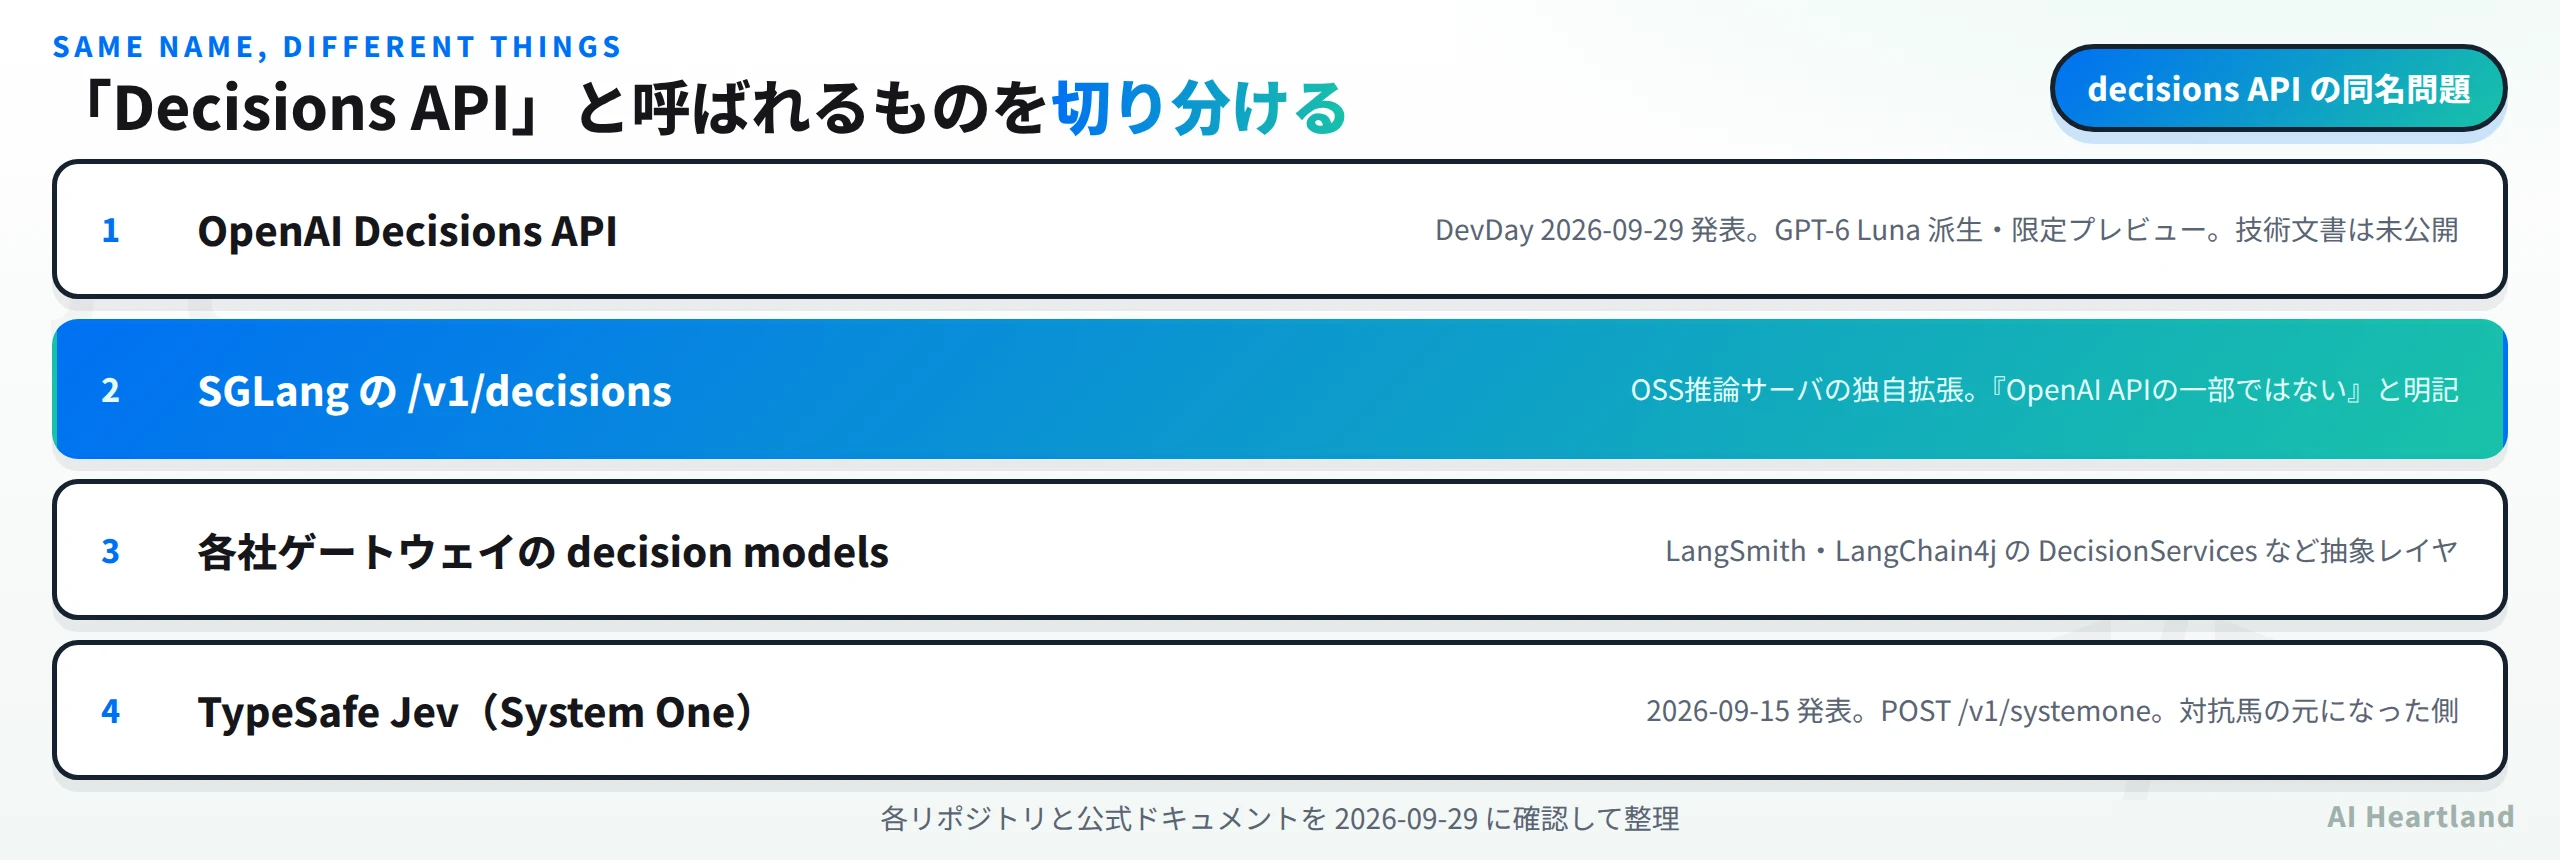
最も紛らわしいのが SGLang の /v1/decisions だ。これは OSS の推論サーバが持つ独自拡張で、ドキュメントに注記がはっきり書いてある——「/v1/decisions は /v1/score や /v1/rerank と同じ /v1 配下の SGLang 拡張である。OpenAI API の一部ではないので、OpenAI SDK のメソッド経由ではなく HTTP で呼ぶこと」。名前が同じなだけの別物で、しかもこちらは今日ソースを読めるし動かせる。
3つ目の系統が、フレームワーク側の抽象だ。LangChain の LangSmith は「decision models」としてゲートウェイに組み込み、Java 側では LangChain4j に DecisionServices を足す変更が進んでいる。後者は Java のインターフェースにアノテーションを付けて宣言する形で、@Decide("Is this message spam?") boolean isSpam(String message) のように書くと yes/no を、Choice<Team> route(String ticket) と書くと選択肢つきの答えを返す。どのバックエンドの契約を実装したかは明言していない——ここでも、抽象だけが先に整って中身が後追いという構図になっている。
そして対抗馬の元になった側、TypeSafe の Jev がある。当サイトでは発表直後にJevとは|文章を返さないSystem Oneモデルの正体を公式SDKのコードで実測し、Claude Codeで試すで公式SDKのコードから契約を確かめ、自前GPUで同じAPIを提供するOpenJevとは|Jev互換のSystem One決定サーバを自前GPUで動かすOSSをソースで実測も別に扱った。さらに別系統の判定モデルとの違いはLayaとJevの違い|文章を書かない判定モデル2系統を入手性・実行場所・検証可能性・制約で比べるにまとめてある。
分類・ルーティング・次の一手"] --> B["抽象レイヤ
LangSmith / LangChain4j DecisionServices"] B --> C["System One 契約
OpenAPI 0.2.0 が公開済み"] B --> D["OpenAI Decisions 契約
未公開"] B --> E["SGLang 独自契約
v1/decisions"] C --> F["TypeSafe Jev
ホスト型"] C --> G["OpenJev / SGLang
自前GPUで同じ形"] D --> H["GPT-6 Luna 派生
限定プレビュー"] E --> G
実測:SGLangの2つのルートをスキーマ15ケースで確かめる
ここからは手を動かす。SGLang は同じサーバで2つの契約を出している——独自形の /v1/decisions と、System One 互換の /v1/systemone だ。後者はドキュメントが「TypeSafe の公式SDKを含め、そのAPI向けに書かれたクライアントは base URL を向けるだけで判定を受け取れる」と書いている。つまり Jev 用に書いたコードが、そのまま自前サーバで動くという主張になる。
GPUが無いので推論そのものは回せない。代わりに、契約の定義だけを取り出して検証した。SGLang 本体の python/sglang/srt/entrypoints/openai/protocol.py と python/sglang/srt/entrypoints/systemone/protocol.py から決定APIに関わる pydantic モデルを逐語で抜き出し、陽性対照と陰性対照を15ケース通している。
# sglang main から契約定義だけを取得(2026-09-29)
curl -sO https://raw.githubusercontent.com/sgl-project/sglang/main/python/sglang/srt/entrypoints/openai/protocol.py
curl -sO https://raw.githubusercontent.com/sgl-project/sglang/main/python/sglang/srt/entrypoints/systemone/protocol.py
# 決定API部分を schemas.py に写し取り、pydantic 2.13.5 で検証
python checks.py
結果はこうなった。
== /v1/decisions ==
  OK      公式ドキュメントの例(陽性対照)
  REFUSED 選択肢27個  -> ('questions',0,'choice','options'): List should have at most 26 items
  OK      選択肢26個
  REFUSED input が空白のみ  -> ('input',): Value error, must not be blank
  REFUSED 大小文字だけ違う選択肢名  -> option name 'billing ' repeats another option
  REFUSED levels 11段階  -> ('levels'): List should have at most 10 items
  REFUSED question id の重複  -> question id 'urgent' repeats another question
  REFUSED 未知のフィールド  -> ('top_p',): Extra inputs are not permitted
== /v1/systemone ==
  OK      当サイトの jev_judge.py が組む形(陽性対照)
  REFUSED temperature を足す  -> temperature is not part of this API, use /v1/decisions for it
  REFUSED instructions も criteria も無い noul  -> needs instructions or a true or false description
  OK      未知のトップレベルフィールド
  REFUSED question の中の未知キー  -> ('questions','pillar','choice','weight'): Extra inputs are not permitted
  OK      choice 255個
  REFUSED choice 256個  -> Dictionary should have at most 255 items
  OK      state が空文字
15ケースすべてがドキュメントの記述どおりだった。公式ドキュメントの例が通り(陽性対照)、境界を1つ越えた入力だけが落ちる(陰性対照)。ここで効いているのが、2つのルートの非対称さだ。/v1/decisions はトップレベルの未知フィールドを拒否するのに、/v1/systemone は無視する。逆に質問の中の未知キーはどちらも拒否する。ドキュメントはこれを「System One のスキーマがそう許しているから」と説明していて、実装が仕様に合わせて意図的に非対称になっていることが分かる。
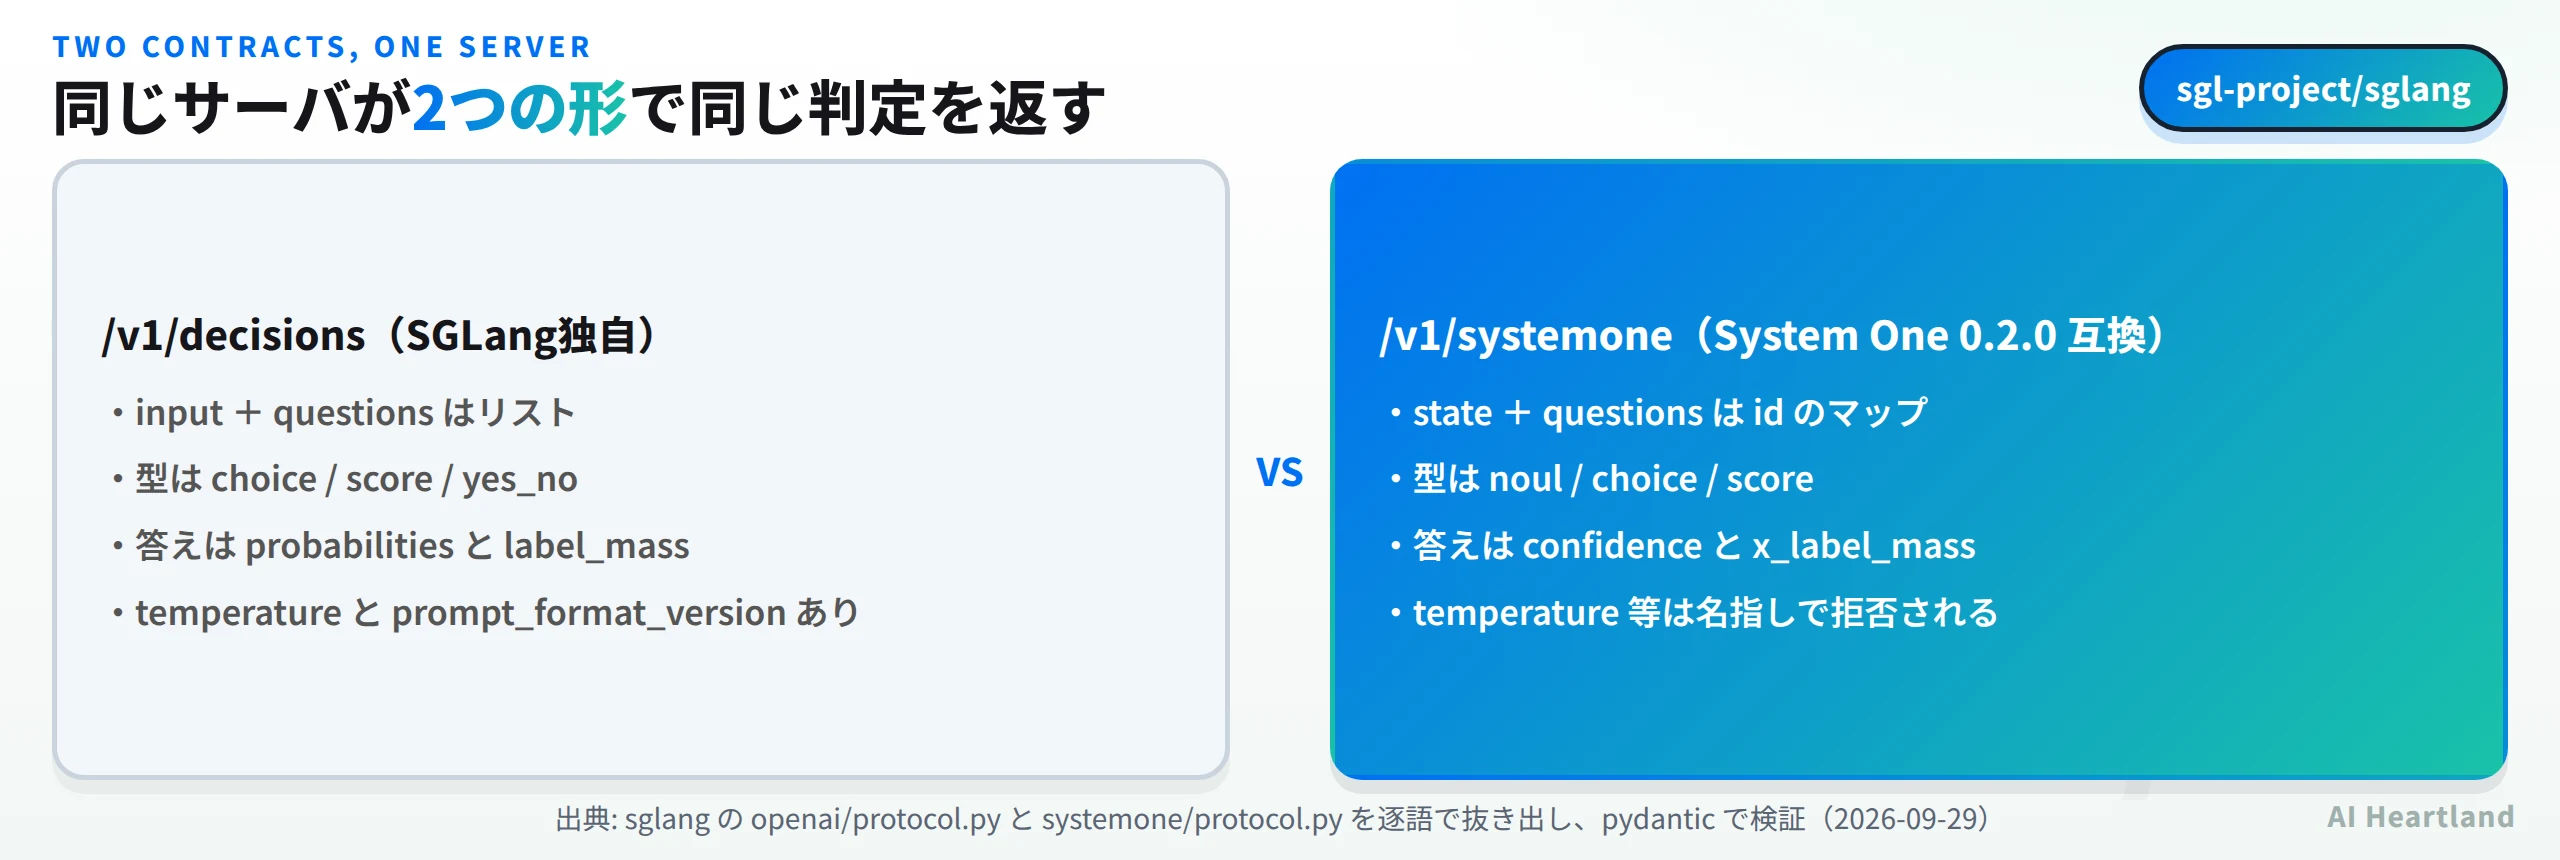
契約の差を並べるとこうなる。
| 項目 | /v1/decisions(SGLang独自) |
/v1/systemone(System One 0.2.0 互換) |
OpenAI Decisions API |
|---|---|---|---|
| 入力 | input(文字列・オブジェクト・配列) |
state(同左・空文字も可) |
不明(テキストまたは画像) |
| 質問 | questions はリスト、各要素に id |
questions はidのマップ |
不明 |
| 質問の型 | choice / score / yes_no |
noul / choice / score |
不明 |
| 選択肢の上限 | 26(ラベルA〜Z) | 255(27個目から2文字ラベル) | 不明 |
| 段階の上限 | 10(ラベル0〜9) | 10 | 不明 |
| 答えの確信度 | label_mass のみ |
confidence + x_label_mass |
「confidence score」とのみ |
| 温度 | temperature あり |
名指しで拒否 | 不明 |
| プロンプト固定 | prompt_format_version |
非対応 | 不明 |
| usage | prompt_tokens / completion_tokens 0 |
input_tokens / output_tokens 0 |
不明 |
当サイトは tools/jev_judge.py という Jev クライアントを自前で持っている(POST /v1/systemone・urllib のみ)。これをSGLangのスキーマを検証に使うローカルサーバに向けて、疎通確認コマンドをそのまま実行した。
$ TYPESAFE_BASE_URL=http://127.0.0.1:8123 python3 tools/jev_judge.py ping
### 🟣 Jev ping: ✅ 応答あり
| レイテンシ | 3 ms(1往復・3問同時) |
| model | sglang-local |
| usage | 入力 1234 / 出力 0 tokens |
| noul(AI関連OSSか) | 0.87 |
| choice(柱) | ai_oss(確信度 0.7) |
| score(記事価値 0-4) | 2.0 |
ホスト型のJev向けに書いたクライアントが、契約チェックを通り、仕様どおりの形のレスポンスをそのまま解釈できた。SGLangの主張——クライアントは base URL を差し替えるだけ——は、少なくとも契約の形については裏が取れたことになる(実際の推論を伴う照合は未検証)。
生成しない、という仕組みと confidence の罠
決定モデルが何をしているのかは、SGLangの実装を読むとそのまま書いてある。質問を1つのユーザーメッセージに整形し、思考モードを切り、選択肢に A〜Z、段階に 0〜9、yes/no という1トークンのラベルを割り当てる。各ラベルが回答位置で確かに1トークンであることを検査してから、1問につき1回の prefill を走らせ、ラベルぶんの次トークン対数確率だけを読む。生成は起きない。だから completion_tokens は常に0で、出力側の課金は原理的に発生しない。
出てくる値は2種類ある。1つが probabilities——ラベル間で正規化した確率で、合計1になる。もう1つが label_mass(System One 互換ルートでは x_label_mass)で、これは正規化前・全語彙に対するラベルの確率質量だ。実装は素直に sum(exp(logprob)) を取っている。この値が低いときは、モデルが提示された選択肢の外に確率を置いている——つまり「どれでもない」と思っている、という信号になる。選択肢設計そのものの妥当性を測る指標として使える値だ。
temperature はラベルのロジットを割ってから softmax する。語彙の正規化項が相殺するので、2択なら exp(lp_yes/T) / (exp(lp_yes/T) + exp(lp_no/T)) にきれいに落ちる。label_mass は温度の影響を受けない、と実装もドキュメントも明記している。
そして、実務で一番引っかかりそうなのが confidence だ。System One 互換ルートの confidence は、TypeSafe が公表している式に従う。選択肢が n 個で確率が正規化済みのとき、(n × max(p) − 1) / (n − 1)。つまり一様分布からどれだけ離れているかであって、確率そのものではない。自分で計算してみるとこうなる。
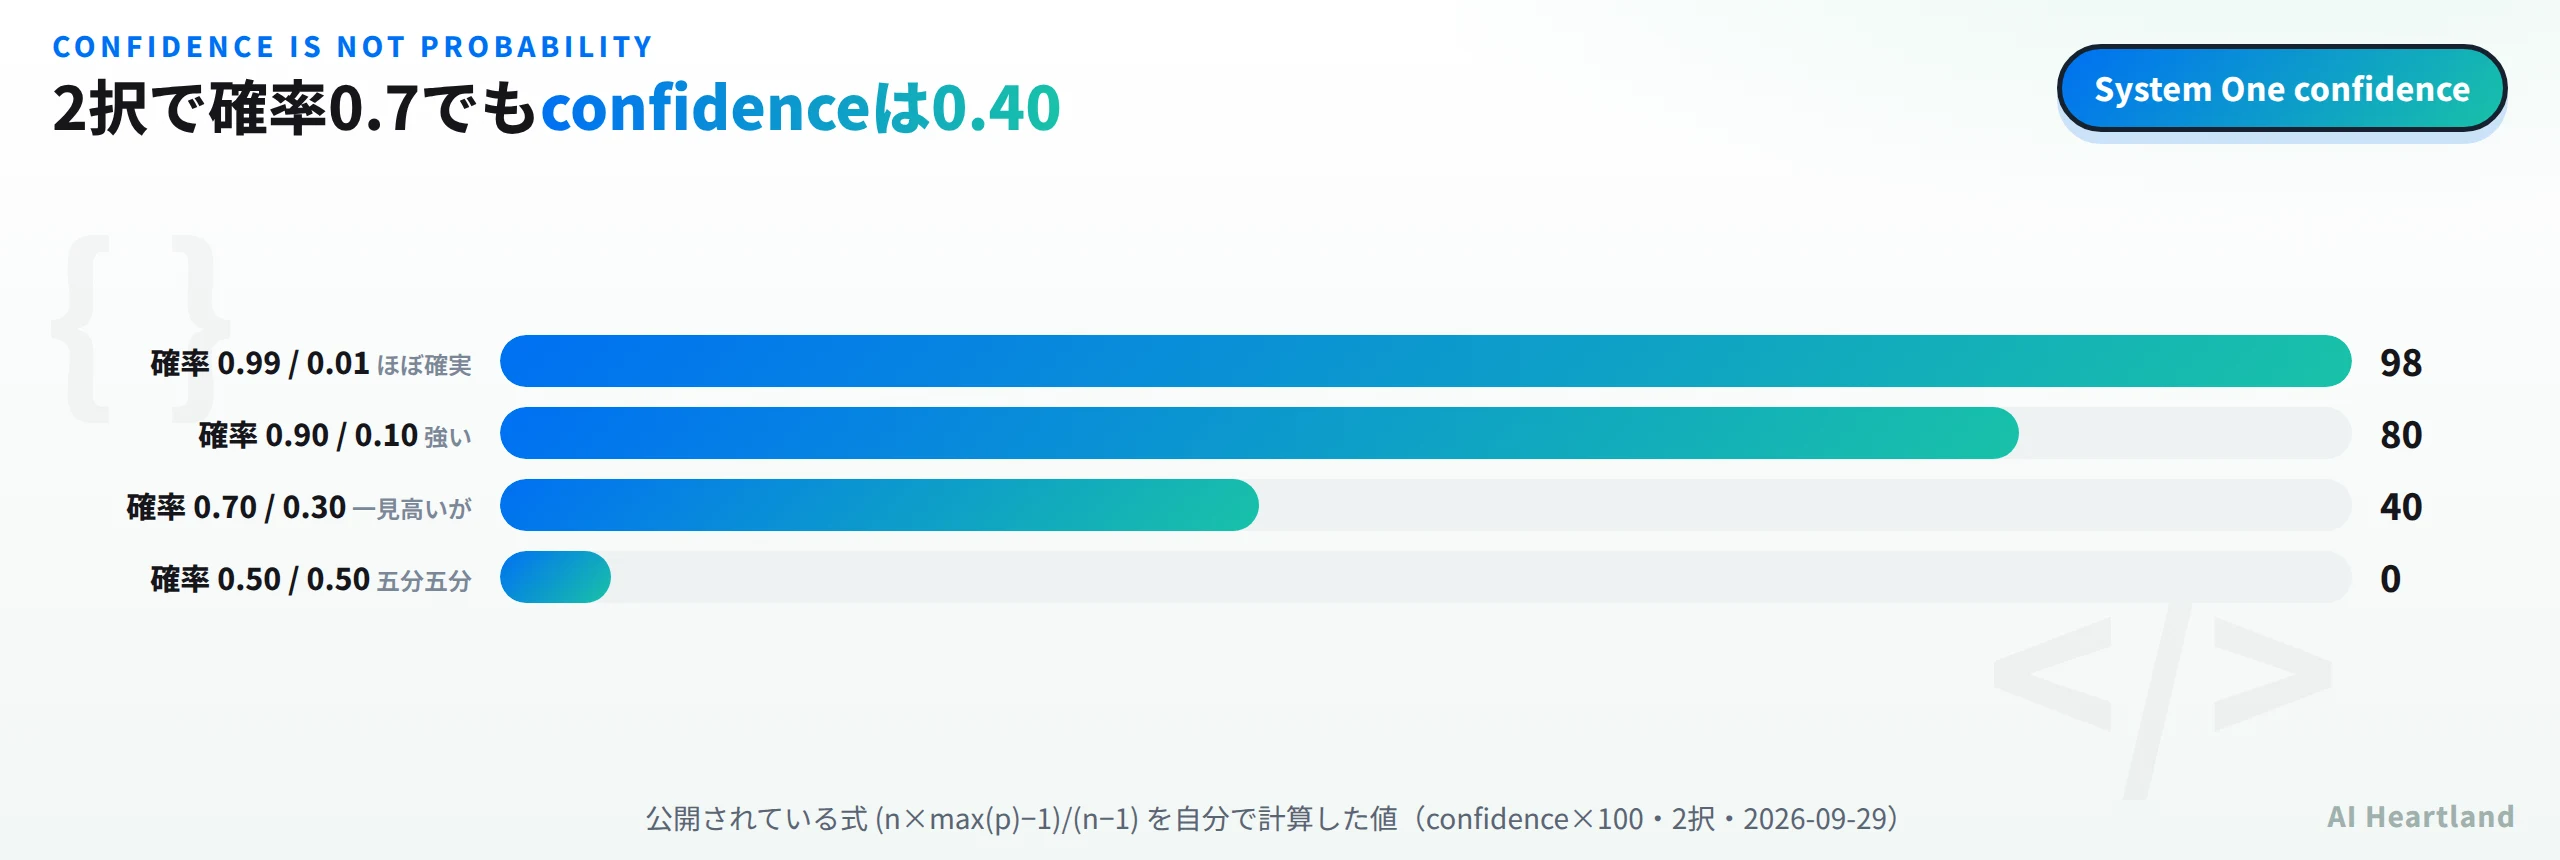
2択で確率0.7の答えは、confidence 0.40。3択で 0.7/0.2/0.1 なら 0.55 になる。「confidence 0.4 だから捨てる」という閾値を確率の感覚で置くと、実際にはかなり強い判定まで落とすことになる。
score 型にはもっと分かりにくい罠がある。score の答えは確率で重み付けした段階の平均で、confidence は「最頻の段階からの広がり」を見る。3段階で確率が [0.5, 0.0, 0.5] に割れた場合を計算すると、score は 1.00、つまり誰も選んでいない真ん中の段階を返し、confidence は 0.000 になる。ドキュメントも「離れた段階に割れた score では 0 になりうる」と書いていて、実装を写して計算した結果もそのとおりだった。平均値だけ読むと両極に割れた判定を中庸と読み違えるので、score を使うなら confidence か probabilities まで見るしかない。
検証環境:Linux 6.18.44/Python 3.11/pydantic 2.13.5/2026-09-29。sglang の main から openai/protocol.py(81,989バイト)と systemone/protocol.py(4,372バイト)、systemone/serving.py、serving_decisions.py、ドキュメント decision_models.mdx(20,247バイト)を raw で取得し、決定APIに関わる pydantic モデルを逐語で写して15ケースを検証した。confidence は実装の式をそのまま Python に写して計算している。当サイトの tools/jev_judge.py ping は、その検証スキーマでリクエストを受けるローカルサーバへ TYPESAFE_BASE_URL で向けて実行した。Jev 側の契約は公式SDK typesafe-ai/typesafe-sdk-js v0.6.0(MIT)を clone して src/client.ts・src/questions.ts・src/types.ts で確認。未検証:どちらのAPIにも実際のリクエストは送っていない。当環境の外向き通信は openai.com・api.typesafe.ai・docs.langchain.com・simonwillison.net などを遮断しており、OpenAI の公式発表ページも直接は読めていない(DevDay の内容は req_llm issue #1062 の記述による)。GPU が無いため SGLang の推論も動かしておらず、レイテンシ・精度・料金はいずれも未測定。公称の応答時間や Luna の性能も未確認。
Decisions APIはJevの対抗馬になるか
現時点の評価を、採用判断に効く順で並べる。
・契約が公開されているのは Jev 側だけ:System One は OpenAPI 0.2.0 として公開され、MITの公式SDKがあり、SGLang と OpenJev という独立した実装まで存在する。OpenAI 側はまだ発表のみで、実装者は待機している
・逃げ道の有無が違う:System One 契約を選べば、ホスト型のJevから自前GPUのSGLang/OpenJevへ base URL の差し替えで動かせる可能性がある(契約の形としては確認済み)。単一ベンダの未公開契約には現状その逃げ道が無い
・選択肢の上限が違う:SGLangの /v1/decisions は26個まで、System One 互換ルートは255個まで。ただし27個目からは2文字ラベルになり、ラベルごとの事前確率が揃わないため選択肢の順番で答えが動きうると明記されている。大きな分類体系をそのまま渡す設計は避けたい
・confidence を確率として扱わない:2択0.7で0.40。閾値は自分のデータで較正する
・score は平均値:両極に割れると中庸に見える。confidence か probabilities を併読する
・再現性は完全ではない:SGLangのドキュメントは、プレフィックスキャッシュの有無やバッチ構成で確率が最大0.07、label_mass が約0.14 動いたと自己申告している(選んだ選択肢は変わらなかった)。判定を監査ログに残すなら、この揺れを前提に閾値を置く
・プロンプト文言はサーバのもの:/v1/decisions は整形文言をバージョン管理していて、prompt_format_version を送ると黙って変わる代わりに落ちてくれる。System One 互換ルートにこの仕組みは無い
当サイト自身は Jev を CI に advisory で配線していて、初回の実データは model jev-latest / 呼び出し35回 / 入力195,953トークン / エラー0・17秒だった。このトークン数はこちらで数えたものではなく、API が usage.input_tokens として返した値で、どのトークナイザで数えているかは公開されていない(当サイトが他記事で使う tools/token_audit.py の heuristic 近似トークナイザとは別物なので、横並びの比較はできない)。ちなみに System One 契約の usage は、state を質問の数だけ重複して数える。3問投げれば state は3回計上される。1リクエストに質問をまとめても入力課金は減らないので、質問を足すときはそのつもりで見積もる必要がある。
そこで分かったのは、判定モデルの当たり外れよりも質問設計のほうが効くということだ。最初に置いた問い(記事の数値が brief から裏付けられるか)では35文中19文が flag されたが、これはモデルが外したのではなく、当サイトの手順では brief より後に一次ソースへ当たって実測するので「brief に無い数値」が出るのが正常だったからだ。問いを「brief と食い違うか」=矛盾検出に変えて解決した。
総括。 Decisions API の発表は、「文章を生成しないモデル」というカテゴリが単独ベンダの実験から一般的なレイヤへ移ったことの証拠としては十分に大きい。LangSmith や LangChain4j が抽象を先に用意しているのも同じ動きだ。ただし対抗馬として評価するには材料が足りない。速さも安さも、まず料金と契約が出てからの話になる。
今日できることに絞るなら、答えははっきりしている。System One 契約で書いて、SGLang か OpenJev で自分の環境に逃がせる形にしておく。そのうえで質問設計を自分のデータで較正しておけば、Decisions API の契約が公開された日に比較する土台が既にある。逆に、いま抽象レイヤだけ先に噛ませて中身を待つのは、較正データが貯まらないぶん遅くなる。判定モデルは、入れた時点では何の効果も出ない種類の部品だからだ。効き始めるのは、自分のデータで閾値が決まってからになる。
参照ソース
・sgl-project/sglang — decision_models.mdx・openai/protocol.py・systemone/protocol.py・systemone/serving.py・serving_decisions.py を 2026-09-29 に確認
・agentjido/req_llm issue #1062 — Decisions API 対応に必要で未公開な項目の一覧
・typesafe-ai/typesafe-sdk-js — System One の契約(v0.6.0・MIT)
・langchain4j/langchain4j PR #6526 — Java側の DecisionServices