deja-vu は、コーディングエージェントに記憶を持たせるOSSだ。ただし方向が他と逆で、新しく記憶を書かない。Claude Code や Codex、Cursor が既にディスクへ書き残したセッション記録をそのまま索引し、新しいセッションが始まったときに関連する過去のセッションを返す。Go製、MIT、star 1.1k、fork 107。当サイトが2026-09-28に分解した mem0 と Hindsight に続く3本目として、公式リリースを取得して測った。
- ・既存のセッション記録を読むだけ。**LLMも生成も使わない**ので入れた日から過去ぶんが引ける
- ・公式 v0.21.4 の linux/amd64 バイナリは **14,897,336バイト(14.2 MiB)**。持ち込まれた公称は18.6MB
- ・合成20,000セッション(70.2MB)の初回索引は **13.96秒=毎秒1,433セッション**
- ・MCPサーバーは**ツール1本・約443トークン**。Hindsightの39ツール16,603トークンと同じ物差しで37分の1
- ・`deja sources` が列挙した読み取り先は**36系統**。起動しただけで本セッションの記録を見つけた
- ・**88.1%は470問の整理版での hit@1**。全500問では87.4%で、公式指標ではないと本人が明記
エージェント基盤の全体像はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその周辺部品である「記憶」の3本目として、設計の向きが違う1本を測る。
deja-vuとは:新しく憶えず、既にある履歴を読む
発想は単純だ。Claude Code は ~/.claude/projects/ 以下にセッションの全文を JSONL で書いている。Codex も Cursor も opencode も、形式は違えど同じことをしている。その記録は既にそこにあるのに、次のセッションからは誰も読まない。 deja-vu はそこを索引するだけの道具だ。
実際に v0.21.4 を取得して deja sources を叩くと、読み取り先が列挙される。
curl -sSLO https://github.com/vshulcz/deja-vu/releases/download/v0.21.4/deja-vu_0.21.4_linux_amd64.tar.gz
tar xzf deja-vu_0.21.4_linux_amd64.tar.gz     # アーカイブ 6,132,190 バイト
./deja --version                               # deja 0.21.4
./deja sources
# claude   /root/.claude/projects/-home-user-ai-archive-jp   sessions=1 messages=1886 size=27.0 MB
# codex    /root/.codex:...                                  sessions=0 messages=0
# ...(全36行:cursor / gemini / copilot / cline / zed / aider / opencode ほか)
鍵もURLも設定していない状態で、この記事を書いている当のセッションが見つかった。1セッション・1,886メッセージ・27.0MB。インストール直後に過去が引ける、という主張はこの1行で分かる。
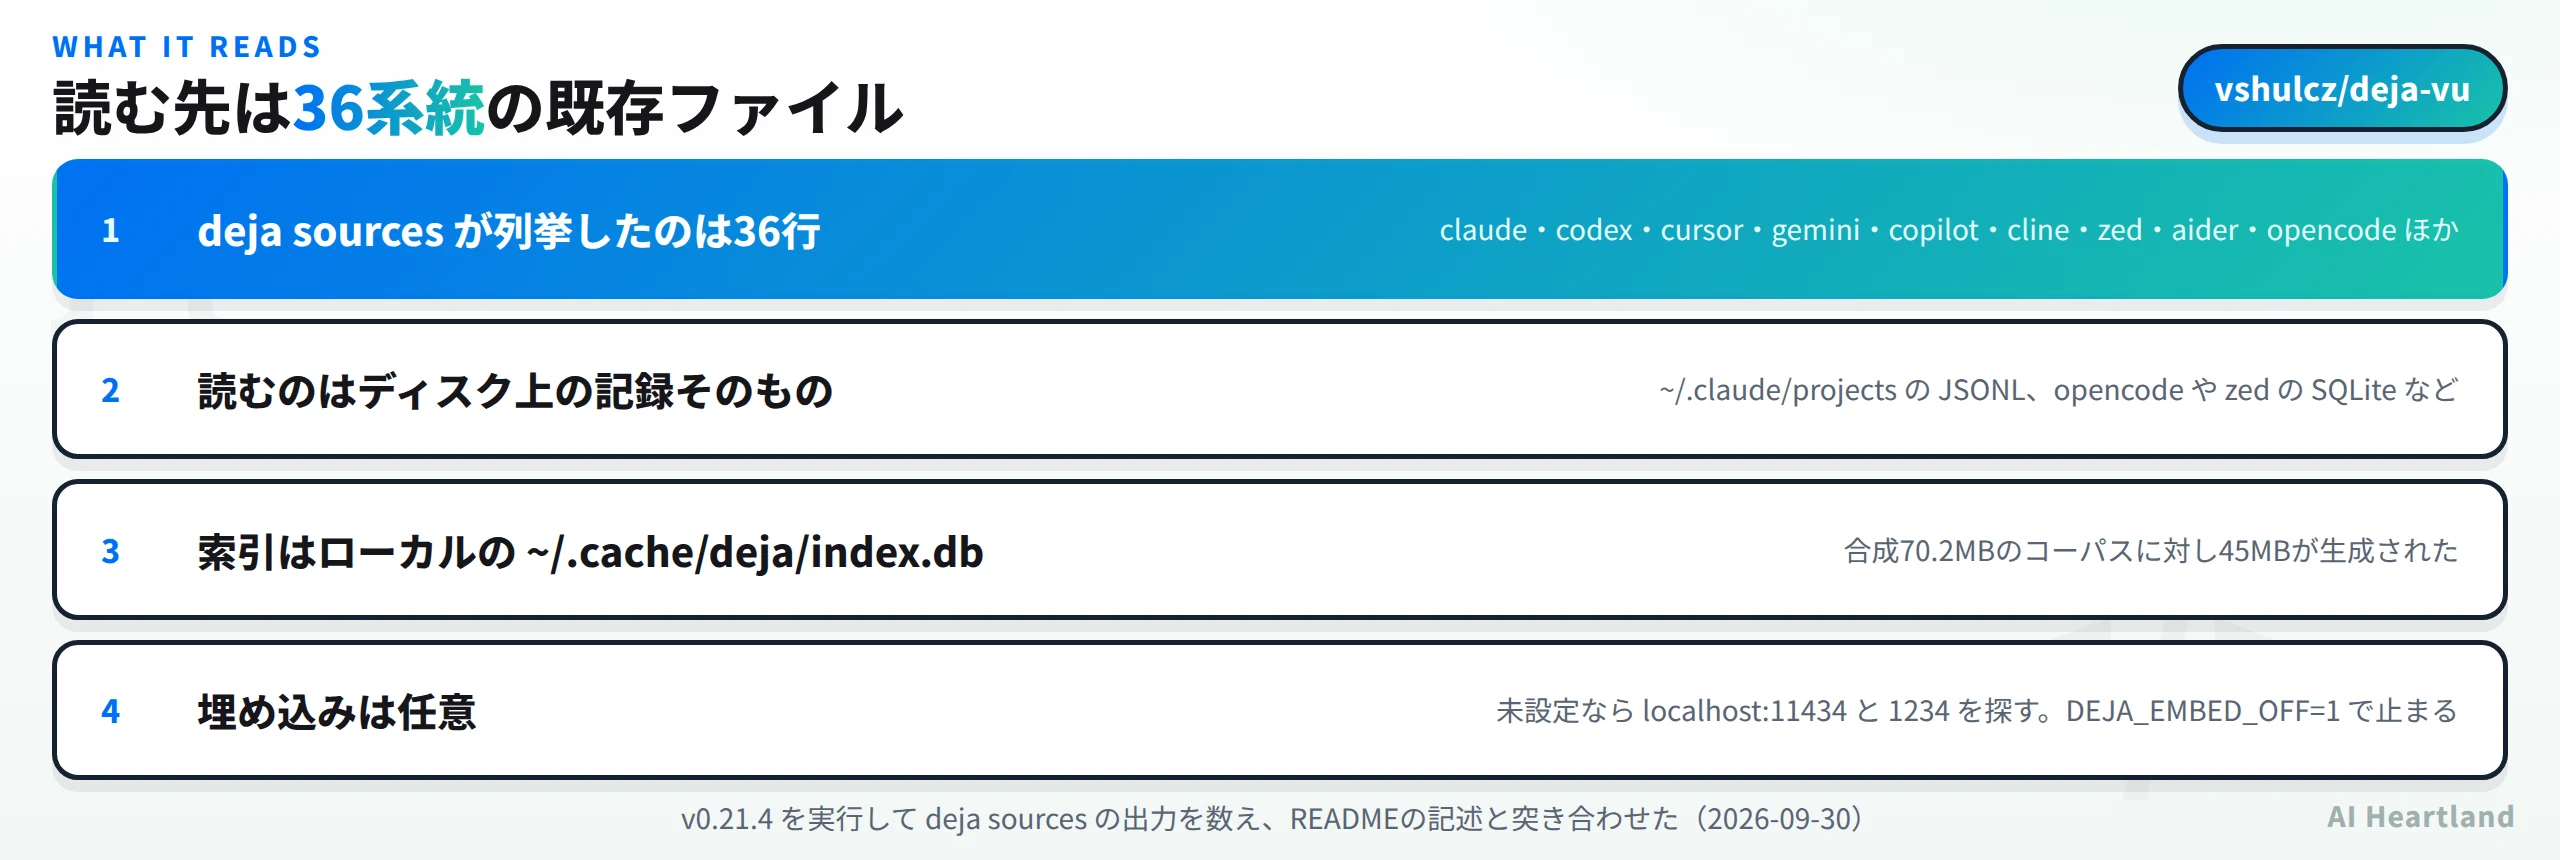
読む先は JSONL だけではない。opencode や zed は SQLite に書くので、そちらは DB を直接読む。索引の置き場所は ~/.cache/deja/index.db で、ネットワークには出ない。
36という数は、対応表を眺めるとエージェントの世代がそのまま並んでいるのが分かる。Claude Code・Codex・Cursor・Gemini CLI・GitHub Copilot といった主要どころに加えて、Cline・Roo・Kilo Code・Continue・Aider・Zed・Crush・Goose・opencode まで入る。裏返すと、これは「エージェントを乗り換えても履歴は残る」ことに賭けた設計でもある。ツールを替えるたびに記憶がゼロに戻る問題を、記憶の側ではなく読み取りの側で吸収しようとしている。対応表には各ハーネスについて、MCP想起・自動想起・スキル・コマンド・再開・引き継ぎのどれが使えるかが列挙されていて、ハーネスごとに実装の濃淡があることも隠していない。
既にディスクにある記録 36系統"] --> B["deja index
JSONL と SQLite を読む"] B --> C["ローカル索引
cache/deja/index.db"] C --> D["deja クエリ
語彙検索でセッションを順位付け"] C --> E["MCPサーバー
ツール1本・約443トークン"] C --> F["フック
セッション開始時と毎プロンプト"] D --> G["関連する過去のセッションを返す
生成はしない"] E --> G F --> G
生成が一切ないので、返ってくるのは過去の発話そのものだ。要約でも抽出された「事実」でもない。ここが mem0 や Hindsight との決定的な違いで、記録に無いことは絶対に出てこない代わりに、出てきたものは必ず実在した発話になる。
公称値を測り直す:14.9MBと毎秒1,433セッション
持ち込まれた数値は3つあった。順に測る。
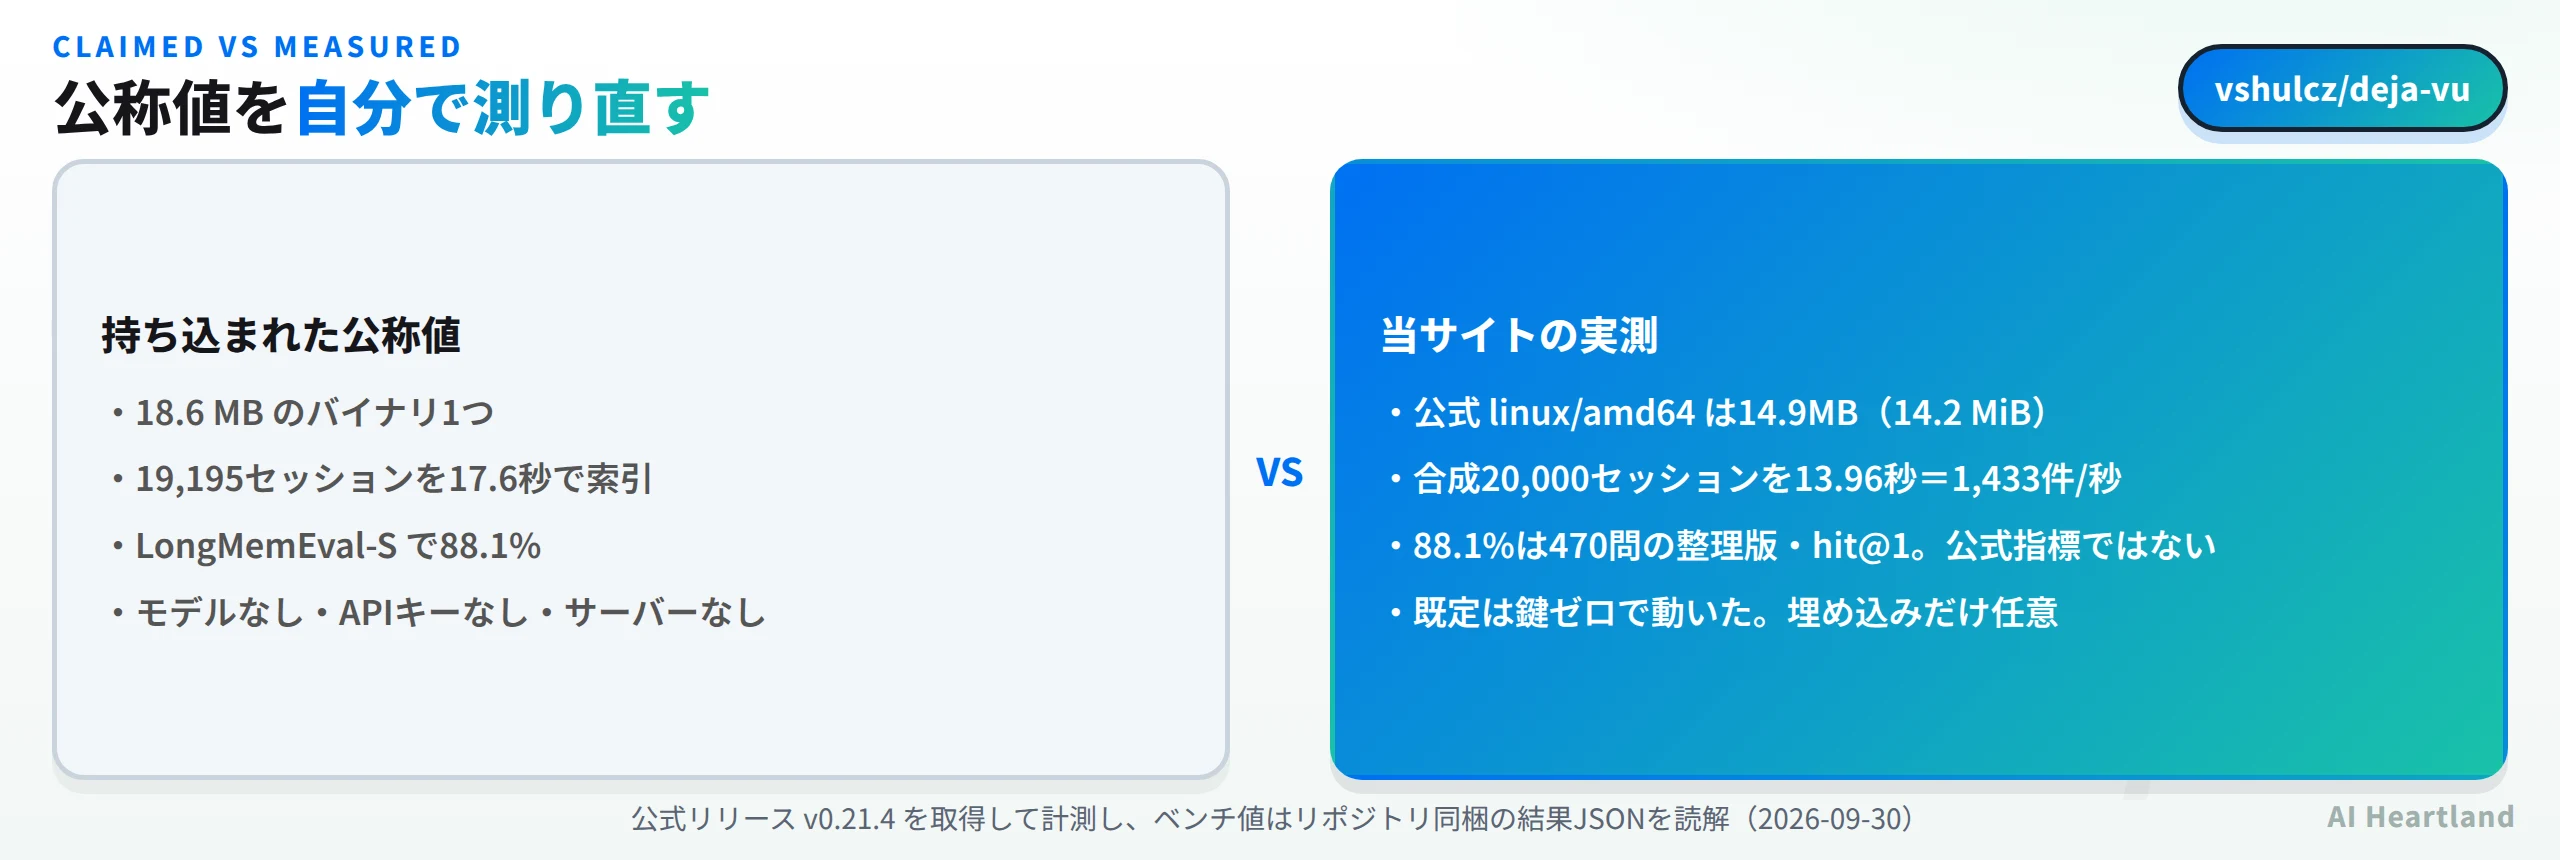
バイナリのサイズ。 公式リリースの linux/amd64 を展開すると 14,897,336バイト(14.2 MiB/14.9 MB)。公称の18.6MBより小さい。念のため自分でも CGO_ENABLED=0 go build -trimpath -ldflags="-s -w" でリリース相当をビルドすると 14,807,224バイトで、公式アーカイブ内のバイナリと0.6%差に収まった。配布アーカイブ自体は linux/amd64 で6,132,190バイト、他プラットフォームも5.5〜6.3MBの範囲だった。18.6MBがどのプラットフォームやどのバージョンを指すのかは特定できていないが、少なくとも今日の linux/amd64 では公称より軽い。
索引の速度。 19,195セッションという実コーパスはこちらには無いので、同じ形のものを作って測った。Claude Code の JSONL 形式で20,000セッション・200,000メッセージ・70.2MBを生成し、初回索引を計時する。
deja sources
# claude  /tmp/dejabench/home/.claude/projects  sessions=20000 messages=200000 size=70.2 MB
time deja index
# deja: claude: 20000 sessions, 200000 messages
# deja: searchable now with the 200 most recent sessions while the rest is indexed
# real  0m13.957s
13.96秒=毎秒1,433セッション。 公称は19,195セッションを17.6秒なので毎秒1,090セッション。当方の合成セッションは1本あたり10メッセージと小さいため速く出て当然で、この2つを直接比べることはできない。言えるのは桁が合っていることと、途中経過として「最新200セッションは索引中から既に検索できる」と表示される設計になっていることだ。参考までに、本物の記録である当セッション(1,888メッセージ・27.0MB)の索引は2.17秒だった。
返ってくる形も見ておきたい。検索結果はセッション単位にまとまり、ハーネス名・プロジェクト・日付・セッションIDの先頭と、そのセッション内でヒットした行が数本並ぶ。合成コーパスで deja "goroutine leak" を叩くと、冒頭に deja: showing 15 of 2000 — add --all to see the rest と出たうえで、[claude] user/proj49 · Jan 14 · f8b9fe06-…8bcd8243eb — 40 matches のような見出しに続けて該当行が並んだ。要約ではなく、当時そこに書かれていた文がそのまま出てくる。 エージェントに渡すにせよ人が読むにせよ、出典のセッションIDが必ず付くので deja show <id> で前後を確認できる。
検索も測った。20,000セッションの索引に対し、1クエリが2,000セッションにヒットする条件で、プロセス起動から表示までの端から端で0.73〜0.81秒。プロジェクトが公称する約0.2秒は2,419セッションの実ストアでの値なので、これも条件が違う。索引の大きさは70.2MBのコーパスに対し45MBだった(公称は「コーパスの約10%」だが、当方の合成コーパスは短い文が大量に並ぶ構造なので比率は比較対象にならない)。
鍵とサーバー。 ここまでのすべてを、APIキーもエンドポイントも設定せずに実行している。埋め込みによる意味検索だけが任意機能で、READMEによれば DEJA_EMBED_URL 未設定時は localhost:11434(Ollama)と localhost:1234(LM Studio)を探しに行き、DEJA_EMBED_OFF=1 で止められる。外部に出る既定の通信は見当たらなかったが、当環境は外向き通信が絞られているため「出ないことの証明」まではしていない。
88.1%が指しているもの
3つ目の数値は性質が違うので節を分ける。持ち込まれた文面は「LongMemEval-Sで88.1%のヒット率」だった。リポジトリには結果JSONが同梱されていて、そこを読むと内訳がはっきり書いてある。
| 実行 | 問題数 | hit@1 | hit@5 | hit@10 | MRR | 実行時間 |
|---|---|---|---|---|---|---|
| LongMemEval-S(整理版) | 470 | 88.085% | 97.447% | 98.723% | 0.920 | 114.6秒 |
| LongMemEval-S(全問) | 500 | 87.4% | 97.2% | 98.6% | 0.915 | 116.2秒 |
| LoCoMo | 1,982 | 70.535% | 90.918% | 95.610% | 0.794 | 10.6秒 |
つまり 88.1% は470問に整理した版での hit@1 で、全500問なら87.4%になる。差は0.7ポイントなので誇張ではないが、数字だけを引くと条件が落ちる。
もっと大事なのは、同じJSONに書かれている注記のほうだ。
hit@kは、その問題の根拠セッションのどれかが上位k件に入ったら正解とする指標である。データセットが定義する公式の指標は、根拠ごとに見るより厳しいevidence_recallである。
プロジェクト自身が「これは公式指標ではない」と明記している。 加えて LoCoMo 側の注記には「セッション単位の検索を製品の検索経路で測ったもので、LLMは1問も回答していない」とある。つまりこれらは検索が正しいセッションを引けたかの指標であって、最終的な回答精度ではない。結果JSONにはデータセットのファイル名・バイト数・sha256・実行日(2026-09-22)・使ったフラグまで記録されており、追試できる形で開示している姿勢は評価できる。数字の意味が狭いことと、開示が不誠実であることは別の話だ。
ハーネスのフラグを読むと、測っている範囲はもう少し広い。-precision は各問のプロンプトを別の問の干し草の山と組み合わせ、答えが無いのに何かを引いてしまう率を測る(陰性対照)。-answer-carry は引いてきたブロックが実際に正解の語を運べているかを、-hook-precision は自動想起のゲートが誤発火する率を数える。-dump-misses は順位が1位でなかった問題だけをJSONLで書き出し、しかも「並べ替えは何を持ち上げたかだけでなく何を落としたかと合わせて評価するべきだ」という理由で全問を書き出す -dump-all も用意されている。引けたかどうかだけでなく、引きすぎていないかを測る口が最初から付いている構成で、記憶系の道具としては珍しい部類に入る。
当サイトではこのベンチを再現していない。ハーネスはリポジトリに入っている(scripts/longmemeval)が、必要な longmemeval_s.json(277MB)は外部データセットで、当環境からは取得できなかった。88.1%は未検証として扱う。
検証環境:Linux 6.18.44/Go 1.25/Node.js 24.21.0/2026-09-30。公式リリース v0.21.4 の deja-vu_0.21.4_linux_amd64.tar.gz を取得して展開し、同梱バイナリのサイズを計測。あわせて CGO_ENABLED=0 go build -trimpath -ldflags="-s -w" でリリース相当を自前ビルドし、0.6%差で一致することを確認した(陽性対照)。索引は、Claude Code の JSONL 形式で生成した20,000セッション・200,000メッセージ・70.2MBの合成コーパスと、本セッションの実記録(1,888メッセージ・27.0MB)の2本で計時。検索はプロセス起動を含む端から端で5クエリ。MCPは stdio で initialize → notifications/initialized → tools/list を送って実取得し、tools/token_audit.py の heuristic 近似トークナイザ(ASCII 4字=1)で換算した。未検証:LongMemEval-S と LoCoMo は再現していない。ハーネスは同梱だが必要なデータセット(277MB)を当環境から取得できず、表の数値はリポジトリ同梱の結果JSONの読解である。また、公称の19,195セッションという実コーパスは手元に無いため、索引速度は別コーパスでの測定であり直接比較にはならない。埋め込みによる意味検索、deja sync のマシン間同期、各ハーネスへのフック配線も未実行。star 1.1k・fork 107 はリポジトリページの表示値。なお本記事は、開発者からの紹介依頼を受けて取り上げたものである。金銭その他の対価は受け取っておらず、数値はすべて当サイトが独立に測り直したか、出典を明示して引用している。
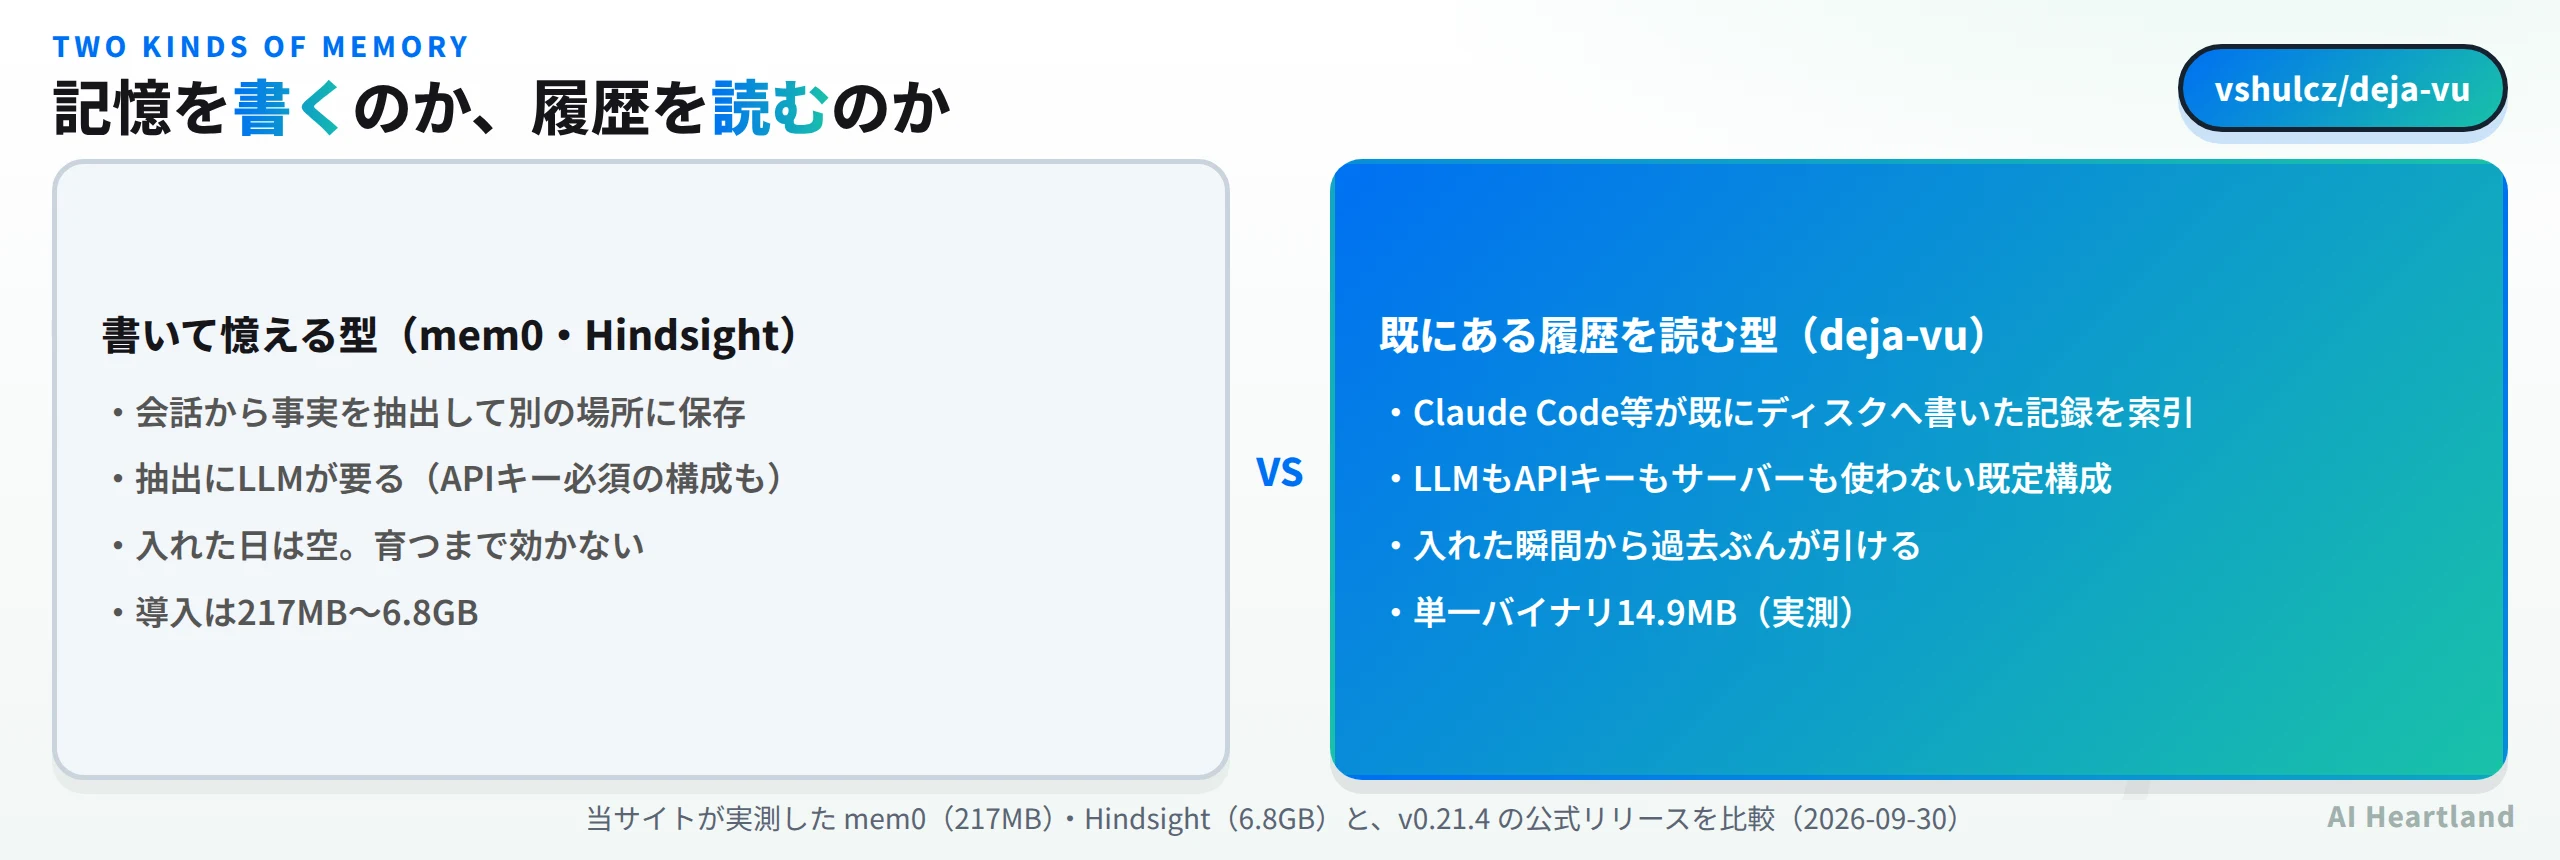
mem0・Hindsightと並べる
同じ物差しで測った3本を並べる。記憶OSSとして名前は同じでも、設計の向きが違うことがはっきり出る。
| mem0 | Hindsight | deja-vu | |
|---|---|---|---|
| 記憶の作り方 | 会話から事実を抽出して保存 | 事実と経験を観察へ畳み込んで学習 | 書かない。既存の記録を索引 |
| LLM | 抽出に必要 | 既定でキー必須 | 不要 |
| 導入サイズ(実測) | 217MB | 6.8GB | 14.9MB(単一バイナリ) |
| MCP常駐(同一物差し) | — | 39ツール・16,603トークン | 1ツール・約443トークン |
| 入れた日の状態 | 空 | 空 | 過去ぶんが即引ける |
| 返ってくるもの | 抽出された事実 | 畳み込まれた観察 | 実在した発話そのもの |
| ライセンス | Apache-2.0 | MIT | MIT |
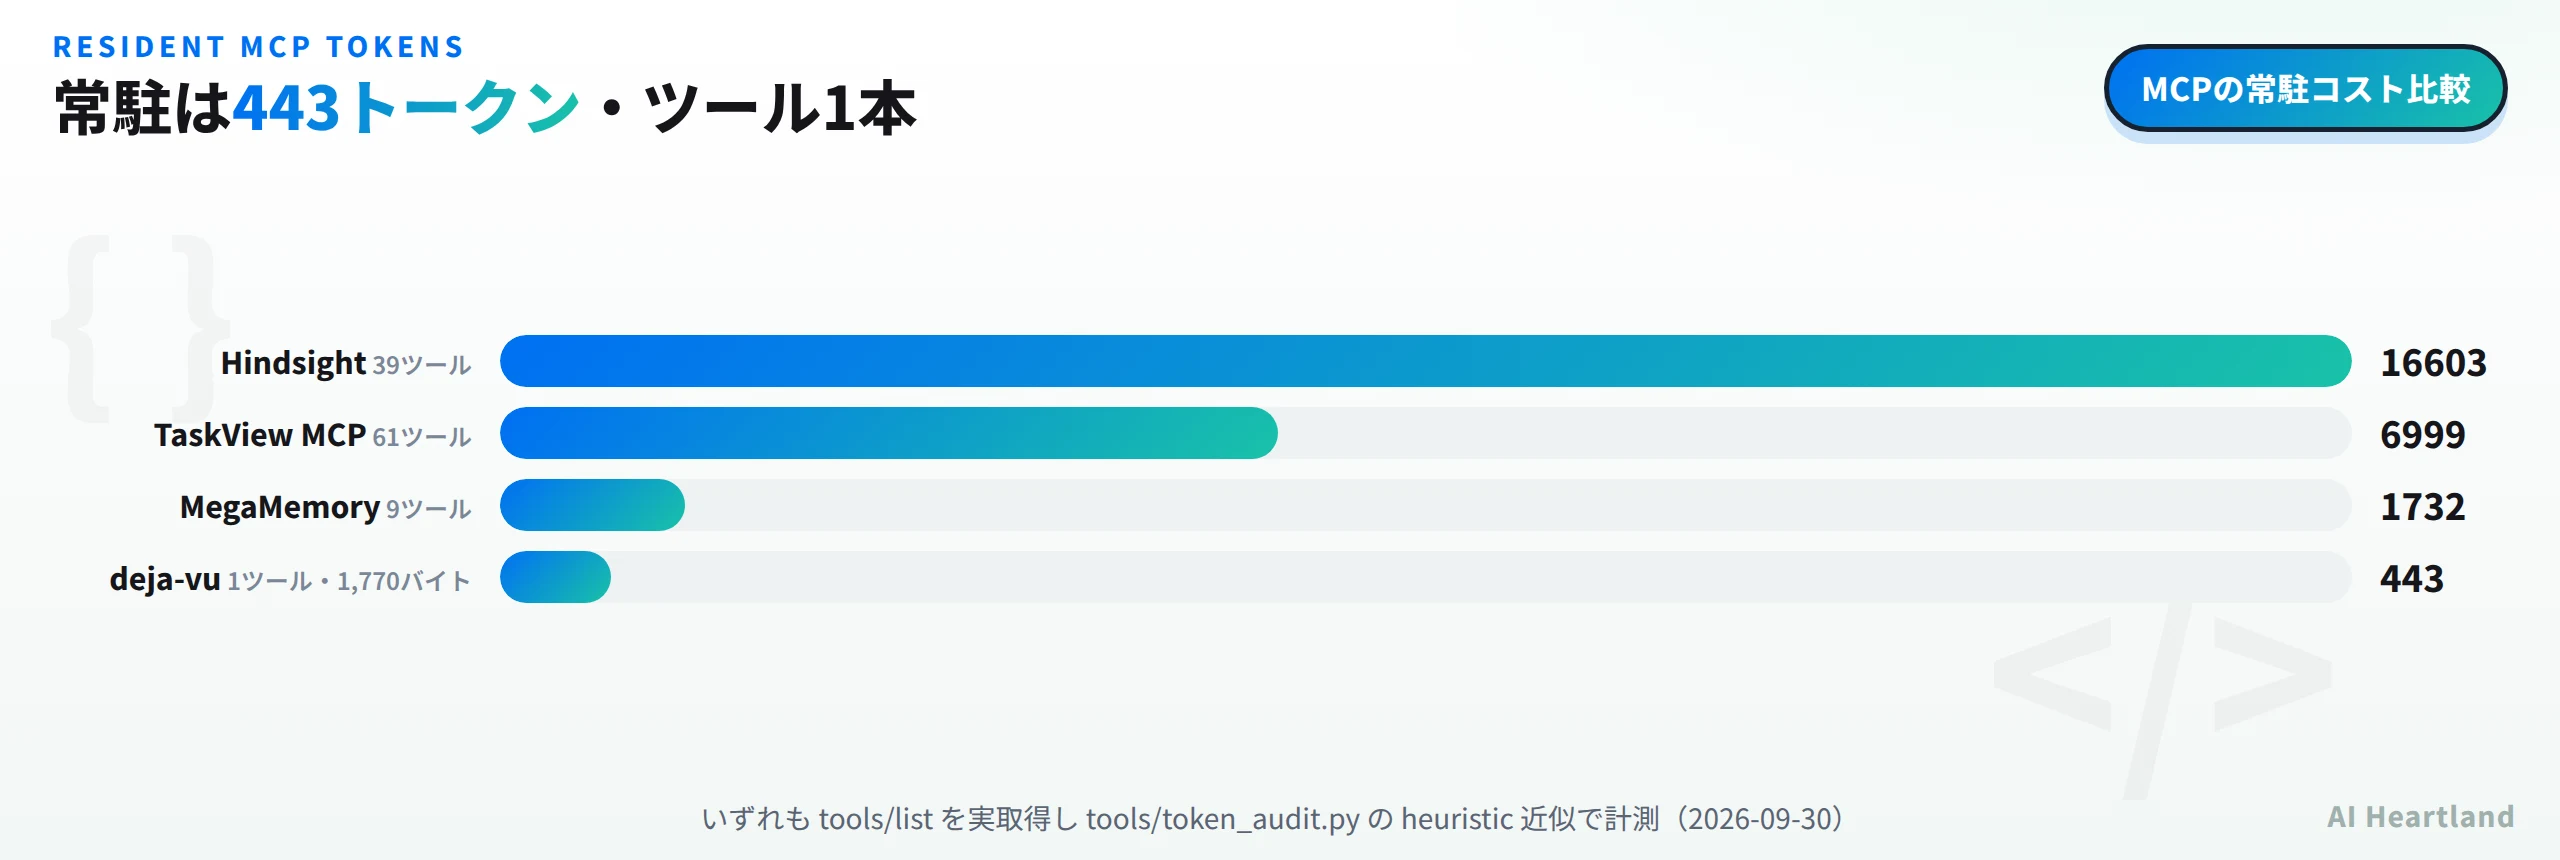
この443トークンという値は、他のMCPサーバーと同じ手順で実取得したものだ。
# stdio で initialize → notifications/initialized → tools/list を送って応答を数える
DEJA_HOME=... node probe.mjs ./deja mcp
# tools: 1 | wire bytes: 1770 | ~tokens(ascii/4): 443
#   deja 1768B ~442t
# 参考: 同じ手順で Hindsight は 39ツール 16,603トークン、MegaMemory は 9ツール 1,732トークン
MCPの常駐コストが桁で違う。 deja-vu が公開するツールは deja の1本だけで、1,770バイト・約443トークン。Hindsightの39ツール16,603トークンに対して37分の1で、当サイトが測った中では最小の部類に入る。ツールを増やさずCLIのサブコマンドで機能を広げる方針(blame files recap how など40近い)の結果で、エージェントの文脈に載るのは入口1本だけという設計になっている。
ツールを絞ったぶん、機能はCLI側に寄っている。--help を眺めると、検索そのもの以外の入口がかなり多い。deja blame <path>:<line> は「この行はどのセッションで決まったのか」を履歴から引く(git blame の会話版にあたる)。deja how <what> は「このプロジェクトで実際に流したコマンド」を、deja fix "<error text>" は「このエラーの後に何を実行したか」を返す。deja recap --since 7d は週次の決定事項を、根拠セッション付きで並べる。deja secrets はセッション記録に混ざった認証情報を洗い出し、--scrub で該当ファイルを書き換える。deja restore は過去の転記物からファイルを復元する。
いずれも記録に対する問い合わせの形をしていて、新しい情報を作る機能は見当たらない。索引が1つあれば、そこから引ける角度をいくらでも足せるという構成で、MCPに1本しか出さない判断とも筋が通っている。エージェントに渡すのは入口1本、人間が叩くのはCLI、という分担だ。
一方で、この設計には構造的な限界がある。記録に残っていないことは引けない。 エージェントが考えただけで書かなかったこと、別のマシンでやったこと、口頭で決まったことは索引に入らない。mem0 や Hindsight が「抽出して要約する」ことで扱おうとしている情報の一部は、原理的にこちらの守備範囲の外にある。逆に、抽出の誤りやモデル依存の揺れも原理的に起きない。どちらが優れているかではなく、何を諦めるかの選択だ。
併用も理屈のうえでは成立する。deja-vu が索引するのは既存の記録なので、抽出型の記憶がどこかに何を書こうと干渉しない。片方は「過去の発話そのもの」を、もう片方は「抽出された事実」を返す、という二階建てにはできる。ただし両方を同時にエージェントへ繋げば、常駐トークンも注入されるコンテキストも足し算になる。Hindsightの16,603トークンに443トークンを足すぶんには誤差だが、フック経由の自動注入まで両方有効にすると、同じ話題について別々の形をした記憶が2つ降ってくることになる。当サイトはその同時運用は試していないので、まずどちらか一方で自分の履歴に効くかを確かめる順番を勧めたい。
deja-vuを試す前に押さえる点
・自分の履歴が資産になるかを先に見る:deja sources を叩けば、手元に何セッション・何メッセージ・何MBあるかが即分かる。ここが薄ければ効果も薄い
・入れた日から効くのが最大の利点:育てる必要がないので、評価に1スプリント待つ必要がない
・記録に無いことは出ない:抽出型の記憶と排他ではなく、補完関係にある
・MCPは1ツール・約443トークン:常駐の負担はほぼ無い。フック経由の自動注入を使う場合は別途トークンが乗る
・埋め込みは任意:未設定だと localhost の 11434 と 1234 を探しに行く。嫌なら DEJA_EMBED_OFF=1
・転記物の扱いに注意:セッション記録には認証情報が混ざりうる。deja secrets という点検・スクラブ用のサブコマンドが用意されているので、索引する前に一度通しておきたい
・ベンチ値は検索側の指標:88.1%はLLMの回答精度ではない。自分の用途で効くかは自分の履歴で確かめる
・動きが速い:タグは64本、v0.21.4は2026-09-29公開で、翌日にもコミットが入っている。固定するならバージョンを明示する
・索引の容量は事前に見積もる:当方の合成コーパスでは元の70.2MBに対し45MBの索引ができた。実記録では比率が下がると公称されているが、ディスクの余裕は確認しておきたい
・再現の口が開いている:ベンチのハーネスと結果JSON(データセットのsha256つき)がリポジトリに入っているので、疑うなら自分で回せる。公称値をそのまま信じる必要がない構成自体が評価点
総括。 deja-vu の賭けは「エージェントの記憶で一番価値があるのは、実はもう書かれている」という一点だ。索引するだけなのでモデルもキーもサーバーも要らず、バイナリは14.9MB、MCPの常駐は443トークン。入れた瞬間から過去が引けるという性質は、育つまで効かない抽出型とは評価の仕方そのものが変わる。
持ち込まれた3つの数値のうち、バイナリサイズは公称より小さく、索引速度は別コーパスで桁が一致し、88.1%は整理版470問でのhit@1という狭い意味だった。3つ目については、プロジェクト自身が結果JSONに指標の限界と再現手順を書き込んでいる。公称値をそのまま載せるより、その注記まで読んで伝えるほうが、この道具の評価としては正確になると思う。試すコストは deja sources の1回ぶんしかないので、手元の履歴が厚い人は先にそれを叩いてから判断するのが早い。逆に、エージェントを使い始めて日が浅いなら、この道具が最も効くのは半年後だということになる。
参照ソース
・vshulcz/deja-vu(公式リポジトリ) — README・docs/benchmarks/*.json・scripts/longmemeval・.goreleaser.yaml を 2026-09-30 に確認
・deja-vu v0.21.4 リリース — 実際に取得して計測した配布物(2026-09-29 公開)
・LongMemEval(ベンチマークの定義元) — 公式指標 evidence_recall の出どころ