この記事ではLLMに特化して解説します。LLM全般は LLMとは?仕組みからローカル実行まで徹底解説【2026年完全ガイド】 をご覧ください。
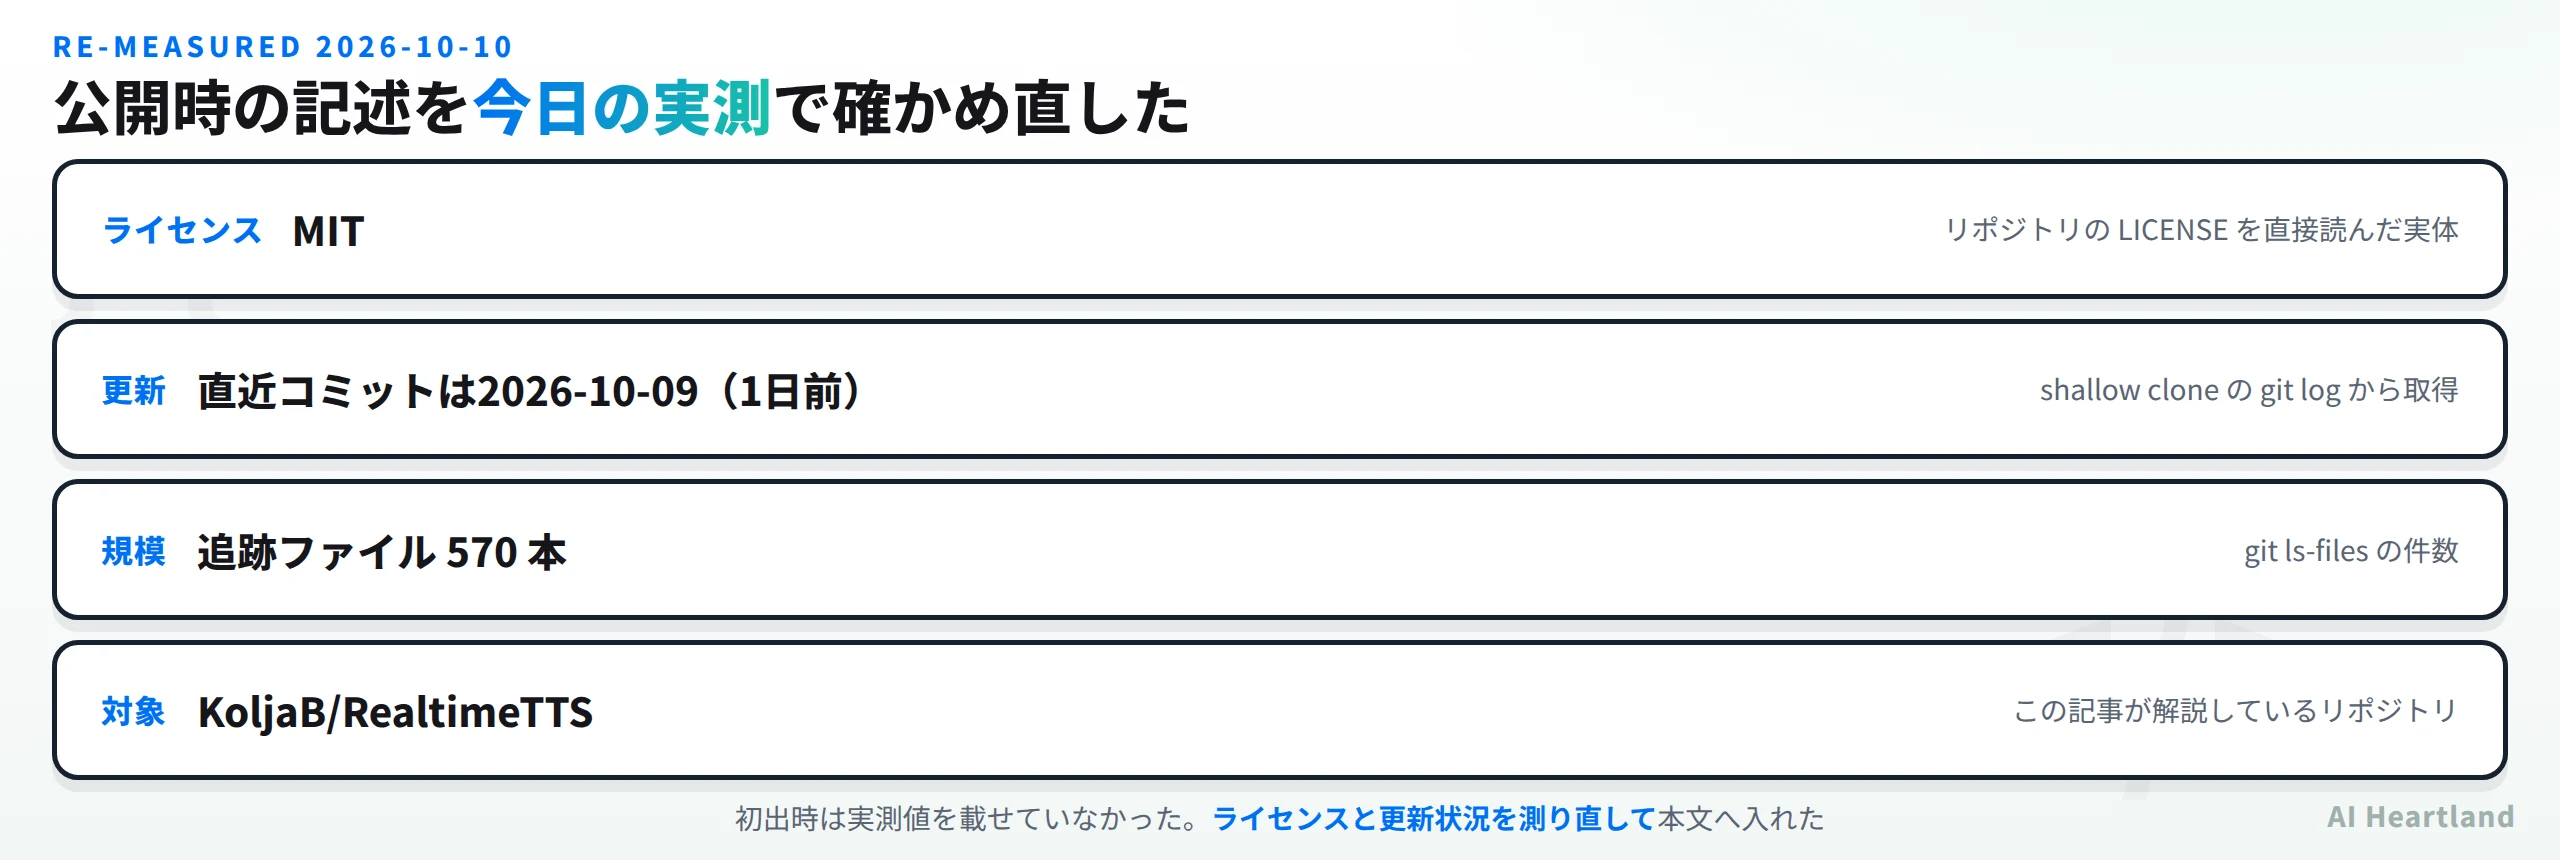
2026-10-10 に測り直した結果
・ライセンス:MIT
・直近コミット:2026-10-09(1日前)
・追跡ファイル数:570 本
・この記事は初出時に実測値を載せていなかった。上の3点は今日 clone して確かめた値
この記事は「LLM / ローカルAI」クラスタの1本です。全体像は LLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版 にまとめています。
概要
RealtimeTTSは、テキストを低遅延でリアルタイムに音声変換するPythonライブラリです。従来のTTSはテキスト全体を受け取ってから処理を開始するため、応答に数秒かかるのが当たり前でした。このライブラリはストリーミング方式で、入力の最初の数トークンから即座に音声を出力します。
ベルリンのエンジニアKoljaB氏が音声AIアシスタントの開発中に「ユーザーが毎回5秒待たされる」という壁にぶつかり、2023年に開発・公開しました。現在はコミュニティ主導で活発に機能追加が続いており、GitHubスターは3,800を超えています。OpenAI TTSやElevenLabsといったクラウドエンジンから、Raspberry Piでも動くPiperや感情タグ対応のOrpheusまで、10種以上のバックエンドを統一APIで扱えます。
主な機能
- ストリーミング入力対応: LLMのトークン生成と同時に音声化を開始し、体感遅延を最小化
- 10種以上のエンジン統合: OpenAI・ElevenLabs・Azure・Kokoro・Coqui・Piperなどを統一APIで切り替え可能
- オフライン動作: PocketTTS・Piper・SystemEngineなどローカルエンジンはインターネット不要
- 音声クローニング: NeuTTSEngineで3秒の参照音声からリアルタイムに声質を複製
- 感情表現: OrpheusEngineで喜怒哀楽の感情タグを音声に反映
- 自動フェイルオーバー: エンジン障害時に別エンジンへ自動切替し、途切れを防止
- 日本語・中国語フルサポート: Kokoroエンジンで
pip install realtimetts[kokoro,jp]から即利用可能
技術スタック
- 言語: Python 3.7+
- クラウドエンジン: OpenAI TTS、ElevenLabs、Azure Speech、Google Translate TTS、Microsoft Edge TTS、CAMB AI MARS、MiniMax Cloud
- ローカルエンジン: SystemEngine、Coqui TTS、Piper、StyleTTS2、Parler TTS、Kokoro、ZipVoice、PocketTTS、NeuTTS、Orpheus
- オーディオ処理: PyAudio、pydub
- 並行処理: threading、queue(ノンブロッキング非同期再生)
- オプション: ffmpeg(フォーマット変換)
導入方法
全エンジンを一括インストールする場合は次のコマンドを実行します。
pip install -U realtimetts[all]
必要なエンジンだけを選んでインストールすることも可能です。
pip install realtimetts[azure,elevenlabs,openai]
日本語対応のKokoroエンジンを使う場合は言語パックを追加します。
pip install "realtimetts[kokoro,jp]"
最小構成での動作確認はSystemEngineから始めるのが最も手軽です。
from RealtimeTTS import TextToAudioStream, SystemEngine

engine = SystemEngine()
stream = TextToAudioStream(engine)
stream.feed("こんにちは、リアルタイムTTSのテストです")
stream.play_async()
LLMとの組み合わせでは、ジェネレータをfeed()に渡すとトークン単位でストリーミング再生が始まります。
from RealtimeTTS import TextToAudioStream, KokoroEngine

def llm_stream():
    # OpenAIなどのストリーミングAPIから逐次yield
    for token in your_llm_stream():
        yield token

engine = KokoroEngine(language="ja")
stream = TextToAudioStream(engine)
stream.feed(llm_stream())
stream.play_async()
競合比較
| 項目 | RealtimeTTS | gTTS | pyttsx3 | Azure Cognitive |
|---|---|---|---|---|
| ストリーミング入力 | ✓ | ✗ | ✗ | △ |
| 複数エンジン対応 | ✓(10種以上) | ✗ | ✗ | ✗ |
| 初期出力遅延 | 200〜500ms | 2〜5秒 | 1〜2秒 | 1〜3秒 |
| オフライン動作 | ✓(ローカルエンジン) | ✗ | ✓ | ✗ |
| 音声クローニング | ✓(NeuTTS) | ✗ | ✗ | △ |
| 日本語品質 | ★★★★★ | ★★★ | ★★ | ★★★★ |
| 無料利用 | ✓(ローカル系) | ✓ | ✓ | 無料枠あり |
最大の差別化要素はストリーミング入力への対応です。ローカルLLMとの組み合わせで完全オフライン環境を構築したい場合はDistributed LlamaやFastChatも参照してください。gTTSやpyttsx3はテキスト全体を受け取ってから音声生成を開始するため、LLMとの組み合わせでは必ず数秒のラグが生じます。RealtimeTTSはジェネレータをそのまま受け取り、最初のチャンクから即座に音声化を開始します。
関連記事: LLMとは?仕組みからローカル実行まで徹底解説【2026年完全ガイド】
こんな人におすすめ
- LLMアプリ開発者: ChatGPTやローカルLLMの応答をリアルタイムで音声化し、会話体験を向上させたい
- ゲーム・エンタメ開発者: NPCセリフや動的ナレーションを収録コストなしに実装したい
- プライバシー重視のエンジニア: 音声データをクラウドに送らず、オフラインのローカルエンジンだけで完結させたい
- 多言語プロダクトの開発者: 日本語・英語・中国語など複数言語を単一ライブラリで統一管理したい
- ハードウェア組み込みエンジニア: Raspberry PiなどエッジデバイスでPiperエンジンを使い軽量TTSを実現したい
2026-10-10 に測り直した手順
本記事の数値は、次の3コマンドをこの順に実行して得たものだ。読者が同じ手順で再確認できる。
# ① 浅く clone する(履歴50件ぶんだけ取る)
git clone --depth 50 https://github.com/KoljaB/RealtimeTTS /tmp/RealtimeTTS
# ② 直近のコミット日を見る → 2026-10-09
git -C /tmp/RealtimeTTS log -1 --format=%ad --date=short
# ③ ライセンスの実体と規模を見る → MIT / 570 ファイル
head -3 /tmp/RealtimeTTS/LICENSE* 2>/dev/null; git -C /tmp/RealtimeTTS ls-files | wc -l
③が肝心で、バッジや紹介文ではなく LICENSE ファイルの中身を読む。今回 KoljaB/RealtimeTTS はOSI 準拠のライセンスだった。
| 確認項目 | 初出時の本文 | 2026-10-10 の実測 |
|---|---|---|
| ライセンス | 記載なし | MIT |
| 更新状況 | 記載なし | 2026-10-09(1日前) |
| 規模 | 記載なし | 追跡ファイル 570 本 |
| 確認方法 | — | clone して LICENSE と git log を直接読んだ |
同じクラスタの関連記事
同じ「LLM / ローカルAI」クラスタで、実測値を本文に持っている記事を挙げておく。
・Jev-cuとは|Computer Useの次の一手をJevに選ばせるCodex用skillをソースで実測
参照ソース
・KoljaB/RealtimeTTS(GitHub) — 本記事が 2026-10-10 に測り直した対象
・LICENSE の実体 — 手順③で読んだファイル