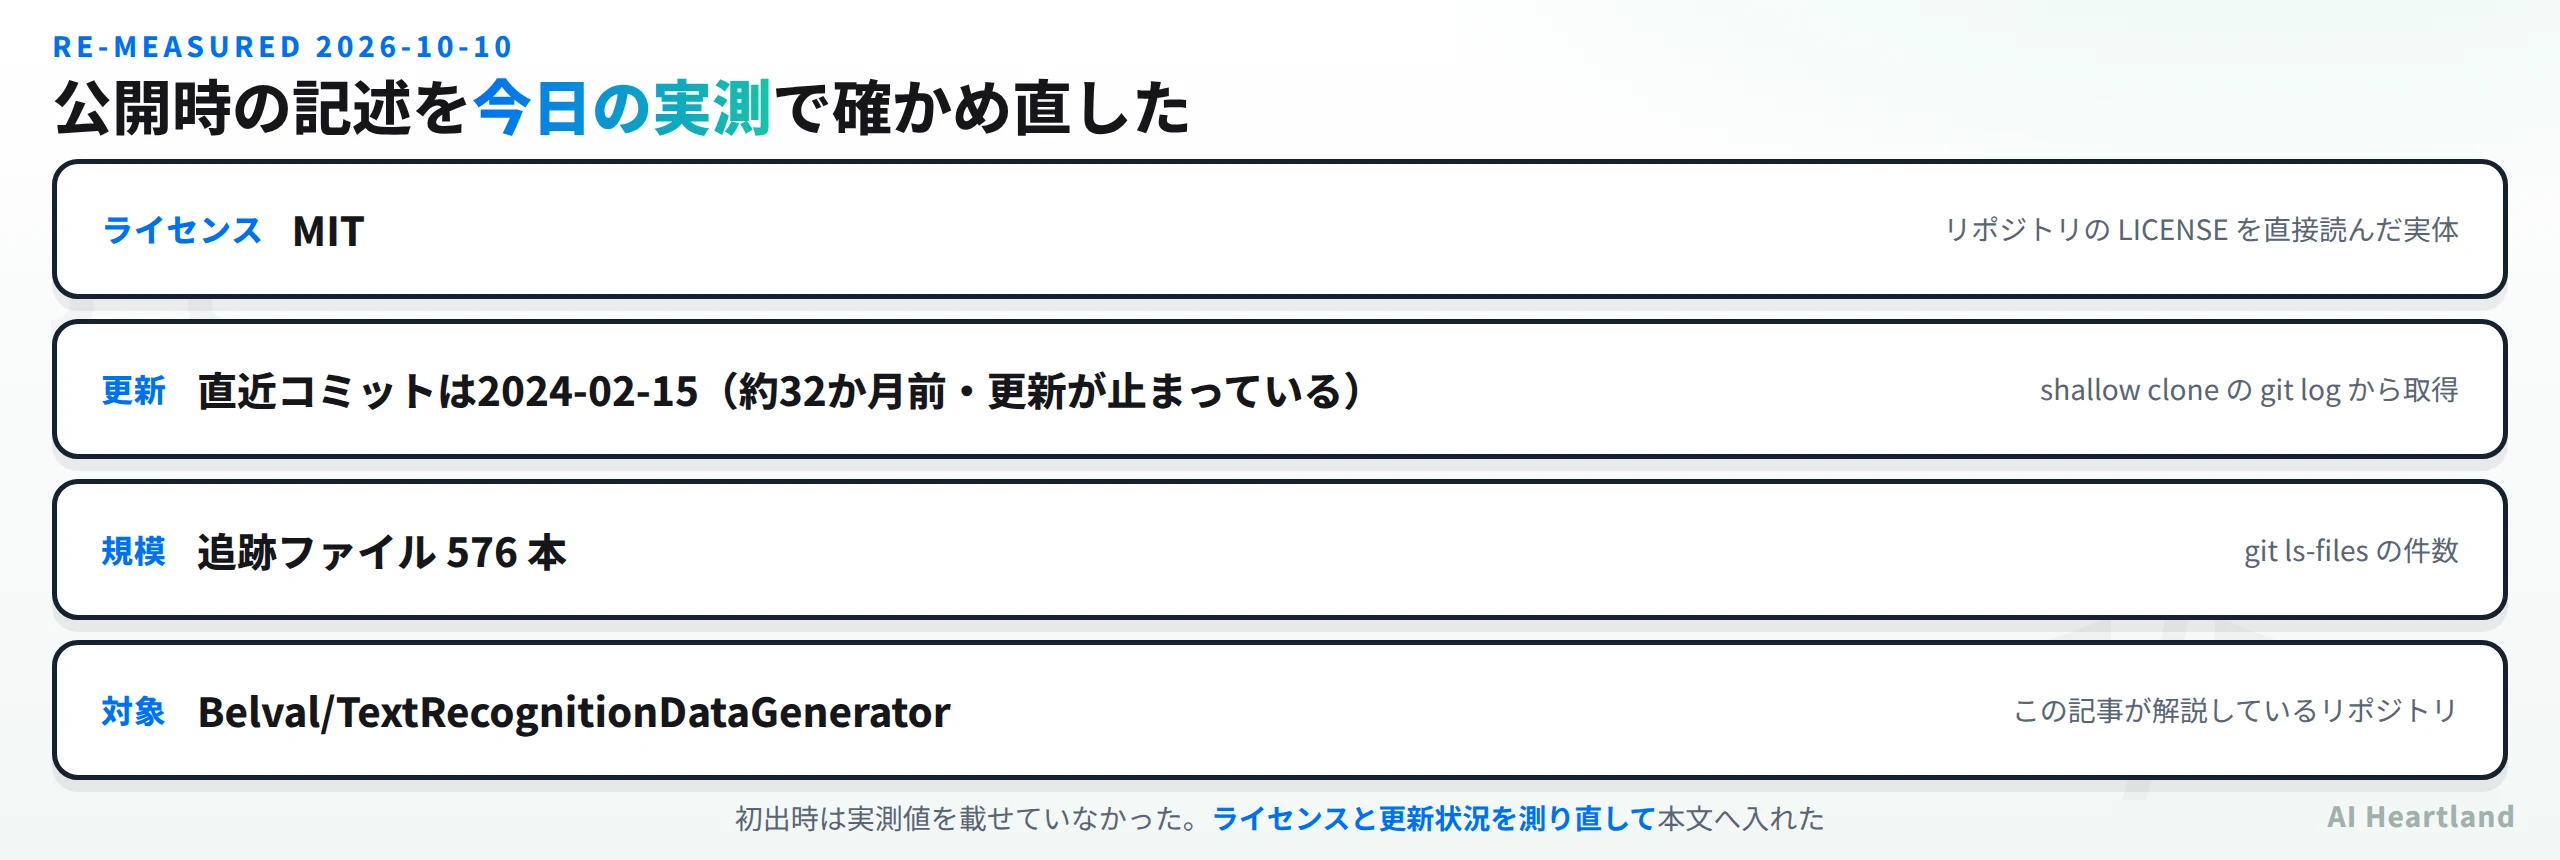
2026-10-10 に測り直した結果
・ライセンス:MIT
・直近コミット:2024-02-15(約32か月前)
・追跡ファイル数:576 本
・この記事は初出時に実測値を載せていなかった。上の3点は今日 clone して確かめた値
この記事は「DevOps & 自動化」クラスタの1本です。全体像は AI自動化ツール|ノーコードからコードまで2026年版の比較と選び方 にまとめています。
概要
TextRecognitionDataGeneratorは、OCR(光学文字認識)やテキスト認識モデルの訓練に必要な合成データを自動生成するPythonツールです。生成した大量データの効率的な処理にはDaft:Pythonで大規模データを高速処理するフレームワークが役立ちます。2017年にBelvalによって開発され、機械学習エンジニアの「大量のラベル付きテキスト画像をどう集めるか」という課題を解決してきました。
例えば領収書認識モデルの構築では、実画像の手作業ラベリングに膨大な時間がかかりますが、このツールで合成画像を大量生成すれば、初期モデルの訓練を短期間で完了できます。その後の実画像での微調整でさらに精度を引き上げることが可能です。
主な機能
- カスタマイズ可能なテキスト生成:任意のテキスト、フォント、サイズ、色を指定して画像を生成できる
- 背景のバリエーション:単色背景、グラデーション、実際の画像背景を合成可能
- ノイズとひずみの追加:ガウシアンノイズ、モーションブラー、遠近変形など複数のデータオーグメンテーション手法を自動適用
- 大量バッチ生成:数千枚から数万枚の画像を効率的に一括生成
- 自動ラベリング:生成される画像には自動的に正解テキストラベルが付与される
- フォントライブラリ対応:システムにインストールされた複数フォントをランダムに選択・組み合わせ
- 形式の柔軟性:PNG、JPEGなど複数の出力形式に対応し、CSVメタデータも同時生成
技術スタック
- 言語:Python 3.6以上
- 画像処理:Pillow(PIL)、OpenCV
- 機械学習連携:TensorFlow、PyTorch用のデータ形式に対応
- 依存ツール:NumPy、FreeType(フォントレンダリング)
- 配布形式:pip経由でのインストール対応
導入方法
インストール
# pipを使った標準インストール
pip install trdg

# または、リポジトリをクローンして直接実行
git clone https://github.com/Belval/TextRecognitionDataGenerator
cd TextRecognitionDataGenerator
pip install -r requirements.txt
基本的な使用方法
# 1,000枚のランダムテキスト画像を生成
python run.py -c 1000 -w 256 -f 32

# 特定のテキストリストから画像生成
python run.py -i input.txt -c 1000 -w 256

# 複数フォント、背景、ノイズを含めた複雑な生成
python run.py -c 5000 -w 256 -f 32 --blur --distortion --background --count-by-picking-random-words
オプション説明
-c / --count:生成する画像枚数-w / --width:出力画像の幅(ピクセル)-f / --font-size:テキストのフォントサイズ-i / --input-file:テキストリストのパス--blur:ブラーエフェクトを有効化--distortion:歪み変形を有効化--background:背景画像を使用
競合比較
| 項目 | TextRecognitionDataGenerator | Synthetic Data Vault(SDV) | imgaug |
|---|---|---|---|
| 主用途 | テキスト認識用合成データ | テーブル・時系列データ合成 | 画像オーグメンテーション |
| セットアップ難易度 | 低(数分で開始可能) | 中程度(データ定義が必要) | 中程度(パイプライン設定) |
| ラベル付け自動化 | ◎完全自動 | △手動対応必要 | ◎自動的に保持 |
| フォントカスタマイズ | ◎豊富 | △限定的 | △なし |
| メンテナンス状況 | 活発 | 活発 | 活発 |
| ライセンス | MIT | MIT | BSD |
差別化ポイント:TextRecognitionDataGeneratorの最大の強みは、OCR・テキスト認識タスクに特化した設計にあります。MLの実験管理と組み合わせる場合はClearML:機械学習実験の完全管理プラットフォームが便利です。フォント、テキストサイズ、背景、ノイズを統合的にコントロールでき、生成された画像に自動的に正解ラベルが付与されるため、TensorFlowやPyTorchのデータローダーにそのまま投入できます。一方、imgaugは既存画像のオーグメンテーション(変形・回転など)に特化し、SDVは構造化データ合成に特化しているため、テキスト認識用の合成画像生成という特定の用途では、このツールが最適です。
こんな人におすすめ
- OCRモデル開発者:大量のラベル付きテキスト画像が必要だが、手動収集が困難な場合に、数分のセットアップで訓練データを確保できます
- スタートアップのAI開発チーム:予算と時間が限定される中で、低コストで高品質な訓練データセットを生成する必要があります
- 多言語対応が必要なエンジニア:複数言語のテキスト認識モデルを構築する際、言語ごとにフォント設定を切り替えるだけで対応できます
- 産業用コンピュータビジョン実装者:製造業の品質検査や物流の自動化で、環境に応じたノイズや背景を含めた現実的な合成データが生成できます
- 機械学習の研究・教育関係者:学生のプロジェクトやハッカソンで、データ準備の時間を削減し、モデル設計と改善に集中できるようにします
2026-10-10 に測り直した手順
本記事の数値は、次の3コマンドをこの順に実行して得たものだ。読者が同じ手順で再確認できる。
# ① 浅く clone する(履歴50件ぶんだけ取る)
git clone --depth 50 https://github.com/Belval/TextRecognitionDataGenerator /tmp/TextRecognitionDataGenerator
# ② 直近のコミット日を見る → 2024-02-15
git -C /tmp/TextRecognitionDataGenerator log -1 --format=%ad --date=short
# ③ ライセンスの実体と規模を見る → MIT / 576 ファイル
head -3 /tmp/TextRecognitionDataGenerator/LICENSE* 2>/dev/null; git -C /tmp/TextRecognitionDataGenerator ls-files | wc -l
③が肝心で、バッジや紹介文ではなく LICENSE ファイルの中身を読む。今回 Belval/TextRecognitionDataGenerator はOSI 準拠のライセンスだった。
| 確認項目 | 初出時の本文 | 2026-10-10 の実測 |
|---|---|---|
| ライセンス | 記載なし | MIT |
| 更新状況 | 記載なし | 2024-02-15(約32か月前) |
| 規模 | 記載なし | 追跡ファイル 576 本 |
| 確認方法 | — | clone して LICENSE と git log を直接読んだ |
同じクラスタの関連記事
同じ「DevOps & 自動化」クラスタで、実測値を本文に持っている記事を挙げておく。
・Certimateとは|SSL証明書の発行・配置・更新を自動化するセルフホストACMEツールを実測
参照ソース
・Belval/TextRecognitionDataGenerator(GitHub) — 本記事が 2026-10-10 に測り直した対象
・LICENSE の実体 — 手順③で読んだファイル