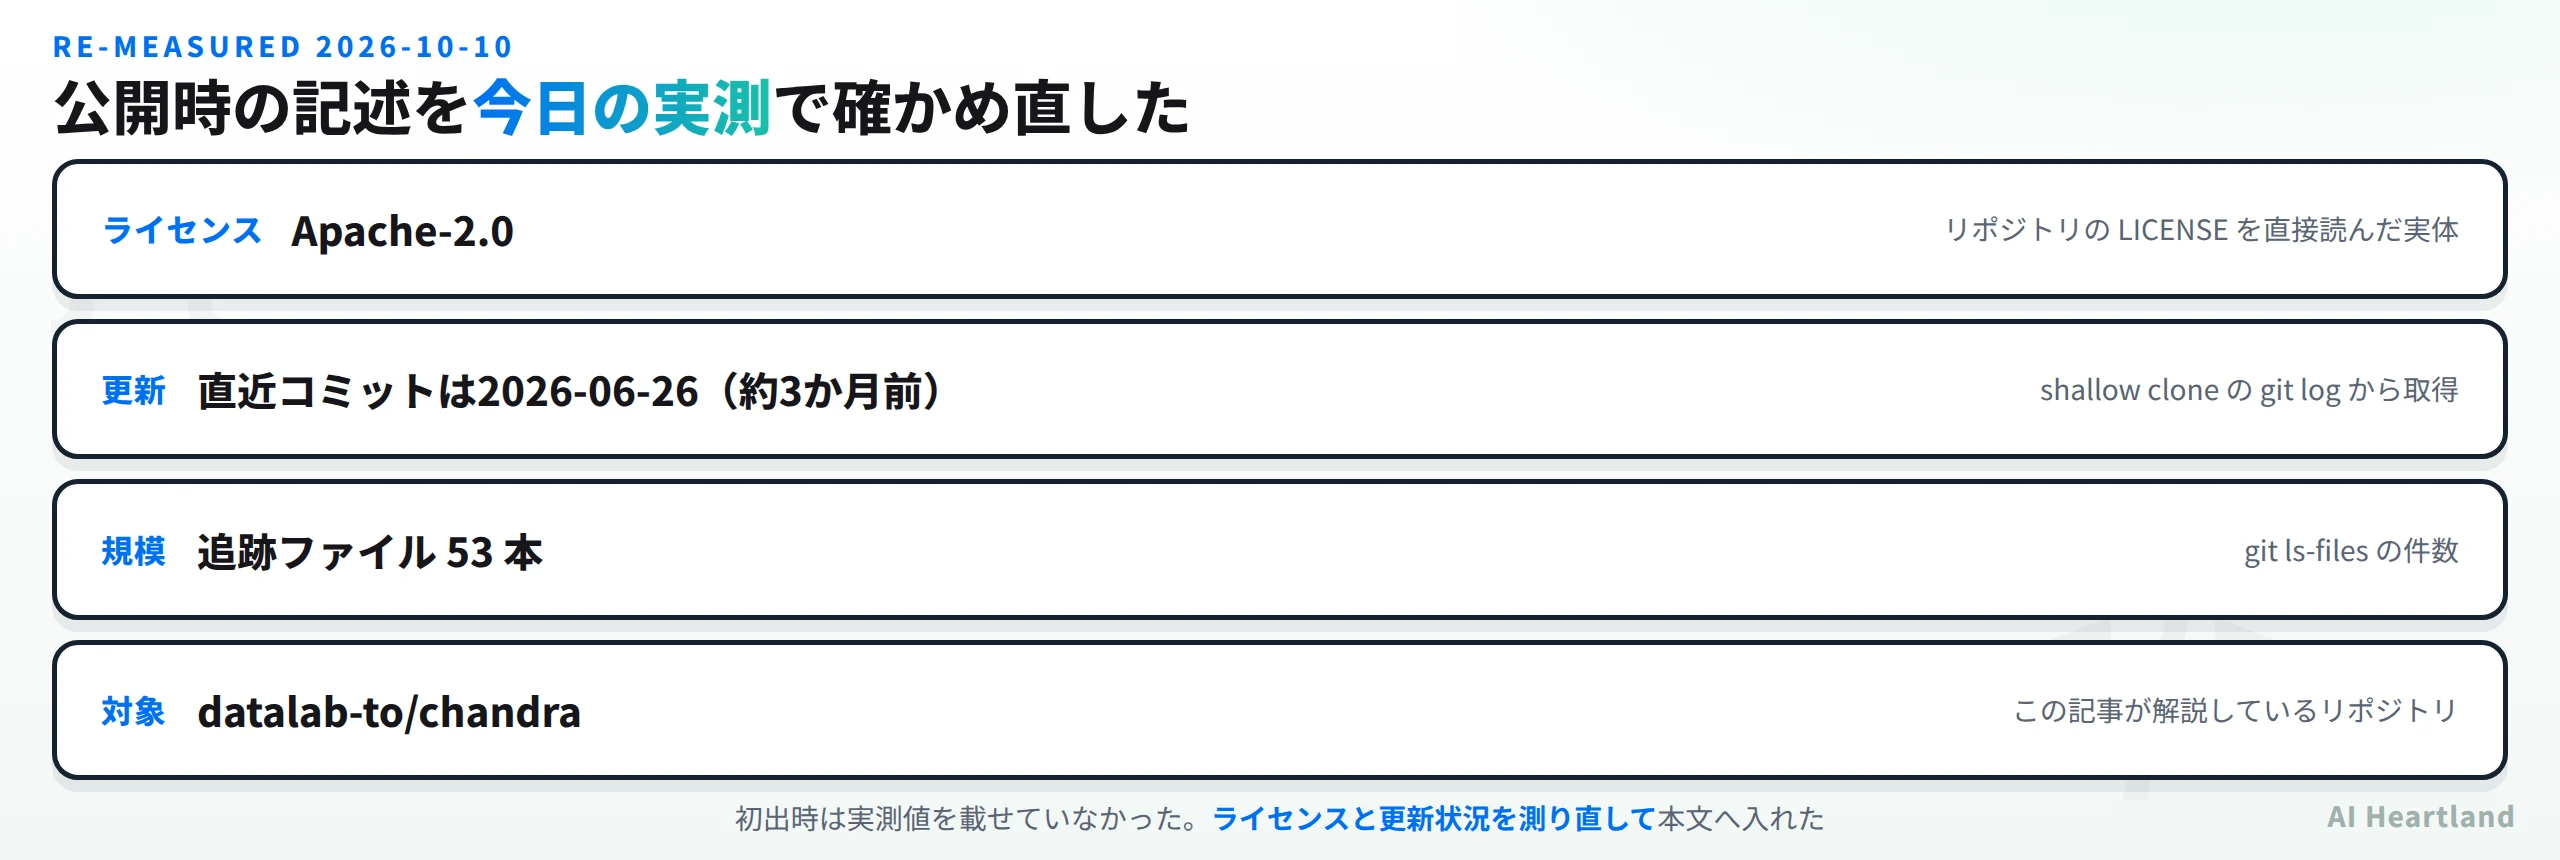
2026-10-10 に測り直した結果
・ライセンス:Apache-2.0
・直近コミット:2026-06-26(約3か月前)
・追跡ファイル数:53 本
・この記事は初出時に実測値を載せていなかった。上の3点は今日 clone して確かめた値
この記事は「DevOps & 自動化」クラスタの1本です。全体像は AI自動化ツール|ノーコードからコードまで2026年版の比較と選び方 にまとめています。
Chandraについて
Chandraは画像やPDFドキュメントを構造化フォーマットに変換するOCRモデルである。単なる文字認識にとどまらず、レイアウト情報を保持しながらHTML、Markdown、JSON形式での出力に対応している。
主な機能と特徴
Chandra OCR 2は複数の強力な機能を備えている。90以上の言語に対応した多言語OCR、手書き認識、テーブルや複雑なレイアウトの認識、数式の抽出と認識、フォーム内のチェックボックスなどの正確な復元が可能だ。画像やダイアグラムの抽出と、構造化データとしてのキャプション追加にも対応している。
セットアップと利用方法
セットアップは比較的簡単で、pipコマンドでのインストールで環境が整う。クローンしてから依存関係をインストールすれば、すぐに利用を開始できる。
ローカルでの推論に対応しているほか、ホストされたAPI経由での利用も可能である。公式サイトには無料のプレイグラウンド環境も用意されており、インストール前に機能を試すことができる。
実務での活用
ドキュメント処理を扱う業務では、Chandraの能力が活躍する場面は多い。紙資料やスキャンされたPDFから構造化データを抽出する必要がある場面、複雑なレイアウトを持つドキュメントを処理する場面で、レイアウト情報を保持したままのデータ変換が実現できる。複数言語混在のドキュメント処理にも対応している。
利用する際の留意点
ドキュメントがまだ発展途上であり、詳細な使い方については公式リポジトリのREADMEだけでは十分でない場面がある。大規模なドキュメントや複雑なレイアウトを扱う場合には、処理時間や精度の面で事前検証が必要である。
それでも、ドキュメント処理を自動化したい組織や、PDF・スキャン画像から構造化データを効率的に抽出したいユースケースでは、実用的なツールとなり得る。
2026-10-10 に測り直した手順
本記事の数値は、次の3コマンドをこの順に実行して得たものだ。読者が同じ手順で再確認できる。
# ① 浅く clone する(履歴50件ぶんだけ取る)
git clone --depth 50 https://github.com/datalab-to/chandra /tmp/chandra
# ② 直近のコミット日を見る → 2026-06-26
git -C /tmp/chandra log -1 --format=%ad --date=short
# ③ ライセンスの実体と規模を見る → Apache-2.0 / 53 ファイル
head -3 /tmp/chandra/LICENSE* 2>/dev/null; git -C /tmp/chandra ls-files | wc -l
③が肝心で、バッジや紹介文ではなく LICENSE ファイルの中身を読む。今回 datalab-to/chandra はOSI 準拠のライセンスだった。
| 確認項目 | 初出時の本文 | 2026-10-10 の実測 |
|---|---|---|
| ライセンス | 記載なし | Apache-2.0 |
| 更新状況 | 記載なし | 2026-06-26(約3か月前) |
| 規模 | 記載なし | 追跡ファイル 53 本 |
| 確認方法 | — | clone して LICENSE と git log を直接読んだ |
同じクラスタの関連記事
同じ「DevOps & 自動化」クラスタで、実測値を本文に持っている記事を挙げておく。
・Certimateとは|SSL証明書の発行・配置・更新を自動化するセルフホストACMEツールを実測
・OpenOutreachとは|送信機能を捨てたOSSのAIリード発掘ツールの仕組みをCLI実測つきで解説
参照ソース
・datalab-to/chandra(GitHub) — 本記事が測り直した対象
・LICENSE — ライセンスの実体(上の手順③で読んだファイル)