Postgres論理レプリケーションのツールを選ぶとき、一番確かめにくいのが「メモリがどこまで増えるか」だ。データベースが大きくなるほど消費が増える実装は珍しくないが、それは本番で踏むまで分からない。
pgsync は Rust で書かれた1バイナリのレプリケーションエンジンで、README が memory-bounded を正面に掲げている。面白いのはその示し方で、ベンチマークの生ログをリポジトリに入れて配っている。公称値を信じるかどうかではなく、自分で再集計して確かめられる。
この記事は「クラスタ運用とデータ移行」の話題です。開発まわりの自動化全体は AI自動化ツール|ノーコードからコードまで2026年版の比較と選び方 にまとめています。
30秒でわかる
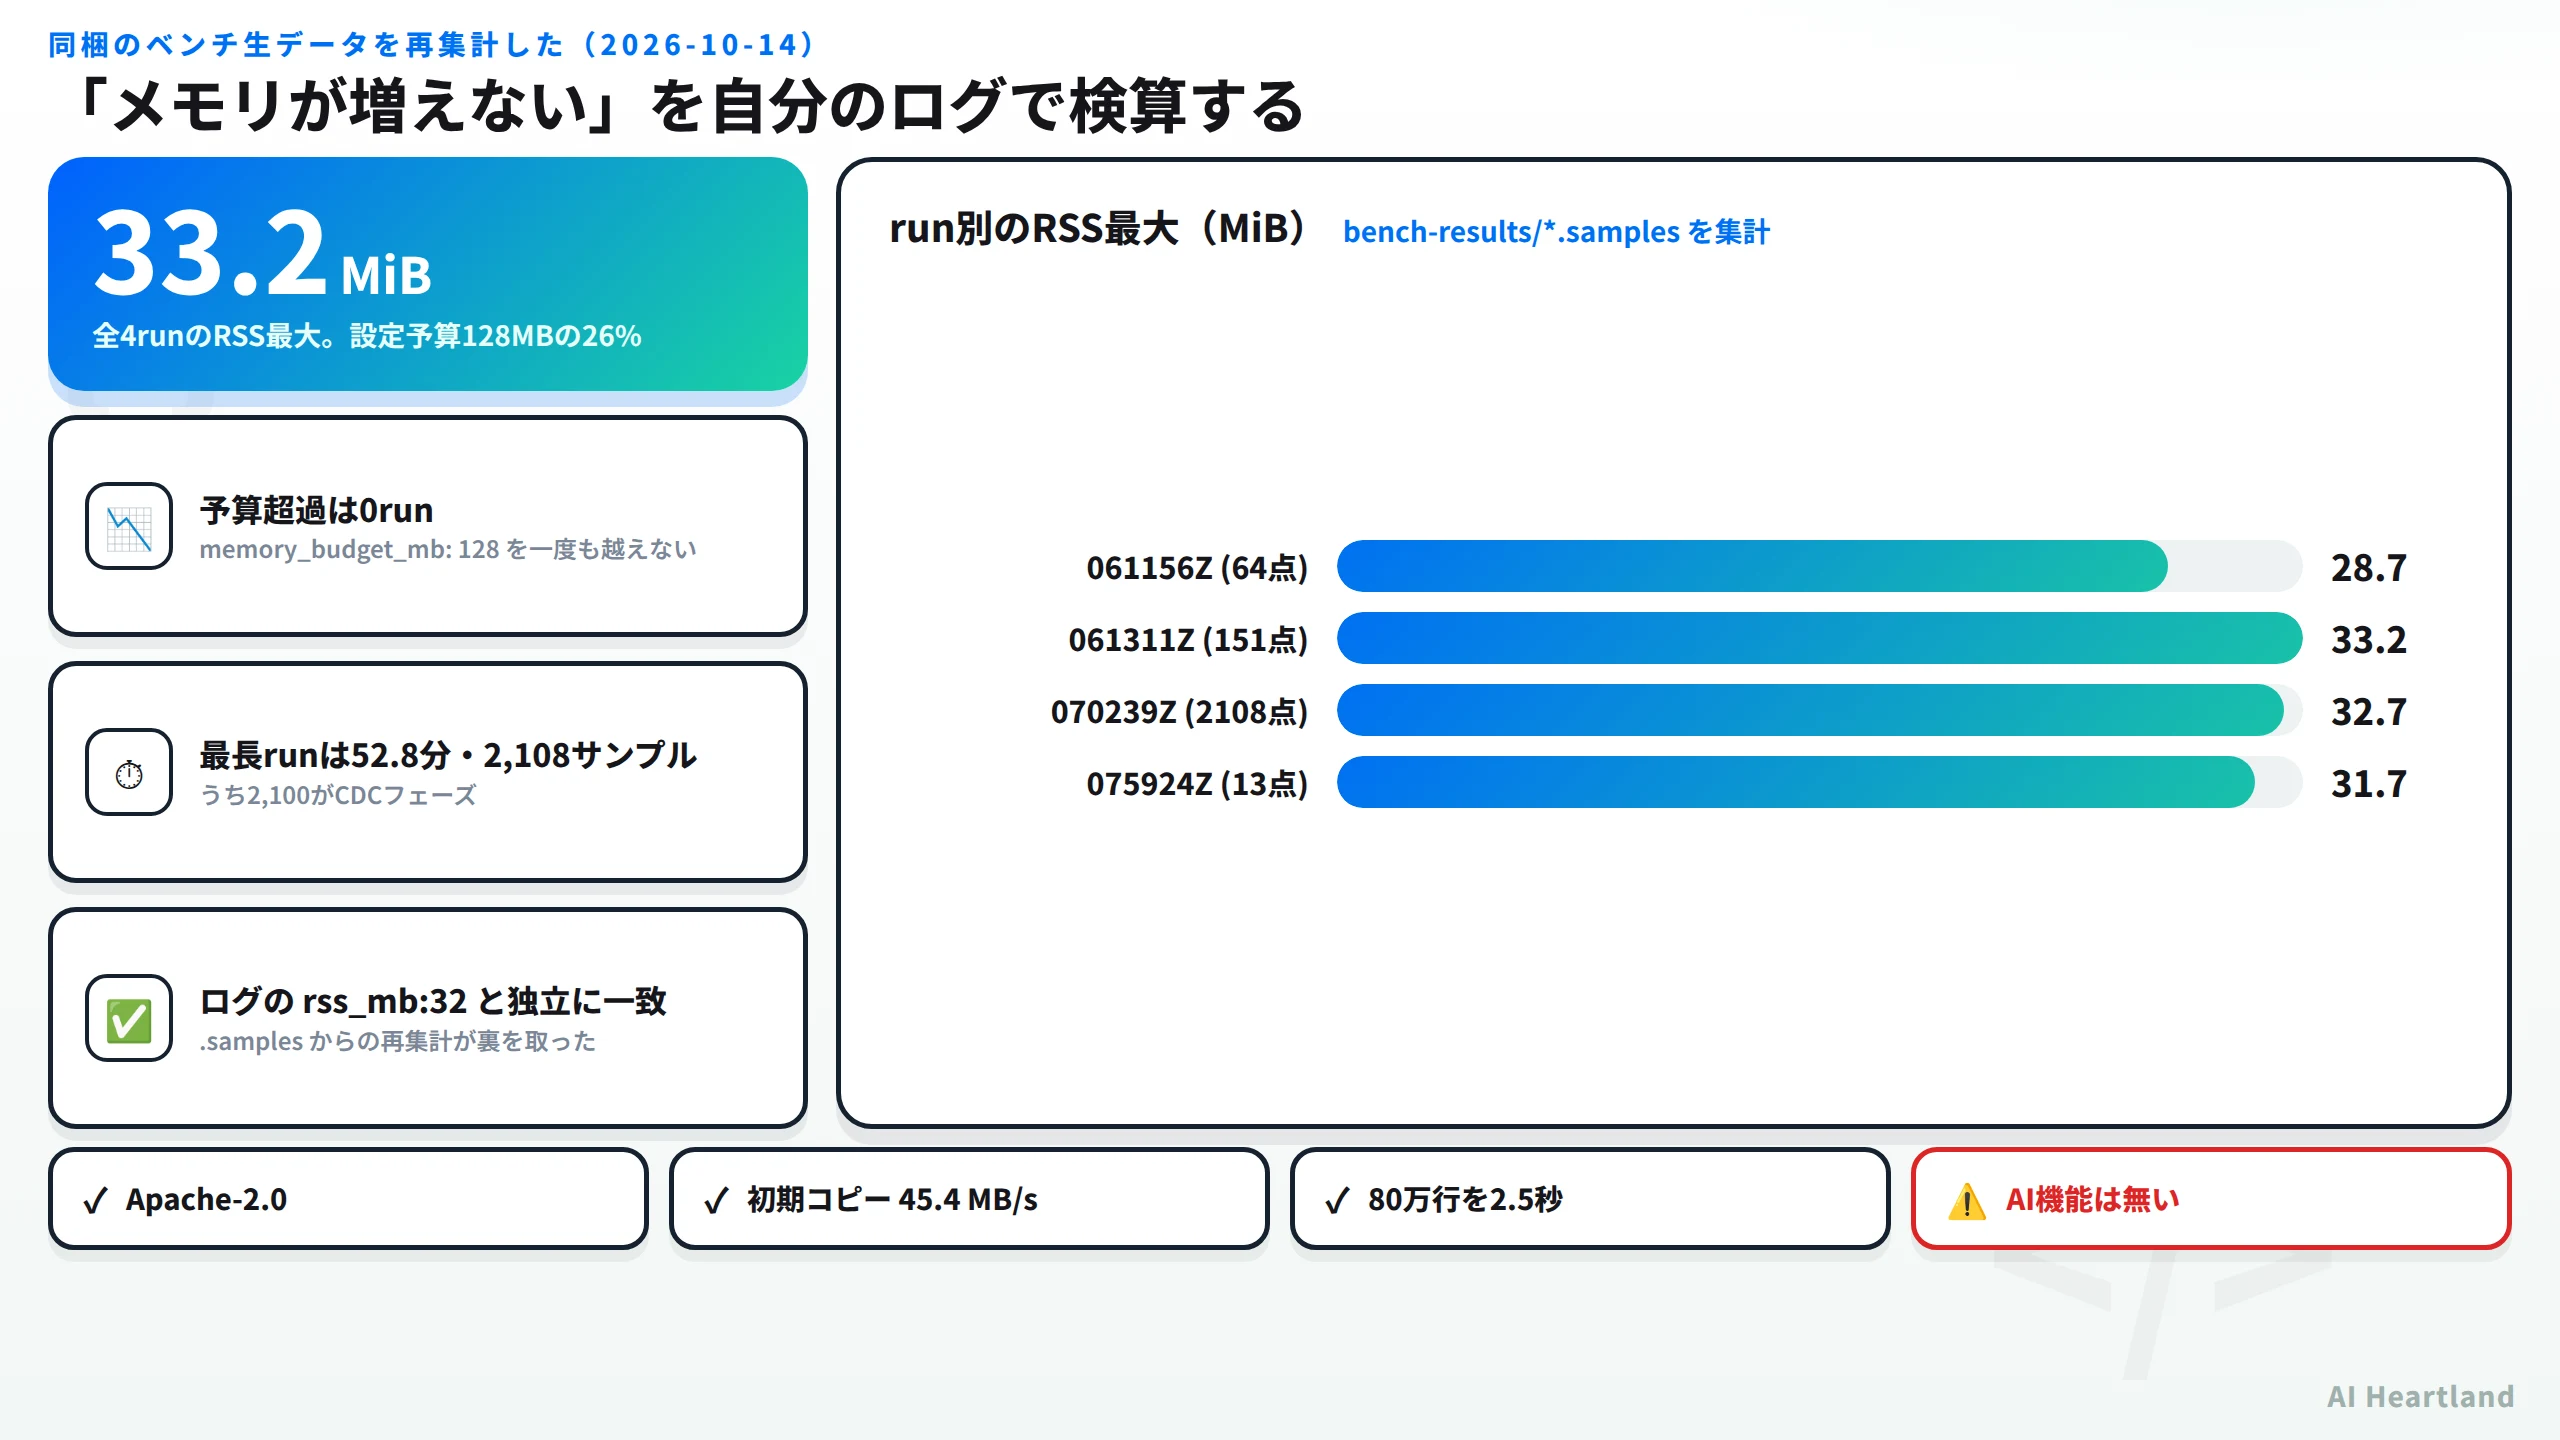
・同梱のベンチ生データ4runを再集計すると RSS最大 33.2 MiB、設定予算128MBを一度も超えていない
・PostgreSQL 16 を2台立てて5万行の同期と INSERT/UPDATE/DELETE の伝播を実際に通した。そのときの RSS は 7〜8 MiB
・check が22項目を検査し、WAL保持の上限なしとスーパーユーザー接続を警告してくる
・AI機能は無い。読者からの明示依頼で取り上げている
Postgres論理レプリケーションの「メモリが増えない」を同梱データで検算する
まず主張の中身を確かめる。bench-results/ には実行ごとに .log・.samples・.yaml の3点が入っていて、.samples は1秒ごとの生サンプルだ。
# 同梱のベンチ生データを自分で再集計する
git clone --depth 1 https://github.com/pgrundev/pgsync
head -3 pgsync/bench-results/*.samples | head -6
中身は epoch RSS(bytes) CPU(%) phase という4列で、こうなっている。
1791871922 1359872 0.0 snapshot
1791871923 16039936 56.1 snapshot
1791871924 28016640 33.9 snapshot
これを run ごとに集計した結果が次の表だ。.yaml 側に書かれている memory_budget_mb: 128 と突き合わせている。
| run | サンプル数 | RSS最大 | RSS中央値 | CPU最大 | 予算128MBに対して |
|---|---|---|---|---|---|
| bench-20261013T061156Z | 64 | 28.7 MiB | 12.7 MiB | 56.1% | 22% |
| bench-20261013T061311Z | 151 | 33.2 MiB | 14.2 MiB | 43.1% | 26% |
| bench-20261013T070239Z | 2,108 | 32.7 MiB | 15.0 MiB | 73.1% | 26% |
| bench-20261013T075924Z | 13 | 31.7 MiB | 31.0 MiB | 97.2% | 25% |
4run とも予算の4分の1あたりで頭打ちになっている。 最長の run は 2,108 サンプル=52.8分で、うち 2,100 サンプルが CDC フェーズだった。長く流しても増えていない、というのがこのデータの読みどころだ。
偶然の一致ではないことを、別経路で確かめる
再集計した値が正しいかどうかは、同じリポジトリの .log 側で裏が取れる。pgsync は定期的に自分の RSS を構造化ログに出しており、最長 run のログにはこう書かれている。
{"message":"status","state":"STREAMING","txns_applied":2230,"rows_applied":117307,
 "events":124432,"bytes_received":23613215,"apply_lag_bytes":0,"rss_mb":32,"reconnects":0}
rss_mb: 32 は、私が .samples から独立に計算した 32.7 MiB と一致する。 計測経路が2つあって同じ値を指しているので、どちらかの読み違いという可能性は小さい。
同じログから初期コピーの性能も読める。2テーブル・80万行・114,008,632バイトを2.5秒で、mb_per_s: 45.4 と記録されていた。
ここで線を引いておく。これは開発元が記録したデータの再集計であって、私による独立再現ではない。 言えるのは「配られている数字は内部で整合している」までで、別のハードウェア・別のスキーマで同じ値が出るかは分からない。
PostgreSQL を2台立てて実際に流す
数字の検算だけでは「動くのか」は分からないので、手元で通した。Docker は使えない環境だったが、Ubuntu の PostgreSQL 16 が入っていたので2インスタンスを別ポートで起動している。
# ソース側だけ wal_level=logical にして2台起動する
initdb -D /var/tmp/pgtest/src -U postgres --auth=trust
printf 'port=5433\nwal_level=logical\nmax_replication_slots=10\nmax_wal_senders=10\n' \
  >> /var/tmp/pgtest/src/postgresql.conf
pg_ctl -D /var/tmp/pgtest/src -l /var/tmp/pgtest/src.log start
ビルドは cargo build --release -p pgsync-cli が 1分37秒で完了し、39MBのバイナリが1つできた。サブコマンドは check bootstrap run status cleanup の5つ。
check は22項目を見て、何も変えない
本番に入れる前に効くのがこれだ。
export PGSYNC_SOURCE_URL='postgres://postgres@localhost:5433/app'
export PGSYNC_TARGET_URL='postgres://postgres@localhost:5434/app'
pgsync --config job.yaml check
5万行のテーブルとパブリケーションを用意して実行すると、21行の判定が返った。抜粋する。
| 判定 | 項目 | 内容 |
|---|---|---|
| PASS | wal_level | logical |
| PASS | publication_tables | 1 tables match replication.tables |
| PASS | table public.users | primary key (id) |
| WARN | max_slot_wal_keep_size | unlimited: 止まった消費者がソースのディスクを WAL で埋めうる |
| WARN | least_privilege | スーパーユーザーで接続中。REPLICATION と SELECT だけの専用ロールが望ましい |
| WARN | source_tls / target_tls | plain connection (loopback) |
| FAIL | target table public.users | already exists; use –restart-snapshot or schema.mode: existing |
WARN の2つは、言われなければ本番で踏むやつだ。 max_slot_wal_keep_size が無制限のままレプリケーションが止まると、保持された WAL がソース側のディスクを食い潰す。スーパーユーザー接続の指摘も、移行作業では雑になりがちな部分を正確に突いている。
FAIL は私が先にターゲット側へテーブルを作っていたせいで、対処法まで併記されている。終了コードは設定不備が 2、プリフライト失敗が 3 と分かれていた。指示どおりテーブルを落とすと OK: prerequisites satisfied に変わった。
21項目の全文(実行結果そのまま)
抜粋だけだと「都合のいい所を選んだのでは」と思われるので、FAIL を直した後の出力を全部置く。これが OK: prerequisites satisfied が出たときの状態だ。
| 対象 | 判定 | 項目 | 内容 |
|---|---|---|---|
| source | PASS | server_version | PostgreSQL 16.15 (Ubuntu 16.15-0ubuntu0.24.04.1) |
| source | PASS | wal_level | logical |
| source | PASS | max_replication_slots | 10 (0 in use) |
| source | PASS | max_wal_senders | 10 |
| source | WARN | max_slot_wal_keep_size | unlimited: 止まった消費者がソースのディスクを保持WALで埋めうる |
| source | PASS | wal_sender_timeout | 1min |
| source | PASS | role | postgres has REPLICATION (superuser) |
| source | WARN | least_privilege | スーパーユーザー接続。REPLICATION と SELECT のみの専用ロールが望ましい |
| source | PASS | publication | pgsync_demo exists |
| source | PASS | publication_operations | insert, update, delete, truncate |
| source | PASS | publication_tables | 1 tables match replication.tables |
| source | PASS | table public.users | primary key (id) |
| source | PASS | slot | まだ存在しない。bootstrap が作る |
| source | PASS | replication_connection | system 7696260439405413726 timeline 1 |
| source | WARN | source_tls | plain connection (loopback) |
| target | PASS | target_version | PostgreSQL 16.15 |
| target | PASS | target_role | superuser (session_replication_role = replica available) |
| target | PASS | target_pgsync_schema | writable |
| target | PASS | pg_dump | pg_dump (PostgreSQL) 16.15 |
| target | PASS | target table public.users | pg_dump schema bootstrap が作成する |
| target | WARN | target_tls | plain connection (loopback) |
PASS 17・WARN 4・FAIL 0 で OK になった。WARN が残っていても先へ進める設計で、止めるのは FAIL だけだ。ループバック接続のTLS警告2件は、この検証環境だから出ているもので本番では潰すべき項目になる。
見落としやすいのが publication_operations の行だ。パブリケーションが insert, update, delete, truncate のどれを配信する設定かを読み出して見せている。CREATE PUBLICATION で操作を絞っていると、ここに出ない操作は流れてこない。レプリケーションが「一部だけ届かない」ときの原因になりやすい箇所を、事前に目視できる形にしているのは実用的だ。
replication_connection の system 7696260439405413726 timeline 1 は、ソースのシステム識別子とタイムラインだ。ソースをPITRで巻き戻したりフェイルオーバーさせたりすると、ここが変わる。継続性が切れたこと(終了コード4の RESYNC_REQUIRED)を検出する土台になっている。
スナップショットと CDC を通す
pgsync --config job.yaml bootstrap # スロット作成 → スナップショット → コピー → ストリーム
ログは snapshot complete; switching to CDC → START_REPLICATION accepted → caught up; now streaming と進み、5万行がターゲットに入った。このときの rss_mb は 8。
ストリーミング中にソース側へ書き込んで、伝播を確かめた。
| 操作 | ソース側 | ターゲット側の結果 |
|---|---|---|
| INSERT | [email protected] を追加 |
Live Row が出現 |
| UPDATE | [email protected] の名前を変更 |
Renamed に更新 |
| DELETE | [email protected] を削除 |
該当行 0 件 |
| 行数 | 50,000 | 50,000(+1 −1 で一致) |
txns_applied=3 rows_applied=3 rss_mb=7 と記録されていた。3トランザクションが取りこぼしなく届いている。
一貫したスナップショットをエクスポート"] B --> C["指定テーブルを並列コピー
本記事では5万行"] C --> D{"コピー完了"} D --> E["pgoutput で CDC を開始
consistent_point から"] E --> F["1ソーストランザクション
= 1ターゲットトランザクション"] F --> G["チェックポイントをデータと同時にコミット"] G --> H["Ctrl-C で停止しても
run で続きから再開"]
止めるときも素直だった。shutdown requested; finishing the current transaction の後に replication stopped cleanly が出て、チェックポイントが残る。run サブコマンドで続きから再開できる。
開発元が自分で引いている線
この記事で一番評価したいのは、プロジェクトが自分の限界を文書にして同梱している点だ。docs/beta-assessment.md の冒頭にこう書かれている。
Verdict: READY for Controlled Technical Beta (synthetic / approved non-sensitive data only) NOT READY for any production customer data: no masking, no DDL handling, single node.
v0.1.0 という版数と整合した、過不足のない自己申告だ。本番の顧客データには使うなと明示したうえで、理由を3つ挙げている。マスキングが無い・DDL変更を扱えない・単一ノードである。
| 開発元が認めている制約 | 実務での意味 |
|---|---|
| no masking | 個人情報を含むテーブルをそのまま流すと、ターゲットにも素のまま載る |
| no DDL handling | ソース側で ALTER TABLE すると追随しない。スキーマ変更は手で合わせる必要がある |
| single node | pgsync 自身が冗長化されていない。プロセスが死ねば止まる |
Postgres論理レプリケーションの道具は「とりあえず動く」までは早いが、この3つは移行プロジェクトの中盤で必ず効いてくる。先に書いてあるのは助かる。
ベンチを取った機械まで書いてある
docs/test-report.md は計測環境をここまで明かしている。
Machine: Apple M1 Pro, 10 cores, 16 GiB RAM, macOS 14.4 (Darwin 23.4.0). Docker Desktop 28.5.1 … for the end-to-end suite; host-local PostgreSQL 18.6 (Homebrew) for the large-table scenario and benchmarks because the Docker VM disk was full.
ディスクが埋まったのでベンチだけホスト側の PostgreSQL 18.6 で取った、という事情まで書いている。数字だけ出して環境を書かない計測より、ずっと読み手に優しい。 私の手元が x86 の Ubuntu コンテナ・PostgreSQL 16.15 なので、同梱ベンチの値をそのまま自分の環境の予測に使えないことも、この記述から分かる。
e2e シナリオは22本と記載されていて、check の検査項目数と同じ22なのは偶然だ(別のもの)。受け入れ基準の表には「スナップショットとCDCの引き継ぎが一貫していること」の根拠として CREATE_REPLICATION_SLOT ... EXPORT_SNAPSHOT と SET TRANSACTION SNAPSHOT、さらに writes_during_snapshot_are_not_lost_or_duplicated というテスト名が挙がっている。スナップショット中の書き込みが落ちも重複もしないことを、名前付きのテストで担保しているという主張だ。
設定で何が絞れるか
examples/pgsync.yaml に出てくる設定項目を数えると約35個ある。メモリ関連だけでも4つあり、「memory-bounded」が単一のノブではないことが分かる。
| 分類 | 項目 | 効くところ |
|---|---|---|
| メモリ | memory_budget_mb / buffer_size_kb / max_inflight_bytes / channel_capacity |
本記事が検算した上限。既定の128MBで RSS は33 MiB止まりだった |
| バッチ | max_batch_rows / max_batch_bytes |
ターゲットへの書き込み粒度 |
| 並列 | max_parallel_copies |
初期コピーの並列度。ベンチでは2 |
| 再試行 | retry_backoff.initial / .max / .multiplier / max_attempts |
切断からの復帰 |
| 安全 | require_tls / insecure_skip_tls_verify / auto_create_publication / auto_drop_slot |
事故の防ぎ方 |
| WAL監視 | wal_retention_alarm_bytes / wal_retention_action / monitor_interval |
check が警告した WAL 肥大への備え |
注目は最後の行だ。check が「max_slot_wal_keep_size が unlimited だとソースのディスクが埋まる」と警告してくる一方で、pgsync 側にも wal_retention_alarm_bytes と wal_retention_action という受け皿がある。実際、ストリーミング中のログには10秒おきに WAL 監視行が出ていた。
wal monitor slot=pgsync_demo_slot active=true wal_status=Some("reserved")
  retained_wal_bytes=278560 slot_lag_bytes=0 apply_lag_bytes=278560 safe_wal_size=None
retained_wal_bytes と slot_lag_bytes を常時出しているので、「スロットが残り続けて WAL が溜まる」という論理レプリケーション最大の事故を、監視に乗せやすい形で露出している。
コード規模とクレート分割
| クレート | Rustファイル | 行数 | 役割 |
|---|---|---|---|
| pgsync-postgres | 16 | 5,077 | プロトコル・pgoutput の解釈 |
| pgsync-core | 13 | 3,174 | スナップショット/CDC の制御 |
| pgsync-cli | 4 | 1,611 | コマンドと設定 |
合計 9,862行、Cargo.lock に並ぶ依存は 210 だった。レプリケーションエンジンとしては小さい部類で、プロトコル層が半分を占めている形が素直だ。docs/ には architecture.md protocol-reference.md operations.md など7本が置かれている。
設計で目を引いた2点
接続情報を設定ファイルに書かせない。 job.yaml は url_env: PGSYNC_SOURCE_URL という形で環境変数名だけを持つ。URL そのものは YAML に入らないので、設定ファイルをリポジトリに置いても資格情報が混ざらない。
行データをデフォルトで出さない。 --show-keys のヘルプにこう書かれている。「Include key column values (e.g. id=42) in the per-transaction lines. These are row data; off by default」。ログに主キーの値を出すかどうかを明示的なフラグにして、既定を off にしている。レプリケーションのログは量が出るので、この既定は効く。
素のPostgres論理レプリケーション(組み込みサブスクリプション)と何が違うのか
PostgreSQL には CREATE SUBSCRIPTION が最初から入っている。それを使わない理由が README に正面から書かれているので、そのまま引く。
A built-in
CREATE SUBSCRIPTIONis the right tool when the target is a PostgreSQL you administer and you want the server to own the process. pgsync exists because PGRun needs the replication engine outside the database: a separate process whose crash cannot take the runtime down, that will later rewrite rows (masking) between decode and apply, and that can feed non-PostgreSQL storage.
「組み込みのほうが正しい場面がある」と先に認めている。 そのうえで、プロセスをデータベースの外に出したい理由を3つ挙げる。レプリケーションが落ちてもランタイムを巻き込まない、デコードと適用の間に行を書き換える(マスキング)余地を作る、PostgreSQL 以外の保存先にも流せる。
マスキングはまだ無い(Not in Beta 1 に明記)ので、これは将来の設計余地の説明として読むのが正しい。
| 比較対象 | pgsync が違う点(README の記述) |
|---|---|
組み込み CREATE SUBSCRIPTION |
エンジンがDBの外。一貫性(エクスポートされたスナップショット、コミット順の原子的適用)は維持しつつ、チェックポイントを自分で持つ |
| pgstream(Go) | 主要な参照実装。docs/research/pgstream-audit.md に監査あり。pgsync は wal2json ではなく pgoutput、トランザクション境界をまたいでバッチせず保持、チェックポイントをスロットだけでなくトランザクションで保存、適用エラーで drop-and-continue せず厳格に停止 |
| Debezium 等のブローカー型CDC | ブローカー型は多数の消費者へのファンアウトを解く。pgsync は Beta 1 ではジョブあたり消費者1・ブローカー無しで設計している |
「先行実装を監査した結果をリポジトリに置く」という作り方は珍しい。pgstream との差分を4点に絞って明文化しているので、どちらを選ぶかの判断材料になる。
終了コードが状態遷移と結びついている
運用ドキュメントには終了コードの表があり、コードごとにジョブの状態と次の操作が決まっている。
| 終了コード | 意味 | ジョブ状態 | 次にやること |
|---|---|---|---|
| 0 | シグナルで停止、またはコマンド完了 | 変化なし | run で再開 |
| 1 | ランタイムエラー(一時障害は再試行後) | ERROR |
ログを見て run |
| 2 | 設定 | 変化なし | 設定を直す |
| 3 | プリフライト | 変化なし | 前提条件を直す |
| 4 | 継続性の喪失 | RESYNC_REQUIRED |
cleanup --yes してから bootstrap |
| 5 | 非対応の変更・一貫性違反 | ERROR |
ターゲットのスキーマを直すか乖離を調査して run |
本記事で実際に観測したのは 2(環境変数未設定)と 3(ターゲットにテーブルが既存)で、どちらも表のとおり「変化なし」のまま止まり、ソース側に何も作らなかった。
4 と 5 の区別が効いている。 4 は「もう追いつけないので取り直せ」、5 は「流れは生きているがスキーマが合っていない」。この2つを同じエラーにしているツールだと、復旧手順を人間が毎回考えることになる。
状態は pgsync.job という行に持たれ、last_error も残る。run を始めると ERROR → CATCHING_UP、接続時に観測したサーバーの WAL 末尾に追いつくと CATCHING_UP → STREAMING に遷移する。私の実行ログでも state=CATCHING_UP のあとに caught up; now streaming が出ており、ドキュメントどおりだった。
Beta 1 に入っていないものの一覧
docs/features.md の末尾に、入っていない機能が列挙されている。
マスキング、DDLレプリケーション、マルチノードHA、PostgreSQL以外のシンク、ソース側のフェイルオーバー、部分スナップショットの再開、処理中トランザクションのディスク退避、Prometheus エンドポイント、ctid範囲の並列コピー、バイナリワイヤフォーマット、SCRAM のチャネルバインディング。
この並びを見ると、本記事が測った「メモリが増えない」は、ディスク退避を持たないことの裏返しでもあると分かる。処理中のトランザクションを溢れさせない設計にしているから上限が効く。逆に言えば、1トランザクションが極端に大きい場合の挙動は max_inflight_bytes の設定次第になる。そこは今回試していない。
Prometheus エンドポイントが無いのは運用で効く。監視は構造化ログ(--json)を取り込む形になる。
AI的な切り口は無い
当サイトは AI 関連 OSS と開発者向けセキュリティを柱にしている。pgsync にはその両方に当たる要素が無い。 AI 機能も、LLM 連携も、エージェント向けのインターフェースも入っていない。純粋な PostgreSQL 運用ツールだ。
読者からの明示依頼で取り上げているので、無理に AI の角度を作らずそのまま書いた。レプリケーション先を分析用 DB に向ければ RAG のデータソース整備に使える、といった接続は書けるが、それは pgsync 側の設計意図ではない。
同じ領域の道具
PostgreSQL まわりで当サイトが実測した他の道具も、用途が重ならない形で並べておく。
・sql-tapとは|アプリを無改修でSQLトラフィックをリアルタイムに覗くGo製プロキシ型TUI/Web — 流れているクエリを見る側。pgsync が「変更を運ぶ」のに対し、こちらは「何が走っているか」を可視化する
・TableProとは|TablePlus代替のmacOSネイティブOSSデータベースクライアントを実測 — 移行後のターゲットを人間が覗くためのクライアント
移行プロジェクトでは「運ぶ・見る・触る」の3つが別々の道具になりがちで、pgsync は最初の1つだけを受け持つ。check が前提条件を潰し、status が位置とラグを返すところまでで、中身のクエリ分析やデータ閲覧は守備範囲外だ。役割を広げていないのが、このツールの読みやすさにつながっている。
未検証で残したもの
・大規模環境での独立再現。手元のテストは5万行・1テーブル・ループバック接続で、同梱ベンチの80万行・2テーブルにも届いていない。メモリ上限の主張を自分のハードウェアで確かめたわけではない
・PostgreSQL 17 と 18。README は16〜18対応と書いているが、動かせたのは 16.15 だけ
・長時間運用。最長でも40秒しか流していない。同梱ベンチの52.8分に相当する連続稼働は試していない
・star 数。api.github.com と github.com のHTMLがこの環境から遮断されているため測っていない
・cleanup サブコマンド。スロット削除は実行していない
測った手順
# ① ビルドして版を確認する(1分37秒・39MBのバイナリ1本)
cargo build --release -p pgsync-cli
./target/release/pgsync --version    # → pgsync 0.1.0
# ② 同梱ベンチの RSS 最大と予算を突き合わせる
python3 - <<'PY'
import glob, re, os
for f in sorted(glob.glob('bench-results/*.samples')):
    rss=[int(l.split()[1]) for l in open(f) if len(l.split())>=4]
    y=f.replace('.samples','.yaml')
    b=re.search(r'memory_budget_mb:\s*(\d+)', open(y).read()) if os.path.exists(y) else None
    print(f, f"{max(rss)/1048576:.1f} MiB", "budget", b.group(1) if b else "-")
PY
# ③ 何も壊さずに前提条件だけ見る(終了コード 0/2/3 で分岐)
pgsync --config job.yaml check; echo "exit=$?"
③は変更を一切行わないので、本番のソースに対しても安全に流せる。
参照ソース
・pgrundev/pgsync(GitHub) — 本記事が 2026-10-14 に clone して測った対象
・LICENSE — Apache-2.0。ライセンスの実体として読んだファイル
・PostgreSQL 公式ドキュメント: Logical Replication — pgoutput とスロットの仕様