OCR ライセンスを確認するとき、リポジトリのバッジを1枚見て終わりにすると踏むことがある。Indra OCR はその典型で、コードと重みでライセンスが分かれている。
2026-10-14 に datalab-to/indra を clone し、PyPI から導入して起動まで確かめた。性能の検証には至らなかったが、その理由も含めて記録する。
この記事は「LLM」クラスタの1本です。モデル全般の見取り図は LLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版 にまとめています。
30秒でわかる
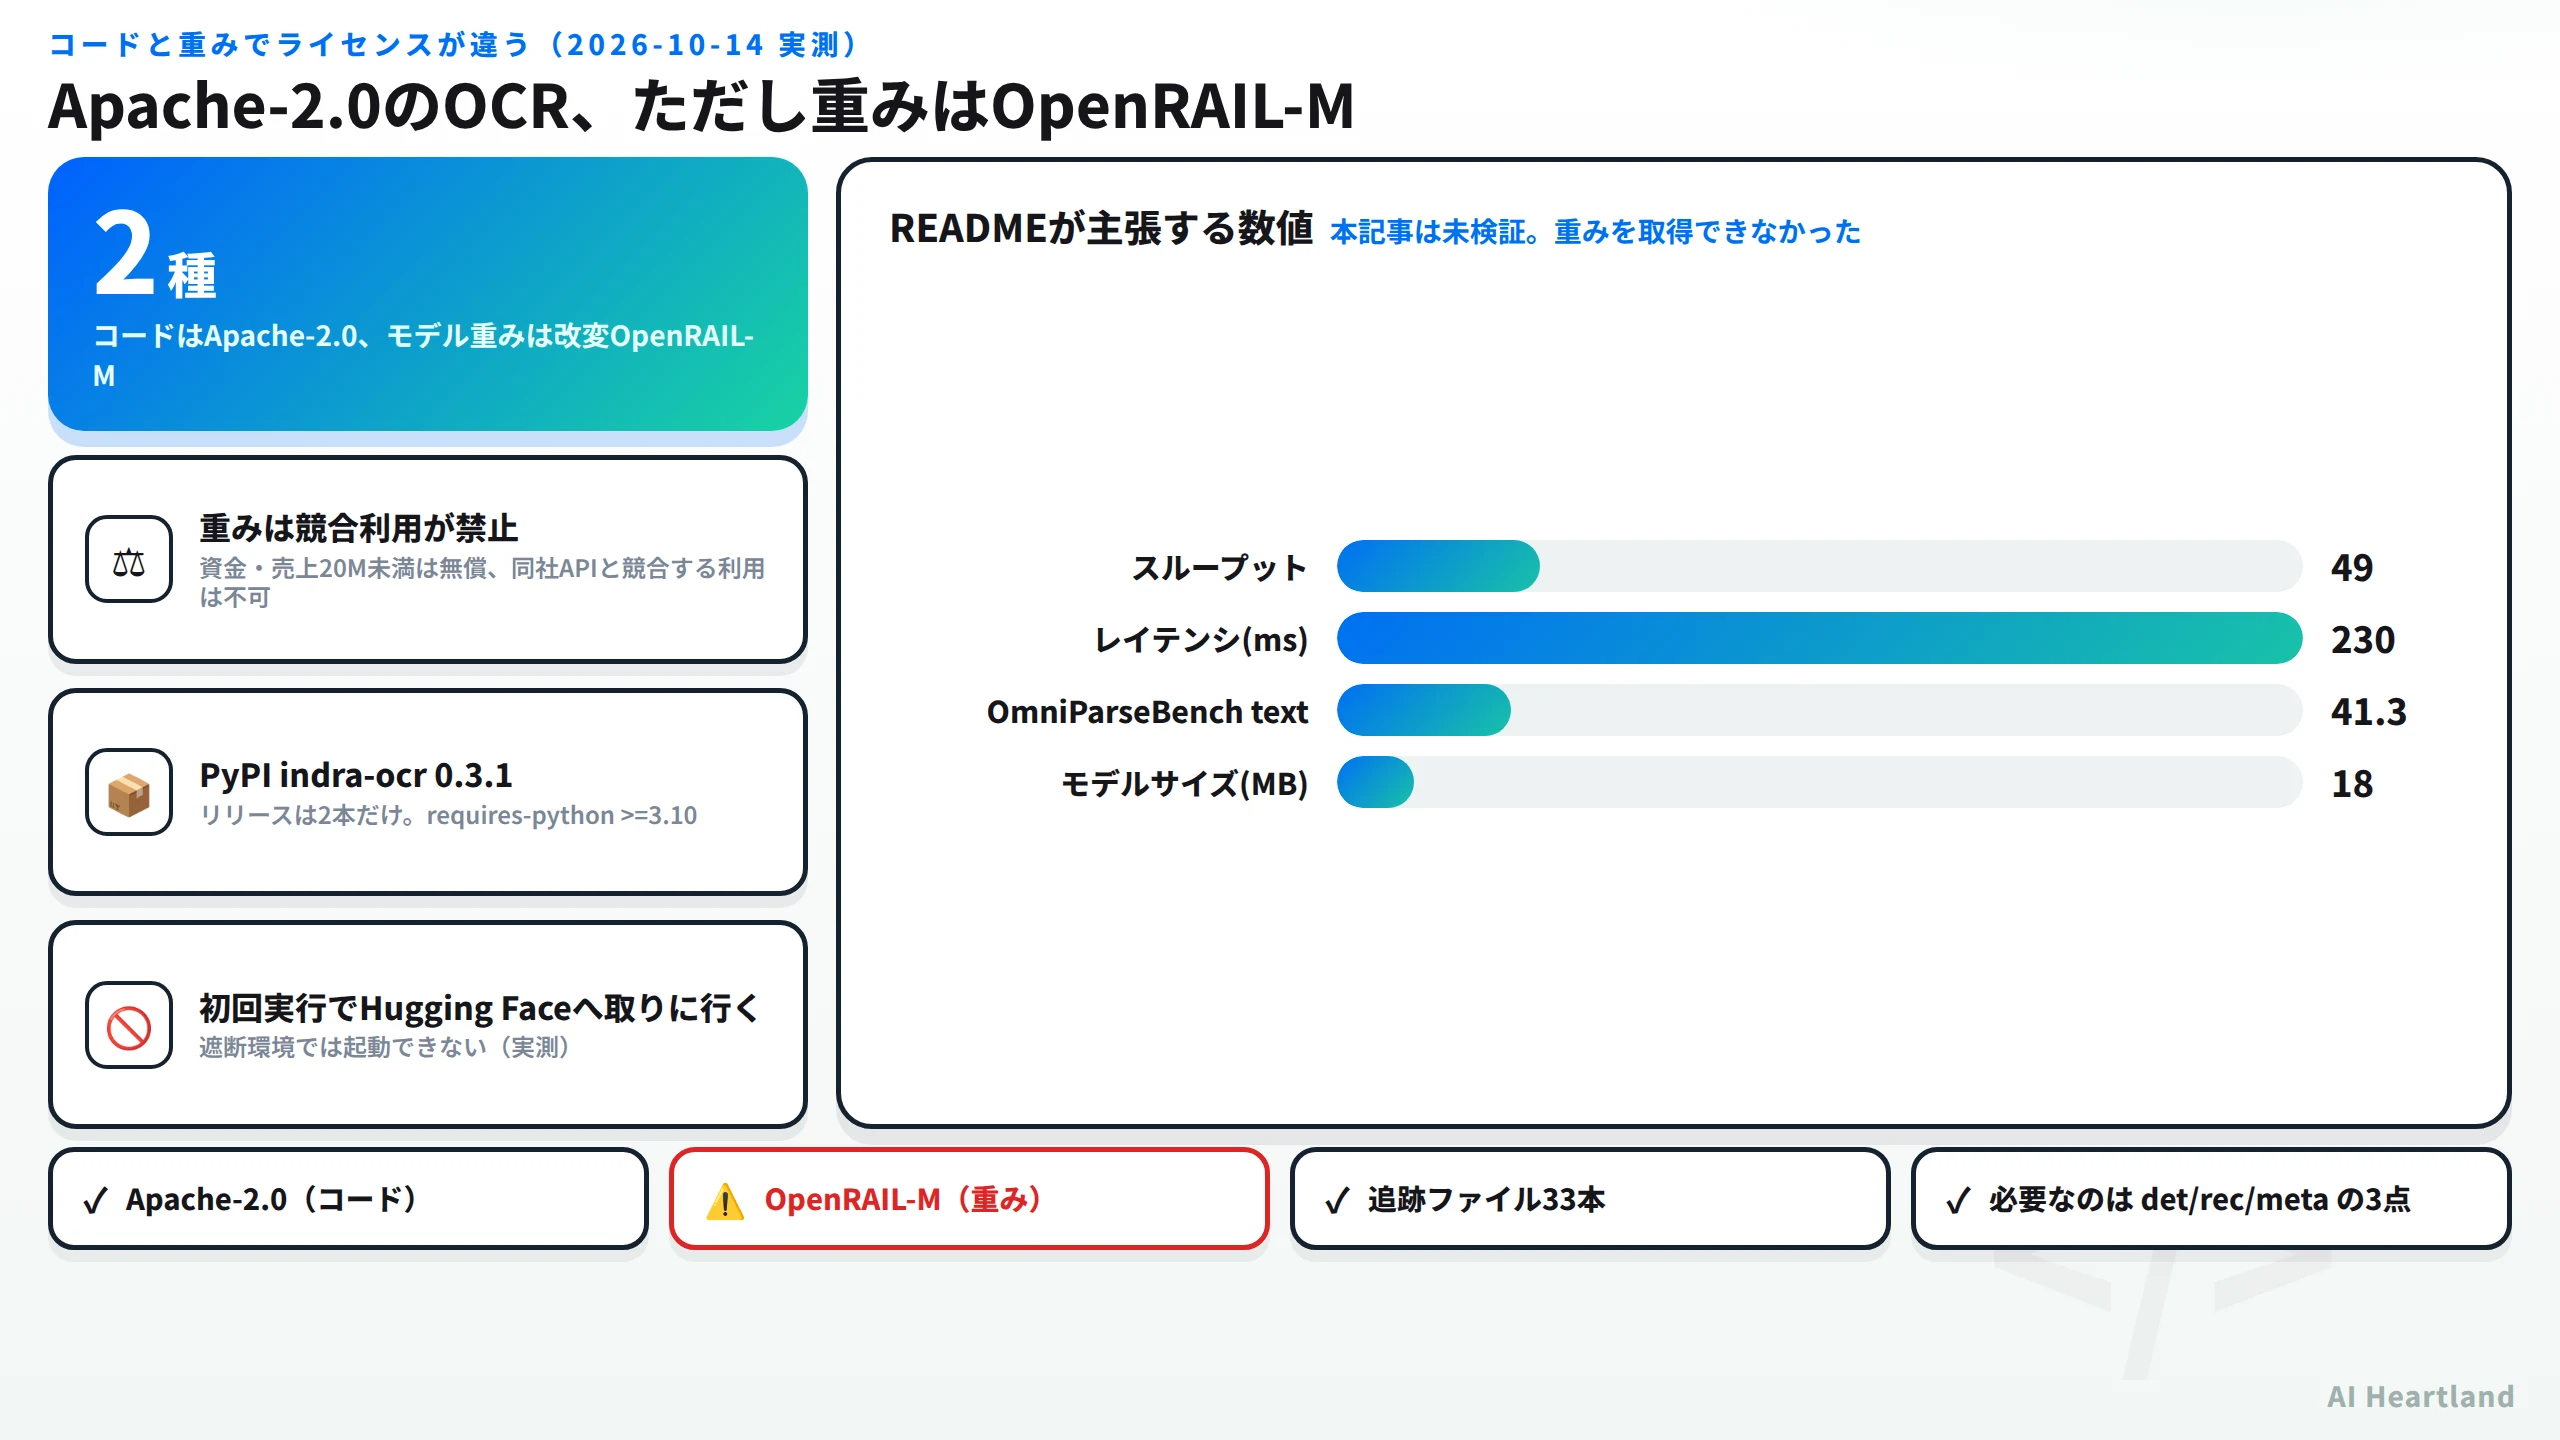
・コードは Apache-2.0、モデル重みは改変 OpenRAIL-M。バッジも README も分けて書いている
・重みは研究・個人・資金/売上2,000万ドル未満のスタートアップは無償。ただし提供元APIと競合する利用は不可
・PyPI の indra-ocr は 0.3.1、リリース2本。導入は通ったが初回実行で Hugging Face を取りに行く
・遮断環境では終了コード1で止まり、det.onnx rec.onnx meta.json を置けと具体的に案内される
ライセンスが2つに分かれている
リポジトリの冒頭にはバッジが2枚並んでいる。片方が Code License: Apache_2.0、もう片方が Model License: OpenRAIL-M で、しかも後者のリンク先は OSI でも Hugging Face でもなく Datalab の価格ページだ。
README 本文の記述はこうなっている。
The code is Apache 2.0. The model weights use a modified OpenRAIL-M license. This code is Apache 2.0, and our model weights use a modified OpenRAIL-M license (free for research, personal use, and startups under $20M funding/revenue, cannot be used competitively with our API).
| 対象 | ライセンス | 条件 |
|---|---|---|
コード(datalab-to/indra) |
Apache-2.0 | pyproject.toml の license = "Apache-2.0" と LICENSE の実体が一致 |
モデル重み(datalab-to/indra-ocr) |
改変 OpenRAIL-M | 研究・個人・資金/売上 $20M 未満のスタートアップは無償 |
| 商用で制限を外す | 別途契約 | 価格ページへ誘導 |
「OSSのOCRを入れた」で済ませられない。 コードだけを読む・改変する分には Apache-2.0 で完結するが、実際に文字を読ませるには重みが要る。そして重みには競合利用の禁止という、OSI の定義に収まらない条項が付いている。
この構図は当サイトで何度か見ている。ライセンスは静かに変わるし、同じリポジトリの中でも部位によって違う。バッジを1枚見て判断しないのが唯一の防御だ。
# ライセンスの実体を分けて確認する
git clone --depth 1 https://github.com/datalab-to/indra
head -4 indra/LICENSE                      # → Apache License Version 2.0
grep -n "Model License\|OpenRAIL" indra/README.md
LICENSE ファイル自体は純粋な Apache-2.0 で、重みの条項はそこには書かれていない。リポジトリ直下の LICENSE を読むだけでは気づけない構造になっている点に注意したい。重み側の条文は Hugging Face 上の別ファイルにある。
同じ会社の Chandra との役割分担
README は自社のマネージドプラットフォームへの導線も隠していない。
Indra OCR is built for speed on CPUs. When you need the highest accuracy, on handwriting, math, complex tables and degraded scans, our managed platform runs Chandra, our state of the art OCR model, with zero data retention by default, SOC 2 Type 2, and custom BAAs.
速度のIndra、精度のChandraという住み分けを明示している。手書き・数式・複雑な表・劣化したスキャンは Chandra 側だ、と先に言っている。
重みの「競合利用の禁止」条項と合わせて読むと、位置づけがはっきりする。ローカルで高速に捌く用途には開放し、精度が要る領域と、それをAPIとして売る行為は囲っている。 ビジネスとしては筋が通っており、利用者側は「自社のどの用途がどちらに当たるか」を先に判断すればいい。
改変 OpenRAIL-M の範囲内"] B -->|"資金/売上 20M ドル以上"| D["別途ライセンスが必要"] B -->|"OCR を API として売る"| E["競合利用に当たる
重みのライセンスで禁止"] C --> F{"精度は足りるか"} F -->|"足りる"| G["CPU でローカル実行"] F -->|"手書き・数式・複雑な表"| H["Chandra 側へ
マネージド基盤"]
導入は通る。止まるのはモデル取得
ここからは実際に動かした記録だ。導入自体はあっさり通る。
# PyPI から導入する(仮想環境を切って実行)
python3 -m venv .venv && .venv/bin/pip install indra-ocr
.venv/bin/python -c "import importlib.metadata as m; print(m.version('indra-ocr'))"
0.3.1 が入った。依存は huggingface_hub numpy onnxruntime opencv-python-headless pypdfium2 の5つが本体で、pikepdf pillow pytesseract pytest は条件付きだ。PyTorch が依存に無いのは README の主張どおりで、ONNX Runtime だけで完結している。
PyPI 側のメタデータも確認した。
| 項目 | 値 |
|---|---|
| バージョン | 0.3.1 |
| 公開リリース数 | 2 |
| requires_python | >=3.10 |
| summary | Fast CPU OCR: line detection, CTC recognition, reading order and markdown, on ONNX Runtime |
| Repository | https://github.com/datalab-to/indra |
| Models | https://huggingface.co/datalab-to/indra-ocr |
リリースが2本しかないのは若いプロジェクトである証拠だ。リポジトリ側の追跡ファイルは33本、直近コミットは 2026-10-13 だった。
遮断環境でどこで止まるか
テスト用の画像を1枚作って実行した。
# 実行すると初回はモデルを取りに行く
.venv/bin/indra-ocr sample.png
返ってきたのはこれだ。
indra-ocr: could not download the models from Hugging Face (datalab-to/indra-ocr, v3.1):
ProxyError: 403 Forbidden. Check the network connection, or point at a local model folder
with --model-dir or INDRA_OCR_MODEL_DIR.
この検証環境は huggingface.co がプロキシに遮断されている。 つまりこれは Indra OCR の欠陥ではなく、こちら側の制約だ。ただしエラーの出方は確かめる価値があったので、細かく測った。
| 測った項目 | 結果 |
|---|---|
| 終了コード | 1(正常終了ではない) |
| 標準出力 | 0 バイト(markdown を吐く口を汚していない) |
| 標準エラー | 220 バイト |
| エラー内容 | リポジトリ名とモデル版(v3.1)、原因、回避策2種を1行で |
標準出力が空のままなのが効いている。 このツールは indra-ocr paper.pdf の出力をそのままパイプで受ける使い方を想定しているので、失敗時に標準出力へ何か書くとパイプラインが壊れる。エラーは標準エラーへ、終了コードは1、という当たり前のことがきちんとできている。
さらに --model-dir に空のディレクトリを渡してみた。
indra-ocr: the model folder empty_models lacks det.onnx, rec.onnx, meta.json
必要な3ファイルを名指ししてくる。 オフライン環境へ持ち込むときに「何を置けばいいか」をドキュメントで探さずに済む。約18MBという README の記述と合わせれば、事前配置の手順は組み立てられる。
日本語を読ませる前に知っておくこと
日本語で使う読者にとって、ライセンスより先に効く制約がある。かなは OCR の対象外だ。
README の Limitations にこう書かれている。
OCR reads Latin, Cyrillic, Greek, Devanagari, Bengali and Chinese. Other scripts, including Arabic, Hebrew, Thai, Japanese kana and Korean Hangul, work only through a digital PDF’s text layer. On scans and images they come out wrong; a Hangul line, for example, comes out as wrong Chinese characters.
つまり入力の種類で結果が割れる。
| 入力 | 日本語の扱い |
|---|---|
| デジタルPDF(テキスト層あり) | 読める。PDF自身の文字を使うため |
| スキャン画像・写真・テキスト層のないPDF | 読めない。かなが OCR の対象言語に入っていない |
ハングルの行が「誤った漢字」として出てくる、という例まで挙げられている。同じことが日本語のかなでも起きうると読むのが妥当だ。紙のスキャンを日本語で流す用途には向かない。
一方でテキスト層経由の品質は数字で示されている。
We checked text mode on 1,125 pages from 75 language families. On pages whose layer passes the checks, Indra OCR keeps at least 98% of the layer’s characters in every family, including … Chinese, Japanese and Korean. Right-to-left lines keep their right-to-left order.
1,125ページ・75語族で98%以上の文字保持、という主張だ(本記事では未検証)。デジタルPDFを markdown に整形する用途なら日本語でも成立するが、それは厳密には「OCR」ではなくテキスト層の再構成である点を押さえておきたい。
自分で認めている失敗率
Limitations には、うまくいかない場合の数値まで書かれている。ここまで書く README は珍しい。
| 苦手なもの | README の記述 |
|---|---|
| 手書き | 非対応。OmniParseBench の手書きテストで約 8% |
| 劣化したスキャン | 古い・褪せた・低解像度は読みにくい。old-scan テストで約 20% |
| 複雑な表 | 結合セル・複数行にまたがるセル・入れ子ヘッダ・罫線なしは行列がずれうる。単純な格子表は良好 |
| 縦書き | 非対応(繁体字の新聞など) |
| 数式 | --math を付けない限りプレーンテキストになる |
| 極端に横長のページ | 読みにくい |
| 図面内のラベル | 小さな表として出がち |
| 100メガピクセル超のページ | 200dpi 未満で描画されるため小さな文字が落ちる |
| 向き補正モデル | 直立したアラビア語・ヘブライ語のページの約半数を誤って回転させる。これらの文字体系では信用するな |
最後の行は特に率直だ。自社モデルの一部機能について「信用するな」と書いている。 そのうえで「これらの文書には Chandra が正確な選択肢」と誘導している。
当サイトの基準で言えば、これは良いREADMEだ。できることだけ並べて失敗率を書かない配布物より、導入判断がはるかにしやすい。
CHANGELOGが実測と一致した
本記事が観測したエラー挙動は、偶然ではなく意図して作られたものだった。CHANGELOG.md の 0.3.1 の項にこうある。
A model download that fails (no network, no access) or a model folder with missing files raises
indra_ocr.ModelErrorwith one clear message; the CLI and the viewer print it as one line and exit with 1.
私が測ったのは、
・モデル取得失敗 → 1行のメッセージ、終了コード 1
・モデルフォルダにファイルが足りない → det.onnx, rec.onnx, meta.json を名指し、終了コード 1
CHANGELOG の記述と完全に一致する。 「ドキュメントにそう書いてある」と「実際にそう動く」が揃っている例で、記述の信頼度を上げる材料になる。0.3.1 はこの挙動を入れたバージョンそのものなので、それ以前の版では別の壊れ方をする可能性がある点は付記しておく。
パッケージの中身
| 項目 | 実測値 |
|---|---|
indra_ocr の Python ファイル |
16 |
| 同 行数 | 3,807 |
| リポジトリの追跡ファイル | 33 |
| 直近コミット | 2026-10-13 |
モジュール名から処理の流れが読める。det_post(検出の後処理)→ rec_preproc(認識の前処理)→ layout_post(レイアウト)→ order_post(読み順)という並びで、line_mask textlayer vocab parallel math が補助に付く。検出・認識・レイアウト・読み順が別モジュールに分かれているので、ONNX の2モデル(det.onnx と rec.onnx)がどこで使われるかも追いやすい。
依存として挙げられているのは ONNX Runtime・pypdfium2・OpenCV・Hugging Face Hub の4つ。PDF のレンダリングを pypdfium2、画像処理を OpenCV に任せ、推論だけを ONNX Runtime で回す構成だ。
再現手順が公開されている
ベンチマークの再現方法も README に載っている。
# 開発元が示している再現手順(本記事では未実行)
git clone https://github.com/datalab-to/indra.git && cd indra
pip install indra-ocr 'omni-parse-bench[benchmark]'
python bench/opb_indra.py --out runs/opb_auto --mode auto --procs 8
各ページを単一スレッドのワーカープロセスで処理し、summary.json(ベンチ自身のサマリに加えて1ページあたりの中央値と p90 ミリ秒)と pages.jsonl(ページごとの時間・ソース・通過テスト)を書き出す、と説明されている。p90 まで出す設計なので、平均だけでごまかしていない。
--models で手元のモデルフォルダを指せるとも書かれており、遮断環境でも重みさえ配置すればベンチを再現できる。本記事がそこまで到達できなかったのは重みを取得できなかったためで、手順自体は塞がっていない。
出力に source が付いてくる
導入判断で地味に効くのが出力の設計だ。--format json にすると1ページ1オブジェクトで返り、そのページをどの経路で処理したかが source に入る。
source の値 |
意味 |
|---|---|
text |
PDF のテキスト層を読んだ |
ocr |
OCR にかけた |
hybrid |
テキスト層+画像内テキストの OCR |
error |
失敗した |
日本語の扱いが入力で割れることは前述したが、この source を見れば「どのページがOCR経路に落ちたか」をページ単位で判別できる。かなを含むスキャンページが混ざった PDF を流したとき、どこが信用できないかを機械的に切り分けられるということだ。note(そのページがその経路を通った理由)も併せて返る。
--mode で経路を強制することもできる。既定の auto はテキスト層が検査に通ればそれを使い、通らない箇所を OCR する。ocr はテキスト層を一切読まない、text は検査に落ちてもテキスト層を使う。日本語文書なら --mode text に寄せるのが安全側の選択になる。
ページには rotation と skew(適用した回転とまっすぐに直した傾き)、timings(工程ごとのミリ秒と total_ms)も入る。向き補正モデルがアラビア語・ヘブライ語で半数誤るという自己申告があるので、rotation の値を監視しておけば異常な回転を検出できる。
レイアウトブロックのラベルは Text Section-Header Page-Header Page-Footer List-Group Table Caption Footnote Table-Of-Contents Form の10種類。markdown 出力ではページヘッダとフッタが既定で落とされ、--keep-furniture で残せる。RAG の前処理としては、ヘッダ・フッタが既定で落ちるほうが都合がよいことが多い。
--cores で使うコア数を絞れる(既定は使える全コア)。--timings を付けると工程ごとの所要時間が標準エラーに出るので、標準出力の markdown を汚さずに計測できる。前述のとおり失敗時も標準出力は空のままなので、indra-ocr paper.pdf > out.md が常に安全に書ける設計で一貫している。
数式は既定でプレーンテキストに落ち、--math を付けると LaTeX になる(ただし数式ページは遅くなると明記)。既定を速い側に倒し、必要な人だけ重い経路を選ぶという設計方針がここにも出ている。
READMEが主張していて、本記事が確かめていない数値
重みを取得できていない以上、性能は一切検証できていない。どれが主張でどれが実測かを混ぜないために、主張側を表にして分離しておく。
| README の主張 | 本記事の扱い |
|---|---|
| CPU で毎秒 49ページ | 未検証 |
| 1ページあたり 約230ms(4 x86 vCPU) | 未検証 |
| Tesseract・PaddleOCR 比で 11〜17倍のスループット | 未検証 |
| OmniParseBench text 41.3(PaddleOCR の PP-OCR 35.8、Tesseract 19.3) | 未検証 |
| ヘッドラインスコア 62.1(PP-StructureV3 の 58.4 を上回る) | 未検証 |
認識器 rec.onnx が約 1Mパラメータ |
未検証 |
| モデル合計 約 18MB | 未検証(ダウンロードできていない) |
いずれも README に数値の出どころ(同一マシン・同一ページでの比較、ベンチマーク名)が添えられており、書き方としては丁寧だ。リポジトリには bench/opb_indra.py というベンチスクリプトも入っているので、重みさえ取得できれば読者が自分で再現できる構成にはなっている。
当サイトの方針として、取得できなかった値を「たぶん正しい」と書くことはしない。この記事が保証できるのはライセンスの構造と、導入・起動時の挙動までだ。
同じ会社で同じ構造を、当サイトは既に一度踏んでいる
この「コードはApache-2.0、重みは別ライセンス」という形は、Datalab の別製品でも確認している。
・liftとは|PDF 構造化抽出の9BモデルをGitHubのApache-2.0表示だけで判断してはいけない — 同じ datalab-to の構造化抽出モデル。GitHub 上の Apache-2.0 表示だけでは判断できない、という同型の結論になっている
同じ会社の製品が2つとも同じ構造なら、これは偶発ではなく方針だ。Datalab のリポジトリを見るときは、最初に「重みのライセンスはどこに書かれているか」を探すのが正しい手順になる。今回の Indra OCR では README の # License 節と、価格ページへ向いたバッジがその場所だった。
OCR まわりの他の選択肢も、当サイトで実測したものを挙げておく。
・Unlimited-OCR解説|AI OCRで数十ページを一括処理するBaiduのOSSとKVキャッシュ固定の仕組み — 長い文書を一括で扱う方向。Indra が1ページの速度を取りにいくのと設計の狙いが違う
・docjevとは|PDFをJevで分類・分割するOSSをOCRから実測し、40文書ベンチの精度も読む — OCR の後段(分類・分割)に当たる道具
Indra OCR の位置づけは「前段の、速い方」だ。文書をまず markdown やテキストに落とす工程を CPU だけで速く回し、その後の理解や分割は別の道具に渡す。ONNX Runtime だけで動き PyTorch を要求しない構成も、その位置づけと整合している。
CPU前提という選択が効く場面
GPU を前提にしないことには実務上の意味がある。
| 条件 | CPU前提であることの効き方 |
|---|---|
| バッチ処理基盤 | GPU ノードを別に確保しなくてよい。既存のワーカーに相乗りできる |
| オンプレ・閉域 | GPU ドライバとランタイムの持ち込みが不要。ONNX Runtime だけで済む |
| コスト | ページ単価の計算に GPU 時間が入らない |
| 常駐サービス | 18MB のモデルなら複数プロセスに持たせても現実的 |
ただしこれはきれいな印刷物を速く捌くという前提の上に乗っている。Limitations が列挙したとおり、手書き・劣化スキャン・複雑な表・かなを含むスキャンは対象外だ。「安いから全部これで」とはならない。
README 自身が「速度の Indra、精度の Chandra」と書き分けているので、入力の質で経路を分ける設計を前提に組むのが素直な使い方になる。デジタルPDFはテキスト層を使って Indra、きれいな英文スキャンも Indra、それ以外は別経路、という切り分けだ。
導入を検討するときの順番
実測から言えることをまとめると、確認の順番はこうなる。
・最初にライセンスを分けて読む。コードの Apache-2.0 だけ見て判断しない。自社の用途が「提供元APIとの競合」に当たらないかを先に決める
・資金/売上の閾値($20M)を自社に当てる。超えていれば無償条件から外れる
・ネットワークを確認する。初回実行で Hugging Face へ出る。出られない環境なら det.onnx rec.onnx meta.json を先に配置する
・精度要件を切り分ける。手書き・数式・複雑な表・劣化スキャンは README 自身が Chandra 側だと言っている
・性能は自分で測る。49ページ/秒は提供元の数値であり、本記事は再現していない
未検証で残したもの
・OCR の精度と速度のすべて。モデル重みを取得できず、1ページも読ませていない
・indra-ocr-viewer(ローカルWebビューア)。モデルが無いため起動していない
・デジタルPDFのテキスト層読み取り。PDF自身のテキストを使い欠落分だけOCRする、という挙動は確認していない
・重み側ライセンスの全文。huggingface.co が遮断されているため、README の要約を引用するに留めている。条文そのものは各自で読む必要がある
・star 数。api.github.com と github.com のHTMLがこの環境から遮断されているため測っていない
・--mode text での日本語の実挙動。テキスト層経由なら日本語が通るという記述は確認したが、実際の PDF を流していない。1,125ページ・75語族で98%保持という主張も未検証
・source と note の実出力。JSON 形式の設計は README から読んだだけで、実際のフィールド値は見ていない
測った手順
# ① コード側のライセンスと規模を確認する
git clone --depth 1 https://github.com/datalab-to/indra
head -4 indra/LICENSE; git -C indra ls-files | wc -l   # → Apache / 33
# ② PyPI のメタデータから版と配布条件を読む
curl -s https://pypi.org/pypi/indra-ocr/json \
  | python3 -c "import json,sys; i=json.load(sys.stdin); print(i['info']['version'], i['info']['requires_python'], len(i['releases']))"
# ③ 導入して、どこで止まるかを終了コードごと記録する
python3 -m venv .venv && .venv/bin/pip install indra-ocr
.venv/bin/indra-ocr sample.png > out.txt 2> err.txt; echo "exit=$?"
③は失敗を前提にした測り方だ。成功したかどうかではなく、失敗の形(終了コード・どちらのストリームに出るか・回避策が示されるか)を見ている。オフライン環境へ入れる判断には、むしろこちらが要る。
参照ソース
・datalab-to/indra(GitHub) — 本記事が 2026-10-14 に clone した対象。コード側の LICENSE を読んだ場所
・indra-ocr(PyPI) — 0.3.1 を導入した配布元。project_urls が重みの所在を示している
・datalab-to/indra-ocr(Hugging Face) — モデル重みと、改変 OpenRAIL-M の条文がある場所(本記事の環境からは到達できていない)