UniFace は、顔検出・顔認識・ランドマーク・フェイスメッシュ・パーシング・視線推定・属性推定・アンチスプーフィングまでを、ONNX Runtime 1本の上で統一APIにまとめたPythonライブラリだ。star 2.0k、fork 269、MIT、バージョンは 4.0.0。この手のライブラリは「入れて動くか」より「商用に使えるか」で詰まることのほうが多い。実際に pip install して動かし、そこを一次情報で確かめた。
- ・顔まわりのタスクを1つのAPIに集約。`MODEL_REGISTRY` は**62エントリ**、全てにsha256が付く
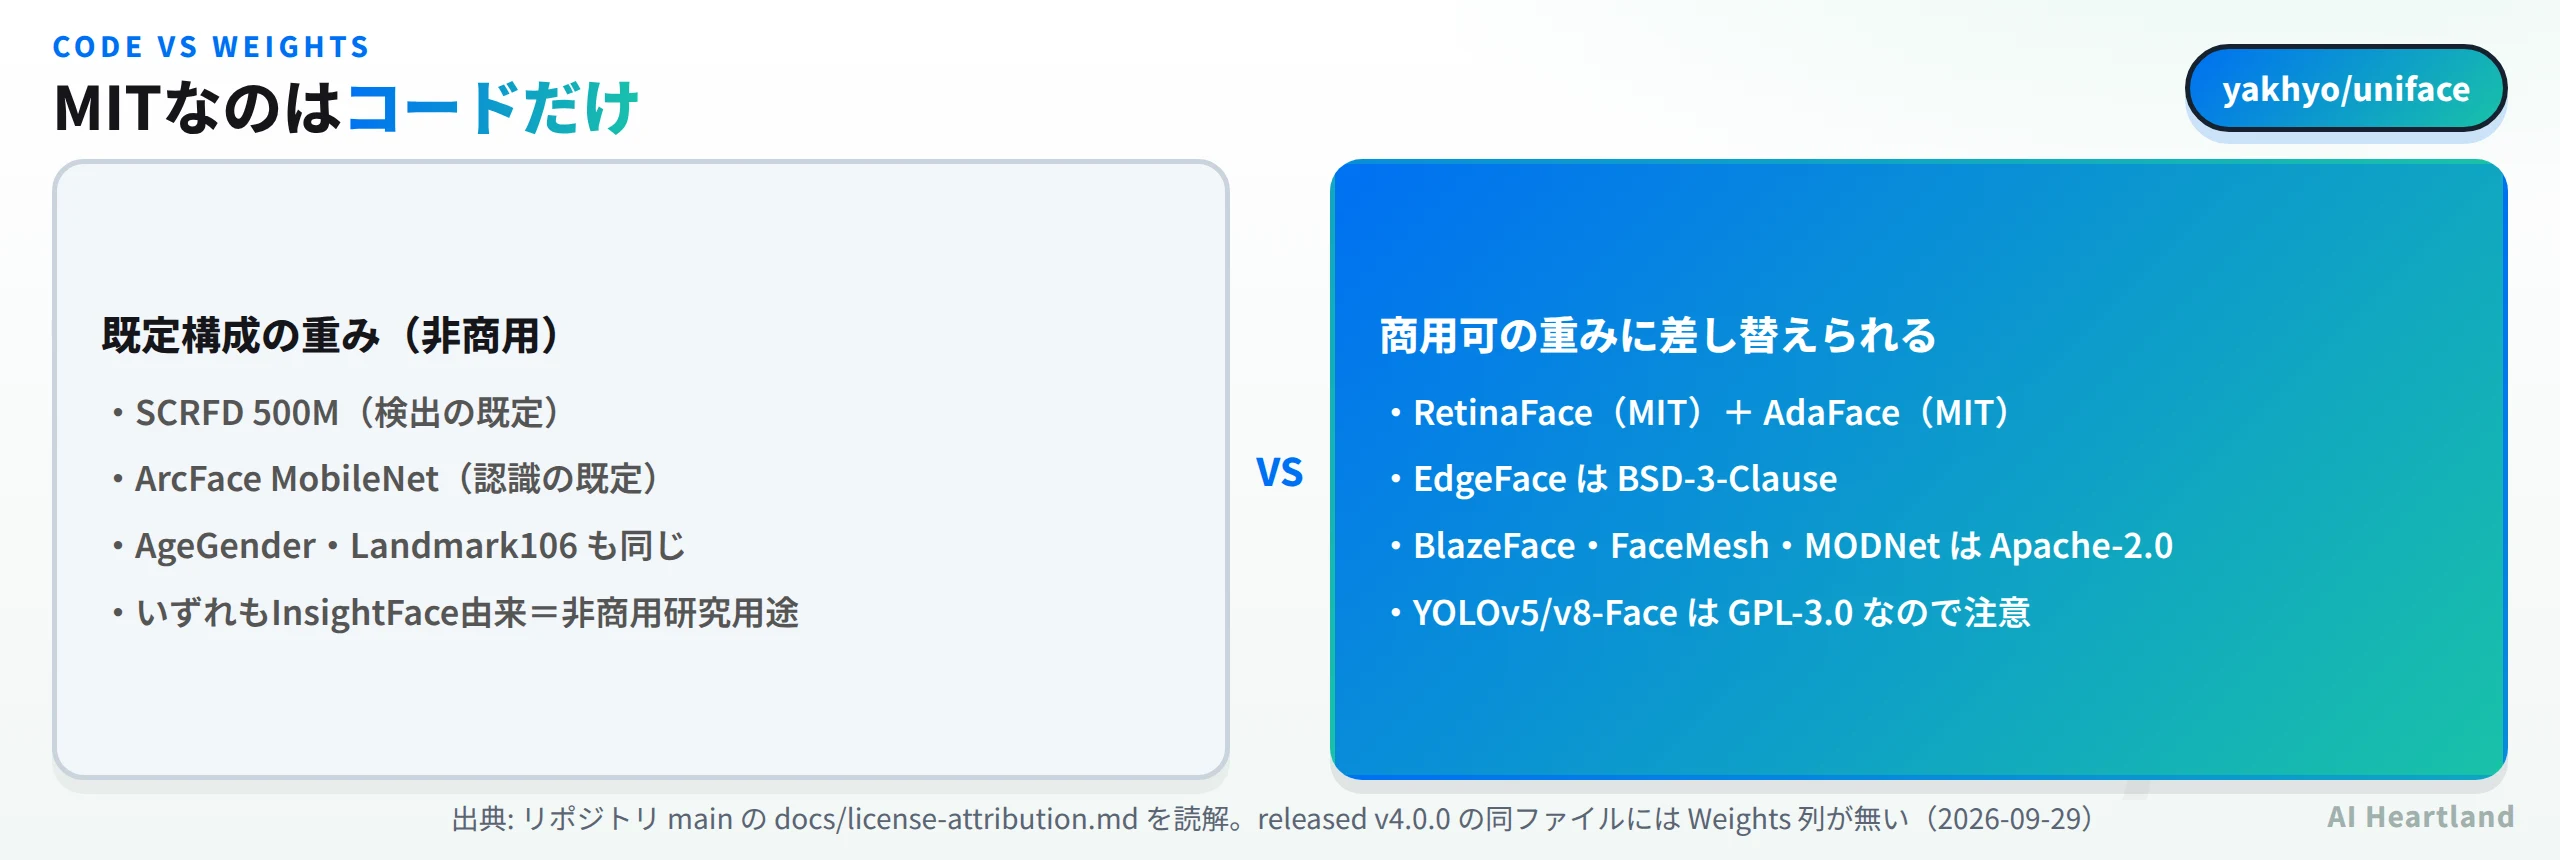
- ・**コードはMIT。だが既定の重みは非商用**(SCRFD・ArcFace・AgeGender・Landmark106 はInsightFace由来)
- ・その注意書きは `main` にはあるが、**PyPIの 4.0.0 時点のドキュメントには無い**
- ・CPU実測:検出のみ25ms、512次元の埋め込みまで126ms、年齢・性別まで210ms(1800×1200・7人)
- ・商用可の構成(RetinaFace+AdaFace)に替えると262msだが、**照合精度はむしろ上がった**
- ・`pip install uniface[cpu]` 後の site-packages は583MB。ただし uniface 本体は2MB
UniFaceとは:62モデルを1つのレジストリに載せる
READMEの見出しは機能名ではなく動詞で並んでいる。「顔を見つけて測る」「顔を切り出す」「頭がどちらを向いているか読む」「顔を読む」「本物の顔と再生映像を見分ける」「顔を照合する、または隠す」。実装としては、各タスクごとに複数のバックボーンが選べる形になっている。
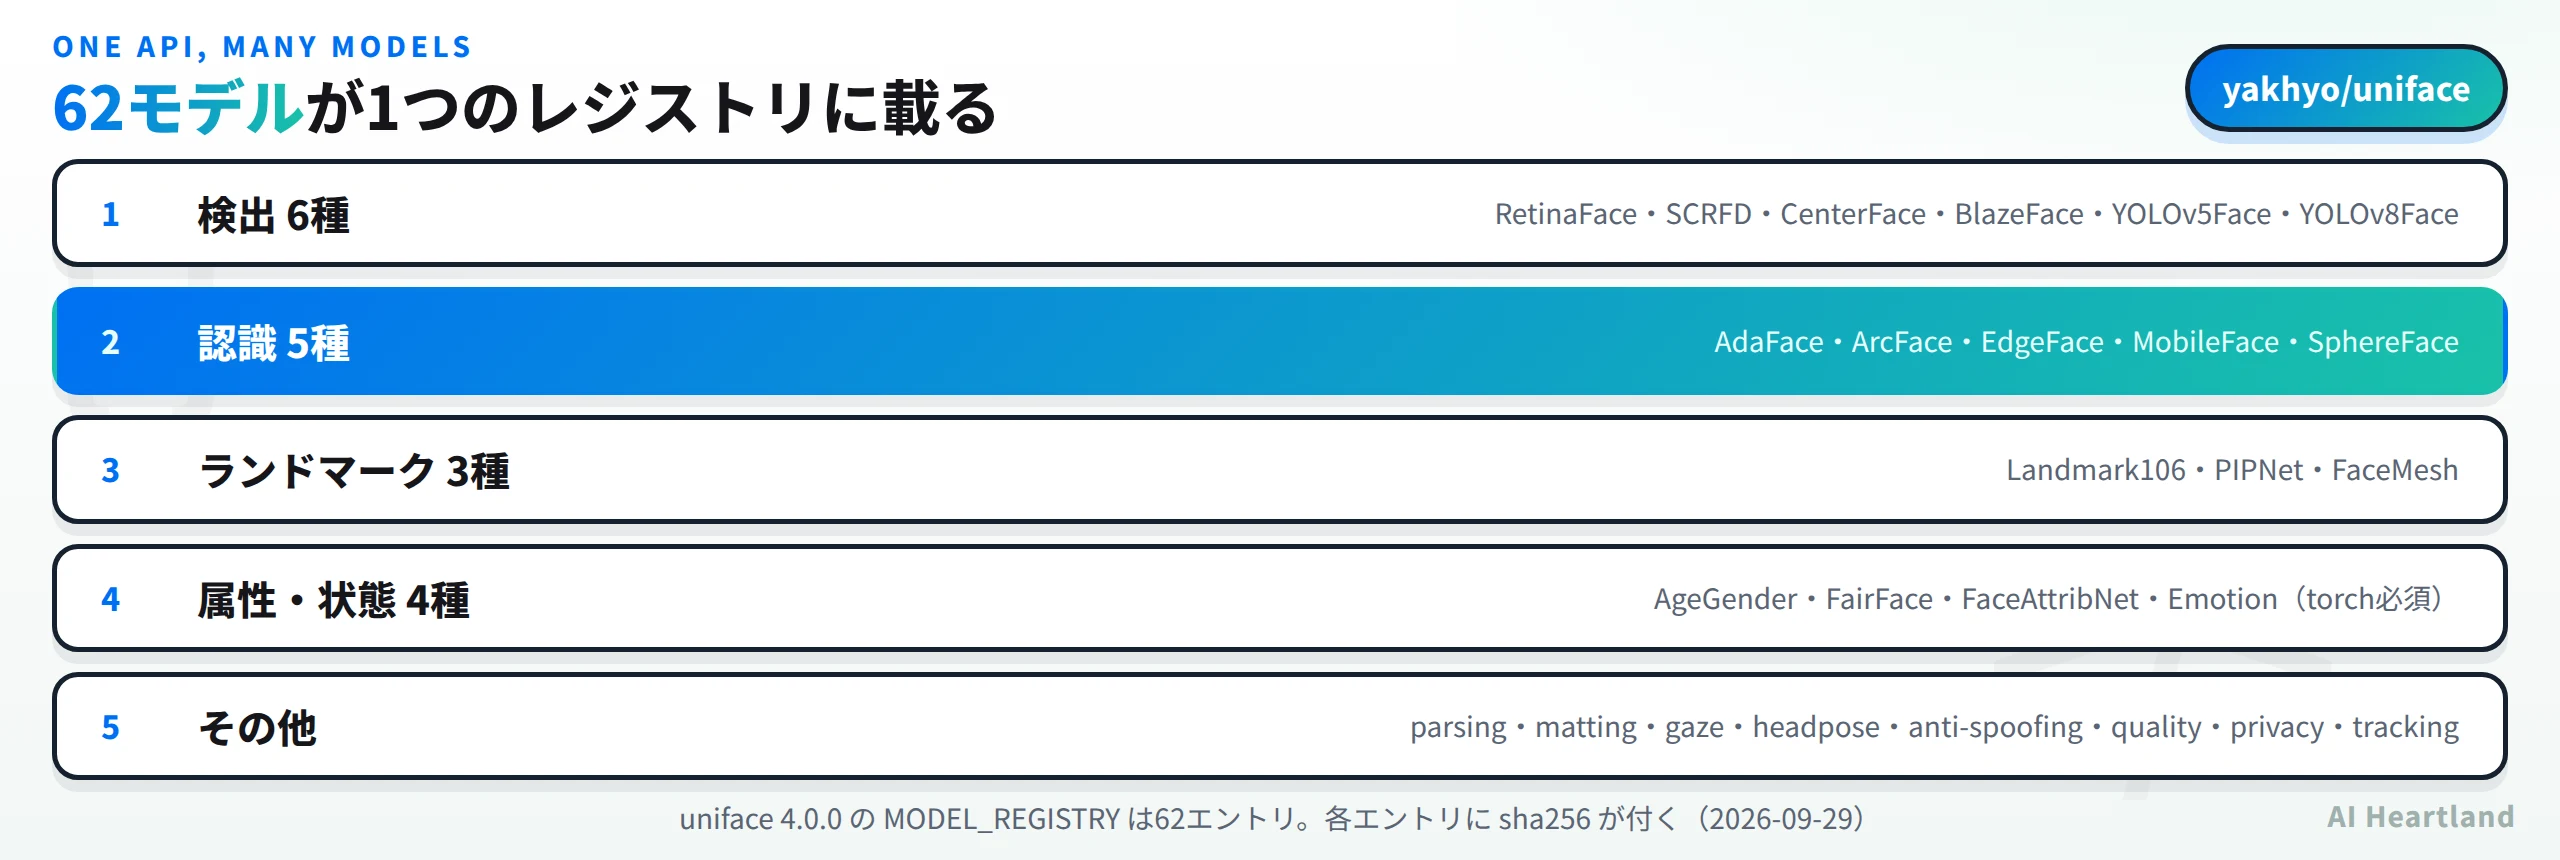
uniface.constants.MODEL_REGISTRY を開くと、エントリは62件。1件ずつがダウンロードURLと sha256 を持つ構造体になっている。URLの既定は GitHub Releases の weights タグで、HF_MIRROR_URL としてHugging Faceのミラー(コミットハッシュでピン留め済み)も定数に入っている。取得後にハッシュを検証する verify_model_weights も公開APIに出ている。重みをネットから落としてくる設計でここまで揃っているライブラリは多くない。
入口は FaceAnalyzer ひとつだ。引数なしで作ると、検出はSCRFD 500M、認識はArcFace MobileNetという「一番小さくて速い組み合わせ」になる。
pip install "uniface[cpu]"   # 4.0.0 が入る。site-packages は583MB
python - <<'PY'
import cv2
from uniface import FaceAnalyzer
a = FaceAnalyzer()                       # SCRFD 500M + ArcFace MNET
faces = a.analyze(cv2.imread("group.jpg"))
print(len(faces), faces[0].bbox.shape, faces[0].embedding.shape)
PY
# 7 (4,) (512,)
初回だけ重みを取りに行き、以降は ~/.uniface/models/ から読む。結果は Face というデータクラスのリストで返り、フィールドは bbox confidence landmarks embedding gender age age_group race emotion emotion_confidence left_eye_open right_eye_open eyeglasses mask sunglasses quality track_id の17個。ここが素直で、検出だけ使いたいときも顔照合まで使いたいときも、返ってくる型が変わらない。
ただし埋まるフィールドは構成次第だ。引数なしの FaceAnalyzer() で埋まったのは bbox(4要素)、confidence、landmarks(5点×2)、embedding(512次元)まで。age も emotion も None のままだった。属性を取りたければ predictors=[AgeGender()] のように明示的に足す設計になっている。常に全部走らせない、という判断で、レイテンシの観点では正しい。
ここで1つ落とし穴に当たった。predictors=[AgeGender(), Emotion()] と書いたら、Emotion requires optional dependency 'torch'. Install with: pip install torch で止まったのだ。ソースを見ると、uniface/attribute/__init__.py が Emotion の import を try/except ImportError で囲み、失敗したときは同名のスタブクラスに差し替える構造になっている。スタブはインスタンス化された瞬間に上記の ImportError を投げる。ONNXで統一されている62モデルの中で、感情推定だけがPyTorchを必要とするわけだ。しかも pyproject.toml の optional-dependencies には cpu gpu dev docs しか無く、torch用の extra は定義されていない。感情推定を使う予定があるなら、別途 pip install torch を自分の依存に足す前提になる。
numpy配列(BGR)"] --> B["detector
SCRFD / RetinaFace ほか6種"] B --> C["bbox + 5点ランドマーク
で顔を切り出して整列"] C --> D["recognizer
ArcFace / AdaFace ほか5種"] D --> E["512次元の embedding"] C --> F["predictors
AgeGender / FairFace など"] E --> G["Face データクラス
17フィールドを埋めて返す"] F --> G H["MODEL_REGISTRY 62件
GitHub Releases または HFミラー"] --> I["sha256 を検証して
~/.uniface/models へ保存"] I --> B I --> D
実測:検出25ms、埋め込みまで126ms
速度を測った。環境はIntel Xeon 2.10GHz 4コア、onnxruntime 1.30.0 のCPU実行。画像はリポジトリ同梱の7人が写った集合写真(1800×1200)で、7回ずつ回した中央値を取っている。
import time, cv2
from uniface import FaceAnalyzer, AgeGender
img = cv2.imread("detect_group.jpg")            # 1800x1200, 7人

b = FaceAnalyzer(recognizer=None)               # 検出のみ   → 中央値 0.025s
a = FaceAnalyzer()                              # 既定       → 中央値 0.126s
c = FaceAnalyzer(predictors=[AgeGender()])      # +年齢性別  → 中央値 0.210s
for m in (b, a, c):
    ts = []
    for _ in range(7):
        t = time.time(); faces = m.analyze(img); ts.append(time.time() - t)
    print(len(faces), round(sorted(ts)[3], 3))
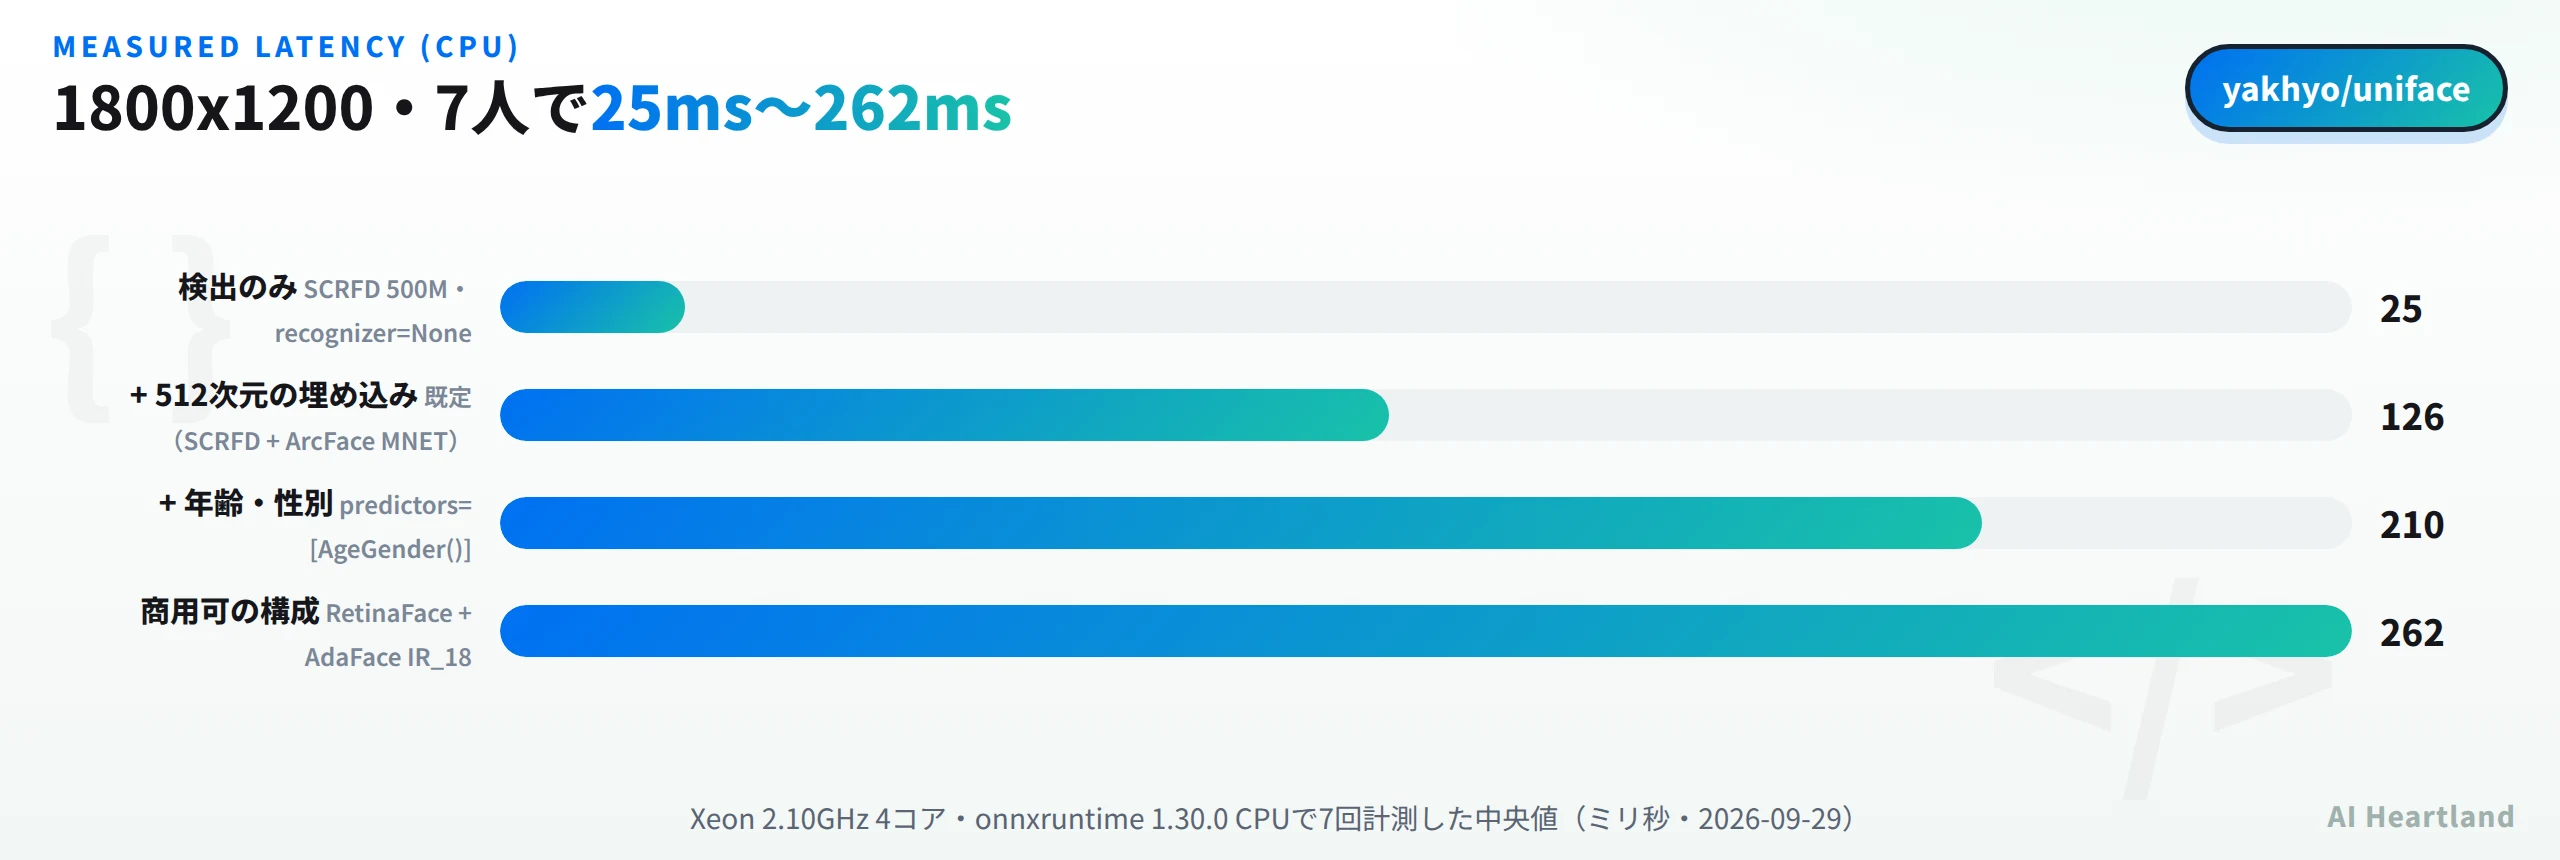
検出だけなら25ミリ秒。ここに512次元の埋め込みが乗ると126ミリ秒で、5倍になる。顔7つぶんの認識モデル推論が乗るので当然ではあるが、「検出だけでいい」用途で既定構成を使うと5倍の無駄を払うことになる。recognizer=None を渡せば止まるので、忘れずに。年齢・性別まで足すと210ミリ秒で、検出のみの8.4倍だった。
FaceAnalyzer() の初期化自体は1.9秒ほどかかったが、これは初回のモデル読み込みを含む値だ。2回目以降の解析では発生しない。
ついでに精度の当たりも見ておいた。属性推定の結果は7人ぶんが gender 0/1 と age の整数で返り、年齢は25〜61に散った。顔写真から年齢を当てる種類のモデルなので、当たり外れの評価は本記事の範囲外だが、7人すべてに値が入り、None の取りこぼしは無かった。
検出そのものの挙動も見ておくと、7人の confidence は 0.83・0.83・0.78・0.77・0.77・0.71・0.68 と並び、最小でも 0.68 だった。RetinaFace の既定しきい値は confidence_threshold=0.5 なので、この写真では全員が余裕をもって残る。逆に言えば、しきい値を 0.7 まで上げると1人落ちる位置にいる顔があるということで、歩留まりを詰めるときに触るべきパラメータがコンストラクタに素直に出ているのは扱いやすい。RetinaFace は他にも nms_threshold input_size pre_nms_topk post_nms_topk dynamic_size をキーワード引数で受ける。
もうひとつ、後の照合で使う人物写真3枚はいずれもきっちり1顔ずつ検出された。検出器が余計な顔を拾っていないことを確認してから類似度を測る、という順番を踏めるので、照合の数値がどの顔から出たのかが曖昧にならない。小さいことだが、実験の段取りとしては効く。
583MBの正体と、モデルの実サイズ
READMEは冒頭で「lightweight, production-ready」と名乗る。この「軽い」がどこを指しているのかを測っておきたい。空の venv に pip install "uniface[cpu]" を入れた直後の site-packages は583MBだった。内訳を大きい順に並べるとこうなる。
・opencv_python.libs 116MB / cv2 72MB — 画像の読み書きと前処理
・scipy 113MB / scipy.libs 30MB — 顔の整列などで使う数値計算
・onnxruntime 67MB — 推論エンジン本体
・numpy 45MB / numpy.libs 28MB
・skimage(scikit-image)32MB
・uniface 本体は 2MB
つまり583MBのうち、UniFace自身のコードは0.3%しかない。pyproject.toml のコア依存は numpy opencv-python scikit-image scipy requests tqdm の6つで、ONNX Runtime は [cpu] / [gpu] の extra 側にある。「軽い」はモデルとコードの話であって、Python環境の話ではない。コンテナイメージを絞りたいなら、opencv-python を opencv-python-headless に寄せられるか、scikit-image と scipy がどの経路で必要なのかを自分で確かめる価値がある。
モデル側は確かに軽い。既定構成で実際に落ちてきたファイルはこうだった。
・scrfd_500m.onnx 2.4MB(検出の既定)
・arcface_mnet.onnx 13.0MB(認識の既定)
・age_gender.onnx 1.26MB(AgeGender を足したとき)
・retinaface_mnet_v2.onnx 11.9MB(RetinaFace() の既定)
・adaface_ir_18.onnx 91.7MB(AdaFace() の既定)
保存先は ~/.uniface/models/。get_cache_dir() / set_cache_dir() が公開APIにあるので、コンテナのボリュームへ逃がすのも難しくない。ここまで使ってキャッシュ全体は29MB(AdaFace を入れる前の時点)で、初回の取得も11.9MBが1秒未満で終わった。オフラインで動かしたいなら、この5ファイルを事前に置いておけば足りる計算になる。
MITなのはコードだけ:既定の重みは非商用
ここからが本題だ。リポジトリのライセンスは MIT(Copyright (c) 2024 Yakhyokhuja Valikhujaev)で、GitHubのサイドバー表示もMIT。ところが docs/license-attribution.md を開くと、冒頭にこう書いてある——MITが覆うのはUniFace自身のソースコードであって、初回利用時にダウンロードされる学習済み重みは第三者の成果物であり、上流の条件に従う。いくつかは商用利用を禁じている。
該当するのは、まさに既定構成だ。
| モデル | 由来 | コード | 重み |
|---|---|---|---|
| SCRFD(検出の既定) | InsightFace | MIT | 非商用 |
| ArcFace(認識の既定) | InsightFace | MIT | 非商用 |
| AgeGender(属性) | InsightFace(buffalo packs の genderage) |
MIT | 非商用 |
| Landmark106 | InsightFace(2d106det) |
MIT | 非商用 |
| RetinaFace | yakhyo/retinaface-pytorch | MIT | ソースに従う |
| AdaFace | mk-minchul/AdaFace 由来 | MIT | MIT |
| EdgeFace | Idiap Research Institute | BSD-3-Clause | BSD-3-Clause |
| BlazeFace・Face Mesh | Google MediaPipe 由来 | Apache-2.0 | Apache-2.0 |
| YOLOv5-Face・YOLOv8-Face | yakhyo/yolov*-face-onnx-inference | GPL-3.0 | ソースに従う |
InsightFace側の原文は明快で、「コードはMITで学術・商用とも制限なし。ただしアノテーション付き学習データと、そのデータで学習したモデルは非商用の研究目的に限る」。つまり pip install uniface[cpu] して FaceAnalyzer() と書いた瞬間に落ちてくる2つの重みは、そのままでは製品に載せられない。
もうひとつ見落としやすいのが YOLOv5-Face と YOLOv8-Face の GPL-3.0 だ。非商用ではないが、コピーレフトなので自社製品に組み込むときの扱いが変わる。検出器を差し替えるときは、速度だけでなくこの列も見る必要がある。
そして注意書きそのものが新しい。 リポジトリの CHANGELOG.md の「Unreleased」節に、こうある——モデルのライセンス表がMITで重みまで覆っているかのように読める状態を直し、コードと重みを別の列に分けた、と。実際、PyPIに出ている v4.0.0 のタグの同じファイルを取得して確認したところ、列は「License」1つだけで、SCRFDもArcFaceも「MIT」と書かれていた。non-commercial という語は1回も出てこない。つまり、4.0.0 を入れてドキュメントを読んだ人は、重みまでMITだと受け取る作りになっていた。
「リポジトリのライセンス表示と、同梱物の実際の条件がずれる」のはUniFaceに限った話ではない。当サイトでもMCP Appsとは|MCPサーバーがUIを配る拡張仕様の対応ホストと、ライセンス4表示のズレを実測で、同じリポジトリの中でライセンス表記が4通りに割れている例を扱った。バッジ1つで判断せず、同梱物ごとに条件を確かめるという手順は、AIモデルを配るOSSでは特に外せない。
検証環境:Linux 6.18.44/Python 3.11/Intel Xeon 2.10GHz 4コア/2026-09-29。python3 -m venv した空の環境に pip install "uniface[cpu]"(4.0.0・onnxruntime 1.30.0)を入れ、リポジトリ同梱の assets/source/ の画像で FaceAnalyzer を実行した。レイテンシは同じ画像で7回計測した中央値。照合は compute_similarity(コサイン類似度)で、同一人物2枚と別人1枚の陽性・陰性対照を取っている。ライセンスの確認は git clone --depth 1 した main の docs/license-attribution.md と CHANGELOG.md、および raw.githubusercontent.com から取得した タグ v4.0.0 の同ファイルを突き合わせた。未検証:GPU実行(uniface[gpu])は試していない。またパーシング・マッティング・視線推定・アンチスプーフィング・トラッキング・FAISS連携は未実行で、属性推定の精度評価も行っていない。Emotion は PyTorch が必要なため動かしていない。star 2.0k・fork 269 はリポジトリページの表示値。ライセンスの記述は原文の読解であり、法的助言ではない。
UniFaceを商用可の構成に差し替えて測り直す
では商用可の重みに替えるとどうなるか。検出を RetinaFace(MIT)、認識を AdaFace(重みもMIT)にして、同じ画像で測り直した。ついでに、同梱されている検証用の顔写真3枚——アルベルト・アインシュタインの1921年と1947年、そして別人の2024年の写真——で照合の当たりを見た。同一人物の26年差という、陽性対照として分かりやすい素材だ。
from uniface import FaceAnalyzer, RetinaFace, AdaFace, compute_similarity
a = FaceAnalyzer(detector=RetinaFace(), recognizer=AdaFace())   # どちらも重みMIT
e1 = a.analyze(cv2.imread("verify_einstein_1921.jpg"))[0].embedding
e2 = a.analyze(cv2.imread("verify_einstein_1947.jpg"))[0].embedding
e3 = a.analyze(cv2.imread("verify_now_2024.jpg"))[0].embedding
print(compute_similarity(e1, e2), compute_similarity(e1, e3))
# 0.5074  -0.0217      (既定の SCRFD + ArcFace では 0.4394 / -0.0856)
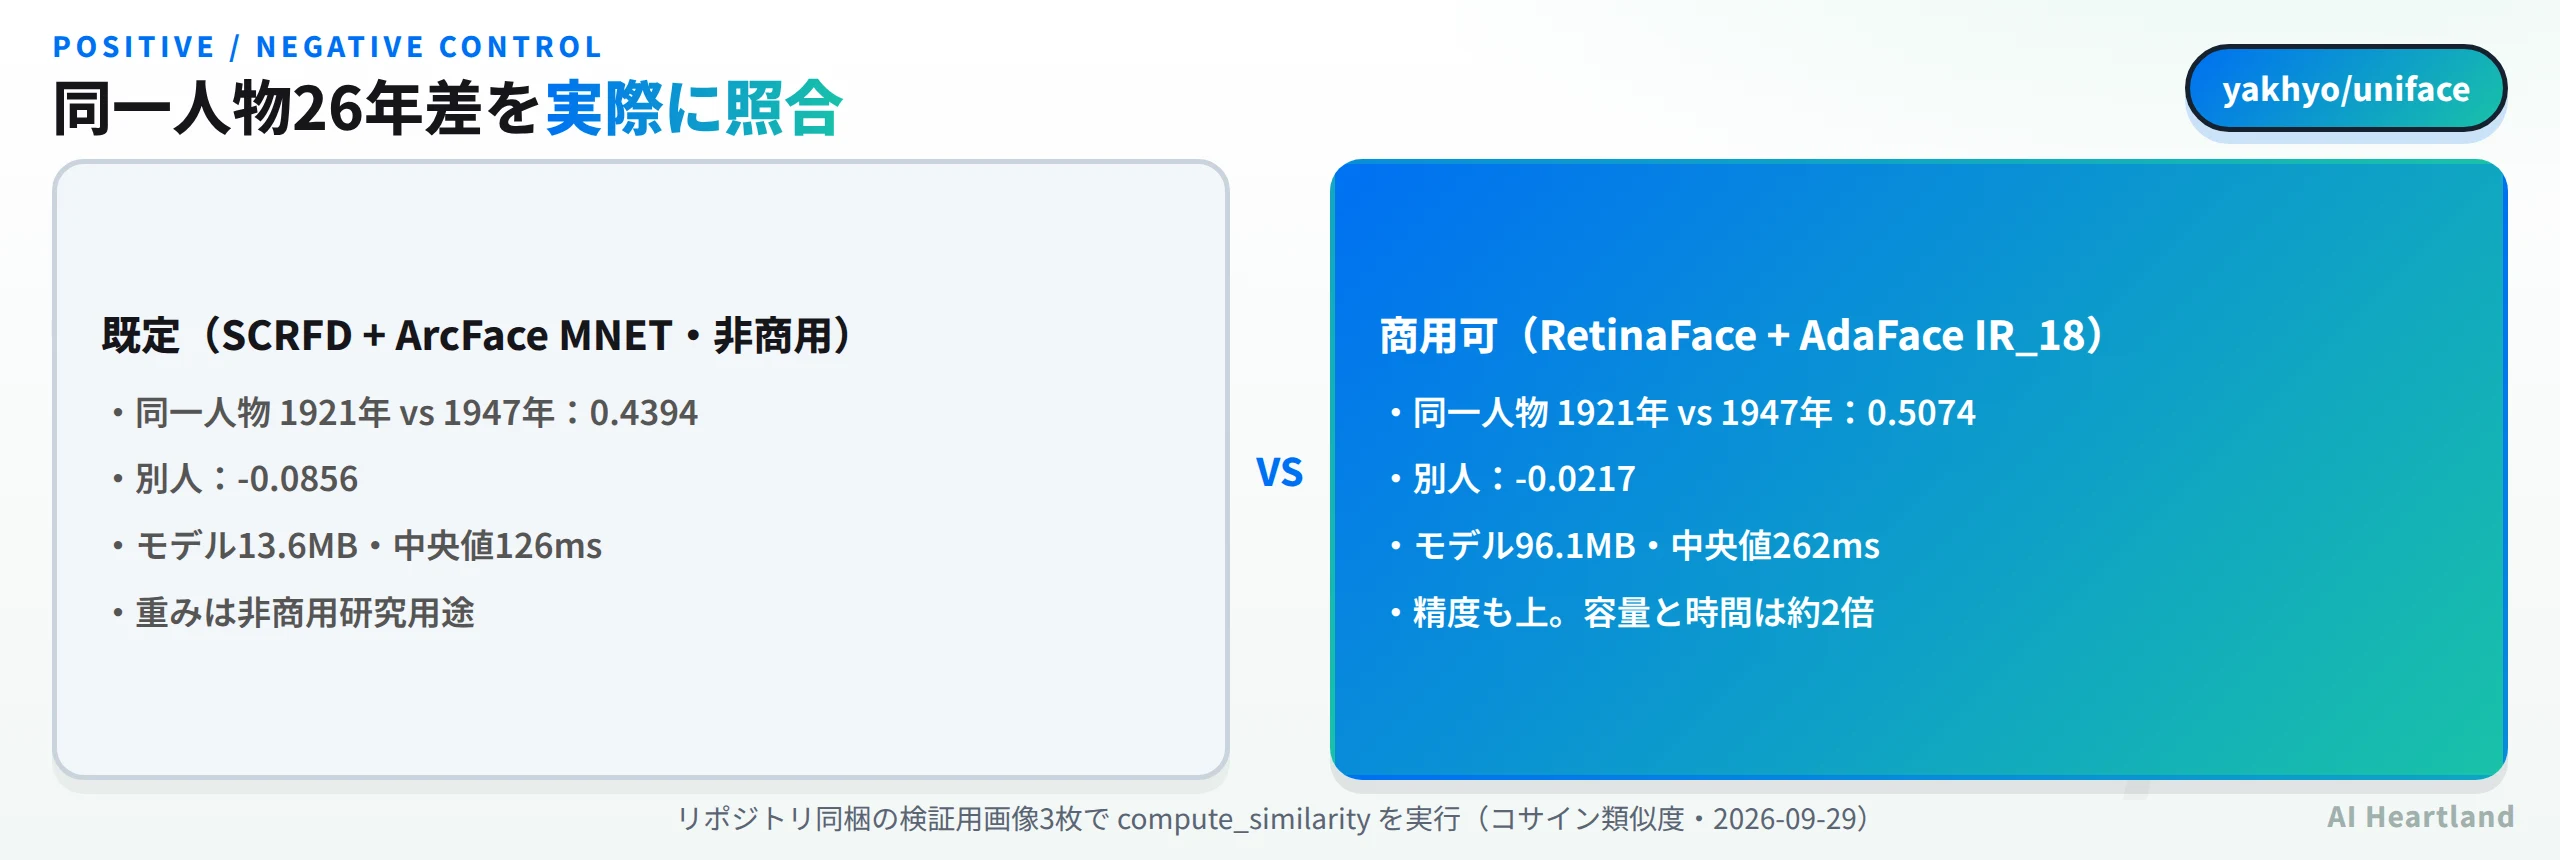
結論から言うと、商用可の構成のほうが照合は良かった。同一人物の類似度は 0.4394 → 0.5074 に上がり、別人との類似度は -0.0856 と -0.0217 でどちらもほぼゼロ。26年離れた写真でも、同一人物と別人の差ははっきり開いている。
代償は容量と時間だ。ArcFace MobileNet の重みが13.6MBなのに対し、AdaFace IR_18 は96.1MB。集合写真の解析は126ミリ秒から262ミリ秒へ、約2倍になった。エッジで回すなら効く差だが、サーバー側のバッチ処理なら払って構わない範囲だろう。少なくとも「商用可にするために精度を諦める」という構図にはなっていない。
ちなみに CHANGELOG.md の Unreleased 節には、さらに大きい AdaFace IR_50(WebFace4M・166MB)の追加も入っている。released の 4.0.0 で選べるのは IR_18 と IR_101 の2つだけなので、これは main を追う人向けの情報だ。
導入前に押さえる点
・既定構成は非商用:FaceAnalyzer() をそのまま使うと SCRFD+ArcFace。製品に載せるなら RetinaFace+AdaFace などMITの重みへ差し替える
・GPL-3.0の検出器がある:YOLOv5-Face・YOLOv8-Face。速度だけで選ばない
・学習データ由来の制約は別問題:ドキュメント自身が「WebFace260M・WIDER FACE・MS-Celeb-1M など、データセット側の条件が下流に及ぶかは判断していない。商用展開するなら自分でデューデリを」と書いている
・recognizer=None を忘れない:検出だけなら126ms → 25ms。5倍違う
・属性は明示的に足す:predictors=[AgeGender()] を渡さないと age も emotion も None のまま
・Emotion は torch が要る:uniface[cpu] には入らず、pyproject.toml に torch用の extra も無い。未インストールだとスタブに差し替わり、インスタンス化で ImportError
・導入は583MB:uniface 本体は2MB。残りは opencv-python・scipy・scikit-image・onnxruntime。コンテナを絞りたいなら効いてくる
・重みはハッシュ検証つき:62エントリすべてに sha256。GitHub Releases が既定で、Hugging Face のミラーも定数で持つ
・main と 4.0.0 の差:ライセンス表の修正も AdaFace IR_50 も未リリース。ドキュメントを読むときはどちらを見ているか意識する
総括。 UniFace は「顔まわりのタスクごとにバラバラのリポジトリをかき集める」という定番の苦行を、62モデルのレジストリと Face という1つのデータクラスに畳んでいる。sha256 検証、recognizer=None での段階的な無効化、predictors による属性の後付けと、設計の筋も通っている。CPUで検出25ミリ秒という数字も、用途によっては十分に実用域だ。
その上で、このライブラリを評価するときに最初に開くべきファイルは README ではなく docs/license-attribution.md だと思う。MITのバッジは重みまで覆っていない。しかもその注意書きは、PyPIに出ている 4.0.0 の時点ではまだ書かれていなかった。上流のInsightFaceが何年も前から同じことを書いているにもかかわらず、下流のライブラリでそれが見えるようになったのはつい最近だ、という構図でもある。作者が自分でそれを直し、データセット由来の制約まで「判断しない」と明記しているのはむしろ誠実な部類で、だからこそ読む側がその欄を見る習慣を持つ必要がある。
参照ソース
・yakhyo/uniface(公式リポジトリ) — README・docs/license-attribution.md・CHANGELOG.md・uniface/constants.py を 2026-09-29 に確認
・deepinsight/insightface — 「学習データとそれで学習したモデルは非商用研究目的に限る」の原文
・UniFace ドキュメント — 公式のAPIリファレンスとライセンス表