code-review-skills は、Claude Code と Codex に「根拠のある指摘だけをさせる」ためのAgent Skillだ。GitHubのAboutは “Evidence-based code review skills for Codex and Claude Code”。AIにコードレビューをさせると、体裁だけの指摘や裏付けのない推測が混ざりやすい——この問題に対して、指摘の強さと根拠の書き方を型で縛るという解き方をしている。star 33、fork 0、MIT、タグは v0.1.0-beta.1 が1本だけの若いリポジトリだが、中身はスキルをMarkdownから機械生成してテストまで回す構成になっていた。2026-09-28時点の main をクローンし、ビルドとテストを実際に走らせて確かめた。
- ・指摘に MUST / SHOULD / BETTER / NITS の4段階を必ず付け、すべてに具体的な契機と影響を要求する
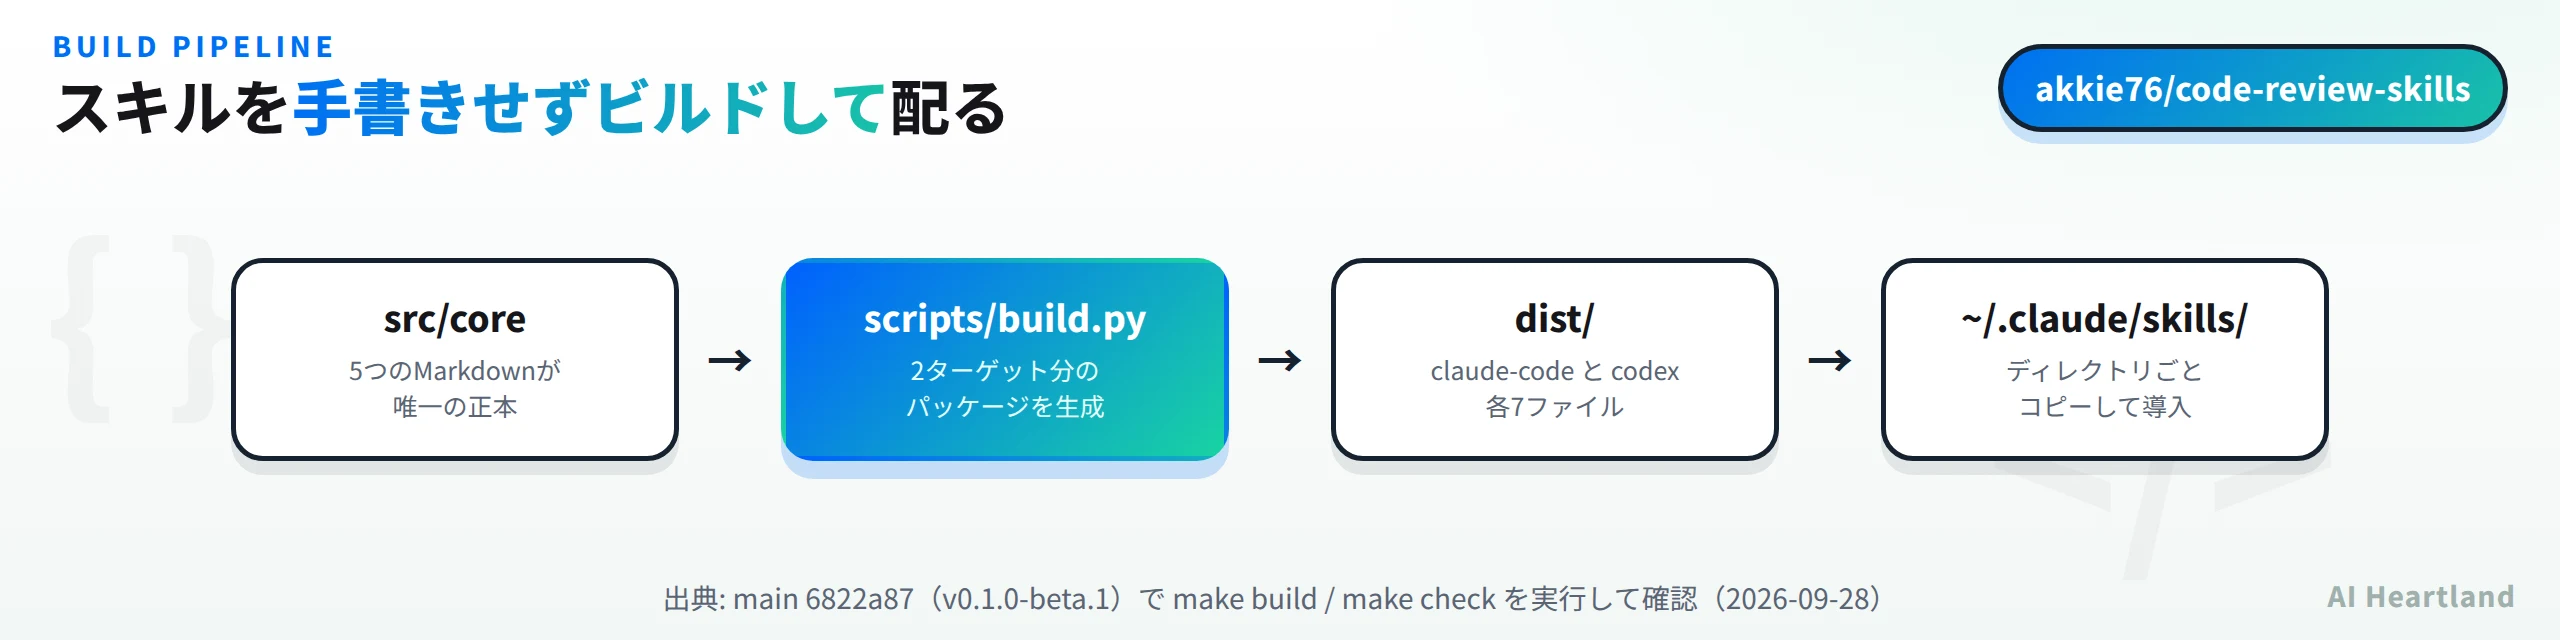
- ・スキル本体は手書きではなく `src/core` の5ファイルから `scripts/build.py` で生成される
- ・`dist/claude-code` と `dist/codex` は diff で差分0。中身は同一で置き場所だけが違う
- ・常駐するのは SKILL.md の約2,360トークン。references 6本を全部読むと約8,395トークン
- ・`make test` は18の評価ケースを検証して全通過。ただし**AIを呼ばずに期待値の形式を検査するもの**
- ・README・CHANGELOG・docs がすべて日本語版と対。評価ケース29プロンプト中13件が日本語
Claude Code の設定と運用の全体像はClaude Code|2026年版・インストールからCLAUDE.md・Hooks・本番運用までの実装手引きにまとめてある。本記事はその拡張であるAgent Skillsの、レビュー用途の実装を見ていく。
code-review-skillsとは:言わせないことを先に決めるスキル
このスキルの設計思想は、READMEの一文に出ている——「Codex と Claude Code が、スタイルだけのコメントと裏付けのない推測を避けながら、実行可能な欠陥を見つけられるようにする」。つまり何を言わせるかより先に、何を言わせないかを決めている。
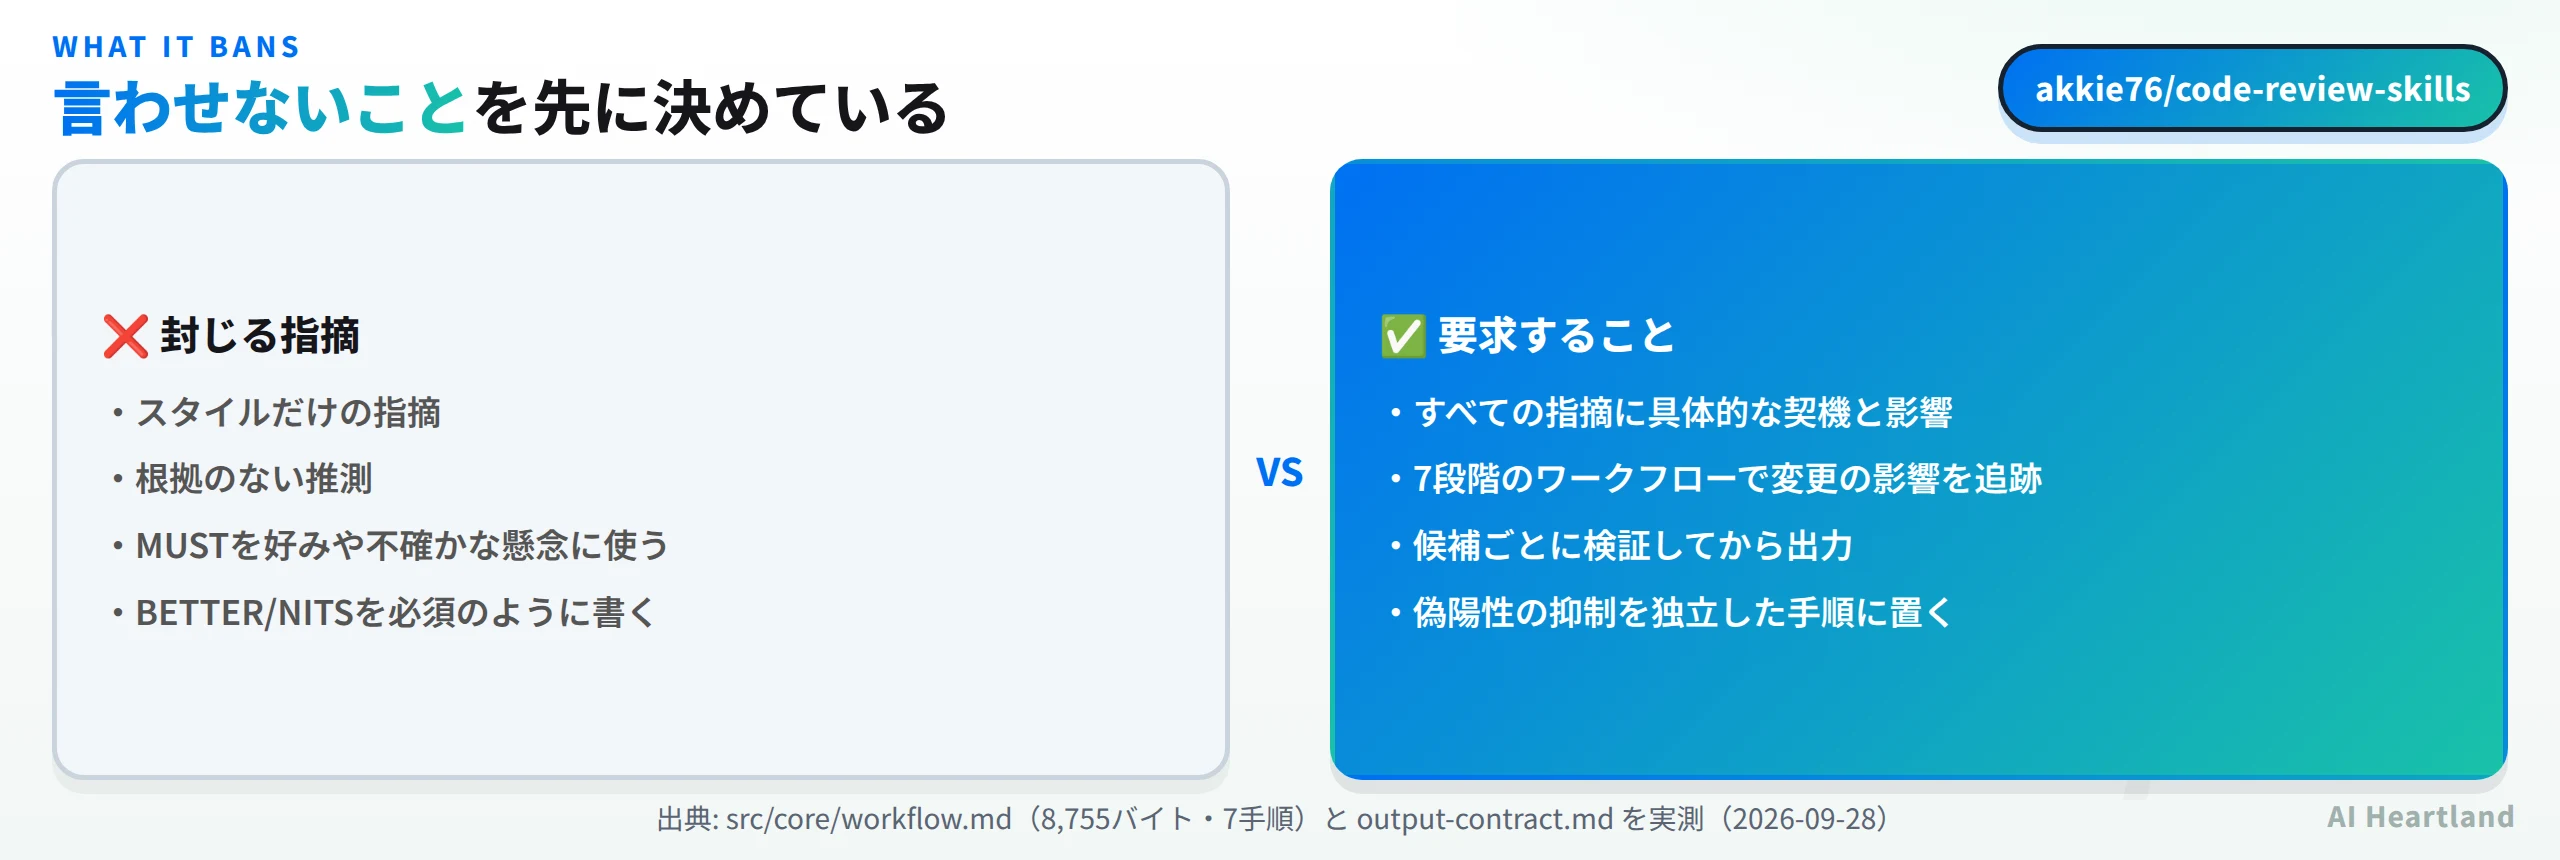
正本は src/core/ の5つのMarkdownで、役割がきれいに分かれている。
| ファイル | サイズ | 役割 |
|---|---|---|
workflow.md |
8,755B | レビューの7手順(契約の確立 → 変更マップ → 影響の追跡 → リスク順のレビュー → 候補の検証 → 偽陽性の抑制 → 出力) |
output-contract.md |
7,395B | 出力言語の選択、4段階のアクションレベル、観点の選択、コメントの書式 |
review-criteria.md |
6,374B | 8つの観点(挙動の正しさ/インターフェースとデータフロー/設計と保守性/理解しやすさ/セキュリティとプライバシー/性能と信頼性/検証とテスト/ドキュメントと運用) |
multi-agent-decomposition.md |
5,273B | サブエージェントへの分割判断、分割軸(関心別・観点別)、独立検証、統合 |
communication-guidelines.md |
1,190B | 伝え方 |
注目したいのは workflow.md の6番目の手順が「偽陽性の抑制」として独立している点だ。レビュー手順の中に「出す前に間違った指摘を落とす」という工程が明示的に置かれている。AIレビューで一番つらいのは誤検知への対応コストなので、そこを独立した手順にしているのは実務的だと思う。
もうひとつが multi-agent-decomposition.md で、大きな変更を関心別(By concern)または観点別(By viewpoint)でサブエージェントに割り、それぞれに独立検証をさせてから統合する、という手順が書かれている。Claude Code のサブエージェント機能を前提にした設計で、計画段階にも独立レビューを挟むvalcraftとは|計画にも独立レビューを通すAgent Skills 12本を公式CIごと実測すると発想が近い。
指摘の強さを4段階で縛る
このスキルの中核は output-contract.md のアクションレベルだ。すべての指摘は4つのうちどれかを頭に付ける。
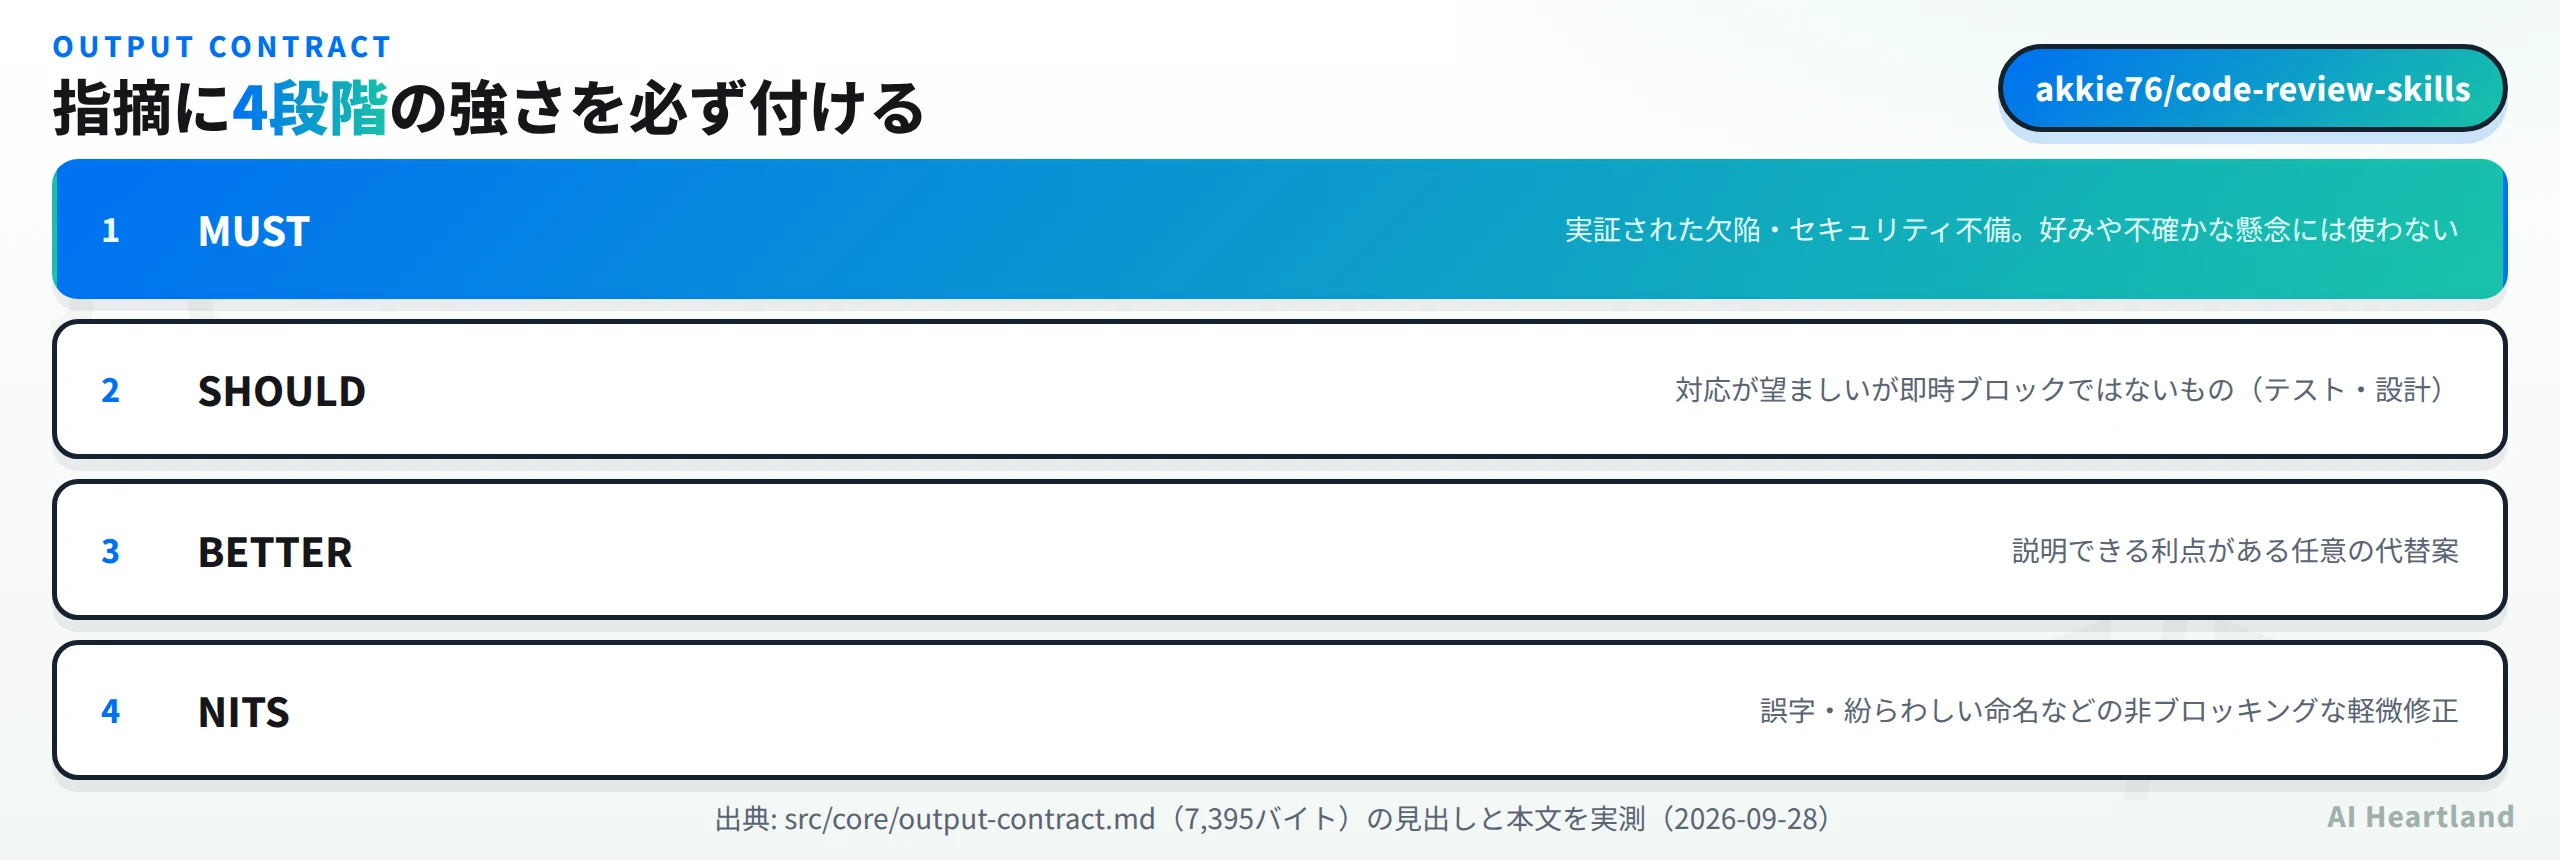
実際の書式は MUST(Functionality): BETTER(Simplicity): NITS(Naming): のように、強さと観点の組になる。output-contract.md の例を引くと、MUST(Functionality): Advance the page before requesting the next result set、NITS(Naming): Correct the misspelled configuration key といった具合だ。
この型が効くのは、レベルの誤用を明示的に禁じているからだ。同ファイルには「MUST を個人的な好み、不確かな懸念、任意の改善に使ってはならない」「BETTER と NITS が必須の要求のように読めてはならない。MUST はその必要な行動が不明瞭になるまで弱められてはならない」と書かれている。強すぎる指摘と弱すぎる表現の両方を封じにいっているのがポイントで、レビューを受ける側が優先順位を判断できる状態を守ろうとしている。
観点の側は評価ケースから実際に使われている組み合わせが拾える。18ケースが期待する接頭辞を数えると、MUST(Functionality) が9件と最も多く、以下 SHOULD(Test) 2件、MUST(Document)・SHOULD(Design)・BETTER(Simplicity)・NITS(Simplicity)・NITS(Naming)・NITS(Style) が各1件。重心が「壊れているかどうか」に置かれていることが、テストの期待値から読み取れる。スタイルや命名の指摘を禁じているわけではなく、NITS という弱いレベルに押し込めることで、読む側が「これは直さなくても進められる」と判断できるようにしている。指摘を減らすのではなく、指摘の重みを正しく伝えることを狙った設計だ。
行単位で指摘を返す専用CLIという別解もあり、そちらはCritとは|AIエージェントの出力へ行単位で指摘を返すレビューCLIを実測、同名OSSとの違いも整理で扱った。あちらがツールとして外から指摘を注入するのに対し、こちらはエージェント自身の振る舞いを規約で縛る。
7手順の中身も見ておく。workflow.md の見出しをそのまま並べると、①レビュー契約の確立、②変更マップの作成、③影響を受ける挙動の追跡、④リスク順のレビュー、⑤候補となる指摘の検証、⑥偽陽性の抑制、⑦レビューの出力——となる。
最初の「契約の確立」が効いている。何をレビュー対象にするか(差分か、コミットか、ブランチか、作業ツリーか)を先に確定させてから読み始める設計で、評価ケースの must-same-diff-contract や instruction-boundary はここが守られるかを見ている。②の変更マップと③の影響追跡は対になっていて、変更された行だけでなく、その変更に影響される未変更の呼び出し元まで辿ることを求める。前述の must-existing-consumer がまさにこの手順を検査するケースだ。
正本のMarkdown"] --> B["scripts/build.py"] B --> C["dist/claude-code
7ファイル"] B --> D["dist/codex
7ファイル・中身は同一"] C --> E["~/.claude/skills/ へ cp -R"] D --> F["~/.codex/skills/ へ cp -R"] E --> G["エージェントが SKILL.md を読む
約2,360トークン"] F --> G G --> H["7手順のワークフローで
変更の影響を追跡"] H --> I{"指摘の候補"} I -- "契機と影響を示せる" --> J["MUST / SHOULD / BETTER / NITS
を付けて出力"] I -- "示せない" --> K["偽陽性として落とす"]
この図のうち、破線で描きたかったのは最後の分岐だ。「契機と影響を示せない指摘は出さない」という判断が、ワークフローの独立した手順として置かれている。AIレビューを実務に入れるときの最大の摩擦は、正しそうに見えて的外れな指摘への対応コストなので、ここを設計の中心に据えているのは理にかなっている。
実測:ビルドは再現し、テストは18ケース通る
このリポジトリで面白いのは、スキルを手書きしていないことだ。src/core/ を正本にして scripts/build.py が dist/ を生成する。生成物の先頭には <!-- Generated by scripts/build.py. Do not edit this file directly. --> が入り、末尾には <!-- source-sha256: ... --> としてソースのハッシュが埋まる。手で直した生成物が紛れ込むのを防ぐ作りになっている。
クローンして、実際にビルドと検証を回した。
git clone --depth 1 https://github.com/akkie76/code-review-skills
cd code-review-skills
make check
# python3 scripts/validate.py
# Validated 2 generated skill packages.
make build && git status --short
# Generated skill packages for: codex, claude-code
# (出力なし=再生成しても dist に差分が出ない)
make build を回しても git status に差分が出ない、つまりコミットされている dist/ はソースから再現できる。生成物をリポジトリに入れる構成では「手元のビルドと中身が違う」が起きがちなので、ここが一致するのは信頼できる。
次にテスト。
make test
# Validated 2 generated skill packages.
# python3 -m unittest tests/test_tooling.py
# Ran 3 tests in 0.002s / OK
# python3 tests/run_evaluations.py
# Validated 18 behavioral evaluation cases.
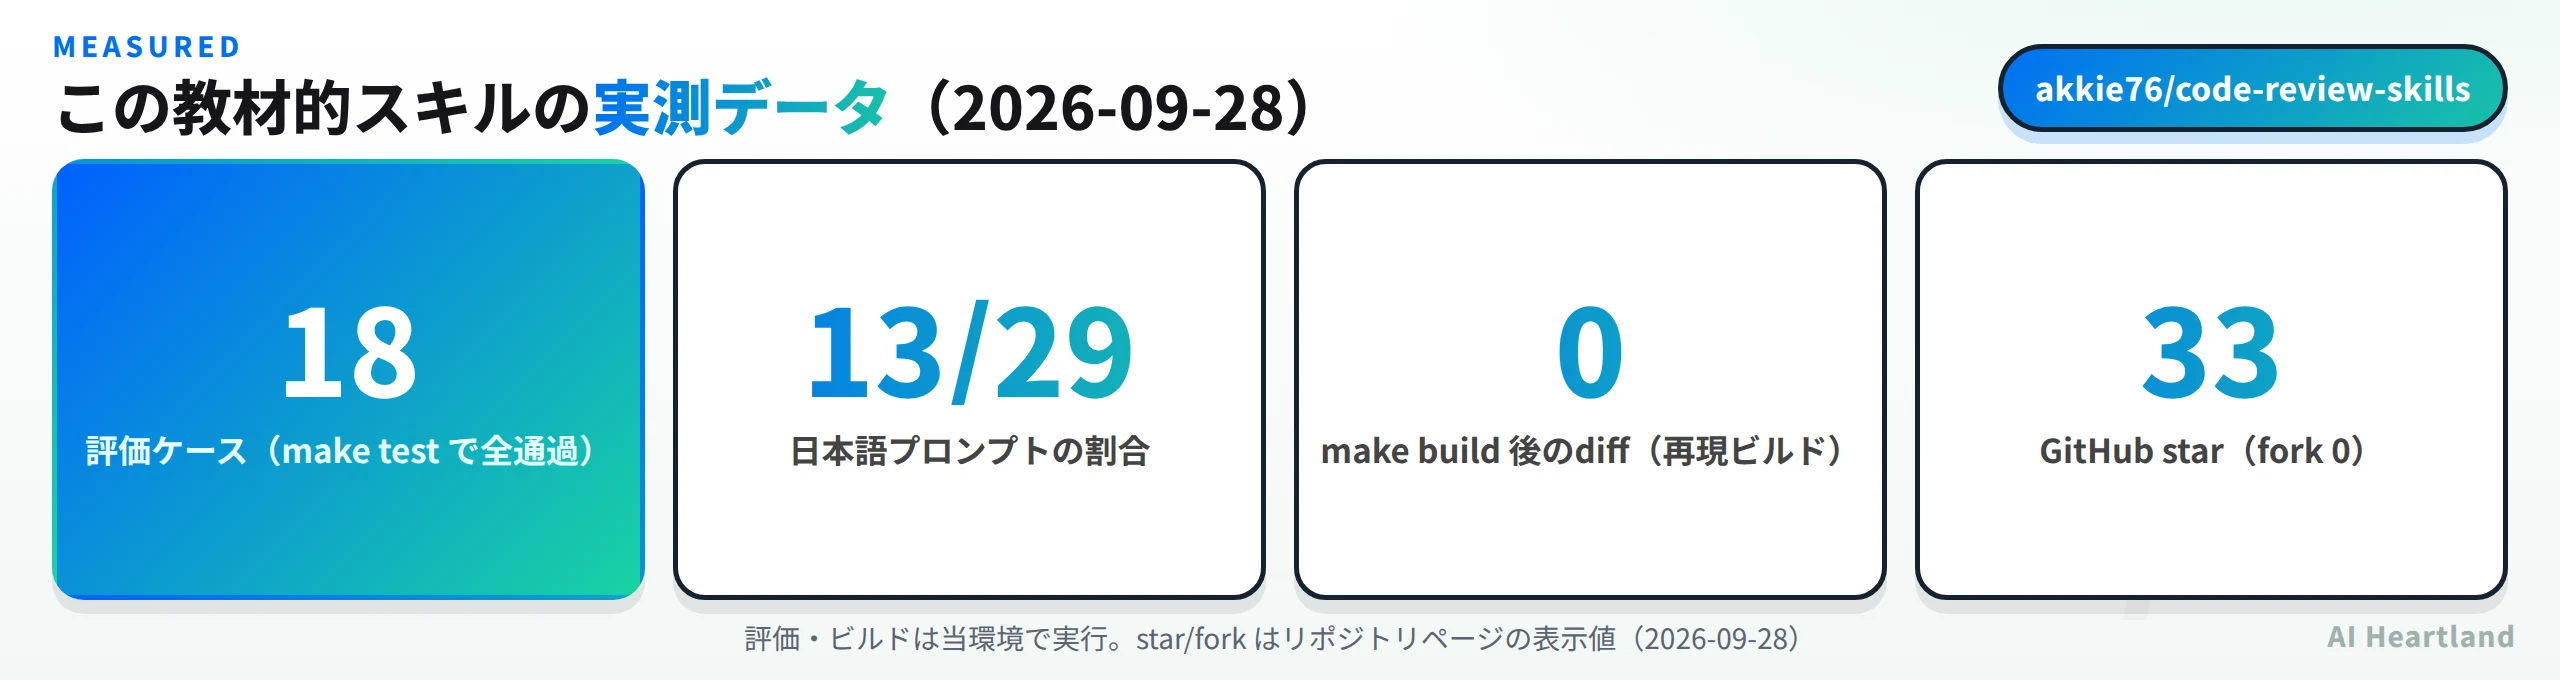
ここは読み方に注意が要る。tests/run_evaluations.py の docstring は「AIサービスを呼び出さずに、振る舞いの評価フィクスチャを検証する」と明記している。つまり18ケースが通ったというのは、各ケースの期待値の記述が形式として揃っているという意味であって、AIが実際に正しくレビューできたという意味ではない。評価の器が整っていることの確認であり、精度の証明ではない。
ケースの中身自体はよくできている。たとえば must-existing-consumer は「共有関数の戻り値がオブジェクトに変わったのに、変更されていない既存の呼び出し元が .length を読み続けている」という状況で、must_report(報告すべき欠陥)と must_not_report(してはいけない見落としや過剰要求)の両方が文章で書かれている。期待する失敗のしかたまで書いてあるのは、評価設計として丁寧だ。
検証環境:Linux 6.18.44/Python 3.11/2026-09-28。リポジトリは main の 6822a87(2026-09-27・タグ v0.1.0-beta.1)を git clone --depth 1。make check・make build・make test をそのまま実行し、git status で再現ビルドを確認。dist/claude-code と dist/codex は diff -r で突き合わせ。導入手順は一時ディレクトリを ~/.claude/skills/ に見立てて cp -R し、7ファイル・72KBが配置されることを確認した。トークン量は tools/token_audit.py の heuristic 近似トークナイザ(CJK 1字=1・ASCII 4字=1)で計測し、tiktoken の cl100k_base は当環境からBPE辞書を取得できないため使っていない。未検証:このスキルを実際のClaude CodeやCodexに読ませてレビューさせていない。指摘の質、偽陽性の少なさ、サブエージェント分割の実動作、日本語での出力品質はいずれも未測定で、18ケースが期待する挙動が本当に再現されるかも確認していない。star 33・fork 0 はリポジトリページの表示値。
常駐コストと導入:SKILL.mdの約2,360トークン
Agent Skills は、トリガーに合致したときに SKILL.md が文脈に入る。だから入れっぱなしで効いてくるのは SKILL.md の分量になる。
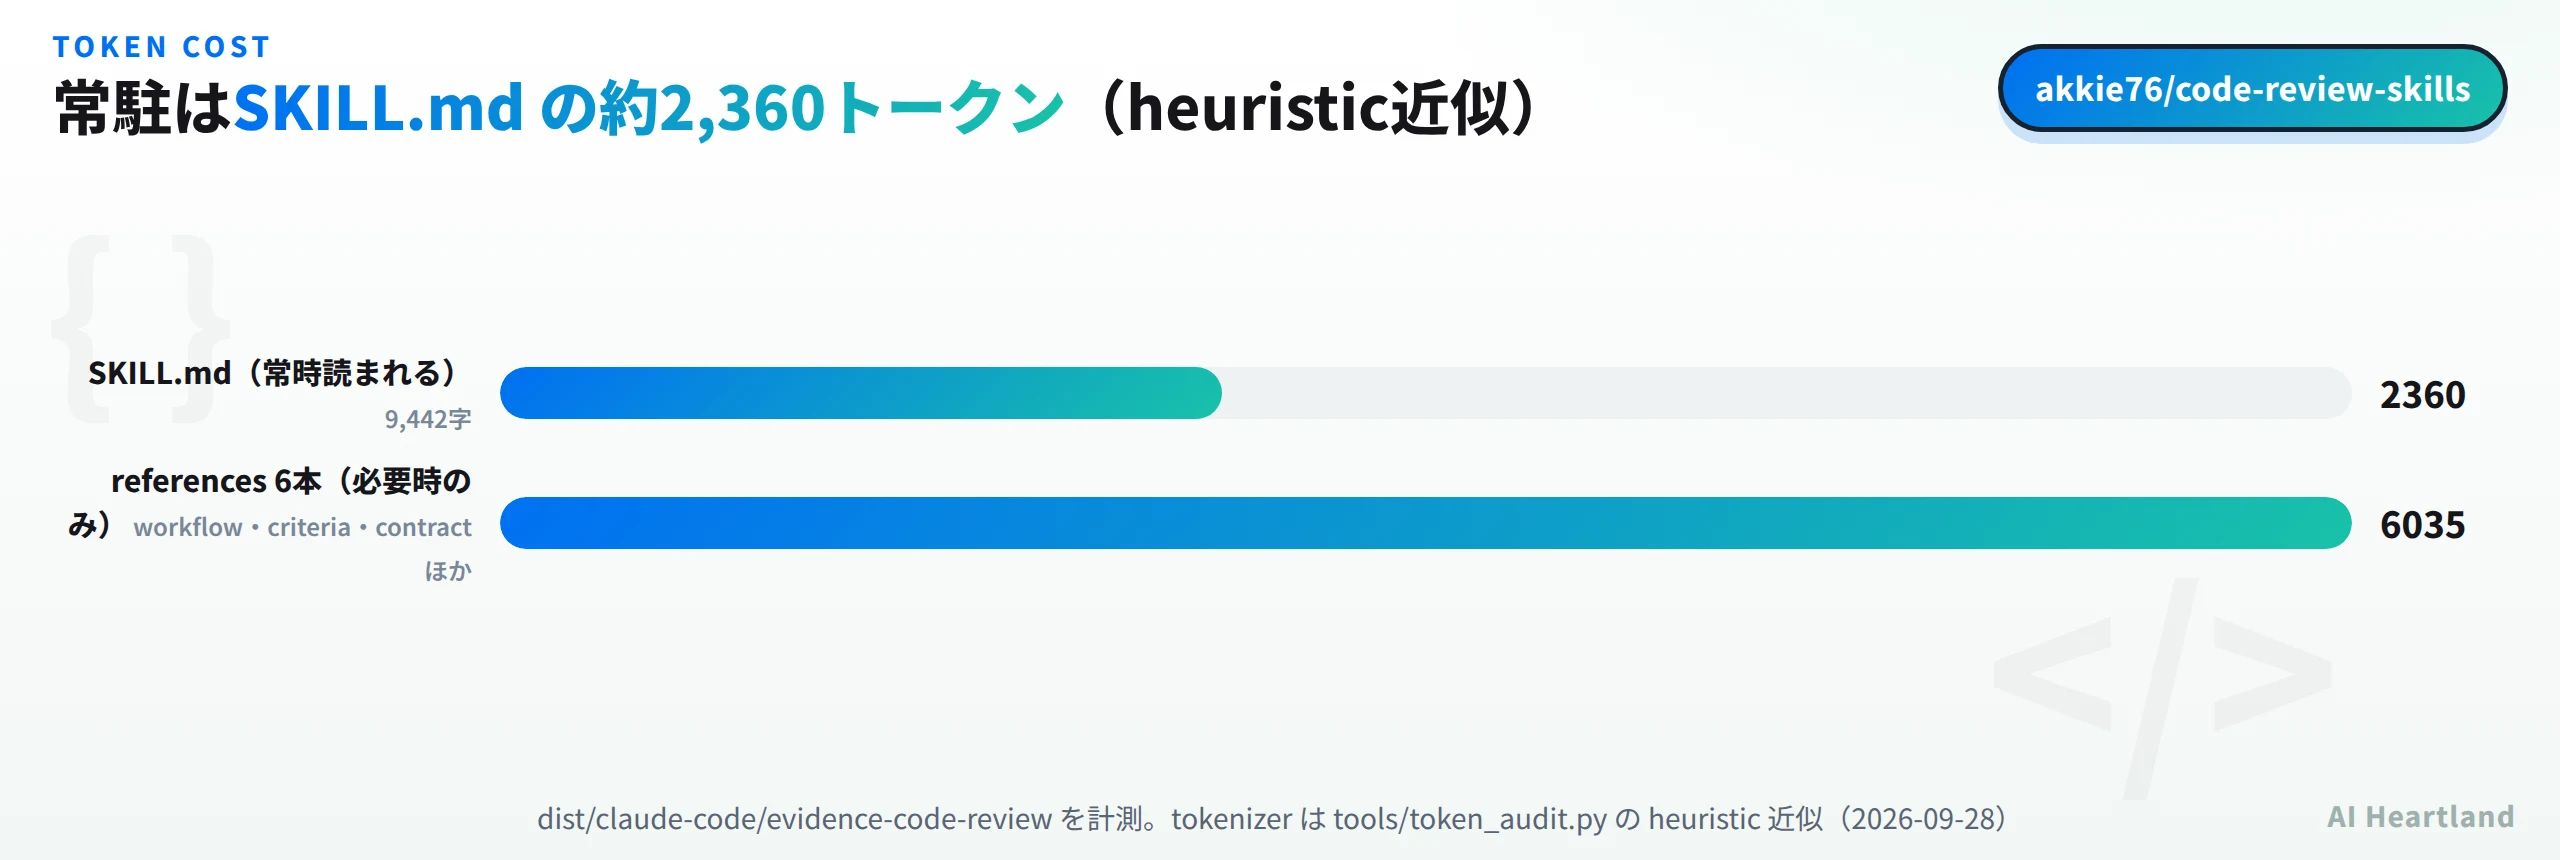
| 対象 | 文字数 | 概算トークン |
|---|---|---|
SKILL.md(常時) |
9,442 | 約2,360 |
references/ 6ファイル(必要時) |
— | 約6,035 |
| パッケージ合計 | — | 約8,395 |
SKILL.md 単体で2,360トークンは、Agent Skill としては軽くはないが重すぎもしない。7手順のワークフローと4段階のレベル定義を本体に持ち、詳細な判断基準(review-criteria.md の8観点や multi-agent-decomposition.md)は references に逃がす、という切り分けができている。スキルを何本も入れると常駐が積み上がる問題はskills-hubとは|Agent Skillsを47ツールへ同期するデスクトップアプリを実測でも扱ったとおりで、入れる本数と1本あたりの重さの両方を見る必要がある。
導入は「ディレクトリごとコピーする」だけだ。READMEも「個別ファイルではなくパッケージ全体をコピーすること」を強調している。手元で一時ディレクトリに対して実行したところ、7ファイル・72KBが配置された。
mkdir -p ~/.claude/skills
cp -R dist/claude-code/evidence-code-review ~/.claude/skills/
# ~/.claude/skills/evidence-code-review/SKILL.md
# ~/.claude/skills/evidence-code-review/references/ 以下6ファイル
Codex の場合は ~/.codex/skills/ に dist/codex/evidence-code-review を置く。ただし前述のとおり、この2つのパッケージは diff -r で差分が0だった。現時点では配置先が違うだけで、中身は完全に同じものが入る。インストーラ経由でスキルを入れる方式と比べると、こちらは cp -R 一発で、何がディスクに入るかがその場で目で見える。導入も撤去も rm -rf で完結するので、試す側の心理的な障壁は低い。
導入前に押さえる点
・まだ v0.1.0-beta.1:タグは1本だけで、最終コミットは2026-09-27。beta表記のとおり、構成や出力規約が変わる可能性は見込んでおく
・star 33 / fork 0:利用実績から品質を推し量れる段階ではない。中身を読んで判断する類のリポジトリ
・日本語が一級市民:README.ja.md・CHANGELOG.ja.md・SECURITY.ja.md・SUPPORT.ja.md に加えて docs/ 配下も5トピックすべてが日英対。評価ケース29プロンプト中13件が日本語で、出力言語の選択手順も規約に含まれる
・技術別ガイダンスは別枠:src/technologies/ があり、言語やフレームワーク固有のルールを足せる構造になっている。逆に言えば、既定では技術固有の知識をほとんど持たない汎用レビューである
・CIで回す前提ではない:このスキルはエージェントの振る舞いを規定するもので、PRに自動でコメントする仕組みは含まれない。CI側で自動レビューを回したいならClaude Code Security Reviewとは|PRを自動で守るGitHub ActionのようなAction型と組み合わせる形になる
総括。 code-review-skills は、AIレビューの出力を規約で縛るという方向に振り切ったスキルだ。4段階のアクションレベル、すべての指摘に契機と影響を求める要件、偽陽性の抑制を独立手順にしたワークフロー——どれも「AIに何かを足す」のではなく「AIに何かを言わせない」ための設計になっている。そしてその規約が、Markdownの正本からの再現ビルドと18の評価ケースという形で機械的に守られている点が、star 33という規模に対して不釣り合いなほど作り込まれている。
一方で、このスキルが実際に良いレビューをするかどうかは本記事では測れていない。評価ケースは器の検証であって精度の証明ではないし、筆者の環境でエージェントに読ませた検証もしていない。それでも、SKILL.md を9,442字で読めること、cp -R で入ること、いつでも消せることを考えれば、試す側のコストは十分に小さい。規約がMarkdownで全部見えるので、自分のチームの基準に合わせて src/core/ を書き換えて再ビルドする、という使い方もできる。まずは自分のリポジトリの直近のPRに当てて、MUST が本当に MUST として出てくるか、そして NITS が MUST に化けていないかを見るのが早いと思う。規約が守られているかどうかは、出力の頭に付く4文字を数えるだけで判断できる。
参照ソース
・akkie76/code-review-skills(公式リポジトリ) — README・src/core/・dist/・tests/cases/・LICENSE を 2026-09-28 に確認(main の 6822a87)
・README.ja.md(公式・日本語) — 日本語版のREADME
・docs/INSTALLATION.ja.md(公式・日本語) — 導入手順の日本語版