「FrontierAgent」はApodex社(ApodexAI)が公開しているOSSのエージェントランタイムで、ターミナル上で動くfrontier-agentという1本のTUI/CLIから、ReAct(単一エージェント)とAgent Team(コーディネーター+並列サブエージェント)という2つの実行モードを切り替えられる。README・LICENSE・実機での起動確認まで裏取りしたうえで、「何ができるか/何を解決するか/何を代替できるか」の3点を実測ベースで整理する。
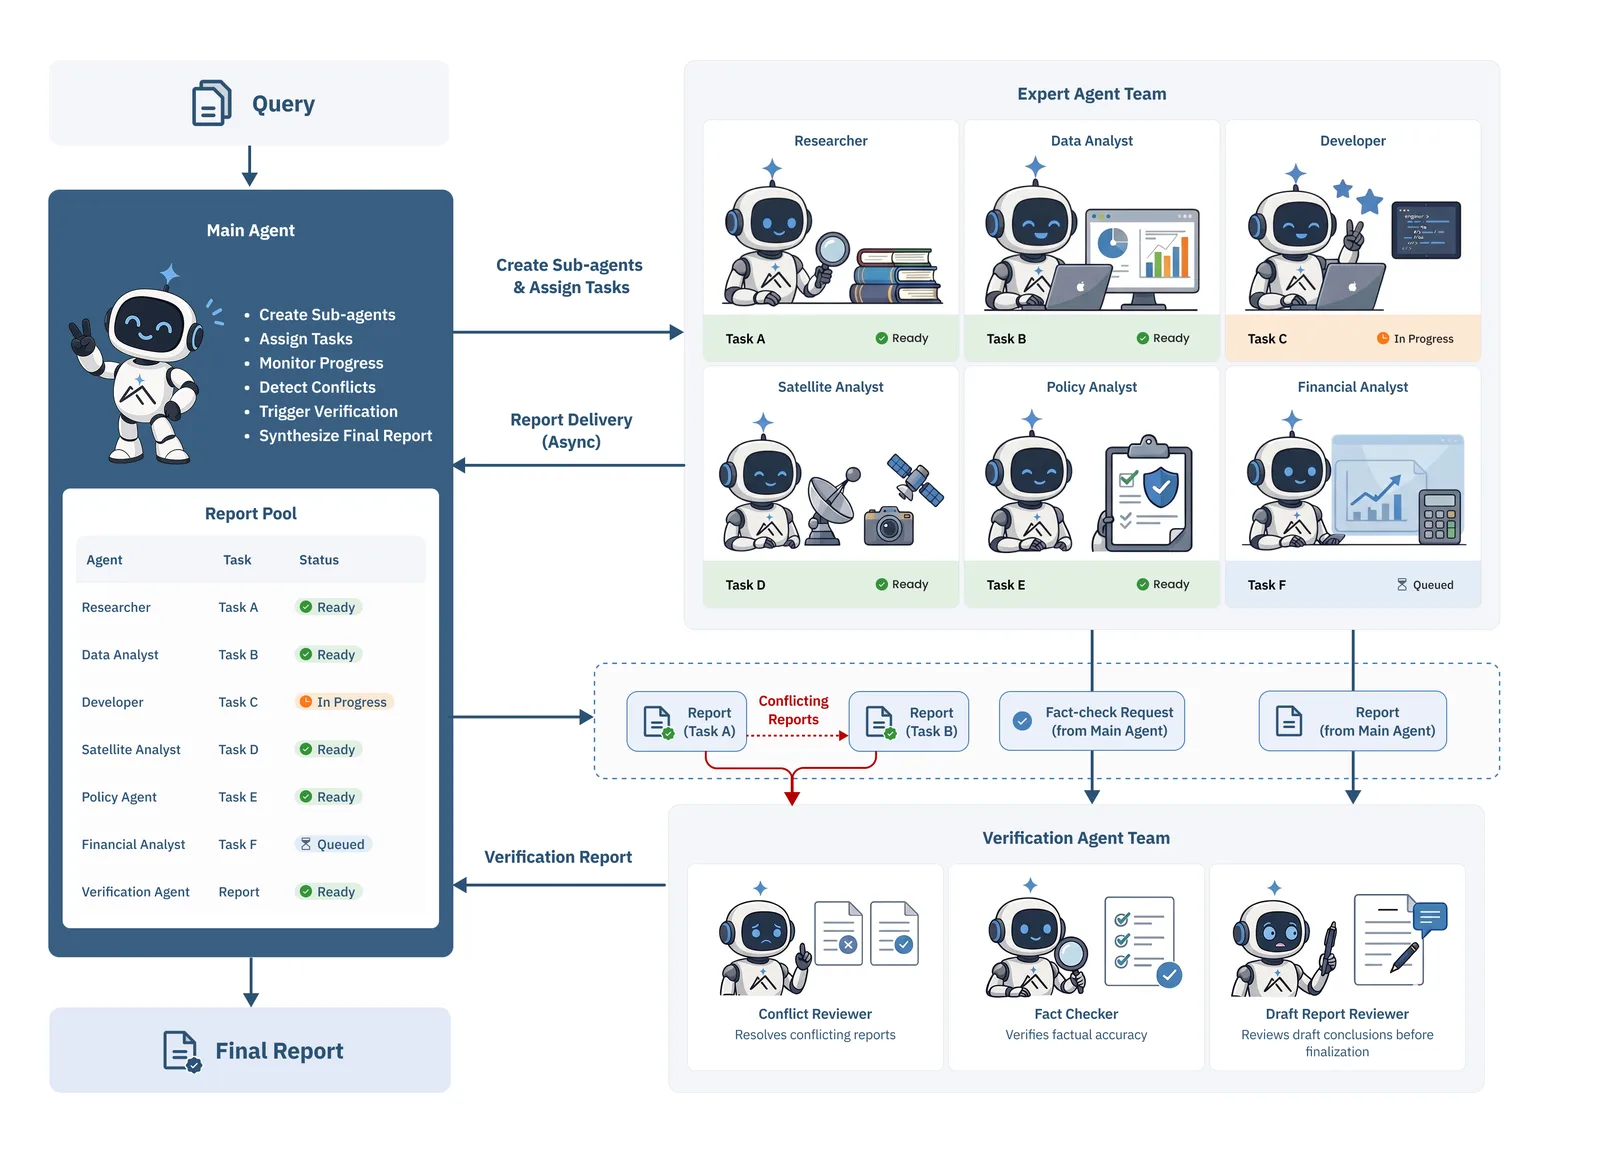
- ・正体:Apodex社製のOSSエージェントランタイム兼TUI。ReAct(単一)とAgent Team(並列コーディネーター)の2モードを持つ
- ・何ができる:長時間の調査・ファイル作業を、承認/トレース/revert付きのサンドボックスの中で実行できる
- ・何を解決する:「調査エージェントに何をされたか分からない」という不透明さを、diff承認とセッション単位のrevertで抑える
- ・実測:
git clone --depth 1からuv sync --python 3.12 --extra devまで約3秒(本日Linux環境で計測、キャッシュ状態に依存する参考値)。API未設定時は起動直後に安全に停止することを確認 - ・注意:GitHub star 2,528・contributor 10人・タグ付きリリース0本(2026-09-11時点、リサーチ枠実測)。pre-1.0であることと、自社モデルApodex 1.1の評価ハーネスを兼ねる構成である点は前提として読む
より広くAIエージェントフレームワークを比較したい場合は、AIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証も参照してほしい。FrontierAgentはこの比較の中でも「調査・ファイル作業に特化した長時間実行エージェント」という枠に入る。
FrontierAgentとは|ReAct/Agent Teamの2モードを持つOSSエージェントランタイム
FrontierAgentは、READMEの定義によれば「long-horizon research and file-based work」向けのオープンソースのエージェントランタイム・ターミナル製品・評価スイートである。中心にあるのはfrontier_agent/パッケージの汎用ループ・スケジューリング・レジストリで、その上に2つの実行モードが載る。
・ReAct:1体のステートフルなエージェントが、タスクスコープのサンドボックス内でファイルを読み書きし、コマンドを実行しながら反復する
・Agent Team:コーディネーターがタスクボードを維持し、独立した作業を並列のサブエージェントへ委任、レポートを集めて最終結果に合成する
READMEはこの2モードを同じワークフローエンジンで動かしていると明記しており、フレームワーク・ツール・ワークフロー・評価レイヤーは分離されているため、それぞれ単独でも再利用できる設計だとしている。
リポジトリの分割はfrontier_agent/(汎用ループ)・plugins/tools/(web・shell・file・sandbox・teamツール)・workflows/(ReAct/Agent Teamのパイプラインとプロンプト)・apodex/(TUI・承認・セッション・Docker周り)・benchmarks/(評価ハーネス)に分かれており、この境界がREADMEで明示的に「意図的」と説明されている。
アーキテクチャ|サンドボックスと承認・トレース・revert
FrontierAgentが他の調査系エージェントと比べて運用寄りに作られているのは、ファイル操作の権限モデルを明確に3層へ分離している点にある。
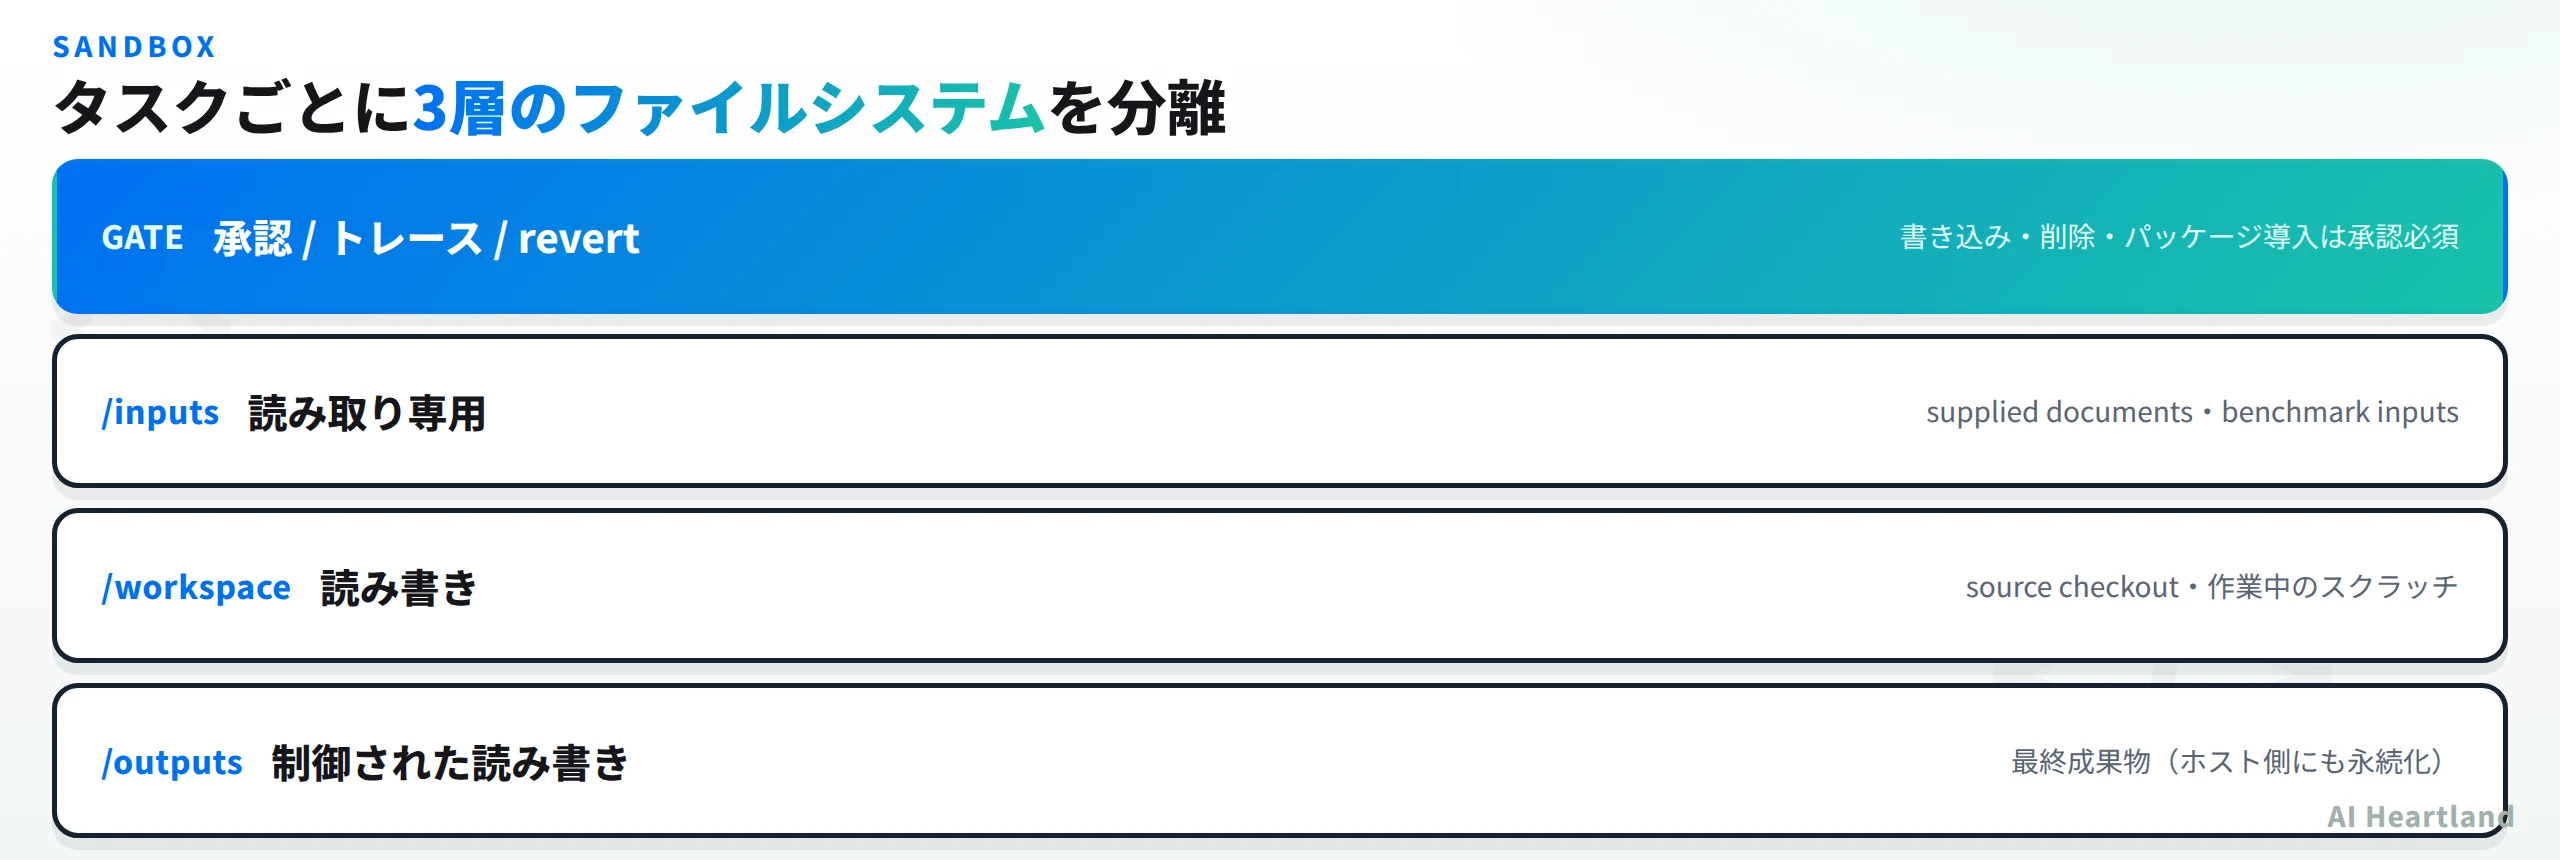
・/inputs:読み取り専用。提供ドキュメントやベンチマークの入力が置かれる
・/workspace:読み書き可。ソースのチェックアウトや作業中のスクラッチ領域
・/outputs:制御された読み書き。最終的な成果物のみが入り、macOS/Docker環境では.apodex/runs/<session-id>/outputsとしてホスト側にも永続化される
シェル・ファイル系のツールはこの1つのタスクサンドボックスとパスポリシーを共有し、インタラクティブなセッションでは書き込み・削除・パッケージ導入・危険なシェルコマンドに承認ゲートがかかる。README上は「一部の操作は--yesを付けても拒否され続ける」「ファイルの変更はジャーナル化されており/revertで取り消せる」と説明されている。セッションはチェックポイントされ、すべてのアクションはローカルにトレースされ、--resumeで保存済みの実行を継続できる、というのがREADMEの記載だ。
① 何ができる:長時間の調査・ファイル作業を、承認ゲート付きの隔離されたファイルシステムの中で実行できる。 ② 何を解決する:「エージェントに何を書き換えられたか分からない」「暴走した操作を戻せない」という不透明さを、diff承認とセッション単位の`/revert`で抑える。 ③ 何を代替できる:素のシェルアクセスを与えるだけの自作ラッパーの代わりに、この権限モデルをそのまま使える。
FrontierAgentを実機で動かす|uv syncからTUI起動まで
brief(リサーチ枠が確定した検証手順)に従い、Linux環境(Docker無し・GPU無し)で実際にセットアップとTUI起動までを試した。以下は本日(2026-09-18、コミットhash未固定のmainブランチ)実行して確認できたコマンドそのものである。
git clone --depth 1 https://github.com/ApodexAI/FrontierAgent.git
cd FrontierAgent
uv sync --python 3.12 --extra dev
git clone --depth 1は約1.1秒、続くuv sync --python 3.12 --extra devは約2.2秒で完了した(キャッシュ済みのCI環境での計測値であり、初回実行や別環境ではより時間がかかる可能性がある参考値)。
cp .env.example .env
# .env に OPENAI_API_KEY / OPENAI_BASE_URL / OPENAI_MODEL を設定してから
uv run frontier-agent --mode react --cwd /path/to/project
OpenAI互換のエンドポイントを用意していない状態(OPENAI_API_KEY未設定)で--mode react・--mode agent_teamの両方を試したところ、いずれも次のように起動処理自体は進み、実際にモデルへ接続する前の設定検査(preflight)で明確に停止することを確認した。
apodex: native mode — mutable runtime files are under <path>/.apodex/runtime/native.
error: runtime configuration preflight failed
- API key (OPENAI_API_KEY) is missing for provider openai.
- The active model is empty.
Set the missing or invalid values and retry, for example:
  export OPENAI_API_KEY=...
  export OPENAI_MODEL=...
つまり、セットアップから実行バイナリの起動までは実機で確認できたが、TUIの実画面(サイドバーのタスクボード表示など)はOpenAI互換エンドポイントが無いと確認できず、この記事では未検証として扱う。README記載どおり、platform.apodex.aiのホスト型エンドポイントを使うか、GPU搭載Linuxホストでのネイティブ/Docker SGLang構成を用意すれば先に進めるはずだが、いずれも本検証の範囲外だった。
FrontierAgentは何を代替できるか|OpenHands・Tongyi DeepResearchとの違い
当サイトには近接テーマの記事として、SWE-Bench特化のコーディングエージェントOpenHands完全ガイド:SWE-Bench 77.6%のOSS AIコーディングエージェント徹底解説、実行環境そのものを提供するAIO Sandbox入門:AIエージェント実行環境をDocker1つで構築する方法、アリババの長時間リサーチ特化エージェントTongyi DeepResearch 解説|アリババのオープンソースDeep Researchエージェント(30B-A3B)を使うがある。FrontierAgentはこれらのどれとも主題が重ならない。
| 項目 | FrontierAgent | OpenHands(当サイト既出) | Tongyi DeepResearch(当サイト既出) |
|---|---|---|---|
| 主な用途 | 長時間の調査・ファイル作業+自社モデルの評価ハーネス | SWE-Bench特化のコーディングエージェント | 長時間リサーチ特化エージェント |
| 実行モード | ReAct(単一)/ Agent Team(並列コーディネーター) | 単一エージェント中心 | 単一エージェント中心 |
| ファイル権限モデル | /inputs読取専用・/workspace読み書き・/outputs制御付き+承認/revert |
既存記事参照(本記事では未再確認) | 既存記事参照(本記事では未再確認) |
| ライセンス | Apache-2.0(LICENSE原文で確認済み) | 既存記事参照(未再確認) | 既存記事参照(未再確認) |
| GitHub ⭐ | 2,528(2026-09-11時点、リサーチ枠実測) | 既存記事参照 | 既存記事参照 |
| 開発元 | Apodex(企業。自社モデルApodex 1.1の評価用途を兼ねる) | OSSコミュニティ | アリババ |
FrontierAgentを一言で位置づけるなら、「もう1つのコーディングCLI」ではなく、調査・ファイル作業向けの汎用ランタイムであり、同時に自社の大規模言語モデルのベンチマーク基盤でもあるという二重の役割を持つOSSだ。コーディング専用の最適化(テスト実行との統合やdiff適用の細かい制御など)を求めるならOpenHandsのような専用ツールの方が向いている。
Apodex 1.1ベンチマークとの関係|自社モデルの評価ハーネスという位置づけ
FrontierAgentのREADME冒頭には、Apodex社の大規模言語モデル「Apodex 1.1」(35B・オープンウェイト)の評価結果が大きく掲載されている。
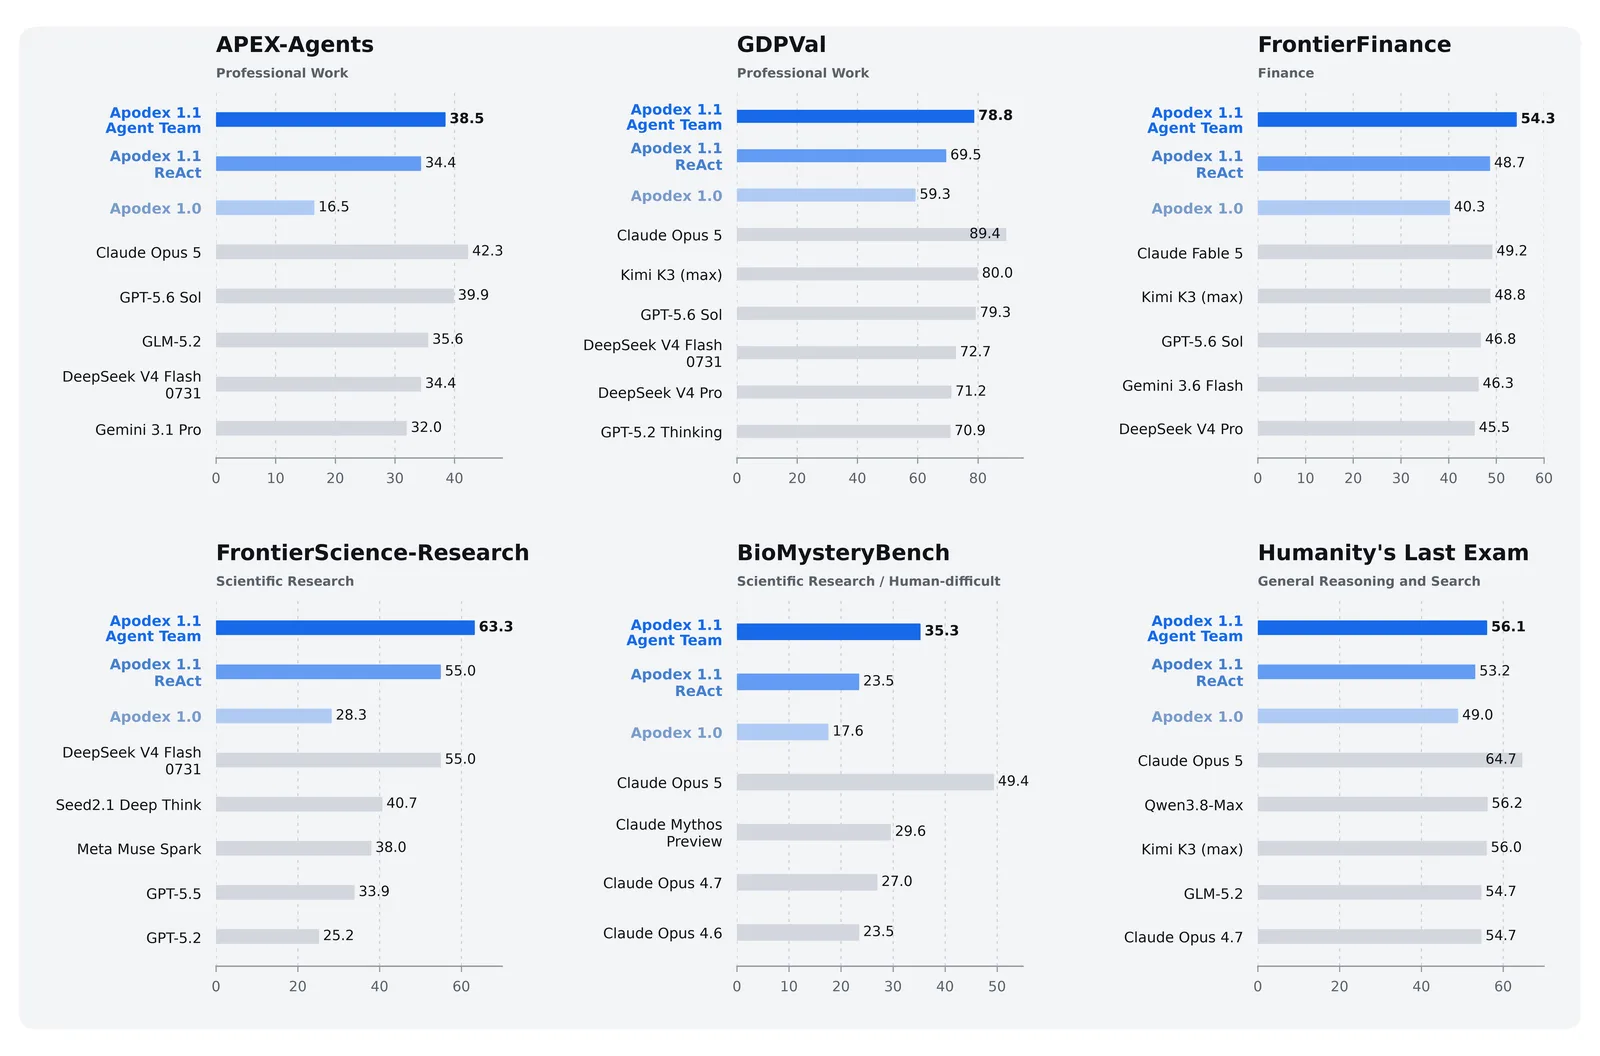
README自身も「the same workflow engine powers the benchmark runner used to evaluate Apodex models」と明記しているとおり、FrontierAgentのワークフローエンジンはApodex 1.1の評価に使われているものと同一だ。つまりFrontierAgentは、①エンドユーザーが使う調査・ファイル作業ツールであると同時に、②Apodex社が自社モデルを測るベンチマークハーネスでもある。GitHub org「ApodexAI」の説明文は「The World’s First Self-Evolving Heavy-Duty Solver」だが、これは企業の自称であり独立した検証は無い。
・何ができるか:BrowseComp・GDPval・Humanity’s Last Examなど、README記載の主要ベンチマークを同じCLIから再実行できる
・何を解決するか:モデルの評価と、実際にエージェントとして使う環境を分けずに済む
・何を代替できるか:自作の評価スクリプトを一から書く手間を、公開済みのベンチマークレジストリで代替できる
導入前に確認すべき注意点|GPU依存・期間限定オファー・pre-1.0
・OpenAI互換エンドポイントが必須:README記載の「2週間無料」のApodex APIオファーは2026-09-18確認時点でまだ表示されていたが、期間限定である以上、利用時点で有効かどうかは公式ページ(platform.apodex.ai)で確認してほしい
・ローカルSGLang実行はGPU/CUDA依存が強い:README自身が「GPU compatibility matrix」の事前確認を強く推奨しており、ドライバ・CUDA・SGLangの組み合わせが合わないと、起動時にわかりにくいCUDA/Tritonカーネルエラーとして表面化するとされている。本検証はGPU無し環境のため、この経路は未検証
・pre-1.0であること:タグ付きリリースは2026-09-11時点で0本(リサーチ枠実測)。バージョン番号による安定性の目安が無いため、動作を確認した時点(コミットの取得日)を明記しておくことが重要
作成からリサーチ枠が実測した時点(2026-08-22作成→2026-09-11)でstar 2,528・contributor 10人・毎日コミットという急成長ぶりだが、これは裏を返せばAPIやディレクトリ構成が今後も変わりうるということでもある。本記事のコマンド・挙動は2026-09-18時点でのmainブランチに基づく。
まとめ|FrontierAgentが向いている場面
FrontierAgentは、「調査タスクをエージェントに任せたいが、何をされたか分からないのは避けたい」という要件に対して、承認・トレース・revertとサンドボックス分離をセットで提供するOSSランタイムだ。コーディング特化のCLIや実行環境そのものを提供するOSSとは層が異なり、ReActとAgent Teamという2つの実行モードを1つのCLIで切り替えられる点、そして自社モデルの評価ハーネスを兼ねている点が特徴になる。
・セットアップから起動処理までは実機で確認済み(`git clone`→`uv sync`→preflight停止まで)
・OpenAI互換エンドポイントが無いとTUI実画面までは進めない(本記事では未検証)
・Apodex 1.1のベンチマーク数値は自社公表値として扱い、断定的な優劣評価はしない
・pre-1.0(タグ付きリリース0本)なので、導入時はコミット時点を記録しておく
参照ソース
・ApodexAI/FrontierAgent(公式リポジトリ・README) — アーキテクチャ・インストール手順・機能一覧・ベンチマーク結果を取得(2026-09-18確認)
・Apodex公式サイト — Apodex 1.1モデルおよび自社エンドポイントの案内を確認(自社公表情報である点に留意)