「Ollamaでモデルをpullして、LM Studioでチャットする」——ローカルLLMの定番ワークフローは、これまでずっと人間が主役だった。Magnitude(magnitudedev/magnitude)は、その前提をひっくり返す。GitHubスター3,656・フォーク259、Apache-2.0ライセンスのOSSで、想定利用者は人間ではなくClaude Code・Codex・Cline等のコーディングエージェント。手元のハードウェアを自動で診断し、動くモデルを推薦し、対応ハーネスへワンプロンプトで接続する——「エージェント専用のローカル推論サーバー」という一点に振り切った設計を、実際にインストールして検証した。
- ・正体:magnitudedev製のApache-2.0・OSSローカル推論サーバー。人間向けチャットUIは無く、コーディングエージェント接続専用。
- ・何ができる:ハードウェアを自動診断し、動作可能なモデルをtok/s見積もり付きで推薦。Claude Code等の対応ハーネスへワンコマンドで接続する。
- ・何を代替できる:Ollama・LM Studioの「人間が手動でモデルを選ぶ」工程。ただし人間向けチャット用途そのものは代替しない。
- ・実測:検証環境(2 vCPU・7.8GB Linux VM)で
npm i -g @magnitudedev/cliから数十秒でサービスが起動し、ハードウェア診断・モデル推薦・ハーネス一覧まで動作を確認。 - ・注意:pre-1.0(0.x系)。検証当日にnpmパッケージが非推奨マーク付きで新版公開、公式は無料デスクトップアプリへの移行を案内していた。
まず前提として、ローカルLLM全般のランタイム比較・VRAM要件・オープンウェイトモデルの選び方は、当サイトのローカルLLMを動かす方法|最新オープンウェイトモデル・ランタイム比較・VRAM要件の総まとめにまとめてある。本記事はその中でも「エージェントの裏方として自動運用される推論サーバー」というMagnitudeならではの立ち位置を、実際にコマンドを叩いて掘り下げる。
Magnitudeとは何か——「人間ではなくエージェントのための」ローカル推論サーバー
Magnitudeを一言でいえば、「ハードウェアを自分で診断し、対応するコーディングエージェントへ自動接続する、OSSのローカル推論サーバー」だ。開発元はGitHub Organizationのmagnitudedev(Discord・X: @usemagnitudeを運用、ドメインはmagnitude.dev)。READMEが掲げるキャッチコピーは「Free to run: no token costs, API keys, or rate limits(トークン課金もAPIキーもレート制限も無く、無料で動かせる)」——ただしこれはMagnitude自身のローカル推論の話であり、接続先のClaude Code等のハーネス側のサブスク・APIコストとは別問題である点は誤解しないでほしい。
・想定利用者が違う:OllamaやLM Studioは「人間がターミナル/GUIでモデルを選び、チャットする」ためのツール。Magnitudeは「エージェントが自動でモデルを選び、推論を任せる」ためのツールで、チャットUIそのものを持たない
・ハードウェア診断が組み込み:CPU・メモリ・アクセラレーションの有無を自動検出し、動かせるモデルだけを提示する
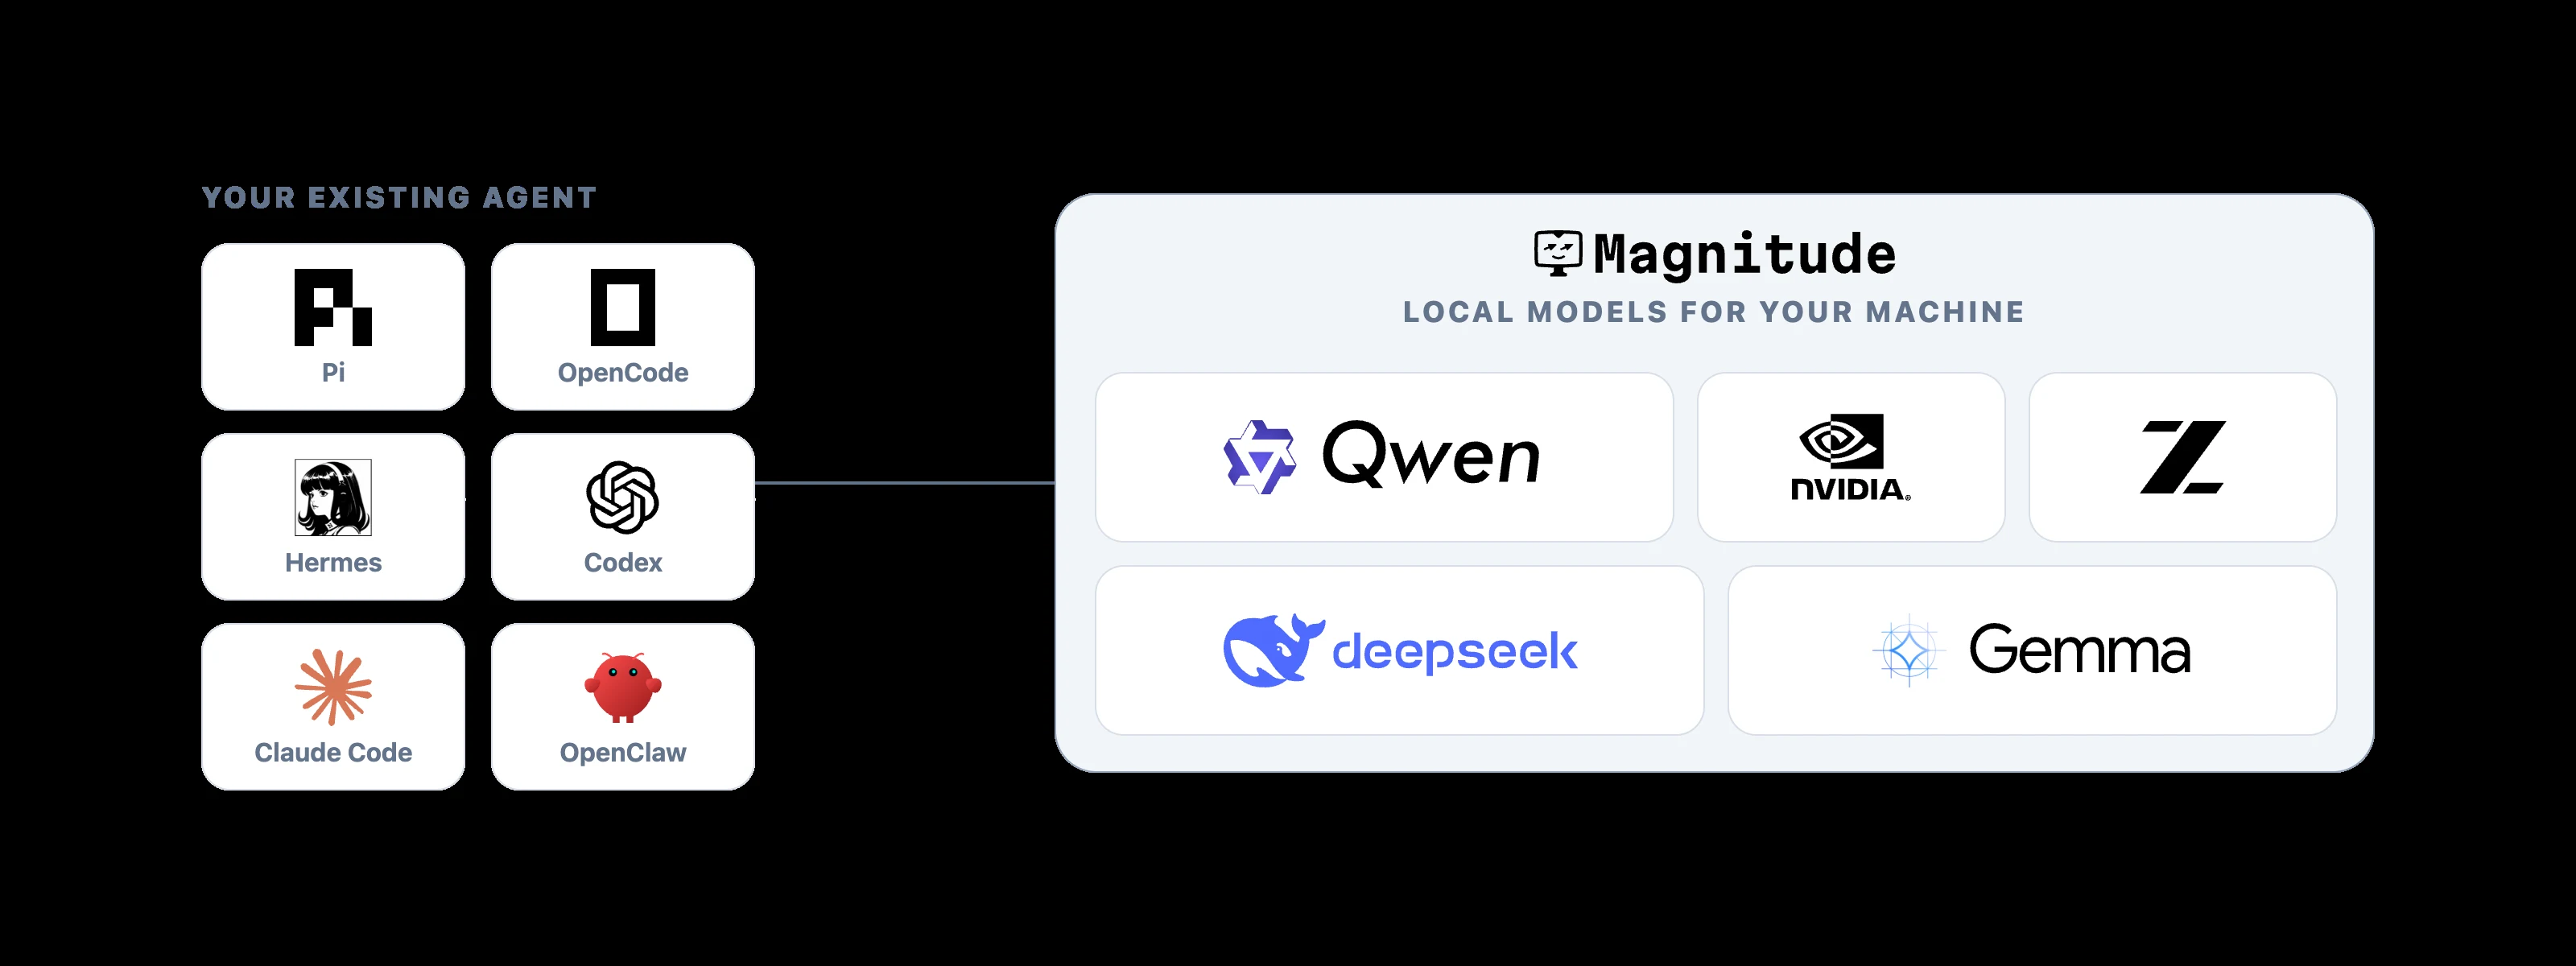
・接続ハーネスが多い:Claude Code・Codex・Cline・OpenCode・Pi・Hermes・OpenClaw等、複数のコーディングエージェントへの接続コマンドが用意されている
・オフラインAI志向:モデルの推論自体は手元のマシンで完結し、コードやプロンプトを外部のクラウドAPIへ送らずに済む。オフラインAI環境でエージェントを動かしたい開発者に向けた設計だ
バス係数とpre-1.0という現実
実測ベースで採用判断に必要な事実も並べておく。GitHub API実測でcontributor数は6名、総コミット数は618(mainブランチ)。618コミットが6名にどう分布しているかまでは未確認だが、少人数集中型のプロジェクトである点は踏まえておきたい。リリース数は46で最新タグは@magnitudedev/[email protected](2026-09-05時点)——ただしnpmレジストリのlatestタグは同時点で0.0.11だった。GitHubのタグとnpmの公開版がズレて動くのは、pre-1.0(0.x系)のプロジェクトではよくあることで、本記事の実機検証でもこのズレはさらに進行していた(後述)。作成は2026-06-12で、約3ヶ月で★3,656まで伸びた急成長中の新規プロジェクトであり、star数と中身(contributor 6名・commit 618)の比率としては「乖離」というより「若いプロジェクトとして自然な規模感」だ。
Magnitudeのインストールとサービス起動——実機で確認したもの
ここからは実際にコマンドを叩いた記録である。検証環境はLinux(2 vCPUコア・メモリ7.8GBの仮想マシン)。公式READMEはWindowsをネイティブ非対応としWSL経由のみをサポートすると明記しているため、macOSまたはLinuxが素直な選択肢になる。
# CLIをグローバルインストール
npm i -g @magnitudedev/cli

# バージョン確認
magnitude --version
インストール自体はadded 1 package in 839msとほぼ一瞬で終わった。ただし、ここで想定外の出力に気づいた。
npm warn deprecated @magnitudedev/[email protected]:
npm warn deprecated ========================================================
npm warn deprecated MAGNITUDE HAS MOVED TO A FREE, OPEN SOURCE DESKTOP APP.
npm warn deprecated
npm warn deprecated THIS LEGACY CLI WILL NO LONGER RECEIVE UPDATES.
npm warn deprecated
npm warn deprecated DOWNLOAD THE DESKTOP APP:
npm warn deprecated https://magnitude.dev/download
npm warn deprecated ========================================================
magnitude --versionが返したのは0.0.15。npmのnpm view @magnitudedev/cliで確認すると、この0.0.15は検証時点のわずか9時間前に公開されたばかりだった。CLI自体は今も動作する(後述の通りコマンド体系は健在)が、npmパッケージには非推奨(deprecated)マークが付き、公式は無料のオープンソース・デスクトップアプリへの移行を案内している。この事実は本記事執筆当日(2026-09-17)に確認したもので、詳細は「注意点」セクションで扱う。
続いて、推論を担うバックグラウンドサービスを起動する。
magnitude service start
実行するとMagnitude serviceのダウンロードが始まり、進捗表示付きで40.6MBのバイナリを取得。完了まで数十秒、最終的に● Magnitude service is ready at 127.0.0.1:10100と表示され、ローカルの10100番ポートでサービスが立ち上がった。
ハードウェア自動診断とモデル推薦——実際に何を見せるか
サービスが起動した状態で、ハードウェア診断コマンドを叩く。
magnitude hardware
magnitude catalog recommendations
magnitude hardwareの実際の出力は次の通りだった。
Virtual Machine
  Linux · x86-64 · 2 logical CPU cores
  7.8 GB system memory

Memory
  System memory
  1.6 GB / 7.8 GB used
  Free          6.2 GB

Current model
  None
仮想マシン環境であることまで正しく識別し、CPU・メモリの空き容量を把握している。続けてmagnitude catalog recommendationsを叩くと、この環境で動くモデルが速度見積もり付きでランキング表示された。
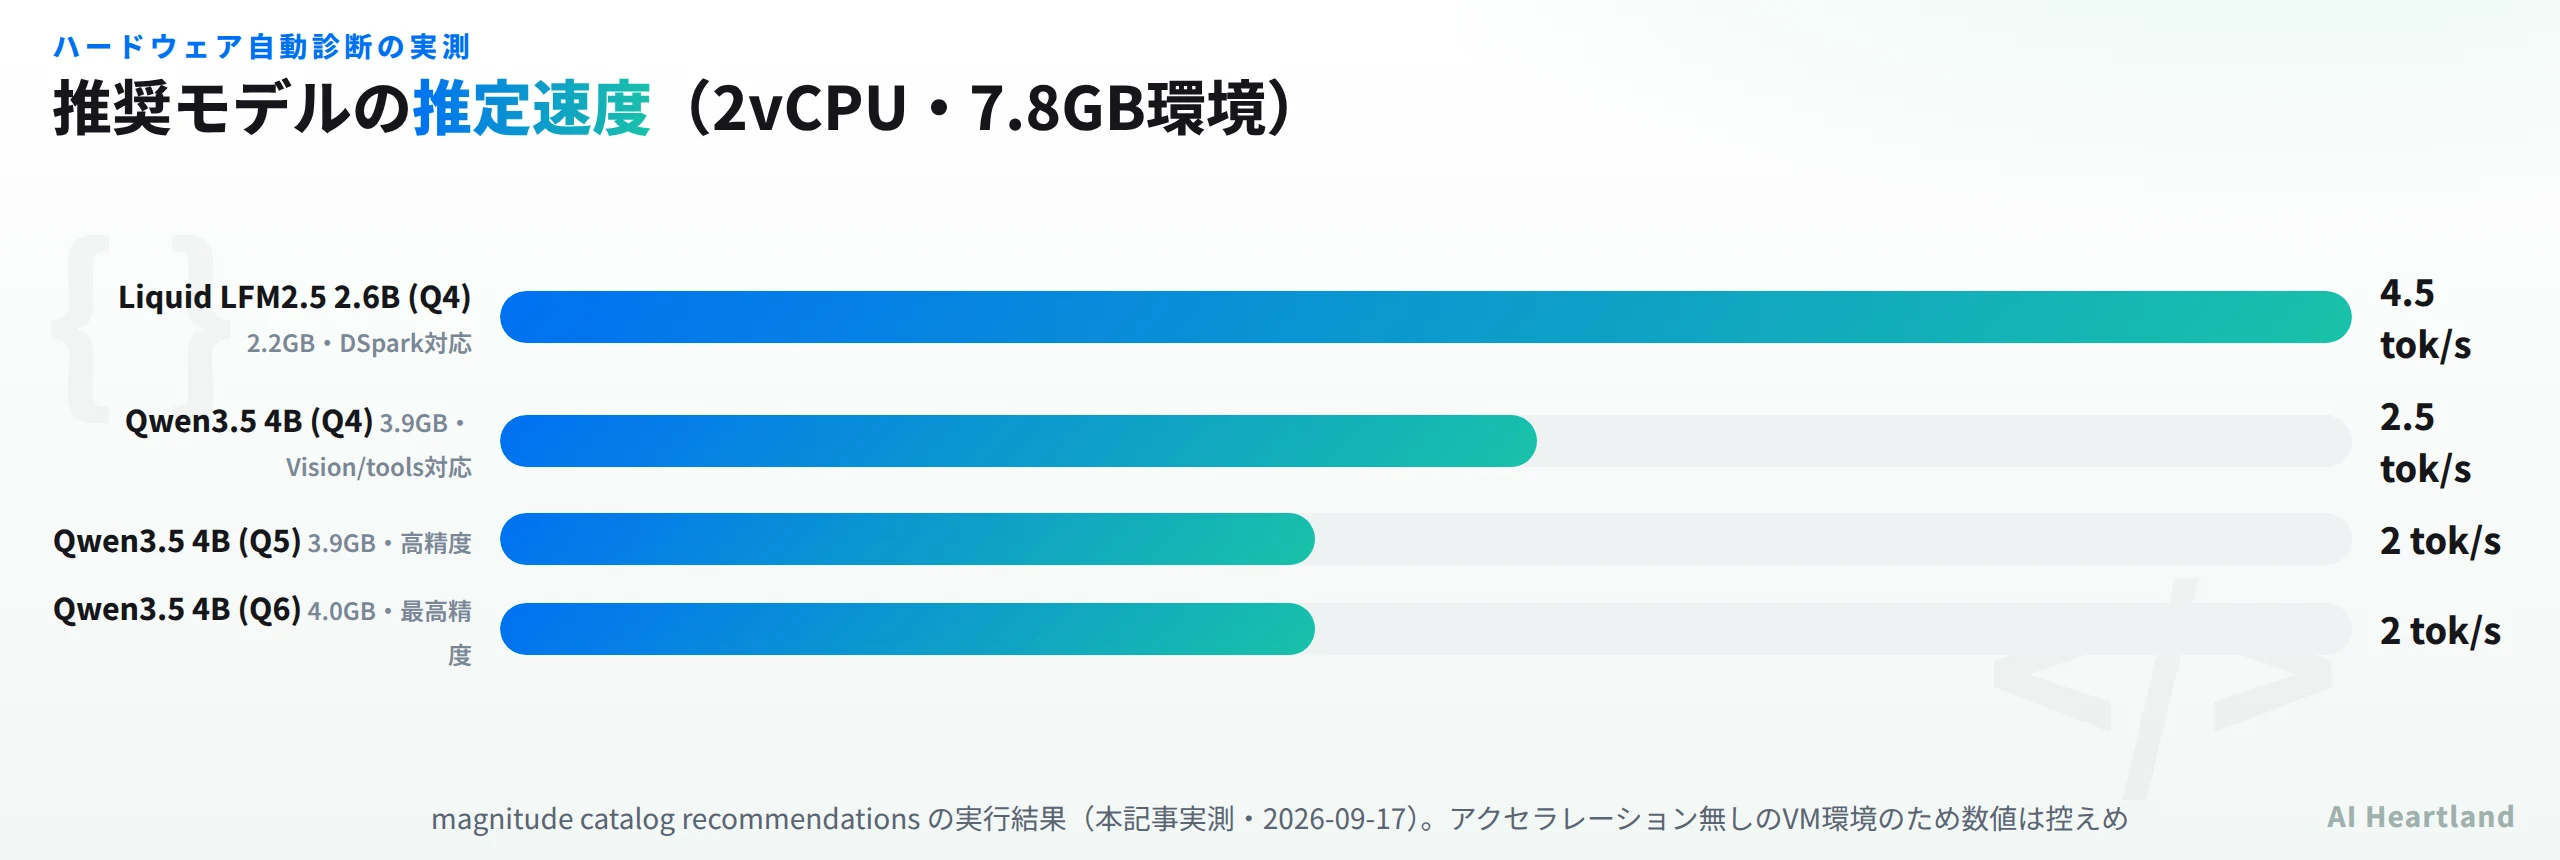
magnitude catalog recommendationsを実行した結果。上位候補はLiquid LFM2.5 2.6B(Q4)とQwen3.5 4B(各量子化)だった。| モデル | 推定速度 | メモリ | コンテキスト | 対応機能 |
|---|---|---|---|---|
| Liquid LFM2.5 2.6B (Q4) | 約4-5 tok/s | 2.2GB | 64K | tools・structured output・reasoning |
| Qwen3.5 4B (Q4) | 約2-3 tok/s | 3.9GB | 64K | Vision・tools・structured output・reasoning |
| Qwen3.5 4B (Q5) | 約2 tok/s | 3.9GB | 64K | 同上(高精度) |
| Qwen3.5 4B (Q6) | 約2 tok/s | 4.0GB | 64K | 同上(最高精度) |
出力には「Assessing 54 additional catalog models; recommendations may change.(他54モデルを評価中。推薦は変わる可能性がある)」という注記もあった。カタログは静的なリストではなく、ハードウェアに対する適合度を継続的に評価している設計であることがうかがえる。なお、このtok/s見積もりはアクセラレーションの無いVM環境での参考値であり、GPU等が使える実機ではより高速になる可能性が高い。
対応モデルカタログの全体像——12モデルが候補に
recommendationsが見せるのは上位4件だけだが、全体像はmagnitude catalog listで見える。この検証環境(2 vCPU・7.8GB)では、次の12モデルが「動作可能」と判定された。
| モデル | メモリ | 速度目安 | アクセラレーション | Model ID |
|---|---|---|---|---|
| Gemma 4 E2B (Q4 QAT) | 4.7GB | 約4-5 tok/s | None | gemma-4-e2b-it-qat:gguf:q4 |
| Gemma 4 E4B (Q4 QAT) | 4.6GB | 約2-3 tok/s | None | gemma-4-e4b-it-qat:gguf:q4 |
| Liquid LFM2.5 2.6B (Q4〜Q8) | 2.2〜2.3GB | 約3-5 tok/s | DSpark | lfm2.5-2.6b:gguf:* |
| Liquid LFM2.5 8B-A1B (Q4) | 2.8GB | 約5-6 tok/s | DSpark | lfm2.5-8b-a1b:gguf:q4 |
| Qwen3.5 4B (Q4〜Q8) | 3.9〜4.6GB | 約2-3 tok/s | None | qwen3.5-4b:gguf:* |
| Qwen3.5 9B (Q4) | 4.2GB | 約1-2 tok/s | None | qwen3.5-9b:gguf:q4 |
個別モデルの詳細はmagnitude catalog show <model-id>で見られる。Qwen3.5 4B(Q4)を例に叩くと、次のような情報が返ってきた。
Qwen3.5 4B (Q4)
Compact dense model for machines where responsiveness and footprint matter most.
  Model ID      qwen3.5-4b:gguf:q4
  Released      March 2026
  Architecture  Dense - 4B
  Context       64K
  Capabilities  Vision, tools, structured output, reasoning

Distribution
  Download size  3.67 GB
  License        apache-2.0
  Source         https://huggingface.co/unsloth/Qwen3.5-4B-MTP-GGUF
配布元はHugging Faceで、モデル個別のライセンス(この例ではapache-2.0)も明示される。Magnitude本体のライセンス(Apache-2.0)と、カタログ経由で配布される個々のモデルのライセンスは別物であり、モデルごとにcatalog showで確認するのが確実だ。なお本記事ではcatalog pullによるモデル本体のダウンロードは行っておらず、magnitude models statusを実行するとNo local models are on this computer.(ローカルにモデルは無い)と返ってきた。ハードウェア診断・推薦・カタログ照会までを実測し、実際の推論実行(トークン生成)そのものは未検証の範囲として明記しておく。
① 何ができる:ハードウェアを自動診断し、動作可能なモデルを速度・メモリ・対応機能付きでランキング表示する。② 何を解決する:「自分のマシンでどのモデルが現実的に動くか」を手作業で調べる手間。③ 何を代替する:Ollama・LM Studioで人間が行っていた「モデルを見繕う」工程を、エージェント/CLI側の自動処理に置き換える。
コーディングエージェントへの接続——対応ハーネス一覧を実測
Magnitudeの核心は、推薦したモデルをコーディングエージェントへ実際に配線する部分にある。対応ハーネスの一覧は次のコマンドで確認できる。
magnitude connections list
実行結果は次の通り。
HARNESS            ID           STATUS
Magnitude Harness  magnitude    Built in
Claude Code        claude-code  Available
Pi                 pi           Not installed
OpenCode           opencode     Not installed
Hermes             hermes       Not installed
OpenClaw           openclaw     Not installed
Codex              codex        Not installed
Oh My Pi           oh-my-pi     Not installed
Cline              cline        Not installed
Claude CodeがAvailable(接続可能)と表示され、他のハーネスは検証環境に該当のCLIが入っていないためNot installed扱いになっている。接続自体はmagnitude connections add <harness>で行う設計(--helpでコマンド仕様を確認済み)だが、本記事の検証環境にはClaude Code本体を含む各ハーネスのCLIを別途セットアップしていないため、実際の接続確立(モデルがハーネス経由で応答するところ)までは今回検証していない。未検証の部分は未検証と明記する——ここは「配線コマンドが存在し、Claude Codeが認識される」ところまでの確認に留まる。
127.0.0.1:10100"] SVC --> HW["ハードウェア自動診断
CPU・メモリ・アクセラレーション"] HW --> CATALOG["catalog recommendations
tok/s見積もり付きモデル推薦"] CATALOG --> PULL["catalog pull <model-id>"] PULL --> CONN["connections add <harness>"] CONN --> CC["Claude Code"] CONN --> OTHER["Codex / Cline / OpenCode 等"]
想定される使い方は、①catalog recommendationsで候補を見る→②catalog pullでモデルを取得→③connections addで目的のハーネスへ配線、という流れになる。人間が「どのモデルを使うか」を選ぶ判断はCLIの推薦が肩代わりし、最後の配線もコマンド1つで終わる設計だ。
どんな開発者に向くか
connections listの一覧が示す通り、Magnitudeは特定の1エージェントではなく複数のハーネスを横断して対応する方向に設計されている。この設計から素直に導ける利用シーンは次のようなものだ。
・複数のコーディングエージェントCLI(Claude Code・Codex・Cline等)を併用していて、いずれもオフラインの推論バックエンドに一時的に切り替えたい開発者
・コードやプロンプトを外部のクラウドAPIへ送りたくない、あるいはネットワークが不安定な環境で作業したい開発者
・「このマシンでどのモデルが現実的に動くか」を毎回自分で調べるのが面倒で、推薦をそのまま使いたい開発者
逆に、成熟した安定運用や特定モデルへの深い最適化(例えばApple SiliconのMLX専用チューニング)を求める場合は、後述の比較表にある通りOllamaや専用ランタイムの方が分がある。
MagnitudeとOllama・LM Studioとの違い——「人間向け」か「エージェント向け」か
「結局Ollamaでいいのでは」という疑問に答える。当サイトにはOllamaとllama.cppの違い2026|ローカルLLMはどちらで動かすべきか徹底比較やLM Studioとは|使い方・MCP連携・Ollamaとの違いまでローカルLLMをGUIで動かす完全ガイドがあるが、いずれも主題は「人間が使うGUI/CLIとしてのローカルLLM実行環境」だ。Magnitudeはこの2本と重ならない。軸は「コーディングエージェントの裏側で自動運用される推論サーバー」という利用文脈の違いにある。
| 観点 | Magnitude | Ollama | LM Studio |
|---|---|---|---|
| 想定利用者 | AIコーディングエージェント | 人間(CLI操作) | 人間(GUIチャット) |
| ハードウェア診断 | 自動(magnitude hardware) |
手動でモデル選択 | 手動でモデル選択 |
| モデル推薦 | tok/s見積もり付きで自動ランキング | 無し(自分で調べる) | 無し(自分で調べる) |
| エージェント自動接続 | ○(connections addで複数ハーネス対応) |
×(変換プロキシが必要) | △(MCP連携はあるが自動診断・自動接続は無し) |
| ライセンス | Apache-2.0(本記事で実測確認) | MIT(当サイト既存記事の記述を踏襲・本記事では再確認せず) | プロプライエタリ(同上) |
| 成熟度 | pre-1.0(0.x系)。npm非推奨表記あり(本記事で確認) | 安定・巨大コミュニティ | 安定 |
この表から読み取れるのは、Magnitudeの独自性が「モデル選定と接続の自動化」に集中している点だ。人間向けチャットUIという意味ではOllama・LM Studioの方が使いやすく、成熟度・コミュニティ規模でも両者に分がある。一方で「エージェントに任せて、ハードウェアに合うモデルを自動で選ばせ、そのまま配線したい」というピンポイントな用途では、Magnitudeが唯一この設計に振り切っている。
注意点——pre-1.0特有の変化とnpm非推奨表記
採用前に押さえておくべき事実を、誇張せずに並べる。
本記事の実機検証(2026-09-17)で
npm i -g @magnitudedev/cliを実行したところ、npmがdeprecated(非推奨)警告を表示した。文面は「MAGNITUDE HAS MOVED TO A FREE, OPEN SOURCE DESKTOP APP(Magnitudeは無料のオープンソース・デスクトップアプリへ移行した)」「THIS LEGACY CLI WILL NO LONGER RECEIVE UPDATES(このレガシーCLIは今後アップデートされない)」というもの。npm viewで確認すると、このバージョン0.0.15は検証のわずか9時間前に公開されていた。CLI自体は0.0.15として現に動作し、本記事の各コマンドも問題なく実行できたが、公式が「レガシー」と位置づけている以上、今後の更新が止まる可能性がある。デスクトップアプリ(https://magnitude.dev/download)への移行案内が出ていることは、採用検討時に必ず踏まえるべき最新事実である。
・バージョン表記のズレ:GitHub最新タグは@magnitudedev/[email protected](2026-09-05)だったが、npmのlatestは同時点で0.0.11、そして検証当日(2026-09-17)には0.0.15まで進んでいた。npm view @magnitudedev/cliで確認したdist-tagsはlatest: 0.0.15・alpha: 0.0.15-alpha.1で、公開者はanerli(メールアドレスから個人アカウントとみられる)、公開時刻は検証の9時間前。GitHubのリリースタグとnpm公開版のどちらが「現在の安定版」かは断定できない状態が続いている
・バス係数:contributor実測6名・commit実測618。少人数集中型で、618コミットが具体的に何名にどう分布しているかは本記事では未確認
・Windows非対応:ネイティブ対応は無く、WSL経由のみ(README明記)
・「無料」の範囲:Magnitude自体はトークン課金・APIキー・レート制限が無いが、接続先のClaude Code等のハーネス側の料金体系とは無関係。この2つを混同しない
・企業サポート:商用版・マネージドクラウドの案内はREADME上に見当たらない(無いと断定はしないが、確認できた範囲では無し)
Magnitudeは、Ollama・LM Studioのような「人間向けローカルLLM実行環境」とは別軸で、コーディングエージェント専用の推論サーバーという一点に振り切ったOSSだ。ハードウェア自動診断・tok/s付きモデル推薦・複数ハーネスへの自動接続は、実機検証でいずれも実際に動作した。ただしpre-1.0で変化が速く、検証当日にnpmパッケージが非推奨マーク付きで公開され、公式がデスクトップアプリへの移行を案内し始めたばかりという、まさに過渡期のプロジェクトである。「エージェントの裏方インフラ」という着眼点自体は明快だが、採用は今後の配布形態の行方を見ながら判断したい。
参照ソース
・magnitudedev/magnitude(公式リポジトリ・README) — 概要・インストール手順・ライセンス・対応ハーネスの一次情報
・@magnitudedev/cli(npm) — 配布パッケージ名・バージョン・非推奨(deprecated)表記を確認
・Magnitude公式ドキュメント — セットアップ手順の一次情報