「どのモデルがAGIか選ばせてみた。20〜200倍速く、40〜400倍安い」——X上でそんな投稿が回り、Jevという聞き慣れない名前が2026年9月の開発者タイムラインを埋めた。だが投稿のスクリーンショットをよく見ると、そこに映っているのは会話ではない。"type": "choice"、"criteria"、そして69%という確率。Jevは文章を1文字も生成しないAIモデルだ。本記事では、公称値をなぞる代わりに、TypeSafe AIがMITで公開した公式SDKと、Claude Codeを自動ルーティングするOSS jev-router のソースコードを手元に落として読み、設計として何が保証されていて、何がまだ誰も検証していないのかを切り分ける。
- ・正体:米TypeSafe AIのSystem Oneモデル第1弾。テキストを生成せず、型つきの判定と確率だけを1往復で返す。
- ・何ができる:分類・ルーティング・スコアリング・再ランキング・LLM-as-a-judgeのような「答えが既知の判断」を高頻度で回す。
- ・何を代替する:LLMの構造化出力(JSONモード)に投げていた判定処理。チャット・要約・コード生成は代替しない。
- ・実測できたこと:公式SDK(MIT・v0.6.0)は依存0で、質問は
choice/noul/scoreの3種類だけ。既定モデルIDはjev-latest、宛先はPOST /v1/systemone。 - ・未検証:検証環境から
api.typesafe.aiへ接続できず(403・181ms)、速度・精度・課金は一切確かめていない。公称値は公称値として扱う。
LLMそのものの仕組みや主要モデルの比較を先に押さえたい場合は、LLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版を読んでから戻ってくると、Jevが「何を捨てたモデルなのか」がはっきりする。
Jevとは何か——「文章を返さない」ことが設計の中心にある
TypeSafe AIはサンフランシスコ拠点のスタートアップで、2026年9月15日にステルスを解除し、DCVCがリードする約4,000万ドルの調達とともにJevを公開した。創業者はOpenAIでRLHFとChatGPTに携わったDiogo Almeida、Erik Gafni、Sasha Shengの3名とされる。学習手法はRLCD(Reinforcement Learning for Calibrated Decisions)と呼ばれ、「正しく当てる」だけでなく「確信度を正しく申告する」ことを目標に置いた設計だと説明されている。
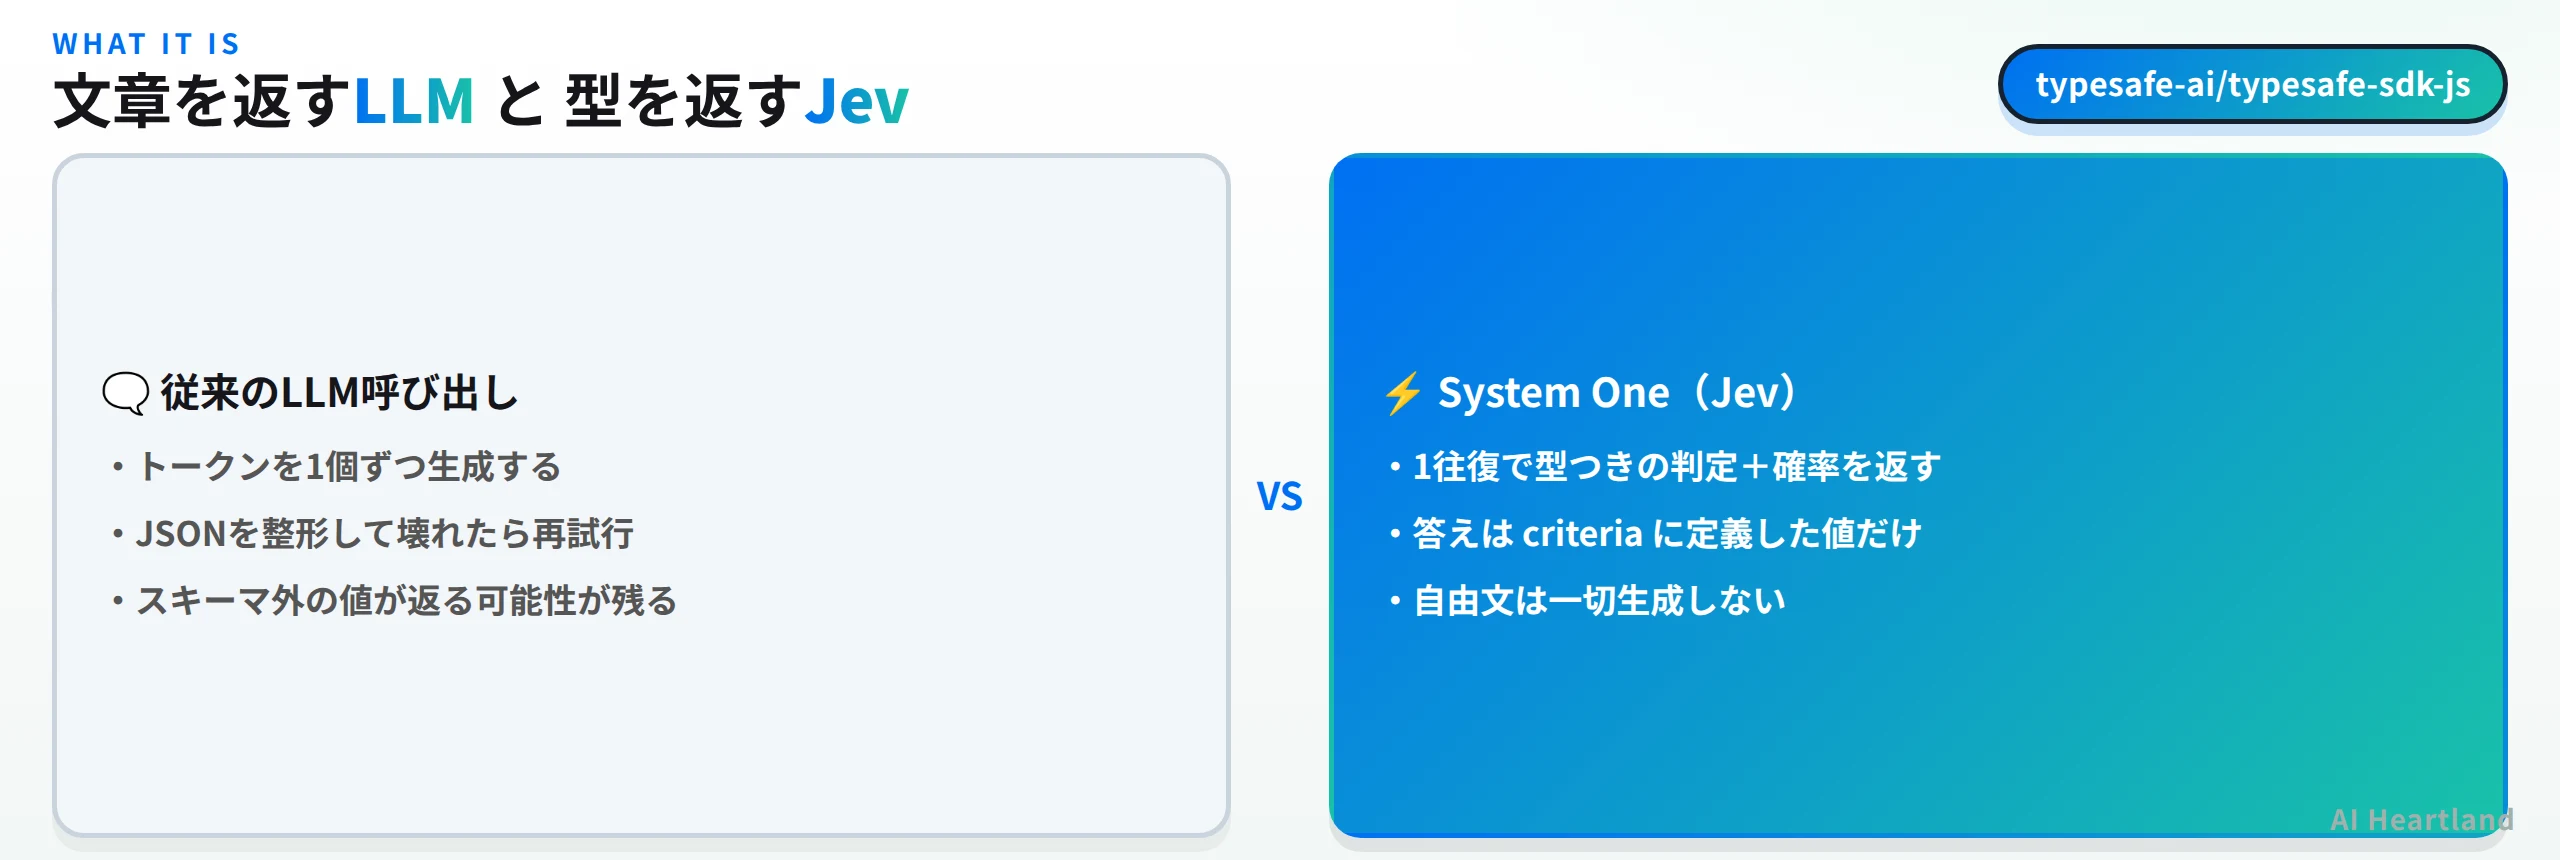
際立つのは製品の輪郭のほうだ。Jevはチャットができない。 要約もコード生成も翻訳もしない。できるのは、渡された状態(state)に対して、あらかじめ型を決めた質問に答えることだけである。
この割り切りが何を生むかは、LLMの構造化出力と並べると分かりやすい。
| 観点 | LLMの構造化出力(JSONモード等) | Jev(System Oneモデル) |
|---|---|---|
| 出力の作り方 | トークンを1個ずつ生成してJSONへ整形 | 生成せず、定義済みの値から選ぶ |
| スキーマ違反 | プロンプト・文法制約で減らすが原理的には起こりうる | criteriaに無い値は返せない(構造上) |
| 確信度 | logprobs等から推定、モデル依存 | 確率が一次情報として返る |
| 出力トークン課金 | 生成量に比例 | 公称で0ドル |
| 得意な仕事 | 生成・要約・対話・コード | 分類・ルーティング・採点・判定 |
| 苦手な仕事 | 高頻度・低遅延の単純判定 | 自由文が必要な仕事すべて |
「型を外せない」というのは、プロンプトの工夫ではなく出力の作り方そのものから来る性質だ。ここがJevの主張の中心であり、同時に後述する公称値の話とは切り離して評価すべき部分でもある。設計上の保証と、ベンダーが測った速度は別物である。
質問の型は Choice・Noul・Score の3つだけ——公式SDKのコードで確認する
TypeSafeはモデル本体こそ非公開だが、SDKはGitHubでMIT公開している。typesafe-ai/typesafe-sdk-js を実際にcloneし、npmからもインストールして中身を確かめた。
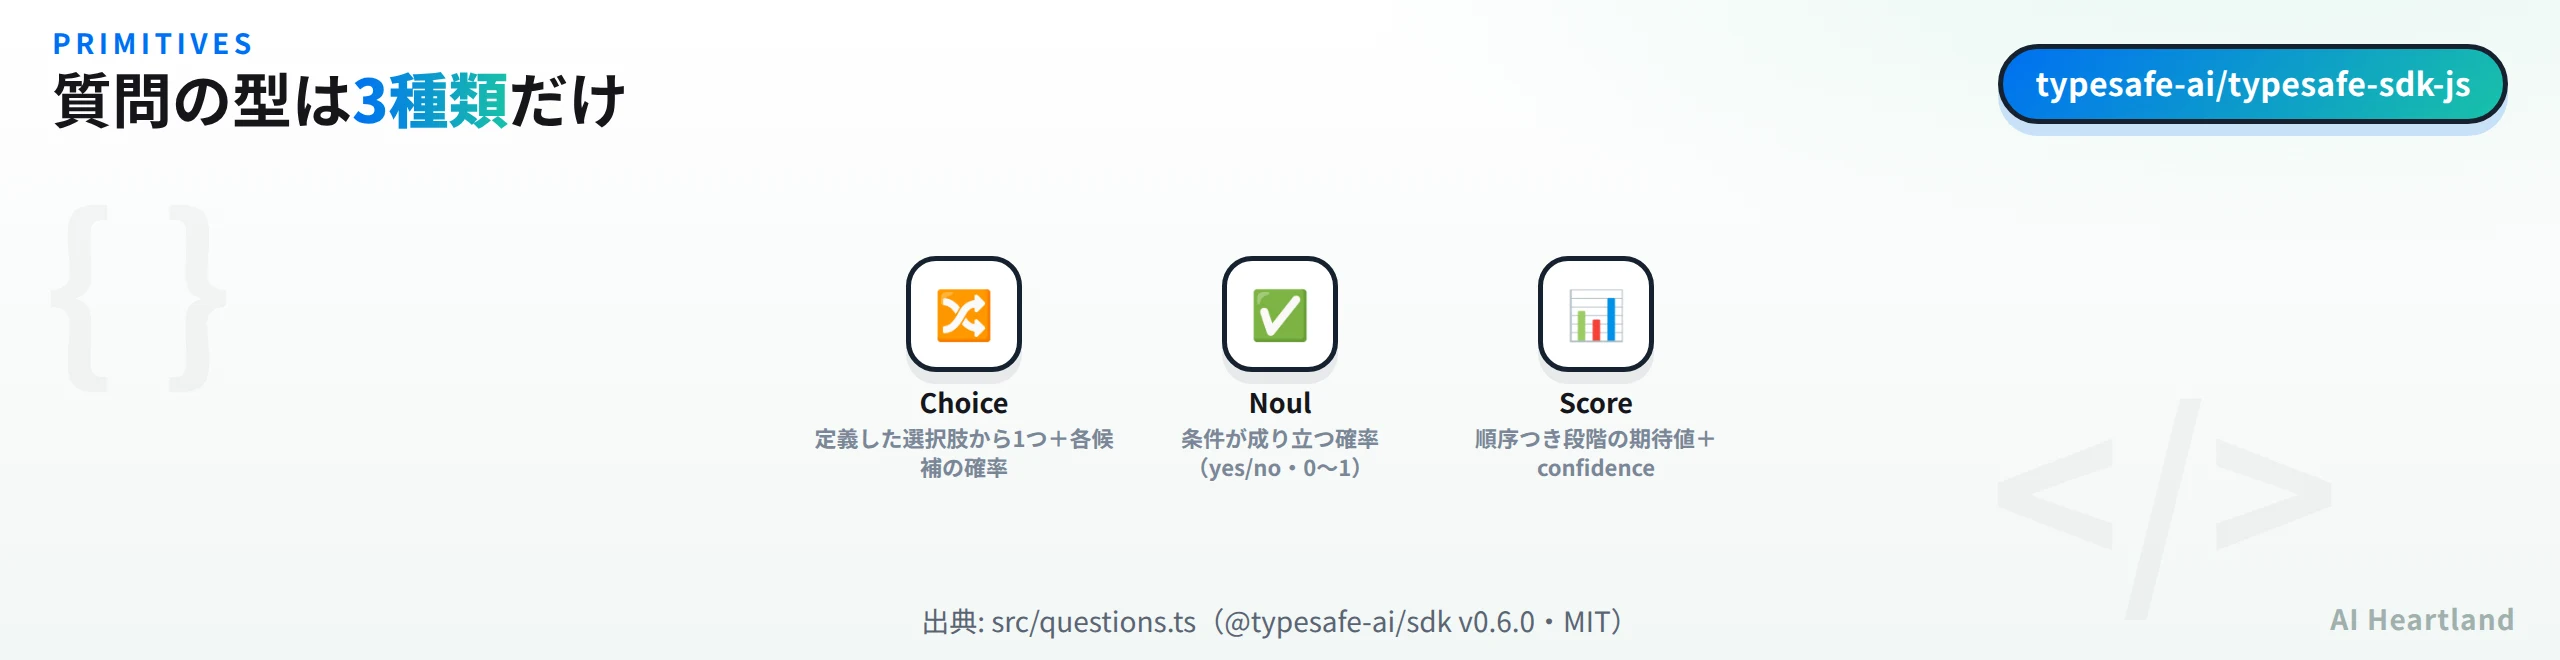
src/questions.ts が定義しているのは、次の3つの関数だけだった。
・Choice:定義した選択肢から1つを選ぶ。選ばれたラベルに加えて、全候補の確率分布が返る
・Noul:条件が成り立つかどうか。0〜1の確率そのものが答えで、別枠のconfidenceは持たない
・Score:順序つきのルーブリック(例:["can wait", "this week", "today", "right now"])上の期待値。confidenceとlegendが付随する
公式スキルリポジトリ typesafe-ai/skills の SKILL.md は、この3つの使い分けを「答えが意味するもので選べ」と明示している。複数のラベルが同時に成り立ちうるならNoulを1つずつ、競合する候補から1つ選ぶならChoice、程度を測るならScore、という整理だ。質問IDはコード側の都合であってモデルには送られない、という注意書きもあり、意味はすべてinstructionsとcriteriaに書き切るのが設計思想になっている。
実際にnpmから入れて、質問オブジェクトが何になるかを確認した。
# 2026-09-18 に実行して確認
npm install @typesafe-ai/sdk
# => added 1 package(依存ゼロ)

node -e "const s=require('@typesafe-ai/sdk');
  console.log(Object.keys(s).length, 'exports');
  console.log(JSON.stringify(s.score('How urgent?',['low','high'])));
  console.log(JSON.stringify(s.noul('Is it billing?')));"
# => 19 exports
# => {"type":"score","instructions":"How urgent?","criteria":["low","high"]}
# => {"type":"noul","instructions":"Is it billing?"}
質問は単なるJSONオブジェクトで、SDK側に隠れた変換は無い。パッケージは依存0(added 1 package)、バージョンは0.6.0、npmの公開日時は2026-09-15T18:17:19Zと、発表当日に出ている。
宛先もsrc/client.tsにそのまま書かれていた。既定のベースURLはhttps://api.typesafe.ai、既定モデルIDはjev-latest、エンドポイントはPOST /v1/systemone。応答側の型(src/types.ts)にはprobabilities、confidence、legend、そしてusage.input_tokens / usage.output_tokensが並ぶ。出力トークンのフィールド自体は存在する——価格が0というだけだ。
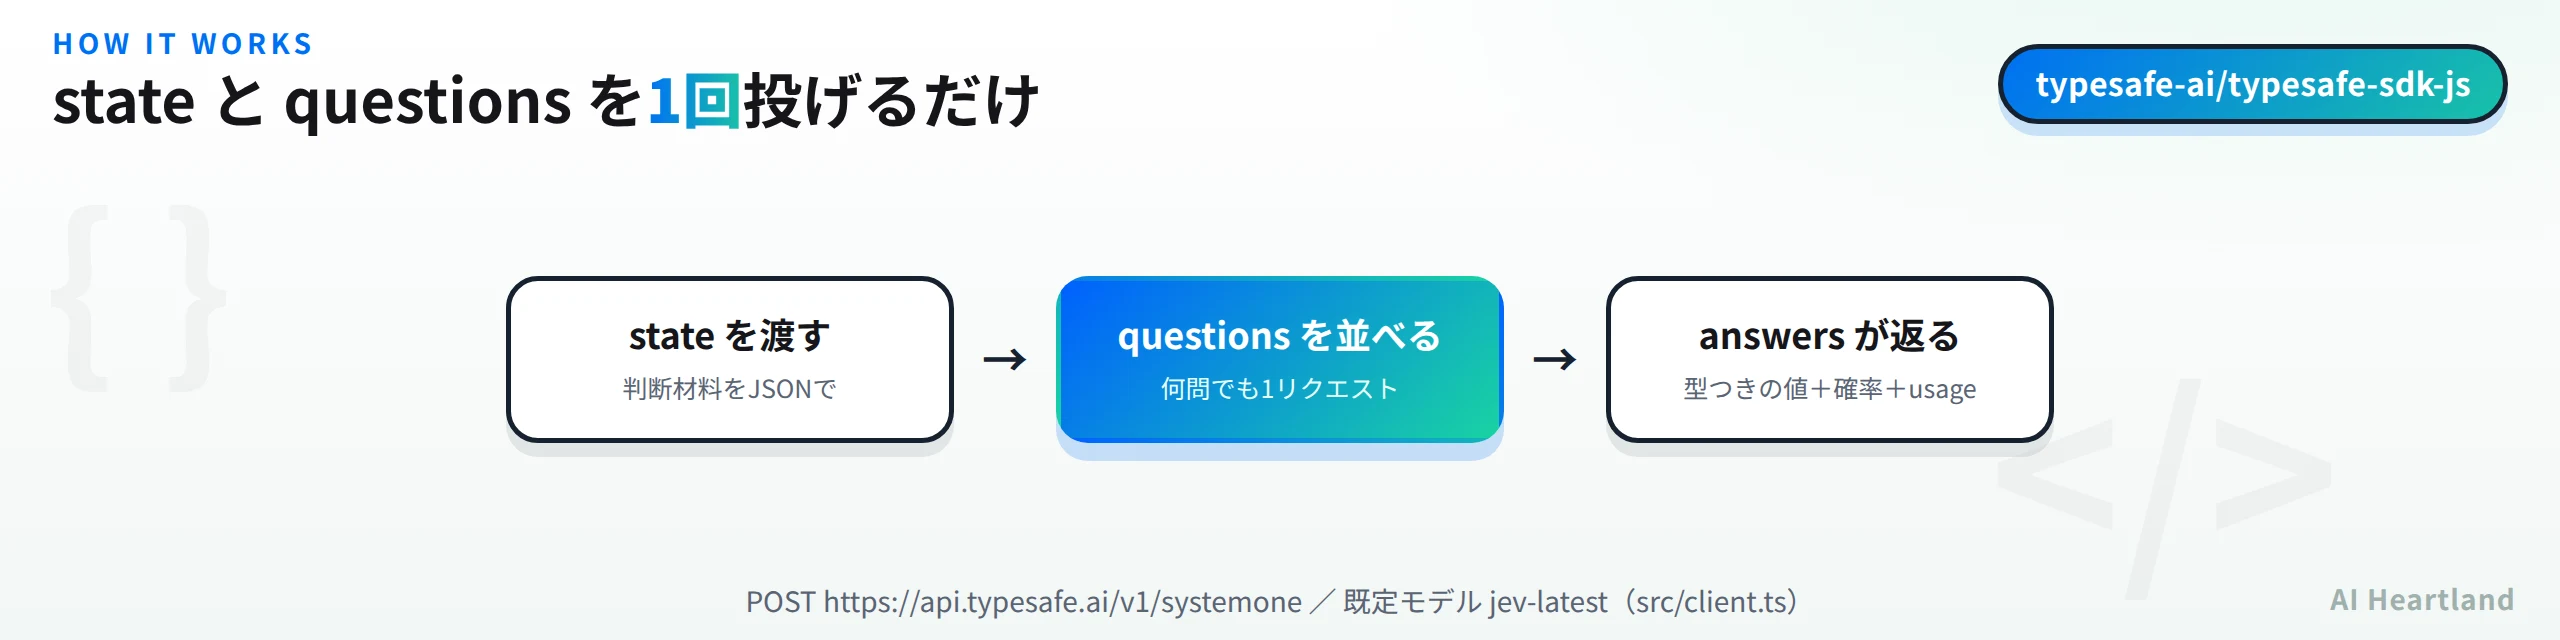
公式のexamples/demo.tsは、1件のサポートチケットに対して「請求の話か(Noul)」「顧客の語調は(Choice)」「緊急度は(Score)」「返金要求の可能性は(Score)」の4問を1リクエストで投げている。ここがトークナイザ単位の最適化とは別種の効きどころで、gigatoken解説|トークナイザーをGB/sで回す1000倍高速化の中身と再現条件のような前処理側の高速化とは、削っている場所が違う。
なお、この検証環境からAPI本体には到達できなかった。ダミーキーで実際に叩くと、181msでPermissionDeniedError: 403 Host not in allowlist: api.typesafe.aiが返る。ネットワーク側の制限であり、Jevの応答ではない。したがって本記事に出てくる速度・精度・課金の数値はすべて他者の計測であり、当サイトでは確かめていない。
「193.6倍速い・444.6倍安い」は、何と何を比べた数字なのか
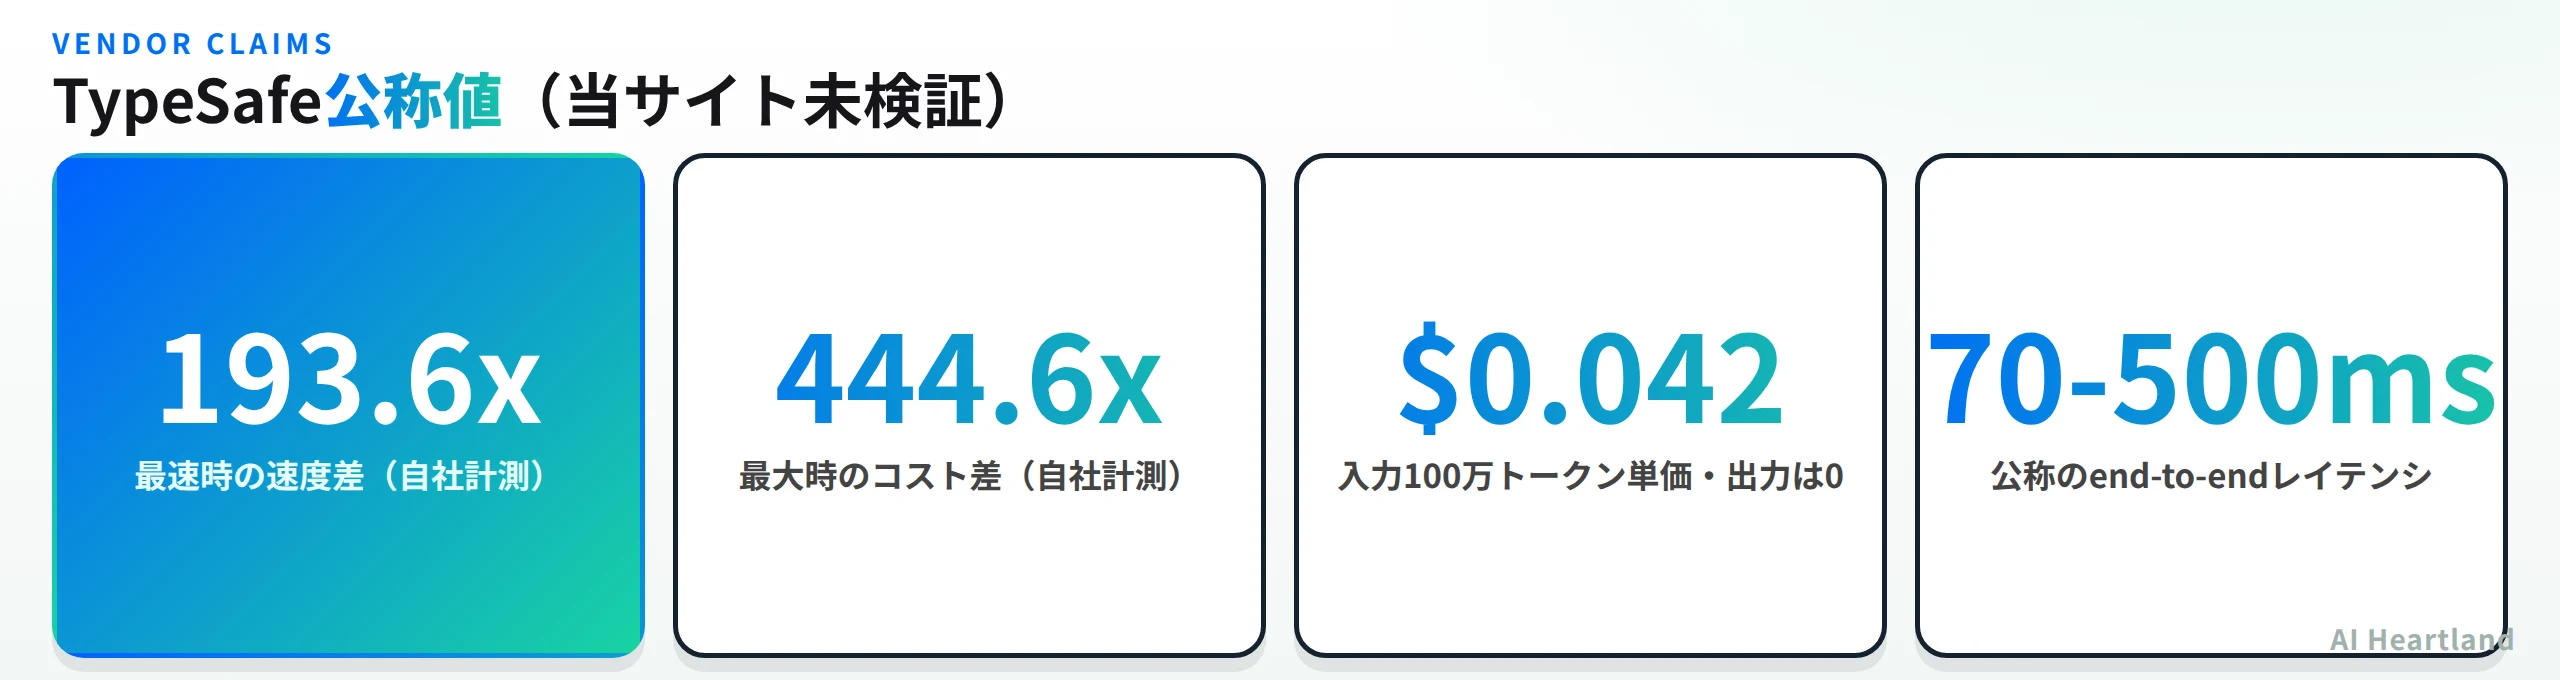
発表で前面に出ている数字を整理すると、次のようになる。左の数字が独り歩きしやすいので、右の「何と比べたか」とセットで見てほしい。
| 公称値 | 比較の中身 | 注意点 |
|---|---|---|
| 40〜200倍速い(最速193.6倍) | 同等タスクでのフロンティアLLMとの比較 | LLM側が思考の連鎖を生成する条件を含む |
| 40〜400倍安い(最大444.6倍) | 同上、1判定あたりのコスト | 入力トークン量はstate次第で変動する |
| 入力100万トークン0.042ドル・出力0ドル | 公称の価格表 | 出力を持たない設計なので0は必然 |
| end-to-end 70〜500ミリ秒 | チャット構成の3〜329秒との対比 | 329秒側が何をしているかで印象が変わる |
| 1判定あたり約0.0004ドル | 上記単価からの算出 | 質問数ではなくstateの長さで効く |
ここで立ち止まる価値があるのは、70ミリ秒と329秒を並べた比較だ。この2つは同じ作業をしていない。片方は選択肢から1つ選ぶ処理で、もう片方は推論過程を含む文章をまるごと生成する処理である。倍率が大きいのは当然で、倍率の大きさ自体はJevの優秀さを測る物差しになりにくい。TypeSafeが速いのは事実として設計から予想できるが、「何倍」の部分はベースラインの取り方で自在に動く。
精度のほうはもっと踏み込んだ確認が要る。同社が公開した4ワークフローのベンチマークでは、Jevは全体67.8%で、GPT-5.6 Terraの67.9%とほぼ横並び、GPT-5.6 Solの74.1%やOpus 5の73.1%には数ポイント届かない。
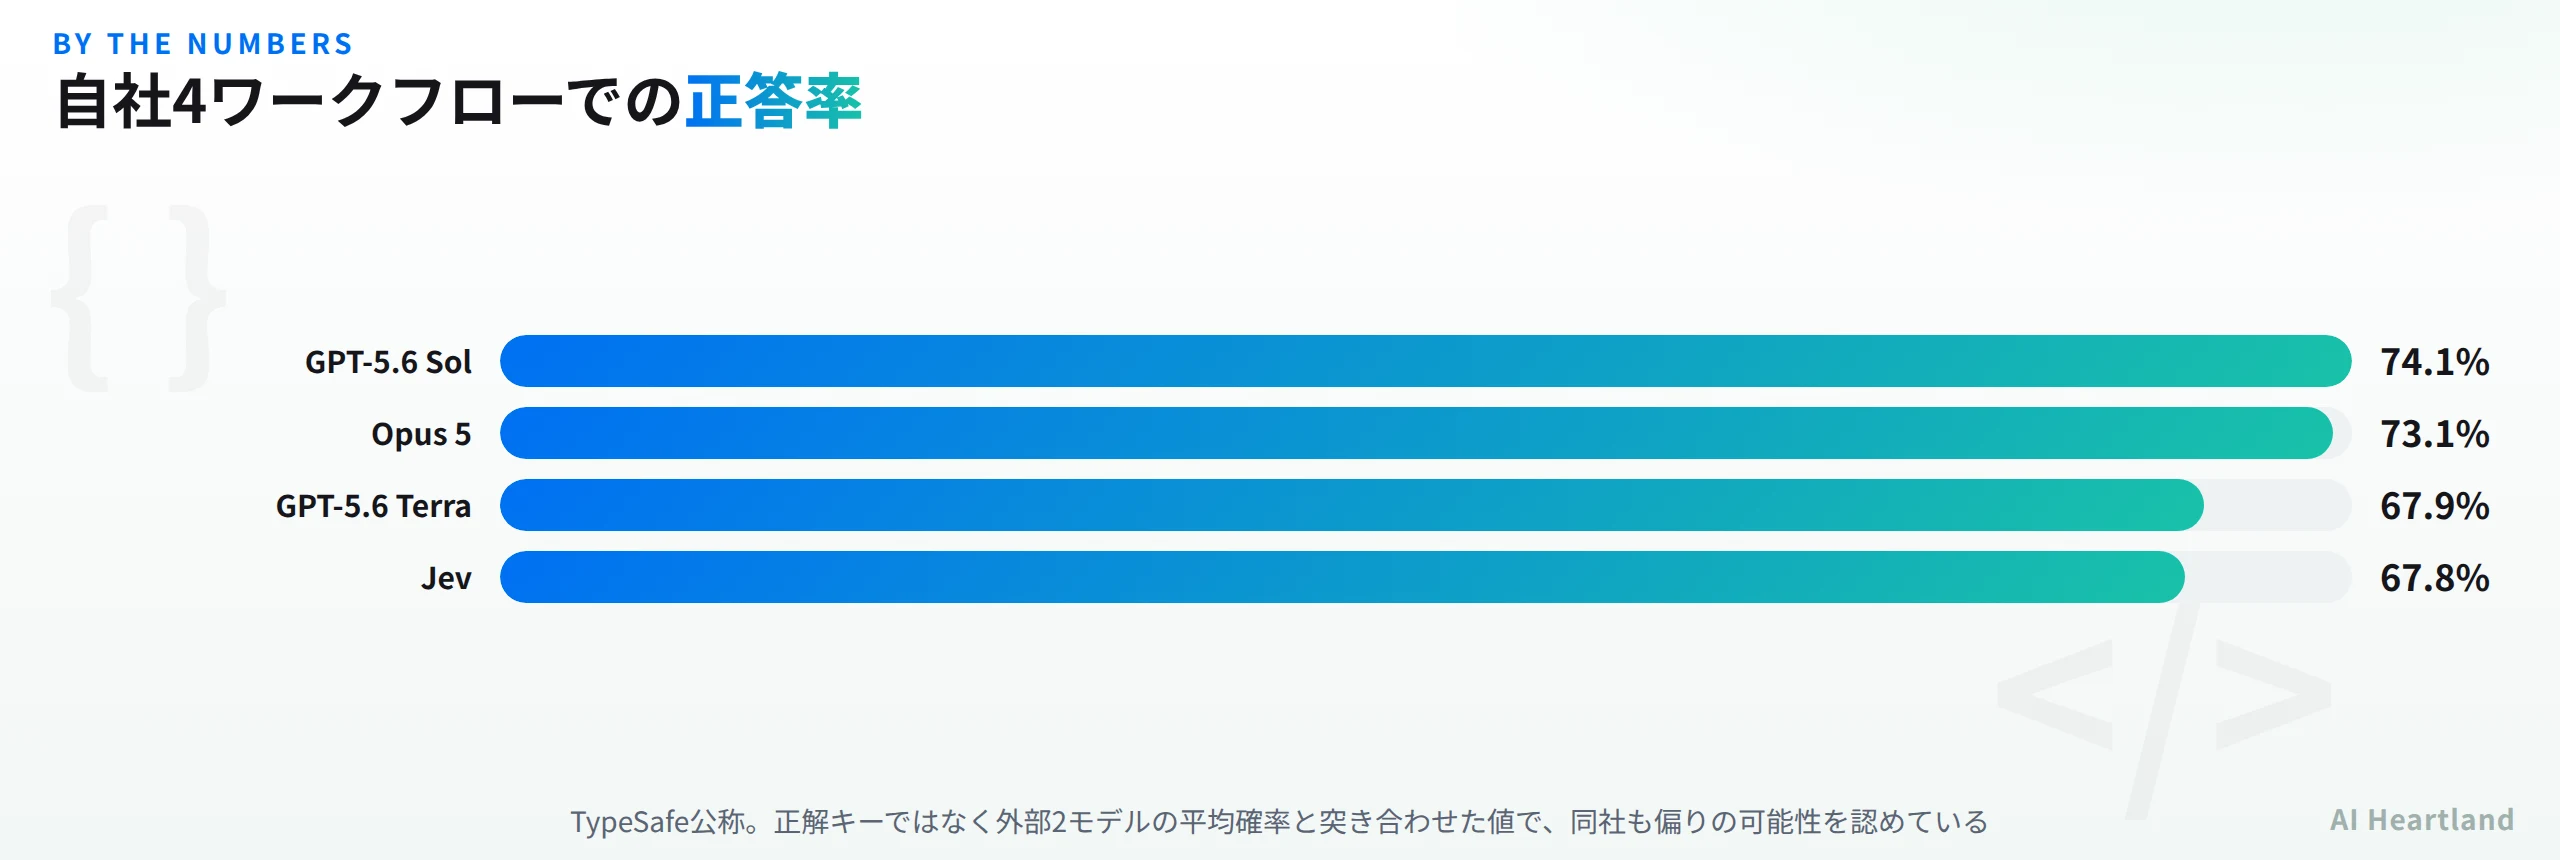
内訳では、セキュリティインシデント判定が61.7%(Opus 5は66.2%)、エージェントのトレース観測が71.6%(同76.6%)、請求書処理が61.8%(同79.1%)、カスタマーサービスが76.0%(同78.3%)と報告されている。請求書処理の差が最も大きい。
さらに重要なのは評価の作り方だ。この4ワークフローは同社のモデル能力チームが作成したもので、TypeSafe自身が偏りの可能性を認めており、報告した差は現実の上限側に寄るだろうと述べている。そして採点は客観的な正解キーに対してではなく、外部の大規模モデル2つが返した確率の平均に対して行われている。つまり「大きいモデルの平均的な判断にどれだけ近いか」を測った数字であって、業務上の正解にどれだけ近いかではない。
まとめると、設計として保証されるもの(型を外せない・確率が一次情報で返る)と、ベンダーが測った数字(速度・コスト・精度)は評価の仕方を分けるべきだ。前者はコードを読めば確認できるが、後者は自分のデータで測るまで分からない。安く速い小型モデルという論点自体はGemini 3.1 Flash-Lite発表 — 高速・低価格で$0.25/Mトークンの頃から続いており、Jevはその延長ではなく「生成をやめる」という別の方向に振った点が新しい。
Claude Codeで実際に使う——jev-router が裏でやっていること
Jev本体はウェイトリスト方式のアーリーアクセスだが、手元のコーディングCLIに組み込むOSSはすでに出ている。gargpratyush/jev-router(MIT)は、Claude CodeとOpenAI Codexのモデル選択を、ターンごとにJevへ委ねるルーターだ。X上で「Jev Auto」のスクリーンショットが出回っていたのはこれである。
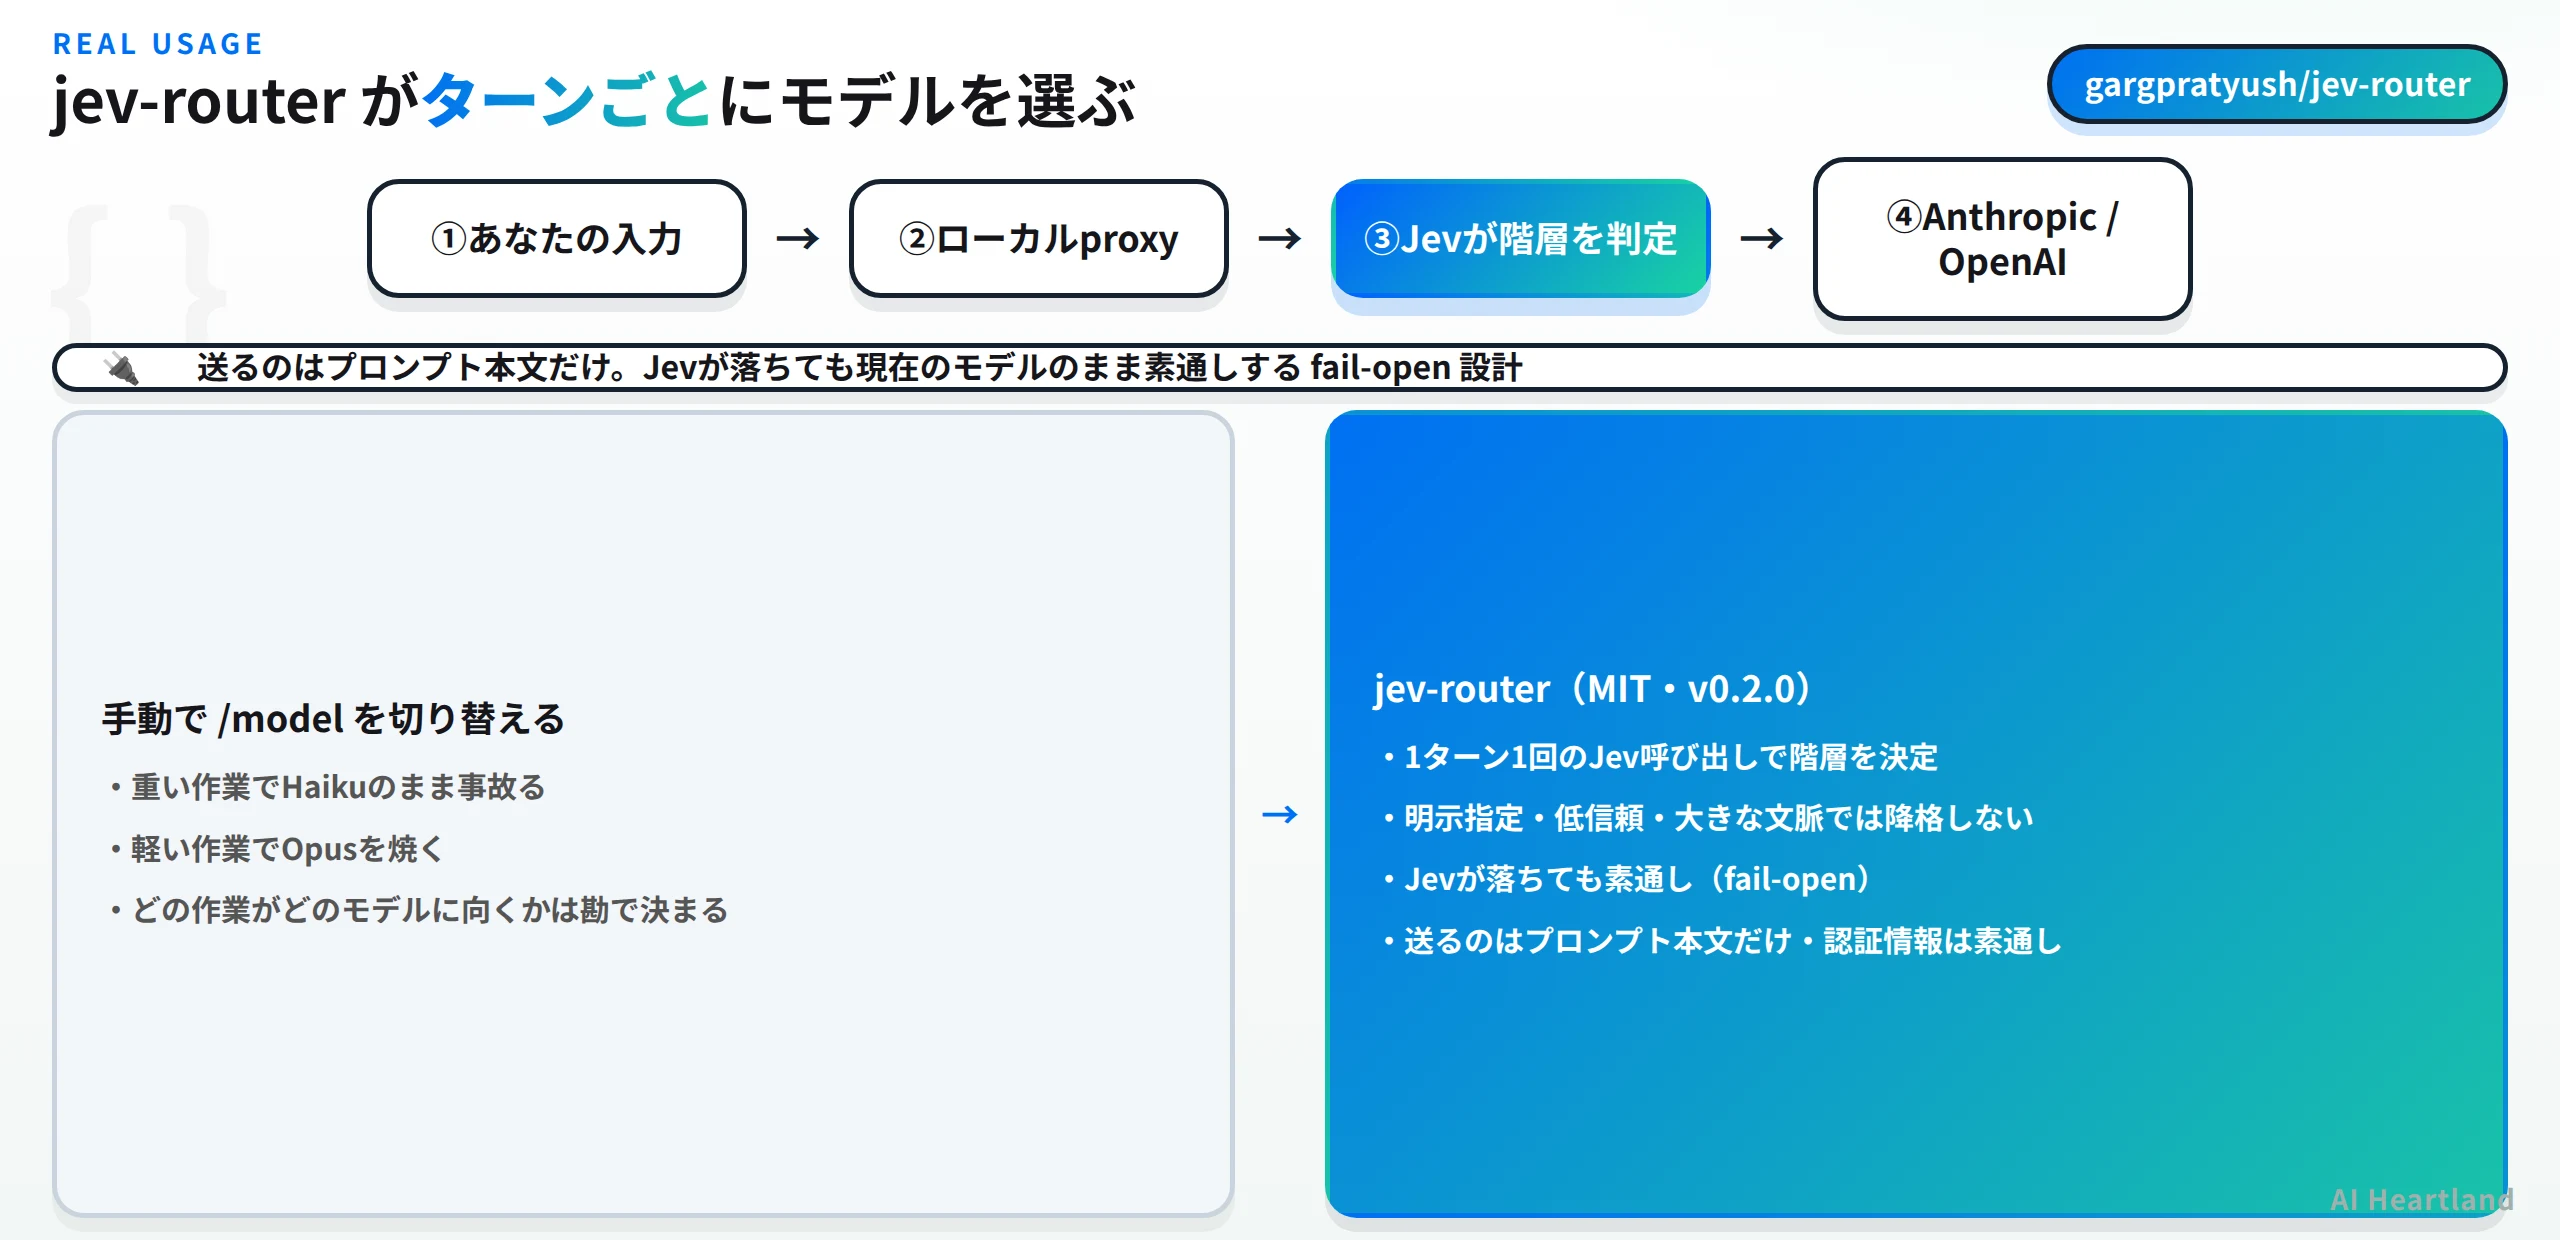
仕組みは素直だ。jev-claudeコマンドがローカルにプロキシを立て、本物のCLIをANTHROPIC_BASE_URL付きで起動する。CLIが送ってきた認証ヘッダは読まず・保存せず・変更せずにそのまま転送する。プロキシはClaude Codeの/modelピッカーに1行だけ追加される番兵モデルIDを見て、「ユーザーが自動を選んだターン」だけをJevに判定させる。具体的なモデル名が指定されていれば素通しする。
ローカルproxy] B --> C[Jev API
tier判定 1回] C --> D[policy.mjs
ルール適用] D --> E[Anthropic API
Haiku / Sonnet / Opus] B -. 認証ヘッダは素通し .-> E C -. 失敗したら現状維持 .-> D
階層はClaudeとCodexで共通の抽象名になっていて、READMEの表はこうなっている。
| 抽象階層 | Claude Code の既定 | Codex の既定 |
|---|---|---|
| Fast | Haiku | gpt-5.6-luna |
| Balanced | Sonnet | gpt-5.6-terra |
| Strong | Opus | gpt-5.6-sol |
| Long | Fable | gpt-6-astra |
ここでREADMEと実コードの食い違いを1つ見つけた。READMEは「Claudeはjev-auto、Codexはjev-routerを番兵に使う」と書いているが、src/config.mjsのAUTO_MODELもsrc/codex-proxy.mjsのCODEX_AUTO_MODELも、実際にはどちらもjev-routerである。さらにmasterブランチのpackage.jsonはjev-explainを含む3つのbinを宣言しているが、npmに公開済みの0.2.0で実際に入るのはjev-claudeとjev-codexの2つだけだった。README記載の/jev-explainを期待して入れると、その場では見つからない。
# 2026-09-18 に実行して確認
npm install jev-router
node -e "const p=require('jev-router/package.json');
  console.log(p.version, JSON.stringify(p.dependencies));
  console.log(JSON.stringify(p.bin));"
# => 0.2.0 {"@typesafe-ai/sdk":"^0.6.0"}
# => {"jev-claude":"bin/jev-claude.mjs","jev-codex":"bin/jev-codex.mjs"}
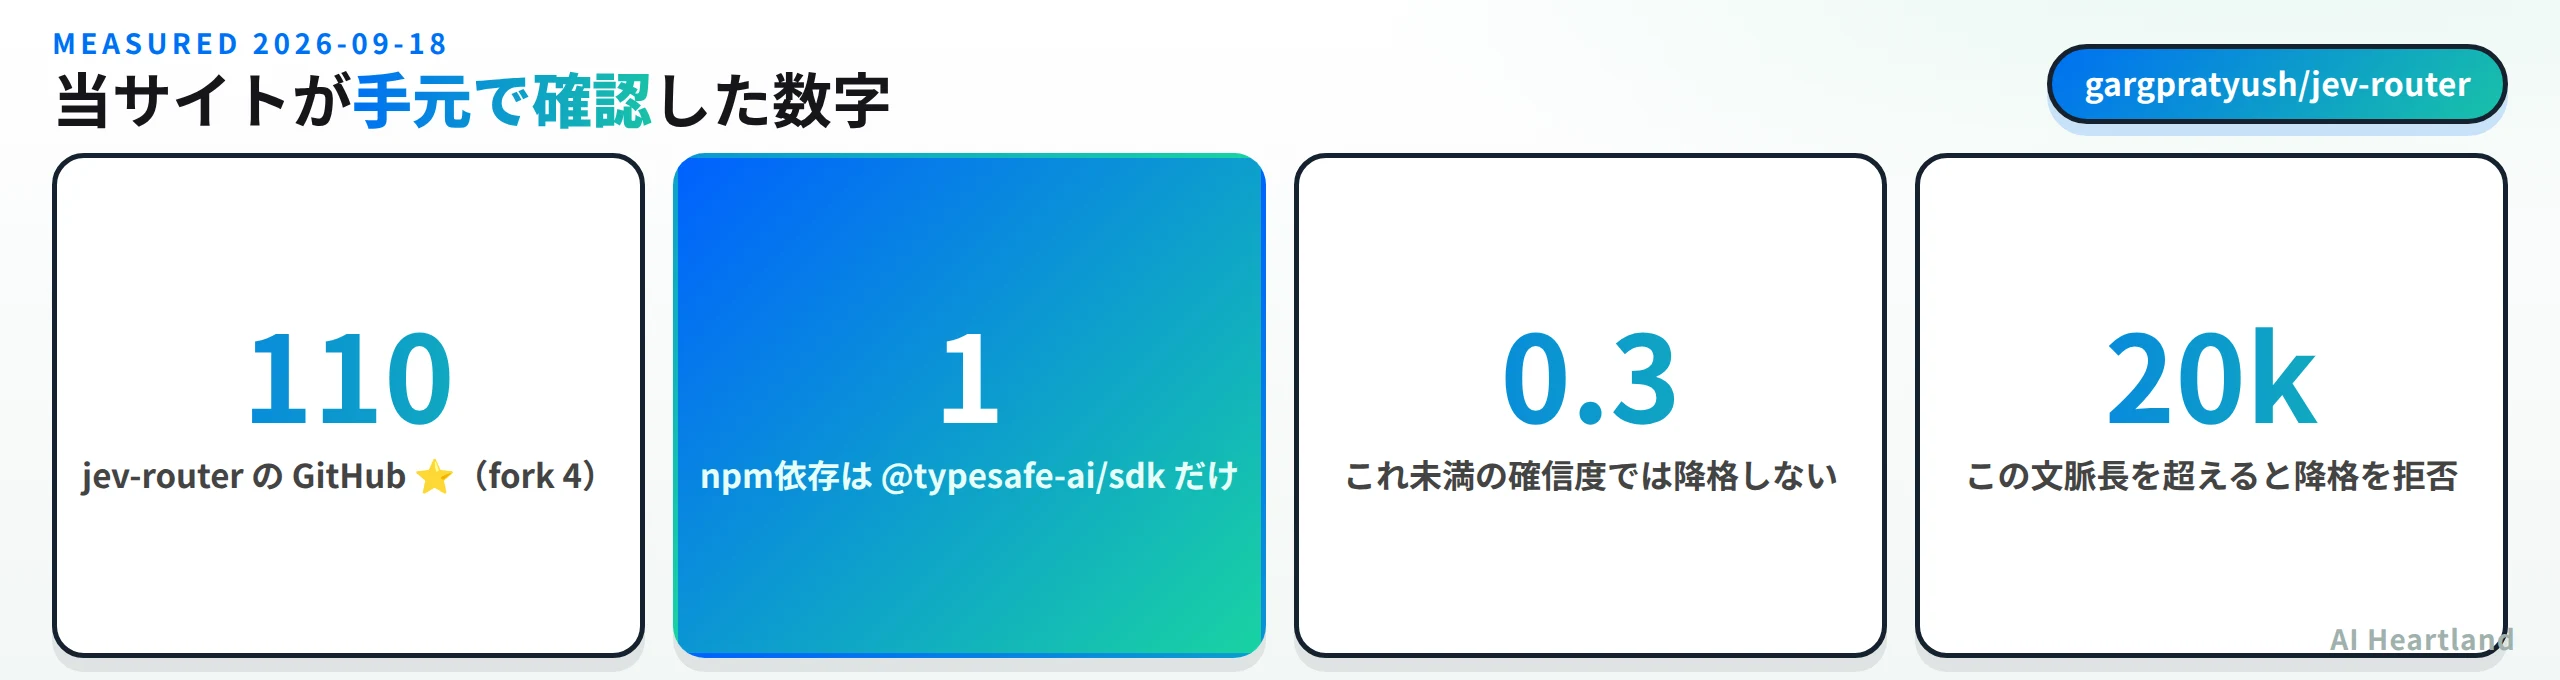
依存は@typesafe-ai/sdkただ1つ。リポジトリは2026年9月18日時点でstar 110・fork 4・open issue 3、タグは未作成で、開発はWindows上のClaude Code v2.1.101とCodex v0.154.0に対してテストされたとREADMEに明記されている。まだ「今週生まれたツール」の段階だと考えたほうがいい。
プライバシー面の記述も確認しておく価値がある。READMEのLimitationsは「ルーティング判定のためにTypeSafeへ送られるのはユーザーのプロンプト本文だけで、それ以外は送らない」と書いている。逆に言えば、プロンプト本文は第三者のAPIを通る。業務コードの文脈を貼り付ける使い方をするなら、ここは組織のポリシーと突き合わせる必要がある。
ルーティング方針を手元で再現する——Jevの答えだけでは決まらない
jev-routerの面白い部分は、Jevの答えをそのまま採用しない点にある。src/policy.mjsが4つの安全弁を挟んでいる。
・明示指定が最優先:プロンプトにuse opusのような指示があれば、Jevの答えより人間が勝つ
・低信頼では降格しない:確信度0.3未満なら、下位モデルへは落とさず、上位への変更もBalancedで頭打ちにする
・大きな会話では降格しない:文脈が20,000トークンを超えていたら、安いモデルに落とす判断そのものを拒否する
・失敗したら現状維持:Jevが落ちても、タイムアウトしても、知らない答えが返っても、現在のモデルのまま進む
3つ目の根拠がコードのコメントに書かれている。モデルを切り替えるとプロンプトキャッシュが無効になり、次のターンで会話全体を送り直すことになる。作者の計測ではOpusへの切り替えでキャッシュ作成が約23,600トークン発生したという。だから「会話が小さいうちの降格しか元が取れない」という閾値が置かれている。安いモデルへ逃がすこと自体が、状況によっては高くつくわけだ。
この判定ロジックはAPIキー無しでも動く。npm公開版のpolicy.mjsを直接importして、Jevの答えを自分で与えて挙動を確かめた。
# 2026-09-18 に実行(APIキー不要・ロジックだけを再現)
node --input-type=module -e '
import { decide } from "jev-router/src/policy.mjs";
const A = ["haiku","sonnet","opus"];
const cases = [
  ["高信頼でhaiku・会話が小さい", {prompt:"typoを直して", jev:{choice:"haiku",confidence:0.92}, current:"opus", available:A, contextTokens:3000}],
  ["高信頼でhaikuだが会話が大きい", {prompt:"typoを直して", jev:{choice:"haiku",confidence:0.92}, current:"opus", available:A, contextTokens:80000}],
  ["低信頼でhaiku", {prompt:"直して", jev:{choice:"haiku",confidence:0.2}, current:"opus", available:A, contextTokens:3000}],
  ["人間が明示指定", {prompt:"use opus for this", jev:{choice:"haiku",confidence:0.99}, current:"haiku", available:A, contextTokens:3000}],
  ["Jev応答なし", {prompt:"直して", jev:null, current:"sonnet", available:A, contextTokens:3000}],
];
for (const [l,a] of cases) { const r = decide(a); console.log(l, "->", r.tier, r.reason); }'
結果は次のとおりで、Jevが「Haikuで十分」と高い確信度で答えても、条件次第でOpusのままになる。
| 入力条件 | 決定 | 理由コード |
|---|---|---|
| Haiku・確信度0.92・文脈3,000トークン | haiku | jev |
| Haiku・確信度0.92・文脈80,000トークン | opus(据え置き) | downgrade-not-worth-cache-rebuild |
| Haiku・確信度0.2 | opus(据え置き) | low-confidence-no-downgrade |
| Opus・確信度0.2(現在haiku) | sonnet | low-confidence-capped |
プロンプトにuse opus |
opus | override |
| Jev応答なし | sonnet(据え置き) | jev-unavailable |
確率を一次情報として返すモデルは、こういう使い方ができる。 「0.2の確信度なら降格させない」という分岐は、LLMの構造化出力で擬似的にやろうとすると自己申告の信頼度に依存することになる。Jevのconfidenceがどこまで較正されているかは公称値の話だが、少なくとも呼び出す側が確率で分岐を書けるという構造は、コードを読めば確認できる事実だ。ローカル環境が要件を満たすかを1コマンドで判定するllmfit完全ガイド|ローカルLLMの判定を1コマンドで済ませる使い方と同じく、判断を機械に寄せる方向の道具立てと言える。
なお、作者のコードコメントにはJev呼び出しが暖機後で約300〜350ミリ秒、初回はTLSハンドシェイクを含めて約900〜1,000ミリ秒という計測も残っている。タイムアウトは1回1,500ミリ秒、全体の締め切りは3,000ミリ秒、再試行は1回。これらは作者の環境での値であり、当サイトでは再現していない。
Jevが向く仕事・向かない仕事
ここまでの確認を踏まえると、採用判断の線引きはかなりはっきりする。
向いている仕事は、答えの集合が事前に決まっていて、同じ判断を大量に繰り返すものだ。チケットの分類、コンテンツのモデレーション、検索結果の再ランキング、抽出した値の候補選択、引用の裏取り、そして今回見たモデルルーティング。LLM-as-a-judgeのように「1回の判定単価×膨大な回数」で効く用途は、単価が2桁変われば設計そのものが変わる。公式スキルが挙げる使い方も、分類にとどまらず「関数呼び出しの引数を型つきで埋める」「複数の観点をスコア化して、重みは後からコード側で変える」といった、判断をデータとして扱う方向に寄っている。
向いていない仕事ははっきりしている。自由文が必要なものすべてだ。要約も、コード生成も、対話も、未知のラベルを発見する探索も、Jevの守備範囲ではない。criteriaに書き忘れた値はモデルが選べない——公式スキルが「候補の網羅性を確認せよ」と念を押しているのはそのためだ。設計段階で選択肢を洗い出す作業は、そのまま人間の仕事として残る。
試すときの現実的な足がかりも用意されている。TypeSafeはsystem-one-adapter-pythonを同じくMITで公開していて、これはTypeSafeClientと同じインターフェースをOpenAIやAnthropicのAPIで裏打ちする差し替え用の実装だ。リポジトリの説明にも「TypeSafeとLLMをコスト・速度・知能で比較するのに便利」と書かれている。ウェイトリストの順番を待つ間に、同じコードをLLMバックエンドで先に書いて動かし、Jevが来たら差し替えて比較する——という進め方ができる。自社のデータで自分で測れという話に帰着するわけで、これは公称値の検証手段としても筋がいい。
一方でリスクも正直に置いておく。モデル本体は非公開のホスト型APIで、ローカル実行の選択肢は無い。価格は変わりうるし、アーリーアクセスの供給も読めない。公称の精度は上位モデルに数ポイント届いておらず、その数字すら自社ベンチの、しかも正解キーを持たない採点によるものだ。組織のコードや顧客データがプロキシ経由で外部に出る構成になる点も、先に潰しておくべき論点になる。
最後に、GitHub上でのTypeSafe自身の足跡も1つ記録しておく。同社のorganizationには、拡散言語モデルの実装LLaDAとサービングエンジンvLLMのフォークが置かれている。アーキテクチャの直接の証拠ではないが、「1回のパスで並列に答えを出す」という説明と拡散モデル系の技術は相性がいい。公式の技術報告が出たら真っ先に確かめたい点だ。
参照ソース
・typesafe-ai/typesafe-sdk-js — 公式JavaScript SDK(MIT・v0.6.0)。src/questions.ts・src/client.ts・src/types.ts・examples/demo.ts を実際に読んで確認した
・typesafe-ai/skills — 公式エージェントスキル。3つのプリミティブの使い分けと設計指針の一次情報
・typesafe-ai/system-one-adapter-python — 同じインターフェースをLLMで裏打ちする互換アダプタ(MIT)
・gargpratyush/jev-router — Claude Code / Codex 用ルーター(MIT・v0.2.0)。README・src/config.mjs・src/policy.mjs を確認
・Introducing System One Models and Jev — TypeSafe AI 公式発表。本記事の検証環境からは到達できず、速度・コスト・精度の公称値は二次報道経由で把握した
検証環境:2026-09-18・Linux。npm install・git clone・nodeのみで確認。api.typesafe.aiは環境側で遮断されており、Jev本体の応答は一度も受け取っていない。