Hindsight は、AIエージェントに「学習する記憶」を持たせるためのOSSだ。READMEは冒頭で立ち位置をはっきり書いている——多くのエージェント記憶システムは会話履歴を思い出すことに集中しているが、Hindsight が目指すのは思い出すことではなく学ぶことである、と。star 39.4k、fork 5.2k、タグは270本、ライセンスはMIT。GitHub Trendingで急上昇していたこのプロジェクトを、2026-09-28時点の v0.10.1 で実際にインストールし、MCPサーバーのツール数と常駐トークン、導入に必要な容量、起動時に何が要求されるかを測った。結論から言うと、Hindsight は「軽いライブラリ」ではなく、記憶のための小さなプラットフォームだった。
- ・記憶を「世界の事実」「エージェント自身の経験」に分け、多数の記憶から観察(Observation)と心的モデル(Mental model)を組み立てる設計
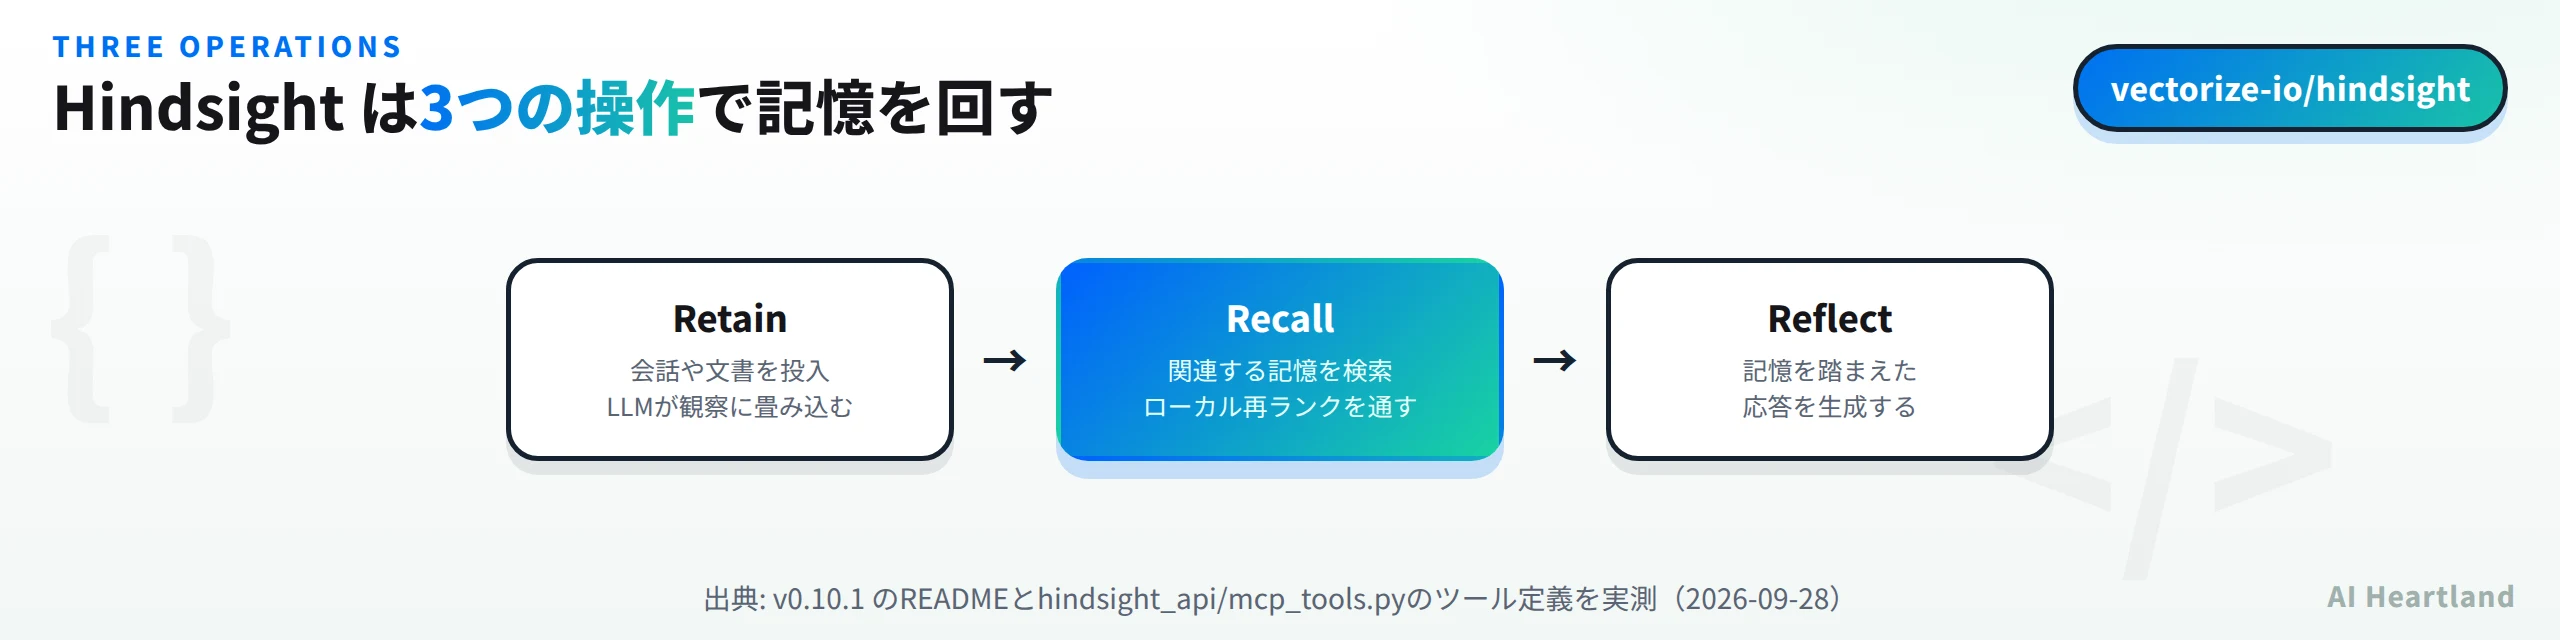
- ・操作は Retain(保存)・Recall(検索)・Reflect(記憶を踏まえた応答)の3つ。記憶はバンク単位で分離する
- ・pip install hindsight-api は 6.8GB・229パッケージ。うち3,196MBがNVIDIAのCUDAライブラリ
- ・LLM APIキーは必須。既定は openai の gpt-4o-mini で、キーが無いと起動を拒否する
- ・MCPサーバーは既定39ツール・約16,603トークン。3ツールに絞れば約1,276トークンまで落ちる
- ・同梱インテグレーションは54ディレクトリ、LLMプロバイダ実装は16本、クライアントSDKは Go/Python/Rust/TypeScript の4種
エージェント基盤そのものの選び方はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその「記憶をどこに置くか」の層を扱う。
Hindsightとは:会話の再生ではなく、観察に畳み込む記憶
一般的なエージェントメモリは、過去の会話をベクトル検索で引き当てて再びプロンプトへ入れる。Hindsight の設計はその一段上を狙っている。READMEの Memory Types 節によると、投入された記憶は次の4層に整理される。
| 層 | 中身 | READMEの例 |
|---|---|---|
| World facts | 世界についての事実 | 「コンロは熱くなる」 |
| Experiences | エージェント自身の経験 | 「コンロに触ったら本当に痛かった」 |
| Observations | 多数の記憶から作られた、根拠つきの確信 | — |
| Mental models | 観察と事実から統合された、世界の理解 | — |
記憶はバンクという単位に入り、追加されると「世界の事実」か「経験」のどちらかの経路へ振り分けられる。その後、エンティティ・関係・時系列の組み合わせとして表現され、疎/密のベクトル表現が付与される——と、ここまでがREADMEの説明だ。
実装側を見ると、この4層に対応するMCPツールがきちんと存在する。list_mental_models get_mental_model create_mental_model update_mental_model refresh_mental_model clear_mental_model と、心的モデルだけで6本。さらに知識ページ(Knowledge Pages)を扱う get_knowledge_base_tree search_knowledge_base create_knowledge_page update_knowledge_node など7本が並ぶ。「観察を畳み込む」という説明は看板だけではなく、APIの粒度まで降りてきている。
チーム単位で記憶を共有・統制する方向の実装としてはTencentDB Agent Memoryとは?チームでAIエージェントの記憶を共有・統制する仕組みが対になる。あちらがマネージドDB側から記憶を扱うのに対し、Hindsight は自分で立てるサーバーとして記憶を持つ。
何を実測したか:pip install で6.8GB、起動にはLLMキーが要る
まず素朴に、READMEの Python Embedded(サーバー不要)の経路をそのまま踏んだ。空の仮想環境に入れて、直後の容量を測る。
python3 -m venv /tmp/hs-venv
/tmp/hs-venv/bin/pip install hindsight-api
du -sm /tmp/hs-venv          # 6898  (= 6.8GB)
/tmp/hs-venv/bin/pip list | wc -l   # 229
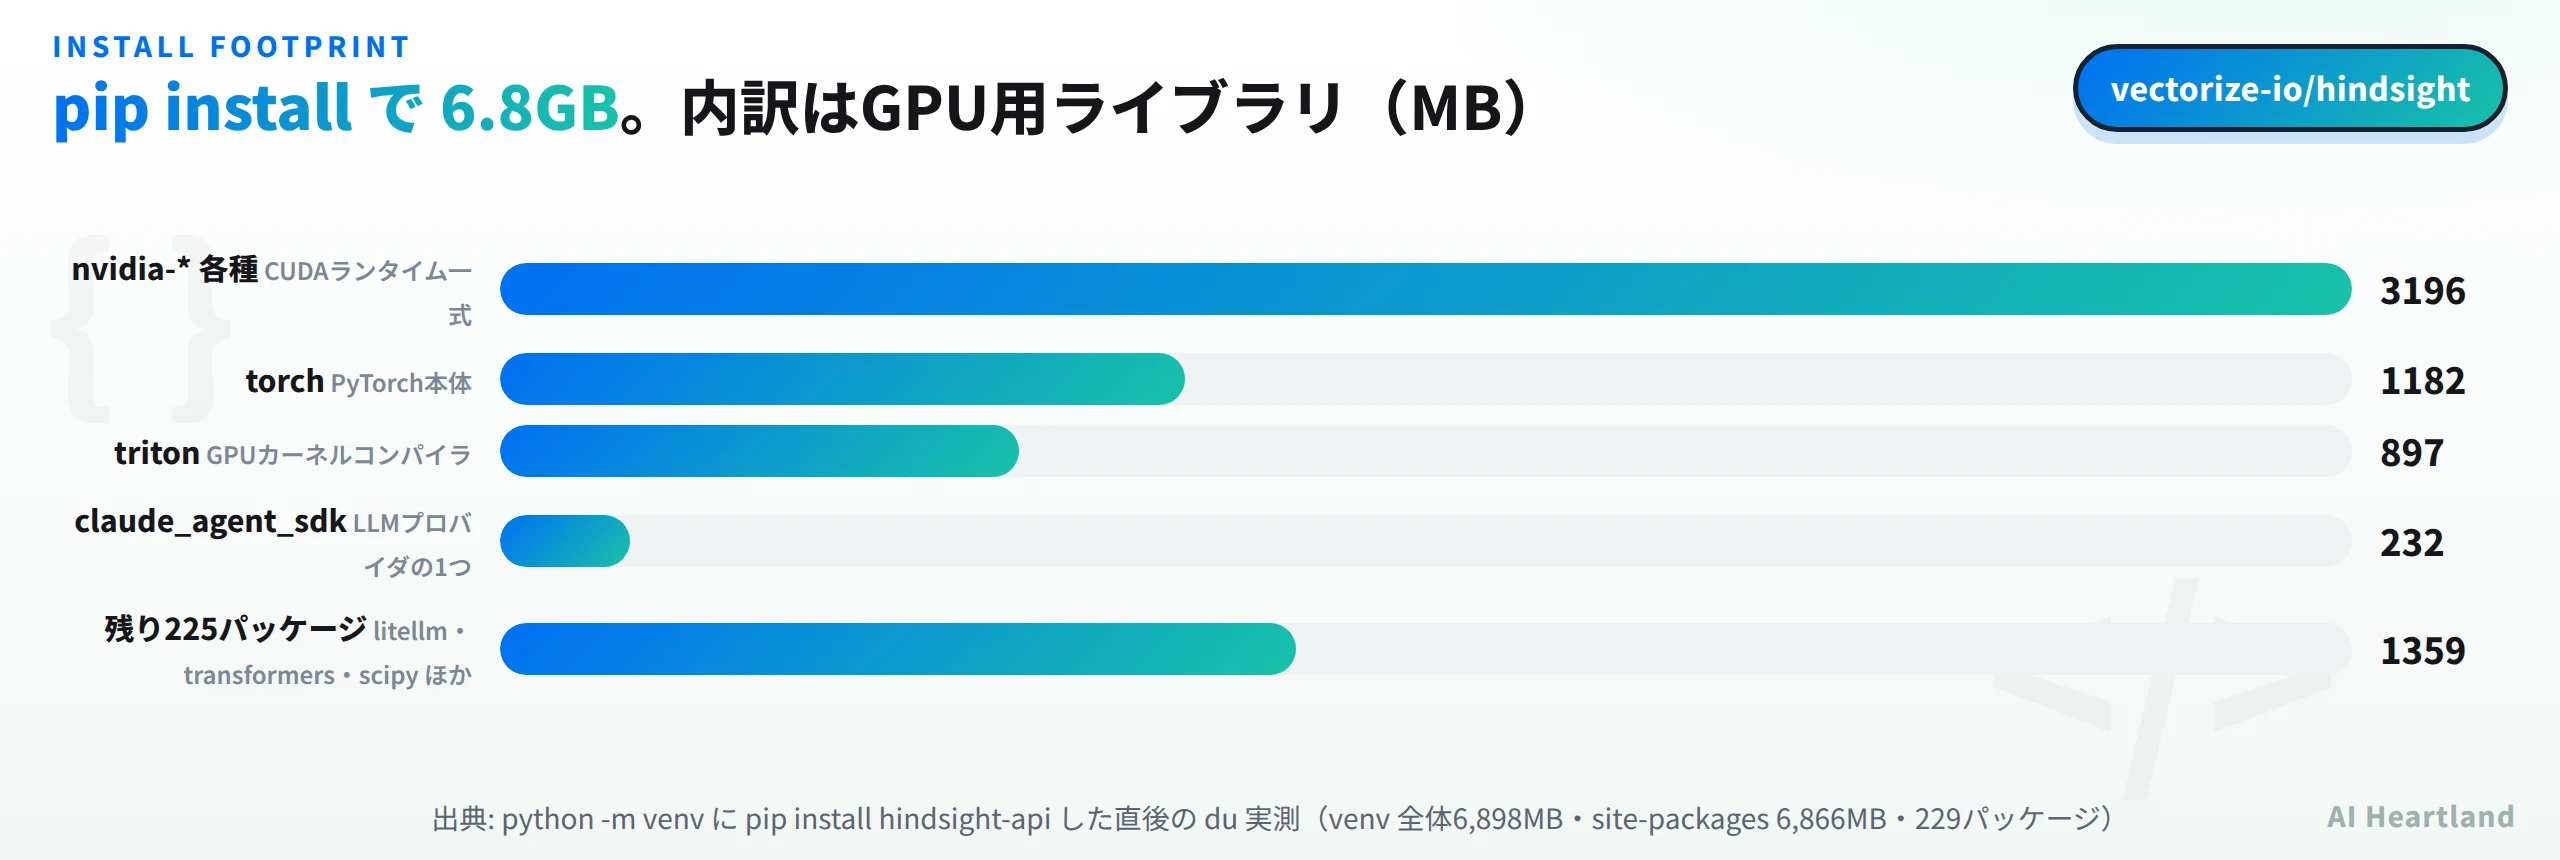
内訳を見ると納得がいく。NVIDIAのCUDAランタイム一式で3,196MB、PyTorch本体が1,182MB、GPUカーネルコンパイラのtritonが897MB。埋め込みと再ランクをローカルで動かす設計のため、sentence-transformers と transformers が入り、その依存としてGPU一式が付いてくる。GPUが無い環境でも同じものが入るので、CIやコンテナに入れる前に容量を見積もっておいたほうがいい。
入るコマンドは4本だった。hindsight-api(APIサーバー)、hindsight-worker(バックグラウンド処理)、hindsight-admin(管理)、hindsight-local-mcp(ローカルMCPサーバー)。
次に、何も設定せずサーバーを起動してみる。
/tmp/hs-venv/bin/hindsight-api --port 8888
# INFO - hindsight_api.config - Database: pg0 (schema: public)
# INFO - hindsight_api.config - LLM: provider=openai, model=gpt-4o-mini
# ValueError: LLM API key is required. Set HINDSIGHT_API_LLM_API_KEY environment variable.
LLM APIキーは必須で、無ければ起動しない。ここは「ローカルで完結する記憶システム」を期待して入れると最初に躓く点だ。起動ログは同時に既定構成を全部教えてくれる。
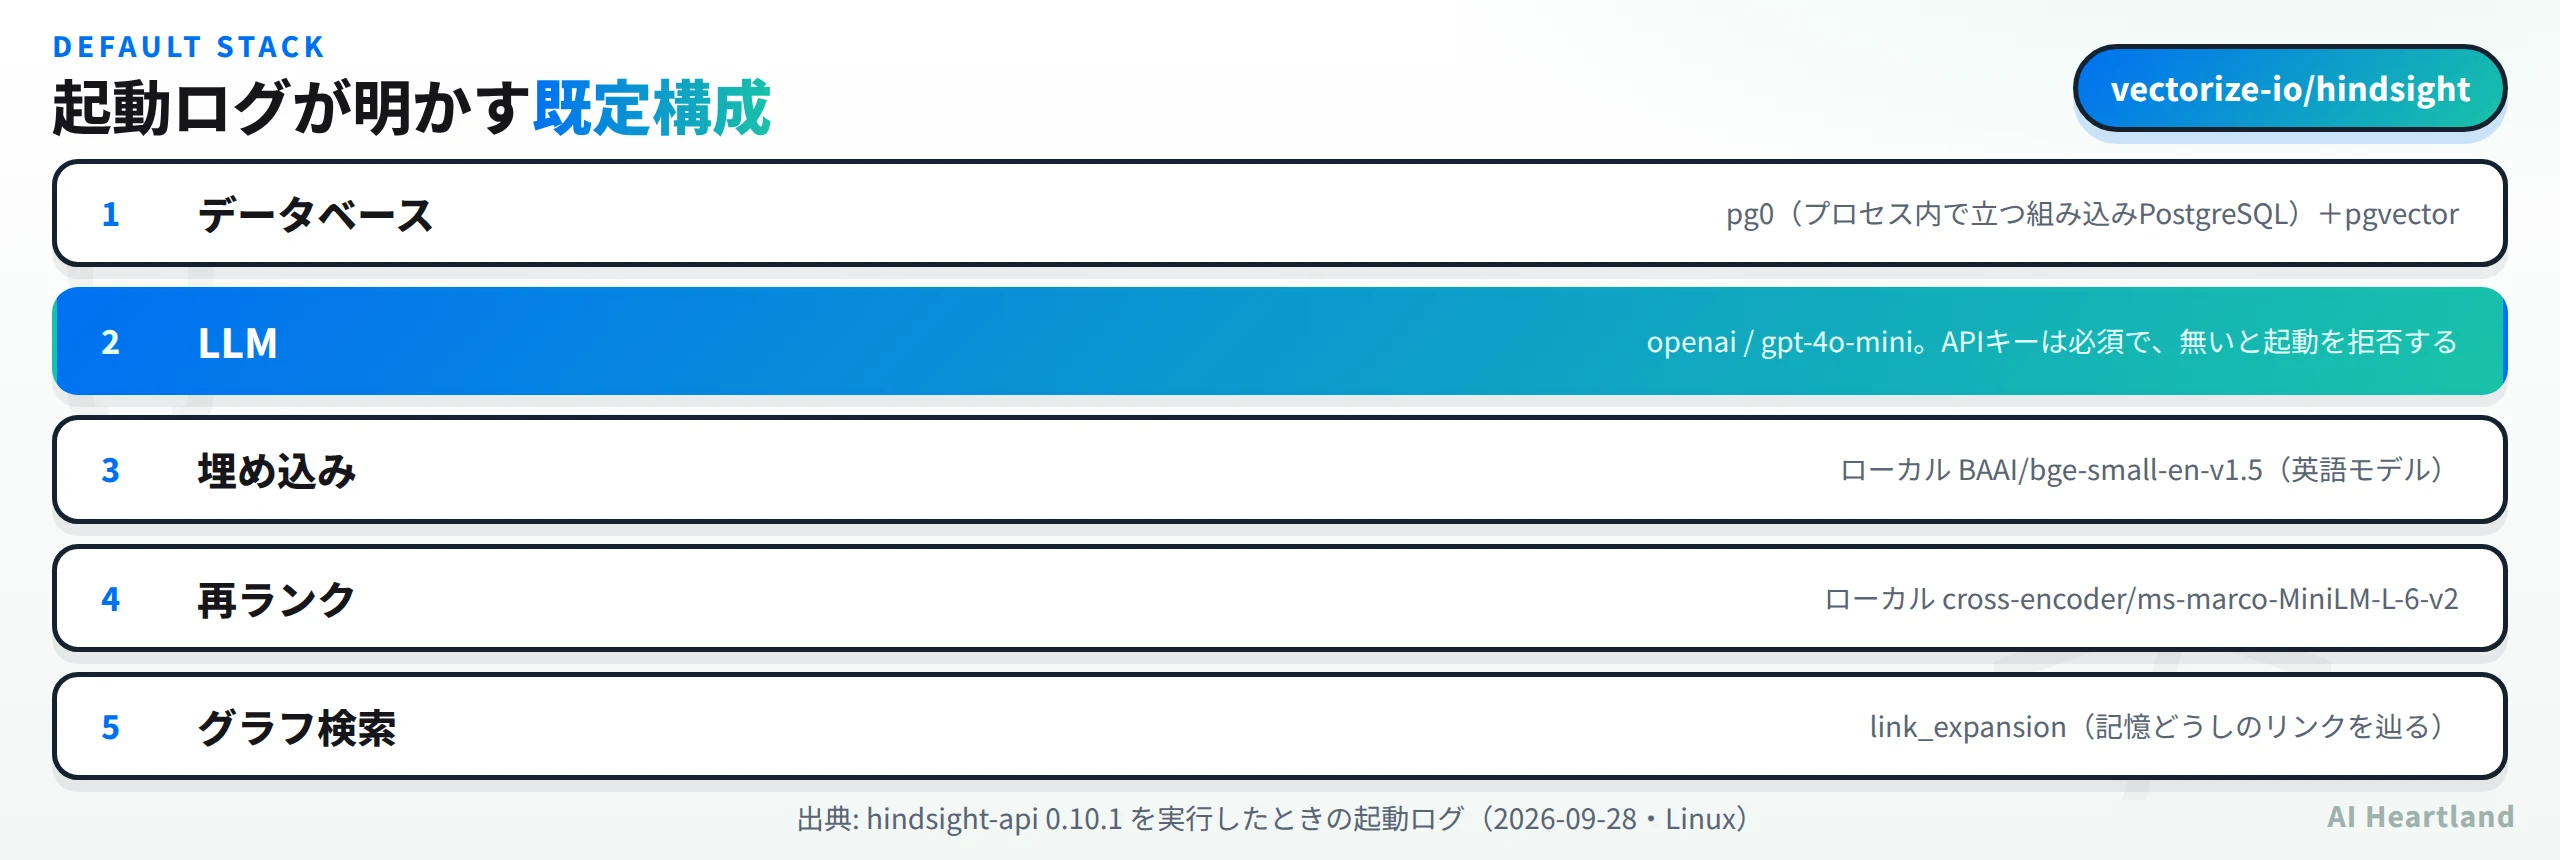
データベースは pg0——外部のPostgreSQLを用意しなくても、プロセス内に組み込みのPostgreSQLが立ち上がる(依存に pg0-embedded と pgvector が入っている)。これは体験としてよくできていて、Docker以外の経路でも pip install だけで完結する理由になっている。
ダミーのキーを渡して先へ進めると、次はモデルのダウンロードで止まった。
HINDSIGHT_API_LLM_API_KEY=sk-dummy /tmp/hs-venv/bin/hindsight-api --port 8888
# INFO - Embeddings: initializing local provider with model BAAI/bge-small-en-v1.5
# INFO - Reranker: initializing local provider with model cross-encoder/ms-marco-MiniLM-L-6-v2
# INFO - Verifying connection: openai/gpt-4o-mini
# httpx.ProxyError: 403 Forbidden   ← 当環境はHugging Faceへ到達不可
# ERROR:    Application startup failed. Exiting.
当記事の検証環境は外向き通信が絞られており、Hugging Face からモデルを取得できずに起動が失敗した。逆に言うと、初回起動にはインターネット接続が要る(モデルをあらかじめ配置する手もあるが、そこまでは試していない)。この失敗のおかげで、起動時に何をするかは正確に分かった——ローカル埋め込みの初期化、再ランカの初期化、そしてLLMへの接続確認である。
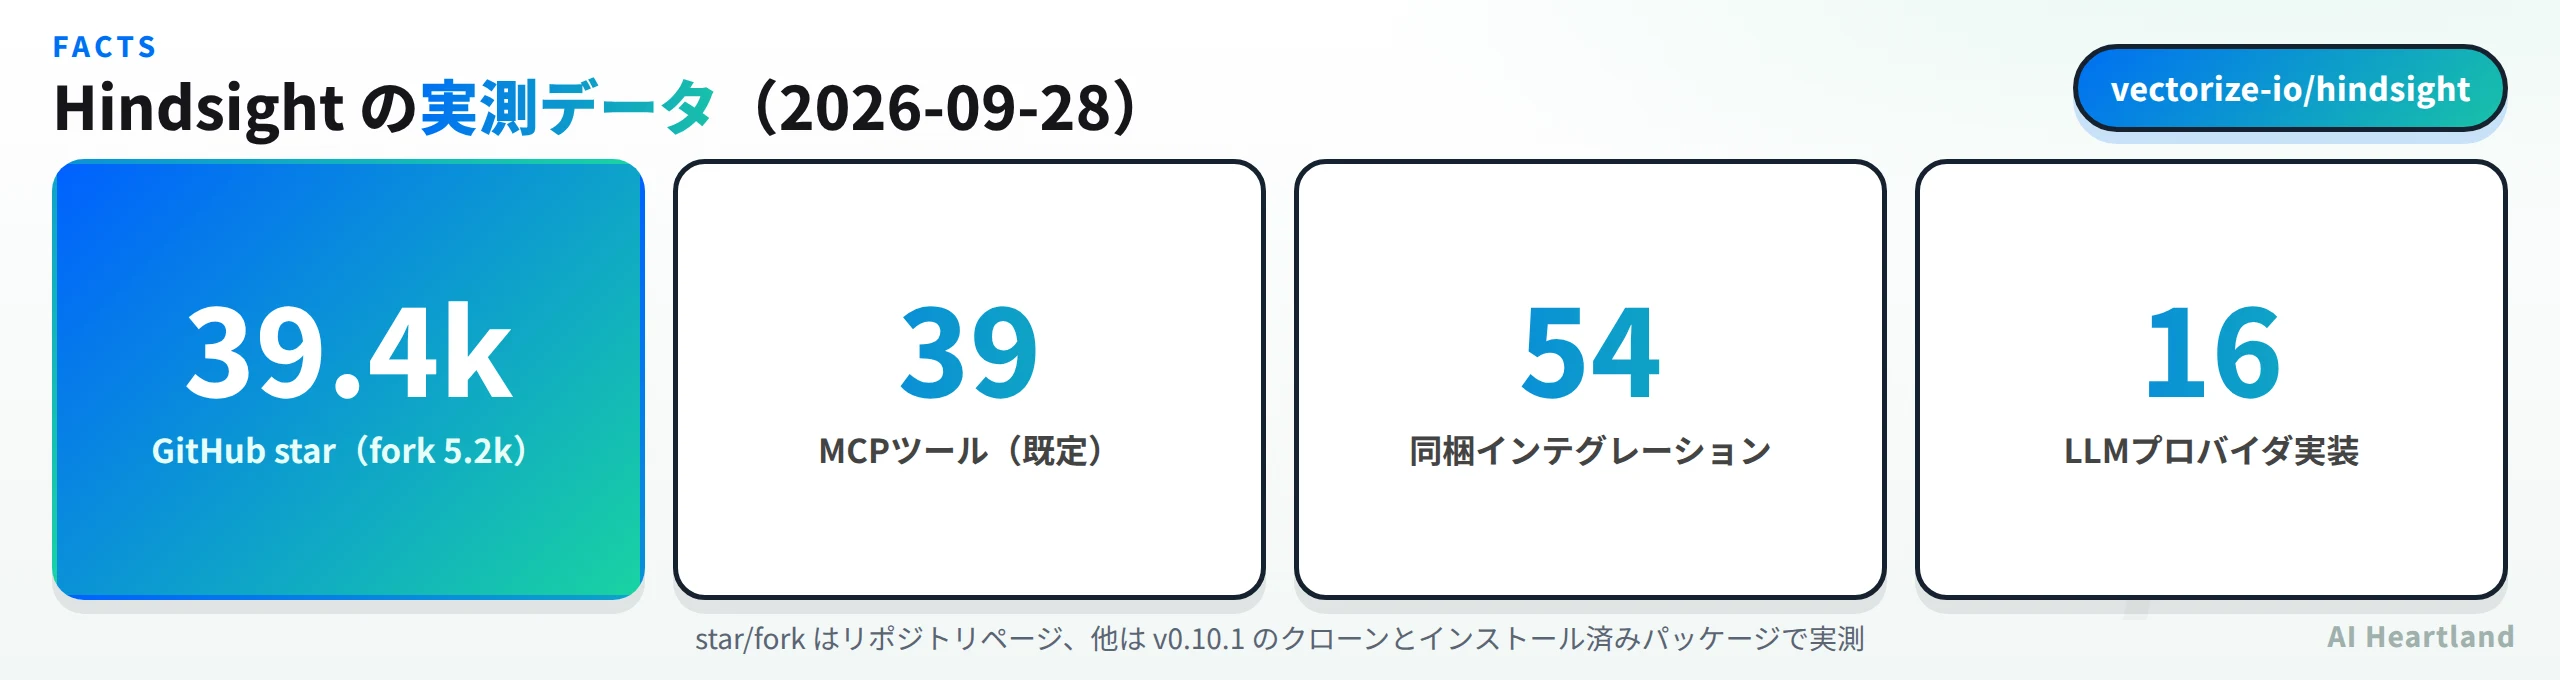
検証環境:Linux 6.18.44/Python 3.11/2026-09-28。リポジトリは main の 8924a5b(2026-09-28)= v0.10.1 相当を git clone --depth 1、PyPI からは hindsight-api 0.10.1 を新規venvへ導入。MCPのツール一覧は fastmcp のサーバーオブジェクトを実際に構築し list_tools() の結果をJSON化して計測。ツール数・インテグレーション数・プロバイダ数はソースとディレクトリを数えた。未検証:記憶の保存・検索を一度も動かしていない。LLM APIキーを持たず、かつ当環境からHugging Faceへ到達できないため、retain / recall / reflect の実動作、精度、レイテンシ、日本語での品質はいずれも未測定。READMEのLongMemEvalスコアと「最も正確なエージェントメモリ」という主張も追試していない。star 39.4k・fork 5.2k はリポジトリページの表示値。
MCPサーバーは39ツール・約16,600トークン。絞れば13分の1になる
Hindsight はHTTPのREST APIと同時に、/mcp/ にMCPサーバーを生やす(起動ログに MCP server enabled at /mcp/ と出る)。エージェントから見れば、ここが常駐コストになる。
ツールの実体は hindsight_api/mcp_tools.py の _ALL_TOOLS に列挙されていて、数えると 39本。モードによって出し分けがあり、multi_bank=False(単一バンク)ではバンク管理系が減る。実際にFastMCPのサーバーを構築して tools/list に相当するJSONを取得し、サイズを測った。
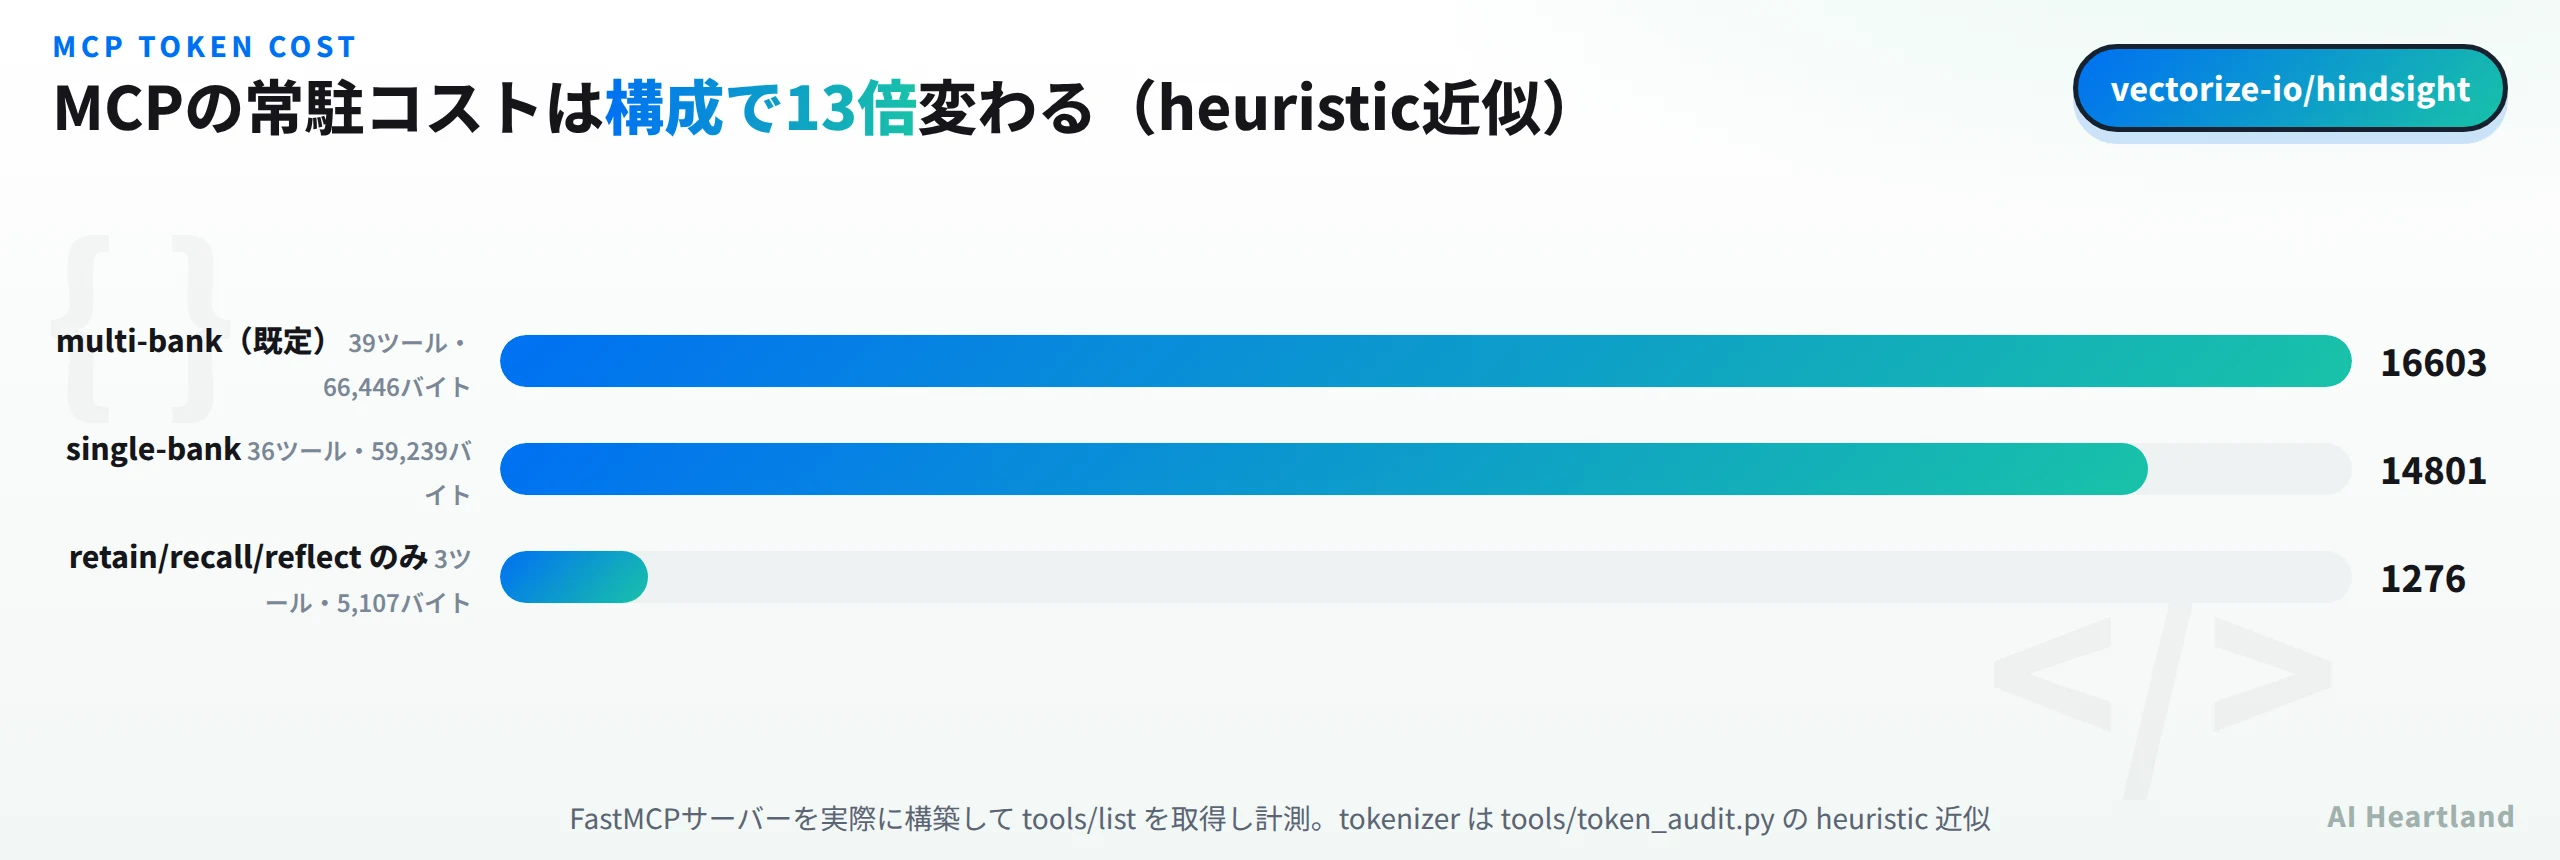
| モード | ツール数 | JSONサイズ | 常駐トークン(heuristic近似) |
|---|---|---|---|
| multi-bank(既定) | 39 | 66,446バイト | 約16,603 |
| single-bank | 36 | 59,239バイト | 約14,801 |
| retain / recall / reflect のみ | 3 | 5,107バイト | 約1,276 |
トークン数は当サイトの tools/token_audit.py に入っている heuristic 近似トークナイザ(CJK 1文字=1・ASCII 4文字=1)で数えた値で、Anthropic系の実トークナイザとは数%ずれる。既定のままClaude CodeやCursorに繋ぐと、それだけで1万6千トークン前後が毎回の文脈に乗る。当サイトで以前測った Notion MCP の21,831トークンや draw.io MCP の24,665トークンほどではないが、軽くはない。サイズを押し上げているのは記憶そのものではなく、create_mental_model(9,862バイト)や create_knowledge_page(9,369バイト)といった、入力スキーマが大きいツールだ。
救いは、絞り込みの口が最初から用意されていることだ。HINDSIGHT_API_MCP_ENABLED_TOOLS に許可するツール名を並べると、その集合だけが公開される(既定は未設定=全部)。エージェントに記憶の読み書きだけさせるなら retain recall reflect の3本で足り、常駐は約1,276トークン——13分の1以下になる。MCPを入れる前にここを決めておくと、あとで「文脈が足りない」と悩まずに済む。記憶を別レイヤへ外に出す発想としてはApache Maka(Incubating)とは|ログを権威にするローカルファーストAIエージェント基盤も近く、あちらは「何が起きたかのログ」を正本に据える点で Hindsight の観察レイヤと対比しやすい。
Claude Code / Cursor / 自作"] --> B["MCP /mcp/
既定39ツール・約16,603トークン"] A --> C["REST API
Python / TypeScript / Go / Rust SDK"] B --> D["MemoryEngine"] C --> D D --> E["LLM
既定 openai gpt-4o-mini・キー必須"] D --> F["埋め込み
ローカル bge-small-en-v1.5"] D --> G["再ランク
ローカル ms-marco-MiniLM-L-6-v2"] D --> H["pg0
組み込みPostgreSQL + pgvector"] H --> I["バンク
事実・経験・観察・心的モデル"]
日本語で使うときの注意:既定の埋め込みは英語モデル
ここは日本語圏の読者にとって最重要だと思う。起動ログが示す通り、ローカル埋め込みの既定は BAAI/bge-small-en-v1.5、再ランクは cross-encoder/ms-marco-MiniLM-L-6-v2。どちらも英語向けのモデルで、日本語の記憶を入れても検索品質はそのぶん落ちると考えるべきだ。
ただし逃げ道はきちんと用意されている。hindsight_api/config.py を読むと、埋め込みプロバイダは複数あり、既定値がそれぞれ違う。
| 埋め込みプロバイダ | 既定モデル | 日本語 |
|---|---|---|
| local(sentence-transformers) | BAAI/bge-small-en-v1.5 |
英語向け |
| onnx | intfloat/multilingual-e5-small |
多言語 |
| openai | text-embedding-3-small |
多言語 |
| gemini / cohere / openrouter / requesty / zeroentropy / litellm | 各社の既定 | プロバイダ次第 |
つまり日本語で使うなら、ONNXプロバイダに切り替えて multilingual-e5-small を使うか、外部の埋め込みAPIに寄せるのが素直だ。環境変数は HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL / HINDSIGHT_API_EMBEDDINGS_ONNX_MODEL_ID などが定義されている。なお、この切り替えで日本語の記憶精度が実際にどこまで改善するかは当記事では測っていない。日本語データでベクトル検索の挙動が変わる例はzvecとは|Alibaba製インプロセスベクトルDBを実測。索引が作られない罠と日本語FTSの初期設定でも扱った通りで、既定値のまま日本語を入れると静かに品質が落ちるのはこの領域の定番の罠である。
LLM側の選択肢は逆に豊富で、engine/providers/ には16本の *_llm.py が並ぶ。anthropic gemini fireworks llamacpp といった素直なものに加えて、claude_code codex cursor github_copilot があるのが目を引く。APIキーを別途契約せず、手元のコーディングエージェントのサブスクリプションを記憶の畳み込みに使わせる経路が用意されている、ということだ(mock と none を除けば実プロバイダは14本)。ローカル完結を狙うなら llamacpp が選択肢になる。
導入前に押さえる点:ベンチマークの読み方とライセンス
READMEは「ベンチマーク性能によれば、これまでテストされた中で最も正確なエージェントメモリシステム」と書いている。根拠は LongMemEval での成績だ。ここは注意して読む必要がある箇所が3つある。
・時点が明記されている:比較表は「2026年1月時点」の各社スコア。本記事執筆時点で9か月近く経っており、他社の数値は更新されている可能性がある
・他社スコアの出どころ:READMEは「その他のスコアはソフトウェアベンダーによる自己申告」と明記している。同一条件の横並び比較ではない
・第三者再現の範囲:Hindsight 自身のスコアは Virginia Tech の Sanghani Center と The Washington Post の研究協力者によって独立に再現された、と書かれている。これは自己申告より強い主張だが、当記事では追試していない
数値そのものを否定する材料は無い。ただ「最も正確」という一語で判断せず、自分のデータで LongMemEval 相当の評価を回してから決めるのが妥当な距離感だと思う。リポジトリには hindsight-system-evals/ が同梱されているので、評価の再現から入る道はある。
ライセンスはリポジトリ直下の LICENSE が MIT(Copyright (c) 2025 Vectorize AI, Inc.)で、実体ファイルも MIT 本文だった。一方でホスト版の Hindsight Cloud が別に存在し、READMEにある「99.9%」はそのクラウドの稼働率SLAであって、記憶の精度の数字ではない。OSS版とクラウド版が併存するプロジェクトなので、「どこまでが無料で自前運用できるか」は導入前に確認しておきたい。
その他、実測して分かった周辺情報を並べておく。
・インテグレーションは54ディレクトリ:hindsight-integrations/ 直下を数えた実数。claude-code・codex・cursor・cline・continue・openclaw・zed といったコーディングエージェント系から、langgraph・crewai・llamaindex・haystack・dify・n8n・zapier まで並ぶ。READMEの「60+」という表記とは数え方が違うようだ
・クライアントSDKは4言語:hindsight-clients/ に go・python・rust・typescript
・同梱スキルは5本:skills/ に hindsight-architect・hindsight-cloud・hindsight-docs・hindsight-local・hindsight-self-hosted。npx skills add でコーディングエージェントに入れる想定。SaaS側をMCPで束ねる構成と組み合わせる話はOpenConnectorとは|導入・使い方からMCP連携まで。1400+SaaSをAIエージェントへを参照
・更新頻度は高い:タグ270本、クローンした時点の最新コミットは当日(2026-09-28)付。安定版を固定して使うか、追従のコストを見込むかは決めておいたほうがいい
総括。 Hindsight は「記憶を持つエージェント」を作るための、かなり本気の実装だった。観察と心的モデルという層を持ち、MCPとRESTの両方を生やし、54のインテグレーションとバンク単位の分離まで用意されている。一方で、導入は6.8GB、LLMキーは必須、MCPを既定で繋ぐと1万6千トークンが常駐し、日本語なら埋め込みの差し替えが要る。「pip install して2行で終わり」という軽さを期待すると齟齬が出る種類のソフトウェアで、記憶をインフラとして扱う覚悟がある場合に効く道具だと思う。
参照ソース
・vectorize-io/hindsight(公式リポジトリ) — README・hindsight_api/ のソース・LICENSE を 2026-09-28 に確認(main の 8924a5b)
・Hindsight ドキュメント(公式) — README から案内されている公式ドキュメント
・Hindsight Benchmarks(公式・継続更新) — モデル別の精度・レイテンシ・コストが公開されている(当記事では数値を追試していない)
・hindsight-api(PyPI) — 実際に導入した 0.10.1 の配布元