mem0 は、AIエージェントに「消えない文脈」を足すための記憶レイヤだ。GitHubのAboutは “The Memory Layer for AI Agents — Drop-in memory infrastructure for AI agents and apps” と名乗っている。star 66.2k、fork 7.8k、ライセンスは Apache-2.0。この手のプロジェクトは看板の数字が派手になりがちなので、2026-09-28時点の v2.2.1 を実際にインストールして、導入サイズ・外部依存・対応プロバイダ数を測り、READMEに並ぶベンチマークが何を指しているのかを原文で確かめた。結果として mem0 は、記憶の計算を自前で抱えず外へ出す「薄い層」だった。
- ・記憶の実体は「会話から抽出した事実」。add で1回のLLM呼び出しで抽出し、search で意味・キーワード・実体照合を融合して返す
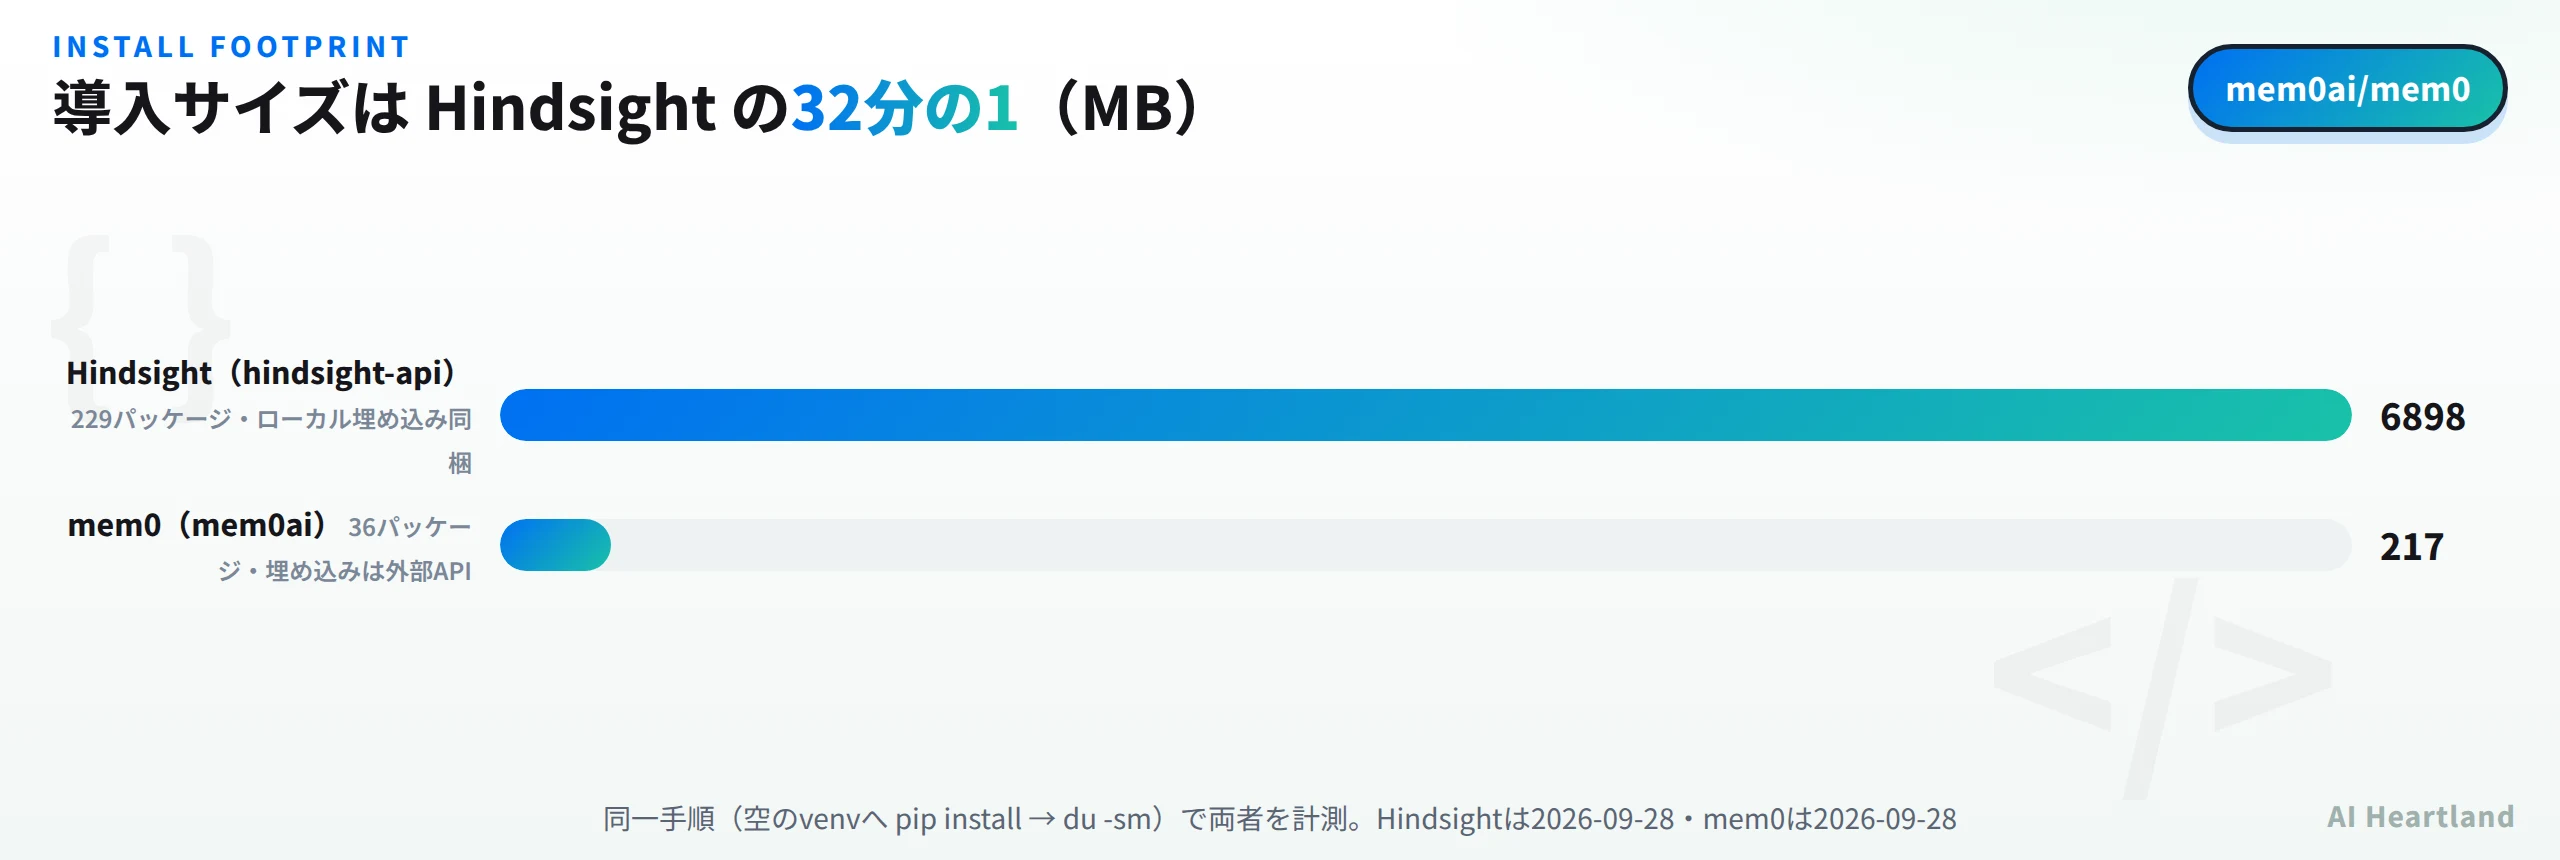
- ・pip install mem0ai は 217MB・36パッケージ。埋め込みも再ランクも外部に出すので軽い
- ・既定は LLM=openai / 埋め込み=openai / ベクタストア=qdrant。OPENAI_API_KEY が無いと Memory() の生成で落ちる
- ・対応実装はベクタストア24・LLM 18・埋め込み12。Ollama や LM Studio もある
- ・READMEのベンチマーク値はマネージド版のもの。OSS版には無い独自最適化を含むとREADME自身が明記している
- ・同梱スキル6本のうち1本は「OSS版からマネージド版へ移行する」ためのもので、逆方向は無い
エージェント基盤そのものの選び方はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその記憶層の話だ。
mem0とは:会話から事実を抜き、貯めて、混ぜて返す
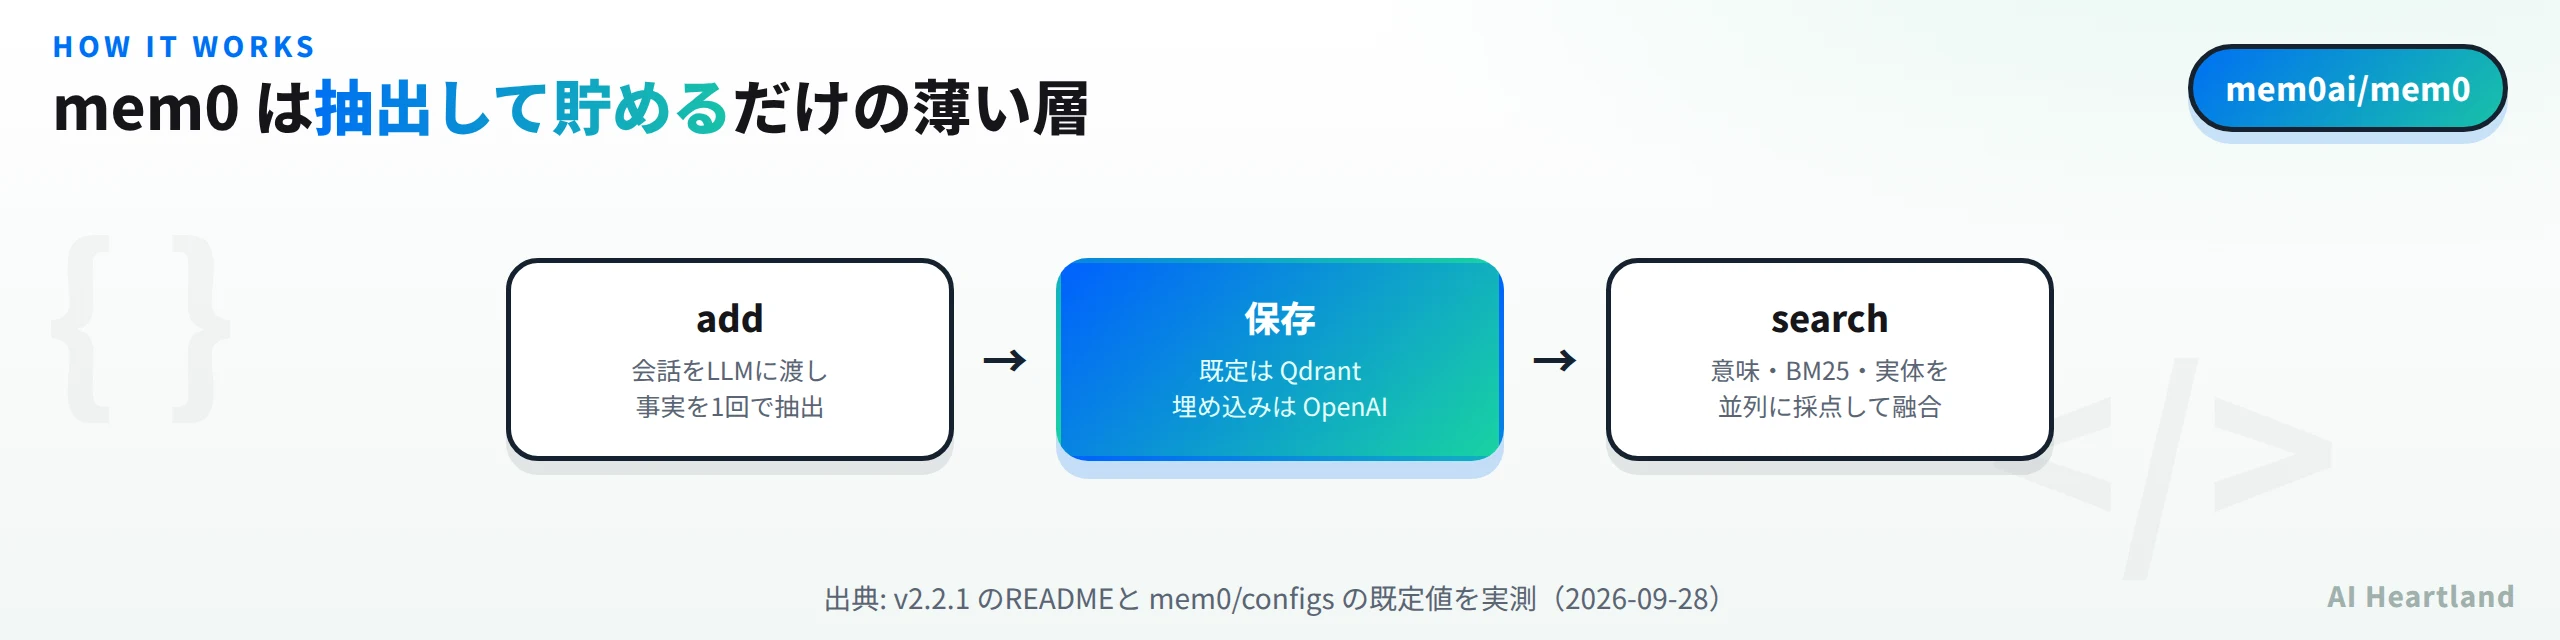
mem0 の仕事は3つの操作に集約される。add で会話やテキストを渡すと、LLMが「覚えておくべき事実」を抽出して保存する。search で問い合わせると、関連する記憶を返す。get_all や delete で管理する。エージェント側から見れば、会話履歴を丸ごとプロンプトに積む代わりに、抽出済みの短い事実だけを受け取れる。
2026年4月に入った新しい記憶アルゴリズムの説明が、設計思想をよく表している。READMEの What changed 節によれば、抽出は single-pass ADD-only——1回のLLM呼び出しで追加のみを行い、UPDATE も DELETE もしない。記憶は上書きされずに積み上がる。エージェントが行動を確定したときの「エージェント自身が生成した事実」も同格で保存し、実体(エンティティ)を抽出して記憶どうしをリンクする。検索は意味検索・BM25キーワード・実体照合を並列に走らせてスコアを融合する。
この「抽出して貯めるだけ」という割り切りは、同じエージェント記憶でも設計が分かれるところだ。観察や心的モデルという層を持つHindsightとは|学習するAIエージェント記憶OSSをMCP 39ツールと6.8GBの実測で解説と比べると、mem0 は明確に手前で止めている。階層的に記憶を管理するmemory-os解説|AIエージェントの記憶をローカル完結でOS的に階層管理するとも方向が違う。どれが正しいというより、記憶の加工をどこまでライブラリ側でやるかの線の引き方が違う。
何を実測したか:217MB・36パッケージという軽さ
まず導入コストを測る。空の仮想環境に入れて、直後の容量を見る。
python3 -m venv /tmp/m0-venv
/tmp/m0-venv/bin/pip install mem0ai
du -sm /tmp/m0-venv                          # 217
/tmp/m0-venv/bin/pip list --format=freeze | wc -l   # 36
217MB、36パッケージ。site-packages の内訳で大きいのは numpy(45MB)・SQLAlchemy(29MB)・openai(25MB)程度で、機械学習の重量級ライブラリは入らない。
この数字が意味を持つのは、比較対象を置いたときだ。同じ日に同じ手順で測った Hindsight は6,898MB・229パッケージだった。理由ははっきりしていて、Hindsight は埋め込みと再ランクをローカルモデルで動かすため PyTorch と CUDA 一式を引き込む。mem0 はその計算を外部APIに出すので、入るのはHTTPクライアントとスキーマ定義だけで済む。
軽さの代償も同じ場所にある。何も設定せずに Memory() を作ると、その場で落ちる。
from mem0 import Memory
m = Memory()
# openai.OpenAIError: Missing credentials. Please pass an `api_key`, ...
# or set the `OPENAI_API_KEY` ... environment variable.
インスタンス生成の時点で埋め込みクライアントを組み立てるため、キーが無いと add を呼ぶ前に例外になる。「ライブラリだから手元で完結する」とは読まないほうがいい。差し替え先は用意されていて、埋め込みには ollama lmstudio huggingface fastembed の実装がある。
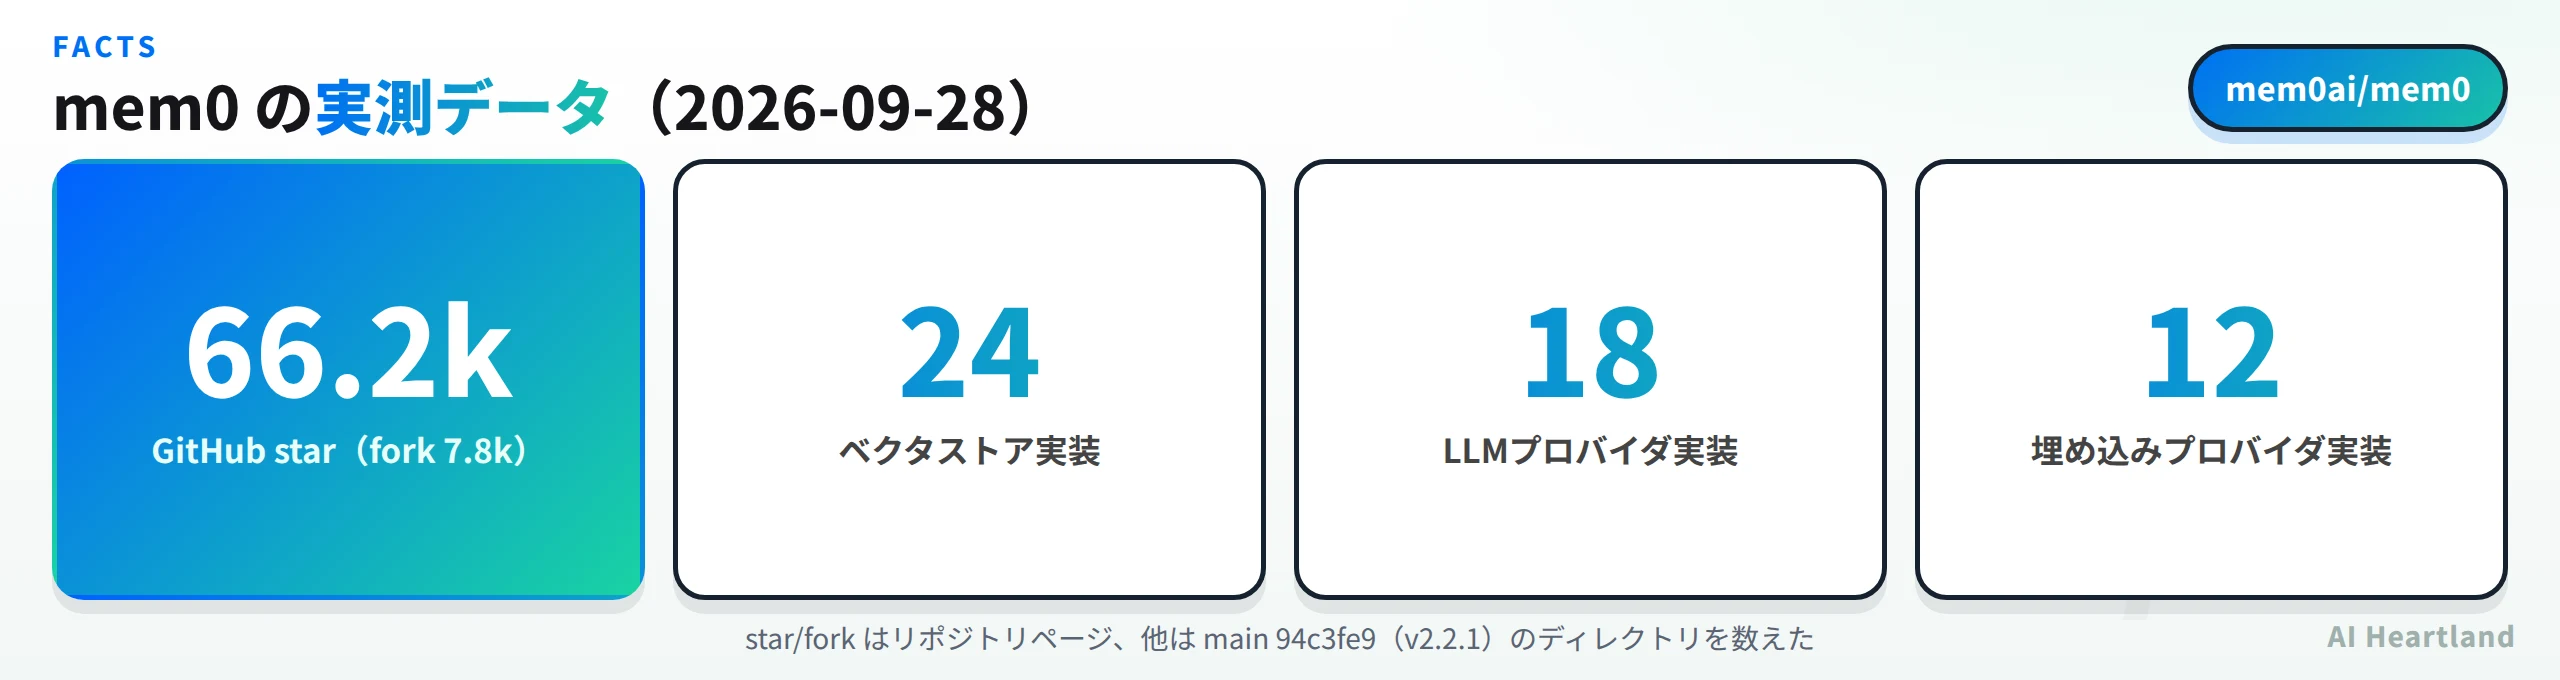
差し替えの幅は広い。mem0/vector_stores/ には24の実装があり、既定の Qdrant に加えて pgvector・Chroma・Milvus・Weaviate・Redis・Elasticsearch・FAISS・Pinecone、さらに Azure MySQL・Oracle DB・S3 Vectors・Databricks・Neptune Analytics まで並ぶ。mem0/llms/ は18本(Anthropic・Gemini・Groq・DeepSeek・vLLM・Ollama・LiteLLM ほか)、mem0/embeddings/ は12本。既存のデータ基盤に合わせて置き場所を選べるのが、このプロジェクトが広く使われている理由のひとつだと思う。
検証環境:Linux 6.18.44/Python 3.11/2026-09-28。リポジトリは main の 94c3fe9(2026-09-25・Python SDK 2.2.1)を git clone --depth 1、PyPI からは mem0ai を新規venvへ導入。容量は du -sm、パッケージ数は pip list、プロバイダ数は各ディレクトリの .py を base/configs/__init__ を除いて数えた。未検証:記憶の保存・検索を一度も動かしていない。OpenAI・Qdrant いずれの資格情報も持たないため、add / search の実挙動、抽出精度、レイテンシ、日本語での品質はすべて未測定。READMEのLoCoMo・LongMemEvalのスコアも追試していない。セルフホストサーバー(server/)とCLI、TypeScript SDK も未起動。star 66.2k・fork 7.8k はリポジトリページの表示値。
ベンチマークの数字が指すのはOSS版ではない
READMEの冒頭には LoCoMo 92.5、LongMemEval 94.4 といったスコア表が並ぶ。ここは丁寧に読む必要がある。表の直下に、READMEの書き手自身がこう注記している。
Scores reflect Mem0’s managed platform, which includes proprietary optimizations not available in the open-source SDK; open-source users should expect directionally similar gains but not identical numbers.
訳せば「スコアはマネージド版のものであり、OSS SDKには無い独自最適化を含む。OSS利用者は同じ方向の改善は見込めるが、同一の数値にはならない」。これは隠していない——むしろ明示しているのは誠実な部類だ。ただし数字だけが引用されて広まりやすい形でもあるので、pip install mem0ai した自分の環境の期待値として持ち込まないほうがいい。
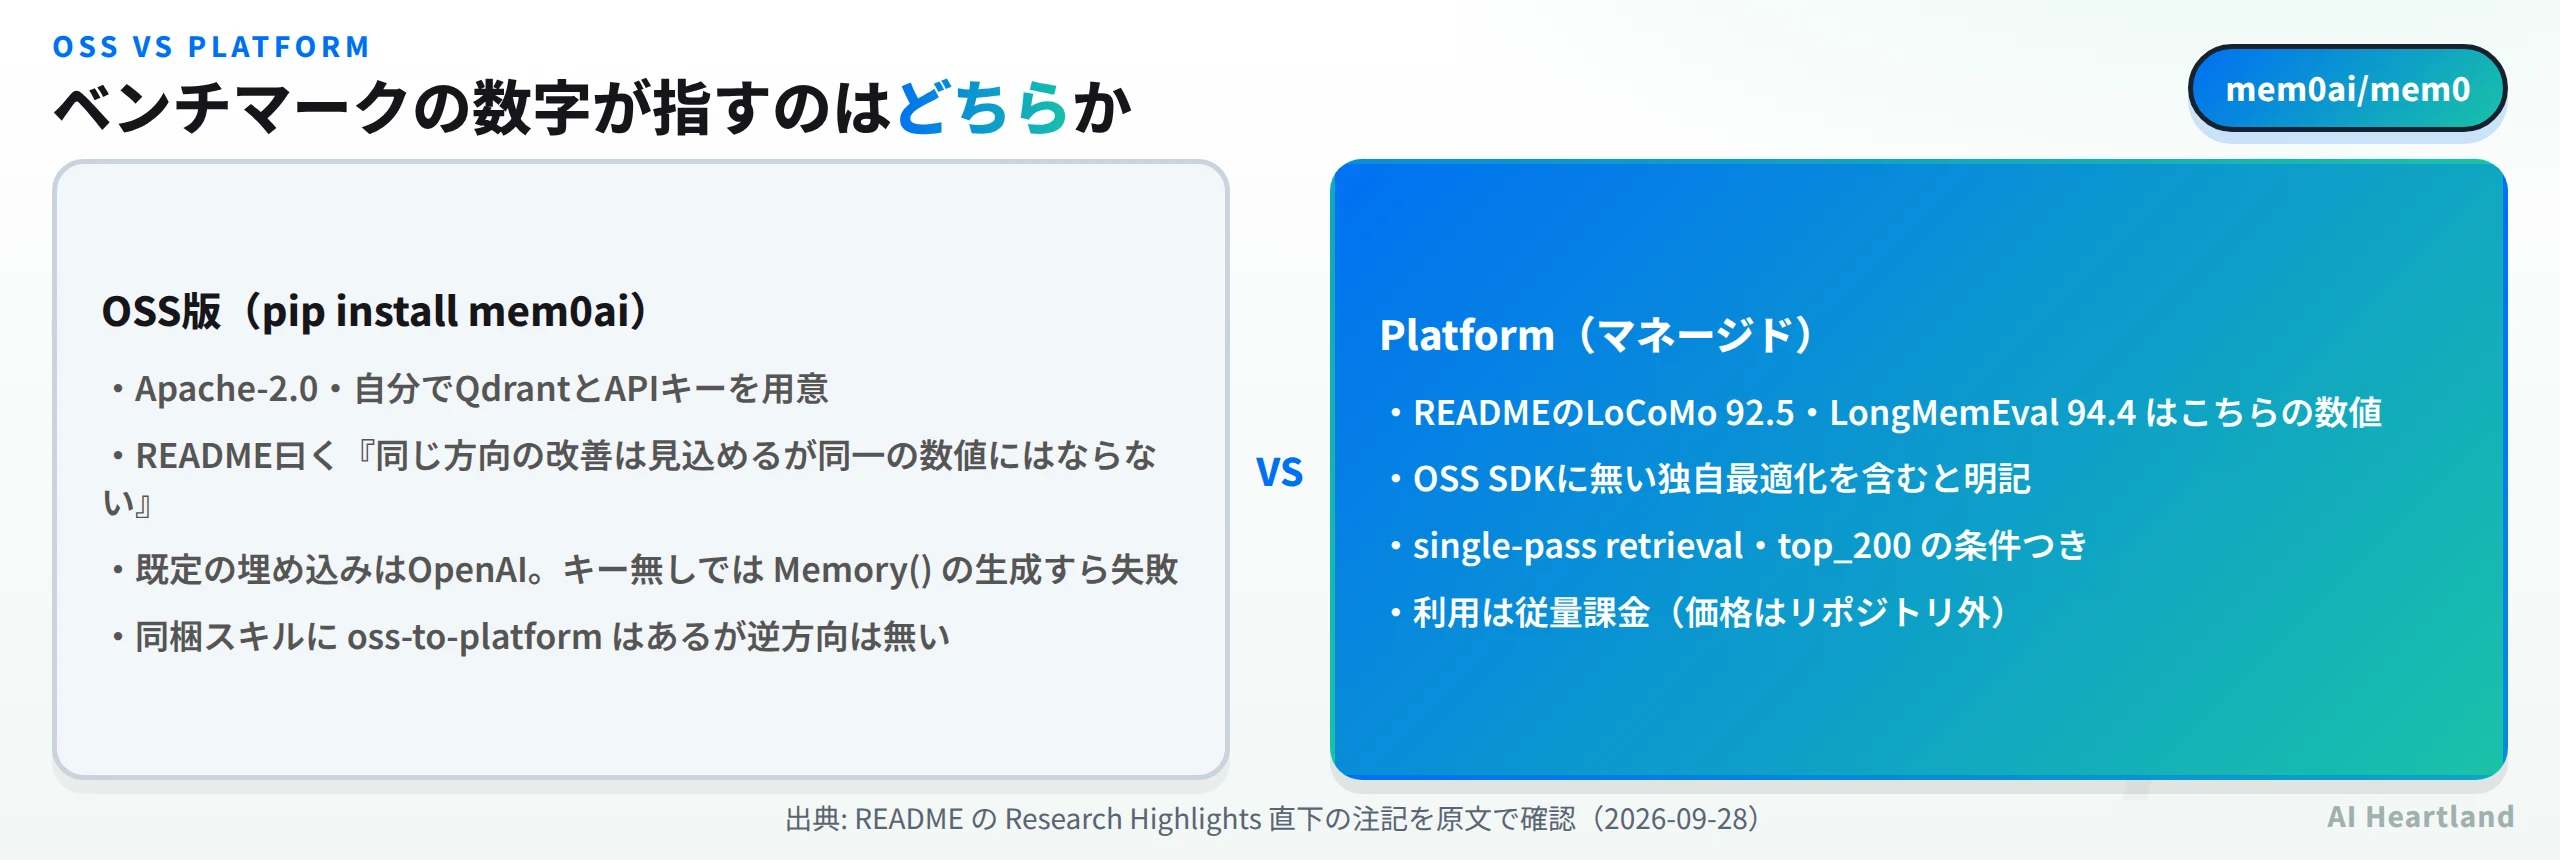
同じ注記には測定条件も書かれている。ベンチマークは「production-representative な同一モデルスタック」で実行し、single-pass retrieval(1回の呼び出し、エージェント的なループ無し)、検索予算は top_200。条件つきの数字であることまで書いてあるので、比較するなら自分の構成も同じ条件に揃える必要がある。
| 見るべき点 | READMEの記載 |
|---|---|
| スコアの対象 | マネージド版(OSS SDKに無い独自最適化を含む) |
| OSS版の期待値 | 「同じ方向の改善は見込めるが同一の数値にはならない」 |
| 検索条件 | single-pass retrieval(1回、ループ無し)/top_200 |
| モデルスタック | 全ベンチマークで同一の production-representative なもの |
ベンダーが公開するスコアの読み方という点では、別の記憶APIを横断比較したsupermemory入門|AI時代のMemory APIをmem0・cogneeと比較も合わせて読むと立体的になる。
OSSと商用の境界:スキル6本が示す導線
mem0 のリポジトリには skills/ があり、コーディングエージェント向けの Agent Skills が6本入っている。中身を見ると、このプロジェクトがどこへ人を導きたいかがよく分かる。
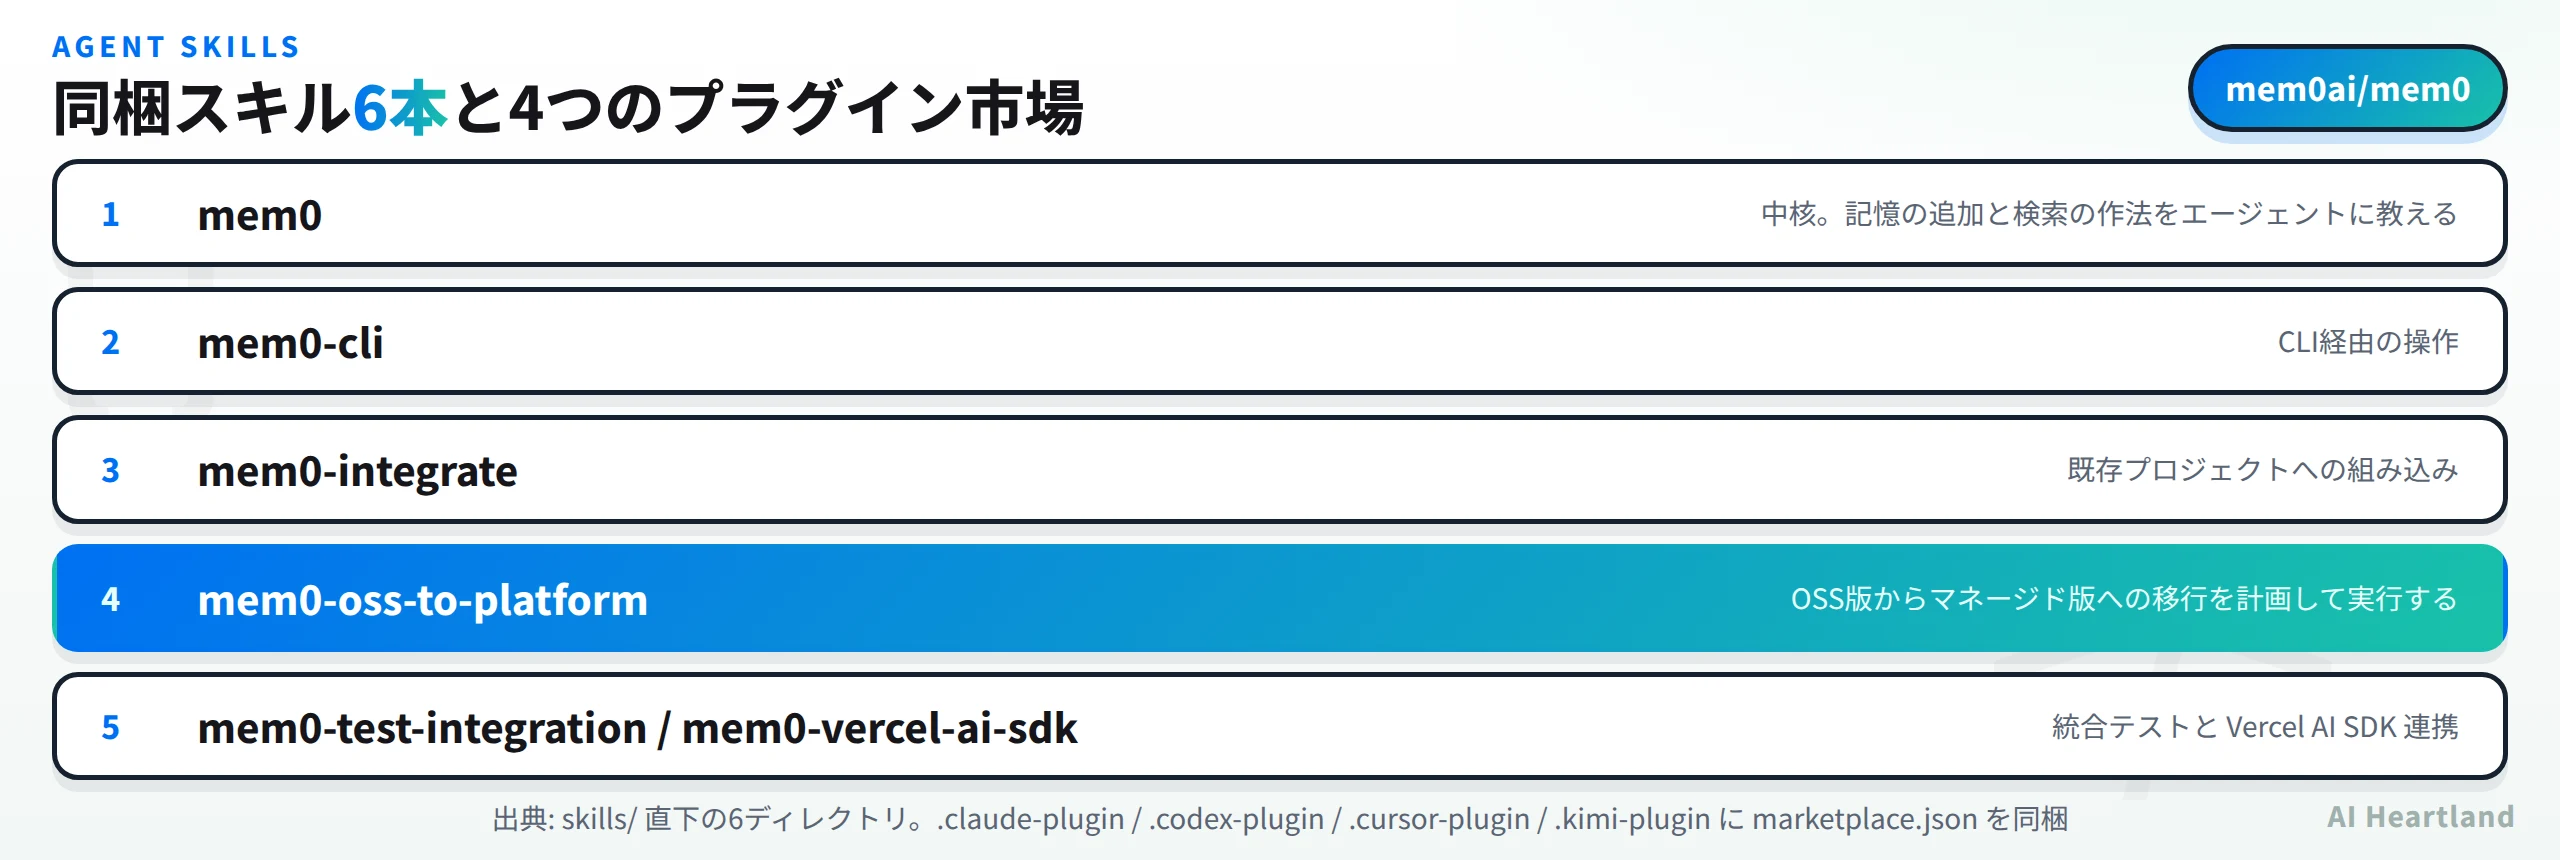
注目したいのは mem0-oss-to-platform だ。SKILL.md の description には「OSS/セルフホストSDK(ローカルの Memory クラス)から Platform/ホスト版SDK(MemoryClient クラス)への移行を計画し、実行する」と書かれ、Python の from mem0 import Memory → MemoryClient、TypeScript の mem0ai/oss → mem0ai という置換まで指定されている。ご丁寧に「ユーザーが『移行』という言葉を使わなくても、既存の mem0 利用をホスト版に移したいのが明らかなら発動する」とまで書いてある。
逆方向、つまりマネージド版からOSS版へ戻すスキルは無い。 これは非難ではなく、事実としての導線の向きだ。OSSを入口に商用サービスへ繋ぐ構造は珍しくないし、Apache-2.0 で公開されている以上、OSS版だけを使い続ける自由はある。ただ「どこまでがOSSの守備範囲か」を最初に線引きしておくと、後から驚かずに済む。
配布先も広い。.claude-plugin/ .codex-plugin/ .cursor-plugin/ .kimi-plugin/ のそれぞれに marketplace.json があり、4つのエージェント環境のプラグイン市場に同時に出している。エージェント側の設定ファイル(AGENTS.md CLAUDE.md LLM.md)もリポジトリ直下に揃っていて、エージェントに読ませる前提で書かれたリポジトリになっている。チーム単位で記憶を共有・統制する話はTencentDB Agent Memoryとは?チームでAIエージェントの記憶を共有・統制する仕組みが近い。
Claude Code / Cursor / 自作"] --> B["mem0 SDK
Python / TypeScript"] A --> C["Agent Skills 6本
4つのプラグイン市場へ配布"] B --> D{"どちらを使うか"} D -- "OSS(Apache-2.0)" --> E["Memory クラス
217MB・36パッケージ"] D -- "マネージド" --> F["MemoryClient
ベンチ値はこちら"] E --> G["LLM 既定 openai
18実装から選択"] E --> H["埋め込み 既定 openai
12実装から選択"] E --> I["ベクタストア 既定 qdrant
24実装から選択"]
セルフホストと計測:テレメトリは既定で有効、送信先はPostHog
ライブラリとして使うほかに、server/ にセルフホスト用のサーバー実装がある。中身は FastAPI・SQLAlchemy・Alembic(マイグレーション)・psycopg(PostgreSQL)で、認証(auth.py・passlib・python-jose)とレート制限(rate_limit.py)、管理用ダッシュボード(dashboard/)まで揃っている。requirements.txt のコメントには「同梱するLLM/埋め込みプロバイダを増やすときは、ここにパッケージを足してイメージを再ビルドし、main.py の BUNDLED_*_PROVIDERS を更新する」と書かれていて、チームで1つのサーバーを共有する運用が想定されている。
この構成で確かめておきたいのがテレメトリだ。mem0/memory/telemetry.py を読むと、既定で有効になっている。
# mem0/memory/telemetry.py(抜粋)
MEM0_TELEMETRY = os.environ.get("MEM0_TELEMETRY", "True")
HOST = "https://us.i.posthog.com"
_DEFAULT_SAMPLE_RATE = 0.1   # MEM0_TELEMETRY_SAMPLE_RATE で変更可
送信先は PostHog の米国エンドポイント。既定のサンプルレートは0.1(10%)で、disable_geoip=True が指定されている。送られる共通プロパティは client_source client_version python_version os os_version os_release processor machine。イベントごとには、コレクション名・ベクトルの次元数・履歴ストア(sqlite)・使っているベクタストア/LLM/埋め込みのクラス名・呼ばれた関数名が付く。記憶の中身そのものは含まれないが、「どの構成で使っているか」はかなり細かく分かる形だ。
サーバー側の server/telemetry.py は、docstring にこう書いてある——「ライブラリと同じ PostHog プロジェクトに送る。共通プロパティはメールアドレスのドメイン、サーバーのバージョン、ランダム生成のインストールUUID。onboarding_completed イベントは運用者が自由記述したユースケース文字列も運ぶ」。メールのドメインと自由記述が乗る点は、社内で立てる前に把握しておきたい。
止め方は明示されている。MEM0_TELEMETRY=false を環境変数に置けばライブラリもサーバーも無効化される(ソースのログ文言にも “Set MEM0_TELEMETRY=false to disable.” と出る)。導入時の手順書に1行入れておけば済む話なので、知っているかどうかだけの問題だ。
連携先の広さも測れる。integrations/ 直下には18のディレクトリがあり、Claude Code・Codex・Cursor・Kimi・DeepSeek・opencode・OpenClaw・Antigravity といったエージェント向けプラグインに加えて、n8n ノード、Zapier、Vercel AI SDK、AWS Strands が並ぶ。記憶を1か所に置いて複数のツールから引く、という使い方を前提にした品揃えになっている。
導入前に押さえる点
実測して分かった注意点を整理しておく。
・既定のままでは外部APIが2つ要る:LLMと埋め込みの両方が openai 既定。自前で完結させたいなら ollama や lmstudio に差し替え、ベクタストアも Qdrant か pgvector を自分で立てる構成になる
・日本語での抽出品質は未知数:記憶の抽出はLLM任せなので、日本語の会話からどれだけ的確な事実を抜けるかはモデル依存。当記事では測っていない
・記憶は上書きされない:新アルゴリズムは ADD only で、UPDATE も DELETE も行わない。矛盾する情報が入ったときの扱いは検索側の融合に委ねられる。長期運用では記憶の肥大化と鮮度の管理を自分で設計する必要がある
・タグは420本と多いがSDK別:v2.2.1 のほかに vercel-ai-v3.0.3 のような連携パッケージのタグが混在する。固定するときは対象を確認する
・テレメトリは既定で有効:MEM0_TELEMETRY=false で止まる。構成情報(ベクタストアやLLMのクラス名)とOS情報が PostHog へ送られる。サーバー版はメールのドメインも乗る
・ライセンスはApache-2.0:LICENSE の実体も Apache License 2.0 だった。MIT前提で扱わないこと
結論として。 mem0 は「記憶の計算を持たない記憶ライブラリ」だ。対応実装が24×18×12と多いのは、記憶の保存先も抽出モデルも埋め込みも自前で選ばせる設計だからで、裏を返せばその3つを用意できて初めて動き出す。217MBという軽さは、埋め込みも検索も外に出した結果であり、既存のベクタDBとLLM契約がある環境に後から足すのに向いている。逆に、手元だけで完結させたい、あるいは観察や要約まで自動でやってほしいなら、設計思想が違う別の選択肢を見たほうがいい。そしてREADMEのスコアは、マネージド版の数字である——この一点だけは、導入判断の前に押さえておきたい。star 66.2k という数字は「多くの人が入口として選んだ」ことを示すが、どこまでをOSSで賄うかは利用者ごとに違う。まず MEM0_TELEMETRY=false と差し替え先のプロバイダを決めてから、小さく試すのが安全な入り方だと思う。
参照ソース
・mem0ai/mem0(公式リポジトリ) — README・mem0/ のソース・skills/・LICENSE を 2026-09-28 に確認(main の 94c3fe9)
・mem0ai(PyPI) — 実際に導入した配布物
・Mem0 公式ドキュメント — READMEから案内されている公式ドキュメント