「なぜ多くのトークンで話す? 少ないトークンで十分」——このひと言のスキルがGitHubで94,643を集めた。caveman は、AIコーディングエージェントの返答から前置き・礼儀表現・埋め草を削って「原始人語(Caveman speak)」にし、出力トークンを平均65%削るスキルだ。ただしこの65%は、条件を外すと簡単に誇張になる。
THE NUMBERS条件込みで読む
削るのは出力トークンだけ。入力は毎ターン増える
65%
出力トークンの平均削減
10タスク・範囲22〜87%
+1.5k
毎ターン足される入力
約1〜1.5k。推論トークンは対象外
30以上
対応エージェント
Claude Code・Codex・Copilot など
30秒でわかる caveman
- ・Claude Code・Codex・Copilot・Gemini など30以上のエージェントに1コマンドで入る、出力トークン圧縮スキル。MIT・Node.js 18以上
- ・削るのは装飾語だけ。コード・URL・コマンド・数値は変えない。推論には介入しない
- ・65%は出力トークンのみの平均(10タスク・22〜87%)。スキル自体が毎ターン約1〜1.5kの入力を足すので、セッション全体の節約は65%より小さい
- ・元々短い応答中心の使い方では差し引きマイナスになりうる。長い説明・デバッグ相談ほど効く
- ・強度は lite / full / ultra / 文言文の4段階。コードを削る ponytail、工程を整える superpowers とは層が違うので併用できる
Claude Code そのものの導入・運用の全体像は Claude Code|2026年版・インストールからCLAUDE.md・Hooks・本番運用までの実装手引き にまとめてある。この記事は、2026年4月の初版を、★43,556→94,643への伸び・付属コマンドの拡充・README の “Honest number” 追記を反映して刷新したものだ。
cavemanとは——「出力を削る」トークン削減スキルの正体
caveman はJuliusBrussee氏が開発したスキルで、実体はプロンプトとフックの組み合わせだ。出力トークンの単価は入力より高いことが多く、同じ情報量でも長々と返すエージェントは費用と待ち時間を膨らませる。caveman は最終的な言語化の段階だけを短くする。
| 削るもの | 削らないもの |
|---|---|
| 「喜んでお手伝いします!」などの前置き | コードブロックの中身 |
| just / really / basically などの埋め草 | URL・ファイルパス・コマンド |
| 不要な冠詞・定型のヘッジ表現 | バージョン番号・日付 |
| 「何かご不明点があれば…」のような締め、繰り返しの確認 | 技術的に意味のある固有名詞 |
README とリポジトリ構成から読み取れる動作は、Caveman構文のルールをシステム文脈に差し込むプロンプト注入、Claude Code / Codex / Gemini CLI でモードを自動で有効化するセッション開始フック、強度をディスク上に持つセッションフラグ、セッションログを読んで節約を集計する /caveman-stats の4つ。主要言語はJavaScript(約69%)で、Python・シェルスクリプトが補助する。Claude Skillsの仕組み——必要なときだけロードされるコンテキストの単位——を、「毎ターンの言い方を上書きする常駐ルール」として使った例だ。
公式READMEのBefore/Afterでは、Reactの再レンダリングについての応答が69トークンから19トークンに減る(72%減)。
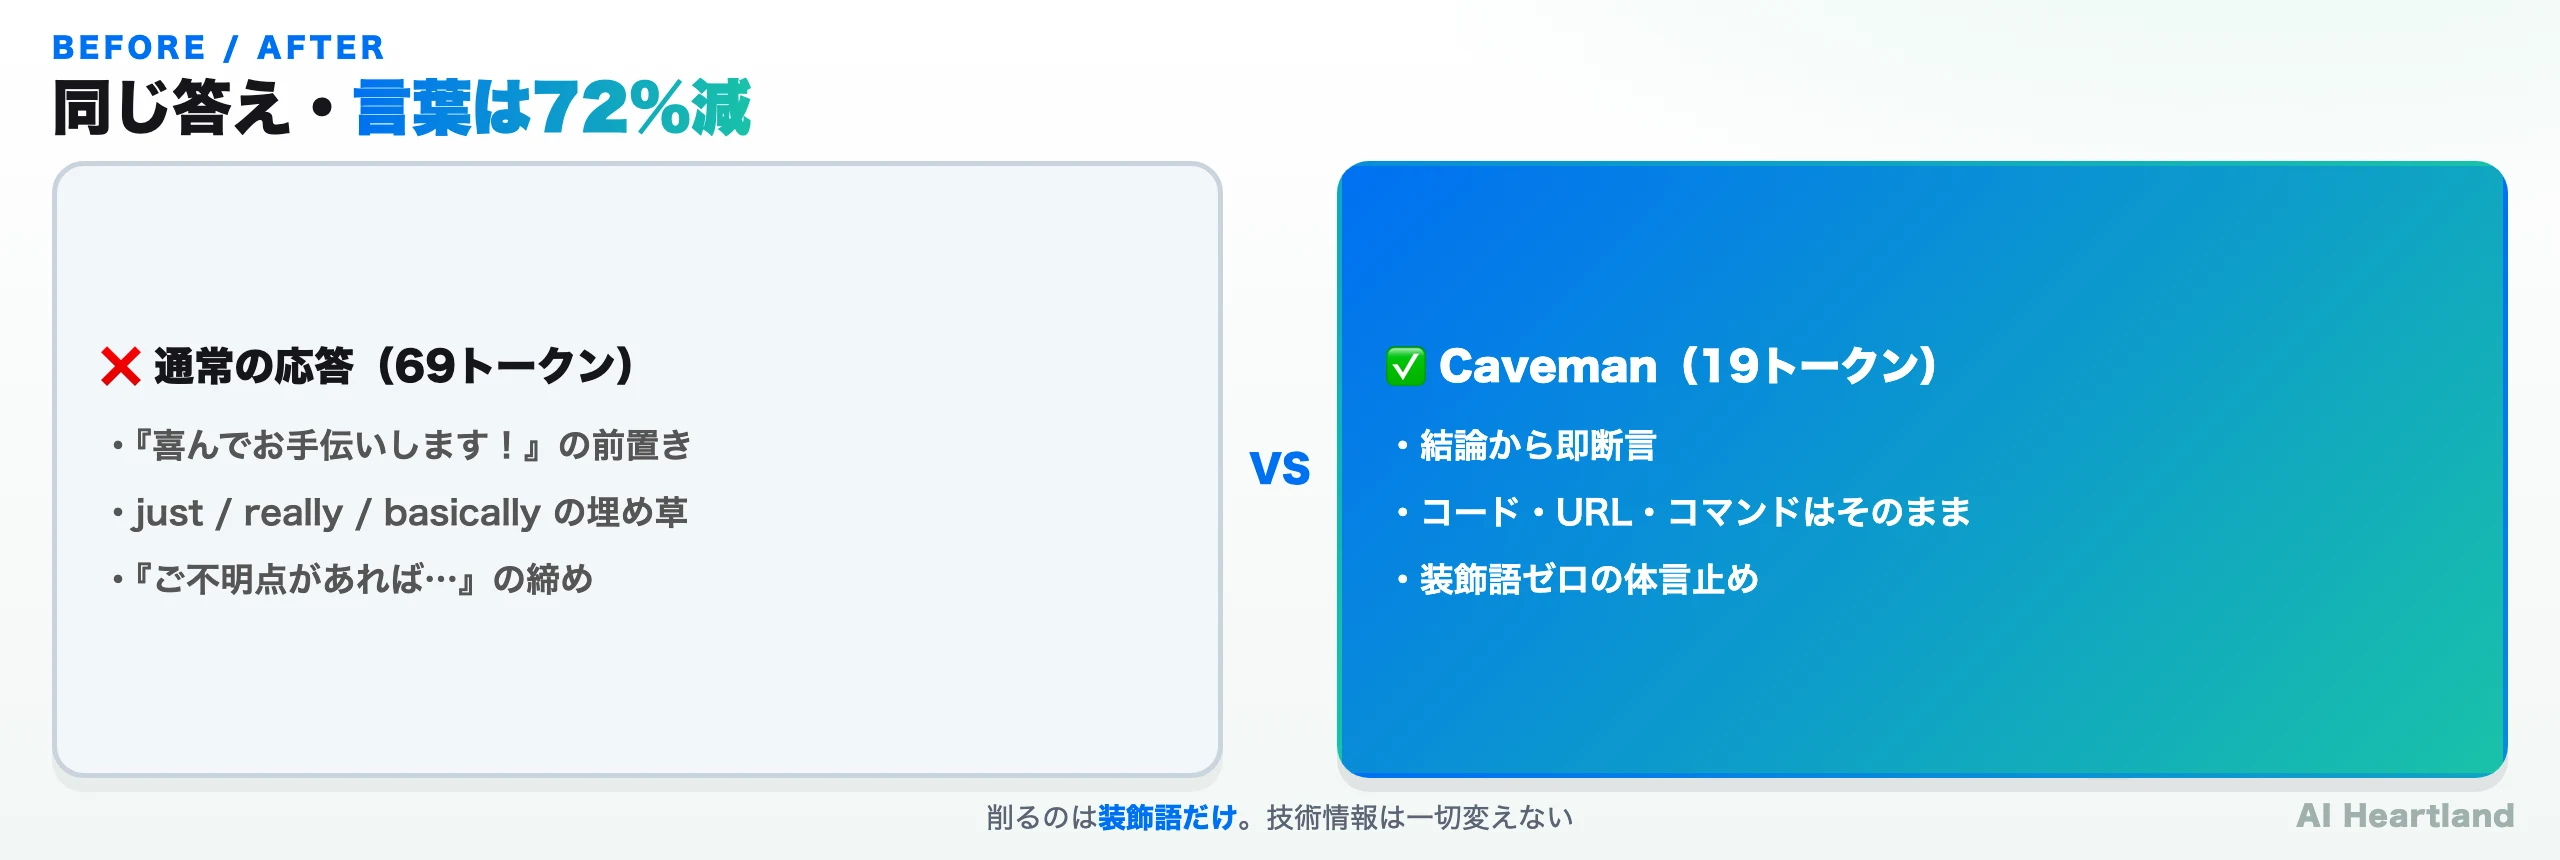
通常のClaude(69トークン)
“The reason your React component is re-rendering is likely because you’re creating a new object reference on each render cycle. When you pass an inline object as a prop, React’s shallow comparison sees it as a different object every time, which triggers a re-render. I’d recommend using useMemo to memoize the object.”
caveman(19トークン)
“New object ref each render. Inline object prop = new ref = re-render. Wrap in
useMemo.”
診断(新しい参照が毎回作られる)と修正方針(useMemoで包む)は完全に一致している。減ったのは周りの装飾だけだ。「言い方の癖」をルールで矯正しているだけなので、モデルのバージョンが変わっても壊れにくい。
「65%削減」の正しい読み方——誇張しない実測条件
READMEには、通常の応答とcaveman適用後を同じ質問でClaude APIに投げ、出力トークンを比べた10タスクの実測が載っている。
| タスク | 通常 | caveman | 削減率 |
|---|---|---|---|
| Reactの再レンダリングバグを説明 | 1,180 | 159 | 87% |
| 認証ミドルウェアのトークン期限修正 | 704 | 121 | 83% |
| PostgreSQL接続プールのセットアップ | 2,347 | 380 | 84% |
| git rebase vs merge の説明 | 702 | 292 | 58% |
| コールバックをasync/awaitにリファクタ | 387 | 301 | 22% |
| マイクロサービス vs モノリスの設計 | 446 | 310 | 30% |
| セキュリティ観点のPRレビュー | 678 | 398 | 41% |
| Docker マルチステージビルド | 1,042 | 290 | 72% |
| PostgreSQL レース条件のデバッグ | 1,200 | 232 | 81% |
| React エラーバウンダリの実装 | 3,454 | 456 | 87% |
| 平均 | 1,214 | 294 | 65% |
削減率が低い(22%、30%)のは設計相談や抽象的な説明で、元々情報密度が高い。長文になりがちなエラー説明・セットアップ手順では80%超が出る。長く喋りがちな場面ほどよく効く。
README は “Honest number” として3つの但し書きを自分から書いている。①原文は “Input and reasoning tokens are untouched”、つまり65%は出力トークンに限った削減率で、リクエスト全体のコストではない。②ルールをシステム文脈に注入するので、毎ターン約1〜1.5kの入力トークンが増える。③すでに簡潔なワークロードでは net-negative(差し引きマイナス) になりうる。紹介記事やSNSでは②③が落ちて「65%コスト削減」と一人歩きしやすい。
NET SAVING差し引きで見る
出力の削減と入力の増加、どちらが勝つかで効果が決まる
減る(出力)
- 前置き・埋め草・礼儀表現
- 長い説明・セットアップで80%超
- 設計相談では22〜30%
増える(入力)
- ルール注入で毎ターン+1〜1.5k
- 短い一問一答では差し引きマイナス
- caveman-compress で一部相殺
支点は「自分のセッションの入出力の比率」
自分のワークロードで確かめるなら、benchmarks/ 同梱のハーネスを使うか、最小構成で通常とcavemanのプロンプトを同じ質問で投げ、出力の削減率と入力の差を両方見る。
import anthropic

client = anthropic.Anthropic()
QUESTION = "Explain why a React component re-renders and how to fix it"

# 通常モード
normal = client.messages.create(
    model="claude-sonnet-4-6",
    max_tokens=1024,
    messages=[{"role": "user", "content": QUESTION}],
)

# caveman ルールを system に付与
caveman = client.messages.create(
    model="claude-sonnet-4-6",
    max_tokens=1024,
    system=(
        "Terse like caveman. Technical substance exact. Only fluff die. "
        "Drop: articles, filler (just/really/basically), pleasantries, hedging. "
        "Fragments OK. Short synonyms. Code unchanged."
    ),
    messages=[{"role": "user", "content": QUESTION}],
)

no = normal.usage.output_tokens
cv = caveman.usage.output_tokens
print(f"normal={no}  caveman={cv}  output_reduction={(1 - cv / no) * 100:.0f}%")

# 但し書き②を可視化:入力側の増加も見る
print(f"input: normal={normal.usage.input_tokens}  caveman={caveman.usage.input_tokens}")
セッション単位の試算もしておく(説明用の例。実際は自分のモデル・料金で計算する)。入力と出力の単価を仮に1:5とし、通常は入力500・出力1,214トークン(ベンチマーク平均)、caveman適用後は出力294・入力は注入で+1,200の1,700トークンとする。「入力×1+出力×5」で見ると、通常 500 + 1214×5 = 6,570、caveman 1,700 + 294×5 = 3,170 で、総コストの削減は約52%と出力だけ見た65%より小さい。元の出力が短い一問一答(入力500・出力200)では、通常 1,500 に対しcavemanは出力を120まで削れても 1,700 + 120×5 = 2,300 となり、入力の増加分が勝って総コストが増える。導入判断は「出力削減率」ではなく「自分のセッションの入出力の比率」で行う。
cavemanはClaude Code専用か——Codex・Copilotでも使えるのか
日本語では「原始人スキル」と呼ばれ、codex 原始人 github copilot 原始人 のように別のエージェント名と組み合わせて探されている。caveman は Claude Code 専用ではない。公式READMEの1行目が「Claude Code、Codex、Gemini、Cursor、Windsurf、Cline、Copilot、その他30以上のエージェント向けのスキル/プラグイン」と明記している。ただし削るのは返答の側なので、効き方は「どのツールか」より「どういう使い方か」で決まる。返答が長い使い方ほど効き、短い応答を高頻度で返す使い方では薄い。
# macOS / Linux / WSL / Git Bash(Node.js 18以上が必要)
curl -fsSL https://raw.githubusercontent.com/JuliusBrussee/caveman/main/install.sh | bash

# Windows PowerShell 5.1+
irm https://raw.githubusercontent.com/JuliusBrussee/caveman/main/install.ps1 | iex

# Claude Code のプラグインマーケットプレイス経由
claude plugin marketplace add JuliusBrussee/caveman
claude plugin install caveman@caveman
インストーラは環境にあるエージェントを自動で検出してスキルとフックを置く。curl … | bash は、実行前に install.sh を開いて中身を読むか、手元にダウンロードしてから実行するのが安全だ。Claude Codeのプラグイン経由では、スキル本体・SessionStart フック・ステータスライン([CAVEMAN] バッジ)の提案までを行い、既存のステータスライン設定は壊さない。アンインストールはインストーラの案内か claude plugin uninstall で戻せる。
フックを使わないエージェントや、プロジェクト単位で常時オンにしたいときは、ルールファイルに次を置くだけでも動く。コミットすればチーム全体に広がる。繰り返すワークフローの規範をメモリファイルに固定するのはClaude Codeのベストプラクティスでも定石とされている。
# コミュニケーションスタイル(CLAUDE.md に追記)
caveman mode. no filler. fragments ok. code exact.
drop: pleasantries, hedging, articles, "I'd be happy to".
pattern: [thing] [problem] [fix]. short. direct.
off: "stop caveman" / "normal mode".
4つの強度モードと付属コマンド
| モード | トリガー | 同じ質問への応答 |
|---|---|---|
| lite | /caveman lite |
“Your component re-renders because you create a new object reference each render. Inline object props fail shallow comparison every time. Wrap it in useMemo.” |
| full(既定) | /caveman full |
“New object ref each render. Inline object prop = new ref = re-render. Wrap in useMemo.” |
| ultra | /caveman ultra |
“Inline obj prop → new ref → re-render. useMemo.” |
| 文言文(wenyan) | /caveman wenyan |
“物出新參照,致重繪。useMemo Wrap之。” |
モードはセッション終了か normal mode での解除まで続く。読みやすさが要る文書はlite、技術の議論を速く回すならfull/ultra。文言文は日本語話者には読みにくいので、読み返さない中間メモ向きだ。ルールは英語だが日本語の出力にも効き、「〜させていただきます」のような過剰敬語、「まず最初に」のようなつなぎ、「良い質問ですね」の前置きが削られる。社外向けの文章をそのまま貼る用途ではliteが無難だ。長時間セッションでモードが通常に戻る「フィラードリフト」も報告されており、READMEは “ACTIVE EVERY RESPONSE” のルールで対策しているが、ultraで長く回すなら折を見て /caveman full などで貼り直す。
付属コマンドは次の4つ。
・/caveman-commit:Conventional Commits形式・件名50文字以内のコミットメッセージ。WhatではなくWhyを書く
・/caveman-review:PRコメントを L42: 🔴 bug: user null. Add guard. の1行に圧縮する。チームで使うなら記法を先に共有する
・/caveman-stats:セッションのトークン使用量と累計節約。但し書き②③を自分のデータで確かめる場所
・/caveman-compress <file>:CLAUDE.md などメモリファイルをCaveman構文に書き換え、入力トークンを削る(公式実測で約46%減)
caveman(モード)が「話す」出力を削り、caveman-compress が「読む」入力を削る。前者だけでは入力が増えるが、後者を併せると総コストの釣り合いが取りやすい。
# メモリファイルを圧縮(バックアップ自動生成)
/caveman-compress CLAUDE.md

# 生成物:
#   CLAUDE.md          … 圧縮済み(Claudeが毎回読む)
#   CLAUDE.original.md … 人間可読のバックアップ(自分が編集する)
セキュリティスキャナの誤検知
- ・
caveman-compressはサブプロセス実行とファイル書き換えのパターンを含むため、Snykなどが「High Risk」と警告することがある。READMEにもあるとおりヒューリスティックによる誤検知だ - ・とはいえ「MITだから安全」と鵜呑みにせず、公開リポジトリのソースを自分で確かめ、組織のポリシーに沿って判断する。第三者スキル(SkillsLLM等)の自動監査を通過している点も確認材料になる
新しめの機能として、MCPツールの説明文を圧縮する caveman-shrink(MCPミドルウェア)や、役割分担したサブエージェント群 cavecrew-*(investigator / builder / reviewer)も加わった。
caveman vs ponytail vs superpowers——同じ「スキル」でも攻める層が違う
| スキル | 開発元 | 狙う対象 | 主な効果(自己申告) | ライセンス |
|---|---|---|---|---|
| caveman | JuliusBrussee | エージェントの出力(話す量) | 出力トークン平均65%減(22〜87%) | MIT |
| ponytail | DietrichGebert | エージェントが書くコード(実装量) | コード量約54%減・約20%安・約27%速い | MIT |
| superpowers | obra | 開発の工程(進め方の方法論) | ブレスト→計画→TDD→レビューを規律化 | MIT |
| Claude Skills | Anthropic | 上記すべてが載る仕組みの土台 | オンデマンドで能力をロードする機構 | — |
ponytail は「一番怠けたシニア開発者」のように、書く前に「そもそも要る?→既にある?→標準ライブラリで足りる?」とYAGNIのはしごを上る。superpowers はトークンに直接触れず、開発プロセスそのものを規律化する。cavemanとponytailは別の蛇口を締めるトークン削減系、superpowersは方法論系なので、3つ同時に入れても衝突しない。
FOUR LAYERS削減の4層
caveman は出力層の即効薬。層が違えば足し算で効く
-
出力
caveman
話す量を削る。説明・レビュー・デバッグ相談で効く
-
入力
caveman-compress・プロンプトキャッシュ
CLAUDE.md など読む量を削る
-
コード
ponytail
書くコードを削る。実装系タスクで効く
-
モデル
Haiku などへの切り替え
単価そのものを下げる
AIエージェントのトークン最適化の文脈では、cavemanは出力層の即効薬だ。説明・レビュー・デバッグ相談が多いならcaveman、機能実装が多いならponytailが効きやすい。両方多いなら両方入れて、Claude API料金のダッシュボードで実測しながら調整する。順番は、まずcaveman単体を1〜2週間回して /caveman-stats で入出力の比率を見る。出力が支配的で効いていると確かめたら入力側の caveman-compress を足し、コードの書きすぎが気になったらponytailを足す。一度に全部入れると、どれが効いているのか切り分けられなくなる。
caveman は同じ開発者の一連のプロジェクトの中核でもある。
| プロジェクト | 役割 |
|---|---|
| caveman | エージェントの出力を圧縮(本記事の主役) |
| caveman-code | ターミナルエージェント全体の最適化(Codex比 約2倍のトークン削減を主張) |
| cavemem | セッションをまたぐメモリを圧縮して保持 |
| cavekit | 自然言語→仕様→並列ビルド→検証のスペック駆動ループ |
| cavegemma | 圧縮を組み込んでファインチューンしたGemma |
94,643★を集めた理由は、ミームのような見た目に反して実際に動き、READMEが net-negative の可能性まで自分から書いていることにある。caveman はトークン最適化の最初の一手として導入コストが低い。ただし「口を小さくする道具であって、脳を小さくする道具ではない」。自分のタスク分布で /caveman-stats を眺めるところから始めるとよい。