CrewAI(クルーAI)入門として、役割を持った複数のAIエージェントを「クルー(船の乗組員)」のように協調させるPython製マルチエージェントフレームワークの使い方を解説します。
CrewAIは、調査担当・執筆担当・レビュー担当といった役割を自然言語で定義し、それぞれにツールと目標を与えてチームとしてタスクを完了させる仕組みです。GitHubで58,000star超(2026-09-17実測)を集めており、2026年のマルチエージェント入門の定番になっています。
本記事は、Crew/Agent/Task/Processの4概念・インストールから実行までの使い方・料金体系・LangGraphやAutoGenとの違い・本番運用・落とし穴までを一枚で俯瞰できる入門ガイドとしてまとめます。
- ・CrewAIとは、役割(role)を持つエージェントを「クルー」として協調させるPython製マルチエージェントフレームワーク。
- ・中核はAgent(役割)・Task(仕事)・Crew(チーム)・Process(進め方)の4概念。
- ・使い方は2系統:
pip install crewaiの直接コードと、crewai create crewのプロジェクト生成(デフォルトJSON、--classicでYAML)。 - ・料金はOSS版が無料(MIT)、チーム運用向けの有償CrewAI AMPは別軸。
- ・LangGraphが「厳密な制御」、AutoGenが「保守モード」なのに対し、CrewAIは「宣言的な役割分担」が強み。
AIエージェントそのものの仕組みや代表的フレームワークの全体比較は AIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証 をご覧ください。本記事はその中の「マルチエージェント協調」を担うCrewAIに絞った各論です。
要点まとめ:CrewAIとは何か
CrewAIは、役割(role)・目標(goal)・背景(backstory)を持つ複数のAIエージェントを「クルー」として編成し、分業でタスクを完了させるPython製フレームワークです。中核はAgent・Task・Crew・Processの4概念だけで、pip install crewaiから数十行で動きます。使い方は素のPythonコードで書く方法と、公式CLI crewai create crew でプロジェクトを生成する方法(デフォルトはJSON構成、--classicで従来のYAML構成)の2系統があります。料金はOSS本体が無料・MITライセンスで、チームでの運用管理には有償のCrewAI AMP(旧Enterprise)があります。LangGraph・AutoGen・Mastra・OpenAI Agents SDKといった競合とは設計思想が異なり、「宣言的な役割分担のしやすさ」がCrewAIの強みです。
背景と文脈:なぜCrewAIがマルチエージェント入門の定番なのか
CrewAIが2026年のマルチエージェント入門の定番になっている背景には、単一LLMの限界があります。1つのプロンプトに「調査して」「書いて」「校正して」を全部詰め込むと、指示が長くなるほど精度が落ちます。これを「役割ごとに専門化したエージェントへ分業する」ことで解決しようとするのがマルチエージェント設計で、CrewAIはその中でも学習コストの低さを武器にしています。
公式は CrewAI を「LangChainや他のエージェントフレームワークから完全に独立した、ゼロから作られた軽量で高速なPythonフレームワーク」と説明しています。初期バージョンはLangChainに依存していましたが、現在は独立実装に移行しており、依存が軽く起動が速いのが実装上の特徴です。公式の学習コースには100,000人超の開発者が認定を受けており、「まず動かして概念を掴む」入門用途での採用が広がっています。
同じ「制御フローを書く」系のフレームワークである LangGraph入門|とは?状態遷移でマルチエージェントを作る基本とLangChainとの違い・比較 も合わせて読むと、CrewAIの「宣言的な役割分担」とLangGraphの「グラフで厳密に状態遷移を書く」設計思想の違いがはっきりします。
詳しく見ていく:CrewAIの使い方と4つの基本概念、インストール〜実行
Crew/Agent/Task/Processの4概念
CrewAIは、たった4つの概念を理解すれば全体像が掴めます。
・Agent(エージェント):役割(role)・目標(goal)・背景設定(backstory)を持つ自律ユニット。ツールを装備でき、自分の担当タスクを判断しながら実行する
・Task(タスク):エージェントに渡す具体的な仕事。説明(description)と期待する成果物(expected_output)、担当エージェントを指定する
・Crew(クルー):エージェントとタスクをまとめたチーム。kickoff()で実行を開始する
・Process(プロセス):クルーがタスクをどの順序・体制で進めるか。SequentialとHierarchicalの2種類がある
この4つの関係は「Agentが人、Taskが仕事、Crewがチーム、Processが進め方のルール」と覚えると直感的です。
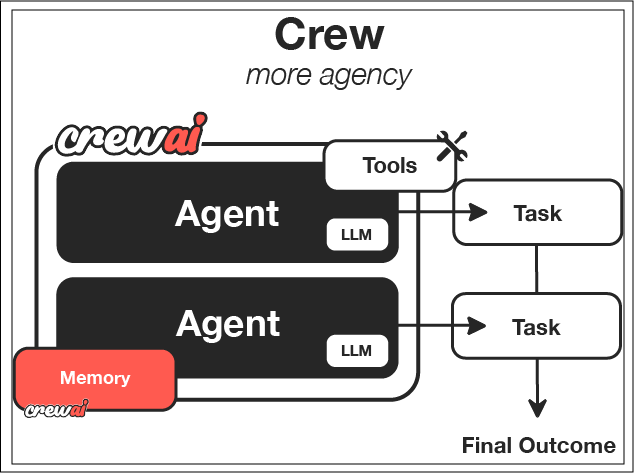
Crews と Flows
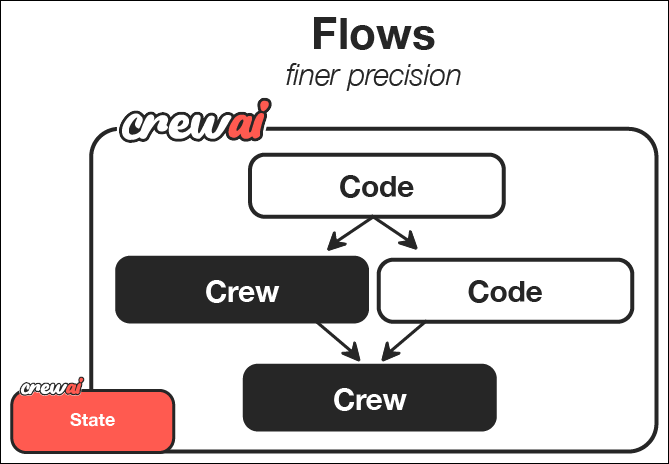
CrewAIにはもう一段上のレイヤーとして「Flows」があります。CrewとFlowsは目的が異なります。
・Crews:自律的に協調するエージェントのチーム。役割ベースで柔軟に判断する。”任せる”側
・Flows:イベント駆動の本番向けワークフロー。状態の永続化・条件分岐・実行制御をPythonで厳密に書ける。”制御する”側
実務では、Flowsで全体の流れ(入力→Crew実行→保存)を管理し、判断が要る部分だけCrewに委譲する組み合わせが定石です。入門段階ではまずCrewだけで十分動きます。
インストール(pip / uv)
CrewAIはPython 3.10〜3.13が対象です。公式はパッケージ管理に高速な uv を推奨していますが、通常の pip でも導入できます。
# uvでライブラリとして導入する場合(高速)
uv pip install crewai

# 通常のpipでも導入可能
pip install crewai

# crewai CLI(create crew等)をグローバル導入する場合は公式推奨のuv tool install
uv tool install crewai

# ツール群(検索・ファイル読み込み等)も含める場合
uv pip install 'crewai[tools]'
ModuleNotFoundError: No module named 'tiktoken' のようなエラーが出た場合は uv pip install 'crewai[embeddings]' を試すと解消することがあります(tiktokenはpyproject.tomlのembeddingsextra配下の依存として定義されており、README本文の手順ではなくextras定義由来のトラブルシューティングです)。
使い方1:CLIでプロジェクトを生成する(デフォルトJSON/--classicでYAML)
公式が「Getting Started」の標準手順として案内しているのは、CLIでプロジェクト一式を生成する方法です。v1.15系で挙動が変わっており、デフォルトはJSON構成、config/agents.yamlのような従来のYAML構成が欲しい場合は--classicフラグを付けます(crewai create crew --helpの説明文で確認済み)。
crewai create crew my_project          # デフォルト:JSON構成
crewai create crew my_project --classic  # 従来のPython/YAML構成
実際にフラグなしで実行すると対話ウィザードでロール・ゴール・バックストーリーとタスクを1件ずつ入力する方式になり、生成される構成は次の通りでした(v1.15.21で実行し、空ディレクトリも含めて実物と突合済み)。
my_project/
├── pyproject.toml
├── README.md
├── crew.jsonc            # クルー設定・タスク・processを定義
├── agents/
│   └── researcher.jsonc  # role/goal/backstory/llm/toolsを定義
├── knowledge/
│   └── user_preference.txt
├── skills/                # カスタムスキル用(空)
└── tools/                 # カスタムツール用(空)
--classicを付けた場合は、src/<project_name>/配下にmain.py(エントリーポイント)・crew.py(Crewの定義)・config/agents.yaml・config/tasks.yamlという旧来のPython/YAML構成が生成され、トップレベルにもtests/(空)とAGENTS.mdが追加されます(これも実行して確認)。役割やゴールをコードでなくJSON(または--classicならYAML)に書けるため、非エンジニアともエージェント設計をレビューしやすいのがどちらの構成にも共通する利点です。
使い方2:Pythonで直接定義する最小コード
概念を素早く試したい場合は、Pythonコードで直接Agent/Task/Crewを定義する書き方も使えます。
from crewai import Agent, Task, Crew, Process

researcher = Agent(
    role="シニアAIリサーチャー",
    goal="{topic} に関する最新動向を正確に調べる",
    backstory="あなたは技術トレンドの調査に長けた専門家です。",
)
writer = Agent(
    role="技術ライター",
    goal="調査結果を初心者向けの日本語記事にまとめる",
    backstory="あなたは難しい技術を平易に書くのが得意なライターです。",
)

research_task = Task(description="{topic} について主要な動向を3点調べる",
                      expected_output="箇条書き3点のリサーチメモ", agent=researcher)
write_task = Task(description="リサーチメモをもとに初心者向け記事を書く",
                   expected_output="見出し付きのMarkdown記事", agent=writer)

crew = Crew(agents=[researcher, writer], tasks=[research_task, write_task],
            process=Process.sequential)
result = crew.kickoff(inputs={"topic": "CrewAI"})
print(result)
Sequentialなのでresearch_taskの出力が自動的にwrite_taskの文脈に渡り、「リサーチャーが調べ、その出力を受けてライターが記事を書く」分業がこの十数行で動きます。
Process・Tools・Memory・Knowledge
入門の最小例を超えて、実務で使う4つの機能を押さえます。
・Process.hierarchical:マネージャーエージェントがどのエージェントに何を任せるかを動的に判断して委譲する。manager_llmまたはmanager_agentの指定が必須
・Tools:tools=[...]でAgentに装備させる「手足」。crewai_toolsパッケージにWeb検索・ファイル読み込み・コード実行など多数が用意されている
・Memory:memory=Trueで有効化。CrewAIはメモリアーキテクチャを単一のMemoryクラスに統合しており、remember(content, scope, categories, ...)で保存、recall(query, scope, categories, limit, depth, ...)で意味的類似度・新しさ・重要度を加味した検索ができる(実装の引数順はキーワード引数指定が前提)。既定の保存先はLanceDBで、CREWAI_STORAGE_DIR未設定時はOS別のアプリデータディレクトリ(appdirs.user_data_dir)、設定時は$CREWAI_STORAGE_DIR/memory
・Knowledge:エージェントが参照する「事前に与える参考資料」。Memoryが「過去の経験」なのに対しKnowledgeは「事前知識」という違いがある。PDF/CSV/JSON/テキストなど多様なソースに対応
crew = Crew(
    agents=[researcher, writer, reviewer],
    tasks=[research_task, write_task, review_task],
    process=Process.hierarchical,
    manager_llm="gpt-4o",   # マネージャー役のLLM
    memory=True,            # Memoryを有効化
)
エージェント数が増え、割り当てを動的に最適化したいときはHierarchicalが効きますが、その分トークン消費と非決定性が増えます。最初はSequentialから始めるのが無難です。
Memoryはエージェントが実行中に得た「過去の経験」(remember/recallで保存・検索)、Knowledgeは実行前に人間が与える「事前の参考資料」です。両方を
memory=Trueとknowledge_sources=[...]で同時に有効化しても役割は競合しません。迷ったら「これはエージェントが自分で学んだことか、こちらが渡した資料か」で切り分けます。CrewAIのアーキテクチャと仕組み
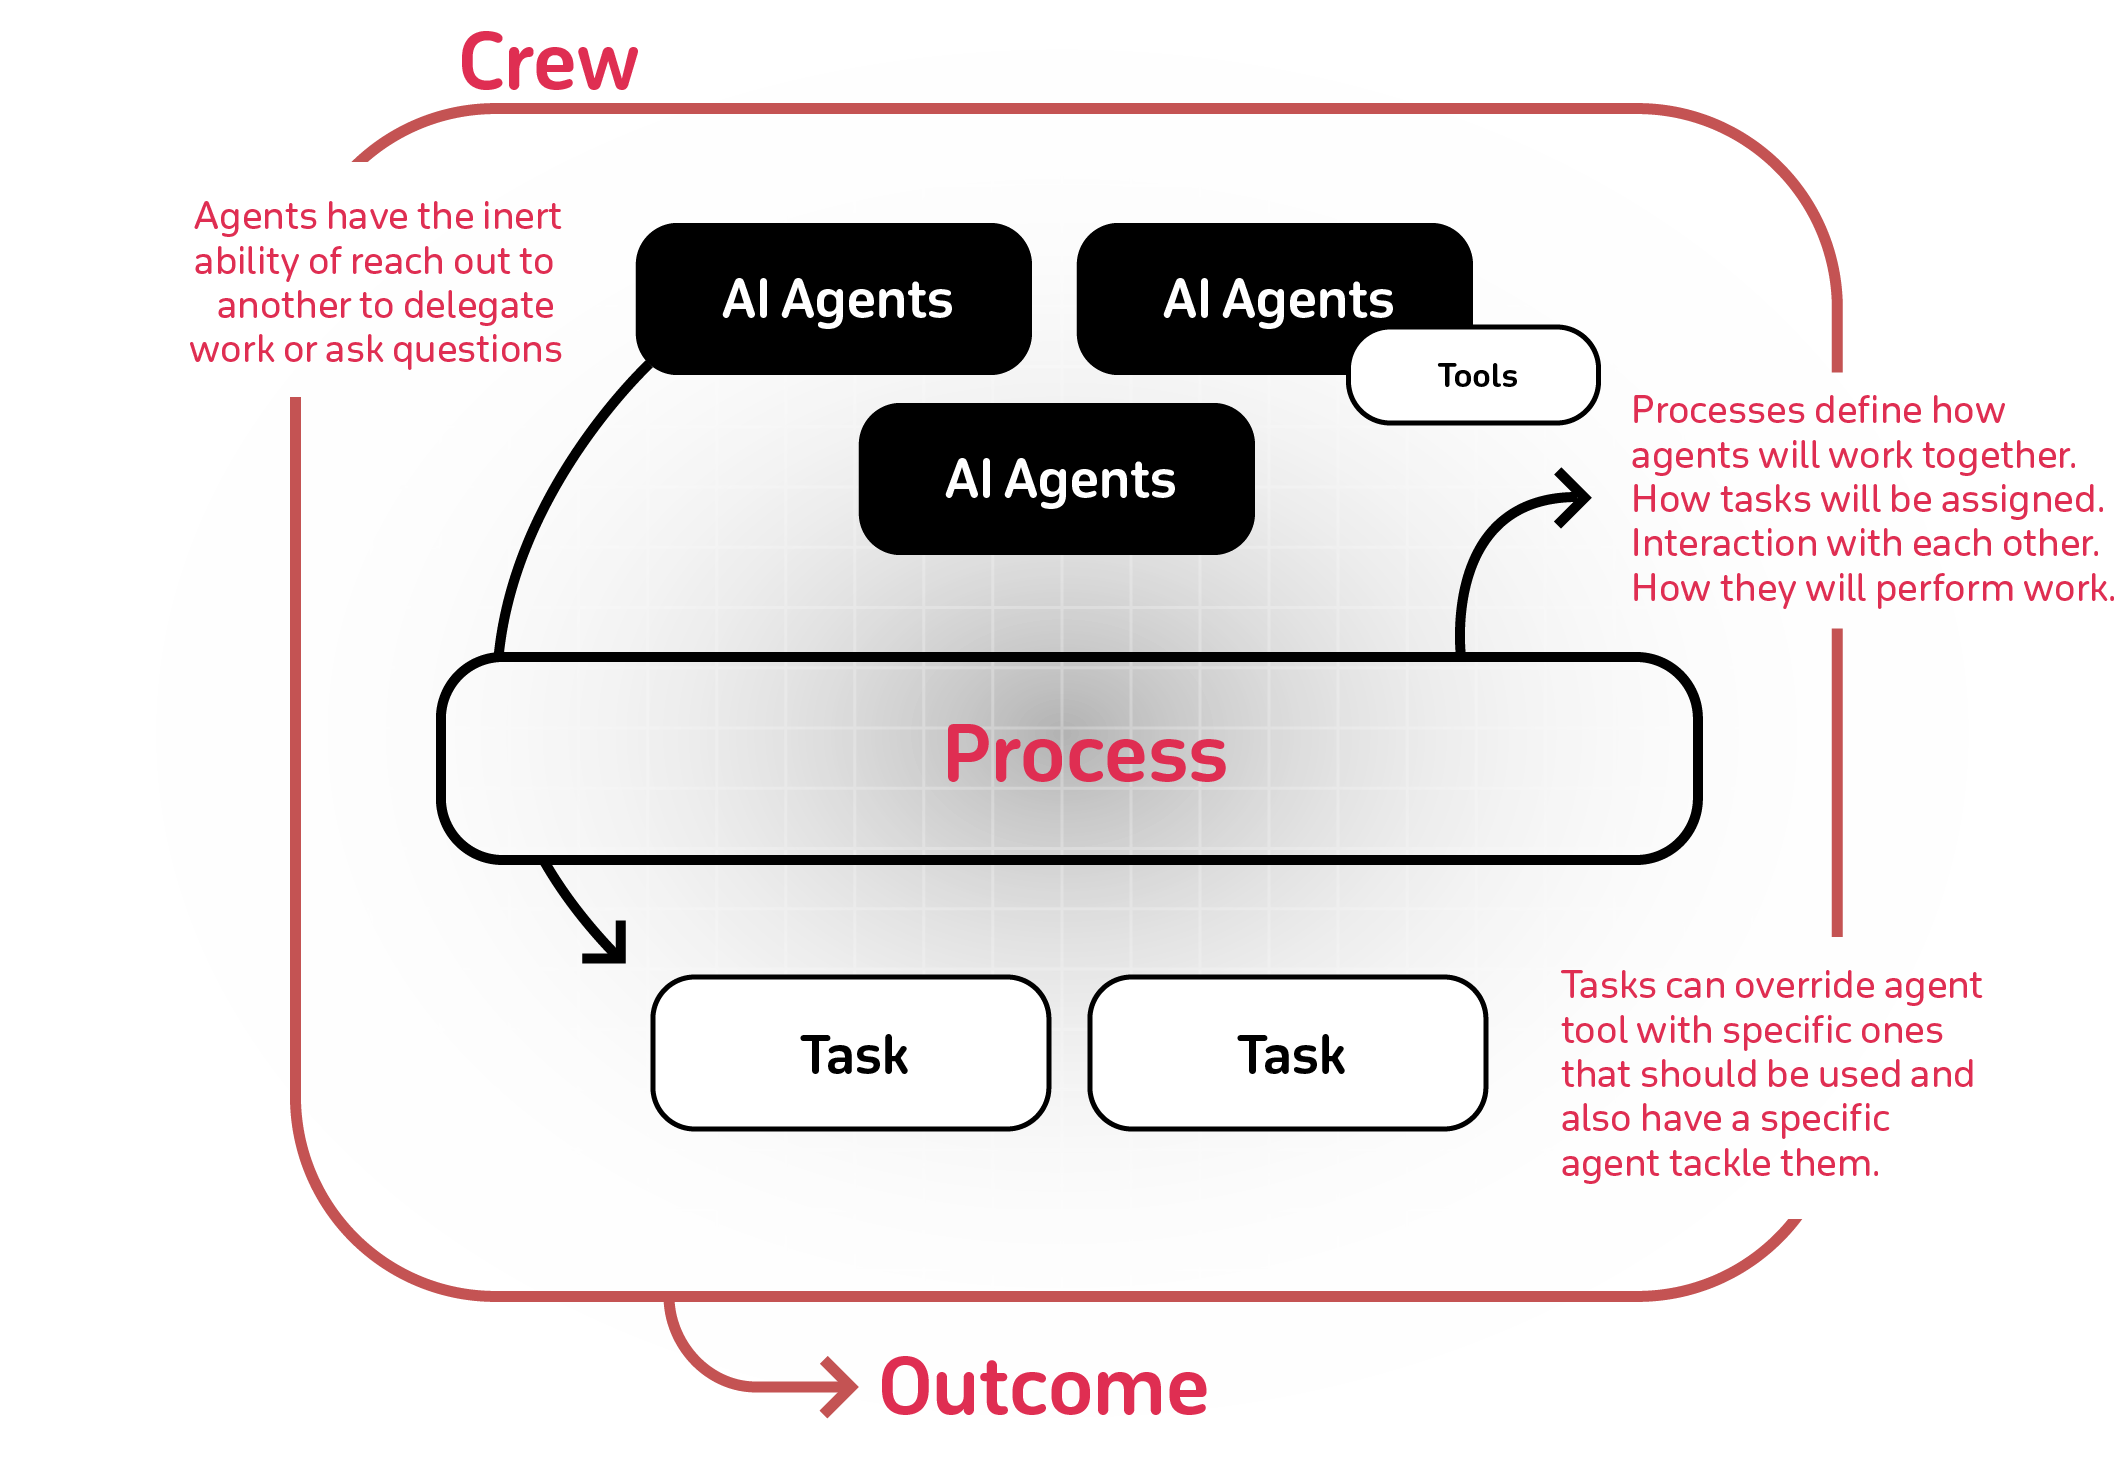
CrewAIの動作を1枚の図で押さえます。ユーザーが目標を渡すと、Crewが各Agentに割り当てられたTaskをProcessのルールに従って実行し、成果物を返します。
図のポイントは3つです。
・Crewが入力を受け取り、Processの種類に応じてタスクをエージェントに割り当てる
・Sequentialなら定義順、Hierarchicalならマネージャーエージェントが動的に委譲先を決める
・各AgentはTaskをこなしながらToolsで外部に働きかけ、KnowledgeとMemoryを参照する
このループを通じて、単一LLMでは難しい「分業による複雑タスクの完遂」を実現するのがCrewAIの本質です。実運用では、この図の一連の流れをさらに大きな「Flow」の1ステップとして組み込み、状態管理や条件分岐をFlowsが担う構成が一般的です。CloudflareのAIコードレビューシステム解剖|7専門エージェント並列実行の仕組みと実績は、CrewAIとは別実装ながら「複数の専門エージェントを並列実行して1つの成果物にまとめる」設計思想が共通する実例として参考になります。
他の選択肢との比較:LangGraph・AutoGen・Mastra・OpenAI Agents SDK
主要なエージェントフレームワークとCrewAIを比較します。どれも「マルチエージェント」を謳いますが、設計思想と得意分野が異なります(CrewAIのStar数は2026-09-17時点、他4フレームワークは2026-08-17時点のGitHub実測値)。
| フレームワーク | 提供元 | 言語 | GitHub Stars | 設計思想 | 得意分野 |
|---|---|---|---|---|---|
| CrewAI | CrewAI Inc. | Python | 約58.7K | 役割ベースの宣言的な協調(Crew) | 調査→執筆→レビュー等の分業を最短コードで |
| AutoGen | Microsoft | Python / .NET | 約60.5K | 会話ベースのマルチエージェント(GroupChat) | 既存資産の保守。新規はMicrosoft Agent Frameworkへ移行推奨 |
| LangGraph | LangChain | Python | 約39.9K | グラフで状態遷移を厳密に定義 | 分岐・ループ・中断再開を細かく制御する本番フロー |
| OpenAI Agents SDK | OpenAI | Python / TS | 約28.7K | handoffs(委譲)とguardrails(検証) | OpenAIモデル中心の軽量な委譲型エージェント |
| Mastra | Mastra | TypeScript | 約27.2K | TSネイティブのワークフロー | TS/Next.jsアプリにエージェントを組み込む |
ざっくり選び分けると次の通りです。
・役割分担を宣言的に最短で組みたい → CrewAI
・制御フローを厳密に書きたい → LangGraph
・既存のAutoGen資産を保守したい/新規は後継を検討 → AutoGen/Microsoft Agent Framework
・TypeScript/フロント統合 → Mastra
・OpenAIモデル中心で軽量に → OpenAI Agents SDK
Microsoftは公式READMEで「AutoGenはメンテナンスモードに入り、新機能は追加されずコミュニティ管理となる」と明言し、新規ユーザーには後継のMicrosoft Agent Framework(★約12.9K)への移行ガイドを案内しています。AutoGenの★数が大きいのは過去の蓄積であり、これから新規に学ぶ場合はこの位置づけを踏まえて選択してください。
CrewAIが選ばれる理由は「制御の厳密さ」ではなく「立ち上がりの速さ」です。LangGraphのような明示的な状態機械を書かずに済むぶん、複雑な分岐が必要な本番フローでは設計の柔軟性が下がるトレードオフがあります。
実務への影響:料金・本番運用・落とし穴・実例
料金の考え方
CrewAIの本番コストは大きく2系統です。
・LLM API課金:OpenAIやAnthropic等の従量課金。自律ループは消費が読みにくいので、上限とアラートを必ず張る
・CrewAI AMP(旧CrewAI Enterprise):デプロイ・監視・スケーリングをマネージドで提供する有償プラン(呼称変更前の「Enterprise」表記で検索されることも多い)。クルーをAPIとしてデプロイし、実行履歴やバージョンを一元管理できる。OSS版を自前インフラで動かす限りCrewAIへの課金は発生しない
個人開発や検証はOSS版+API従量で十分です。チーム運用や可観測性が必要になった段階でAMPを検討する流れが現実的です。ローカルLLM(Ollama)へ切り替えてAPIコストをゼロに近づける選択肢もありますが、ツール呼び出しの精度はモデルサイズに依存するため、まずクラウドの高性能モデルで設計を固めてから置き換えるのが安全です。モデル選定や量子化の基礎を先に押さえたい場合は LLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版 が参考になります。
Claude(Anthropic)をLLMバックエンドに使う
「crewai claude code」で検索して辿り着く読者向けに補足します。CrewAIにClaude Codeという専用CLI連携は存在しませんが、Anthropicのモデル自体はLLMバックエンドとしてネイティブにサポートされています。公式ドキュメントは「Anthropic Python SDKを通じたネイティブ統合」と明記しており、他の非対応プロバイダのようにlitellm経由の間接呼び出しではありません。導入はuv add "crewai[anthropic]"で拡張を追加し、環境変数ANTHROPIC_API_KEYを設定するだけです。
from crewai import LLM

llm = LLM(
    model="anthropic/claude-sonnet-5",
    api_key="your-api-key",  # または環境変数ANTHROPIC_API_KEYで設定
    max_tokens=4096,  # Anthropicモデルは必須パラメータ
)
Anthropicモデルはmax_tokensの指定が必須という点が他プロバイダと異なる注意点です。生成したllmはAgent(llm=llm, ...)のように各エージェントへ個別に渡せるため、リサーチ担当はClaude、レビュー担当は別モデルというように役割ごとに使い分ける構成も組めます。
可観測性とチェックポイント
エージェントは非決定論的に動くため、「なぜその判断をしたか」を追える可観測性が本番では必須です。CrewAIはAMP上のダッシュボードで各Agent/Taskの実行タイムラインとLLM呼び出しの入出力をトレース表示する機能を備えており、verbose=Trueのログだけでは追いにくいタスク間の依存関係やレイテンシを可視化できます。
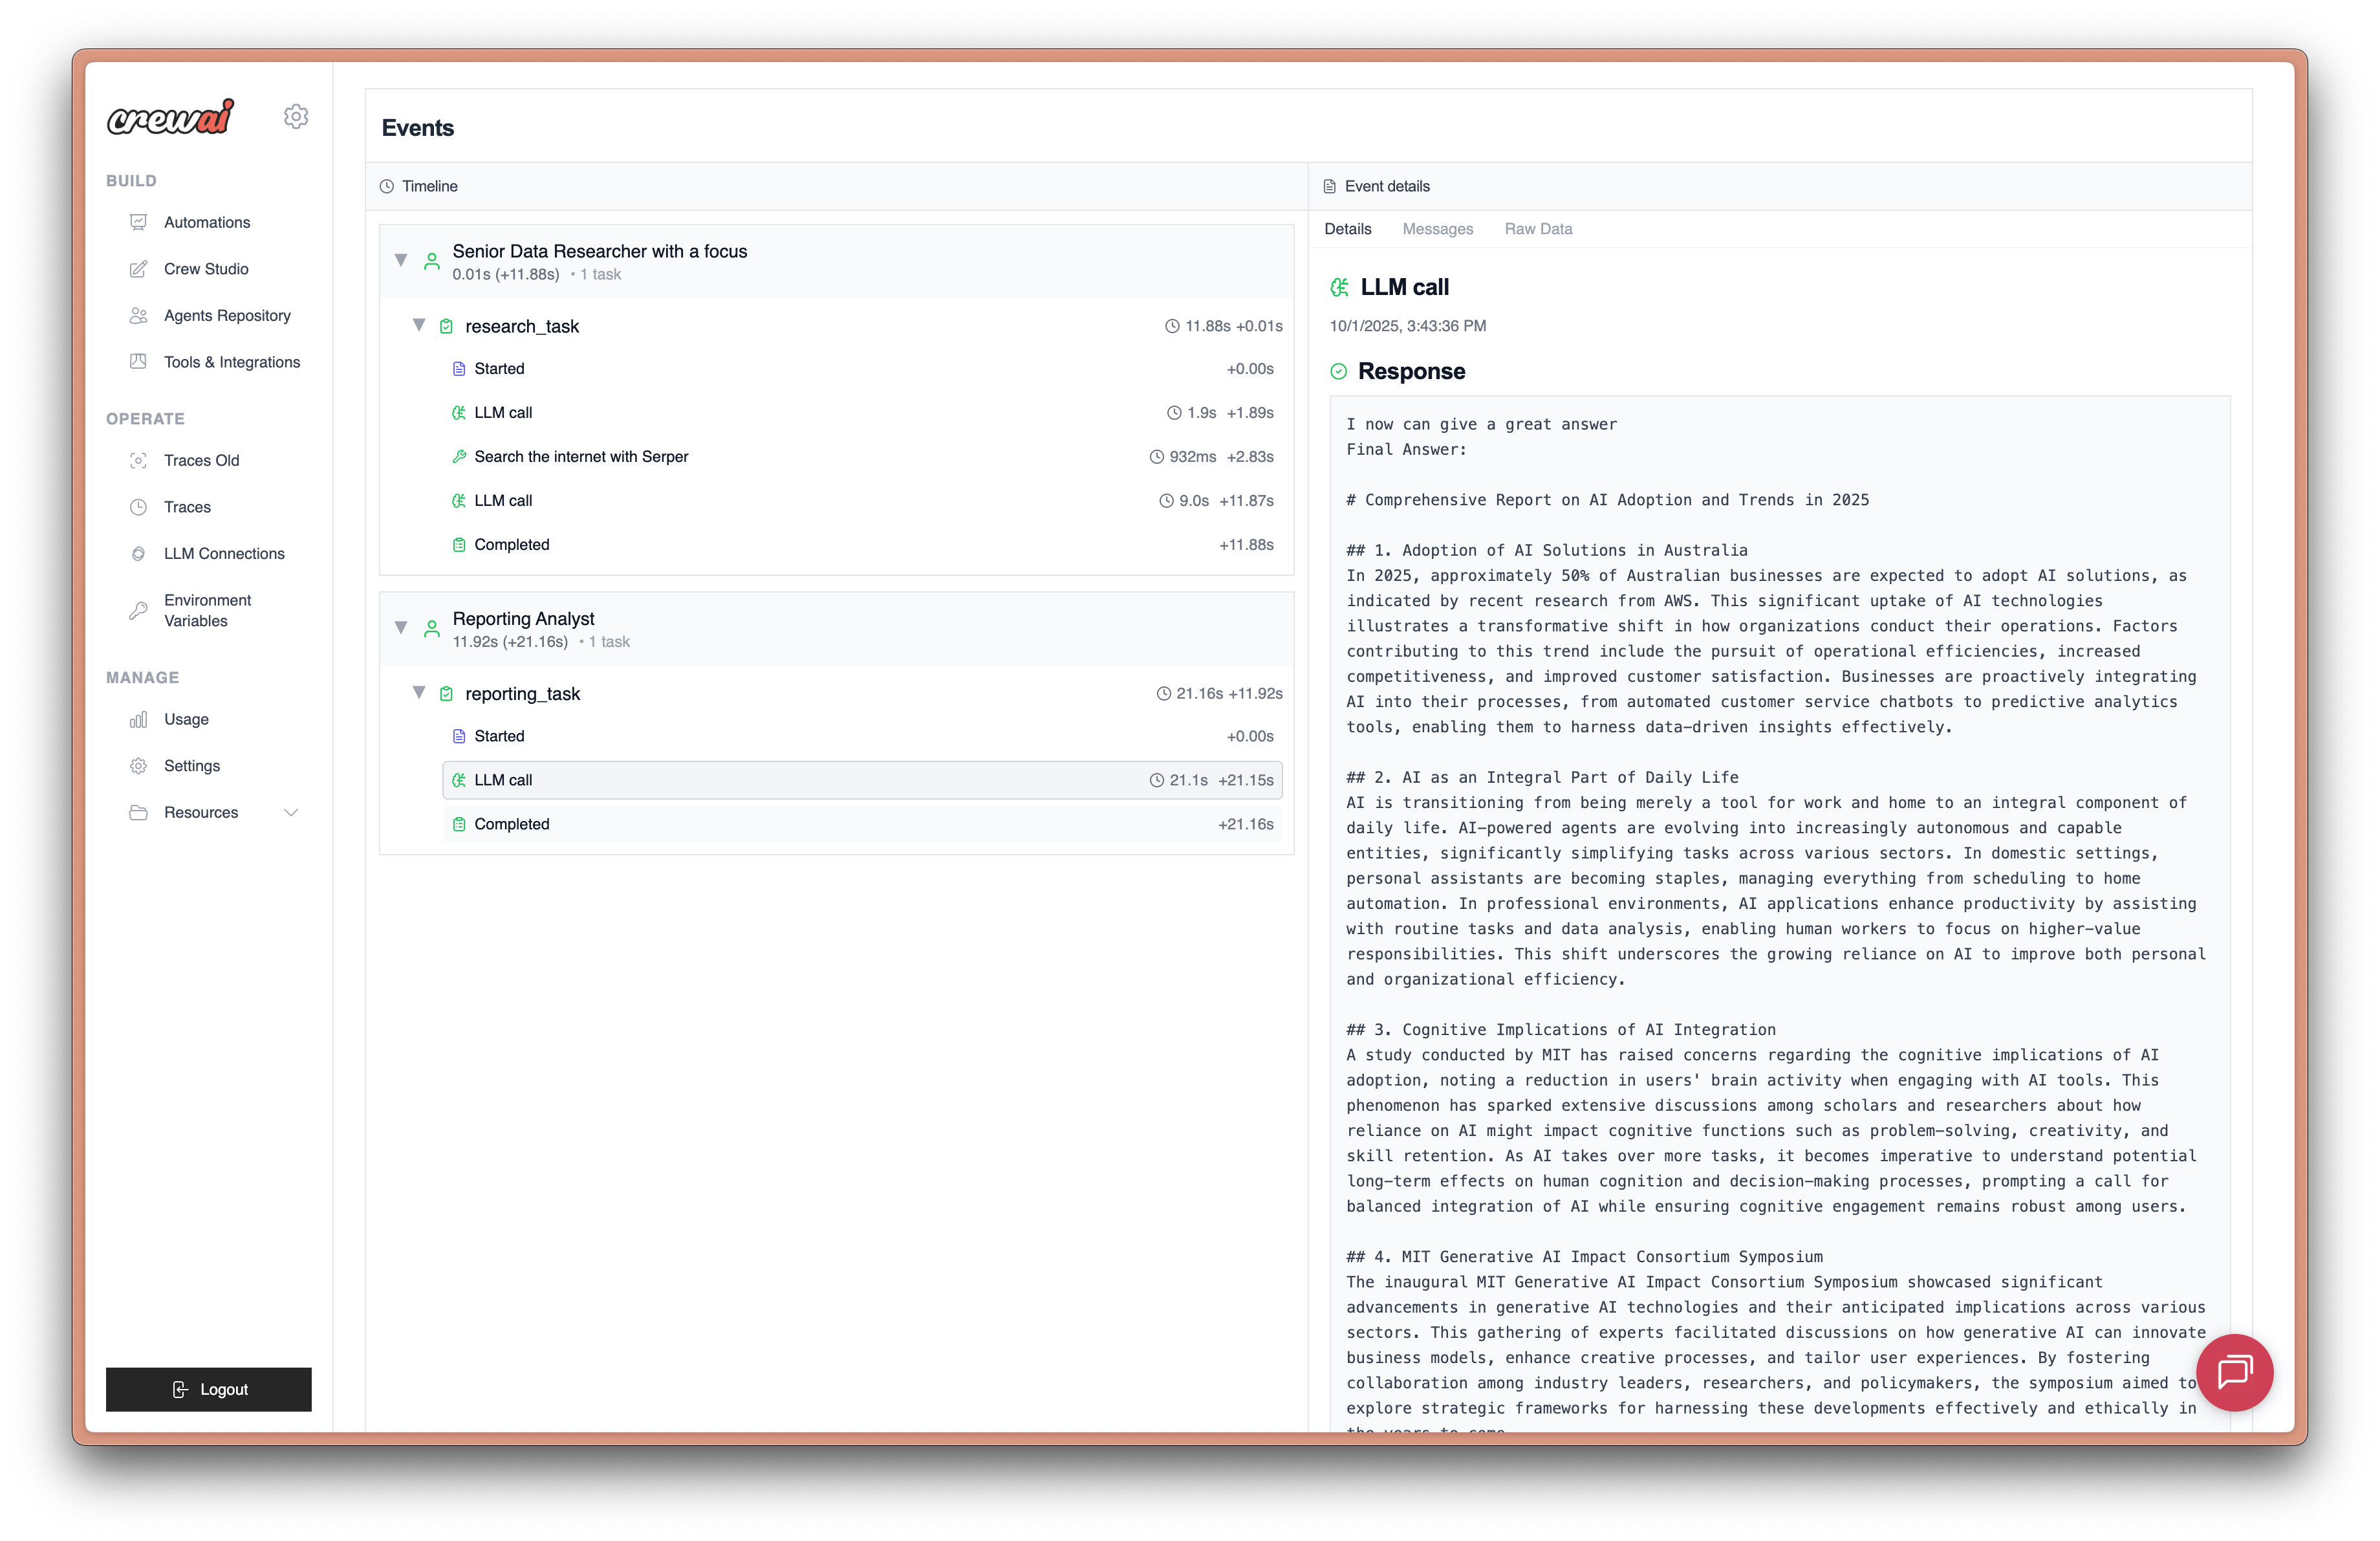
長時間実行するCrewやFlowでは、途中経過を保存して失敗地点から再開できるチェックポイント機能も用意されています。CLIツール(TUI)でチェックポイント履歴をツリー表示し、任意の時点からResume(再開)やFork(分岐)ができるため、途中でエラーが起きても最初からやり直す必要がありません。
実例・サンプルコード集
「まず動くコードを見たい」場合は、公式のcrewAI-examplesリポジトリが最短です。Landing Page Generator(LP自動生成)・Trip Planner(旅行プラン作成)・求人票ライティング(Job Posting)・Stock Analysisなど、実行可能なCrewの実例が公開されています。このうちJob Posting・Trip Planner・Stock Analysisはcrewai本体READMEのExamplesセクションからYouTube解説動画付きでリンクされており(Landing Page Generatorはコードのみ)、いずれも「調査→生成→レビュー」の分業パターンを異なる題材で示しています。自分のユースケースに近い例から読み始めると設計の勘所を掴みやすくなります。
よくある落とし穴
入門者がつまずきやすいポイントを先回りで挙げます。
・roleやgoalが曖昧で出力がブレる:抽象的な役割定義は出力品質を直接下げる。「優秀なライター」より「IT初心者向けに専門用語を噛み砕く技術ライター」のほうが出力が安定する
・いきなりHierarchicalにして制御不能:マネージャー委譲は便利だが非決定性が増す。まずSequentialで挙動を固める
・トークン消費の暴走:自律ループや多エージェントは想定の数倍消費しうる。max_iter・予算アラートを最初から組み込む
・MemoryとKnowledgeの混同:Memoryは「過去の経験」、Knowledgeは「事前に渡す参考資料」。役割が違うので使い分ける
・バージョン差での書き方の食い違い:CrewAIは更新が速く、Memory周りなどAPIが変わる。PyPI実測で2026-08-12に1.15.15、2026-08-14に1.15.16、2026-09-09に1.15.21が公開されており(2026-09-17時点でも1.15.21が最新)、数日〜週単位でパッチが出ている。uv pip show crewaiでバージョンを確認し、そのバージョンの公式ドキュメントを参照するのが確実
特に最後の「バージョン差」は実害が出やすい点です。記事やチュートリアルのコードが動かないときは、まず自分の環境のCrewAIバージョンを疑うと早く解決します。crewai create crewのデフォルトがYAMLからJSONへ切り替わったのもこの更新頻度の一例で、今後もCLIの既定構成やMemory周りのAPIは変わり得るため、公式ドキュメントは常にインストール済みバージョンのものを参照するのが安全です。キャリアパス全体でマルチエージェント設計がどう位置づけられるかは バイブコーディングは終わった?2026年版Agentic AIエンジニアのロードマップと進化の全体像 でも扱っています。
まとめ:CrewAIの使い方を最短で押さえる
CrewAIは、役割を持つエージェントを「クルー」として協調させるマルチエージェントフレームワークです。覚えるべきはAgent・Task・Crew・Processの4概念だけで、使い方はCLI(crewai create crew。デフォルトJSON構成、--classicでYAML構成)でプロジェクトを生成する方法と、Pythonコードで直接定義する方法の2系統があります。料金はOSS本体が無料・MITライセンス、チーム運用にはCrewAI AMPという棲み分けです。制御を厳密に書きたいならLangGraph、TS統合ならMastraという使い分けを押さえつつ、まずはSequentialな最小クルーで「分業が動く」感覚を掴むのが最短の入門ルートです。
CrewAIは役割ベースの宣言的な協調が強みのPython製マルチエージェントフレームワーク。4概念・2つのインストール経路・料金の無償/有償ライン・競合との違いを押さえれば、最短でCrewを動かせます。
参照ソース
・CrewAI 公式サイト — フレームワークの概要・AMP情報
・crewAIInc/crewAI(GitHubリポジトリ・README) — インストール手順・Getting Started・Key Features・ソースコード
・CrewAI 公式ドキュメント:Memory — 統合Memory API(remember/recall)・LanceDBストレージの一次情報
・CrewAI 公式ドキュメント:LLMs — AnthropicのネイティブSDK統合・LLM(model=...)設定例の一次情報
・crewAIInc/crewAI-examples(GitHubリポジトリ) — 実行可能なCrewの実例集
・Microsoft AutoGen(GitHub) — 比較対象。メンテナンスモード移行の公式告知
・Microsoft Agent Framework(GitHub) — AutoGenの後継として公式が案内する移行先