Tencent AuK(Tencent-Hunyuan/AuK・MIT・GitHubスター737)は、音声の生成と編集を1つのモデルで扱う1.5Bの基盤モデルです。ゼロショットTTS、発話内容の書き換え、感情や音色の変更、ノイズ除去、話者分離、ボーカル抽出など16タスクを、「自然言語の指示+必要なら入力音声」という同じ入口で受け付けます。2026年9月9日にコードと重みが公開され、同月13日にはApple Silicon向けMLX推論とCUDAのCPUオフロードが追加、ICASSP 2027 Audio Editing Challengeの公式ベースラインにも採用されました。
これまで音声の生成・編集・強調・分離は別々のモデルを組み合わせる領域で、「指示文だけで何でも」というのは主張としては強い。本記事はGPUの無い環境で書いているため推論は動かせていません。代わりに、リポジトリのソース・README・Cookbook・LICENSEを読み、構成・VRAM要件・対応言語・ライセンスについて確かめられたことと、確かめられなかったことを分けて整理します。
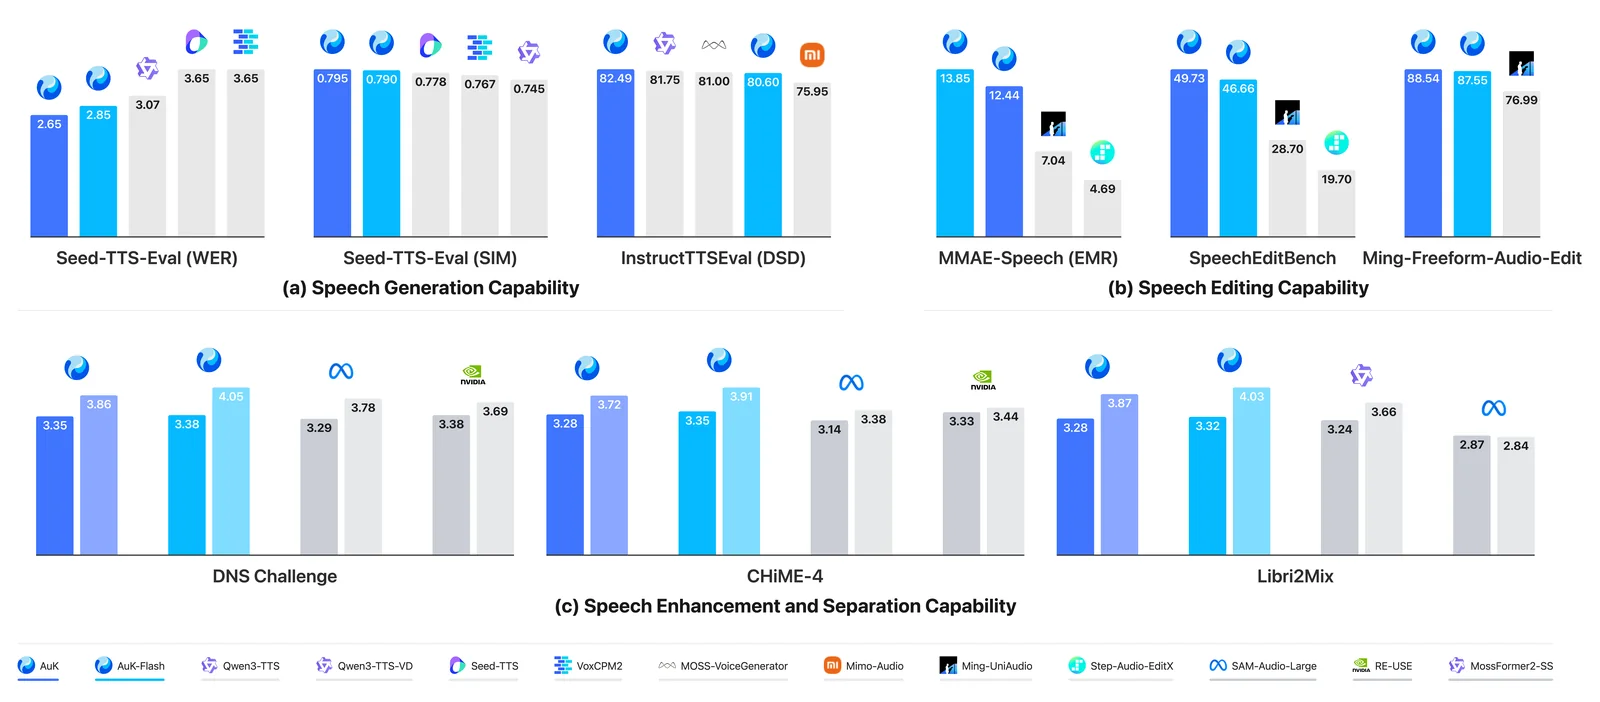
- ・正体:Tencent Hunyuanの音声生成・編集の基盤モデル。1.5B・MIT・重み公開。基本モデルAuKと4ステップ蒸留のAuK-Flash
- ・何ができる:TTS/内容編集/音響編集/パラ言語編集/強調・分離の5カテゴリ16タスクを、同じ指示口(テキスト+音声)で
- ・構成:Qwen2.5-Omni-3B(凍結)→ 層ごとの重み和 → 1.5B DiT(MMDiT+Single Stream)→ VAEデコーダ。推論はフローマッチング(既定NFE 32・CFG 2.0)
- ・要件:README実測でピークVRAM約25GiB、CPUオフロードで約17GiB(A800・bf16)。Python 3.10・PyTorch 2.7系
- ・注意:日本語対応は公式に明記なし(デモ・テンプレートは英語と中国語)。本記事は推論未実測。Qwen2.5-Omni-3Bは別ライセンス
音声モデルはLLMとは別の系統ですが、「オープンウェイトをローカルで動かす」という判断軸は共通です。モデルの選び方・量子化・実行環境の全体像はLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版で整理しており、本記事はそのうち音声の生成・編集に絞ります。
Tencent AuKとは——16タスクを「指示1本」に統合した音声基盤モデル
READMEの定義は「1.5B foundation model for speech generation and editing」で、「数百万時間の多様な音声データで学習」「ゼロショット/指示ベースのTTS、内容・音響編集、パラ言語編集、音声強調、音源分離を、統一された自然言語の指示インタフェースで」とあります。ポイントは最後の一句で、タスクごとのモードやフラグが無く、何をするかは指示文で決まります。
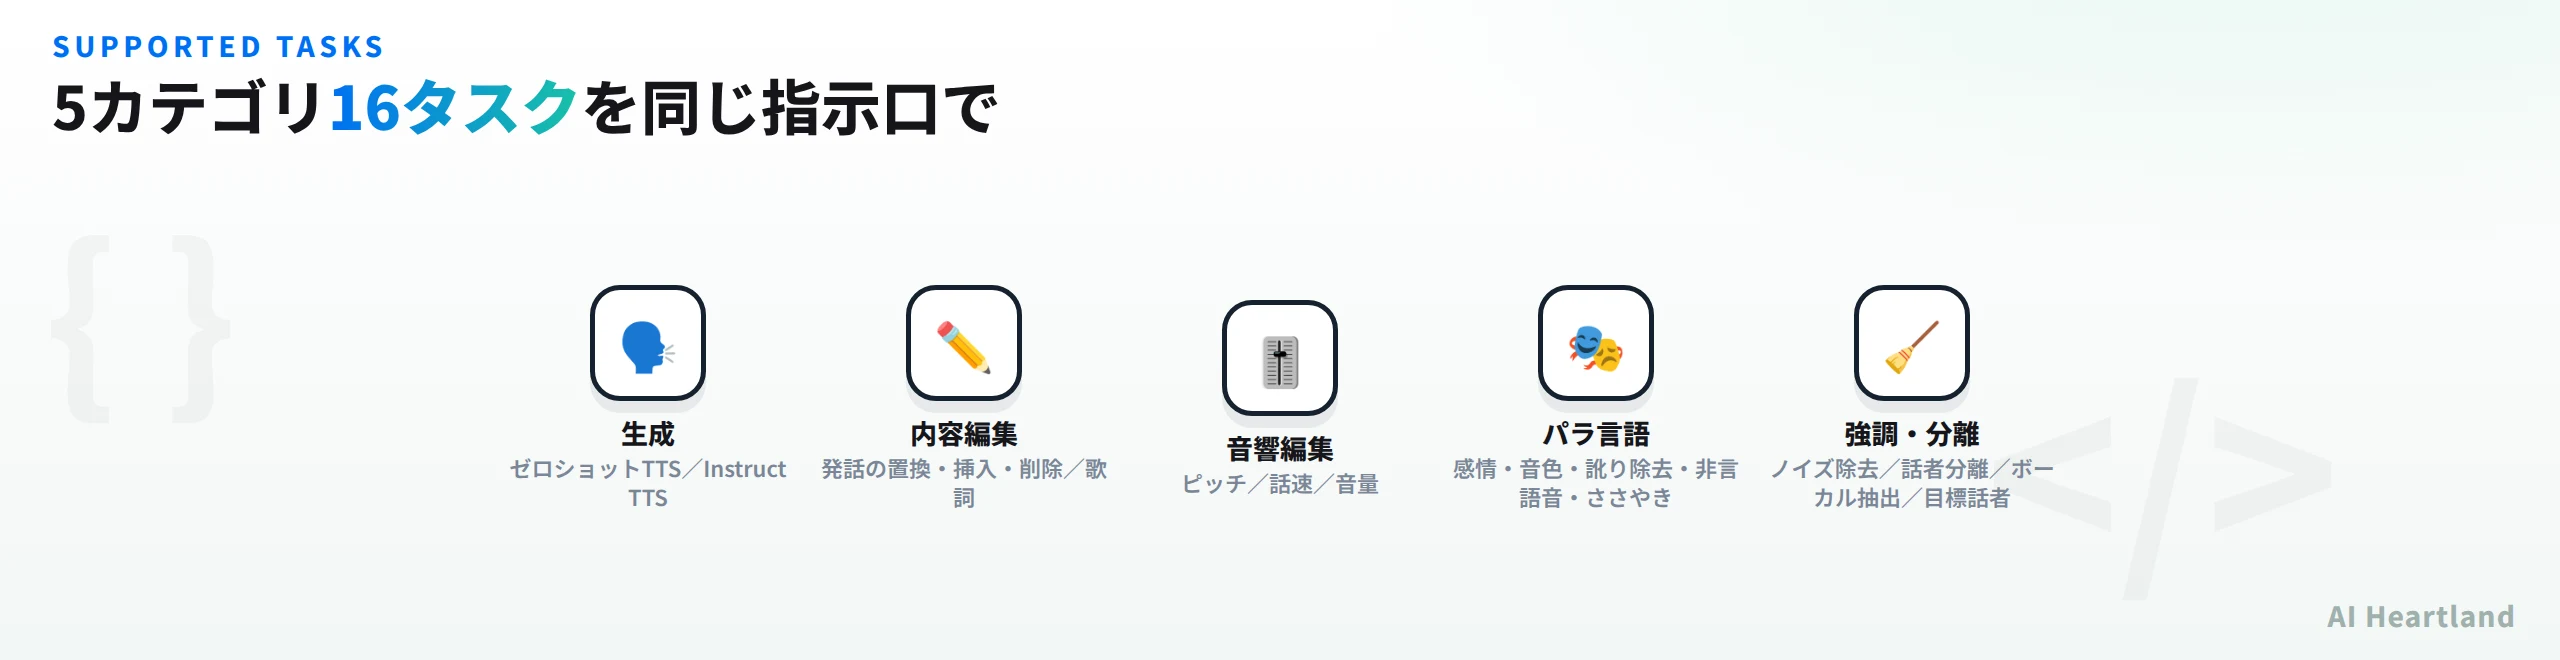
| カテゴリ | タスク | 指示の例(Cookbookの英語テンプレートを要約) |
|---|---|---|
| 音声生成 | ゼロショットTTS/Instruct TTS | 「同じ声で次を話して:…」/「次の声の説明に基づいて生成:…」 |
| 内容編集 | 発話内容の編集/歌詞編集 | 「’A’ を ‘B’ に置き換えて」「’X’ の前に ‘Y’ を追加」「’Z’ を削除」/「歌詞の…を…に」 |
| 音響編集 | ピッチ/話速/音量 | 「ピッチを2半音上げて」「話速を1.5倍に」「音量を10dB下げて」 |
| パラ言語編集 | 感情/音色/訛り除去/非言語音/ささやき | 「感情をhappyに」「音色を…に」「地域訛りを取り除いて」「息継ぎを全部消して」「ささやきに変換」 |
| 強調・分離 | 音声強調/話者分離/音楽分離/目標話者抽出 | 「ノイズと残響を除いて等長のクリーンな音声を」「2番目に話す人だけ残して」「ボーカルだけ抽出」「’…’と言っている人だけ残して」 |
入力形式はChatMLに似たメッセージ列で、role: user の content にテキストと(任意で)音声を並べます。CLIでは auk-infer --audio <入力> --instruction "<指示>" --output <出力> --gen_seconds <秒> の1行です。出力の長さはモデルが自動で決めないので、--gen_seconds で秒数を指定するか、--ref_text と --gen_text(参照音声の書き起こしと生成したい文)から推定させます。ここが素朴に使うと最初につまずく点で、後述のPrompt Enhancerはこの秒数推定を肩代わりする道具です。
仕組み——Qwen2.5-Omni-3Bを条件にしたDiT+フローマッチング
構成はREADMEのアーキテクチャ図と src/auk/model/ から4層に整理できます。
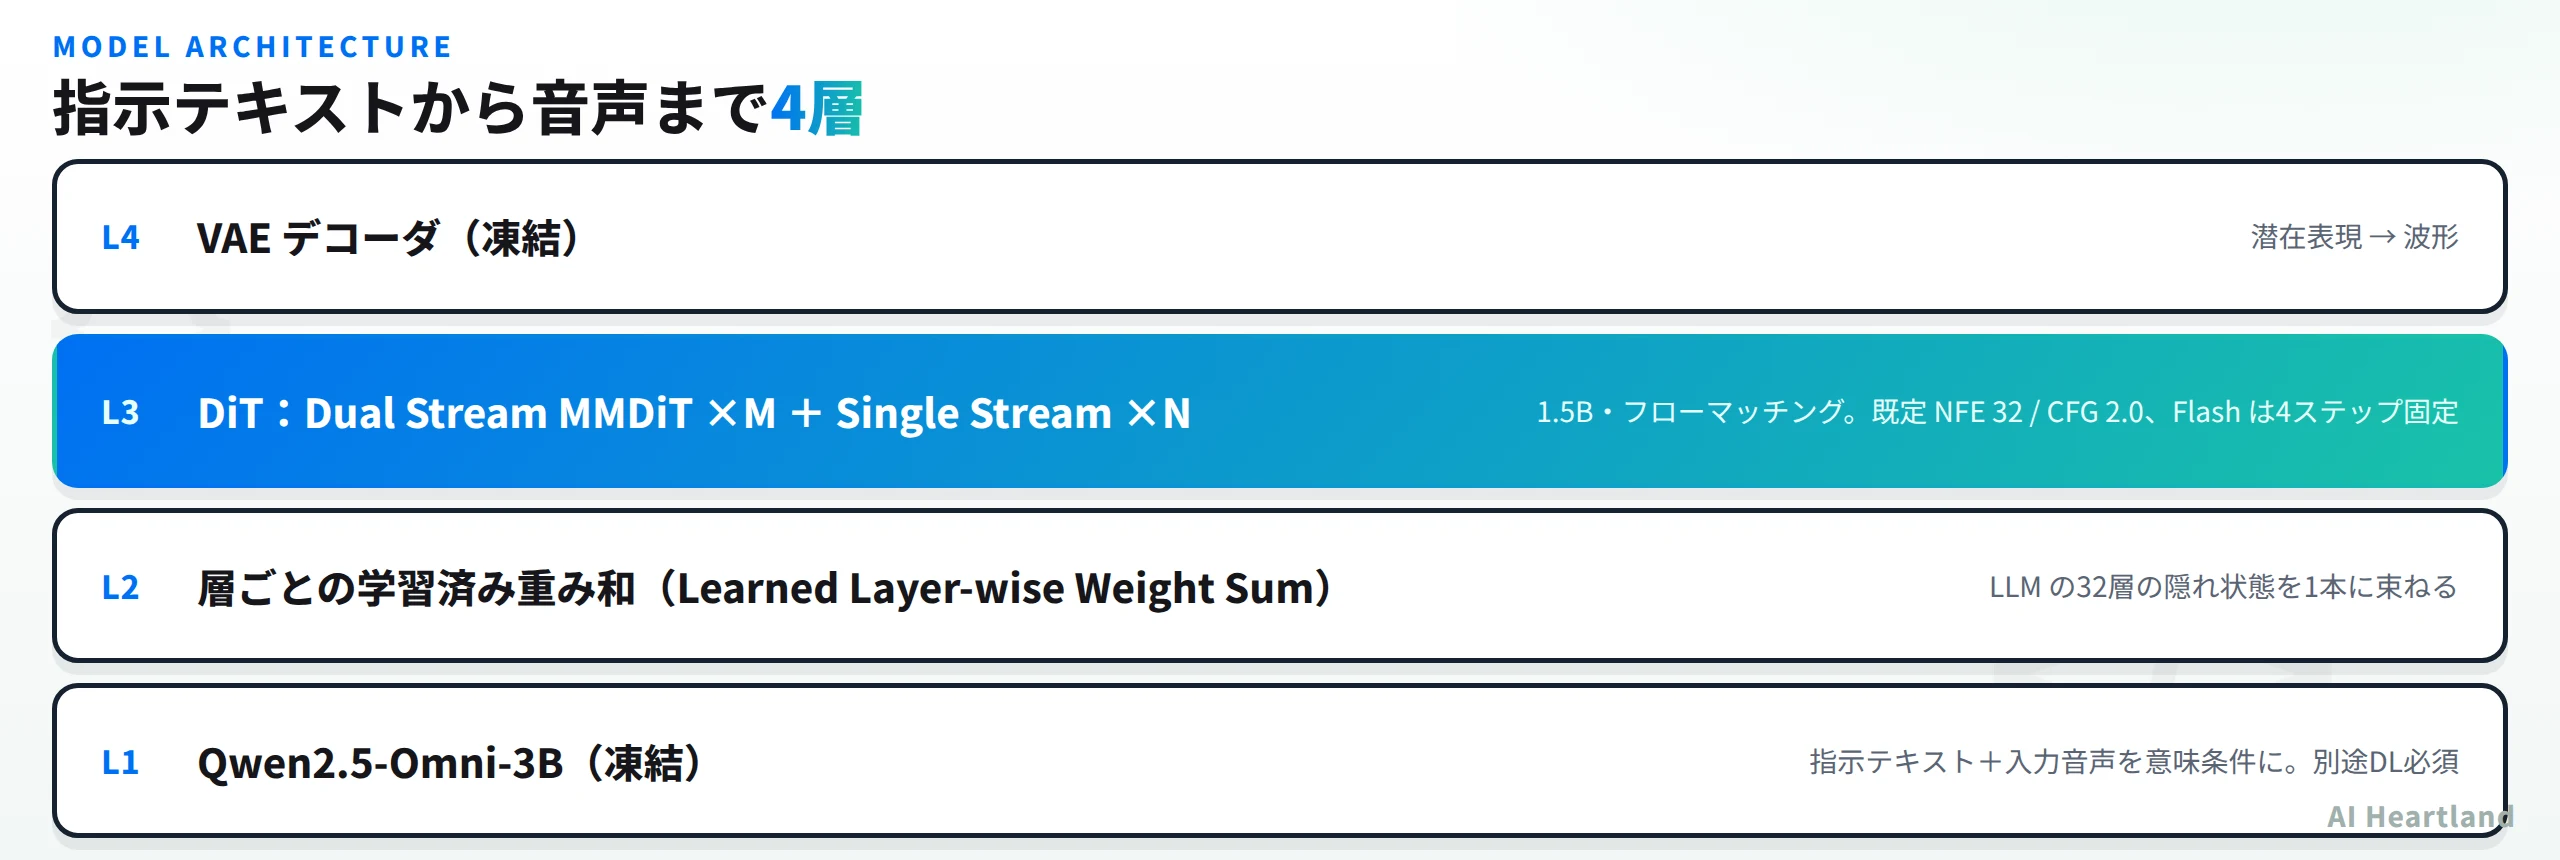
・L1 意味エンコーダ(凍結):Qwen2.5-Omni-3Bが指示テキストと入力音声を読み、層ごとの隠れ状態を出す。別途 hf download Qwen/Qwen2.5-Omni-3B で取得する必要があり、READMEは「Qwen3-Omniは現時点で非対応」と明記
・L2 学習済み層ごとの重み和:LLMの32層の隠れ状態を学習した重みで1本に束ね、線形変換して条件トークンにする。どの層の情報を使うかをモデルに学ばせる設計
・L3 DiT本体(1.5B):Dual StreamのMMDiTブロック×M(意味ストリームと音響ストリームをJoint Attentionで混ぜる)の後にSingle StreamのDiTブロック×N。参照音声の潜在表現(任意)とノイズを加えた目標潜在表現を入力し、フローマッチングで復元する。実装は flux2_edit.py・cfm_edit.py
・L4 VAE(凍結):BigVGAN系のフローVAE(bigvgan_flow_vae.py)が潜在表現と波形を相互変換。エンコーダは入力音声側、デコーダは出力側で使う
推論のパラメータはCLIの既定値から読めます。NFE(ODEステップ数)32・CFG 2.0・sway係数−1.0・bf16が基本モデルの既定で、AuK-Flashは4ステップ固定・CFG 0に蒸留されているため、これらの指定は無視されます。チェックポイントはDiTと層融合の重みだけを含み、意味エンコーダとVAEは実行時に別ファイルから読むため、「text_encoder.* のキーが見つからない」という読み込み時の警告は正常だとREADMEが注記しています。
「'A' を 'B' に置き換えて」"] --> Q["Qwen2.5-Omni-3B
(凍結・別途DL)"] S["入力音声(任意)"] --> Q S --> VE["VAE エンコーダ
参照潜在表現"] Q --> W["層ごとの重み和 → 条件トークン"] W --> D["DiT 1.5B
MMDiT ×M + Single Stream ×N"] VE --> D N["ノイズ(t ~ U[0,1])"] --> D D -->|"フローマッチング
NFE 32 / Flash は 4 ステップ"| Z["生成潜在表現"] Z --> VD["VAE デコーダ(凍結)"] --> O["出力波形 .wav"]
① 何ができる:TTS・発話内容や感情の書き換え・ノイズ除去・話者分離など16タスクを、指示文と音声を渡すだけで1モデルが実行する。② 何を解決する:タスクごとに別モデルを選び、前処理と後処理を継ぎ足す手間。③ 何を代替できる:用途が英語・中国語で、25GiB級のVRAM(オフロードで17GiB)を用意できるなら、TTS・音声編集・強調・分離の個別ツール群。日本語用途は本記事では判定できない。
インストールとVRAM要件——README実測はピーク約25GiB
環境はPython 3.10とPyTorch 2.7系(torch>=2.7,<2.8)で、uvかCondaでインストールします。追加機能は extras で選びます。
git clone https://github.com/Tencent-Hunyuan/AuK && cd AuK
uv venv --python 3.10 && source .venv/bin/activate
uv pip install -e .                 # 推論とCLIのみ
# uv pip install -e ".[gradio]"     # + Gradio UI・Prompt Enhancer・ASR
# uv pip install -e ".[comfyui]"    # + ComfyUI ノード
# uv pip install -e ".[train]"      # + ファインチューニング

# 重み(Hugging Face。ModelScope でも可)
hf download tencent/AuK --local-dir ./ckpts/AuK
hf download tencent/AuK-Flash --local-dir ./ckpts/AuK-Flash       # 任意
hf download Qwen/Qwen2.5-Omni-3B --local-dir ./ckpts/Qwen2.5-Omni-3B
推論はCLIかPython APIです。READMEの例をそのまま挙げます。
# 発話内容の編集:言った内容を書き換える
auk-infer \
    --audio assets/demo-input-audio/content-edit/content.wav \
    --instruction "Replace 'but accepting what we cannot have' with 'and living well with dreams unmet'." \
    --output out_content_edit.wav \
    --gen_seconds 7.0

# 高速版 AuK-Flash に切り替える(4ステップ固定・CFG 0)
#   --ckpt ckpts/AuK-Flash/auk_flash.safetensors
# VRAM を減らす(CUDA のみ)
#   --cpu_offload
VRAMはREADMEに実測表があります。
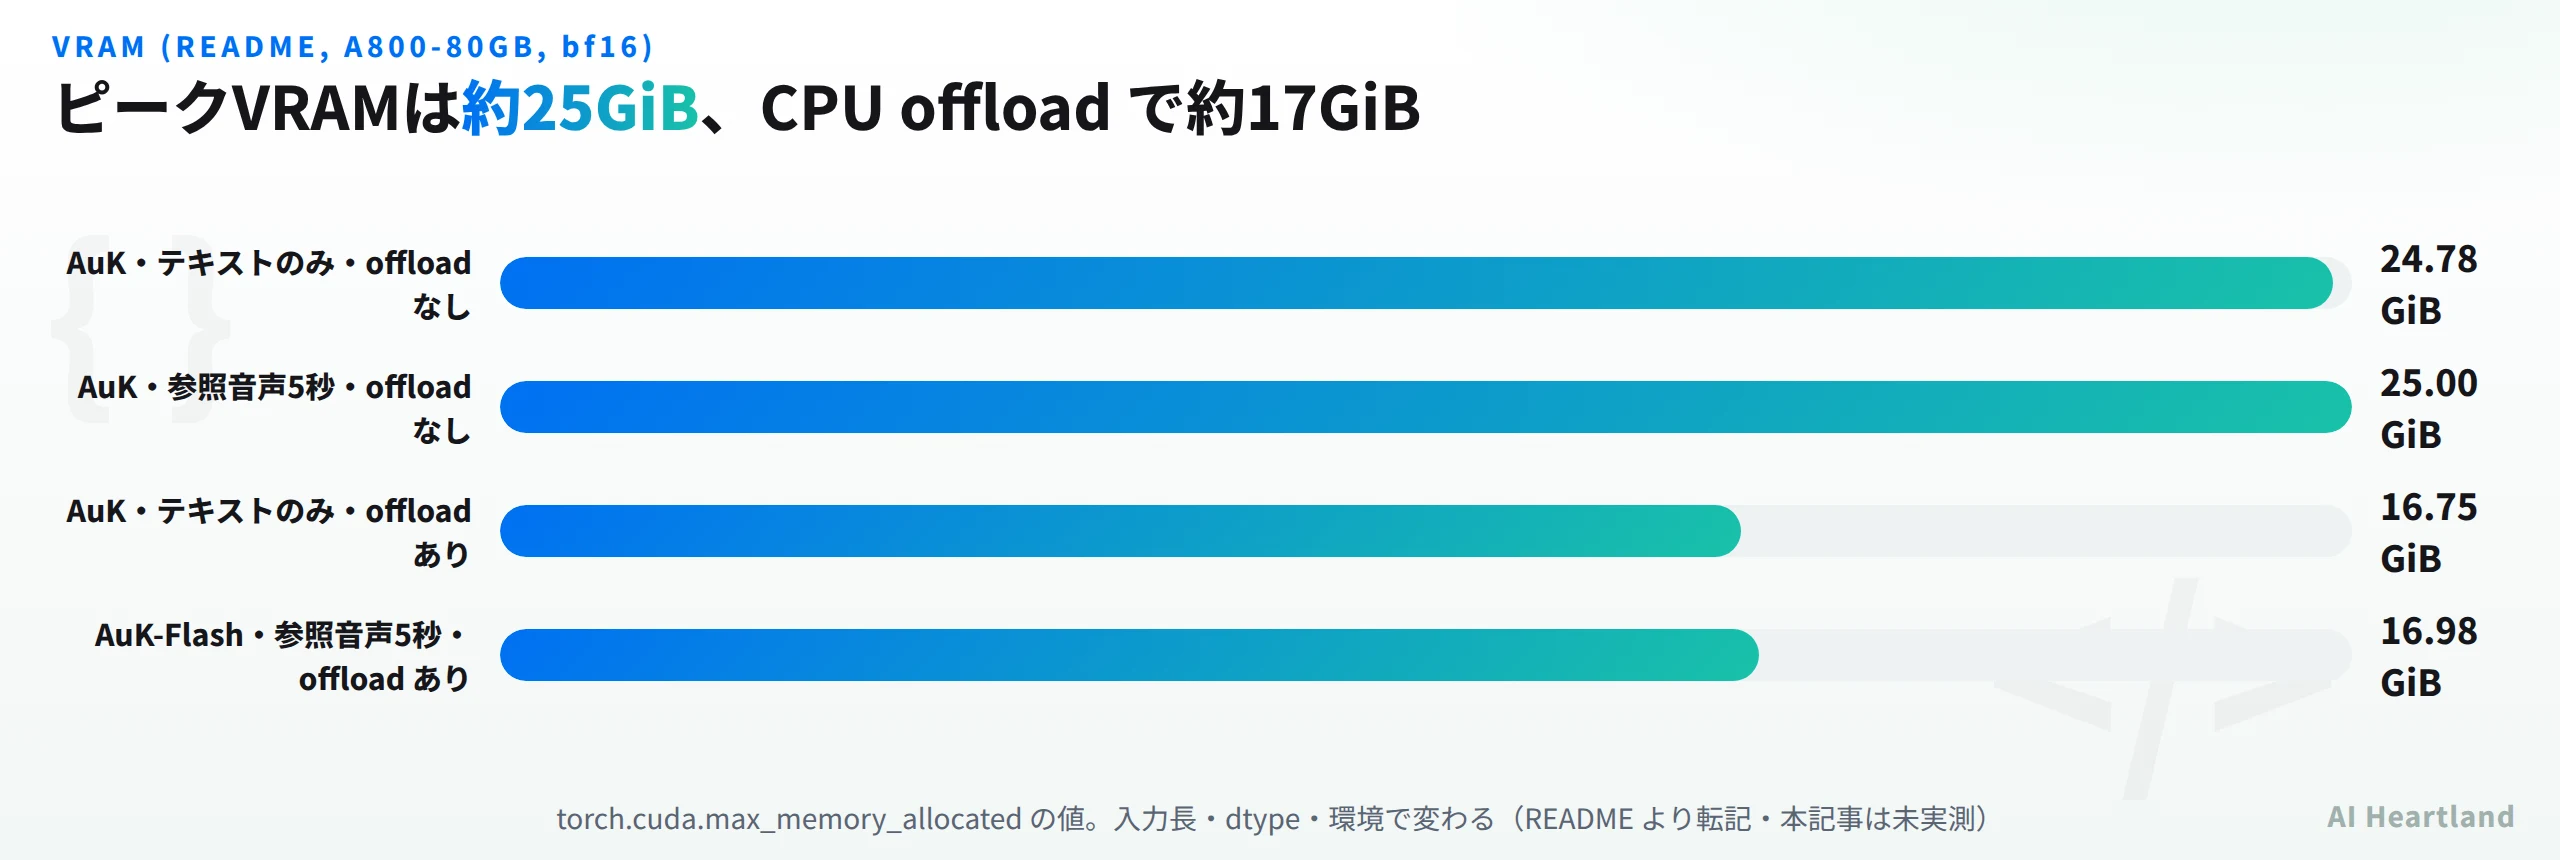
| モデル | 入力 | CPUオフロードなし | CPUオフロードあり | 削減 |
|---|---|---|---|---|
| AuK | テキストのみ・1.5秒出力 | 24.78 GiB | 16.75 GiB | 32.4% |
| AuK | 参照音声5秒 | 25.00 GiB | 16.98 GiB | 32.1% |
| AuK-Flash | テキストのみ・1.5秒出力 | 24.77 GiB | 16.75 GiB | 32.4% |
| AuK-Flash | 参照音声5秒 | 24.97 GiB | 16.98 GiB | 32.0% |
FlashはステップDiTの回数を減らすだけでモデルサイズは同じなので、VRAMは基本モデルと変わらず、速くなるだけです。24GBのコンシューマGPUでは --cpu_offload が事実上必須で、それでも17GiB弱を要します。ComfyUIノード版には「入力音声+生成音声の合計30秒まで」という上限もあります(docs/COMFYUI.md)。2026-09-13追加のMLX推論(Apple Silicon)は feat/mlx-apple-silicon ブランチにあり、mainには入っていません。
Tencent AuKのPrompt EnhancerとGradio——自由文を「実行できる指示」に変換する
AuKの指示文はテンプレートに沿っている必要があり、さらに目標秒数を自分で決めなければなりません。Prompt Enhancer(PE)はその2つを肩代わりする補助ツールです。自由文の依頼と入力音声を渡すと、①タスクを判定し ②モデル向けの指示文に整え ③ASRで入力音声を書き起こして目標秒数を推定し ④必要な前処理をした音声を書き出して ⑤そのまま実行できる auk-infer の1行を出力します。
PEにはOpenAI互換のテキストLLMが必要で、.env.example にはTencent Cloud TokenHubの hy3 とDeepSeek(deepseek-v4-flash)の2例があります。ASRはTencent Cloudの認証情報があればそれを、無ければ iic/SenseVoiceSmall をCPUで自動ダウンロードして使います。つまりPEを使う場合だけ外部LLMのAPIキーが要り、モデル本体の推論はオフラインで完結します。
Gradioデモ(auk-gradio)は基本モデルとFlashを同時に読み込んでUIで切り替えられ、--base_device cuda:0 --flash_device cuda:1 のように2GPUへ分けることも、1GPUに両方載せることもできます。既定のポートは7860です。
Python APIとファインチューニング——JSONL1行が1ペア
Python APIはCLIと同じメッセージ形式です。READMEの例を、参照音声あり(内容編集)となし(Instruct TTS)の2通りで示します。
from auk.infer.infer_auk import AukInfer, save_audio

engine = AukInfer("ckpts/AuK/config.yaml", "ckpts/AuK/auk_base.safetensors")

# 参照音声あり:発話内容の編集
messages = [{"role": "user", "content": [
    {"type": "text", "text": "Replace 'but accepting what we cannot have' with 'and living well with dreams unmet'."},
    {"type": "audio", "audio": "assets/demo-input-audio/content-edit/content.wav"},
]}]
audio, sr = engine.generate(messages, gen_seconds=7.0)
save_audio(audio, sr, "out_content_edit.wav")

# 参照音声なし:声の説明文だけから生成(Instruct TTS)
messages = [{"role": "user", "content": [
    {"type": "text", "text": "Generate speech based on the following description: \"a calm female voice in her twenties\". The content to speak is: \"Welcome back.\""},
]}]
audio, sr = engine.generate(messages, gen_seconds=4.0)
save_audio(audio, sr, "instruct.wav")
AukInfer はVAEを推論デバイスに常駐させ、QwenとDiTだけを cpu_offload=True で退避できるようにしてあります(infer_auk.py のコメント)。Flashのチェックポイントを渡すと固定の時間刻みとCFG 0を自動検出するため、呼び出し側のコードは変わりません。
ファインチューニングは src/auk/train/train.py で、データはJSONLです。1行が1ペアで、user メッセージに指示と(任意で)入力・参照音声、assistant メッセージに目標音声を置き、duration(目標秒数)で動的バッチを組みます。16タスクすべてが同じ形式で、指示文と音声の組み合わせを変えるだけです。同梱の scripts/train.sh は num_gpus=8・学習率2e-5・エポック200・EMA付きという設定で、docs/FINETUNING.md に構成の意味・チェックポイントと再開・監視・トラブルシュートがまとまっています。なお学習の依存は .[train] extraで別に入れます。
本記事の検証環境:Linux(GPU無し)で2026-09-14に main のソース・README・Cookbook・LICENSE・pyproject.toml を読解。推論・学習は未実行で、数値はすべて公式記載の転記です。
対応言語・ライセンス・類似モデルとの比較
日本語圏の読者にとって最初の疑問は「日本語が使えるか」ですが、公式資料に日本語の記載はありません。READMEのデモは英語(English)と中文の2本、Cookbookの指示テンプレートは「EN & CN」、同梱デモ音声のファイル名も en-・zh- です。Hugging Faceのモデルカードでは英語と中国語が宣言されていると報じられていますが(本記事の環境からは直接確認できず)、日本語音声での品質は誰も保証していない状態です。日本語の非言語音除去やノイズ除去のような「言語に依存しにくいタスク」は動く可能性がありますが、TTSや内容編集は試してから判断するしかありません。
ライセンスはMITで、LICENSEファイルは「学習コード・推論コード・パラメータ・重み」を対象と明記しています。ただし意味エンコーダのQwen2.5-Omni-3Bは別途取得する別ライセンスのモデルで、AuKのMITはそこに及びません。
同じ「オープンウェイトの音声モデル」でも、性格はかなり違います。当サイトで扱った近縁モデルと並べます。
| AuK | VoxCPM2 | VibeVoice | RealtimeTTS | |
|---|---|---|---|---|
| 正体 | 生成+編集+強調+分離の基盤モデル | トークナイザレスTTS(音色設計・クローン) | Microsoftの音声AI(ASR/TTS) | TTSエンジンをつなぐストリーミング層 |
| 規模 | 1.5B DiT+Qwen2.5-Omni-3B | — | — | ライブラリ |
| 主な用途 | 既存音声の編集が中心。TTSも可 | 多言語TTS | ASR/TTS | LLM応答の即時音声化 |
| ライセンス | MIT(Qwenは別) | 記事参照 | 記事参照 | 記事参照 |
| 日本語 | 明記なし | 多言語(記事参照) | 記事で実測 | エンジン依存 |
VoxCPM2はAuKの性能図で直接比較されている相手で、VoxCPM2|トークナイザレス多言語TTSをローカルで動かす(音色設計・クローニング対応)で解説しています。日本語の音声AIで実際に動かした例はVibeVoiceとは|Microsoft製の音声AI(ASR/TTS)の使い方と日本語対応の実際に、生成した音声をLLM応答に載せる話はRealtimeTTS:テキスト音声変換オープンソースで実現するLLM応答のゼロ遅延音声化手法にあります。AuKの立ち位置は「TTSの1つ」ではなく、録音済み音声を指示で作り替える側に重心があります。
開発状況と注意点
| 項目 | 実測(2026-09-14) |
|---|---|
| 初回コミット | 2026-09-04(Initial release) |
| 公開 | 2026-09-09(README News) |
| コミット数 | 23件 |
| スター/フォーク/オープンIssue | 737/50/4 |
| 直近の動き | 09-12に8件、09-13にMLX推論(別ブランチ)・CPUオフロード・ICASSP 2027ベースライン採用・PR #15マージ |
| エコシステム | SGLang-Omni(Day-0対応)、Xinference、コミュニティ製ComfyUI-AuKと量子化版、Awesome-Audio-Editing |
・若いリポジトリ:公開から1週間・コミット23件。APIやCLIフラグは変わりうる
・PyTorchの固定:torch>=2.7,<2.8 に固定されており、他のプロジェクトと環境を共有すると衝突しやすい。専用の仮想環境が前提
・Qwen2.5-Omni-3Bの別途取得:モデル本体とは別に3Bのエンコーダを落とす必要があり、Qwen3-Omniには未対応
・秒数指定:出力長を自分で決める設計。PEを使うか、--ref_text/--gen_text で推定させる
・ファインチューニング:JSONL+scripts/train.sh。同梱設定は8GPU前提で、docs/FINETUNING.md に単GPUへ落とす手順の記載があるかは各自確認が要る
まとめ
・向く:英語・中国語の音声を録り直さずに直したい(発話の置換、感情変更、ノイズ除去、話者分離)、24GB以上のGPUがある
・向かない:日本語品質を保証してほしい、16GB以下のGPU、PyTorch 2.7系に固定できない環境
・次に読む:Cookbook(docs/COOKBOOK.md)で自分のタスクの指示テンプレートを確認 → テキストのみTTSでVRAMを実測
参照ソース
・Tencent-Hunyuan/AuK(公式リポジトリ・README・docs/COOKBOOK.md・LICENSE) — タスク一覧・インストール・VRAM表・ライセンスの一次情報。2026-09-15時点のmain(コミット abccf0e 相当のPR #15マージ後)を読解
・AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing(arXiv:2609.08936) — READMEの引用情報(本記事の環境からは本文未取得)
・tencent/AuK(Hugging Face)/tencent/AuK-Flash — 重みの配布元
・ソース読解:src/auk/infer/infer_cli.py(既定NFE 32・CFG 2.0・bf16)、src/auk/infer/infer_auk.py(Flashの固定ステップ検出・VAE常駐)、src/auk/model/flux2_edit.py・cfm_edit.py(DiTとフローマッチング)、pyproject.toml(依存の固定)