PDF 構造化 API を選ぶとき、本当に効いてくるのは精度ではなく失敗したときに何が返るかだと思っている。100ページのうち3ページだけ読めなかったとき、全体が落ちるのか、3ページぶんだけ失敗が返るのか。そしてその3ページに課金されるのか。
opendocrouter.ai は LlamaIndex(run-llama)が出した文書パース用のルーターだ。OpenRouter がモデルを束ねるのと同じ形を、PDFのパースでやる。
ところがこのサイト、本記事の環境からは到達できない。egress プロキシに遮断されていて、APIのベースURLも同じホストにある。
curl https://www.opendocrouter.ai/
#   CONNECT tunnel: HTTP/1.1 403 Forbidden
それでも書けた。2026-10-07に公開された公式SDK 2本の型定義に、仕様がほぼ全部入っていたからだ。
30秒でわかる
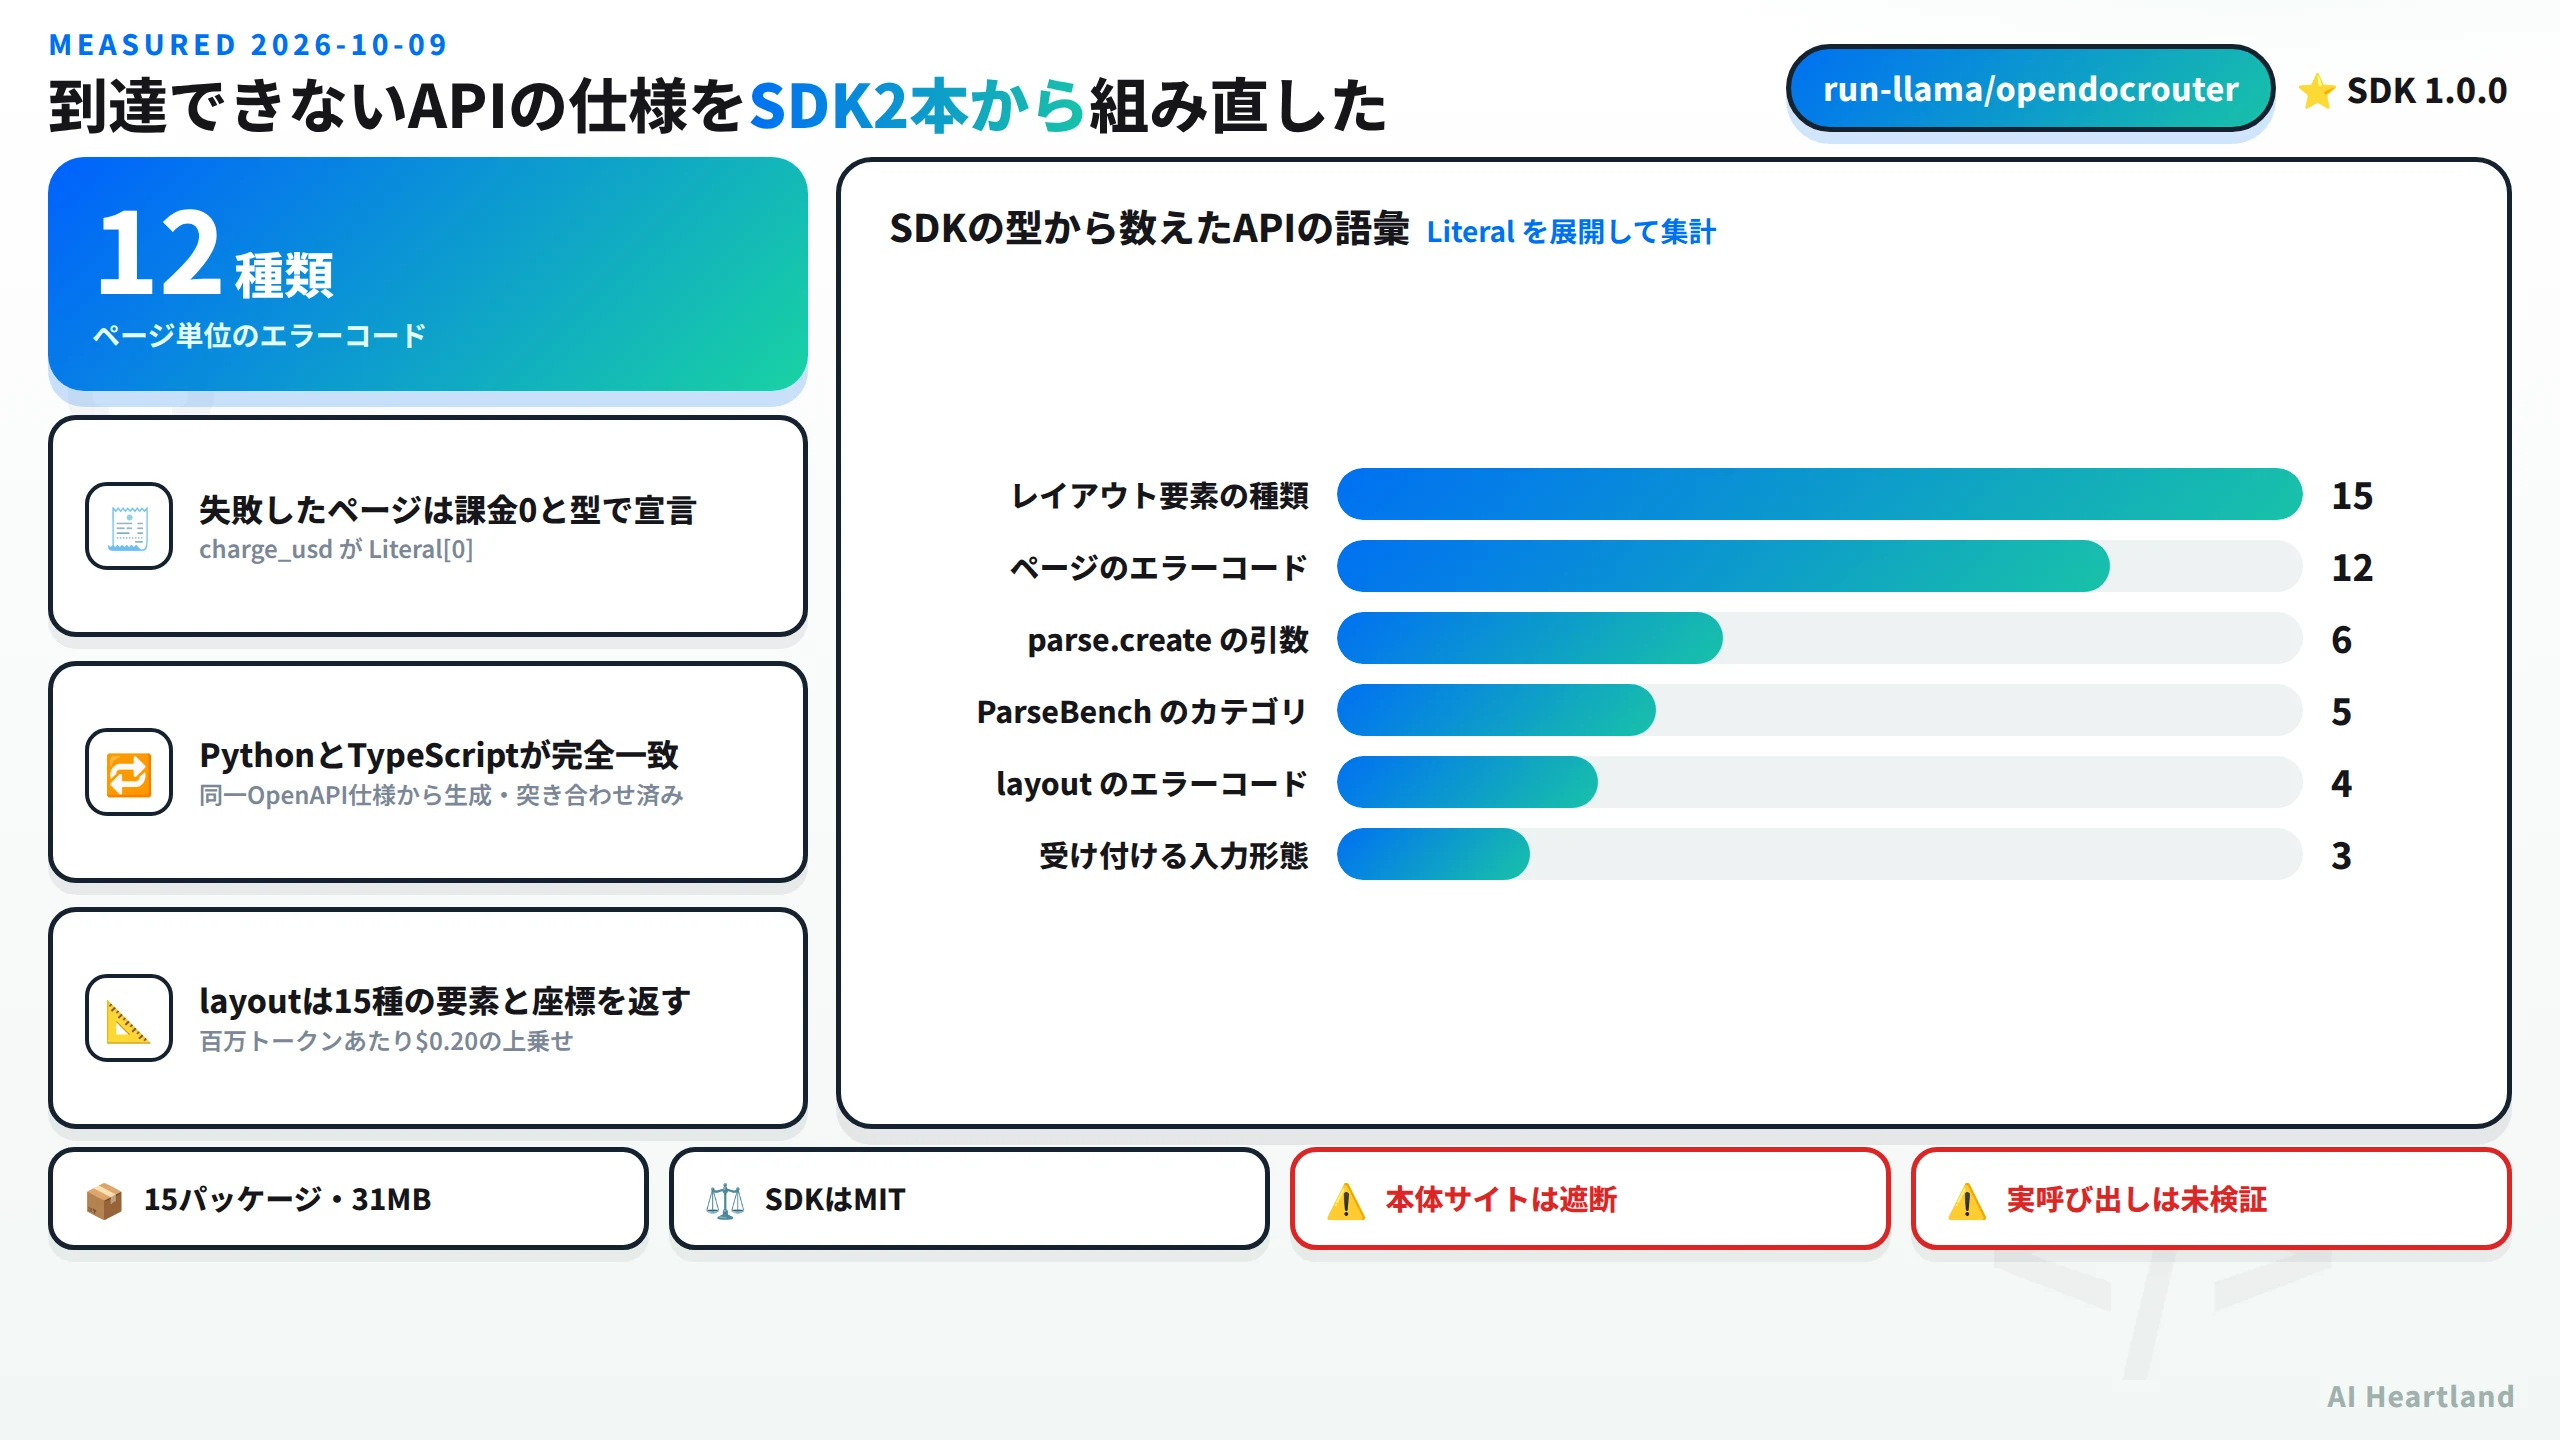
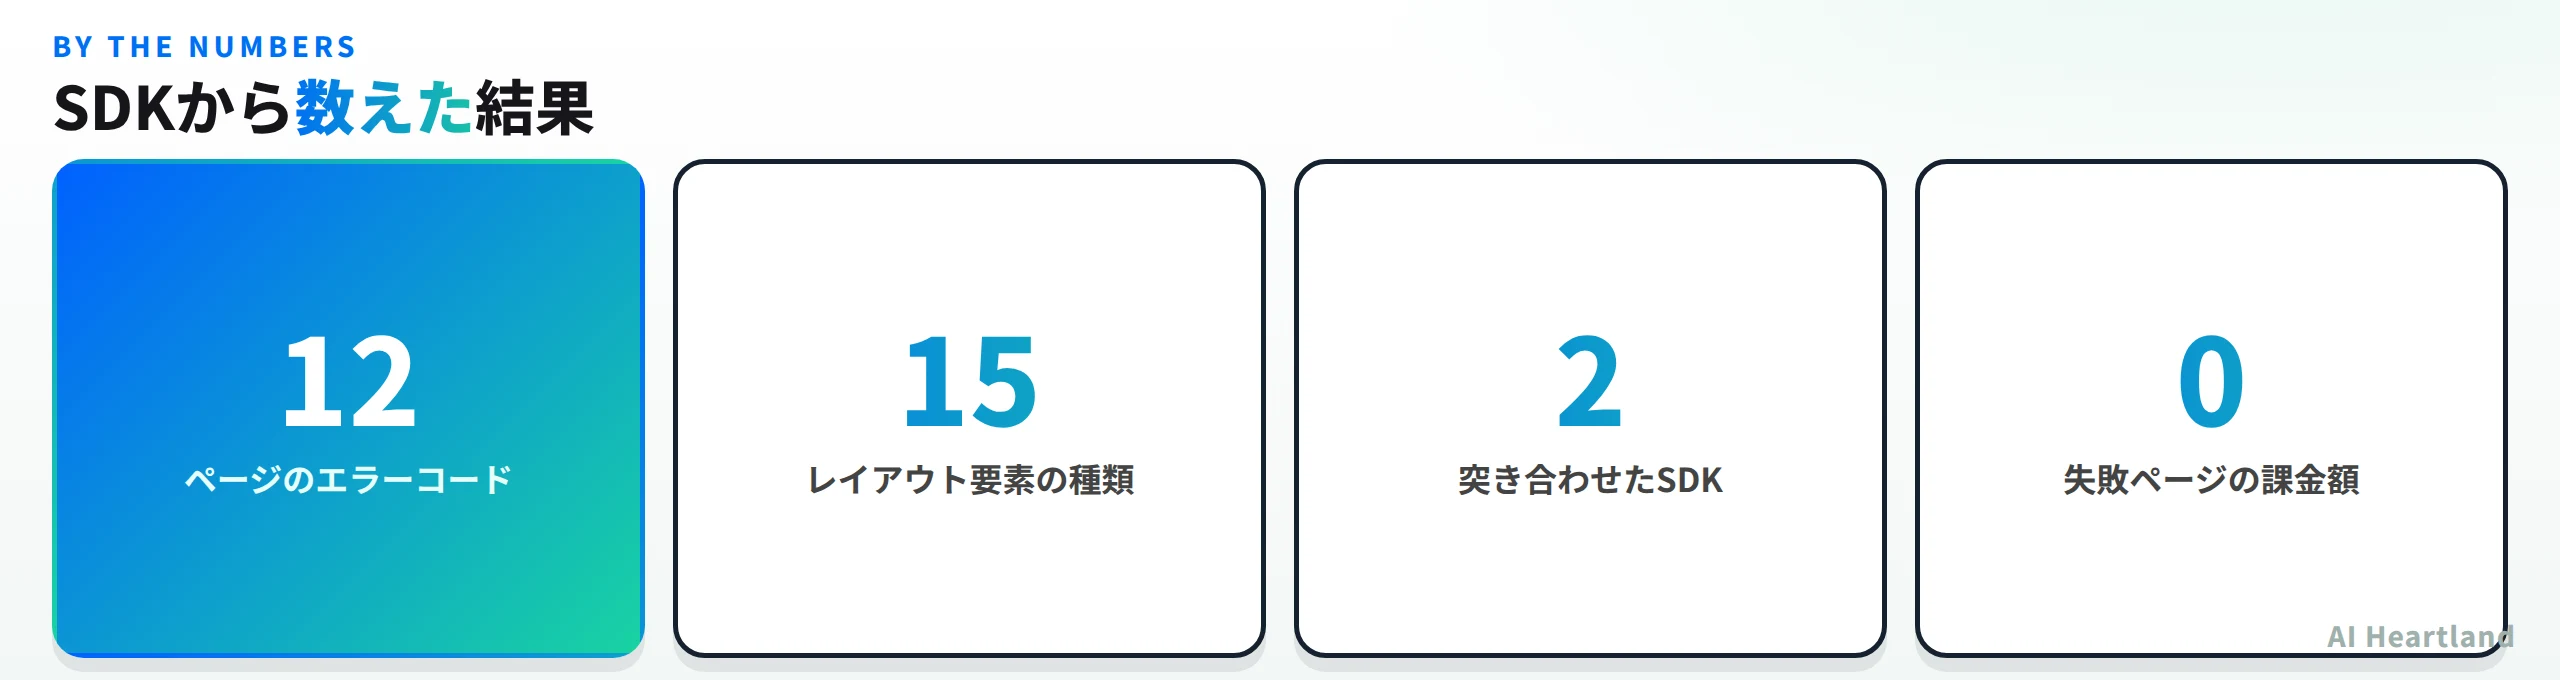
・ページ単位のエラーコードが12種類。repetitive_output(モデルが同じ文字列を繰り返した)など、LLMでページを読むと実際に起きる失敗が分類されている
・失敗したページの charge_usd は Literal[0]。「失敗分は課金しない」が文章ではなく型で宣言されている
・layout: true で15種類の要素と座標・確信度・Markdownの対応行が返る(百万トークンあたり$0.20の上乗せ)
・ParseBench という独自ベンチの5項目が、モデル一覧のレスポンスに埋め込まれている
・Python版とTypeScript版が完全に一致した。同一のOpenAPI仕様から生成されており、2系統で裏が取れた
・ただし本体サイトは遮断。実呼び出し・モデル一覧・価格・ベンチのスコアはいずれも未検証
RAG全体の組み立てはRAGとは?仕組み・構築・ベクトルDB選定までの2026年実装マップにまとめてある。本記事はその入口、文書を取り込む段で何が壊れるかを扱う。
PDF 構造化 APIの輪郭をSDKから描く
まず正体の確認から。SDKのREADMEにはこうある。
The OpenDocRouter Python library provides convenient access to the OpenDocRouter REST API from any Python 3.9+ application.
導入は素直に通った。
pip install opendocrouter
python -c "import opendocrouter; print(opendocrouter.__version__)"   # → 1.0.0
12秒・15パッケージ・31MB。 PyPI の初公開は2026-10-07、ライセンスは MIT(著作権表記は LlamaIndex, Inc.)。TypeScript 版は npm の @llamaindex/opendocrouter 1.0.0 で、同じく2026-10-07公開、依存ゼロ。
APIの面積は驚くほど小さい。api.md を読むと4リソースしかない。
| リソース | メソッド |
|---|---|
| Parse | POST /v1/parse / GET /v1/parse/{id} / DELETE /v1/parse/{id} |
| Uploads | POST /v1/uploads |
| Credits | GET /v1/credits |
| Models | GET /v1/models |
そして parse.create の引数は6つだけだった。型から展開して確かめている。
| 引数 | 内容 |
|---|---|
document |
必須。URL(最大50MB)/ base64インライン / 事前アップロードのID の3形態 |
model |
必須。GET /v1/models の id |
mode |
sync(モデルの max_sync_pages まで)/ async(500ページまで・cache 必須) |
pages |
1起点のページ・範囲指定 |
cache |
結果を暗号化して24時間保存。同じ文書・モデル・layout の既存ページは無料で返る |
layout |
要素と座標を付ける。百万トークンあたり$0.20の上乗せ |
インライン投入のMIMEは application/pdf / image/png / image/jpeg の3種に限定されている。
APIキーを渡さずにクライアントを作ると、リクエスト時ではなく生成時に止まる。
OpenDocRouterError: The api_key client option must be set either by passing api_key
to the client or by setting the OPEN_DOC_ROUTER_API_KEY environment variable
既定値も型から取れた。base_url は https://www.opendocrouter.ai、タイムアウトは接続5秒・読み書き60秒、max_retries は2。TypeScript 側も maxRetries 2・DEFAULT_TIMEOUT 1分で一致した。
失敗の仕方が12種類に分けてある
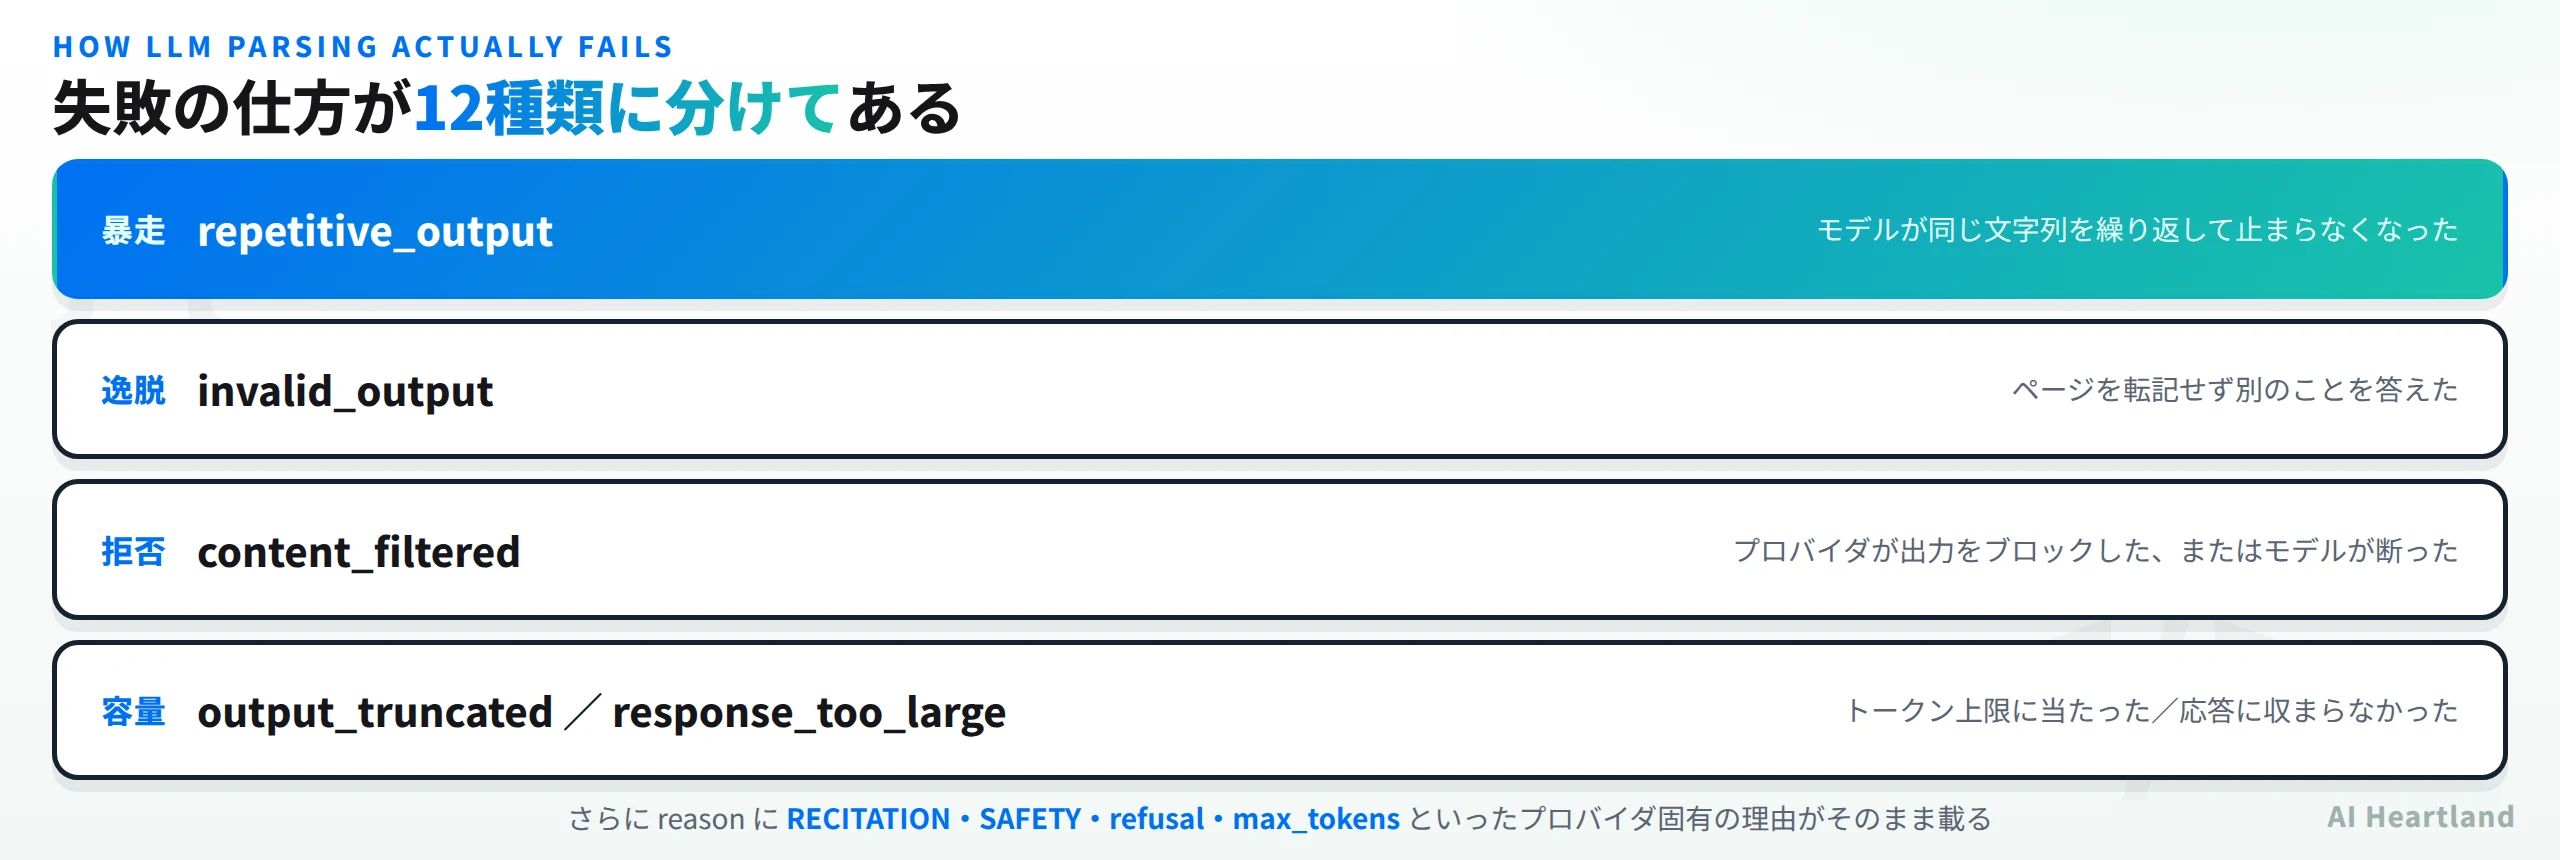
ここが一番面白かった。ページ単位のエラーコードを型から展開すると12種類あり、しかも全部に説明が付いている。
| コード | 型に書かれている説明 |
|---|---|
provider_error |
プロバイダがエラーを返した |
rate_limited |
プロバイダがそのページをレート制限した |
timeout |
期限までに終わらなかった |
output_truncated |
出力がトークン上限に当たった |
content_filtered |
プロバイダが出力をブロックした、またはモデルが断った |
repetitive_output |
モデルが同じ文字列を繰り返して止まらなくなった |
invalid_output |
モデルがページを転記せずに別のことを答えた |
empty_output |
モデルが何も返さなかった |
at_capacity |
期限までにプロバイダの空きが無かった |
unreadable_page |
PDFは開けたが、このページは分割も描画もできなかった |
response_too_large |
ページが応答に収まらなかった。pages で単独指定せよ |
not_processed |
非同期ジョブがこのページの前に終了した |
この12種類は、LLMに文書を読ませたことがある人なら全部心当たりがあるはずだ。 repetitive_output と invalid_output は特にそうで、前者はモデルが同じ行を延々と吐き続ける現象、後者は「このページには表が含まれています」などと内容を要約してしまって転記しない現象にあたる。従来のOCRには存在しなかった失敗で、LLMパーサ特有のものだ。
さらに reason フィールドがあり、プロバイダ固有の理由がそのまま載る——型のdocstringには RECITATION、SAFETY、refusal、max_tokens、repetition が例示されている。RECITATION は Gemini が学習データの復唱を疑って止めるときの理由で、どのプロバイダを裏で使っているかが透けて見える。
layout 側は別系統で4種類(provider_error / timeout / unreadable_page / at_capacity)。本文のパースは成功したがレイアウト抽出だけ失敗する、という状態を表現できるようになっている。
TypeScript 側のソースから同じ12種類を抽出したところ、完全に一致した。どちらも Stainless が同一のOpenAPI仕様から生成していて(各ファイル冒頭に File generated from our OpenAPI spec by Stainless)、2系統から同じ答えが出たことで本記事の仕様再構成に裏が取れている。
「失敗分は課金しない」が型で書いてある
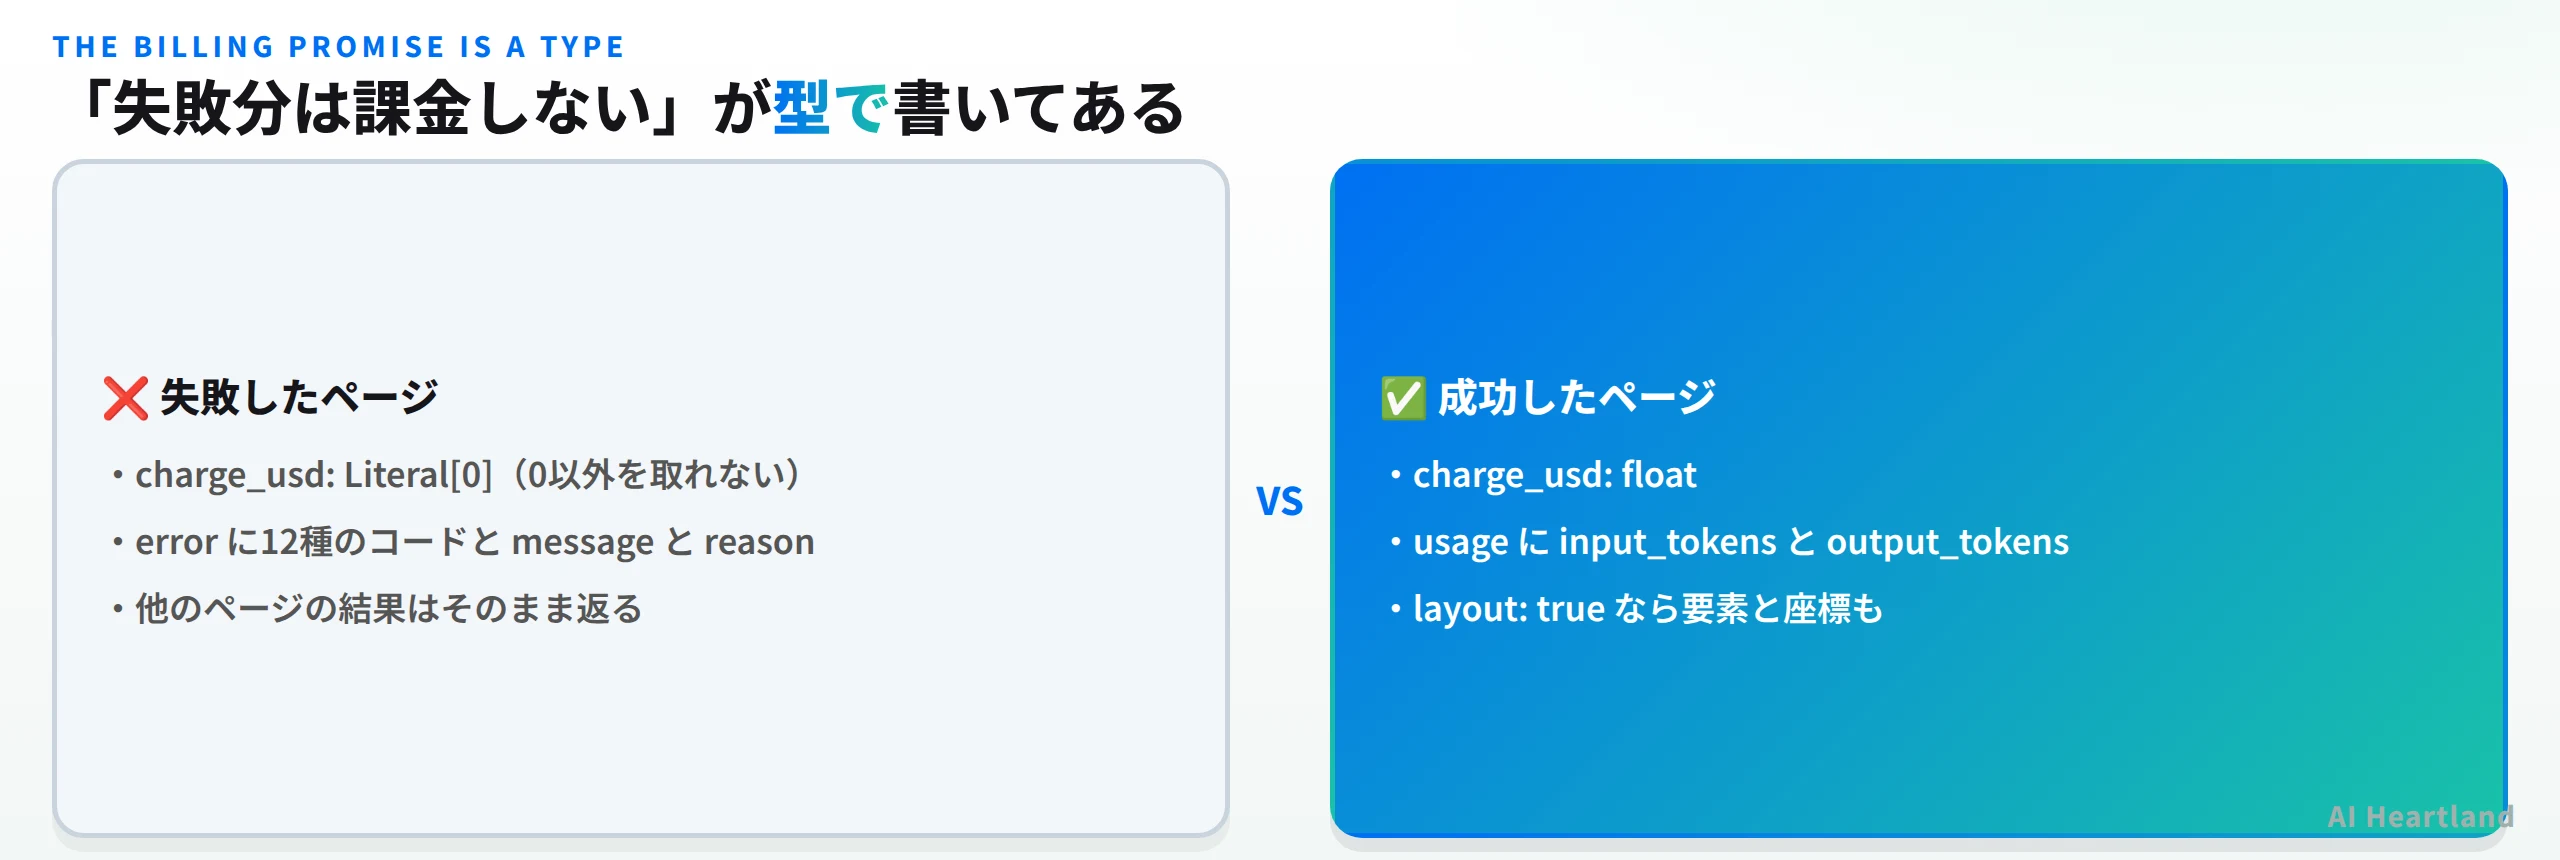
レスポンスの構造を読んでいて手が止まったのがここだ。
class PageErrorPage(BaseModel):
    charge_usd: Literal[0]
    error: PageErrorPageError
    page: int
    status: Literal["error"]
charge_usd が Literal[0]。 失敗したページの課金額は、型の上で0以外を取り得ない。
これは普通、利用規約やFAQに文章で書く類の約束だ。それを型に落としてあるということは、OpenAPI仕様の時点でそう定義されているということで、SDKを生成するたびに同じ制約が全言語に配られる。文章の約束は改定されても気づかないが、型が変われば差分が出る。
もうひとつ。Page は status を判別子とする Union(PageOkPage |
PageErrorPage)になっていて、1ページ失敗しても他のページの結果は返る。100ページのPDFで3ページ落ちたら、97ページぶんのMarkdownと、3ページぶんのエラーコードが返り、課金は97ページぶん——という挙動が構造から読める。 |
ルーター型のサービスでこれは効く。裏で複数のプロバイダに振り分ける以上、一部が失敗するのは例外ではなく通常運転だ。それを最初から当たり前として扱う設計になっている。
成功ページ側は charge_usd: float と usage(input_tokens / output_tokens)を持つ。ページごとにトークン量と金額が返るので、どのページが高くついたかを後から追える。
cache必須"] H --> J["ページごとに結果"] I --> J J --> K["成功ページ
markdown・usage・charge_usd"] J --> L["失敗ページ
12種のコード・charge_usd は0"] K --> M{"layout オプション"} M -->|"true"| N["15種の要素と座標
百万トークンあたり+0.20ドル"]
キャッシュが課金と非同期を兼ねている
cache の説明文を読むと、このフラグが3つの役割を持っていた。
Store the results, encrypted, for 24 hours:
GET /v1/parse/{id}?expand=markdownreads them andDELETE /v1/parse/{id}deletes them sooner. Pages your account already has stored for the same document, model andlayoutare served from them, free. Required forasync. Defaults to false.
① 結果の保管(暗号化して24時間、明示削除も可)、② 重複ページの無料配信(同じ文書・同じモデル・同じ layout 設定なら再課金しない)、③ 非同期モードの前提条件。
②が実務に効く。同じPDFを設定違いで何度も試すのは文書パースの検証でよくやることで、素直に実装すると毎回フルで課金される。ここでは文書とモデルと layout の3つが一致したページだけが無料で返る。layout を含めているのが細かくて、レイアウト抽出は追加課金のある別処理なので、それを変えたら再実行が要るという整理になっている。
③は設計上の制約だ。async は500ページまで扱えてジョブとしてポーリングするが、結果をどこかに置かないと取りに行けない。だから cache: true が必須になる。逆に sync はモデルごとの max_sync_pages が上限で、その場で結果が返る。ページ数で2つのモードを使い分け、長いほうは保管が必須という切り分けになっている。
なお DELETE /v1/parse/{id} が明示的に用意されていて、24時間を待たずに消せる。扱いに制約のある文書を投げる場合はこれが要るだろう——ただしルーター経由である以上、裏のプロバイダ側に何が残るかはこのAPIの範囲外だ。そこは本記事では確かめられていない。
モデル一覧が価格と採点を連れてくる
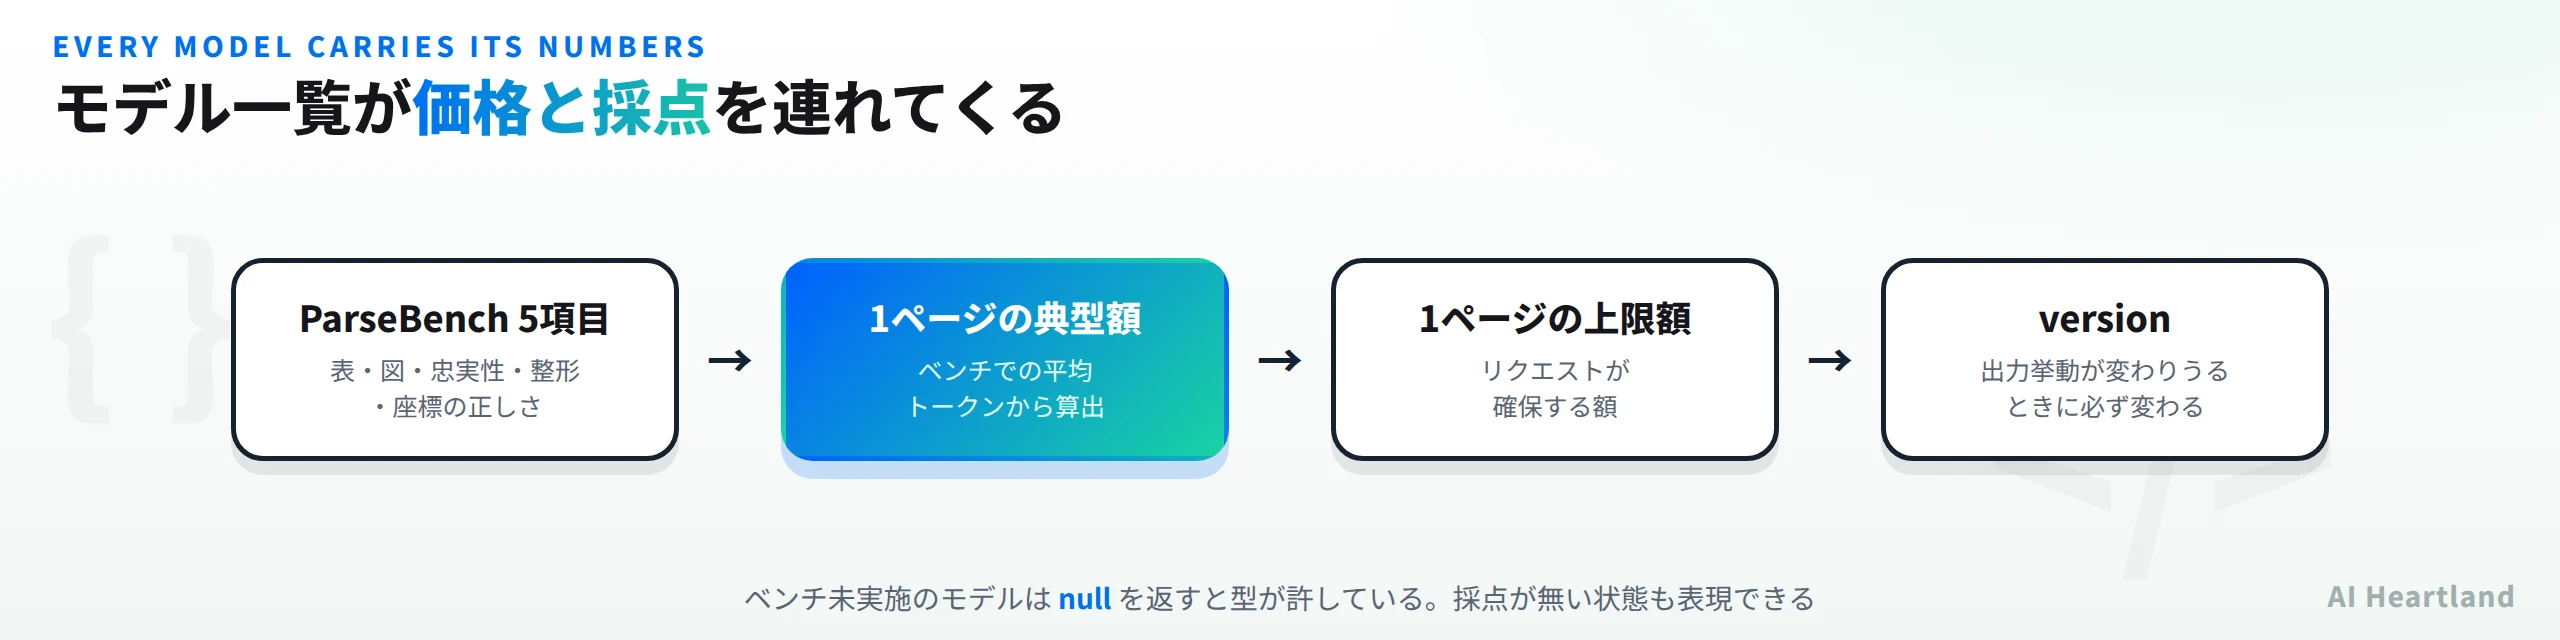
GET /v1/models のレスポンス型を読むと、モデル1件が持つ情報がかなり多い。
| フィールド | 内容 |
|---|---|
id / name |
指定に使うidと表示名 |
version |
出力の挙動が変わりうるときに必ず変わる |
price_per_million_tokens |
cached_input / input / output の3段 |
avg_charge_per_page_usd |
ParseBench での平均トークン数から出した1ページの典型額 |
max_charge_per_page_usd |
1ページが課金されうる上限(リクエストが1ページあたり確保する額) |
max_sync_pages |
sync モードで一度に投げられるページ数 |
parsebench |
5カテゴリのスコアとその平均 |
ParseBench というのが独自のベンチマークらしく、5つのカテゴリが型に埋まっている。
・tables(表)
・charts(図表)
・content_faithfulness(内容の忠実さ)
・semantic_formatting(意味に沿った整形)
・visual_grounding(layout: true が各要素をページ上にどれだけ正しく置けるか)
score はこの5つの平均と定義されている。カテゴリの切り方が実務的で、特に visual_grounding を独立させているのは、レイアウト機能を売る以上そこを別に測るという意思表示に見える。
細かいが良いと思ったのは、parsebench と avg_charge_per_page_usd がどちらも Optional で「Null until benchmarked(ベンチが終わるまでnull)」と注記されていることだ。採点がまだ無い状態を型が許している。 新しいモデルを追加した直後にスコアを捏造せず、nullのまま出す運用が前提になっている。
max_charge_per_page_usd の説明も具体的だった——「1ページが課金されうる最大額。これがリクエストが1ページあたり確保する額」。つまり先に上限額を予約して、実際の消費ぶんで精算する方式だ。GET /v1/credits が balance_usd / reserved_usd / available_usd の3つを返すのも同じ仕組みで、「実行中のリクエストが押さえている額」が見える。
ただしParseBench のスコアそのものは取得できていない。サーバー側のデータで、本記事の環境からは GET /v1/models を叩けない。ベンチの中身(何件の文書で、どう採点するのか)も公開されているのか分からない。ここは未検証のまま残る。
到達できないサービスをどこまで書けるか
今回やったことを整理しておく。本体サイトに一度も到達しないまま、ここまで分かった。
| 分かったこと | 根拠 |
|---|---|
| APIの全リソースとメソッド | SDKの api.md(生成物) |
| リクエストの全パラメータと制限 | parse_create_params.py の型とdocstring |
| レスポンスの全構造 | parse_record.py の型 |
| 失敗の分類12種と各説明 | Literal の展開とdocstring |
| 課金の約束 | charge_usd: Literal[0] |
| 料金体系の構造 | model_list_response.py の型 |
| ベンチのカテゴリ | DataParsebench の型 |
| クライアントの既定値 | 実際にインスタンス化して取得 |
分からないのは「実際の値」だけだ。どのモデルが載っているか、1ページいくらか、ParseBench のスコアがいくつか。構造は全部分かって、数字だけが空いている。
これは Stainless のようなOpenAPI仕様からSDKを生成する仕組みの副産物だと思う。仕様のdocstringがそのまま各言語の型に転記されるので、SDKを1つ入れればAPIドキュメントを読んだのとほぼ同じ情報が手に入る。そして2言語ぶんあれば、互いに突き合わせて転記ミスを除ける。
当サイトでは以前にも、一次ソースが遮断された状態から配布物だけで記事を書いたことがある。やり方は毎回同じで、公称を読む代わりに配られたものを読む。今回はそれがたまたま型定義だった、というだけだ。
この方法の限界もはっきりしている。型は「何が返りうるか」しか語らない。 repetitive_output というコードが定義されていることと、実際にモデルが暴走したときに正しくそのコードが返ることは別の話だ。同様に charge_usd: Literal[0] は請求の意図を示すが、請求書そのものではない。設計の表明としては読めるが、動作の証明にはならない。 そこを混ぜないように、本記事では「型に書いてある」と「実際にそうなる」を区別して書いている。
ついでに同じ LlamaIndex の仕事として、当サイトはliteparse|LlamaIndex製RustドキュメントパーサがRAG前処理の速度ボトルネックも測っている。あちらは「速いローカルパーサ」で、こちらは「複数のモデルに振り分けるルーター」。同じ会社が、同じ前処理の問題に別の方向から手を出しているのは押さえておくと見通しが良い。文書が素直なら liteparse で十分で、壊れたPDFや図表が多いものはモデルに読ませる、という使い分けになるだろう。
ルーティングで解く発想そのものはpdf-inspector徹底解説|PDFがOCR必要かを25msで判定しMarkdown化するRust製CLIでも扱った。あちらはローカルで25msの判定、こちらはAPIの向こうで複数モデルを束ねる。層が違う。
PDF 構造化 APIとして導入するかの判断材料
向いていそうな場面
・複数のパースモデルを試して比べたい場合。model を差し替えるだけで切り替わり、価格もベンチのスコアも同じレスポンスに載る
・部分的な失敗を前提に組みたい場合。ページ単位で成功と失敗が分かれ、失敗ページは課金されない(型の上では)
・座標が要る場合。layout: true で15種類の要素とページ上の位置、Markdownの対応行まで返る。引用元をハイライトするUIを作るならここが効く
向いていなさそうな場面
・外部に文書を出せない場合。ルーターである以上、文書はサーバーを経由し、裏のプロバイダへ渡る
・ローカル完結したい場合。同じ LlamaIndex の liteparse のような手元で動くパーサのほうが素直
・今すぐ本番に入れたい場合。SDKが公開されたのが2026-10-07で、本記事執筆時点で2日しか経っていない。SDKリポジトリのstarはどちらも0
何を代替するかは「パースモデルを自分で選んで、自分で契約して、自分でフォールバックを書く」作業だ。文書パースのモデルは増える一方で、どれが自分の文書に合うかは試さないと分からない。model の文字列だけで切り替えられるなら、その試行が軽くなる。
一方で、本記事が確かめたのは型であって挙動ではない。charge_usd: Literal[0] は立派な宣言だが、実際の請求書を見たわけではない。12種類のエラーコードが本当に正しく出し分けられるかも分からない。ParseBench のスコアに至っては1つも見ていない。
それでも書く価値があると思ったのは、この型定義そのものが設計の表明になっているからだ。LLMで文書を読むと repetitive_output も invalid_output も起きる、と認めたうえで、それぞれに名前を付け、失敗ページは課金しないと型で書く。そこまでやっているサービスは多くない。少なくとも何を問題だと思っているかは、サイトを見なくても分かった。
参照ソース
・run-llama/opendocrouter-py(GitHub) — 本記事が読んだ Python SDK。MIT
・run-llama/opendocrouter-ts(GitHub) — 突き合わせに使った TypeScript SDK
・opendocrouter(PyPI) — 1.0.0・2026-10-07公開
・@llamaindex/opendocrouter(npm) — 1.0.0・依存ゼロ
計測値は data/measurements/runs/2026-10-09-opendocrouter-parse-api.json に記録した。環境は Ubuntu 24.04 / x86_64 / Python 3.12.3。www.opendocrouter.ai はこの環境から到達できないため、実際のAPI呼び出し・モデル一覧・価格・ParseBench のスコア・課金の挙動はいずれも未検証。本記事の記述はすべて公式SDK 2本の型定義と、それをインスタンス化して得た既定値に基づく。