E2Eテスト AI を名乗るツールは増えた。どれも「セレクタを書かなくていい」と言う。そこまでは同じで、分かれるのは合否を誰が決めるかと、速さとコストの主張を確かめられるかの2点だと思う。
dmoka/quicke2e は README にこう書いている。
QuickE2E,
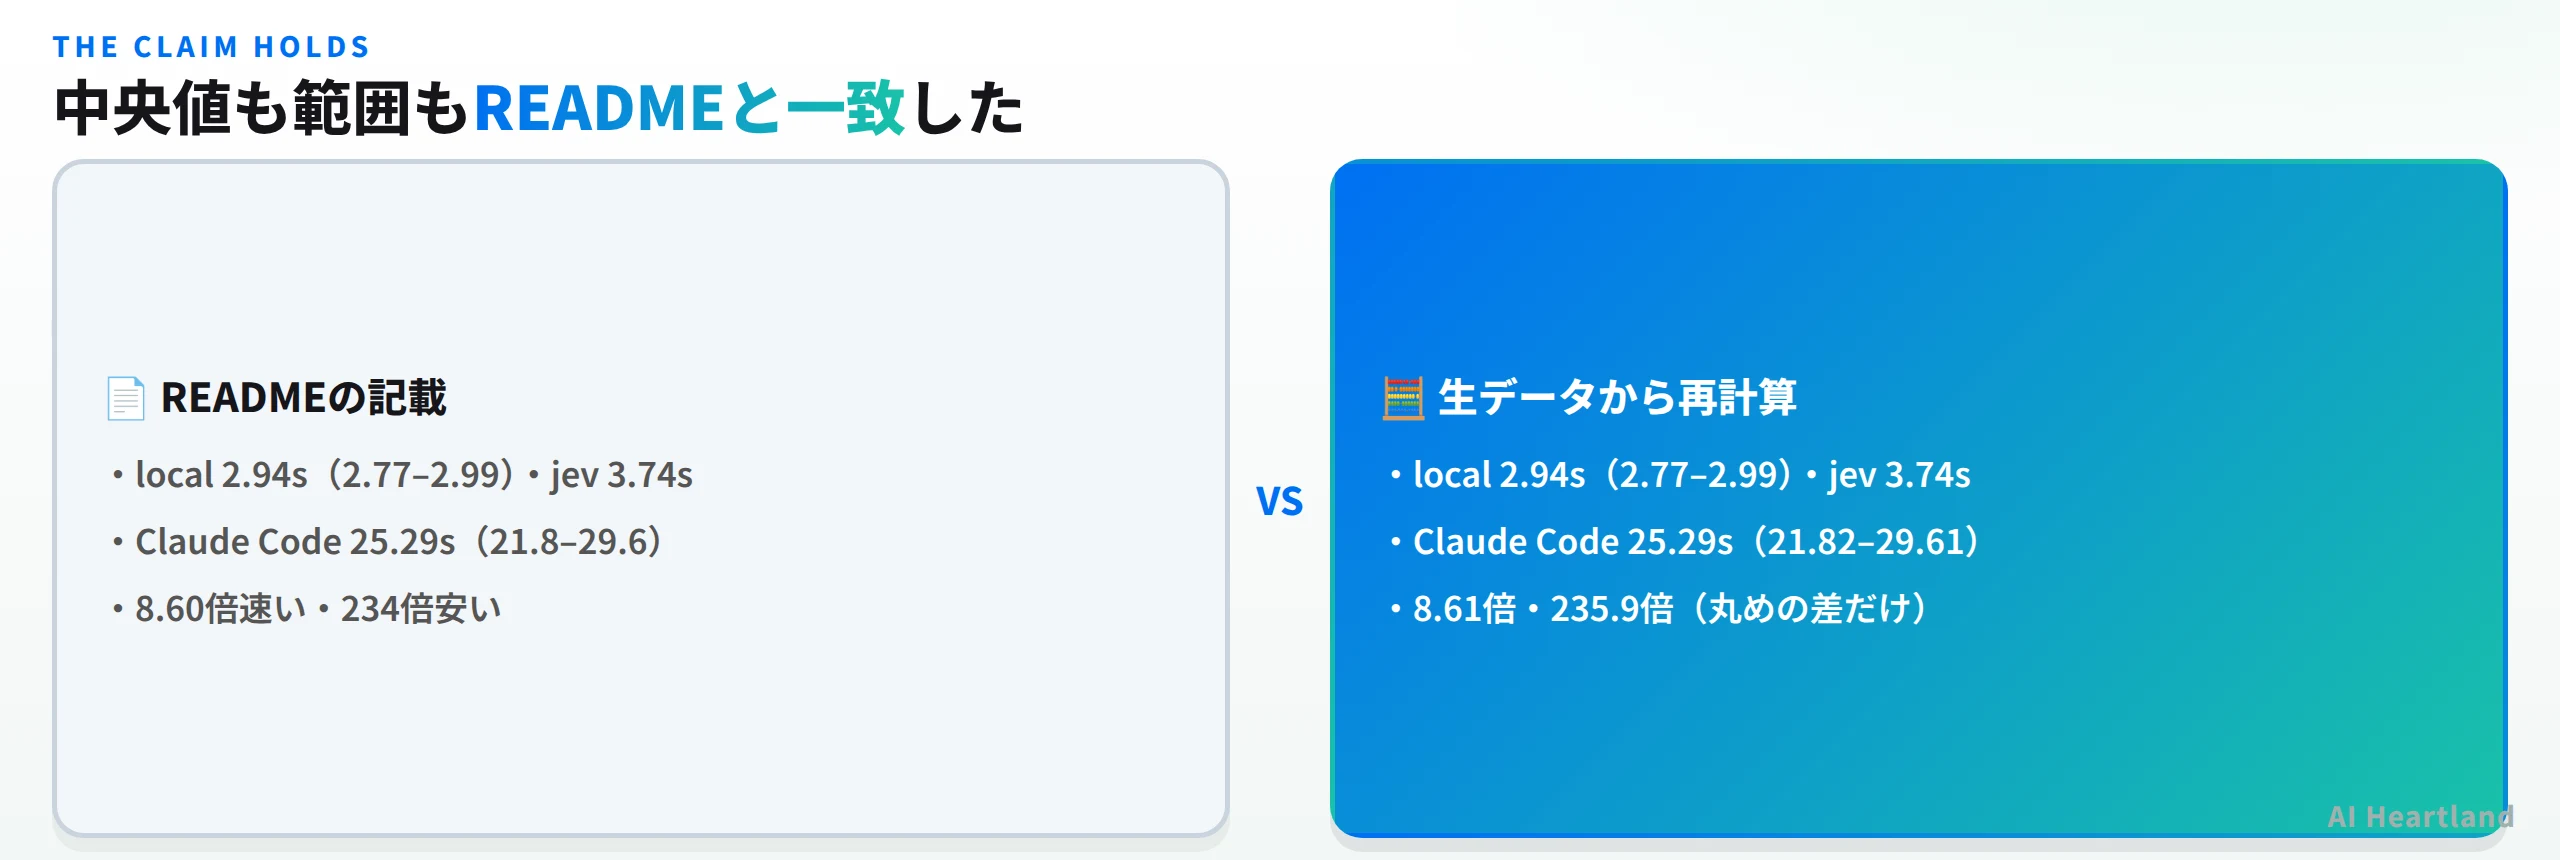
localengine: 2.94 s, $0 / QuickE2E,jevengine: 3.74 s, $0.00038 / Claude Code + Playwright MCP, Sonnet 5: 25.29 s, $0.08968.60× faster, 234× cheaper
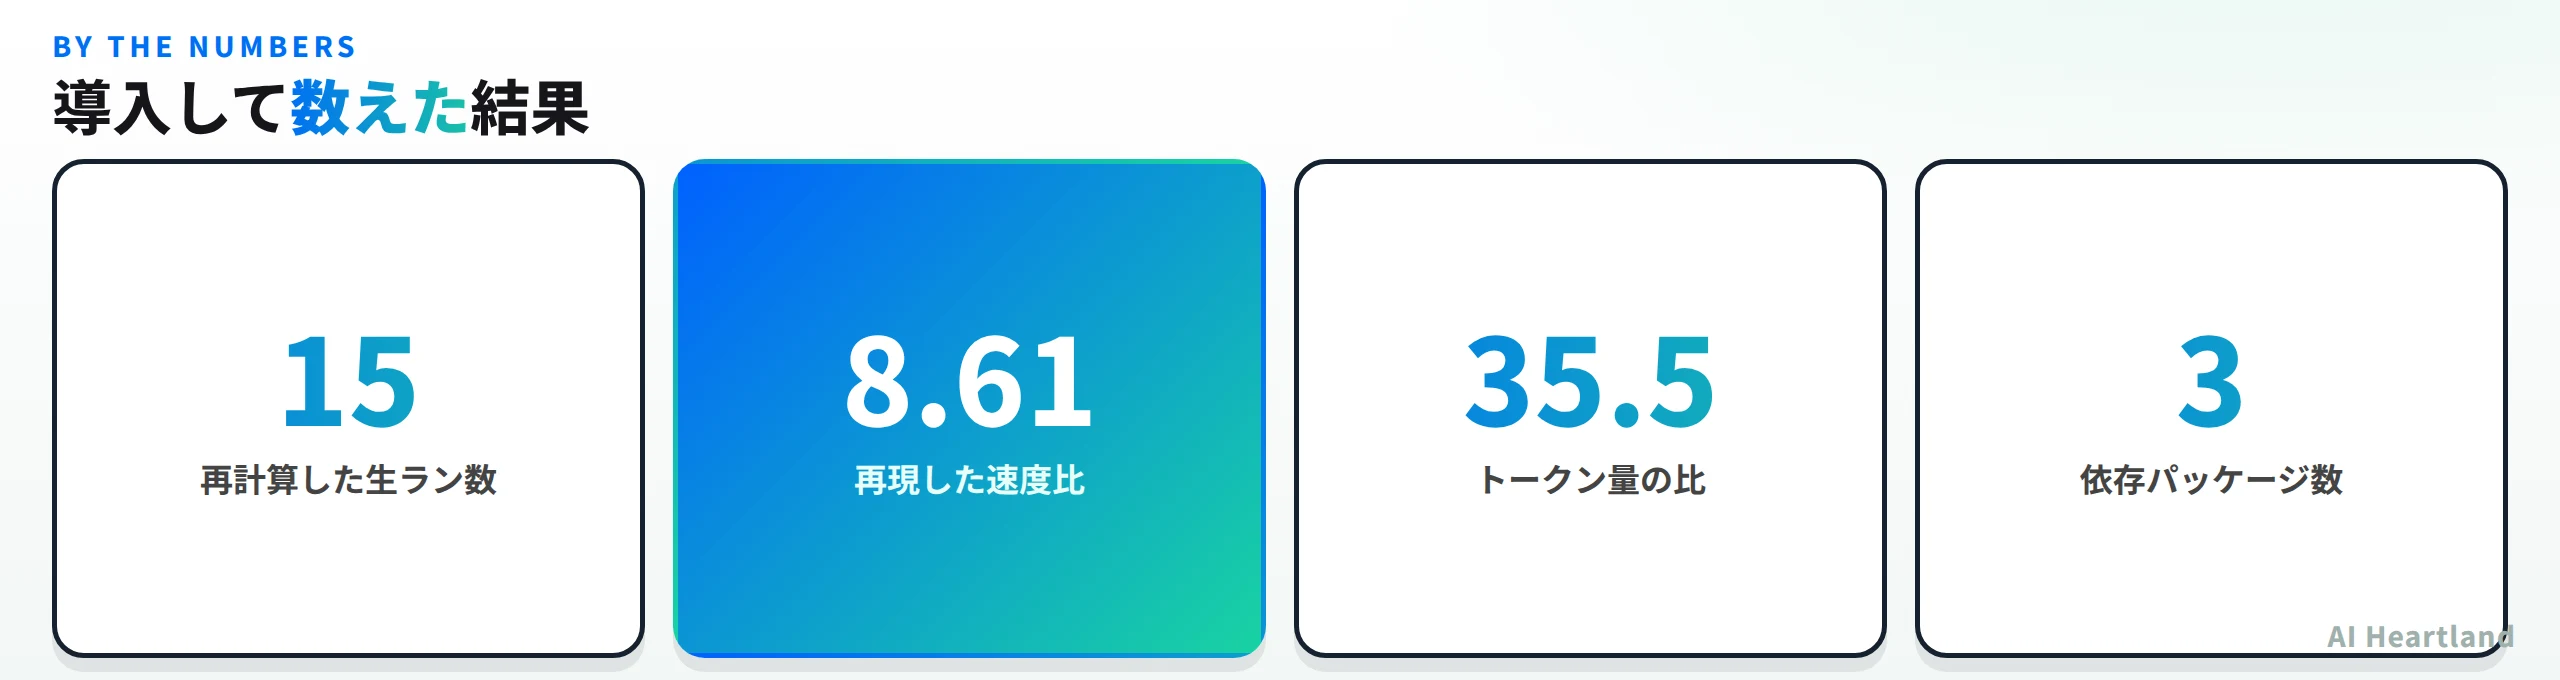
この手の数字は普通あとから確かめられない。ところがこのリポジトリは、その数字を出した生ラン15件を bench/results/ にコミットしている。それなら計算し直せる。やってみたら再現した上に、READMEが書いていない差がもうひとつ出てきた。
30秒でわかる
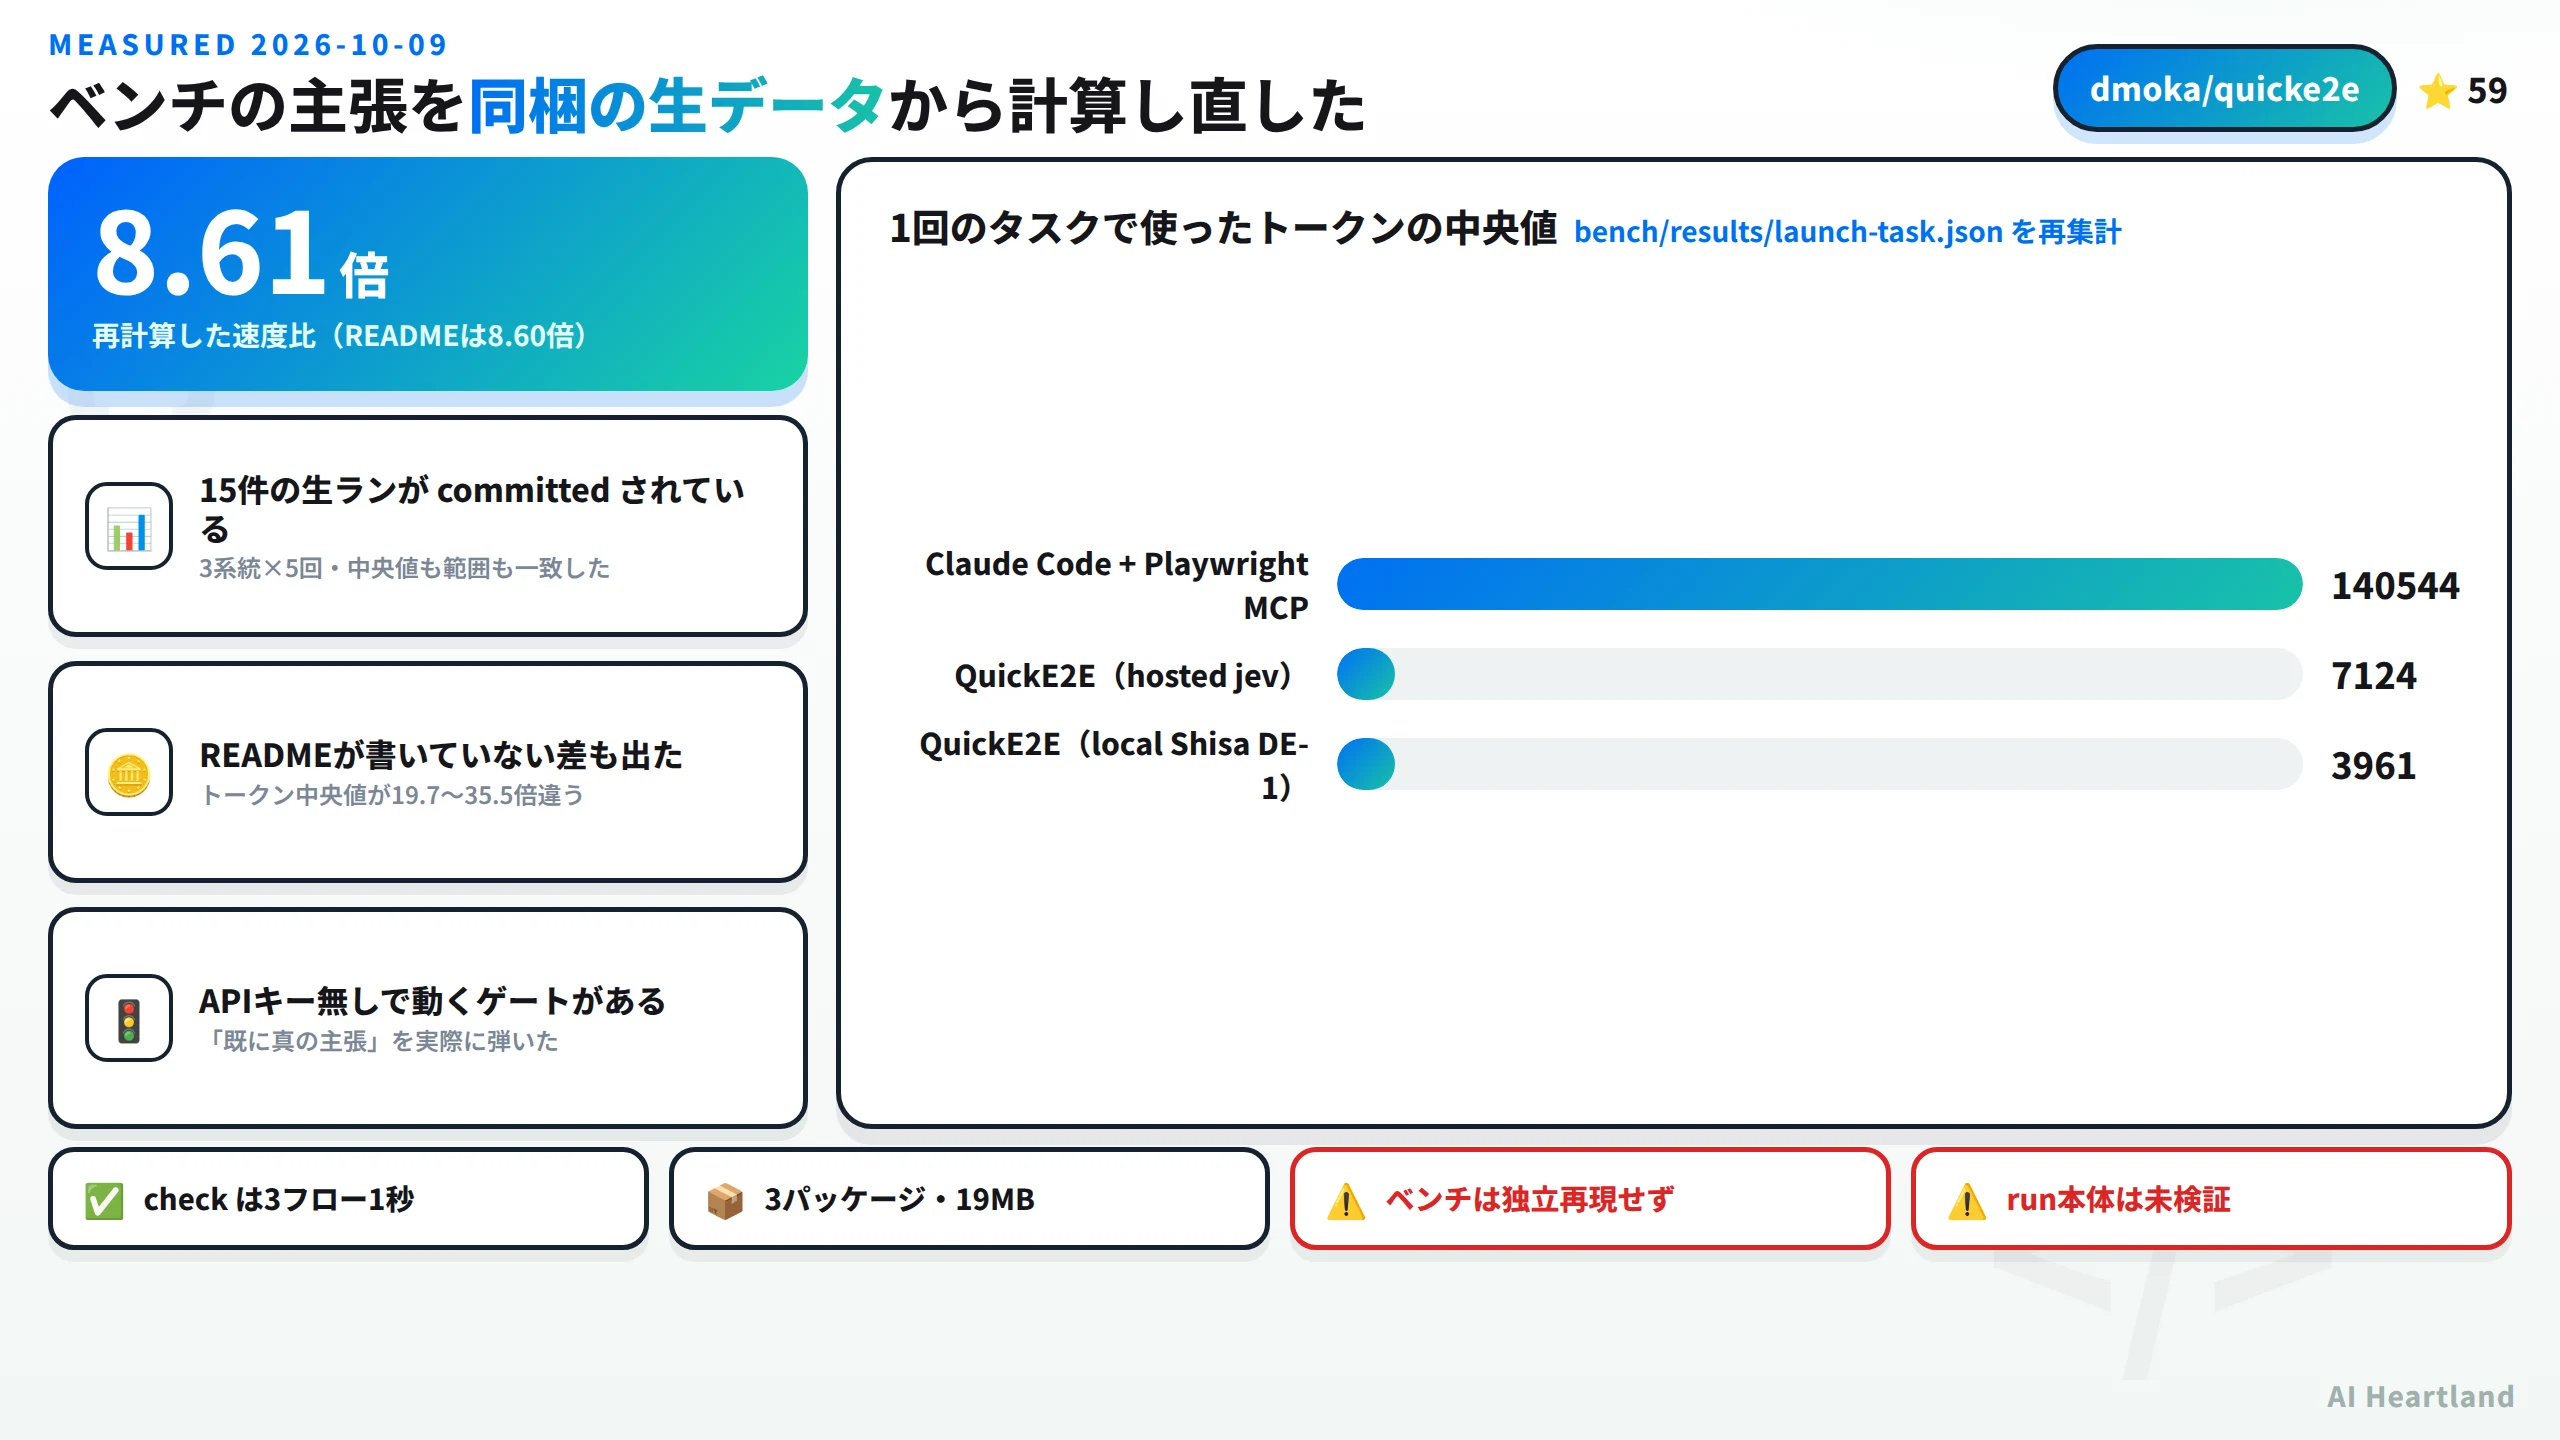
・README の数字は生データから再現した。中央値も範囲も一致し、比は8.61倍(README は8.60倍)
・READMEが触れていない差があった。1回のタスクのトークン中央値が 3,961 / 7,124 / 140,544——コスト234倍の機序はここ
・check はAPIキー無しで最後まで動く。同梱3フローが1秒で ok
・そして「開始ページで既に真の assertion」を実際に弾いた。WEAK_ASSERTION で終了コード1
・依存は playwright 1本だけ。3パッケージ・19MB・脆弱性0件
・ただしベンチは作者が自作アプリで測った値。本記事が確かめたのは算術と内部整合性で、独立再現ではない
—
エージェント基盤全体の選び方はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその枝として、エージェントに任せる範囲をどこで切るかを測る。
E2Eテスト AIが分かれるのは「合否を誰が決めるか」
まず正体の確認から。README の1文はこうだ。
Plain-English end-to-end tests for web apps. A small decision model picks each click. Code decides pass or fail.
後半が設計の全部だ。モデルが決めるのは次の一手まで、合否はコードが決める。 spec はこう書く(同梱の例)。
export default [
  { name: "login", start: "/login.html", maxSteps: 8,
    inputs: { email: "[email protected]", password: "Demo-Pass-42!" },
    goal: "Sign in with the email and password.",
    done: "The dashboard is shown.",
    expectUrl: "login-done\\.html", expect: ["Signed in as"] },
];
goal と done は自然文で、セレクタは1つも無い。一方 expectUrl と expect は正規表現と文字列で、ここは機械が判定する。assertion は6種類(expectUrl / expect / expectState / expectSeen / expectAbsent / expectGone)ある。
導入は軽い。
npm i -D quicke2e @playwright/test
npx quicke2e --version   # → quicke2e 0.5.0
実測は 4秒・3パッケージ・19MB・脆弱性0件。dependencies は playwright ^1.50.0 の1つだけで、peerDependencies は無い。engines は node >=20。
| 項目 | 実測値 |
|---|---|
| バージョン | 0.5.0(npm quicke2e) |
| ライセンス | MIT |
| 導入 | 4秒 / 3パッケージ / 19MB / 脆弱性0 |
| 依存 | playwright のみ |
| 本体ソース | src 9ファイル2,620行+bin 417行 |
| 付属 | bench 49 / fixtures 80 / examples 8 / codegen 3 / local-engine 4 |
| エージェント向け入口 | AGENTS.md(206行)・llms.txt(16行)・Agent Skill(162行) |
| star / fork | 59 / 4 |
エージェント向けの入口を3種類も用意しているのが今風だ。AGENTS.md には spec の書き方・終了コード・--json レコードの形が書いてある。
ひとつ環境面の注意を書いておく。同梱の playwright 1.63.0 は chromium-1243 を要求するが、本記事の環境に用意されていたのは chromium-1194 だった。そのままだと止まる。
Chromium is not installed for Playwright. Run: npx playwright install chromium
これは QuickE2E の問題ではなく Playwright のブラウザ版数固定によるもので、メッセージ自体は原因と対処を正しく指している。本記事では既存の 1194 を 1243 のパスへシンボリックリンクして Chromium 141.0.7390.37 を起動させ、以降を計測した。
生データ15件を計算し直す
bench/results/launch-task.json には、タスク(TicketBay のトップページから購入まで)を3系統×5回走らせた生ランが入っている。1件はこういう形だ。
{"task":"buy-from-home","arm":"quicke2e","engine":"local:shisa-de-1","run":1,
 "pass":true,"wallMs":2990,"cost":0,"tokens":3961,"steps":7,
 "captured":"2026-10-06","version":"0.5.0",
 "decisionMs":[127,114,87,82,80,111,112]}
wallMs から中央値を取り直した結果がこうなる。
| 系統 | n | pass | 実時間の中央値 | 範囲 | コスト中央値 | 手数 |
|---|---|---|---|---|---|---|
QuickE2E local (Shisa DE-1) |
5 | 5/5 | 2.94s | 2.77–2.99s | $0 | 7 |
QuickE2E jev |
5 | 5/5 | 3.74s | 3.59–4.74s | $0.00038 | 7 |
| Claude Code + Playwright MCP (Sonnet 5) | 5 | 5/5 | 25.29s | 21.82–29.61s | $0.08964 | 15–16 |
README の記載と、中央値も範囲も一致した。 比を出すと 25.29/2.94 = 8.61、25.29/3.74 = 6.76。README は8.60倍・6.76倍と書いている。コストは 0.08964/0.00038 = 235.9倍で、README の「234」は $0.0896/$0.00038 を丸めた値だ。桁は変わらない。
判断時間も計算できた。decisionMs を全部集めると、local の中央値86ms(n=35)、jev が300ms(n=35)。これも README の記載どおりだった。
READMEが書いていない差
生データには tokens が入っている。READMEはこれに触れていないが、集計するとこうなった。
| 系統 | トークン中央値 |
|---|---|
QuickE2E local |
3,961 |
QuickE2E jev |
7,124 |
| Claude Code + Playwright MCP | 140,544 |
35.5倍(local比)と19.7倍(jev比)。コストが234倍違う機序はここにある。Claude Code 側は15〜16回のツール呼び出しをするたびにページの状態を文脈へ積み上げていくので、1タスクで14万トークンに届く。QuickE2E は7ステップで、1回の判断に渡す情報が小さい。
速さの差(8.6倍)より、トークンの差(35倍)のほうが本質に近いと思う。速さは機械を変えれば縮むが、文脈に積む量の差は設計から来ている。この観点は当サイトでもCloudflare cf CLIとは|2,936コマンドをエージェントに渡さない設計を実測で確かめるで扱った。渡すものを減らす設計は、速さではなくトークンで効く。
この再計算で何が言えて、何が言えないか
はっきりさせておく。言えるのは「READMEの数字は、同梱の生データと矛盾しない」までだ。
・計算は合っている(中央値・範囲・比・判断時間がすべて一致)
・データは改ざんの痕跡なく15件そろっている(3系統×5回、pass も全て記録)
・取得条件が書かれている(M2 Max、TicketBay の特定ブランチ、2026-10-06、QuickE2E 0.5.0)
言えないのは独立再現だ。 これは作者が自作アプリの上で、自分の手で測った値で、本記事の環境には OPENROUTER_API_KEY も対象アプリも無い。Claude Code 側の条件が公平かどうか(プロンプト、MCP の設定、リトライの扱い)も確かめていない。
ただ README 自身が「Claude Code’s median changes from day to day on the same task: 20.89 s then, 25.29 s on 2026-10-06」と、自分に不利なぶれを先に書いている。生データを置いて、条件を書いて、ぶれを認める——ベンチの出し方としては誠実な部類だ。
goal・done・inputs"] --> B["quicke2e check"] B --> C{"主張しているか"} C -->|"assertionが無い"| D["終了コード2
使える6種類を列挙"] C -->|"開始ページで既に真"| E["終了コード1
WEAK_ASSERTION"] C -->|"通る"| F["quicke2e run"] F --> G{"エンジン"} G -->|"jev(既定)"| H["OpenRouter経由
判断300ms"] G -->|"local"| I["Apple Silicon限定
判断86ms"] H --> J["モデルが次の一手を選ぶ"] I --> J J --> K["コードがassertionを評価"] K --> L["--emit でPlaywright specへ"]
モデルを呼ぶ前に止まるゲート
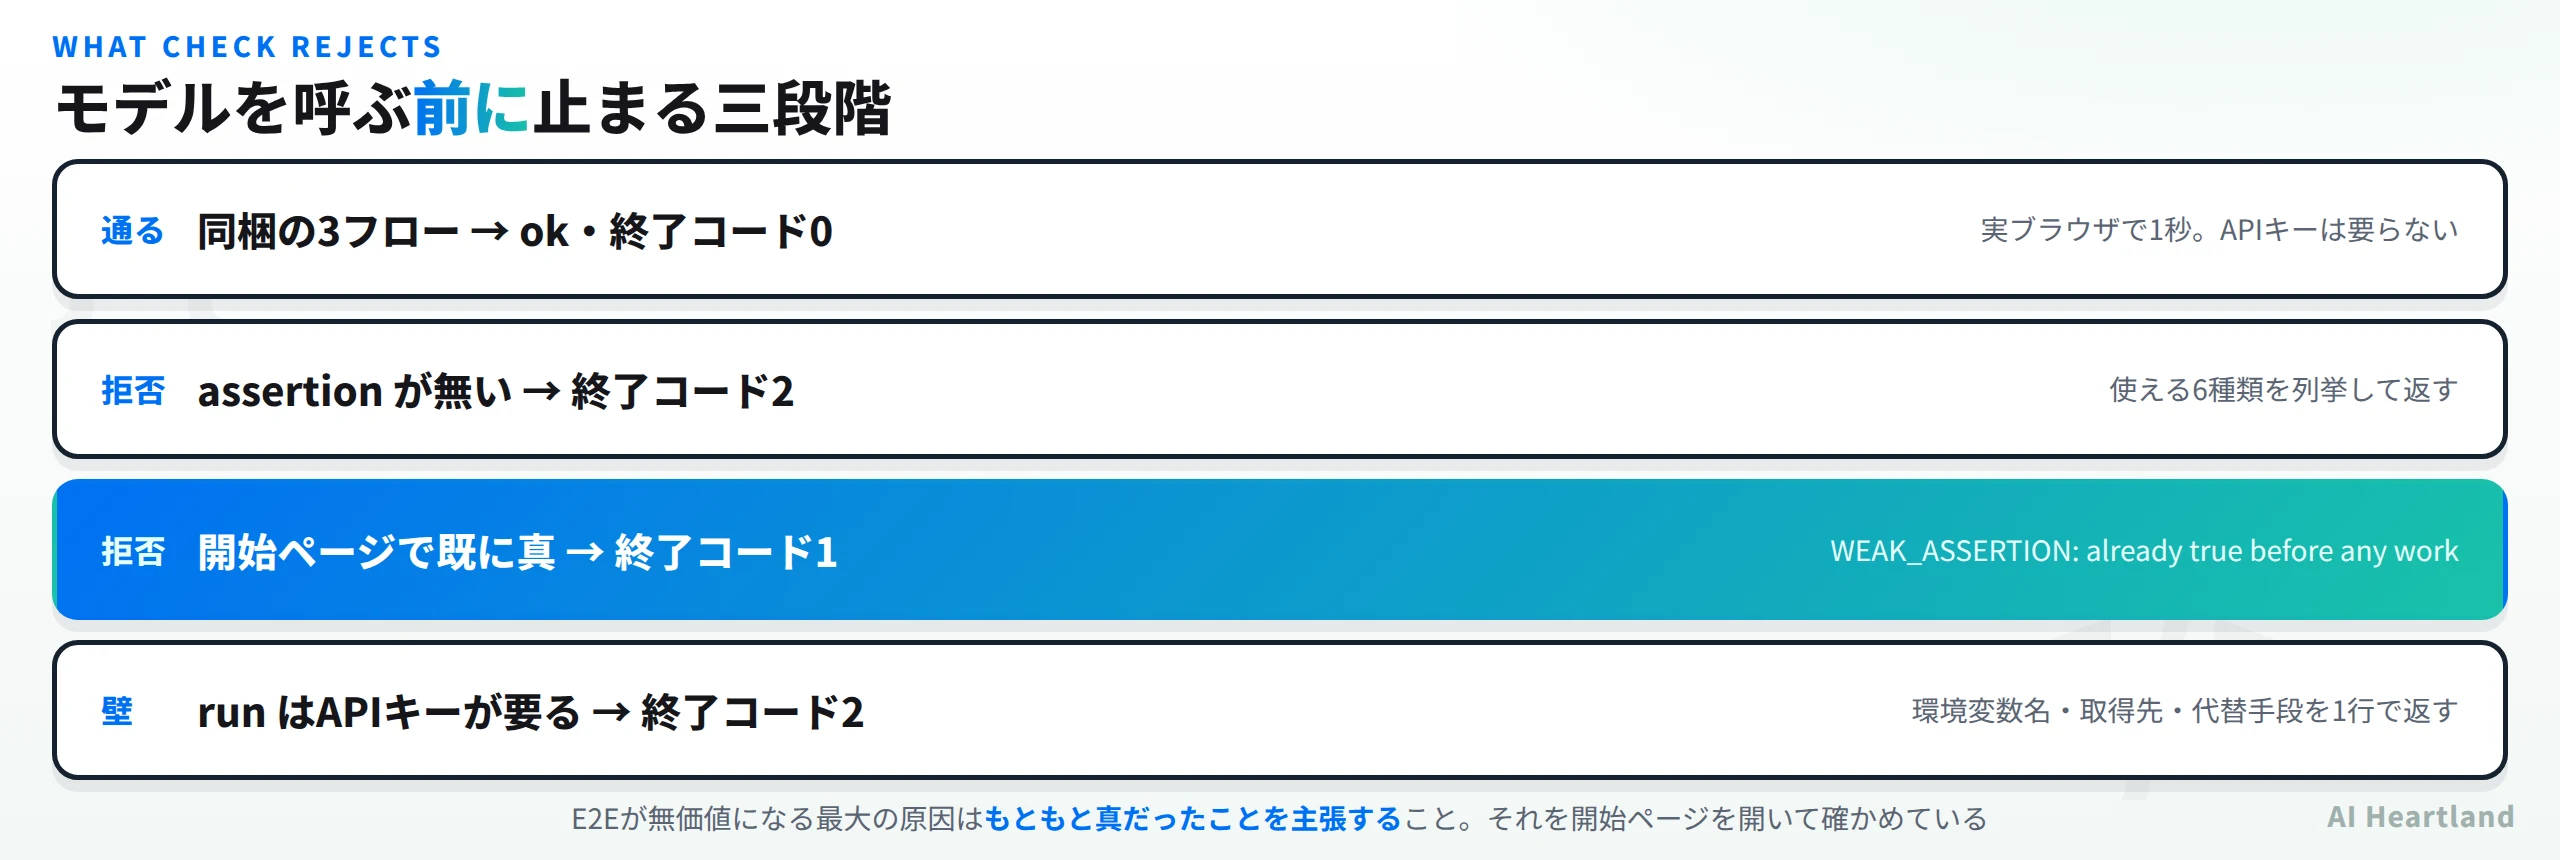
check の --help には「validate specs against the running app (no engine call)」とある。本当にキー無しで動くか、そして何を弾くかを確かめた。
① 正常な spec を通す(陽性対照)
node fixtures/serve.mjs 8899 &
npx quicke2e check examples/fixtures.spec.mjs --base http://127.0.0.1:8899
#   ok              login
#   ok              choose-a-plan
#   ok              weekly-digest-toast
終了コード0、所要1秒。実ブラウザを起動して3フローぶんの開始ページを開いている。OPENROUTER_API_KEY は未設定のままだ。
② assertion が無い spec(陰性対照)
expectUrl も expect も書かない spec を作って通した。
1 problem in the spec
  no-assertions: no assertion: add expectUrl, expect, expectState, expectSeen,
  expectAbsent or expectGone (code decides pass or fail from them)
終了コード2。使える6種類を全部列挙して返すので、次に何を書けばいいかが分かる。
③ 開始ページで既に成立する assertion(本命)
ここが面白かった。/login.html を開始ページにして expect: ["Sign in"] と書いた——ログイン画面に「Sign in」があるのは当たり前で、何も証明していない spec だ。
WEAK_ASSERTION trivially-true: the assertion is already true on /login.html before any work.
終了コード1。実際に開始ページを開いて、assertion がもう成立していないか確かめている。
E2Eテストが無価値になる最大の原因は、落ちないテストを書いてしまうことだ。「もともと真だったこと」を主張していれば、アプリが壊れても緑のまま通る。それをモデルを1回も呼ばずに、1秒で検出する。構造的な不備(②)と弱い主張(③)で終了コードを分けているのも実用的で、CIで扱い分けられる。
当サイトでは先日AI E2Eテストとは|e2eをAPIキー0本で動かし、モデル呼び出しが2回→0回になる所まで実測したで別のE2Eツールを測ったが、あちらはキャッシュでモデル呼び出しを減らす方向だった。QuickE2E はそもそも呼ぶ前に弾く。どちらも「モデルを呼ばない時間をどう作るか」の話で、入り口が違う。
④ そして壁
run のほうはキーが要る。
Set OPENROUTER_API_KEY for the jev engine (https://openrouter.ai/keys), or use --engine local.
終了コード2。--engine local を x86_64 で指定すると、
The local engine does not answer at http://127.0.0.1:8822.
Start it from a clone of https://github.com/dmoka/quicke2e: python local-engine/server.py
(see local-engine/README.md), or set LOCAL_URL.
どちらも1行で、環境変数名・取得先URL・代替手段を含む。スタックトレースは出さない。エージェントに実行させる前提のCLIとしてはこうあってほしい形で、実際この数日に測った別のCLIでは、ネットワークが届かないだけで生のトレースバックが端末に出た。エージェントは ProxyError を読んで次の手を決められないので、この差は地味に効く。
結果として、実際のモデル呼び出しを伴う run は未検証のまま残った。local エンジンも Apple Silicon 限定なので試せていない。
任せる範囲をどこで切るか
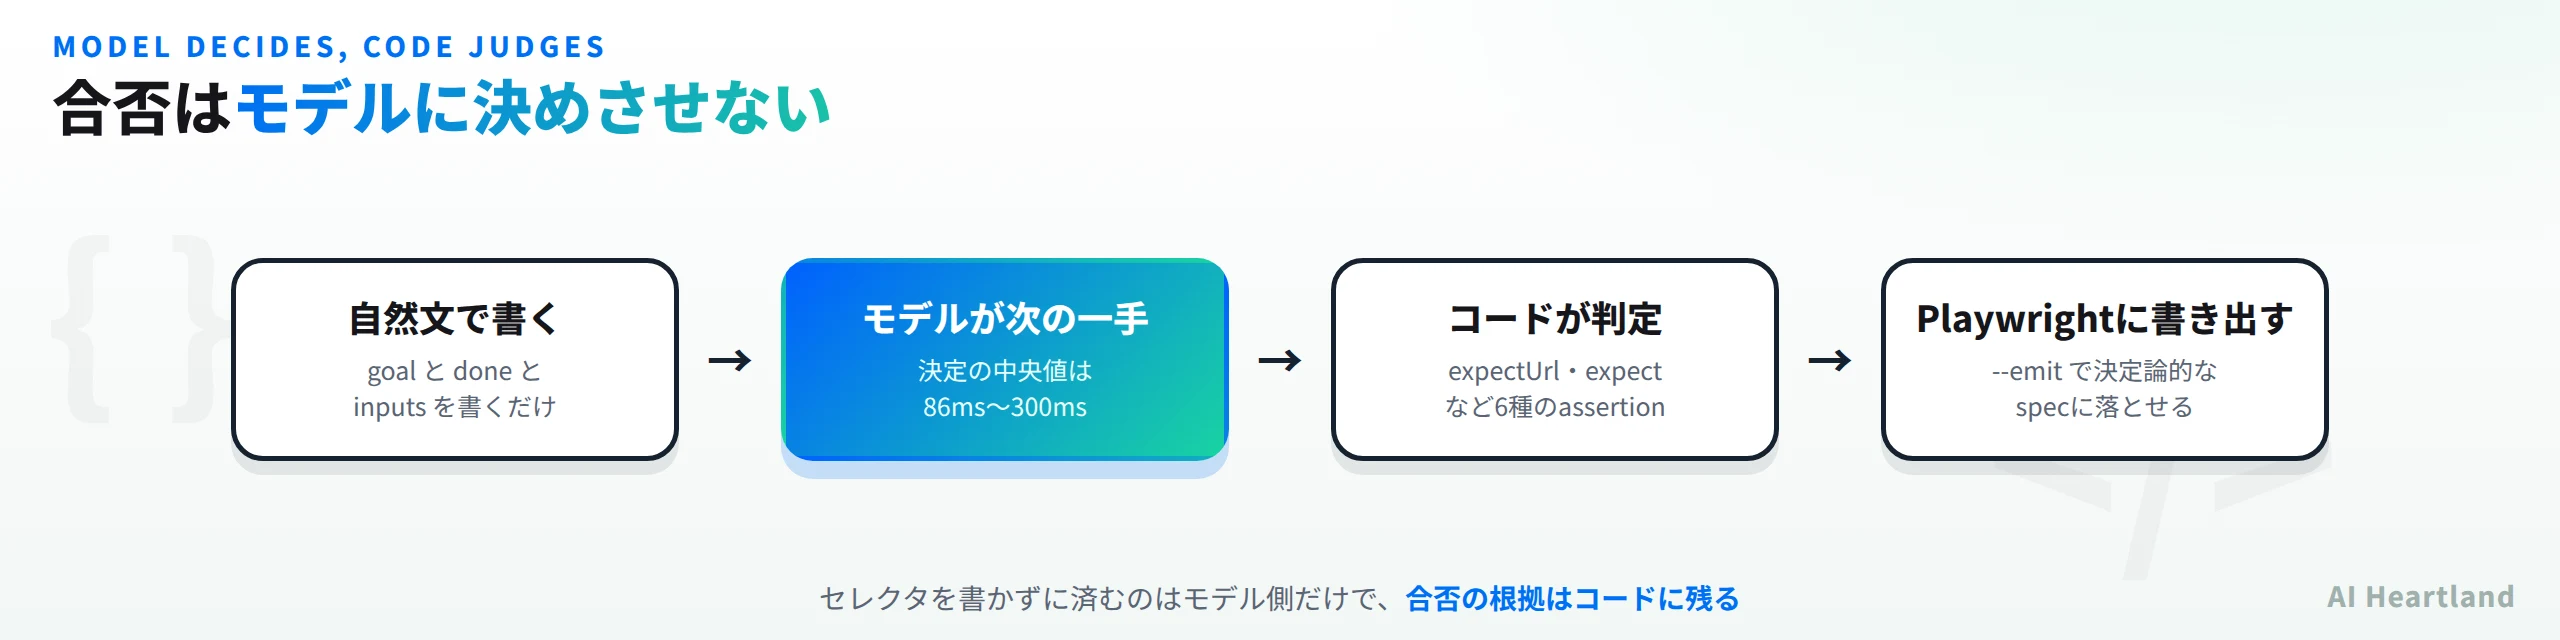
ここまで測ってきて、この道具の輪郭がはっきりした。エージェントに渡しているのは「次にどこを押すか」だけだ。
・何をテストするか → 人が goal と done に書く
・どこを押すか → モデルが毎ステップ決める(中央値86〜300ms)
・通ったかどうか → コードが assertion で判定する
・テストとして成立しているか → check が事前に弾く
さらに --emit で、通った経路を Playwright の spec として書き出せる。一度通ったフローは決定論的なテストに落として、以降はモデルを呼ばずに回せる、という流れだ。
この切り分けは、モデルが苦手なことをモデルにやらせていない。合否の判定は曖昧さを許さない作業で、そこを自然文に任せると「たぶん成功していると思います」になる。逆にDOMの中から押すべき要素を見つけるのは機械的なセレクタが壊れやすい領域で、そこはモデルが強い。
その代わり、goal と done を書く手間は消えない。セレクタを書かなくていいだけで、何をテストしたいかは結局人が言語化する。check が弾くのはまさにその言語化が甘いケースで、道具としては正直だと思う。
攻撃ケースは「拒否された」だけでは通さない
もうひとつ測っておきたい設計があった。README の Attack cases 節だ。
Attacks are not a separate mode.(攻撃は別モードではない)
同梱の Agent Skill は、毎回ハッピーパスを先に書いてから、境界値・拒否・攻撃のケースを続けて作る。ハッピーパスが落ちているあいだ、そのフローへの攻撃は待つ——という順序まで決まっている。
内容は具体的だ。負の数・ゼロ・巨大な数量、極端に長い文字列やUnicode、<script> タグ、SQL風の文字列、使用済みの割引コードの再利用、1つめの上に2つめのコードを重ねる、他人の注文をURLで開く、?qty=-3 や ?code=A&code=B のような細工したクエリ、締め切った受付、送信済みフローの再送信——といった具合に列挙されている。
面白いのは判定の仕方だった。
Every attack asserts two things.(すべての攻撃は2つを主張する)
1つめはアプリが拒否すること(拒否メッセージを expect に書く)。2つめは成功状態が存在しないこと(成功時だけ出る文言を expectAbsent に書く)。理由も書いてある——「アプリがエラーを表示しつつ、割引は適用してしまうことがあるから」。
これは実務で何度も見た失敗だ。エラーメッセージが出ているので人間は安心するが、裏では処理が通っている。拒否文言だけを確認するテストはそれを見逃す。
実装側にも対応する結果コードがあった。ソース中の結果コードを拾うと、ABSENT_SEEN(expectAbsent の文言が見えてしまった=攻撃が通った)、ABSENT_ON_START、NOT_REFUSED、MODEL_BLOCKED、LOOP、MAX_STEPS、DONE_VERIFIED、DONE_REJECTED、WEAK_ASSERTION など20種類ほどが定義されている。「落ちた」ではなくなぜ落ちたかが機械可読で返る。
さらに、前節で測った WEAK_ASSERTION ゲートが攻撃ケースと噛み合うよう手当てされていた。他人の注文を /orders/1 で開くような攻撃では、ページを開いた時点で assertion が成立している——つまりゲートに弱い主張だと誤判定される。そこで control に「アプリが許可する側のURL」(自分の注文 /orders/281)を書かせ、check はその control ページに対して WEAK_ASSERTION を評価する。ゲートの設計上の穴を、別のフィールドで塞いでいる。
ついでに discover(アプリを巡回して地図を作るコマンド)のソースにも、同じ種類の記録が残っていた。
// SAFE mode is STRUCTURAL, not a word list (audit C1: 7/7 mutating controls fired,
// the name regex is English-only): it probes only controls that declare they open
// something -- aria-haspopup, aria-expanded, a tab, a combobox.
「安全なボタンかどうか」を名前の正規表現で判定していたら、監査で7/7の変更系ボタンを押してしまった。しかも英語名にしか効かない。そこで名前ではなく、要素が「何かを開く」と宣言しているか(aria-haspopup・aria-expanded・tab・combobox)という構造で判定するよう変えた、と書いてある。自分の安全策が全滅した記録をコメントに残しているのは珍しい。
なおエンジンは3系統あった。既定の jev(OPENROUTER_API_KEY)、vercel(AI_GATEWAY_API_KEY)、local(Apple Silicon 限定)。README は前2つを明示していないので、--help を読まないと vercel の存在に気づかない。
run のフラグを見ると、この道具が何を想定しているかがもう少し分かる。
| フラグ | 役割 |
|---|---|
--emit |
通った実行ごとに Playwright の spec を書き出す |
--min-confidence |
エンジンの確信度がこの値未満の操作は実行しない(既定0.3) |
--reset |
実行のたびにシードデータを戻すシェルコマンド |
--allow-weak |
WEAK_ASSERTION で落ちたフローをあえて走らせる |
--trace / --video |
実行ごとのJSONトレース/WebM録画 |
--runs |
フローあたりの実行回数(ぶれを見るため) |
--min-confidence があるのが実務的だ。モデルが迷ったまま適当な要素を押すくらいなら止める、という設計になっている。--emit と合わせると、一度通った経路は決定論的な Playwright spec に凍らせて、以降はモデルを呼ばないという運用が成り立つ。--allow-weak は、前節のゲートに意図的に例外を開ける逃げ道で、こういう抜け道を用意しつつ既定では塞いでおくのは良い塩梅だと思う。
コマンドは3つだけだった——discover(巡回して地図を作る)・check(主張の検証)・run(実行)。--help も1画面に収まる。
E2Eテスト AI として導入するかの判断材料
向いている場面
・既存のE2Eがセレクタの保守で崩れている場合。UIを変えるたびに直す作業がモデル側に移る
・CIのトークン予算が気になる場合。1タスク4,000〜7,000トークンという水準は、汎用エージェントに画面を触らせるのとは桁が違う
・まず無料で試したい場合。check だけならキー無しで動き、同梱フィクスチャで挙動が分かる
向いていない場面
・外部APIを呼べない環境。既定の jev エンジンは OpenRouter 経由で、local は Apple Silicon 限定
・判定が目視に依存するテスト(レイアウト崩れ、色、アニメーション)。assertion はテキストとURLと状態で、見た目は判定できない
・成熟度を要求する場面。star 59・バージョン0.5.0・最初のコミットが2026-09-25で、まだ2週間ほどしか経っていない
何を代替するかは「セレクタを書いて保守する時間」だ。置き換えないのは「何をテストすべきか決める時間」で、そこは goal と done という形で残る。
測ってみて一番良かったのは、ベンチの生データが置いてあったことだった。主張を数字で書く OSS は多いが、その数字を出した記録ごと置いてある OSS は少ない。 計算し直して一致したからといってベンチが正しいと証明されたわけではないが、少なくとも確かめられる形で出しているという事実は、道具そのものの設計姿勢と地続きに見える。check が「何も証明していないテスト」を弾くのと、同じ種類の潔癖さだ。
残しているのは肝心の部分でもある。実際にモデルに運転させる run、local エンジン、そしてベンチの独立再現。最初の2つは API キーと機材の問題で、3つめは同じアプリと同じ条件を用意しないと意味が無い。
参照ソース
・dmoka/quicke2e(GitHub) — 本記事の計測対象。MIT・star 59
・bench/results/launch-task.json — 本記事が再計算した生ラン15件
・AGENTS.md — spec のルール・終了コード・--json レコード
・quicke2e(npm) — 配布パッケージ 0.5.0
計測値は data/measurements/runs/2026-10-09-quicke2e-plain-english-e2e.json に記録した。環境は Ubuntu 24.04 / x86_64 / node v22.22.2 / playwright 1.63.0 / Chromium 141.0.7390.37。実際のモデル呼び出しを伴う run、local エンジン、ベンチマークの独立再現はいずれも未検証。