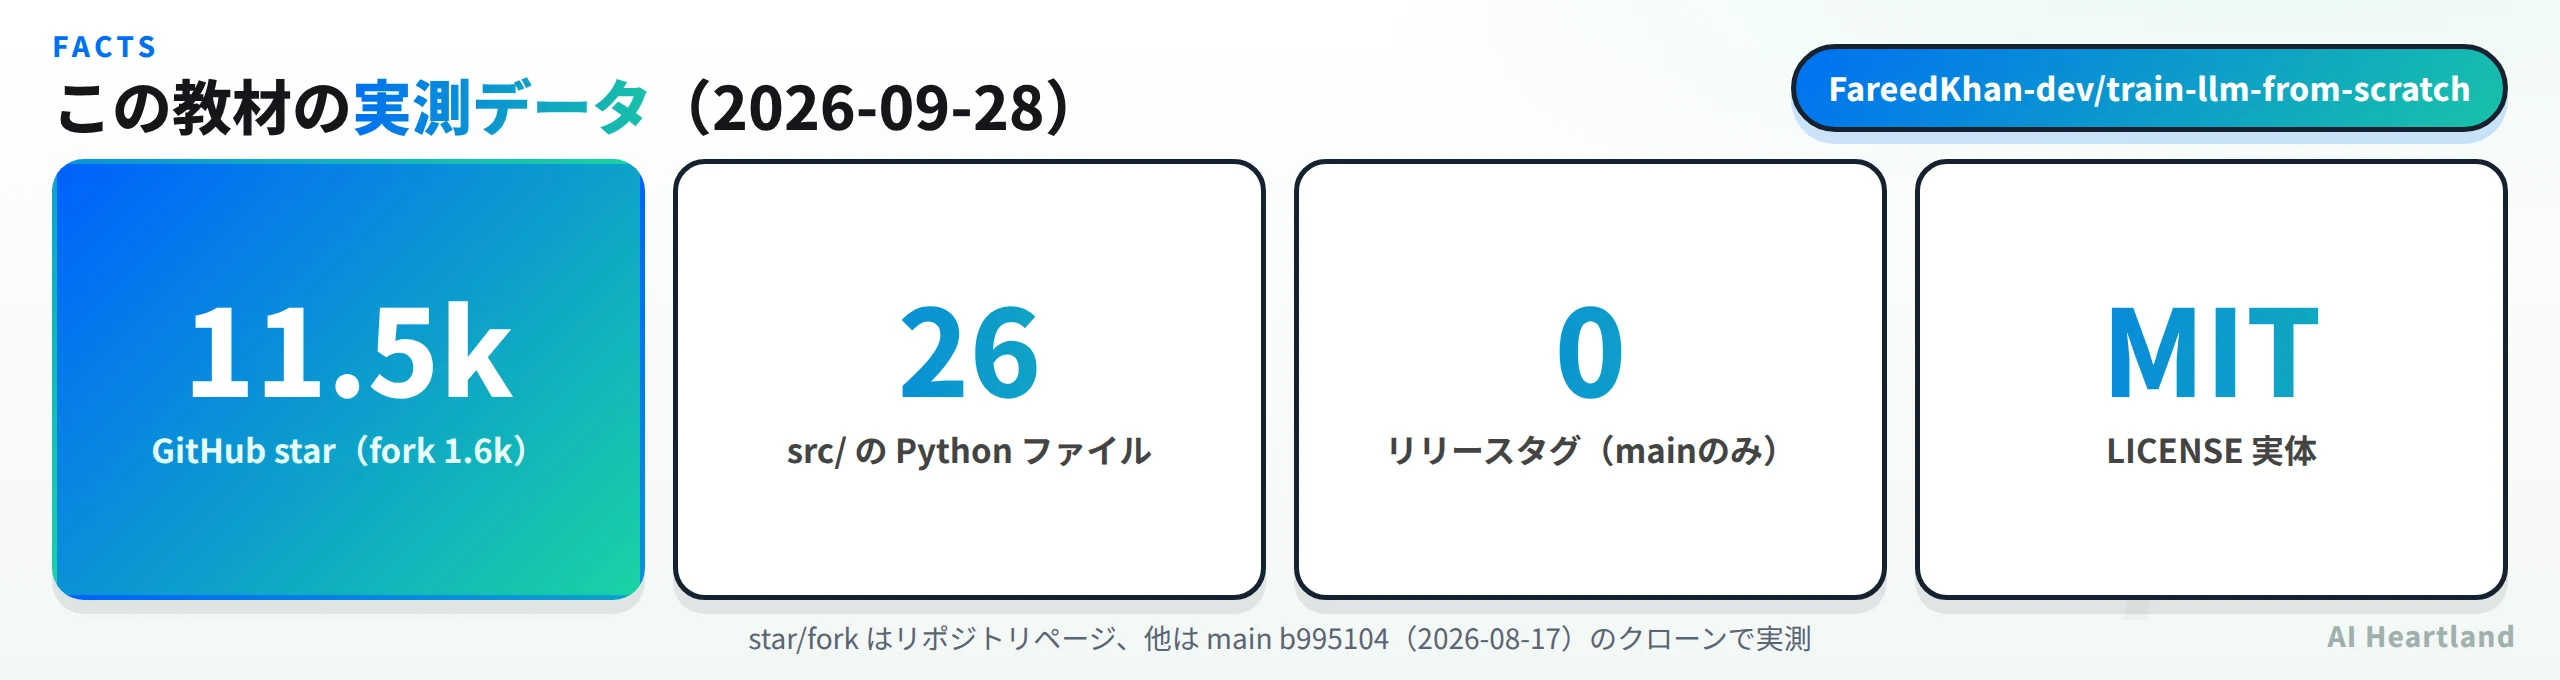
train-llm-from-scratch は、生のテキストから「推論する型のモデル」までを、素のPyTorchだけで書き切った学習教材だ。READMEはこう名乗っている——「もともとは事前学習のチュートリアルだった。いまは生テキストから整合済みの推論スタイルのモデルまで、すべてのアルゴリズムを素のPyTorchで手書きしている(trl なし、peft なし、transformers なし)」。star 11.5k、fork 1.6k、MIT。この種の教材で気になるのは、書かれている数字と主張が実際のコードと合っているかの一点に尽きる。そこで2026-09-28時点の main をクローンし、モデルを実際に組み立ててパラメータを数え、依存の主張を grep で確かめた。
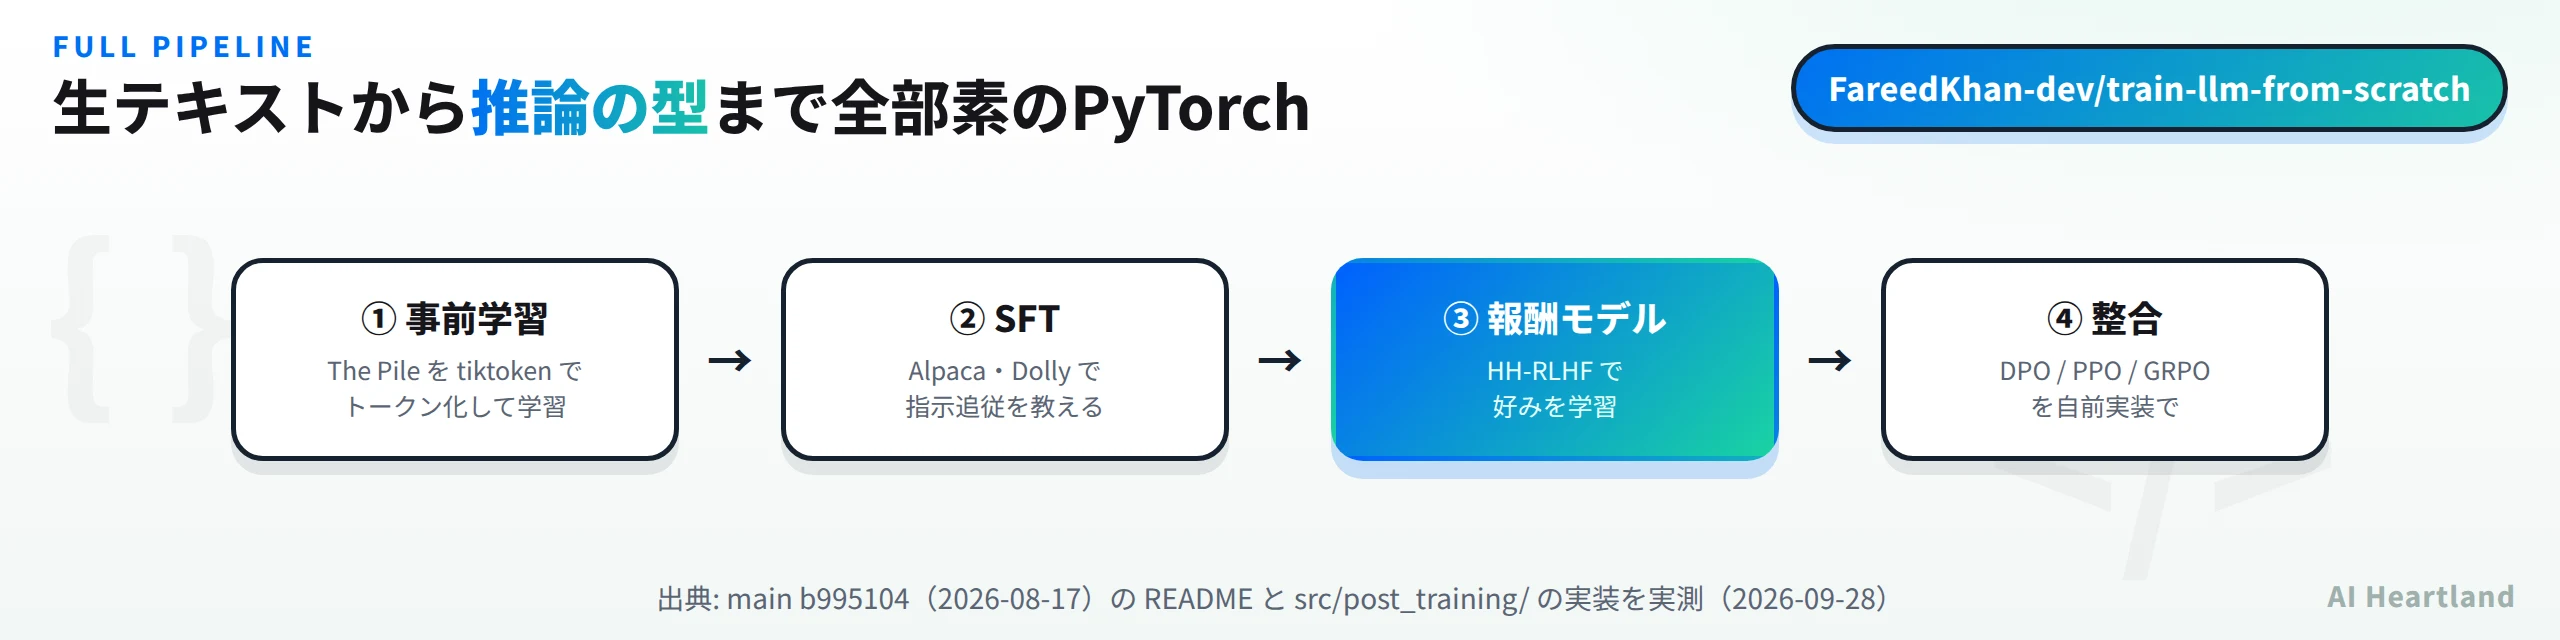
- ・事前学習 → SFT → 報酬モデル → DPO/PPO/GRPO → 評価・推論を、すべて素のPyTorchで実装した教材
- ・src/ のPythonファイルは26本。post_training/ に dpo.py・ppo.py・grpo.py・reward_train.py などが独立して並ぶ
- ・依存は torch・numpy・h5py・requests・tqdm・zstandard・tiktoken の7つ。transformers も trl も peft も入らない
- ・READMEの「13,142,656パラメータ」はモデルを実際に組むと完全一致した(context_length=128のとき)
- ・後段の既定 configs/base.json は406,359,168パラメータ。READMEの406Mと合う
- ・リリースタグは0本。main のみで進む教材型のリポジトリ
LLMそのものの仕組みと選び方はLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめてある。本記事はその「自分で1から作る」側の教材を検証する。
train-llm-from-scratchとは:高水準ライブラリを1枚も挟まない教材
このリポジトリが他の「LLM自作」系と違うのは、範囲の広さだ。Transformer を書いて事前学習して終わり、ではない。src/ の中身を数えると26本のPythonファイルがあり、内訳はこうなっている。
| ディレクトリ | 中身 |
|---|---|
src/models/ |
mlp.py(フィードフォワード)・attention.py(単一ヘッドとマルチヘッド)・transformer_block.py・transformer.py |
src/post_training/ |
sft.py・reward_model.py・reward_train.py・dpo.py・ppo.py・grpo.py・value_head.py・rollout.py・chat_template.py・evaluation.py・inference.py・optim.py・distributed.py ほか |
src/post_training/rewards/ |
parsing.py・verifiers.py(報酬の検証ロジック) |
PPOには価値ヘッド(value_head.py)とロールアウト(rollout.py)が要る。GRPOはグループ相対の優位性推定が要る。DPOは参照モデルとの対数比が要る。これらが別々のファイルとして読める形で置かれているのがこの教材の価値で、trl を使えば PPOTrainer(...) の一行で済む部分が、ここでは自分で読める。
READMEは Transformer の実装も断片を貼りながら説明していて、たとえばフィードフォワードブロックは nn.Linear(n_embed, 4 * n_embed) で4倍に広げて戻すだけ、と図つきで示される。ブラウザ上でGPTの内部を可視化して学ぶTransformer Explainer徹底解説|GPTの仕組みをブラウザで動かして学ぶ可視化OSSが「見て理解する」教材だとすれば、こちらは「書いて動かす」側に振り切っている。「自分で作る」系の教材を横断的に見たいならbuild-your-own-x徹底活用|日本人開発者がキャリアで差をつける『自分で作る』TOP10も合わせて読むといい。
主張の検証①:本当にフレームワークを使っていないか
「trl なし、peft なし、transformers なし」は検証できる主張だ。src/ 以下の import を数えた。
grep -rnE '^\s*(import|from)\s+(trl|peft|transformers|accelerate)\b' src/
# (一致なし)
grep -rcE '^\s*(import|from)\s+torch' src/ | awk -F: '{s+=$2} END{print s}'
# 36
禁止リスト側は0件、torch は36件。陰性(主張どおり無い)と陽性(あるべきものはある)の両方が取れているので、grep が空振りしているわけではない。
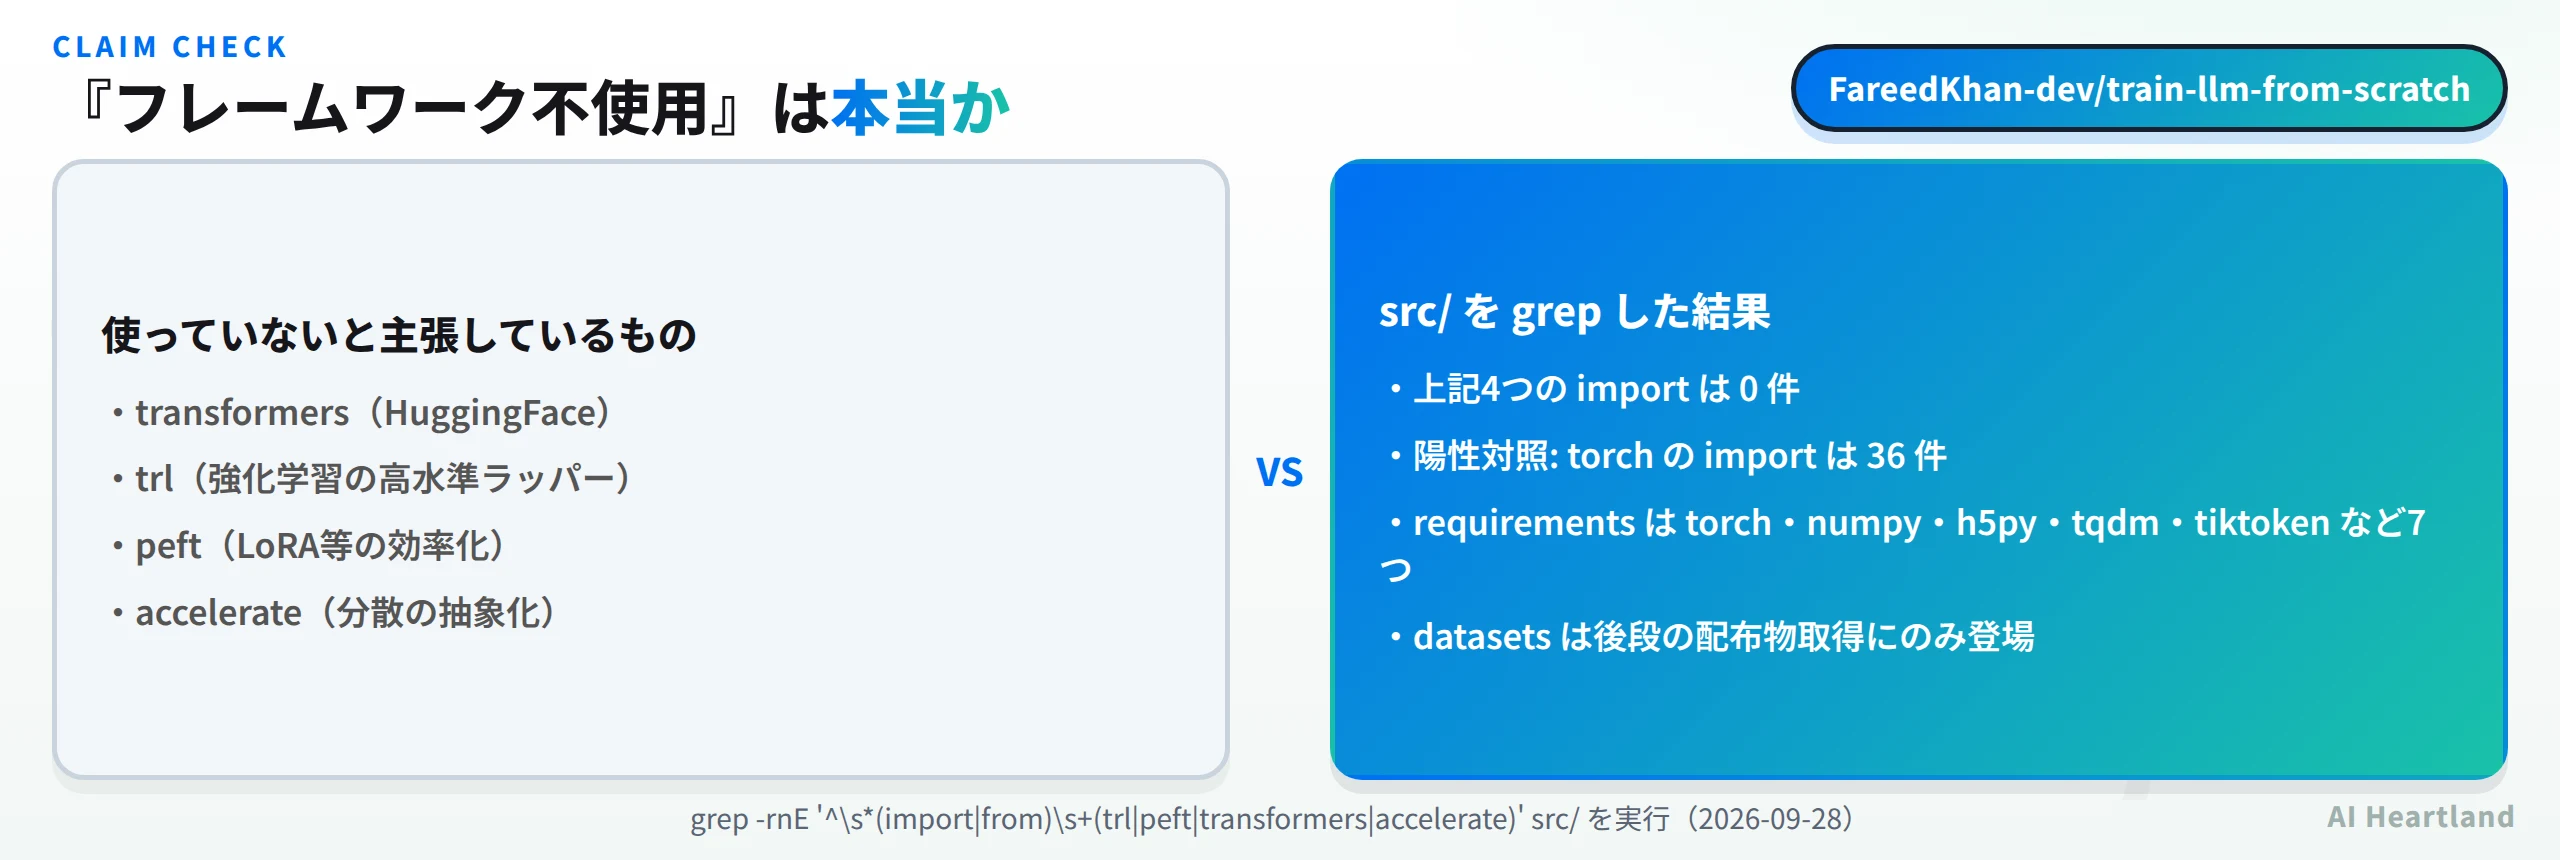
requirements.txt も素直だ。並んでいるのは torch・torchvision・torchaudio・numpy・h5py・requests・tqdm・zstandard・tiktoken。トークナイザに tiktoken を使うのは現実的な選択で、ここを自作しないのは妥当な線引きだと思う。後段用の requirements-post.txt には datasets(HuggingFaceのデータセット取得)と任意の wandb が足されるが、これはデータを落とすためのもので、学習アルゴリズムには入っていない。コメントにも「すべてのスクリプトはJSONLも書く」とあり、wandb は無くても回る設計になっている。
README原文と実装が食い違う例は珍しくないので、この一致は素直に評価できる。逆に言えば、この教材の価値は「隠れている部分が無いこと」そのものなので、ここが崩れていたら教材として成立しない。
主張の検証②:パラメータ数を実際に数える
READMEには「13M small config (n_embed=128, n_head=8, n_blocks=1): 13,142,656 params」という具体的な数字が出てくる。Transformer クラスをそのままインスタンス化して数えた。
from src.models.transformer import Transformer
m = Transformer(n_head=8, n_embed=128, context_length=128, vocab_size=50304, N_BLOCKS=1)
print(sum(p.numel() for p in m.parameters()))   # 13142656
13,142,656——READMEの値と完全に一致した。ただしここで一点、教材として面白い発見がある。同じ構成で context_length だけを変えると値が動く。
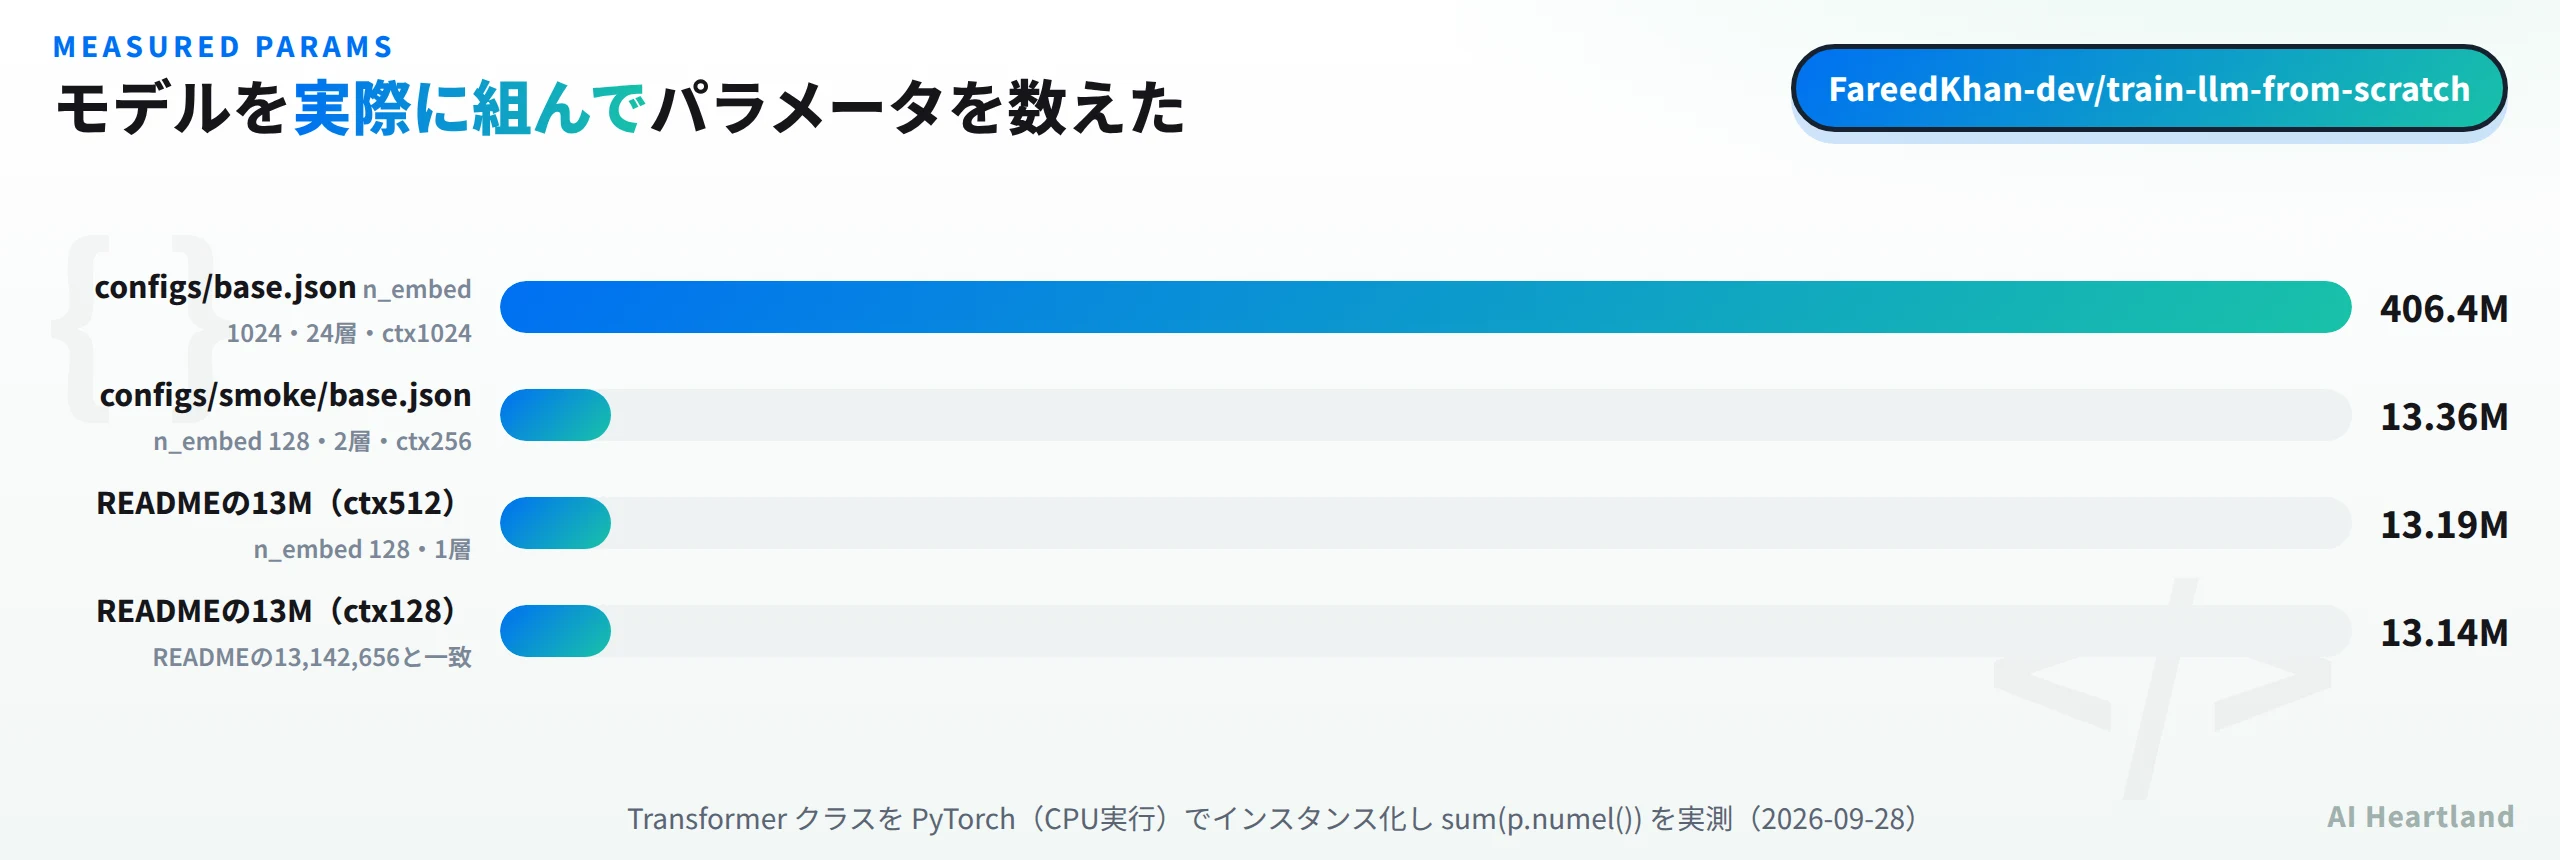
| 設定 | 実測パラメータ数 |
|---|---|
configs/base.json(n_embed 1024・24層・ctx 1024) |
406,359,168 |
configs/smoke/base.json(n_embed 128・2層・ctx 256) |
13,356,928 |
| READMEの13M構成・ctx 512 | 13,191,808 |
| READMEの13M構成・ctx 128 | 13,142,656 |
ctx 512 と ctx 128 の差は 49,152 パラメータ。これは位置埋め込み (512-128) × 128 = 49,152 にぴったり一致する。小さいモデルでは位置埋め込みがパラメータ数に効くという、教材で最初に引っかかりやすい事実が数字で出ている。READMEの13,142,656 は context_length=128 のときの値だと分かった。
後段の既定である configs/base.json は 406,359,168パラメータで、READMEが言う406Mと合致した。内訳を見ると、トークン埋め込みが 50304×1024 で約51.5M、24層のブロックが約302M、そして出力側の線形層が約51.5M——埋め込みと出力層が重み共有されていない構成だと分かる。この手の設計判断も、コードを読める教材だからこそ確認できる。
検証環境:Linux 6.18.44/Python 3.11/PyTorch(PyPI既定ビルド・CPU実行)/2026-09-28。リポジトリは main の b995104(2026-08-17)を git clone --depth 1。パラメータ数は src/models/transformer.py の Transformer をインスタンス化し sum(p.numel() for p in m.parameters()) で計測。依存の検証は src/ への grep(陰性・陽性の両対照つき)。未検証:学習を1ステップも回していない。GPUが無く、The Pile もダウンロードしていないため、事前学習・SFT・報酬モデル・DPO/PPO/GRPO・評価はいずれも未実行。READMEに載っている損失曲線やGSM8Kのスコア、生成テキストの品質、学習時間はすべて未確認。日本語での学習も試していない。star 11.5k・fork 1.6k はリポジトリページの表示値。
何行で読めるのか:後段アルゴリズムの実装量を数える
「読める教材」と言うからには、実際にどれくらいの分量なのかを出しておきたい。クローンして src/post_training/ の主要ファイルの行数を数えた。
git clone --depth 1 https://github.com/FareedKhan-dev/train-llm-from-scratch
cd train-llm-from-scratch
for f in sft dpo ppo grpo reward_model rollout; do
  printf "%-14s %4s lines\n" $f $(wc -l < src/post_training/$f.py)
done
結果はこうなった。
| ファイル | 行数 | 中身 |
|---|---|---|
sft.py |
63 | 教師ありファインチューニングの損失と学習ループ |
dpo.py |
95 | dpo_loss に加えて orpo_loss・kto_loss・implicit_accuracy まで実装 |
ppo.py |
100 | クリップ付き方策勾配 |
grpo.py |
70 | group_advantages(グループ相対の優位性)と k3_kl、grpo_loss |
reward_model.py |
68 | 報酬モデルの本体 |
reward_train.py |
30 | 報酬モデルの学習ループ |
value_head.py |
56 | PPO用の価値ヘッド |
rollout.py |
293 | 生成とロールアウト(ここが最大) |
evaluation.py |
116 | 評価 |
DPOが95行、GRPOが70行。高水準ライブラリなら数行の呼び出しで終わる部分が、この分量で読める。しかも dpo.py には DPO だけでなく ORPO と KTO も入っていて、選好学習の派生をまとめて比較できる形になっている。GRPO 側は group_advantages と k3_kl(K3推定によるKLダイバージェンス)が関数として切り出されていて、「グループ内で相対的に良かった応答を上げる」という考え方が式のまま読める。
報酬の定義も具体的だ。rewards/verifiers.py には reward_gsm8k(数式の答えが合っているか)と reward_format(出力形式が守られているか)があり、_answers_match が数値の一致を判定する。検証可能な報酬(verifiable reward)を自分で書くというのが、いま主流になっている推論モデルの学習の考え方そのもので、それが50行程度の関数として置かれている。
一方、行数が突出しているのが rollout.py の293行だ。強化学習の難しさが損失関数ではなく「生成してサンプルを集める部分」にあることを、この数字が端的に示している。学習アルゴリズムを実装したいと思って読み始めると、実際に手間がかかるのはここだと分かる。生成の打ち切り条件、パディングの扱い、バッチ内で長さが揃わないときの処理——損失の式には出てこないが、動かすと必ずぶつかる部分が293行に詰まっている。教材としてはむしろここが読みどころで、論文を読んだだけでは埋まらない距離がそのまま見える。
uncopyrighted サブセット"] --> B["tiktoken でトークン化"] B --> C["事前学習
src/models/transformer.py"] C --> D["SFT
Alpaca・Dolly・sft.py 63行"] D --> E["報酬モデル
HH-RLHF・reward_model.py 68行"] D --> F["DPO
dpo.py 95行・ORPO/KTOも同梱"] E --> G["PPO
ppo.py 100行 + value_head.py"] E --> H["GRPO
grpo.py 70行・検証可能な報酬"] F --> I["評価
GSM8K・evaluation.py 116行"] G --> I H --> I
動かすには何が要るか:既定値は手元では大きすぎる
教材としての難所はハードウェアだ。READMEは率直に「学習にはGPUが必要」と書き、GPU別の目安表を載せている。無料のColabやKaggleのT4(16GB)で13Mモデルは回るが、10億パラメータ級は載らない、という線引きだ。
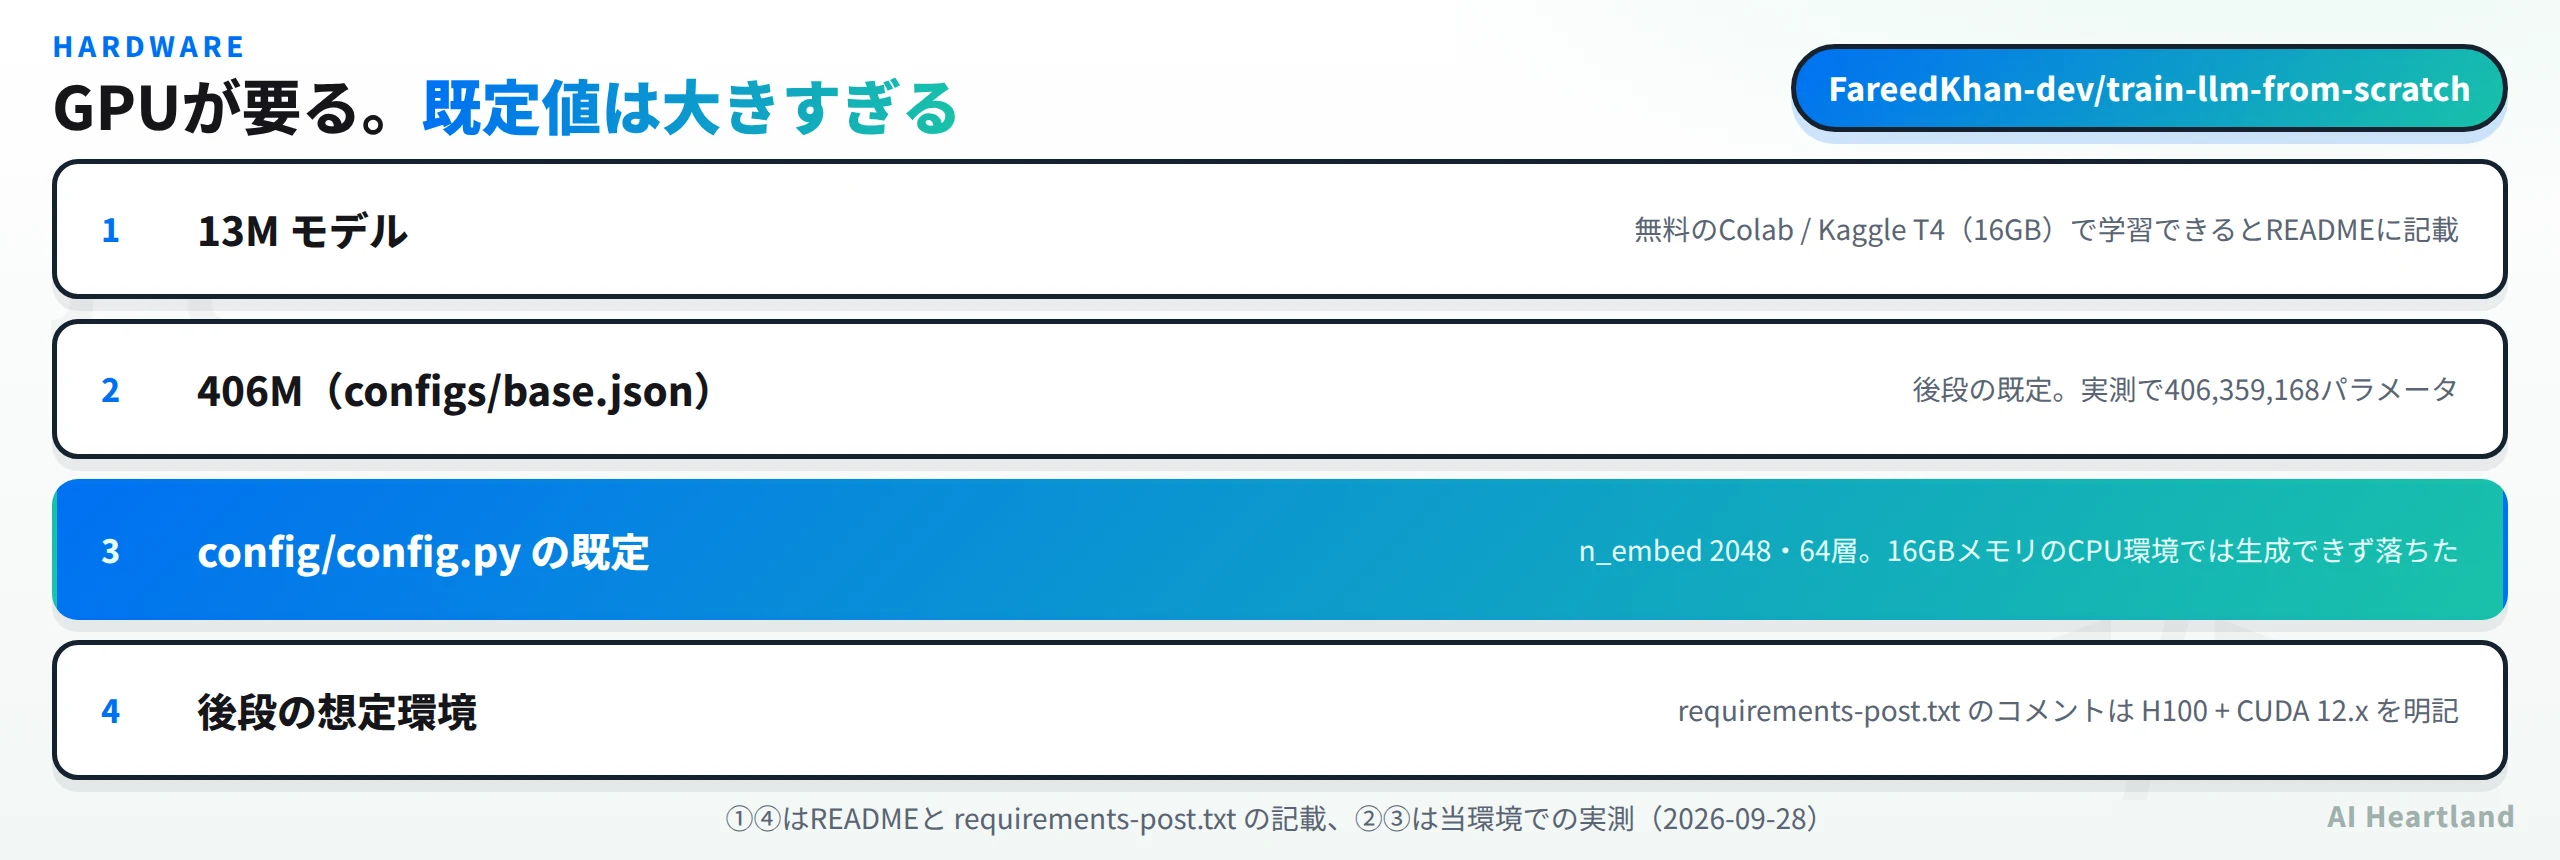
ここで注意したいのが、リポジトリ既定の config/config.py だ。中身は N_EMBED = 2048、N_BLOCKS = 64、CONTEXT_LENGTH = 512、VOCAB_SIZE = 50304。この設定でモデルを組もうとしたところ、メモリ16GBの環境ではプロセスが出力を残さず終了した(fp32の重みだけで10GBを大きく超える規模なので、OOMによる強制終了と考えるのが自然だ)。つまり git clone して既定のまま走らせると、多くの人の手元では最初の一歩で止まる。READMEが「まず13Mモデルから始めて、n_embed と n_blocks をメモリの限界まで上げていけ」と書いているのは、この事情を踏まえた実践的な助言だ。
後段の requirements-post.txt はもっとはっきりしている。ファイル冒頭のコメントに「H100 + CUDA 12.x を想定」「基盤の requirements.txt は事前学習向けに cu118 を固定しているのでこのファイルはそれを上書きしない」と書かれている。SFT以降を最後まで回すなら、個人の環境では現実的でないと読むべきだろう。
現実的な使い方は3つに分かれると思う。ひとつ目は13Mモデルだけを実際に回して、テキストが生成されるところまで体験する。ふたつ目は configs/smoke/ のスモーク設定(n_embed 128・2層・ctx 256、実測13,356,928パラメータ、device: cpu)でパイプラインの通り道だけ確認する。三つ目は学習を回さずコードを読む。DPOやGRPOの実装が数百行で読める機会はそう多くないので、三つ目だけでも十分に元が取れる。
推論側を小さく回す工夫という点では、1ビット量子化でCPU推論を成立させたbitnet.cpp(BitNet)とは|Microsoftの1ビットLLM推論フレームワークのアプローチが対照的で、学習と推論のどちらでメモリが効くのかを考える材料になる。
導入前に押さえる点
実測して分かった細かい事実を並べる。
・リリースタグが0本:git tag の出力は空で、main だけで進む。バージョンを固定したいならコミットハッシュで留める
・最終コミットは2026-08-17:クローン時点の main 先頭は約6週間前。教材としては落ち着いた状態で、逆に言えば活発に動いているプロジェクトではない
・ライセンスはMIT:LICENSE 実体も MIT License / Copyright (c) 2025 Fareed Khan だった
・追加インストールは用途別:pip install -e ".[train]" でデータ取得とwandb、".[ui]" でstreamlitの管理画面、".[docs]" でmkdocs。最小構成なら pip install -e . だけで済む
・データセットは英語中心:事前学習は The Pile の uncopyrighted サブセット、後段は Alpaca・Dolly・GSM8K・Anthropic HH-RLHF・UltraFeedback。日本語での学習を試したいなら、データもトークナイザの扱いも自分で考える必要がある
・テストとUIも同梱:tests/ と ui/(streamlitの操作パネル)、mkdocs.yml によるドキュメントサイトが揃っている。教材としての作り込みは丁寧
総括。 この教材の主張は、確かめた範囲では正確だった。フレームワークは本当に使っておらず、READMEのパラメータ数は実際に組むと一致する。数字が合う教材は信用できる——逆に言えば、教材を選ぶときは書かれた数字を1つ再現してみるのが最も安い検証になる。ハードルはGPUで、既定設定のまま動かすのは現実的ではないが、13Mモデルなら無料枠で届く範囲にある。「PPOやGRPOが内部で何をしているか、ライブラリの外側から説明できない」という自覚がある人には、コードを読むだけでも価値がある一本だと思う。
参照ソース
・FareedKhan-dev/train-llm-from-scratch(公式リポジトリ) — README・src/・configs/・requirements*.txt・LICENSE を 2026-09-28 に確認(main の b995104)
・Attention Is All You Need(arXiv:1706.03762) — READMEが実装の基礎としている原論文
・The Pile(EleutherAI) — 事前学習に使うデータセット(uncopyrighted サブセット)