Jellyfish(Forget-C/Jellyfish)は、AIショートドラマの制作を「台本 → ショット → 確認 → 生成」の流れで管理するオープンソースのワークスペースだ。2026-10-16時点のGitHub Starは約6.7k、ライセンスはApache-2.0、最新タグはv0.3.2(2026-04-17)。本記事ではmain(a967819)のバックエンドとフロントエンドを起動し、APIでプロジェクトと章を作ってショット分割を走らせ、どこでモデルのAPIキーが要るのかを確かめた。
WHAT IT REPLACES何を代替するか
1カットずつの生成をショット単位の制作台帳に置き換える
動画モデルのWeb画面
1カットずつ手で生成
- 台本の分割と人物設定は手元のメモ
- カットごとにプロンプトを書き直す
- 生成の進み具合はタブごとに見る
Jellyfish
台本→ショット→生成を1つのDBで管理
- LLMが台本をショットに分け、人物・場面・小道具・衣装を候補に出す
- 確定した資産をショットに紐づけて使い回す
- 文章・画像・動画の生成をタスクセンターで追う
30秒でわかる Jellyfish(2026-10-16時点)
- ・正体:AIショートドラマ用の制作台帳。FastAPI+Celeryのバックエンドと、React(antd)の画面でできている
- ・何ができる:LLMで台本をショットに分け、人物・場面・小道具・衣装を候補に出し、確認したショットから画像と動画を生成する
- ・実測:SQLiteで起動して33テーブル・138のAPI操作を確認。ショット分割はモデル無しでは止まり、ローカルの模擬サーバをつなぐと3ショットがDBに入った
- ・注意:mainは2026-04-20から更新なし。APIに認証が無い。実モデルでの画像・動画生成は未検証
| 同じ名前のもの | 何か | 本記事 |
|---|---|---|
| Forget-C/Jellyfish | AIショートドラマの制作ワークスペース(Apache-2.0) | 対象 |
PyPIの jellyfish |
文字列の近似一致・発音照合のPythonライブラリ(MIT、1.2.1) | 対象外 |
台本の理解に使う言語モデルそのものの仕組みは、LLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめている。
Jellyfishとは:AIショートドラマを台本から組み立てる制作ワークスペース
READMEはJellyfishを「AI生成ショートドラマのためのエンドツーエンドの制作ワークスペース」と説明する。画像や動画を1枚ずつ作る道具ではなく、台本・ショット・登場人物・生成タスクをデータとして持ち、あとから見直して使い回せるようにするのが狙いだ。
読者の3つの問いに答えると次のようになる。
・何ができる:章ごとの台本をショットに分け、ショットごとに人物・場面・小道具・衣装・台詞を抜き出し、確認が済んだショットでキーフレームや参照画像を用意して動画を生成する
・何を解決する:カットが増えると崩れやすい人物の見た目と、長くかかる生成待ちの管理。資産を共通の台帳に置き、生成をタスクとして追う
・何を代替する:動画モデルのWeb画面に1カットずつプロンプトを入れ、台本と人物設定を手元のメモで持つやり方
台本を読む処理はLangChainの上に作られたエージェント群で、mainのコードには台本の分割・最適化・簡略化、要素の抽出、人物・場面・小道具・衣装の分析、同一人物の統合、一貫性チェック、首尾フレームとキーフレームのプロンプト作成など14のエージェントのクラスがある。
同じ「絵コンテから動画へ」を、GeminiとVeoの組み合わせで1本の動画に結合する方式は StoryGen Atelierとは|Geminiで絵コンテを作りVeoで動画化するOSS で扱った。Jellyfishはその手前の「どのショットに誰が出るか」の管理に重心がある。
仕組み:ショットは確認が済んでから生成に進む
SHOT PIPELINE仕組み
1つのショットは確認が済んでから生成に進む
-
章の台本
chapters.raw_text
-
ショット分割
LLMが行番号で区切る
-
候補の確認
pending → ready
-
分镜工作室
キーフレーム・参照画像
-
動画生成
Celeryのタスク
リポジトリのAGENTS.mdは、画面の役割と状態の意味をはっきり分けている。分镜編集ページは「抽出・確認・修正」、分镜工作室は「生成の準備・実行・結果の確認」、タスクセンターは状態の一覧だけを受け持つ。
状態は3種類あり、混ぜないことが約束になっている。
| 状態 | 値 | 意味 |
|---|---|---|
| ショットの確認状態 | pending / ready | 抜き出した候補の確認が済んだか |
| タスクの実行状態 | pending / running / streaming / succeeded / failed / cancelled | 生成や解析の処理が今どうなっているか |
| 動画の準備度 | video-readiness | 動画を生成する条件が揃っているか(ready でも生成できるとは限らない) |
データはSQLAlchemyのモデルで持ち、既定のSQLiteに作ると33テーブルになった。人物(characters)と俳優(actors)、場面、小道具、衣装はそれぞれ画像の表を持ち、正面・側面・背面などの向きを区別する。ショットから抜き出した候補は「紐づけ済み/無視」、台詞の候補は「採用/無視」で確定させ、ショットのフレームは首帧・尾帧・キーフレームの3種類で持つ。
長い処理はすべてCeleryに渡し、ブローカーはRedis。状態の正本はDBの generation_tasks 表で、Celeryの結果バックエンドは使わない設計だとコードのコメントに書かれている。
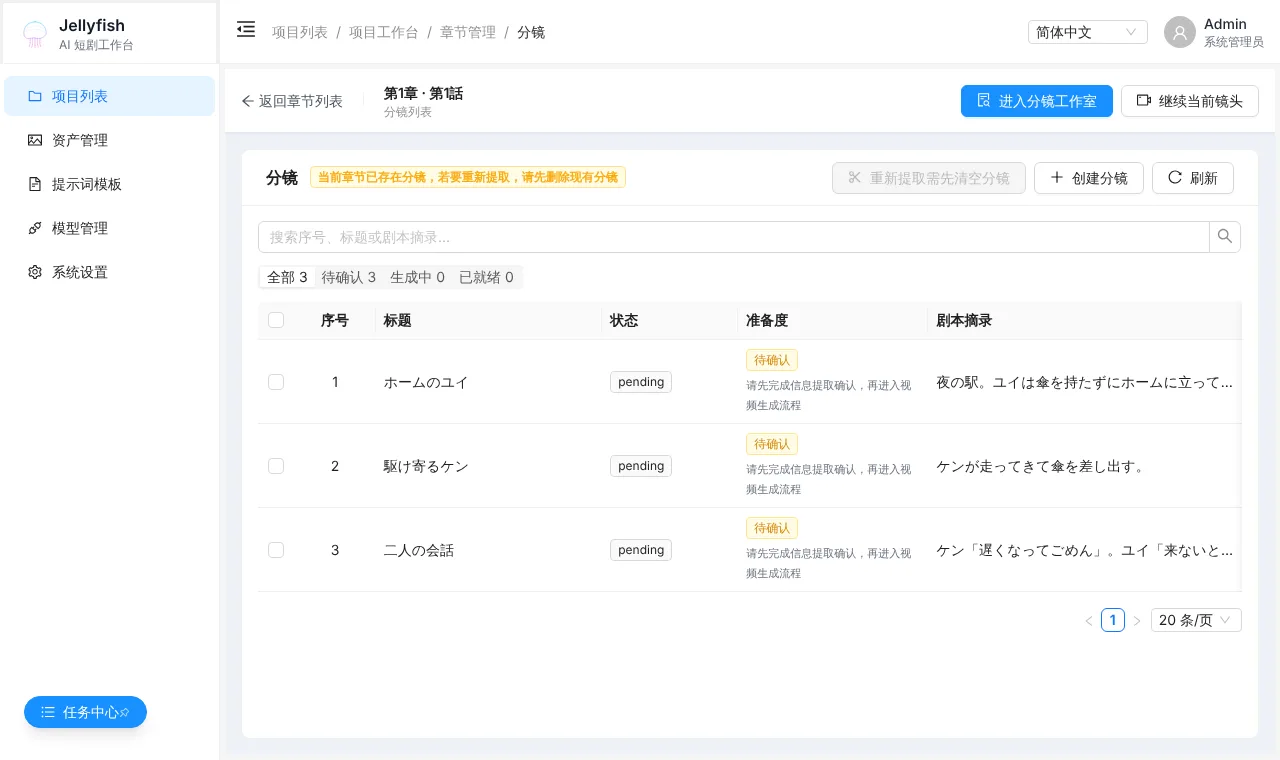
上は当サイトの環境で撮った分镜一覧の画面だ。3つのショットはどれも pending で、準備度の列に「待确认(確認待ち)」と出る。
どのAIモデルを使うか:Jellyfishの接続先とローカル実行
接続先は .env ではなく、画面のモデル管理(API では /api/v1/llm/providers と /llm/models、/llm/model-settings)に登録する。.env.example には IMAGE_API_KEY などの項目が残っているが、mainのコードはこれらを読んでいない。/llm/providers/supported が返した組み込みの接続先は次の3つだった。
| 接続先 | 扱う種類 | 呼び先(コードから) |
|---|---|---|
| OpenAI | 文章・画像・動画 | /chat/completions、/images/generations と /images/edits、/videos |
| 火山引擎(Ark) | 画像・動画 | /images/generations、/contents/generations/tasks |
| 阿里百炼(DashScope 互換モード) | 文章 | OpenAI 互換の /chat/completions |
文章モデルはLangChainの ChatOpenAI で呼ぶので、OpenAI互換のbase_urlなら差し替えられる。ただし条件が2つある。
・APIキーが空だと「Provider api_key is empty」で止まる。ローカルのモデルでもダミーの値が要る
・ショット分割は関数呼び出しで答えさせる。模擬サーバに届いた要求は tool_choice: "required" で、関数名は ScriptDivisionResult だった。関数呼び出しに答えられないモデルでは通らない
画像・動画の接続先にはモデル名の一覧が埋め込まれておらず、利用者が登録した名前をそのまま送る。生成したファイルの保存にはS3互換のストレージが要る(Docker ComposeはRustFSを同梱)。
BEFORE YOU RUN動かす前に
生成まで進むには4つを自分で用意する
-
1.Redis
非同期タスクはCeleryがRedis経由で受け取る。無いと投入が500で失敗
-
2.S3互換ストレージ
画像のアップロードと生成物の保存先。未設定だとアップロードが500
-
3.文章モデル(OpenAI互換)
関数呼び出し(tool_choice=required)に答えられること
-
4.画像・動画モデル
OpenAI か 火山引擎(Ark)のAPIキー
実測:Jellyfishを起動してAIショートドラマの台本を流した
Linux(x86_64・4コア・15GiB)で、main(a967819)をcloneして試した。Dockerのデーモンが無い環境だったので、READMEのローカル開発の手順で起動した。
cd backend
cp .env.example .env
echo "REDIS_PORT=6391" >> .env
uv sync
.venv/bin/python init_db.py
uv sync は100.8秒で94パッケージ、.venv は166MBだった。テーブルは起動時には作られないので、init_db.py を先に流す。Redisは、ほかの作業とポートが重ならないよう6391番にした(.env は起動時に読まれるので、先に書いておく)。
非同期のタスクを動かすにはRedisとCeleryのworkerが要る。APIとworkerを別々に立てる。
redis-server --port 6391 --save '' --daemonize yes
.venv/bin/uvicorn app.main:app --host 127.0.0.1 --port 8000 &
.venv/bin/celery -A app.core.celery_app:celery_app worker -l info --concurrency 1
uvicornの起動から /openapi.json が返るまで7.1秒、APIは101パス・138操作あった。
APIでプロジェクトと章を作り、章の台本のショット分割を投げた。認証のヘッダは付けていない。
B=http://127.0.0.1:8000/api/v1
curl -s -X POST $B/studio/projects -H 'content-type: application/json' \
  -d '{"id":"p1","name":"雨の駅","style":"真人都市"}'
curl -s -X POST $B/studio/chapters -H 'content-type: application/json' \
  -d '{"id":"c1","project_id":"p1","index":1,"title":"第1話"}'
curl -s -X POST $B/script-processing/divide-async -H 'content-type: application/json' \
  -d '{"script_text":"夜の駅。ユイは傘を持たずにホームに立っている。","write_to_db":true,"chapter_id":"c1"}'
条件を変えて、どこで止まるかを見た。
| 条件 | 結果 |
|---|---|
| Redis を起動していない | 投入が500。Redisへの接続拒否。タスクは pending のまま残り、同じ章の再投入は reused: true でそれを返すだけで動かない(取り消すと再投入できた) |
| 文章モデルが未設定 | タスクが failed:「No default model configured for category=text」 |
| 届かない接続先+ダミーのキー | failed:「Connection error.」(約4.7秒) |
| langchain-openai を外した環境 | failed:「Install langchain-openai to enable script-processing tasks」 |
| ローカルの模擬サーバ(固定の分割を返す) | succeeded(237ms)。3ショットが pending でDBに入り、画面にも出た |
| S3 未設定で画像をアップロード | 500。ログは「S3 未配置」 |
最後の模擬サーバは、手順が最後まで通ることを示す陽性対照として当サイトが書いた30行ほどのPythonで、分割の中身は固定だ。本物のモデルが台本をどう区切るかは測っていない。
メモリは、uvicornが148MB、Celeryのworkerが親子合わせて283MB(RSS)。画面は pnpm install(node_modules 279MB)のあと vite で7788番に立ち、バックエンドのCORSの既定もこの番号に合わせてある。
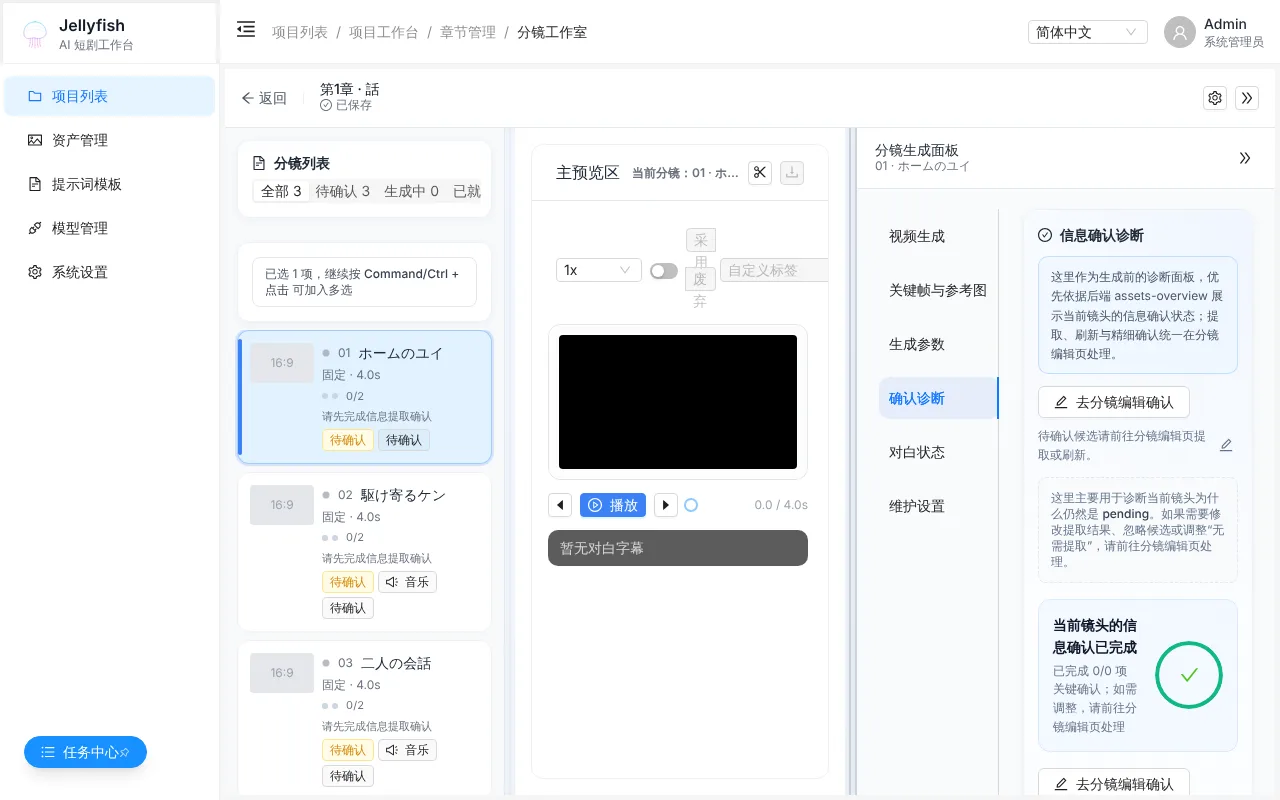
分镜工作室(上)は開けたが、動画生成のパネルは確認が済んでいないショットでは先に分镜編集へ戻るよう案内する。画面の言語は簡体字中国語と英語の2つで、英語に切り替えても翻訳ファイルはナビゲーションや設定など4つの名前空間しかなく、作業画面の大半は中国語のままだった。
未検証の範囲
- ・OpenAI・火山引擎・阿里百炼の実APIでの台本解析、画像生成、動画生成(APIキーが無い)
- ・Docker Compose での起動(デーモンが無い)。Dockerfile は
uv sync --no-devで、langchain-openai は dev グループにしか無い。コードを読む限りイメージ内では台本解析が上の表と同じエラーになるはずだが、イメージでは試していない - ・書き出し(README にある export)と動画の編集画面
- ・実在のローカルLLM(Ollama など)での関数呼び出し
選び方:ほかのAIショートドラマ・動画生成ツールとの比較
| 道具 | 作る単位 | 台本と人物の扱い | 生成モデル | ライセンス |
|---|---|---|---|---|
| Jellyfish | 章 → ショット | LLMが分割・抽出し、人が候補を確定。資産をショットに紐づけて使い回す | OpenAI・火山引擎(画像・動画)、OpenAI互換(文章) | Apache-2.0 |
| StoryGen Atelier | 絵コンテ → つなぎの動画 | Gemini が絵コンテの文とフレームを作る | Gemini・Vertex AI Veo | Apache-2.0 |
| MoneyPrinterTurbo | テーマ → 1本の短い動画 | LLM が台本を書き、素材動画・字幕・音声を自動で合わせる | 多数の LLM ゲートウェイ、Pexels などの素材 | MIT |
| ComfyUI | ノードをつないだワークフロー | 台本の管理は持たない | 手元の画像・動画モデルなど | GPL-3.0 |
| 動画モデルのWeb画面 | 1カット | 利用者の手元 | そのサービスのモデル | サービスの規約 |
Jellyfishが向くのは、話数と登場人物が多く、同じ人物を何十ショットにも出す作り方だ。1本の動画をテーマから素早く作りたいならMoneyPrinterTurbo型、絵の作り込みを自分の環境で詰めたいならComfyUIのほうが近い。フォトリアルな動画の生成と編集をOSSで組む方法は CapCut代替でAI動画をOSSで自作する完全ガイド:生成と編集 にまとめている。
注意点:Jellyfishの更新状況と、認証の無いAPI
コミットの履歴を全部取ると、151件は2026-03-06から2026-04-20の間に収まっていた(3月87件、4月64件)。タグはv0.1.0-alpha(04-01)からv0.3.2(04-17)まで。mainは約6か月止まっている。
GitHubのページで見たIssueは24件で、すべてクローズ済み。プルリクエストは8件が開いたままで、古いものは2026-03-19、新しいものは2026-09-19に出されている(英語の翻訳を足すもの、Novita や MiniMax などの接続先を足すもの、OpenAIの thinking 引数の互換を直すものを含む)。
・APIに認証が無い:Issue #37「All API v1 endpoints missing authentication and authorization (CWE-306)」は2026-09-10にクローズされたが、mainには4月以降コミットが無く、手元のmainでも認証なしでプロジェクトや接続先を作れた
・ポートの公開:Docker Compose は 8000・7788・3306・6379・9000 などをホストIPの指定なしで公開する。Dockerの既定では全インターフェースで待ち受けるので、外から届くネットワークに置かない
・APIキーの保存:接続先のAPIキーはAPIの応答には出ないが、DBの providers 表には平文で入っていた
・OpenAIの thinking 引数:Issue #38 は OpenAI のモデルで enable_thinking が拒否されると報告している。mainのコードは今もこの値を送る。実APIでは未検証
まとめ
- ・Jellyfish は、AIショートドラマの台本・ショット・人物・生成タスクを1つのDBで管理する制作台帳
- ・起動と画面は手元で動いた。生成まで進むには Redis・S3互換ストレージ・関数呼び出しに答えられる文章モデル・画像と動画のAPIキーが要る
- ・mainは半年止まり、APIに認証が無い。試すなら手元の閉じた環境で
参照ソース
・Forget-C/Jellyfish(公式リポジトリ・README・AGENTS.md)
・Forget-C/Jellyfish Issues
・Forget-C/Jellyfish Pull requests
・0xsline/StoryGen-Atelier
・harry0703/MoneyPrinterTurbo
・comfyanonymous/ComfyUI