ファインチューニング エージェント、つまりAIにファインチューニングを任せる道具が増えている。学習そのものを自動化するものではなく、何を作りたいかを聞き取って、ベースモデルを選び、データを整え、ハイパーパラメータを決めて、サーバーを借りるところまで案内するという形だ。
empero-org/brewery-ai(Brewery)はその一例で、2026-10-05 に公開されて1日で183 star が付いた。この種の道具で気になるのは機能の数ではない。エージェントがどこまで勝手に進めるかだ。GPU を借りれば課金が発生する。学習率を間違えればモデルが壊れる。ベースモデルのライセンスを踏み外せば配布できない。どれも「あとで気づく」類の事故で、しかも気づくのは請求書か、公開後の指摘によってだ。
そこで本記事は、機能紹介ではなく止まる場所を数える方針で測った。41あるツールのうち危険なものは何件か、課金に至る経路は実装されているか、ハイパーパラメータの制限はどこまで緩められるか。すべて実行して確かめている。
eb75d9b)を仮想環境に導入して計測。数値はいずれも 2026-10-06 の実測30秒でわかる
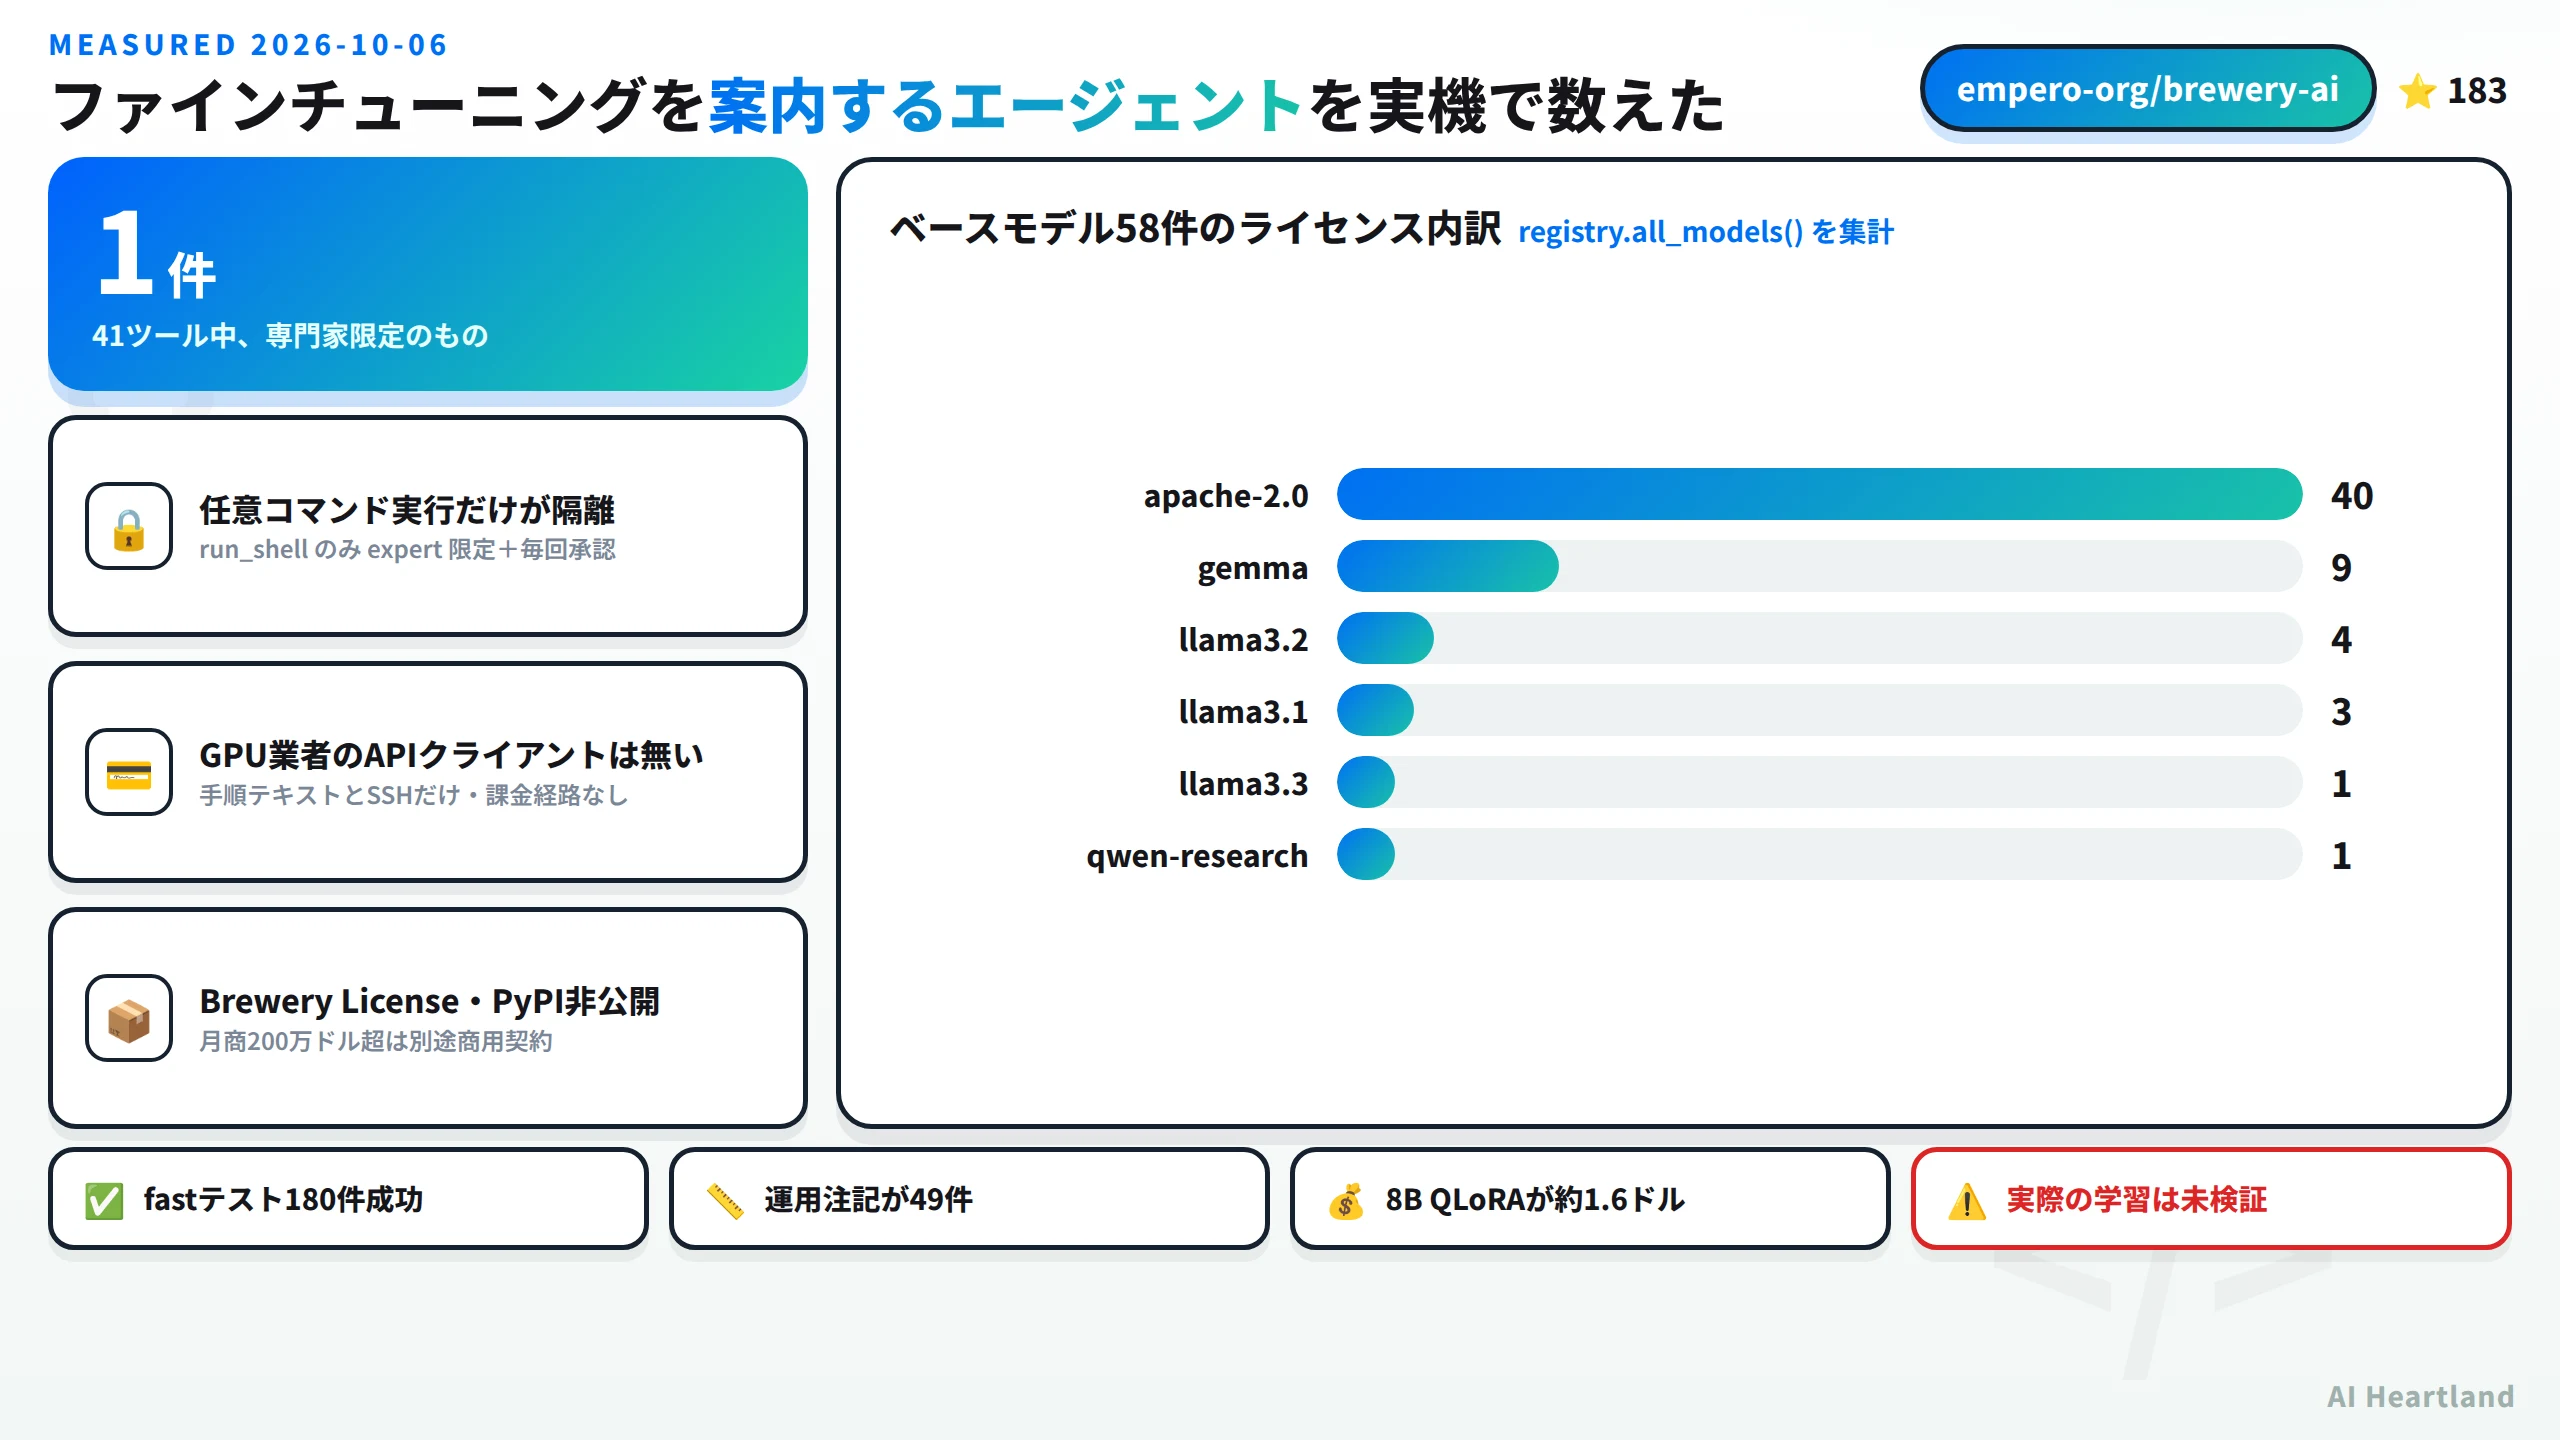
・エージェントの41ツールのうち、任意のシェルコマンドを実行できる run_shell 1件だけが専門家モード限定で、さらに実行ごとに承認を取る
・GPU業者のAPIクライアントはコードに存在しない。手順テキストとSSHだけで、サーバーを借りるのは人間。エージェントが課金を発生させる経路が無い
・ベースモデル58件にライセンス条件が機械可読で付いている。Llama 系は名前が Llama で始まらないと拒否され、Qwen Research 系は非商用の告知がモデルカードに自動で入る
・ハイパーパラメータの制限は二層。学習率などは expert_override で警告へ降格できるが、手法の不許可とコンテキスト超過は専門家でも通らない
・ライセンスは MIT ではない。月商200万ドルを超える組織は別途商用契約が要る
・リポジトリの全履歴が 11.4時間に収まる。実際の学習(GPU必須)は本記事では未検証
エージェント基盤全体の選び方はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその枝として、エージェントに金と法務が絡む作業を任せたときの歯止めを測る。
ファインチューニング エージェントが実際に握っている権限
まず名前の整理から。このプロジェクトは 0.1.0 を Homebrew という名前で公開し、同じ日に Brewery へ改名している。README にも理由が書いてある。
| macOS の Homebrew | 本記事の Brewery | |
|---|---|---|
| 正体 | パッケージマネージャ | ファインチューニングを案内するエージェント |
| コマンド | brew |
brewery |
| 配布 | 公式サイト・各種パッケージ | GitHub から直接(PyPI には無い) |
| ライセンス | BSD 2-Clause | Brewery License(商用上限つき) |
| 作者 | Homebrew コミュニティ | Empero |
検索でも混ざりやすいので、以降は Brewery と書く。
導入は README の案内どおり Git から直接行う。pip install brewery-ai は通らない(No matching distribution found で終わる)ので、PyPI 経由を期待しないこと。
python3 -m venv .venv
.venv/bin/pip install "brewery-ai @ git+https://github.com/empero-org/brewery-ai"
.venv/bin/brewery doctor
この環境(Ubuntu 24.04 / Python 3.12.3)での実測は 51秒・63パッケージ・589MB。注意したいのは、この 589MB に学習本体の PyTorch が入っていないことだ。GPU で学習する場合は [train] エクストラで CUDA 版 PyTorch が追加される。
doctor の出力はこうなった。
Brewery 0.2.1 · Python 3.12.3
! no guiding AI configured yet (run `brewery setup`)
! not logged in to Hugging Face (needed for gated models and uploads)
! GPUs: none — training will run on a rented server
  PyTorch: not installed
  RAM 15.7 GB · free disk 6.0 GB
APIキーも Hugging Face ログインも GPU も無い状態で、何が足りないかを正しく4行で返してくる。この手の道具は「環境が整っていないと何も言わずに落ちる」ことが多いので、ここが素直なのは良い。
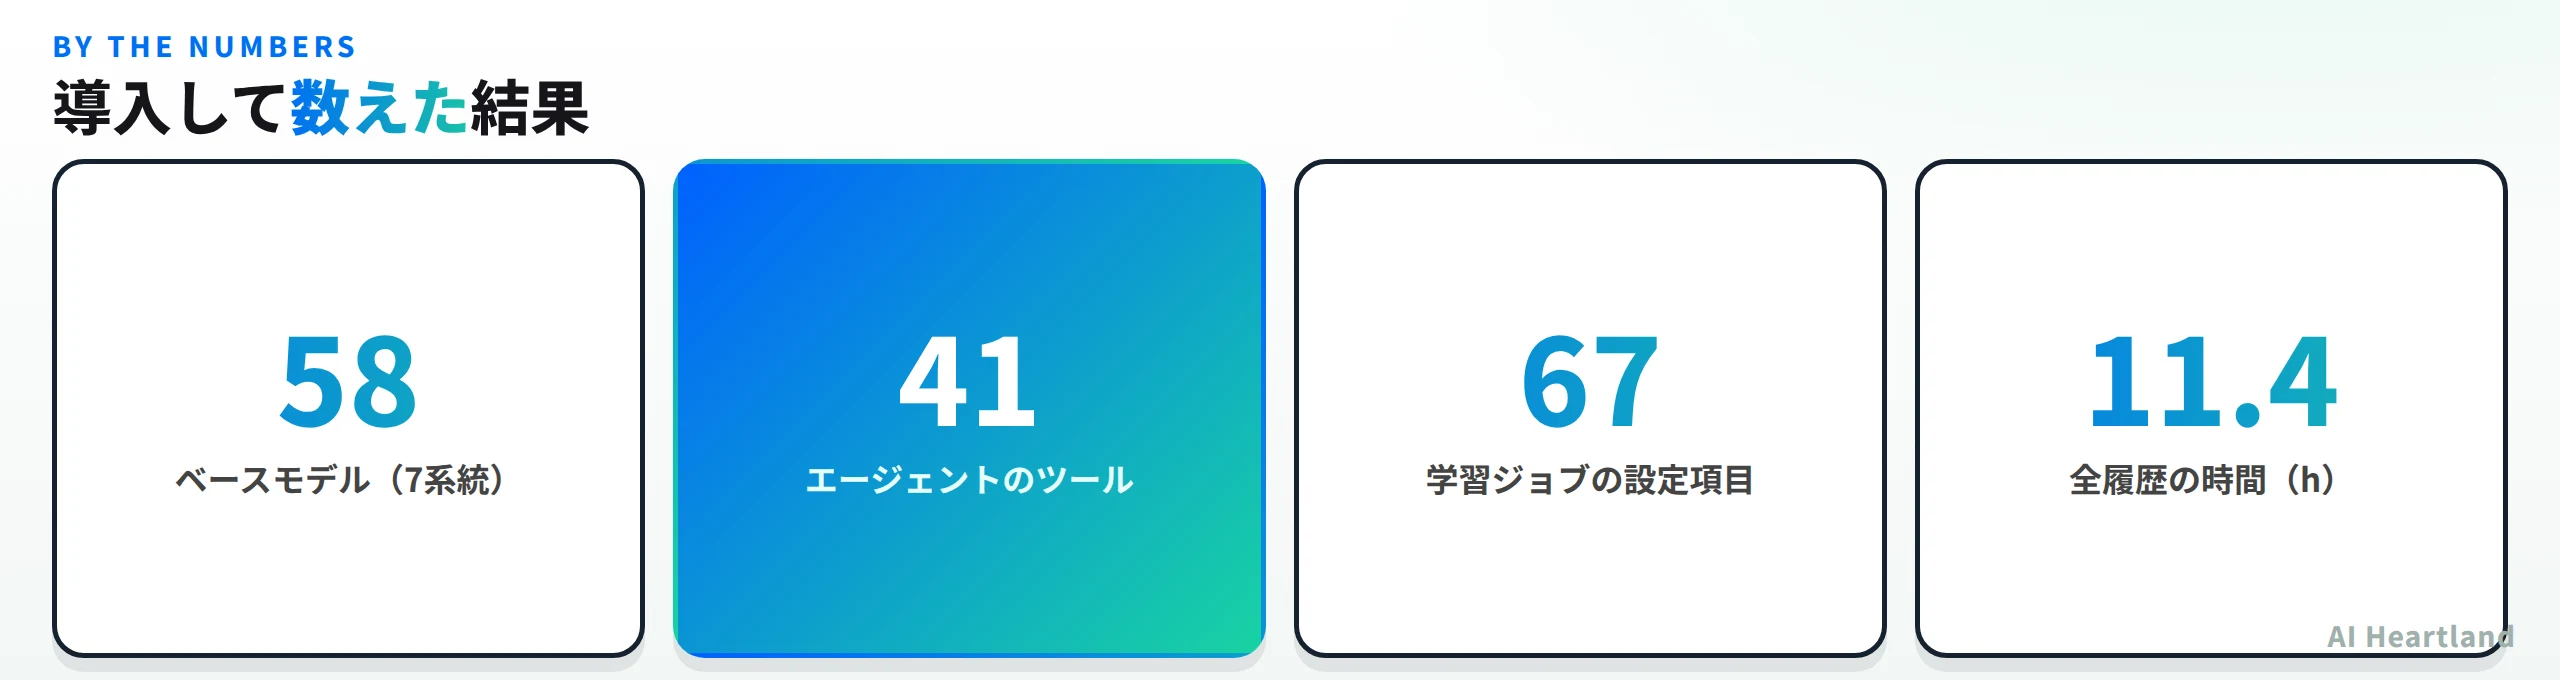
本題の権限を数える。エージェント(Brewery では brewmaster と呼ばれる)が持つツールはレジストリに 41件登録されている。そのうち権限レベルで隔離されているものを調べると、結果は1件だった。
・specs(level="expert") → 41件
・specs(level="beginner") → 40件
・差分 → run_shell のみ
run_shell は任意のシェルコマンドをローカルまたは接続先サーバーで実行するツールで、定義には levels=("expert",) が付き、実装の先頭で ctx.confirm_or_raise を呼んでコマンド1本ごとに利用者の承認を取る。つまり二重の歯止めがかかっている。残りの40ツールは、モデル検索・ハードウェア検査・データ変換・学習設定といった作用の範囲が定義で閉じているものだ。
この構え自体は、当サイトで先日扱ったREAとは|AIエージェント 逆解析ツールが宣言する副作用7項目と証拠形式を実際に数え直したと同じ考え方にあたる。REA は16機能すべてに副作用を機械可読で宣言させていた。Brewery は宣言ではなく権限レベルと承認ゲートで同じ問題を解いている。どちらも「エージェントに渡す道具は、何をするかではなく何をしないかを先に決めておく」という設計だ。
エージェントが課金を発生させられるか
ファインチューニングで一番怖いのは、学習の失敗よりも借りっぱなしの GPU だ。Brewery は「サーバーを借りるところまで案内する」と README に書いてあるので、ここは実装を確かめる必要がある。
結論から書くと、2026-10-06 時点のコードに GPU 業者の API クライアントは存在しない。src/ 全体を runpod と vast で検索して出てくるのは、案内テキストに埋まった URL と SSH の分岐だけで、HTTP リクエストを送る箇所が無い。
実装にあるのは2社ぶんの手順書だ。
・Runpod:8手順+課金の注意3項目
・Vast.ai:7手順+課金の注意3項目
課金の注意は具体的だった。Runpod は「停止した pod もボリュームディスクの課金は続く。終わったら TERMINATE すること」、Vast.ai は「停止しても保管料は止まらない。終わったら DESTROY すること」と書いてある。どちらもクラウド GPU で実際に請求が膨らむ原因そのもので、手順書としては正確だ。
そして README の Roadmap を読むと「automatic GPU rental via provider APIs(opt-in、支出上限つき)」が将来項目として挙げられている。つまり「まだ実装していない」という自己申告とコードの実態が一致している。READMEの公称と実装がずれていないことを確認できたので、ここは安心して使える。
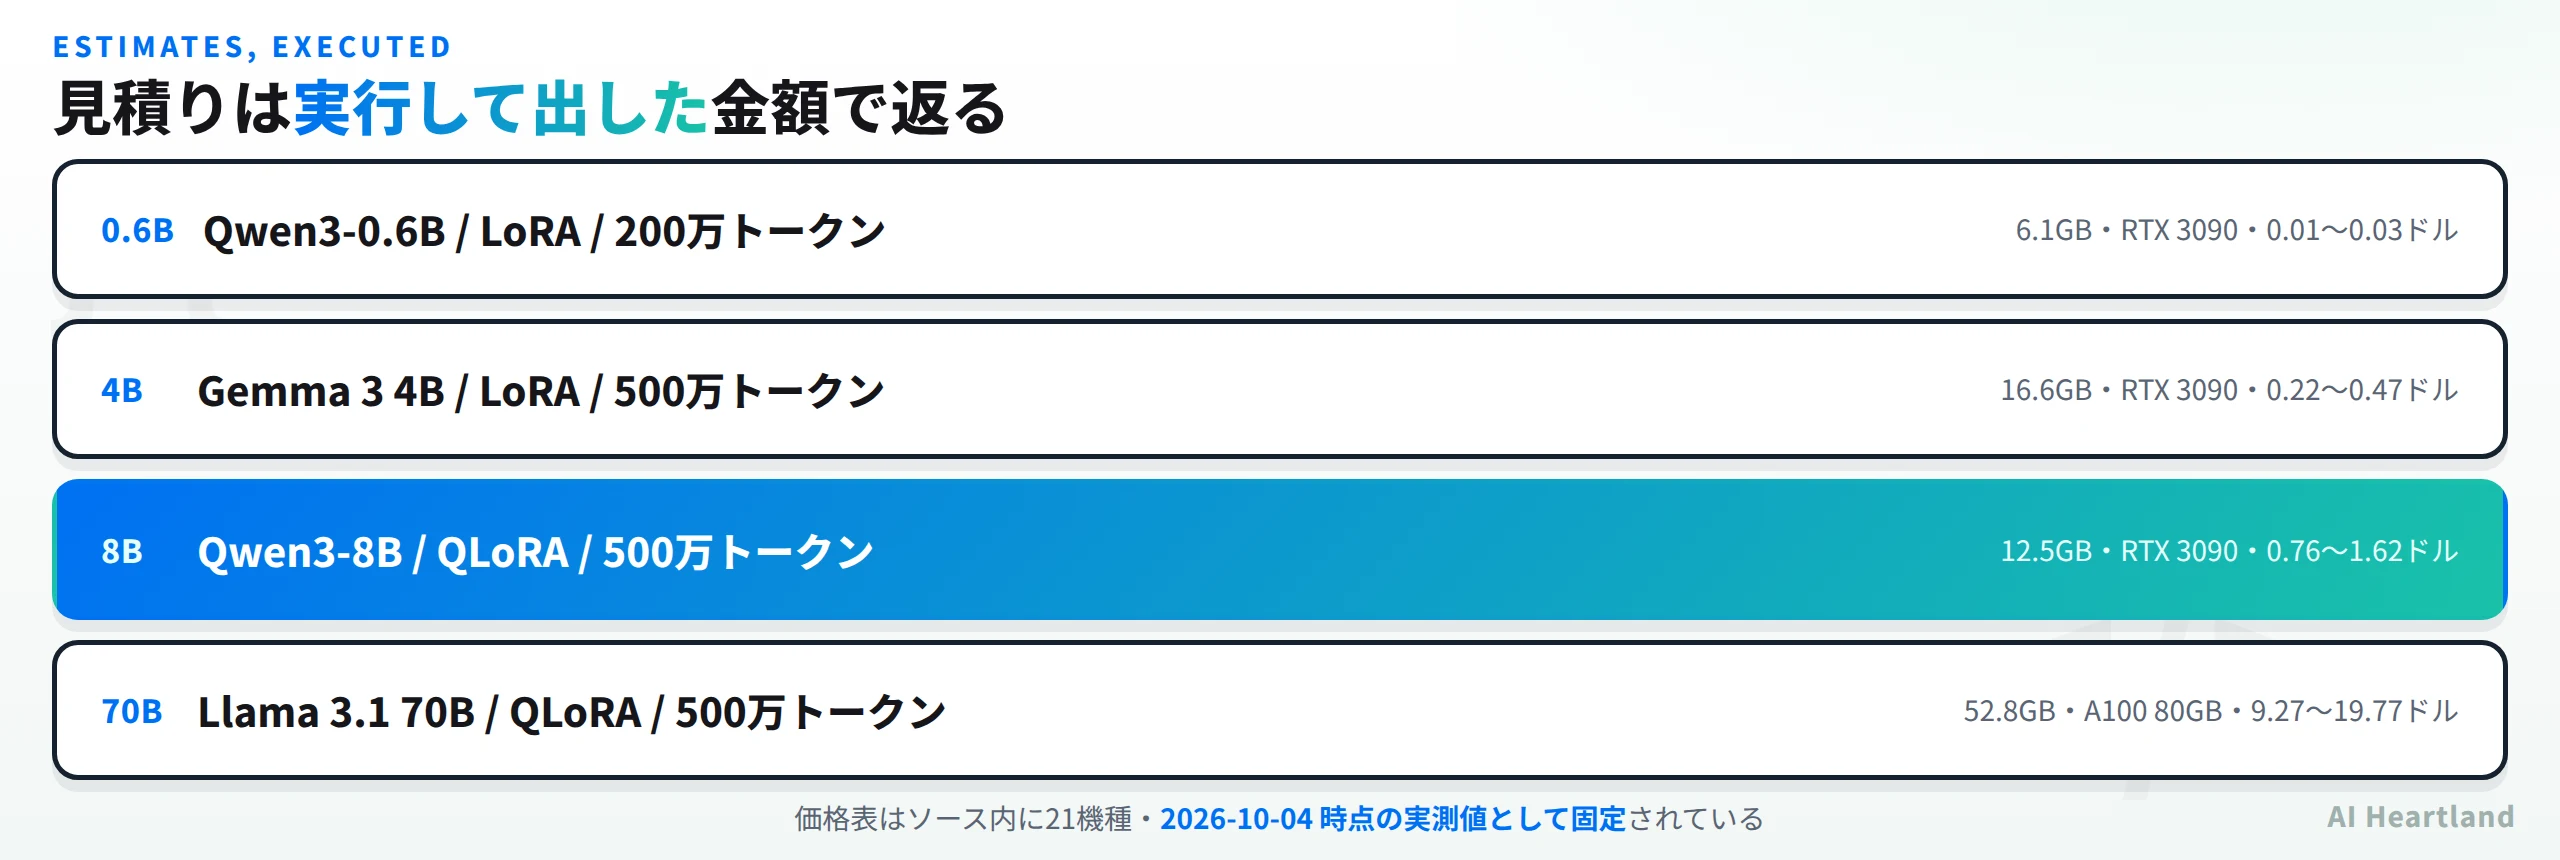
代わりに実装されているのが見積りだ。estimate_requirements はベースモデルと手法から必要 VRAM を計算し、収まる GPU を価格順に返す。これは API キー無しで動くので実行して確かめた。
| ベースモデル | 手法 | 必要メモリ | 推奨GPU | 時間 | 概算費用 |
|---|---|---|---|---|---|
| Qwen3-0.6B | LoRA | 6.1 GB | RTX 3090($0.22/h) | 0.06〜0.12h | $0.01〜0.03 |
| Gemma 3 4B | LoRA | 16.6 GB | RTX 3090($0.22/h) | 1.00〜2.13h | $0.22〜0.47 |
| Qwen3-8B | QLoRA | 12.5 GB | RTX 3090($0.22/h) | 3.45〜7.36h | $0.76〜1.62 |
| Llama 3.1 70B | QLoRA | 52.8 GB | A100 80GB($1.19/h) | 7.79〜16.61h | $9.27〜19.77 |
※ 系列長2048、Qwen3-0.6B のみ200万トークン、他は500万トークン処理時の値
メモリの内訳まで返ってくるのが面白かった。Qwen3-0.6B の LoRA で合計 6.1GB のうち、重みが 1.12GB、学習対象とオプティマイザが 0.15GB、活性値が 0.25GB に対して、ロジットが 2.9GB を占める。小さいモデルほど語彙サイズ由来のロジットが支配的になるわけで、「0.6B なら 8GB の GPU で足りるだろう」という直感が外れる理由がここにある。
価格表はソース内に 21機種ぶん固定されており、PRICES_CHECKED = "2026-10-04" という定数で確認日が明示されている。16機種に両社の価格が入り、5機種は価格なし(RTX 3060・A10G・A100 40GB・RTX PRO 5000・MI300X)。固定値である以上いずれ古くなるが、いつ時点かが書いてあるのは良心的だ。なお README がデモモデルを焼いたと書いている RTX PRO 5000 は、この価格なし側に入っている。
58モデルのライセンスはコードで処理されている
ここが Brewery のいちばん実用的な部分だった。
ベースモデルのカタログは 58件・7系統。ライセンスの内訳は apache-2.0 が40件、gemma 9件、llama3.2 4件、llama3.1 3件、llama3.3 1件、qwen-research 1件。gated(利用規約への同意が要る)が17件、推奨マークが15件。
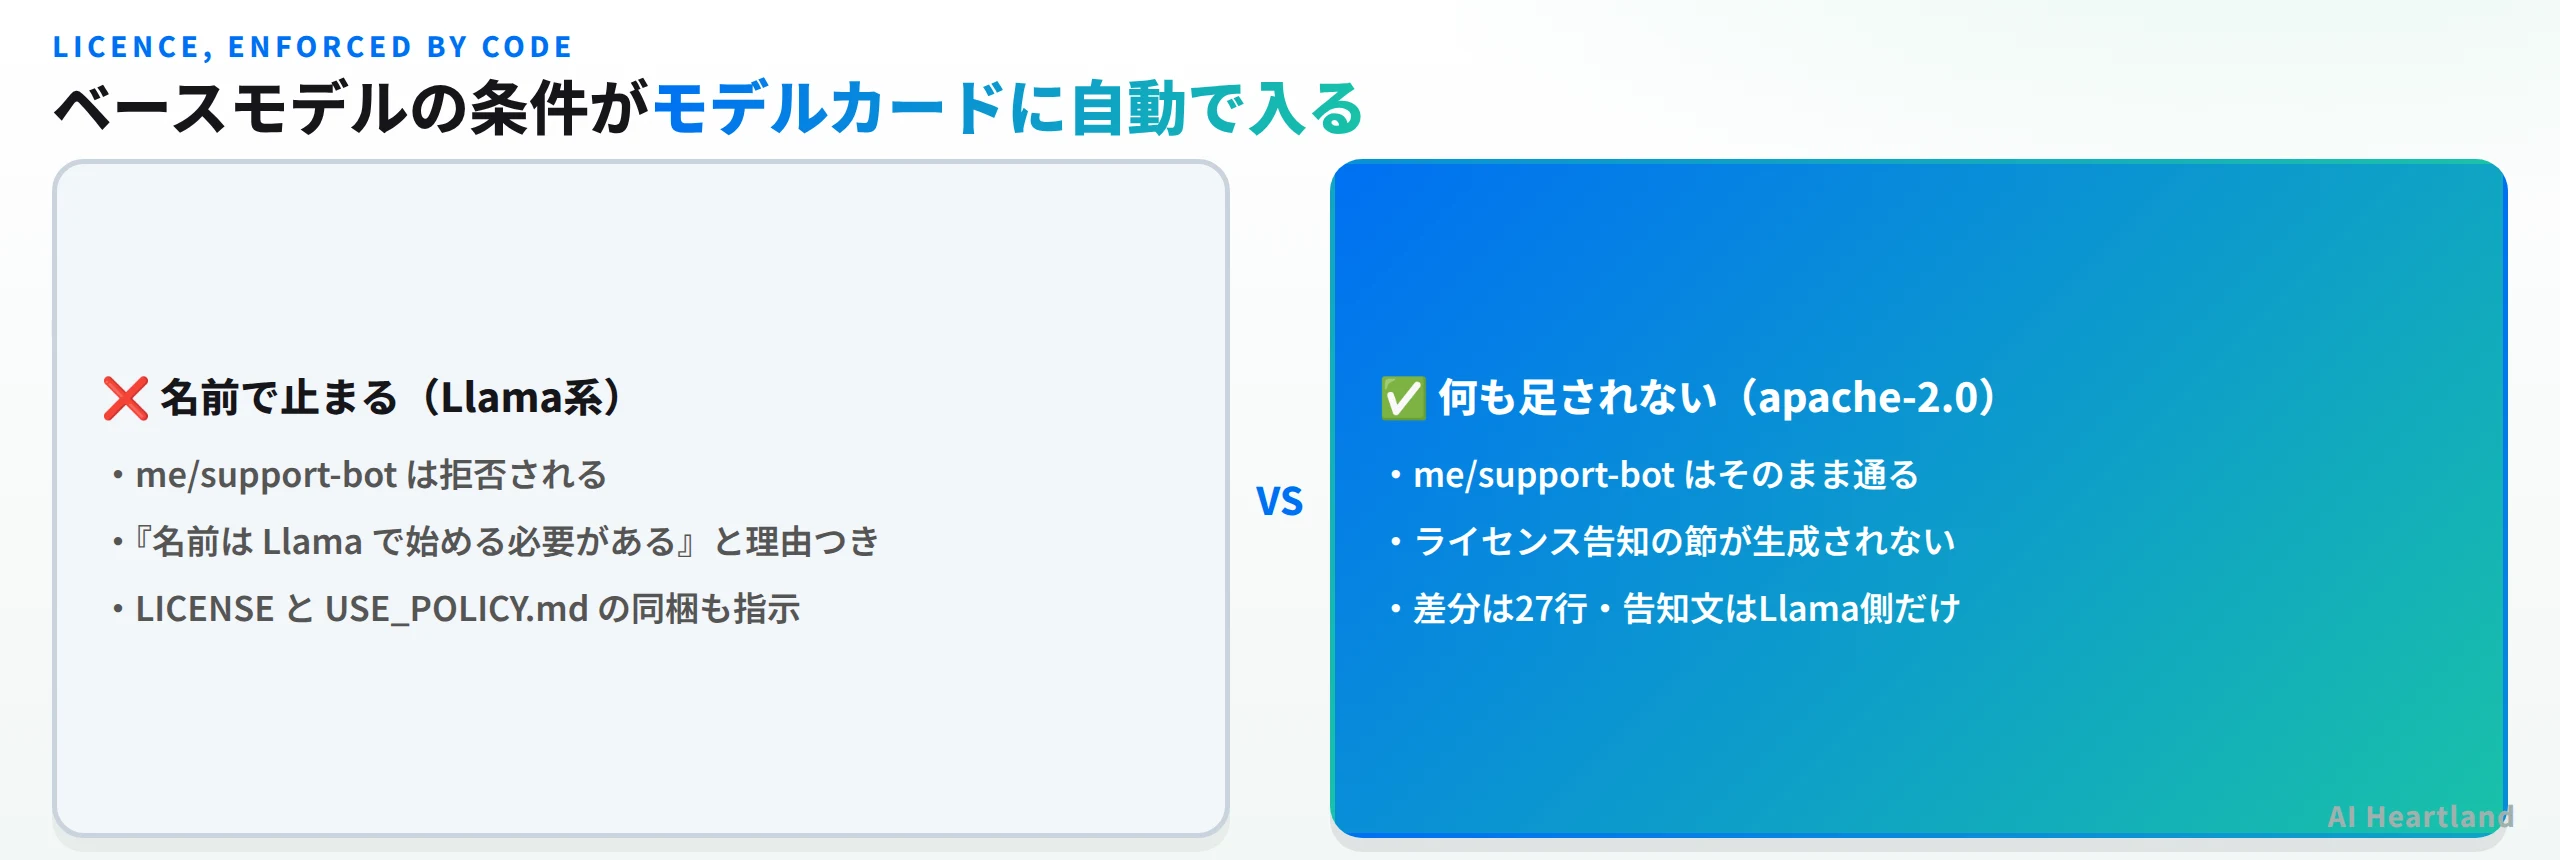
注目したいのは数ではなく、ライセンスごとの義務が構造化されて入っていることだ。
| ライセンス | 非商用 | 告知文 | 同梱必須ファイル | 名前の規則 |
|---|---|---|---|---|
| apache-2.0 | いいえ | なし | なし | なし |
| gemma | いいえ | あり | なし | なし |
| llama3.1 系 | いいえ | あり | LICENSE・USE_POLICY.md |
Llama で始めること |
| qwen-research | はい | あり | LICENSE |
あり |
これが本当に効いているかを、同じ内容のモデルカードをベースモデルだけ変えて生成し、差分を取って確かめた。
・apache-2.0(Qwen3-4B)のカード:1,855文字・63行
・llama3.1(Llama-3.1-8B-Instruct)のカード:2,112文字・69行
・差分:27行
増えていたのは ## License notice という節と、その中の「Built with Llama.」および Meta の著作権表示だった。frontmatter の license: も apache-2.0 から llama3.1 へ、タグも qwen3 から llama3 へ入れ替わる。
名前の検査も実行した。
・check_repo_name("me/support-bot", Llama-3.1-8B) → ["the Llama 3.1 Community License requires the model name to start with 'Llama'"](拒否)
・check_repo_name("me/Llama-support-bot", Llama-3.1-8B) → [](通る・陰性対照)
・check_repo_name("me/support-bot", Qwen3-4B) → [](apache-2.0 なので規則なし・陰性対照)
さらに suggest_repo_name("support-bot", Llama-3.1-8B) は Llama-Instruct-support-bot を返した。規則に合う名前を自分で作ってくるわけだ。
非商用の Qwen Research ライセンスを使った場合はもっと強い文面が入る。生成されたカードには frontmatter に license: other / license_name: qwen-research が入り、本文に「Non-commercial use only. The base model is released under the Qwen Research License (non-commercial); this derivative and its outputs may not be used commercially.」が自動で書き込まれた。
この挙動は、Brewery 自身のライセンス第3条と筋が通っている。第3条は「Software を使って作ったモデル・データセット・出力は Software の二次的著作物ではなく、このライセンスの対象外。ベースモデルとデータセットのライセンスに従う」と書いている。つまり Brewery は自分の権利を主張しない代わりに、ベースモデル側の義務を機械的に転記する役を引き受けている。
ライセンス表示を鵜呑みにすると事故る話は、当サイトでliftとは|PDF 構造化抽出の9BモデルをGitHubのApache-2.0表示だけで判断してはいけないでも書いた。lift はリポジトリが Apache-2.0 でも重みは別ライセンスで、しかも出力まで条件が及ぶという構造だった。Brewery はその逆で、出力に条件が及ばないことを明文化したうえで、ベース側の条件だけを自動で引き継ぐ。どちらも「リポジトリのバッジ1個では判断できない」ことを示している。
そして Brewery 自身のライセンスも MIT ではない。名前は Brewery License、中身は MIT の許諾文に条項を足したものだ。
- Commercial Threshold. The permission above is granted to individuals and to Organizations whose gross revenue, together with that of their Affiliates, does not exceed USD 2,000,000 (two million US dollars) per month, averaged over the twelve (12) months preceding the use.
月商200万ドル(年商換算で約2,400万ドル)を超える組織は Empero と別途商用契約が必要になる。個人と大半の企業には MIT と同じ条件だが、OSI 準拠のオープンソースではない。pyproject.toml の license フィールドも LicenseRef-Brewery と書かれており、MIT を名乗っていない点は誠実だ。README でも同じ説明がされている。
ハイパーパラメータの制限はどこまで緩むか
「安全なハイパーパラメータを選んでくれる」という売り文句は、裏を返せば利用者が上書きできるのかという問いになる。できなければ窮屈だし、無条件にできれば歯止めにならない。
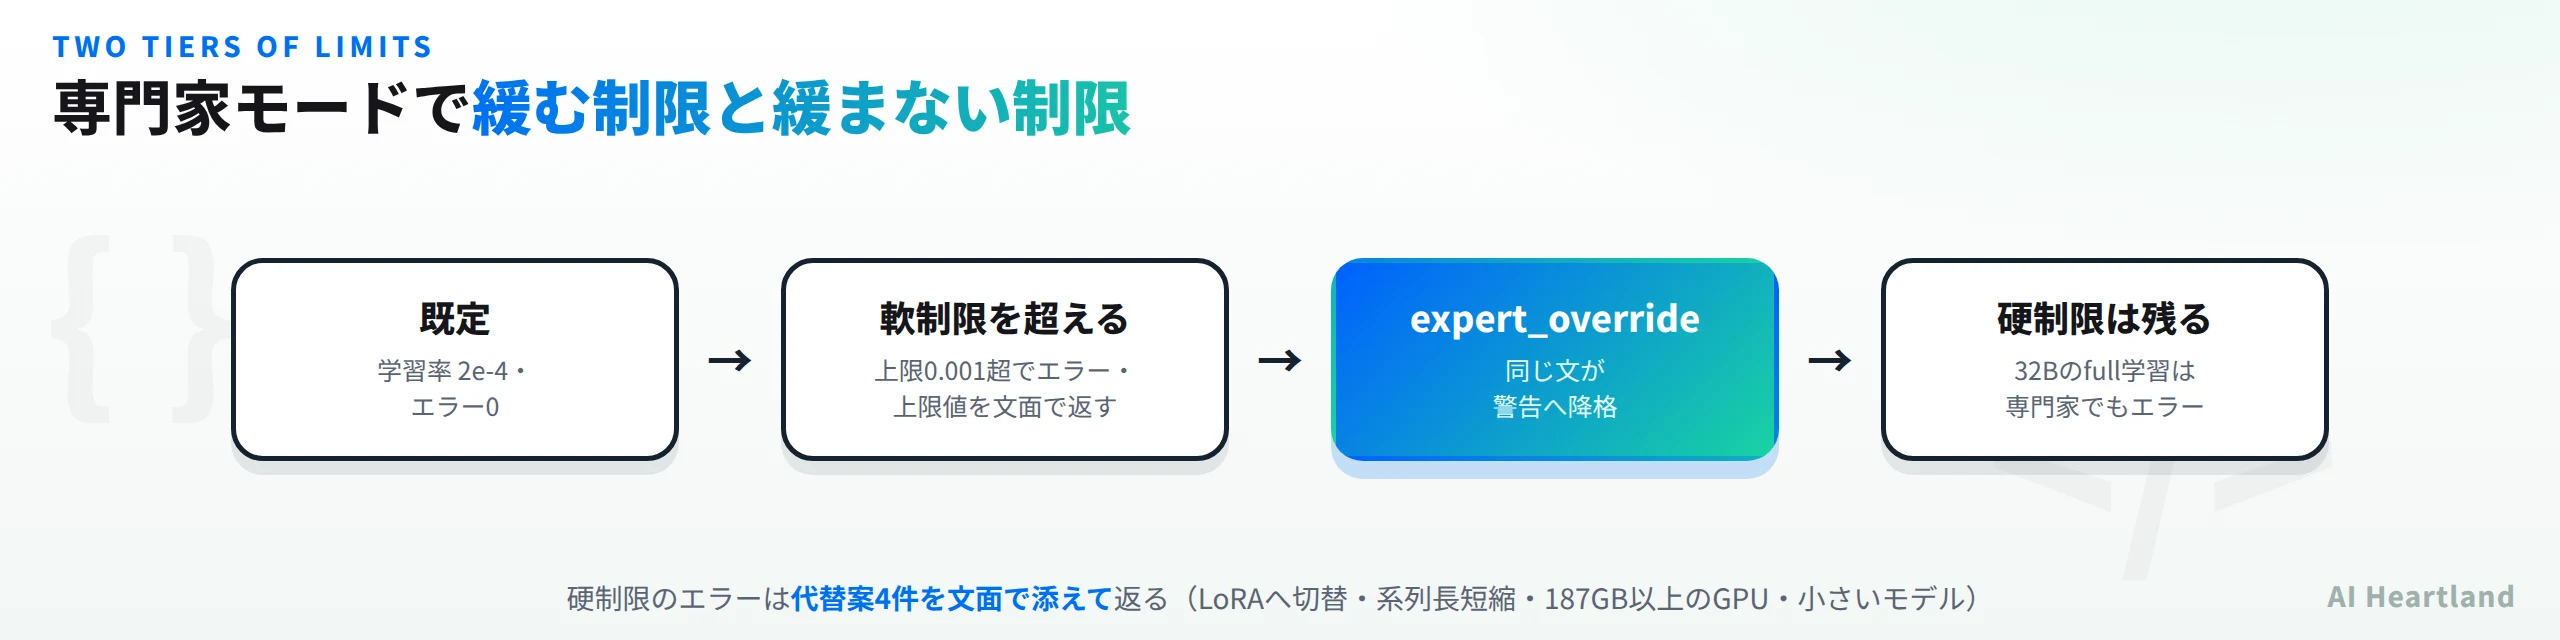
build_job() を3条件で実行した結果はこうなった。
| 条件 | 学習率 | 結果 |
|---|---|---|
| 既定(ガイドライン任せ) | 2e-4 | エラー0・警告0 |
| 0.05 を指定・override なし | 0.05 | エラー「learning_rate=0.05 is above the allowed maximum 0.001」 |
0.05 を指定・expert_override |
0.05 | 警告へ降格「(expert override) learning_rate=0.05 is above…」 |
上限値(0.001)を文面に含めて返すのが実用的だ。「だめです」ではなく「いくつまでなら良いか」が分かる。
では expert_override で何でも通るのかというと、通らない。設定の検証部分を読むと、override はエラー文に not allowed か context window を含むものだけを除外して警告へ落とす実装になっている。つまり手法の不許可とコンテキスト超過は専門家モードでも硬いままだ。
陽性対照として、Qwen3-32B に対して full(全重み更新)を expert_override=True で要求してみた。
estimated 172 GB needed but the GPU has 80 GB; options: switch to LoRA
(trains a small adapter instead of every weight); shorten max_seq_len
(now 2048); rent a GPU with at least 187 GB; pick a smaller base model
method 'full' is not allowed for Qwen/Qwen3-32B: ... Full fine-tuning a
32B model needs a multi-GPU cluster; use LoRA or QLoRA.
専門家モードでもエラーのまま残り、しかも代替案を4件(LoRA へ切替/系列長を短く/187GB以上の GPU/小さいモデル)添えてくる。陰性対照として Qwen3-0.6B に同じ full を要求するとエラー0で通った。モデルサイズに応じた判定が正しく効いている。
学習ジョブの設定項目は、最上位20フィールドにサブモデル7種(データ・最適化・LoRA・DPO・画像・実行時・初期化)を足して計67項目ある。この67個をエージェントが対話から埋めて、ガイドラインでクランプし、ハードウェアに合わせて自動調整する、という構造だ。
41ツール"] B --> C["ベースモデル選択
58件・7系統"] B --> D["データ整備
ETF へ変換"] C --> E["ガイドライン層
67項目をクランプ"] D --> E E --> F{"制限の種類"} F -->|"軟制限:学習率など"| G["expert_override で
警告へ降格できる"] F -->|"硬制限:手法・文脈長"| H["専門家でも通らない
代替案を返す"] G --> I["学習ジョブ"] H --> J["やり直し"] I --> K["モデルカード生成
ライセンス条件を自動転記"]
7系統の YAML プロファイルには、運用上の注意が family 側に29件・variant 側に20件、合計49件書かれている。これが実のところ一番価値のある部分だと思う。たとえば、
・Gemma 3:「T4 / V100 では活性値が fp16 でオーバーフローする。bf16 対応 GPU が必要」
・Gemma 3:「262k の語彙でロジットが巨大になる。小さい GPU では系列長とバッチを控えめに」
・Qwen3:「推論痕跡を含む標本を75%以上残さないと thinking 能力が落ちる。素の回答だけで学習させると弱くなる」
・Qwen3:「思考なしの回答にはテンプレートが空の think ブロックを足すので、Brewery は損失計算から除外する」
・Llama 3.1:「派生物は命名規則と使用ポリシーの同梱が要る。パッケージャが両方書く」
普通はブログ記事や事故報告に散らばっている知見が、実行時に参照される形で入っている。58という数字より、この49件のほうが導入判断の材料になる。
なお1点だけ脆い箇所がある。画像モデル系統(qwen_image)の依存指定が、diffusers を GitHub のコミット固定 zip で参照している。上流の構成が変われば無言で404になりうる経路で、ここは時間が経つと壊れる可能性がある。
学習データの検証は機械可読なコードで返る
Brewery は学習データを ETF(Empero Trace Format)v1 という形式に統一する。JSON Schema が同梱されていて、$defs が13件、レコード型は oneOf で4種(trace / text / completion / image)だった。
これが実際に何を弾くのかを、陽性対照と陰性対照の両方で確かめた。まず正しい3行を通す。
.venv/bin/brewery etf validate good.jsonl
結果は valid 3 / invalid 0(trace 1・text 1・completion 1)。次に壊した3行、すなわち「assistant の応答が無い対話」「messages を持たないレコード」「text に数値を入れたもの」を通すと、valid 0 / invalid 3 になり、エラーコードが3種返った。
| 投入した行 | エラーコード | メッセージ |
|---|---|---|
| user 発話だけの対話 | nothing_to_learn |
no assistant message to train on |
messages が無い |
unknown_record |
record needs ‘messages’, ‘text’, ‘prompt’+’completion’ or ‘image’ |
{"text":12345} |
empty_text |
— |
加えて警告 trailing_messages も1件。assistant の応答が無い対話を nothing_to_learn で弾くのは、データ整備でいちばん起きやすい事故に直接効く。対話ログをそのまま流し込むと、学習対象が無い行が混ざるからだ。
ただし3つめは正確ではない。{"text":12345} は空ではなく型違反なのに、コードは empty_text が返る。空文字列と型の間違いが区別されていない。実用上は困らないが、エラーコードで分岐する処理を書くなら知っておいたほうがいい。
同梱テストも回した。fast スイートは 180 passed / 5 failed / 15 skipped。失敗5件はすべて環境要因で、内訳は ssh バイナリ不在が3件、PyTorch 不在が2件だった(どちらもこのコンテナに入っていない)。コード側の失敗は0件。テスト関数は16ファイルに126個定義されている。
認証情報の扱いも確認した。Brewery は起動時に「ブリューマスターがあなたの API キーを見ることはない。キーはこのパソコンにだけ保存される」と表示する。実際にキーを保存してパーミッションを見ると、
・ディレクトリ ~/.config/brewery-ai/ → drwx------(700)
・ファイル credentials.yaml → -rw-------(600)
・書き込みは一時ファイル経由の os.replace で原子的
表示どおりだった。ただし中身は平文の YAML で、OS のキーチェーンは使っていない。ANTHROPIC_API_KEY のような環境変数があればそちらが優先される。「モデルには渡らない」は正しいが「暗号化されている」わけではないので、共有マシンでは注意がいる。
ブリューマスターの選択肢は6つ(Claude / OpenAI / OpenRouter / Ollama / LM Studio / その他 OpenAI 互換)。Ollama と LM Studio を選べばローカルモデルで完結するが、画面には「ツール呼び出しに対応した14B以上のモデルを使うこと」と条件が書かれていた。41ツールを扱うので、小さいモデルでは回らないという判断だろう。
APIキーを一本も持たずにどこまで確かめられるかは、当サイトでPydantic AIとは|APIキー0本でエージェントの往復を実測し744モデル文字列を数えるを書いたときにも試した方法だ。Pydantic AI は偽のモデルを挿し込めたので往復まで追えたが、Brewery は対話そのものが外部モデル前提なので同じ手は使えない。結果として、APIキーが無い本記事の環境では、ここが壁になる。対話を始めるには6択のいずれかを選んでキーを入れる必要があり、ブリューマスターとの実際のやりとりは未検証のまま残した。同様に、Hugging Face への push もログインが無いため未検証、そして実際の学習も未検証だ。最後の点は Brewery 自身の判定と一致している——GPU の無いこの環境に対して、ツールは verdict に「training here is not practical (tiny test models only); rent a GPU server」と返している。
ファインチューニング エージェントとして導入するかの判断材料
最後に、気になる点を正直に書いておく。
リポジトリの全履歴が11.4時間に収まる。git log で全10コミットの時刻を取ると、最初の Initial commit が 2026-10-05 00:16(+02:00)、v0.2.1 が同日 11:39。この間に Python 70ファイル・14,037行と、Homebrew → Brewery の改名まで入っている。タグ3本も同日だ。
これをどう読むかは慎重にしたい。コードがどう書かれたかは計測していない(.claude/ や AGENTS.md のような支援ツールの痕跡は無く、コミットに Co-Authored-By も付いていない)。言えるのは実務上の含意だけで、レビュー履歴から成熟度を読み取れないということだ。issue は0件、外部からの PR は1件(Windows の AMD GPU 検出の修正)がマージ済み。使うなら自分でテストを回す前提になる。幸い同梱テストは充実していて、実際に180件が通った。
ついでに言うと main(eb75d9b)とタグ v0.2.1(a732194)はコミットが別物だが、git diff を取ると差分は空だった。内容は同一で、タグ付け後に空コミット相当の操作が入っている。実害は無い。
star は 183 で、当サイトが普段使っている採用ラインには届いていない。公開翌日という事情はあるが、定着するかはまだ分からない。
向いている場面
・ファインチューニングを一度もやったことがなく、どこから手をつけるか分からない場合。49件の運用注記と67項目の自動設定が、独学なら数週間かけて踏む地雷を代わりに踏んでくれる
・ベースモデルのライセンス条件を自力で追いたくない場合。58件ぶんの義務が構造化されていて、モデルカードに自動で入る
・GPU を借りる前に費用の桁を知りたい場合。見積りは API キー無しで動く
向いていない場面
・すでに trl や axolotl で自前のパイプラインがある場合。Brewery が代行するのは判断であって学習そのものではないので、判断が済んでいるなら層が増えるだけになる
・月商200万ドルを超える組織。別途商用契約が要る
・OSI 準拠のライセンスが社内要件になっている場合
何を代替するかを一言で言えば、「ファインチューニングの前段にある調べもの」だ。どのモデルが自分の GPU に載るか、学習率はいくつが妥当か、Llama 派生の命名規則は何か、データ形式はどう揃えるか——個別には検索すれば出てくるが、正しい順序で全部やるのが難しい。その順序が道具の形になっている。
逆に、学習そのものの品質を上げる道具ではない。実際に回すのは transformers と peft と trl で、Brewery はその上に判断の層を乗せているだけだ。だからこそ、判断の層がどこで止まるか——本記事が測ったのはそこだった。41ツール中1件の隔離、課金経路の不在、二層のクランプ、ライセンスの自動転記。いずれもエージェントに任せたときに効く歯止めで、機能の数より先に確認する価値がある。
参照ソース
・empero-org/brewery-ai(GitHub) — 本記事の計測対象。Brewery 0.2.1 / main eb75d9b
・LICENSE(Brewery License 原文) — 商用上限条項と第3条の出典
・docs/etf.md(ETF 仕様) — Empero Trace Format の説明
・docs/models.md(モデルプロファイル) — 58モデルのカタログ定義
計測値は data/measurements/runs/2026-10-06-brewery-finetuning-agent.json に記録した。環境は Ubuntu 24.04 / x86_64 / Python 3.12.3、GPU 無し、空きディスク 6.0GB。