PDF 構造化抽出のモデルが増えている。lift datalab ——Marker や Surya を公開している datalab.to が出した9Bのビジョンモデル——は、JSONスキーマを渡すとそれに沿ったJSONが返る。スキーマ制約デコーディングで出力の妥当性を保証する、という触れ込みだ。⭐983。素の文書OCRがページのテキストを返すのに対し、lift は「何を抜きたいか」をスキーマで宣言して構造化JSONを直接受け取る。
GitHubのリポジトリ画面にはライセンスが Apache-2.0 と出る。だが採用を検討するなら、そこで止まってはいけない。リポジトリには LICENSE とは別に MODEL_LICENSE というファイルがあり、重みの条件はそちらで決まっている。
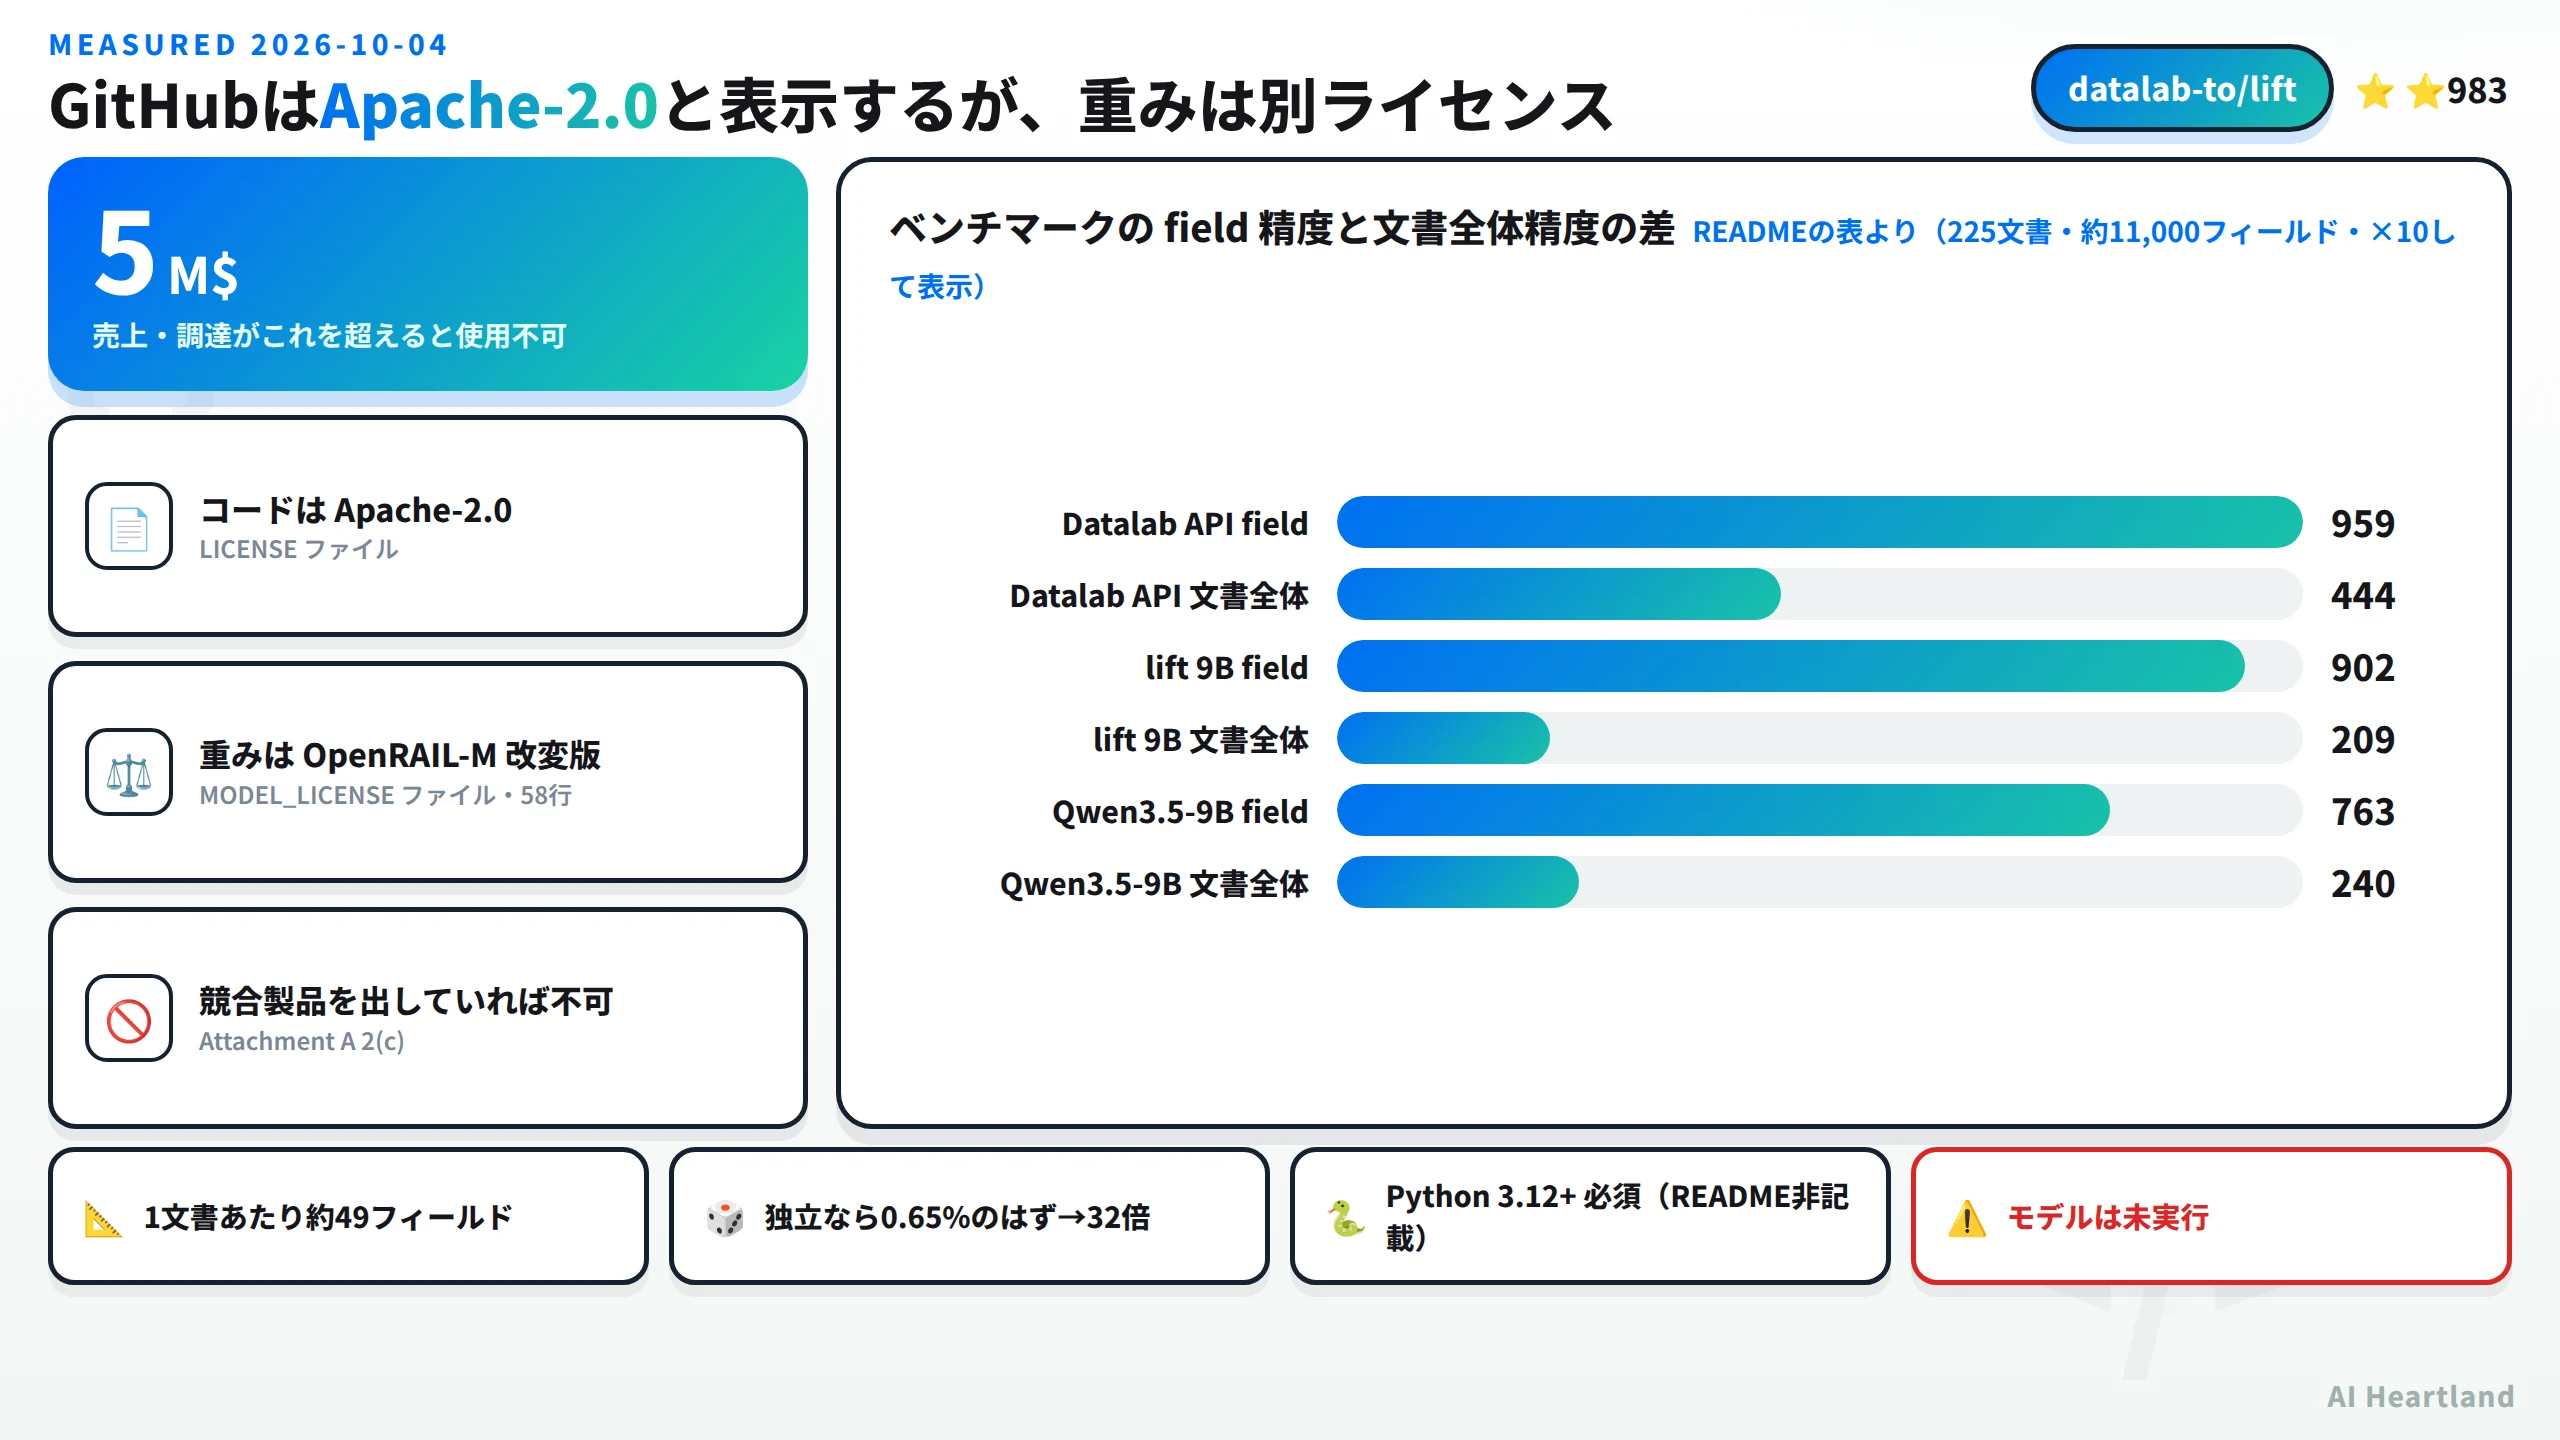
・GitHubのバッジは `LICENSE` しか見ない。**重みは OpenRAIL-M 改変版**で、売上/調達 5M USD 超の企業は使えない
・READMEは制限を明記している。**隠しているのはバッジのほう**で、プロジェクトは誠実
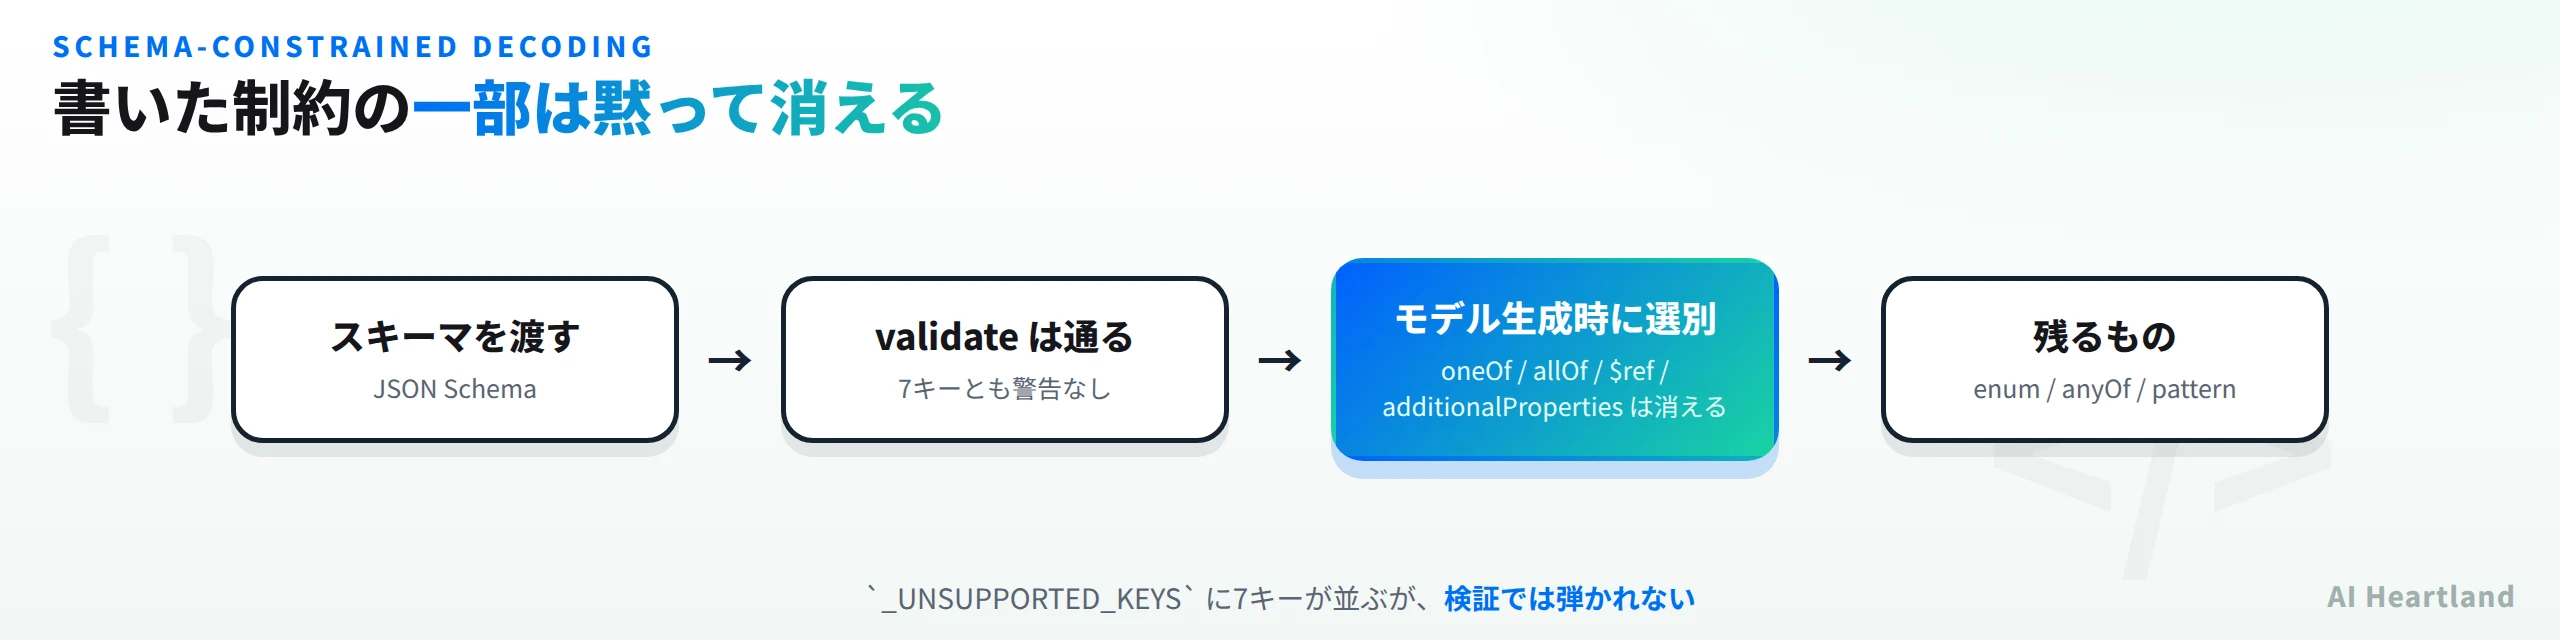
・スキーマ制約は全部は効かない。**`oneOf`/`allOf`/`$ref`/`additionalProperties` は検証を通って黙って消える**
- ・PDF・画像 → スキーマ準拠JSONの **9Bビジョンモデル**。⭐983・最終コミットは 2026-06-19
- ・**コードは Apache-2.0、重みは OpenRAIL-M 改変版**の2本立て
- ・重みの制限:**売上/調達 5M USD 超は不可**・**Datalab と競合する製品も不可**
- ・PyPI のパッケージ名は `lift` ではなく **`lift-pdf`**。**Python 3.12+ 必須**(READMEに記載なし)
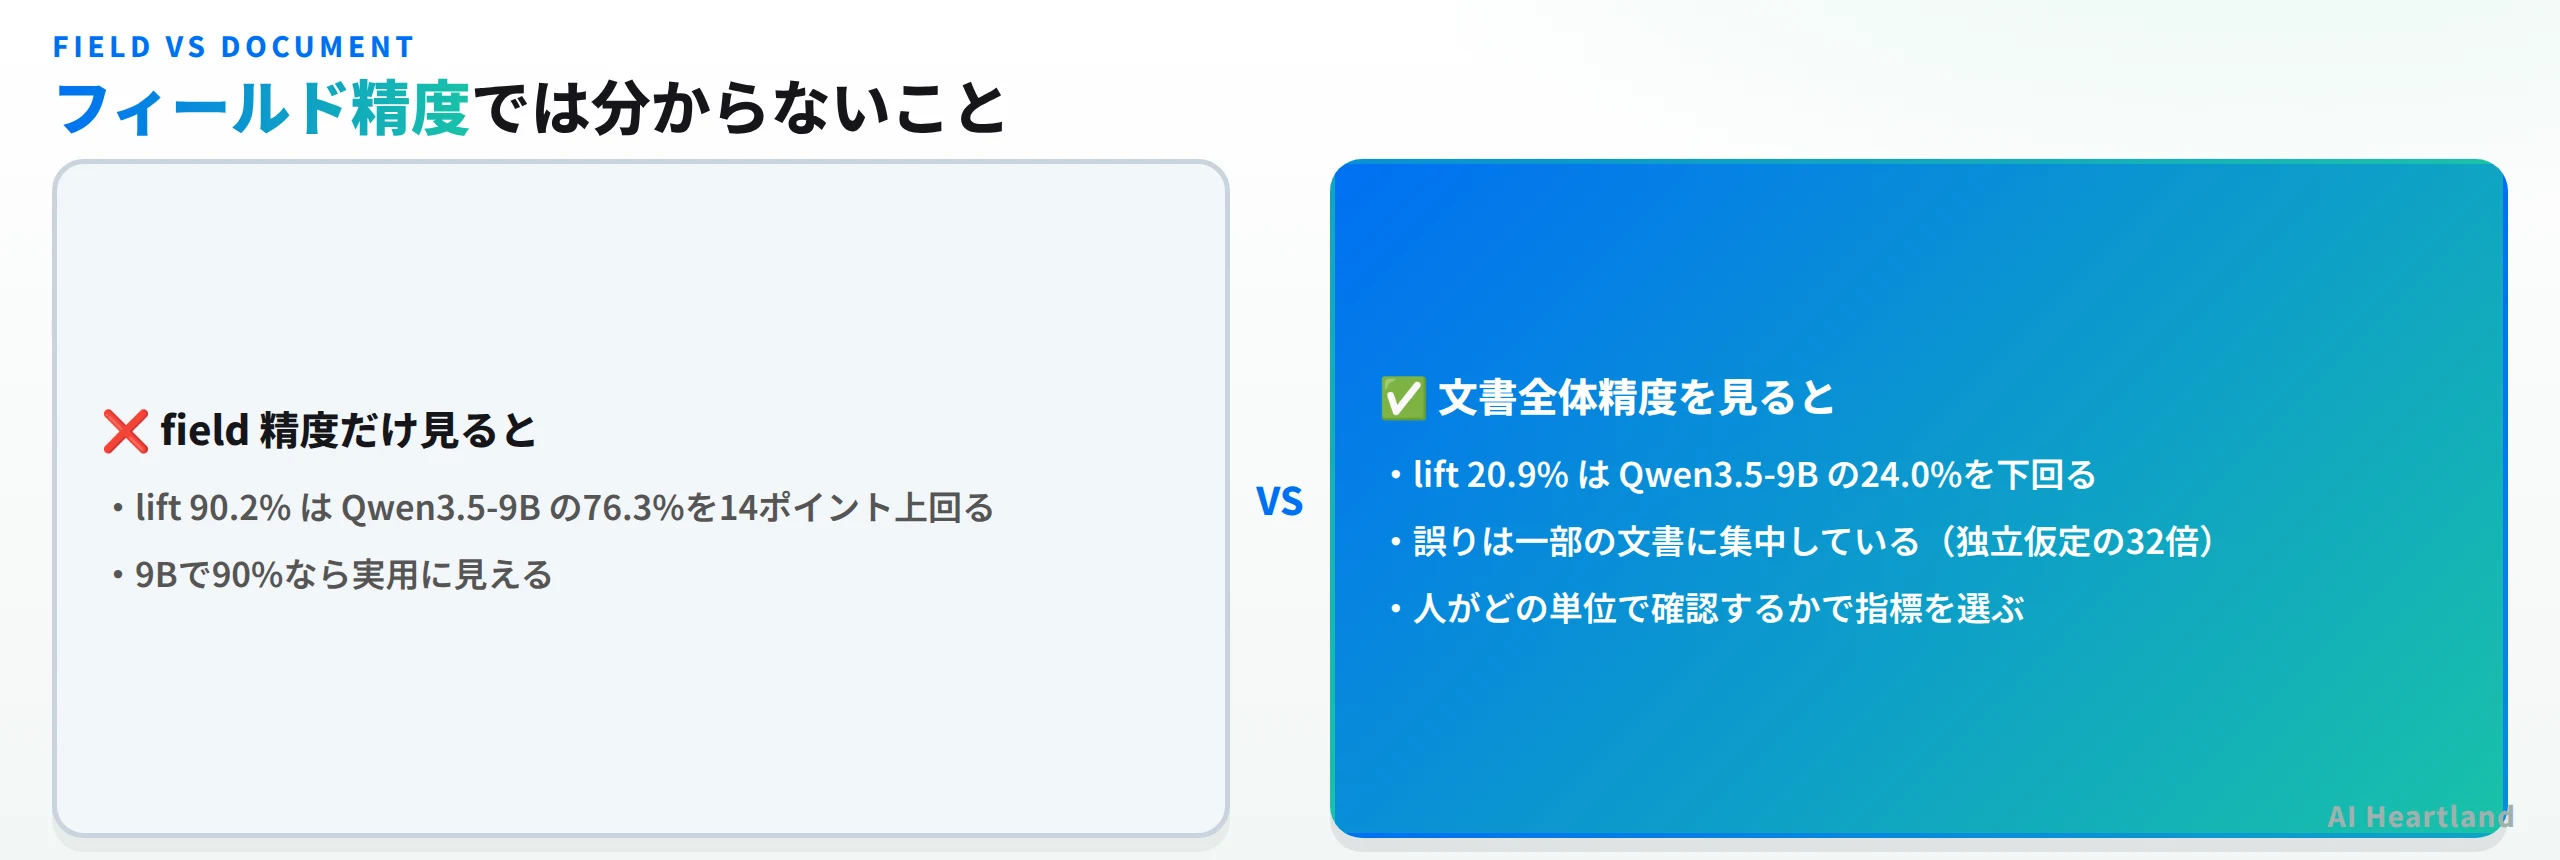
- ・フィールド精度 90.2% に対し**文書全体精度は 20.9%**。誤りは一部の文書に集中
- ・スキーマの7キーは検証を通るが、**4キーは生成時に消える**
モデルの位置づけ全体はLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版を参照してほしい。本記事は lift 単体について、重みに触れずに確かめられることを測った記録である。
PDF 構造化抽出のライセンスは2ファイルに分かれている
まず構成を見る。リポジトリ直下にこの2つが並んでいる。
LICENSE         Apache License 2.0(661行)
MODEL_LICENSE   AI PUBS OPEN RAIL-M LICENSE (MODIFIED)(58行)
GitHub のライセンス表示は licensee というライブラリが LICENSE を既知のテンプレートと照合した結果なので、MODEL_LICENSE は視界に入らない。結果として、使用制限つきの重みを配っているリポジトリが、画面上は素の Apache-2.0 に見える。
この分割自体は珍しくない。モデルを配るプロジェクトでは、コードと重みで条件を分けるのが普通になってきている。当サイトのCLAUDE.mdにも「ライセンスは静かに変わる(Paseo AGPL→Apache、TimesFM は重みだけ非商用)」という既知の落とし穴が書かれていて、lift はその TimesFM 型にあたる。
MODEL_LICENSE の Attachment A(USE RESTRICTIONS)が核心だ。
- Commercial: (a) for any purpose if You (your employer, or the entity you are affiliated with) generated more than five million US Dollars ($5,000,000) in gross revenue in the prior year, except where Your Use is limited to personal use or research purposes; (b) … has raised more than five million US dollars ($5,000,000) in total equity or debt funding … (c) for any purpose if You … provides or otherwise makes available any product or service that competes with any product or service offered by or made available by Licensor
整理するとこうなる。
| 条件 | 使えるか |
|---|---|
| 個人利用・研究目的 | ✅ 制限なし |
| 売上5M USD 以下の企業の業務利用 | ✅ |
| 前年の売上が5M USD 超 | ❌(個人利用・研究を除く) |
| 累計調達額が5M USD 超 | ❌(同上) |
| Datalab の製品と競合するサービスを提供 | ❌ |
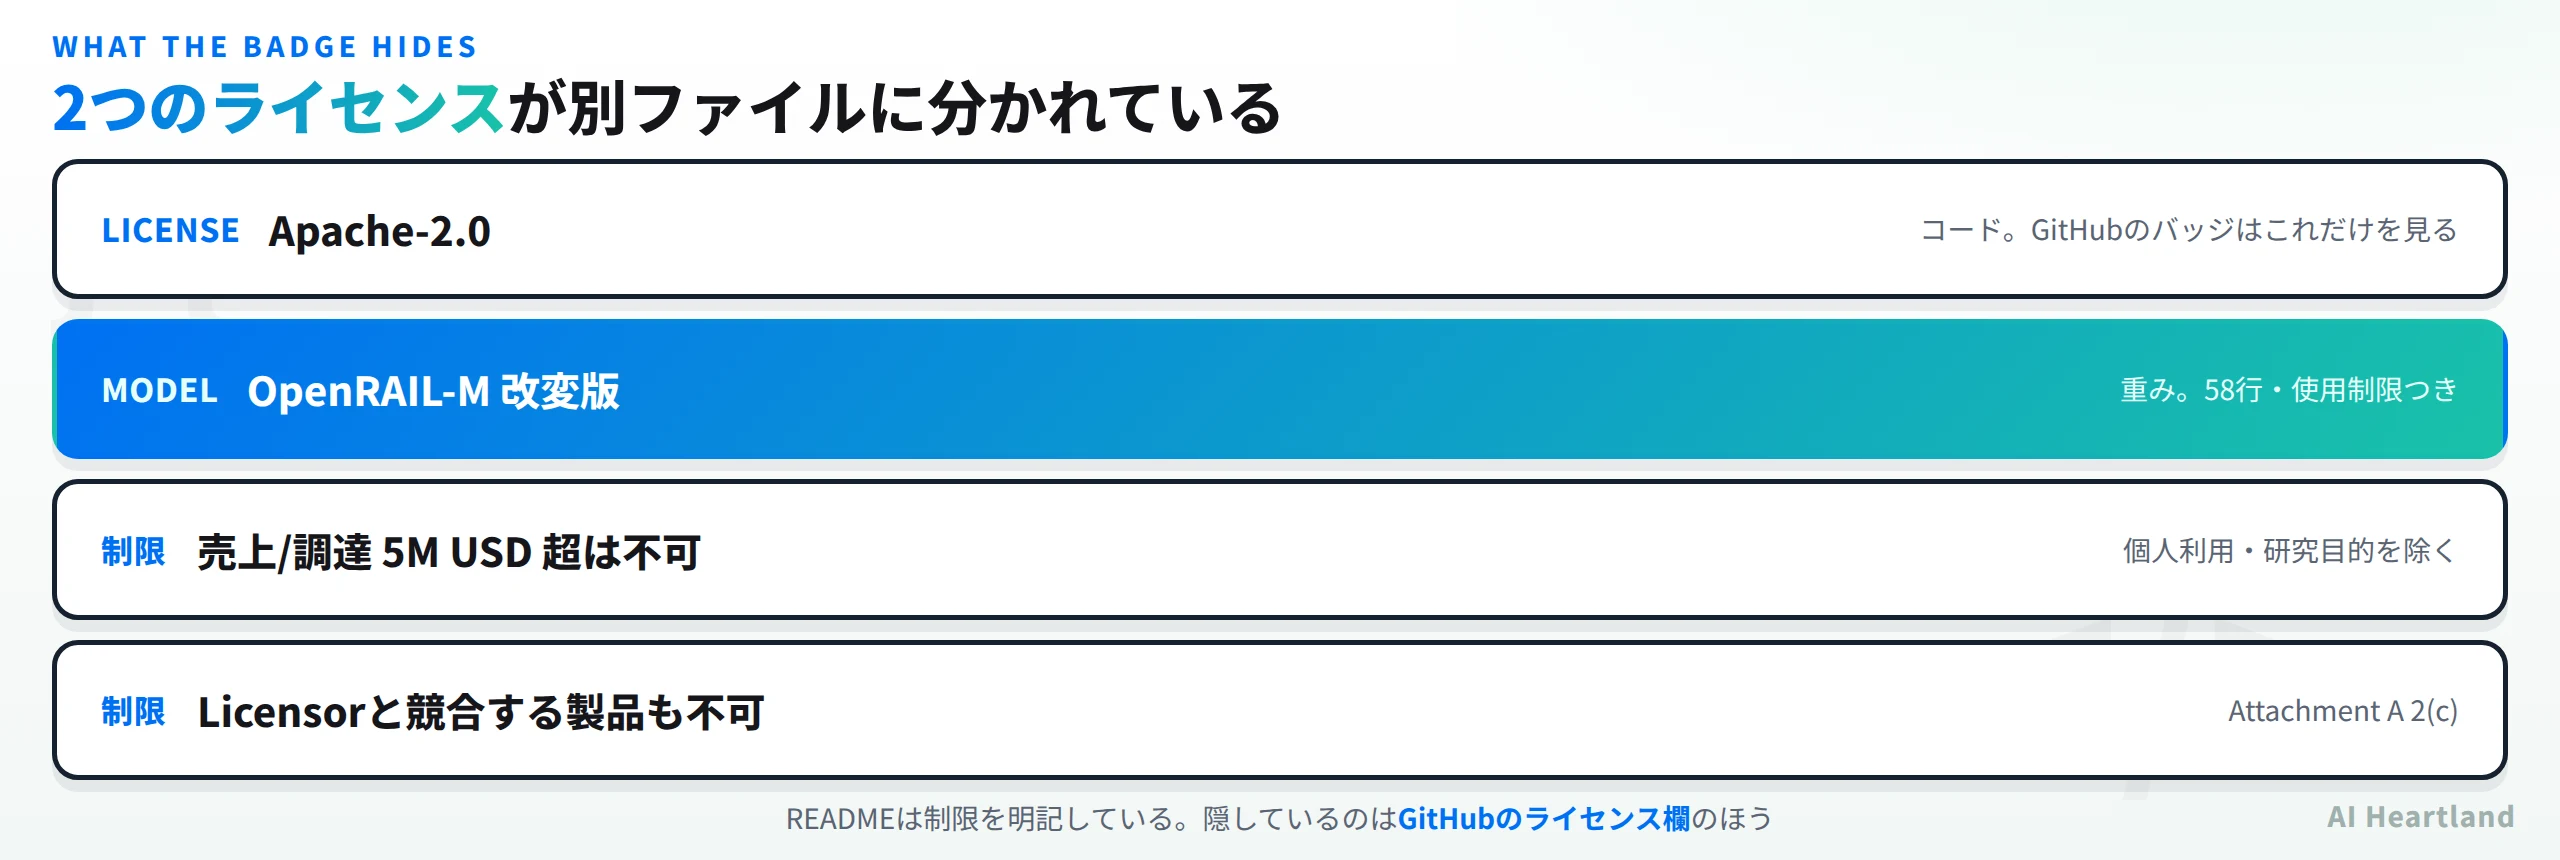
ここで公平を期しておきたい。README は制限を隠していない。# Commercial usage の節にこうある。
This code is Apache 2.0, and our model weights use a modified OpenRAIL-M license (free for research, personal use, and startups under $5M funding/revenue, cannot be used competitively with our API).
一文で正確に書かれている。問題はプロジェクトの姿勢ではなく、リポジトリ画面のバッジが片方しか見ないという仕組みのほうだ。当サイトで先日7本のOSSのライセンス実体を読んだときも、GitHubが NOASSERTION と出した4本が要確認リストと一致した。lift はその逆で、バッジが素直に Apache-2.0 と出るぶん、かえって見落としやすい。
出力にも条項が及ぶ
もう1点、読んでおいたほうがいい条項がある。第8条の Share-a-Like だ。
- Share-a-Like. … You agree to apply this License (to the exclusion of all others) to any and all copies of the Model, Derivatives of the Model, … and to the Output and any derivatives, changes or improvements to or of the Output.
文面どおりなら、モデルが生成した出力(抽出されたJSON)にもこのライセンスを適用することに同意したことになる。一方で第6条にはこうある。
- The Output You Generate. Except as set forth herein, Licensor claims no rights in the Output You generate using the Model.
6条は「出力に権利を主張しない」、8条は「出力にもこのライセンスを適用せよ」と読め、素直に読むと緊張関係がある。文書抽出は自社の請求書や契約書を通す用途なので、出力の扱いは実務上かなり重い。当記事は法的な結論を出す立場にないので、ここは条文を引くにとどめ、商用で使うなら弁護士に当たるべき箇所として挙げておく。
書いた制約が全部効くわけではない
ライセンスを確認したところで、技術側を測る。GPUも重みもない環境なのでモデルは動かせないが、スキーマの扱いは重みなしで検証できる。
PyPI から入れる。ここで最初につまずいた。
pip install lift-pdf
# ERROR: Could not find a version that satisfies the requirement lift-pdf (from versions: none)
原因は Python のバージョンだった。
ERROR: Ignored the following versions that require a different python version:
0.1.0 Requires-Python >=3.12; 0.1.1 Requires-Python >=3.12
pyproject.toml に requires-python = ">=3.12" とあるが、READMEにはPythonバージョンの記載がない。3.11 で叩くと「そんなパッケージはない」という紛らわしいメッセージになるので、ここは最初に知っておきたい。3.12 で入れ直すと21秒・25パッケージ・88MBだった。
パッケージには schema_builder モジュールがあり、validate_schema が公開されている。README の「schema-constrained decoding guaranteeing valid output」が何を受け付けるのかを、ここで試せる。
最初のテストは間違っていた
正直に書いておくと、1回目の計測は無効だった。validate_schema を例外ベースだと思い込んで try/except で囲んだところ、16ケース全部が「通過」した。
受理 16 / 拒否 0(計16)
陰性対照が1つも落ちないのは、検証器が効いていない証拠だ。実装を読むと答えが出た。
def validate_schema(schema: dict) -> str | None:
    """Validate the schema the same way the vLLM path does. Returns an error message or None."""
例外ではなくエラー文字列を返す。try/except では何も捕まらないので、全部が緑に見えていただけだった。戻り値を見る形に直して測り直した。
_UNSUPPORTED_KEYS と実際の挙動が合わない
ソースにはこんな定数がある。
_UNSUPPORTED_KEYS = ('enum', 'anyOf', 'oneOf', 'allOf', '$ref',
                     'additionalProperties', 'patternProperties')
7つのキーが「ビルダーは対応しない」と宣言されている。では渡すとどうなるのか。検証を通るかと、生成されたモデルに残るかを分けて測った。
| キー | validate_schema |
生成モデルに残るか | 制約は効くか |
|---|---|---|---|
enum |
通る | 残る | 効く(範囲外を拒否) |
anyOf |
通る | 残る | — |
pattern(対照群) |
通る | 残る | 効く |
oneOf |
通る | 消える | — |
allOf |
通る | 消える | — |
$ref |
通る | 消える | — |
additionalProperties |
通る | 消える | — |
重要な点が2つある。
1つめ。7キーのどれも validate_schema では弾かれない。「対応しない」と宣言されているのに、検証は何も言わずに通る。
2つめ。その先で挙動が割れる。enum は実際に保持され、範囲外の値を入れると ValidationError になる(正常値は通る、という陽性対照も取った)。一方 oneOf・allOf・$ref・additionalProperties は生成されたモデルから警告なしに消える。
型を宣言して出力を縛るという発想自体は、Clefとは|Cloudflareの決定モデルの「Jev互換」を両側のJSONを生成して突き合わせたで見た決定モデルと同じ系譜にある。ただし Clef が3種類の固定した質問型しか受け付けないのに対し、lift は任意のJSON Schemaを受け取る構えなので、どこまで本当に効くのかを自分で確かめる必要が出てくる。
実務的な含意ははっきりしている。$ref で共通定義を切り出したスキーマを渡すと、参照が解決されないまま落ちる。oneOf で「請求書か領収書か」を表現しても、その分岐は効かない。しかも検証はパスするので、気づく機会が実行結果しかない。
逆に enum が効くのは朗報で、分類フィールドを固定値に縛るという一番よく使う形は使える。請求書の「通貨」を ["JPY","USD","EUR"] に限定する、といった指定は意図どおり効く。
対処としては、スキーマを渡す前に平坦化しておくのが現実的だ。$ref は参照先を展開して書き下す、oneOf の分岐は別フィールド(document_type を enum にする)に置き換える、といった変換で、効く範囲に収められる。json-schema-to-pydantic が依存に入っているので内部でPydanticモデルに変換しているが、その変換で落ちる前に自分で潰しておく、という考え方になる。
なお patternProperties は _UNSUPPORTED_KEYS に入っているものの、当記事では単独のテストケースを作っていない。上の表の7行目(additionalProperties)までが実測で、patternProperties は未検証である。
なお、ここでも私は最初に誤った推測をしかけた。_UNSUPPORTED_KEYS に enum があるのを見て「enum は黙って落ちる」と書きかけたが、実際に生成モデルへ値を入れて確かめたら保持されていた。宣言と挙動が食い違うときは、宣言のほうを信じてはいけないという例になった。
同梱物から分かる使い方
重みは動かせないが、パッケージの中身からは運用の形が読める。lift-pdf を入れると入口が3つ用意される。
| コマンド | 役割 |
|---|---|
lift_extract |
単一ファイル/ディレクトリの抽出CLI |
lift_vllm |
vLLM サーバの起動ラッパー |
lift_app |
Schema Studio(スキーマを作るGUI)の起動 |
既定値は lift.settings にある。
MODEL_CHECKPOINT  = 'datalab-to/lift'   # Hugging Face のリポジトリ
VLLM_MODEL_NAME   = 'lift'
MAX_OUTPUT_TOKENS = 12384
出力トークンの上限が 12,384 に設定されているのが目を引く。抽出対象が64ページの文書まで想定されていることを考えると、1文書ぶんのJSONをこの範囲に収める前提だ。フィールド数が多いスキーマを渡すときは、ここが天井になりうる。
バックエンドは2通りある。README が「recommended, lightweight install」と呼ぶのは vLLM 側で、torch を直接入れずに済む。ローカルでLLMを立てる土台の選び方はDistributed Llama:家庭用デバイスを繋ぐだけでLLMローカル実行を高速化する分散フレームワークでも扱ったが、lift は9Bなので単一GPUに載る前提の構成になっている。HuggingFace バックエンドは pip install lift-pdf[hf] で torch 込みになる。素の pip install lift-pdf は25パッケージ・88MBで、推論エンジンを含まない薄い構成だった。モデル本体(9B)は別途ダウンロードされる。
lift.schema_builder には rows_to_schema と schema_to_rows という対になる関数もある。Schema Studio が「表形式でフィールドを並べる UI」と「JSON Schema」を相互変換するためのものだろう。スキーマを書くこと自体を支援する設計になっているのは、この手のツールでは効く。スキーマが書けないと何も始まらないからだ。
ただし前節で見たとおり、その JSON Schema のうち効くのは一部だけである。GUIで組み立てたスキーマがそのまま通る保証はないので、$ref を含む構造をエクスポートした場合は実行結果で確かめたほうがよい。
フィールド精度90%は文書精度20%とセットで読む
READMEのベンチマークは条件が明記されていて読みやすい。225文書(6〜64ページ)、約11,000フィールド、決定的な完全一致採点、全モデルに同じページ画像を渡し1パスで抽出。
| モデル | サイズ | フィールド精度 | 文書全体精度 | 中央値レイテンシ |
|---|---|---|---|---|
| Datalab API | — | 95.9% | 44.4% | 30.8s |
| Gemini Flash 3.5 | — | 91.3% | 40.0% | 28.1s |
| lift | 9B | 90.2% | 20.9% | 9.5s |
| Azure Content Understanding | — | 83.4% | 22.2% | 73.7s |
| NuExtract3 | 4B | 81.5% | 8.4% | 8.3s |
| Qwen3.5-9B | 9B | 76.3% | 24.0% | 16.8s |
9Bでフィールド精度90.2%、しかも最速というのは素直に強い。だが同じ行の文書全体精度は20.9%だ。
ここで気づく点がある。lift はフィールド精度で Qwen3.5-9B を14ポイント上回るのに、文書全体精度では下回っている(20.9% 対 24.0%)。
この差が何を意味するのか、簡単な計算で確かめられる。1文書あたりのフィールド数は 11,000 ÷ 225 ≈ 48.9。誤りが独立に起きるなら、文書全体精度は 0.902^48.9 になるはずだ。
| モデル | フィールド精度 | 文書全体(実測) | 独立仮定の予測 | 実測/予測 |
|---|---|---|---|---|
| Datalab API | 95.9% | 44.4% | 12.9% | 3倍 |
| Gemini Flash 3.5 | 91.3% | 40.0% | 1.2% | 34倍 |
| lift | 90.2% | 20.9% | 0.65% | 32倍 |
| Qwen3.5-9B | 76.3% | 24.0% | ほぼ0% | 桁違い |
全モデルで実測が予測を大きく上回る。つまり誤りは独立ではなく、一部の難しい文書に集中している。READMEが「cross-page values, exhaustive lists, fields that must be left null, near-miss distractors」といった敵対的ケースを仕込んだと書いているのと整合する。
実務的には、どちらの指標を見るかは人間のレビュー単位で決まる。フィールド単位で確認・修正する運用ならフィールド精度90.2%が効く。文書を丸ごと受理/却下する運用なら、5文書に1文書しか自動で通らない。lift を選ぶか Qwen3.5-9B を選ぶかが、この一点で逆転しうる。
lift 90.2%"] B -- "文書ごとに受理/却下" --> D["文書全体精度を見る
lift 20.9%"] C --> E["liftが有利"] D --> F["Qwen3.5-9B が上回る
24.0%"] E --> G["レビュー工数で費用対効果を出す"] F --> G
同じ組織の Marker・Surya とどう使い分けるか
datalab.to は文書処理のOSSをいくつか出している。lift を検討するなら、同じ組織の既存プロジェクトとの関係を整理しておくと判断が早い。
・Surya — OCR・レイアウト検出・読み順推定。ページから「どこに何が書かれているか」を取り出す
・Marker — PDF → Markdown。文書を丸ごと読みやすい形に変換する
・lift — PDF → スキーマ準拠JSON。「請求書番号」「合計金額」のように欲しい項目を指定して抜く
つまり縦に並ぶものではなく、出口の形が違う。全文が欲しいなら Marker、座標や構造が欲しいなら Surya、決まった項目だけを型つきで欲しいなら lift という分かれ方になる。lift の pyproject.toml の依存を見ると pypdfium2 でページを画像化しており、Surya のようなレイアウト解析を挟まずにページ画像をそのままビジョンモデルに渡す構成だった。READMEの「All models receive the same rendered page images」という注記とも一致する。
この設計は実務で効く面と効かない面がある。レイアウト解析を挟まないぶんパイプラインが短く、9Bで9.5秒という速さにつながっている。一方で、抽出できるのはスキーマに書いた項目だけなので、「とりあえず全部取っておいて後で考える」という使い方には向かない。何を抜くかが先に決まっている業務——請求書処理、申込書のデータ化、契約書の条項抽出——が素直な適用先になる。
なお、ライセンスの制限が効くのは lift の重みであって、Marker や Surya には別の条件が設定されている。同じ組織のOSSだからといって条件が同じとは限らないので、組み合わせて使うならそれぞれの実体ファイルを開く必要がある。本記事では lift の MODEL_LICENSE のみを確認しており、他2つは未確認である。
PDF 構造化抽出に lift を入れるかの判断材料
向いている場面
・個人利用・研究、または売上と調達がどちらも5M USD 以下の組織
・フィールド単位でレビューする運用。90.2%なら修正箇所を絞り込める
・レイテンシが効く用途。9.5秒は表の中で2番目に速く、API勢の3分の1
・スキーマが enum と素直な型で書ける場合
避けたほうがよい場面
・売上または調達が5M USD を超える企業。重みのライセンスで明確に不可
・Datalab と競合するサービスを提供している場合(同上)
・$ref や oneOf を多用した複雑なスキーマ。黙って落ちる
・文書を丸ごと自動受理したい用途。20.9%では人が外せない
当記事で測っていないこと
・モデルを一度も実行していない。GPUも重みもない環境で、測ったのはパッケージとスキーマ処理だけ
・したがって精度・レイテンシは当記事の実測値ではなく、すべてREADME記載値
・vLLM バックエンドも HuggingFace バックエンドも起動していない
・Schema Studio(同梱のGUI)も未起動
・独立仮定との比較は、1文書あたりのフィールド数を平均値(48.9)で代表させた概算である。文書ごとのフィールド数分布は公開されていない
・patternProperties の挙動は未検証(他6キーは実測)
・Marker・Surya のライセンス条件は確認していない
判定の順番としては、ライセンス → スキーマ → 精度の順に見るのが効率的だと思う。売上が5M USD を超える組織なら最初の時点で終わるし、スキーマに $ref が必須ならそこで止まる。精度の議論まで進める条件が揃っている組織のほうが、むしろ少ないかもしれない。
最終コミットが 2026-06-19 で3か月半動いていない点も触れておく。lift-pdf は 0.1.1 が最新で、タグは2本。活発に開発中のプロジェクトではないので、採用するなら自分でメンテする前提のほうが安全だろう。
参照ソース
・datalab-to/lift(⭐983・コードは Apache-2.0・2026-10-04時点)
・MODEL_LICENSE(AI PUBS OPEN RAIL-M LICENSE 改変版)(58行・Attachment A に使用制限)
・lift-pdf — PyPI(0.1.1・requires-python >=3.12)
本記事の計測レコードは data/measurements/runs/2026-10-04-lift-pdf-extraction.json に登録した。