Pydantic AI は、Pydantic を作っているチームが開発している Python向けのAIエージェントSDKだ。MIT、⭐20,352(2026-10-02時点)、最新は 2.53.0(タグ数338)。「型で端から端までつなぐ」を掲げていて、エージェントループ・ツール呼び出し・構造化出力が中心にある。評価するうえで一番うれしかったのは、APIキーを1本も用意せずに往復を丸ごと再現できることだった。
- ・Pydanticチーム製のPython AIエージェントSDK。MIT・⭐20,352・最新 **2.53.0**(タグ338本)
- ・**APIキー0本で往復が再現できる**。`TestModel` で型つき出力もツール呼び出しも成立
- ・**既知のモデル文字列は744件・プロバイダ接頭辞26種**(openai 87・anthropic 19)
- ・別パッケージ `pydantic-ai-harness` に **61の capability**(memory・planning・guardrails ほか)
- ・`pip install` は約1分・`.venv` 252MB・106パッケージ
- ・実行のたびに**自社SaaSの案内バナー**が出るが、**stderr** なので stdout は汚れない
フレームワークの選び方全体はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその枝として、「鍵を入れる前にどこまで確かめられるか」という一点を掘る。
Pydantic AIとは:型を先に決めてからモデルを選ぶ
READMEの位置づけは「The Python AI SDK」だ。中心にあるのは型つきの agent loop で、モデルは文字列1つで差し替えられる、という設計になっている。同じエージェントが Web フロントエンドの裏でも、ターミナルでも、音声通話でも、永続キューでも、GitHub Actions の中でも、ただの run() を呼ぶオブジェクトとしても動く——というのが売り文句だ。
実際に動かすと、売り文句の「型つき」が何を指すのかがすぐ分かる。
from pydantic import BaseModel
from pydantic_ai import Agent
from pydantic_ai.models.test import TestModel

class Support(BaseModel):
    advice: str
    risk: int
    block_card: bool

agent = Agent(TestModel(), output_type=Support,
              instructions="銀行のサポート担当として答える")
r = agent.run_sync("カードを無くしました")
print(type(r.output).__name__, r.output, r.usage)
# Support advice='a' risk=0 block_card=False
# RunUsage(input_tokens=51, output_tokens=8, requests=1)
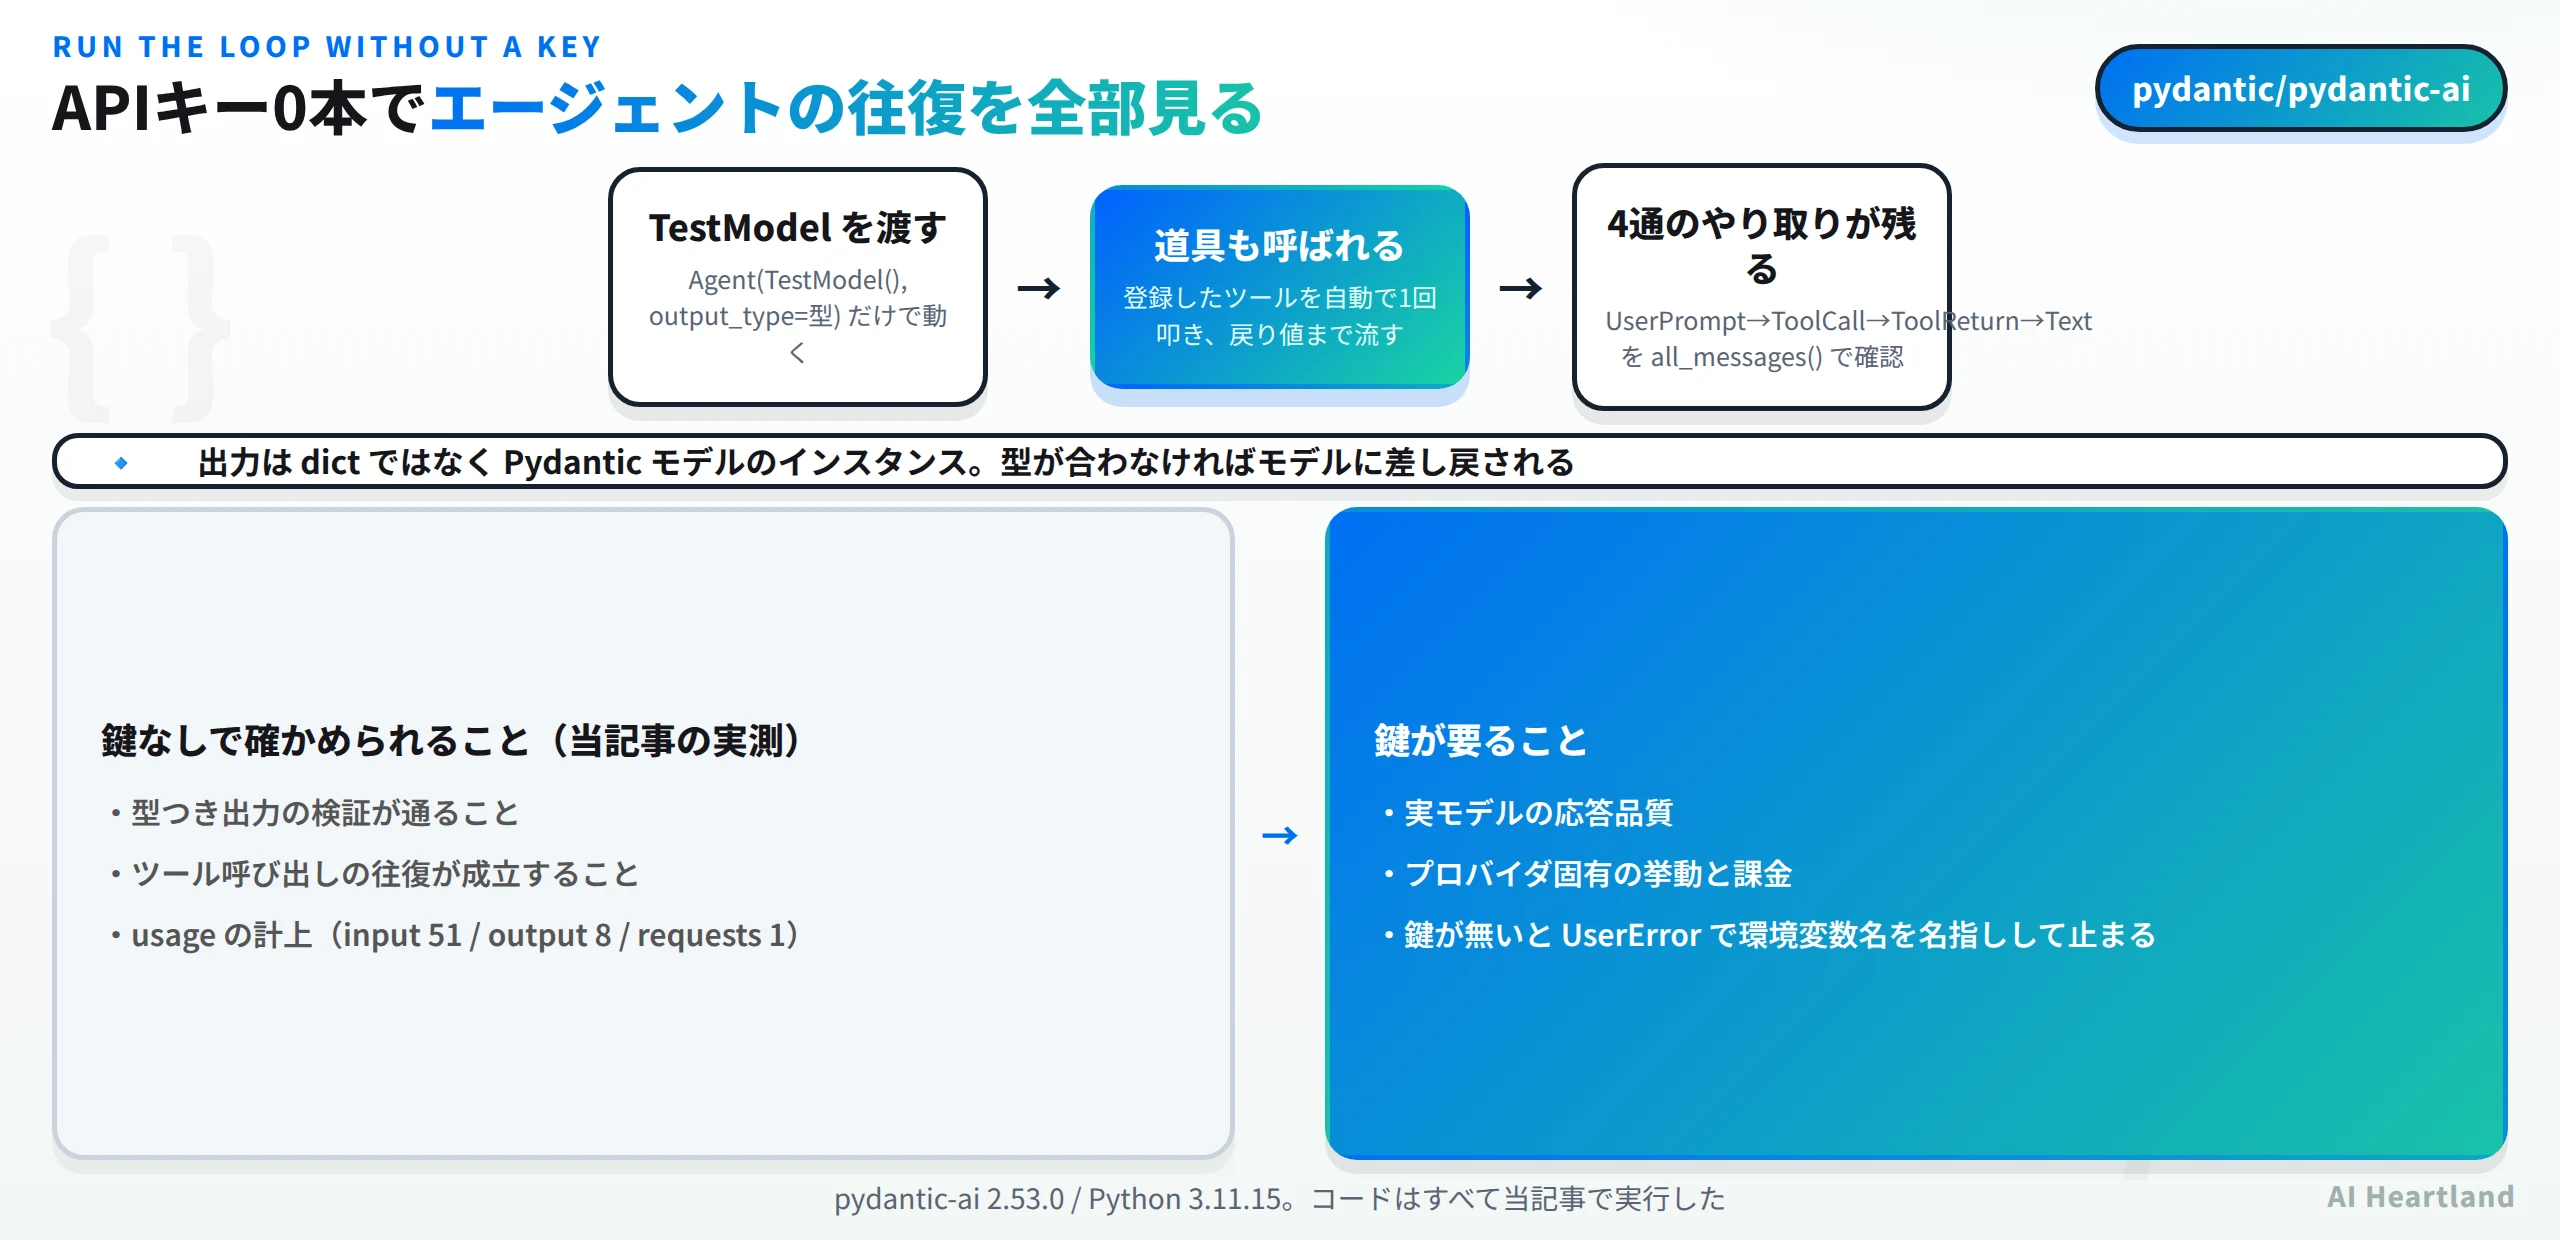
返ってくるのは辞書ではなく Support のインスタンスだ。output_type に渡した Pydantic モデルがそのまま契約になり、モデルの出力が型に合わなければ差し戻される。LLMの出力を自前で json.loads して KeyError に怯える、という工程が消える。
ここで使った TestModel が本題だ。これは実モデルを呼ばずに、スキーマから適当な値を埋めて返すテスト用のモデル実装で、APIキーも通信も要らない。上の実行でも usage はきちんと計上され(input 51 / output 8 / requests 1)、本番と同じ経路を通っていることが分かる。
生態系は広い。pydantic-ai 本体のほかに、型つき制御フローの pydantic-graph、pytest のようにエージェントの振る舞いを試す pydantic-evals、そして長時間作業用の pydantic-ai-harness が同じバージョン系列(2.53.0 / harness は 0.53.0)で並ぶ。可観測性は OpenTelemetry で、同社の Logfire に限らず任意のバックエンドに流せる。
鍵なしでツール呼び出しの往復まで見る
型つき出力が通るのは分かった。では道具を持たせた場合はどうか。TestModel は登録されたツールを自動で1回呼ぶので、ループ全体を鍵なしで観察できる。
import os
os.environ['PYDANTIC_AI_NO_BANNER'] = '1'
from pydantic_ai import Agent
from pydantic_ai.models.test import TestModel

agent = Agent(TestModel(), instructions="天気を聞かれたら必ず道具を使う")
calls = []

@agent.tool_plain
def get_weather(city: str) -> str:
    """都市の天気を返す"""
    calls.append(city)
    return f"{city} は晴れ"

r = agent.run_sync("東京の天気は?")
print("ツール呼び出し:", calls)
for m in r.all_messages():
    print(type(m).__name__, [type(p).__name__ for p in m.parts])
実行結果はこうなった。
ツール呼び出し: ['a']
ModelRequest  ['UserPromptPart']
ModelResponse ['ToolCallPart']
ModelRequest  ['ToolReturnPart']
ModelResponse ['TextPart']
4通のやり取りが全部残る。ユーザーの発話 → モデルのツール呼び出し → ツールの戻り値 → 最終応答、という順序がそのまま確認でき、calls にはツール本体が実際に呼ばれた記録が入っている(引数の 'a' は TestModel が型から生成したダミー値)。
この往復を図にすると、どこが鍵なしで動き、どこから先が実モデル任せなのかがはっきりする。
引数は型から自動生成"] M -->|"実モデル: 鍵が要る"| T1 T1 --> F["登録したPython関数を実行
tool_plain / tool"] F --> R["戻り値をモデルに返す"] R --> O["最終応答を output_type で検証"] O -->|"型が合う"| OK["Pydanticモデルのインスタンス"] O -->|"型が合わない"| M OK --> USG["RunUsage に入出力トークンと回数が残る"]
点線の分岐に見えるところ——ツールの定義、引数のスキーマ、戻り値の受け渡し、出力型の検証——はすべて鍵なしで確かめられる。実モデルに委ねるのは「どのツールをいつ呼ぶか」という判断だけだ。
これが効くのは、採用判断の段階で確かめたいことの大半が、実モデルの賢さではないからだ。ツールのスキーマが意図どおりに出ているか、出力型が厳しすぎないか、ツールの戻り値がちゃんとモデルに返るか——このあたりは鍵も課金も無しで潰せる。12-Factor Agents完全解説:本番投入できるLLMエージェント設計12原則を一次ソースで読むが説く「エージェントを普通のソフトウェアとしてテストせよ」という原則を、SDK側が仕組みとして用意している形だ。
ちなみに鍵が必要な場面での落ち方も素直だった。
Agent('openai:gpt-5').run_sync('hi')
# UserError: Set the `OPENAI_API_KEY` environment variable or pass it
#            via `OpenAIProvider(api_key=...)` to use the OpenAI provider.
401 やスタックトレースではなく、どの環境変数を入れればよいかを名指しする UserError で止まる。
「どのモデルも文字列1つ」を数えて確かめる
READMEは「every model a string swap away」と書く。これは数えられる主張なので、数えた。
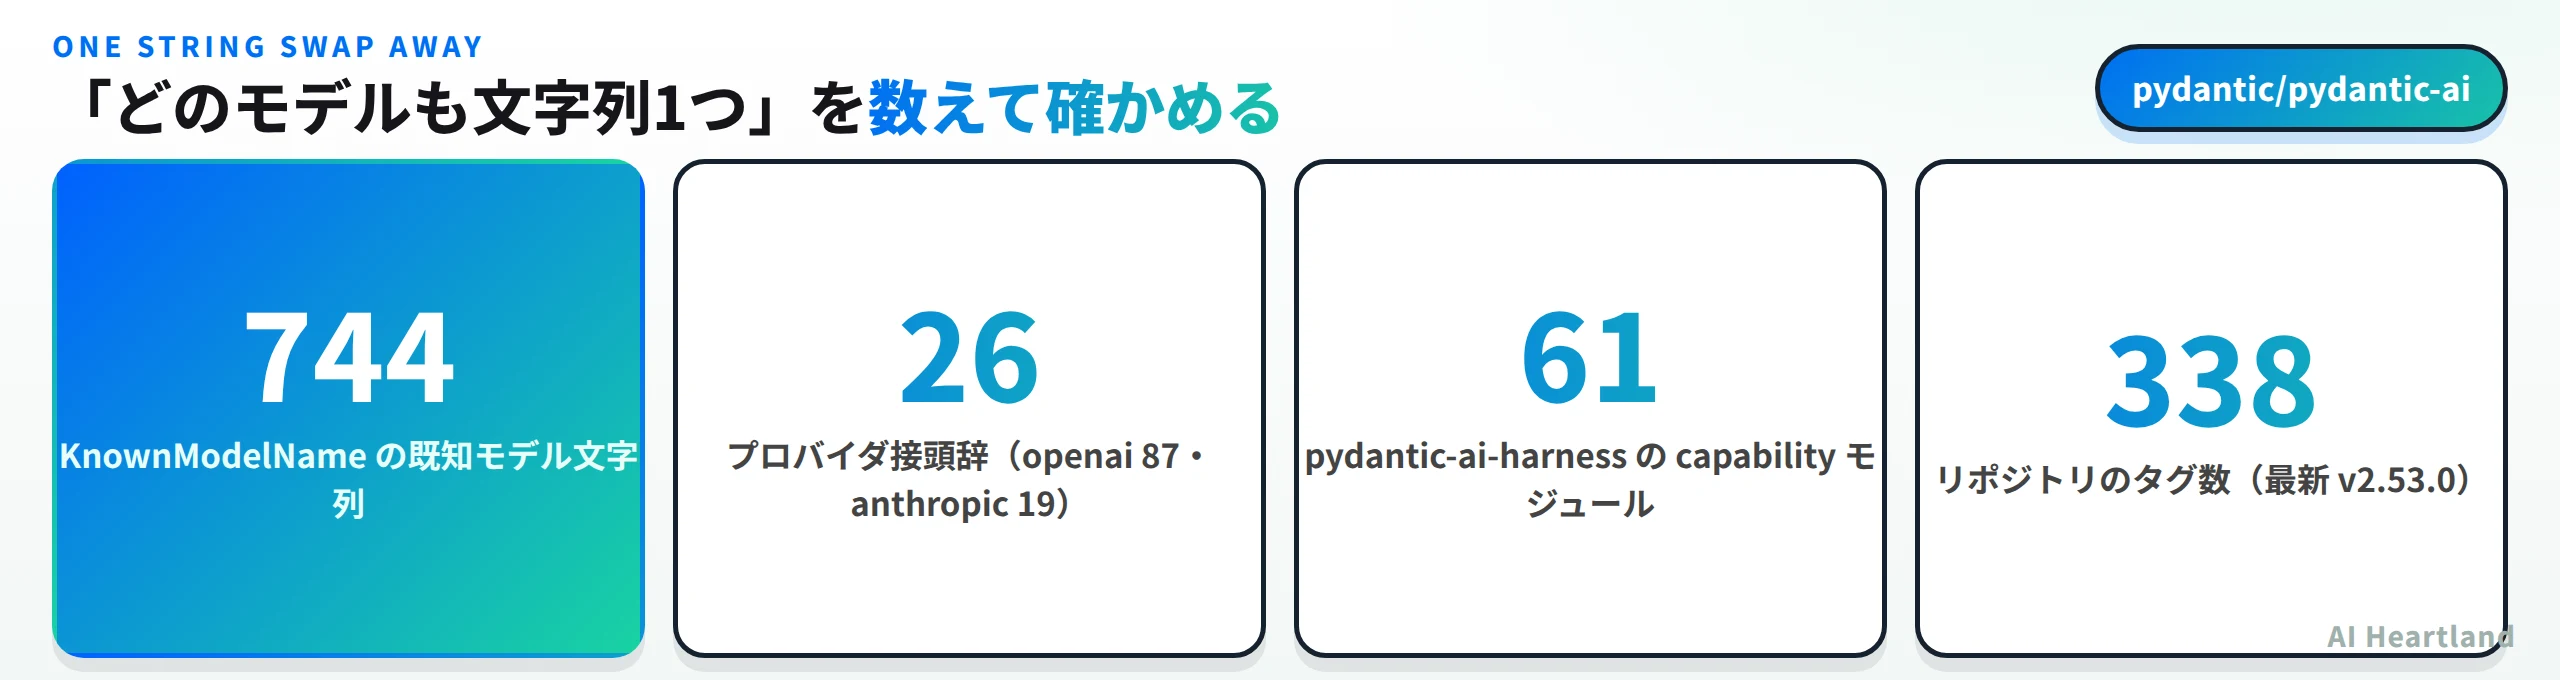
KnownModelName に列挙された文字列は 744件、プロバイダ接頭辞は 26種だった。内訳は openai が87件、anthropic が19件。接頭辞には bedrock / google / groq / mistral / cohere / deepseek / xai / moonshotai / zai / cerebras / huggingface といった顔ぶれに加え、gateway/openai のように同社の AI Gateway 経由を示すものも並ぶ。
目を引いたのは typesafe:jev-latest と typesafe:jev-preview だ。当サイトで繰り返し扱っているJevとは|文章を返さないSystem Oneモデルの正体を公式SDKのコードで実測し、Claude Codeで試すの判定モデルが、文字列1つで差し替えられる対象として最初から入っている。「文章を生成せず型つきの判定だけを返すモデル」と「型つき出力を前提にしたSDK」は相性がよく、ここが繋がっているのは理にかなっている。
接頭辞に gateway/openai gateway/anthropic gateway/google gateway/bedrock gateway/groq の5つが並んでいるのも設計として分かりやすい。同社の AI Gateway を挟むかどうかが、プロバイダ名の前に1語足すかどうかで表現されている。鍵を1本にまとめたい、支出を監視したいといった要求が、コードの書き換えではなく文字列の変更になる。Gateway は自前ホストもできると README に書かれている(未検証)。
数え方は次のとおりで、同じ手順で読者も再現できる。
import typing
from pydantic_ai.models import KnownModelName
names = typing.get_args(KnownModelName.__value__)
print(len(names), len({n.split(':')[0] for n in names if ':' in n}))
# 744 26
導入コストも測っておいた。空の venv に pip install pydantic-ai を実行して 約1分(1m1.7s)、.venv は 252MB、インストールされたパッケージは 106件。pydantic-ai-harness を足すと260MBになる。重いと感じるかは用途次第だが、音声も画像生成も埋め込みも同梱していることを考えれば妥当な範囲だろう。
どこまでを自分で書き、どこから先を任せるか
型つき出力を前提にすると、設計の順番が変わる。先に「エージェントに何を返させたいか」を Pydantic モデルで書き、そのあとでモデルとツールを選ぶ、という順になる。実務で効くのは次の3点だった。
・出力の契約を先に固定できる。output_type に渡した型が通らなければ差し戻されるので、下流のコードは KeyError を想定しなくてよい
・ツールは普通のPython関数。@agent.tool_plain を付けるだけで、docstring が説明に、型注釈がスキーマになる。別途JSONスキーマを書く工程が無い
・モデルの差し替えが設定値になる。Agent('openai:gpt-5') と Agent('anthropic:claude-opus-5') の違いが文字列1つなので、比較を回しやすい
逆に、型を厳しくしすぎると差し戻しが増えてトークンを食う。risk: int のように値域を書かない型だと、モデルが0〜100のつもりで返しても通ってしまう。型は通し、意味は別で検証するという切り分けが要る点は、他の構造化出力と変わらない。
pydantic-ai-harness:長時間の仕事に要る部品が並ぶ
本体とは別に pydantic-ai-harness(0.53.0)がある。READMEいわく「複雑で長時間の作業にエージェントが必要とするものを capability として snap on する」もの。中身を数えたら、公開サブモジュールが61本あった。
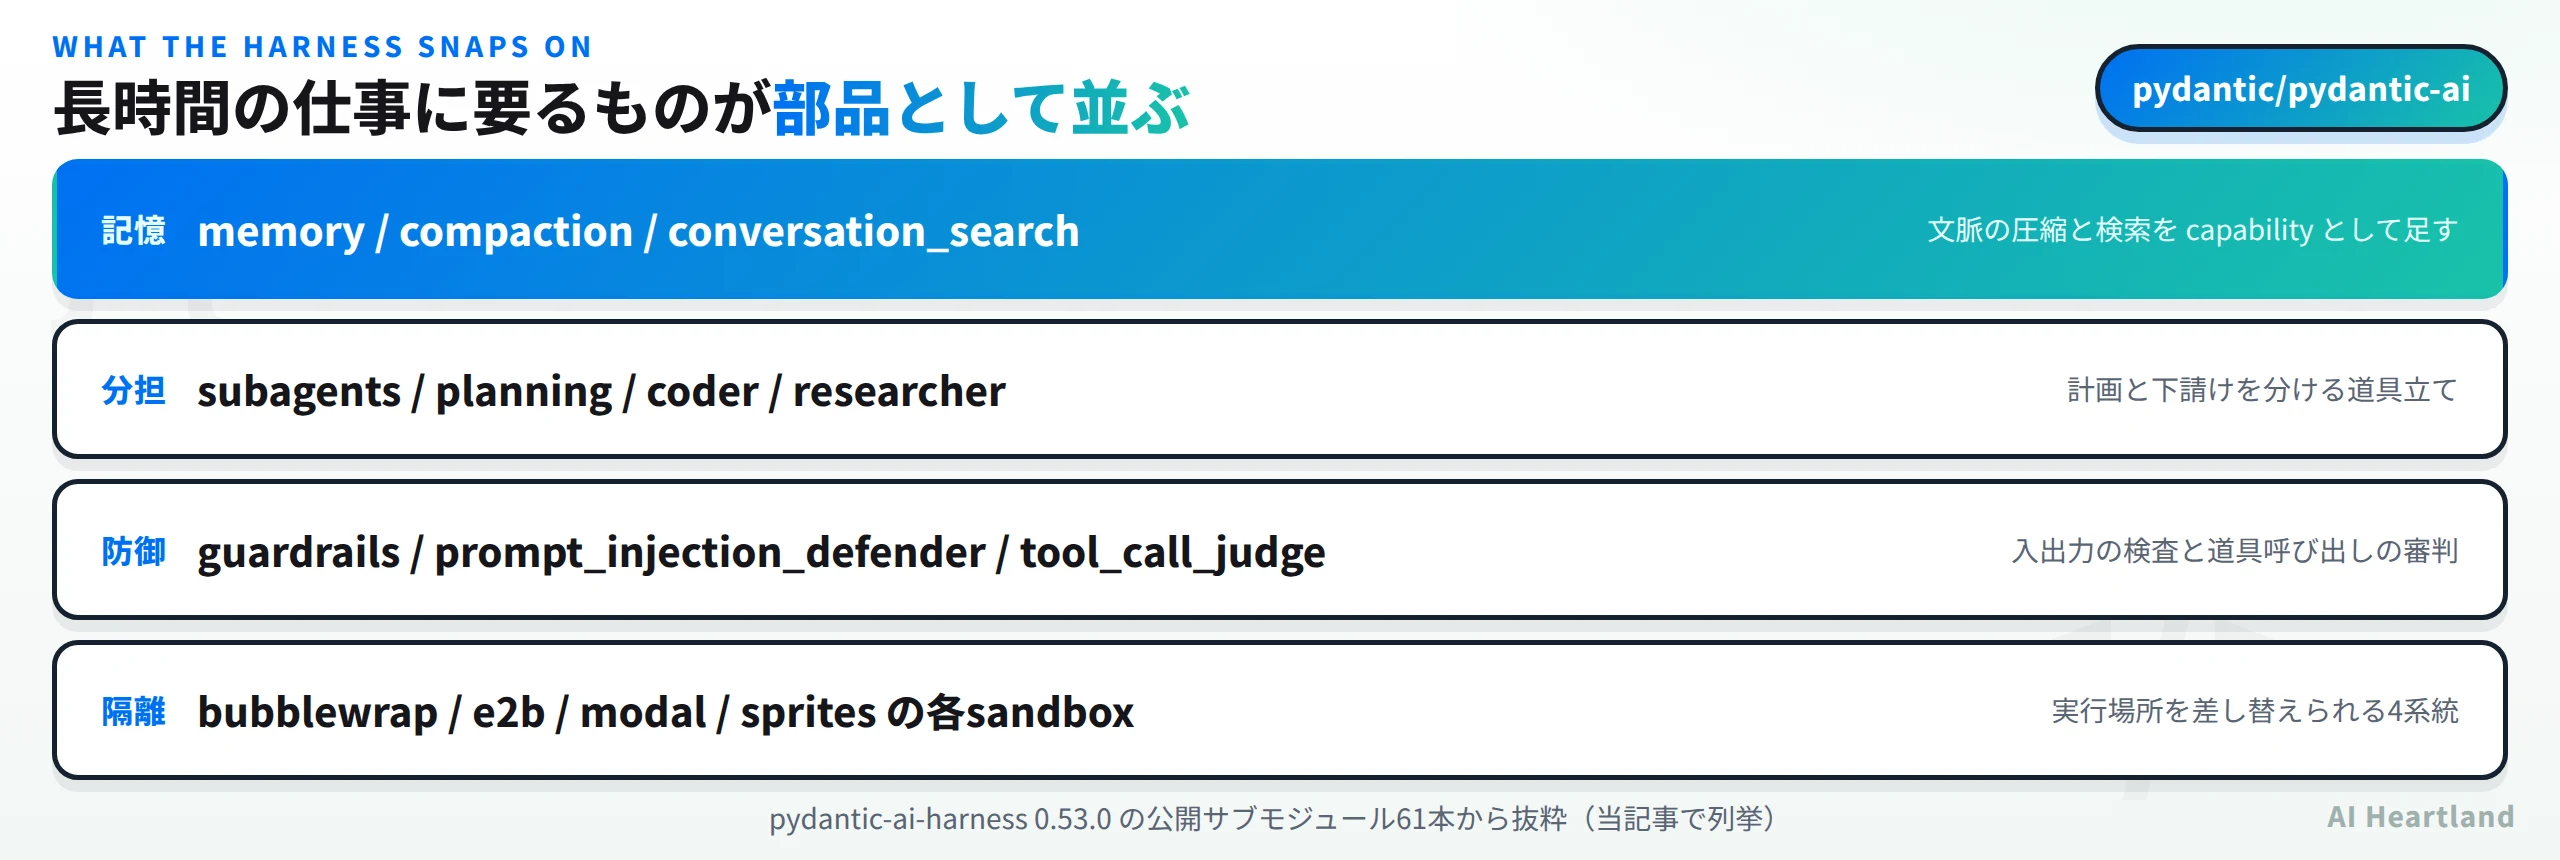
分類すると性格が見える。
・記憶と文脈:memory / compaction / conversation_search / context / overflowing_tool_output
・分担と計画:subagents / planning / coder / researcher / advisor / dynamic_workflow
・防御と審判:guardrails / prompt_injection_defender / tool_call_judge / trajectory_judge / repair_tool_arguments
・隔離:bubblewrap_sandbox / e2b_sandbox / modal_sandbox / sprites_sandbox / ssh_workspace
・連携:github / slack / notion / linear / exa / posthog / google_workspace / stackone
・運用:spend / step_persistence / cache_stability / warn_on_cache_busts / system_reminders
サンドボックスが4系統あって差し替えられるのが実務的だ。prompt_injection_defender と tool_call_judge が標準の部品として並んでいるのも、humanlayer/skillsとは|6スキルの中身とCLAUDE.mdを条件付きに書き換える一本を自サイトで試算で見た「エージェントの暴走を仕組みで止める」という発想と同じ方向にある。skills というモジュールまであり、Agent Skills 形式がフレームワーク側に取り込まれつつあることが分かる。
なお当記事では harness の各 capability を実際に動かしてはいない。インストールしてモジュール構成を数えただけで、個々の挙動は未検証だ。
実行のたびに出るバナーの話
最後に、使っていて一番意見が分かれそうな点に触れておく。何も設定しないと、実行のたびにバナーが出る。
                 pydantic-ai v2.53.0 • Python 3.11.15
      / \
     /   \       agent: agent • model: test:test • output: Support • tools: 0
   /___.___\
  /    |    \    observability: off — see every model and tool call live, with cost
/      |      \    set it up free with Logfire and a GitHub login: ...
`---.._|_..---'    or use any OpenTelemetry backend: ...
AAのスキー場図つきで6行、内容は同社のSaaS(Logfire)の案内を含む。ライブラリが実行ごとに自社サービスを宣伝するのは、受け取り方が分かれるところだろう。
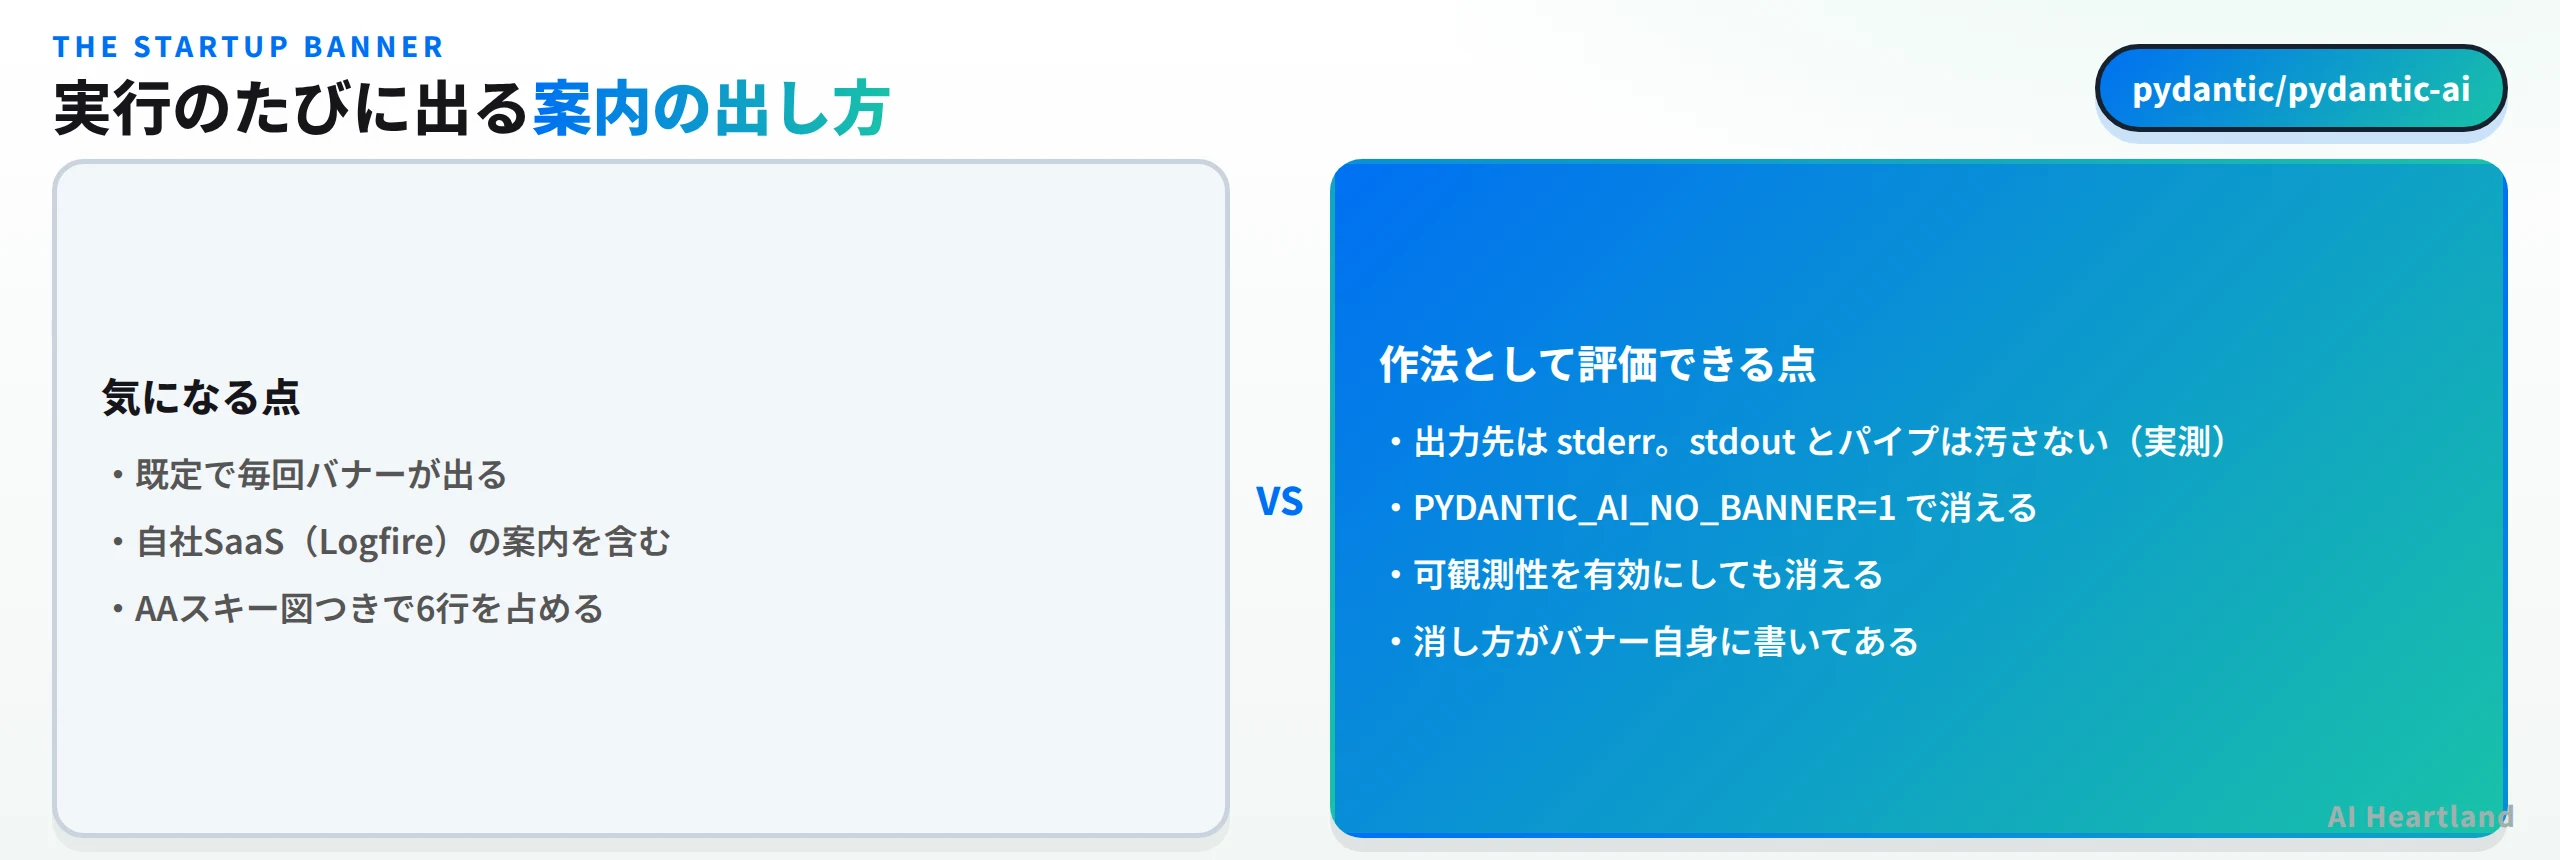
ただし作法としては丁寧だった。実際に stdout と stderr を分けて実行したところ、バナーは stderr にしか出ない。つまりパイプで繋いだり標準出力を取り込んだりする使い方は壊れない。
python t1.py 2>/dev/null        # バナーは消え、結果だけが出る
PYDANTIC_AI_NO_BANNER=1 python t1.py   # そもそも出ない
抑止方法はバナー自身に書かれており、可観測性を有効にしても消える。「黙って標準出力に混ぜる」のが最悪の作法だとすれば、ここはその逆を行っている。スクリプトに組み込むなら PYDANTIC_AI_NO_BANNER=1 を最初に置いておけばよい。
最後に、当記事で確かめた範囲を整理しておく。
| 項目 | 確認方法 | 状態 |
|---|---|---|
| 型つき出力(Pydanticモデルで返る) | TestModel で実行 |
実測 |
| ツール呼び出しの往復4通 | all_messages() を列挙 |
実測 |
| usage の計上 | RunUsage を出力 |
実測 |
| 既知モデル文字列744件・26接頭辞 | KnownModelName を数えた |
実測 |
鍵なし実行時の UserError |
実行 | 実測 |
| インストール規模(約1分・252MB・106件) | pip install を計測 |
実測 |
| harness の capability 61本 | インストールしてサブモジュールを列挙 | 実測 |
| バナーの出力先と抑止 | stdout/stderr を分離して実行 | 実測 |
| 実モデルでの応答品質・コスト | APIキーが無く未実行 | 未検証 |
| harness 各 capability の挙動 | 列挙のみ、実行していない | 未検証 |
| 音声・画像生成・埋め込み | 未実行 | 未検証 |
「鍵を入れないと何も分からない」フレームワークが多いなかで、型と道具の設計だけを先に検証できるのは実務的な強みだった。採用を決める前に半日触ってみる、という使い方に向いている。
参照ソース
・pydantic/pydantic-ai — GitHubリポジトリ(main・最終コミット 6bc07cf・2026-10-01 を clone して確認): https://github.com/pydantic/pydantic-ai
・pydantic-ai — PyPI(2.53.0 を実際にインストールして計測): https://pypi.org/project/pydantic-ai/
・pydantic-ai-harness — PyPI(0.53.0・capability 61本を列挙): https://pypi.org/project/pydantic-ai-harness/
・pydantic/pydantic-ai LICENSE — MIT(Copyright Pydantic Services Inc. 2024 to present): https://github.com/pydantic/pydantic-ai/blob/main/LICENSE