AIエージェント 逆解析——エージェントにバイナリやアプリの中身を調べさせる、という方向の道具が増えている。REA(Reverse Engineer Anything)はその中でも規模が大きいリバースエンジニアリング ツールで、⭐5,336、MIT、CLI と MCP サーバーの両方で動く。
この種の道具で最初に気になるのは機能の多さではない。エージェントに渡したとき、何が勝手に起きるのかだ。プロセスを起動するのか、ネットワークに出るのか、解析対象のファイルを書き換えてしまわないか。REA はそこを機械可読で宣言しているので、宣言どおりかを数えて確かめた。
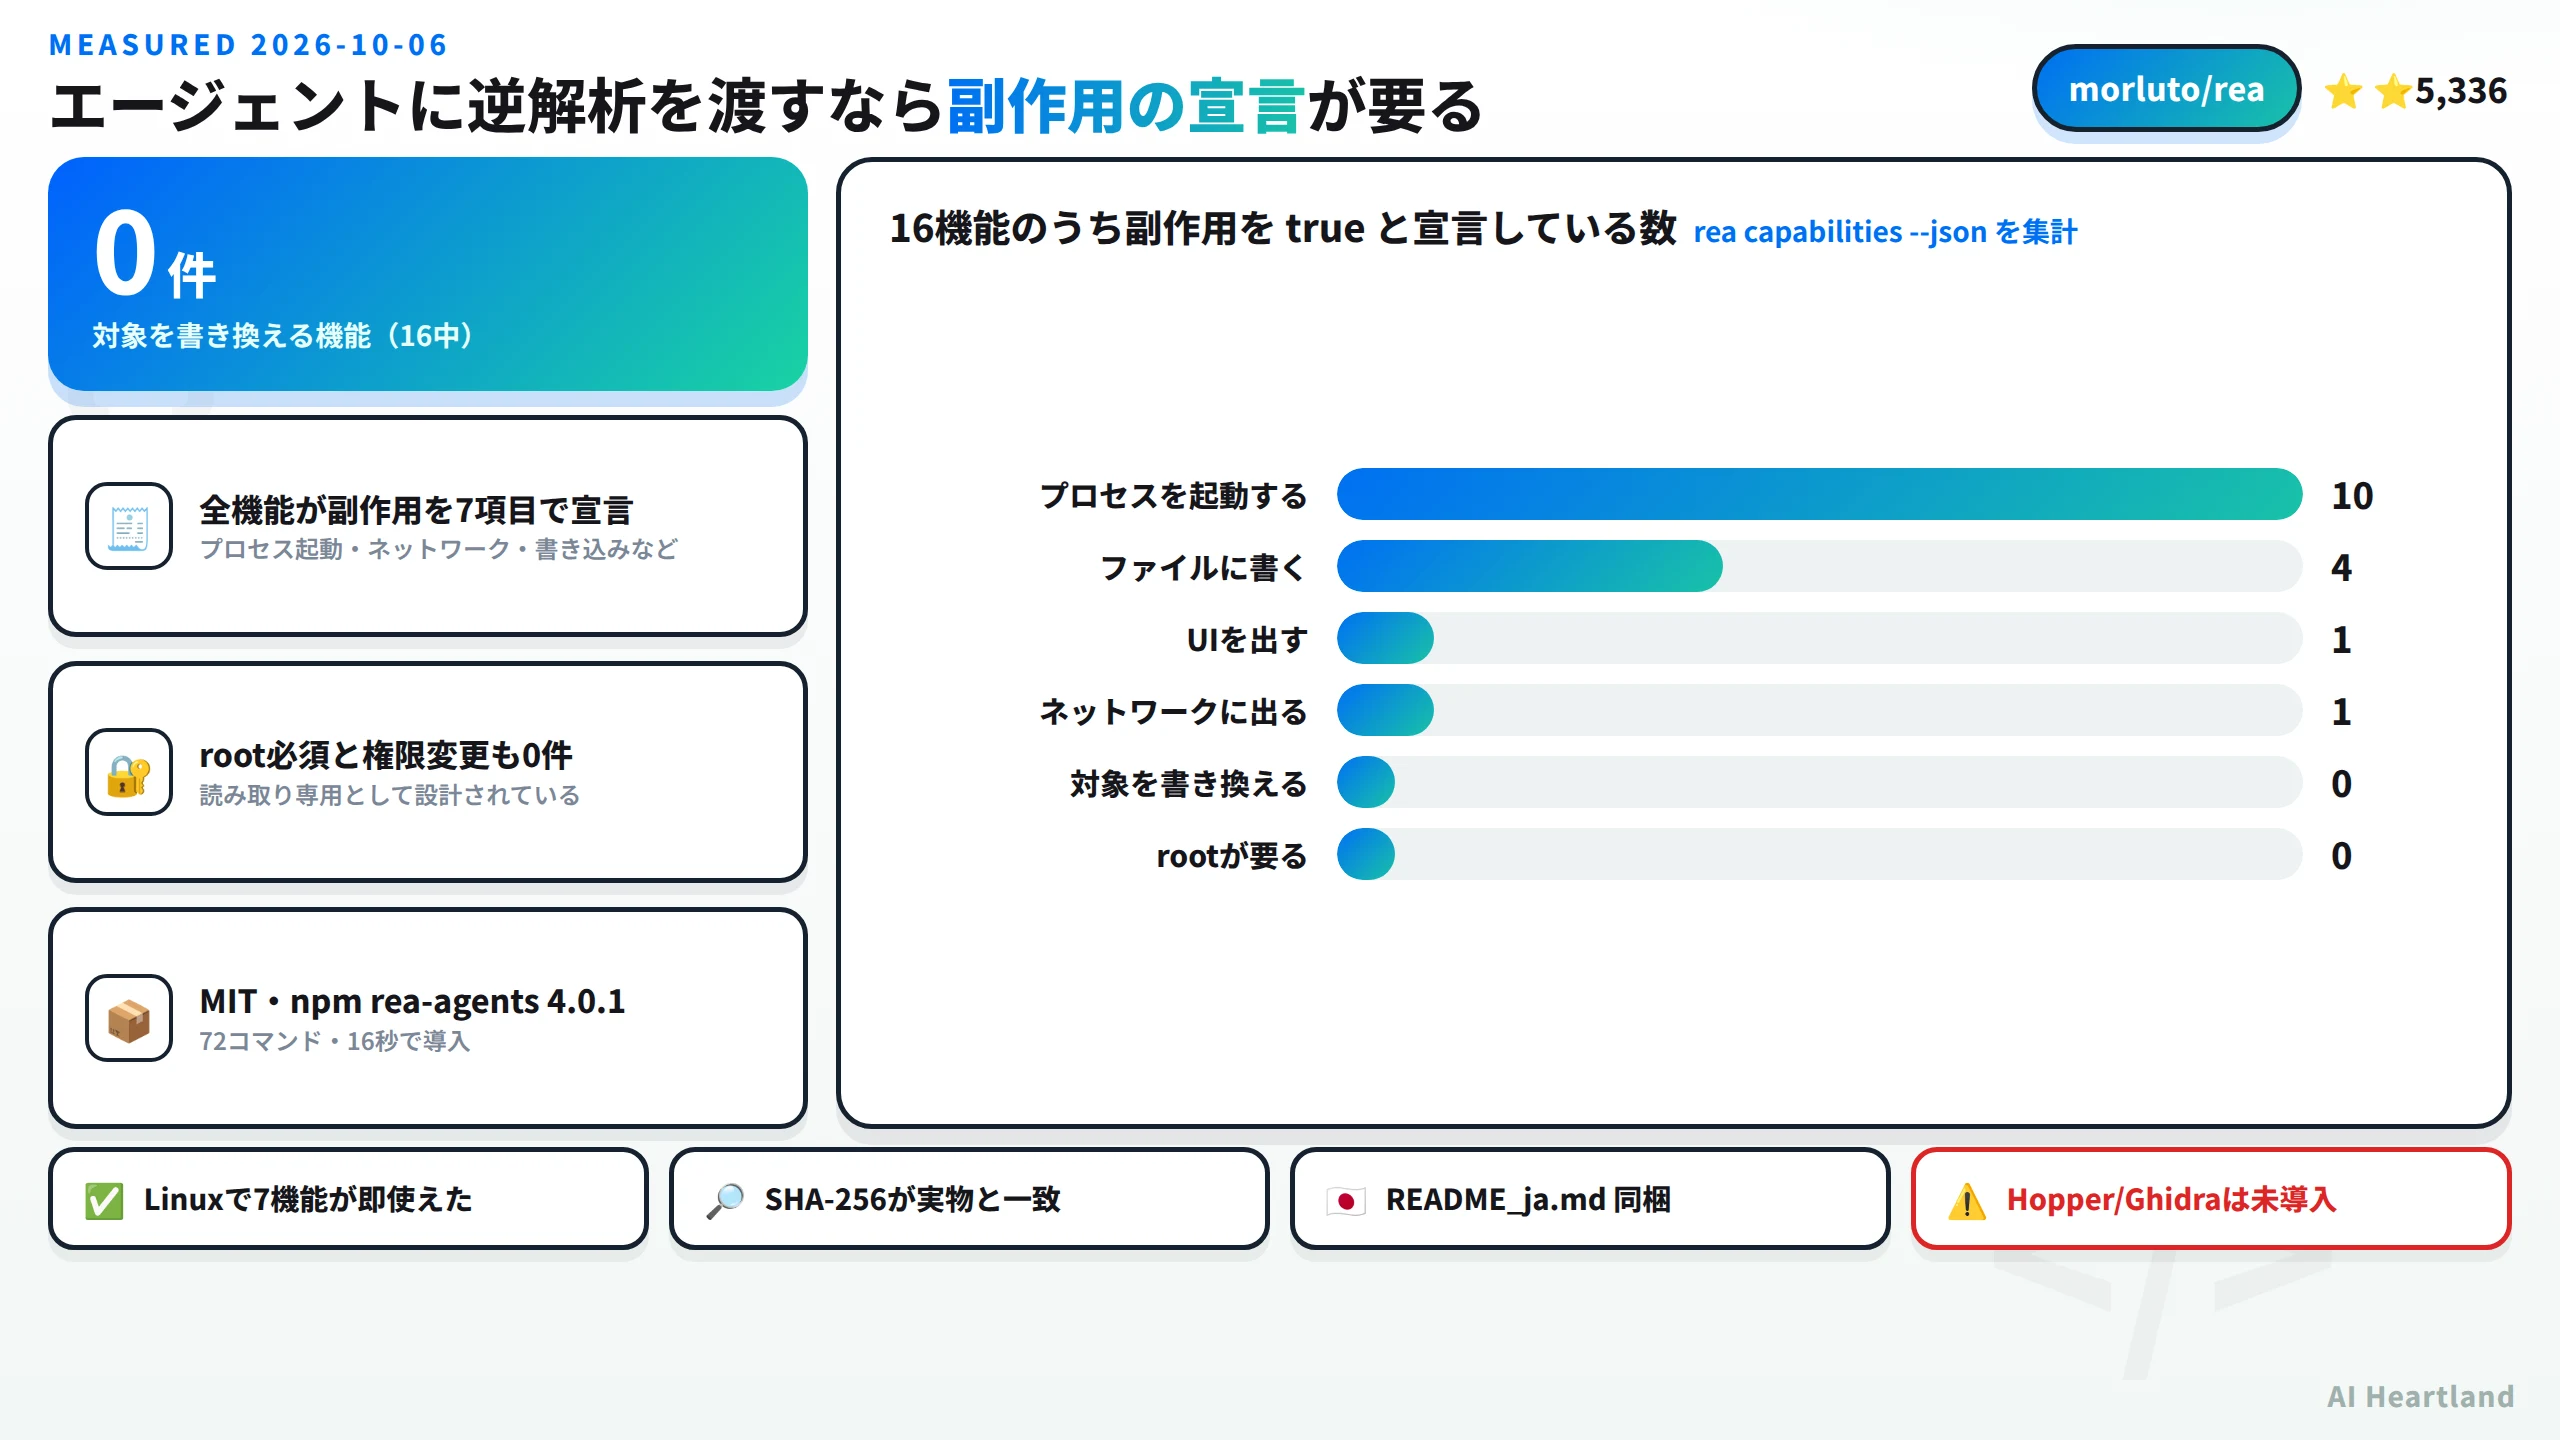
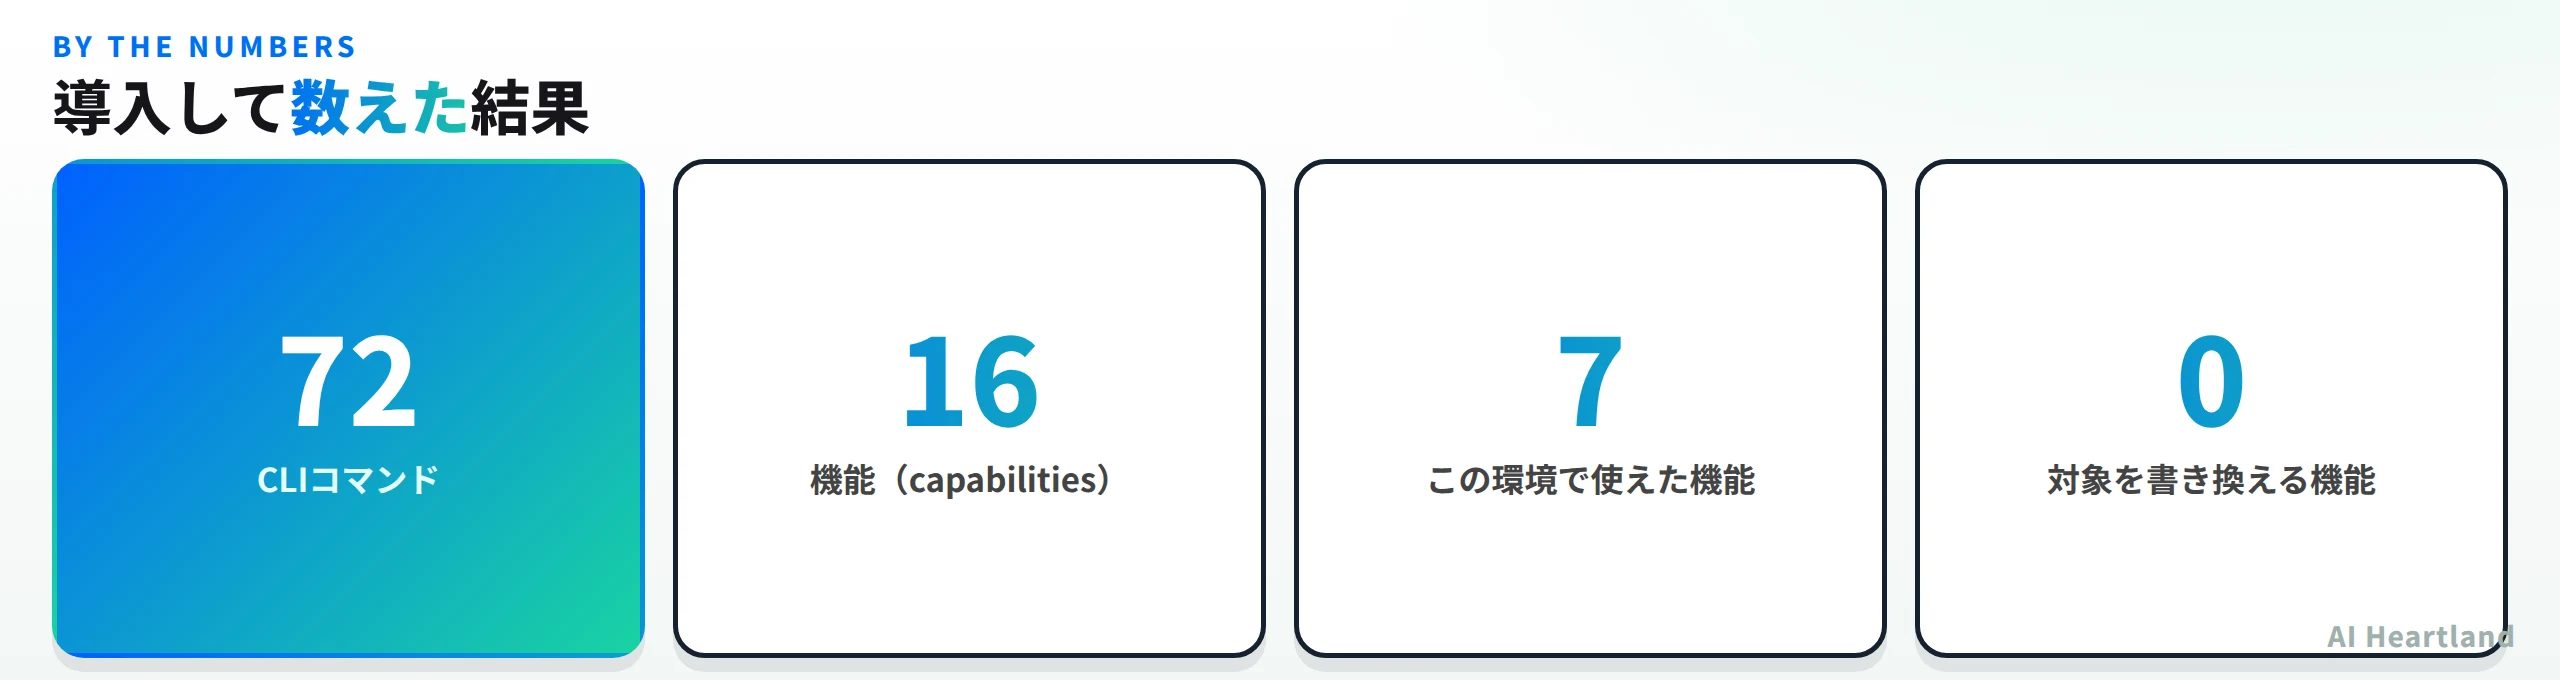
・16機能すべてが**7項目の副作用を機械可読で宣言**している。エージェントに渡す道具として要る設計
・**対象の書き換え・root必須・権限変更は0件**。一方プロセス起動は10件あるので無条件許可はできない
・返ってくる Evidence の SHA-256 を `sha256sum` と照合して**完全一致**を確認した
- ・アプリの挙動からネイティブバイナリまで、エージェントに調べさせるツールキット。**MIT**・⭐5,336
- ・npm `rea-agents` 4.0.1。**72コマンド**・16秒・82MB・脆弱性0
- ・CLI と **MCPサーバー**の両方。Claude Code・Codex・Cursor・opencode・VS Code に登録できる
- ・出力は **Evidence**。内容アドレスのIDと in-toto 形式の `predicate_type` を持つ
- ・Hopper / Ghidra 無しの素の Linux でも **7機能が動いた**
- ・**日本語READMEを同梱**(README_ja.md のほか中国語・韓国語・アラビア語)
エージェント基盤全体の選び方はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその枝として、エージェントに渡す道具側の安全設計を測る。
AIエージェント 逆解析ツールの副作用を数える
まず導入する。npm から入るので手順は短い。
npm install rea-agents
npx rea --help
16秒・82MB・npm audit は脆弱性0だった。リポジトリ側の規模は src に 872ファイル・154,338行(TypeScript)、テストが232ファイル。タグは28本で、バージョンは rea-agents-4.0.1 まで来ている。半年強でメジャーを4つ重ねている計算になる。
skills/ ディレクトリには Agent Skill が1本(reverse-engineer-anything)入っている。コーディングエージェントに「調べ方」そのものを教える形で、当サイトで扱ってきたAgent Skills の設計と同じ構えだ。道具(CLI)と手順書(Skill)とプロトコル(MCP)の3点セットで配っている。
--help を数えると 72コマンドある。analyze decompile function のような解析系から、compare-web-captures capture-electron-scenario のような観測系、evidence-export evidence-import のような証跡系まで揃っている。
本題は capabilities だ。
npx rea capabilities --json
16の機能それぞれについて、こういう構造が返る。
{
  "operation": "decode_interface_builder",
  "available": true,
  "effects": {
    "mutates_artifact": false,
    "launches_process": false,
    "may_show_ui": false,
    "may_access_network": false,
    "may_write_filesystem": false,
    "changes_permissions": false,
    "requires_root": false
  },
  "limitations": ["..."]
}
7項目の副作用マトリクスが機能ごとに宣言されている。16機能ぶんを集計した。
| 副作用 | true と宣言している機能数 |
|---|---|
launches_process(プロセスを起動する) |
10 / 16 |
may_write_filesystem(ファイルに書く) |
4 / 16 |
may_show_ui(UIを出す) |
1 / 16 |
may_access_network(ネットワークに出る) |
1 / 16 |
mutates_artifact(解析対象を書き換える) |
0 / 16 |
requires_root |
0 / 16 |
changes_permissions |
0 / 16 |
limitations という配列も各機能についていて、たとえば decode_interface_builder にはこう書かれていた。
DMG child inventory automatically uses a read-only native macOS mount; PKG remains root-hash-only. ASAR files discovered in filesystem-backed inventories are expanded without bulk extraction; other nested containers remain recorded only.
「どこまで踏み込むか」の境界が機能ごとに明文化されている。DMG は読み取り専用マウント、PKG はルートハッシュだけ、ASAR は展開するが他の入れ子コンテナは記録のみ。副作用の真偽値だけでなく、この粒度の但し書きが付くのは珍しい。
下3つが0なのが効く。解析対象そのものを書き換える機能がひとつも無いので、「調べたつもりが証拠を壊した」が構造的に起きない。root も要らない。
一方で launches_process が10件ある点は軽く見ないほうがいい。外部の解析エンジン(Hopper や Ghidra)やブラウザを起動するためだが、エージェントが自動で判断して走らせてよいかは別問題だ。この宣言があることの価値は、エージェント側で「プロセスを起動する操作だけは人に確認する」といった方針を機械的に書けることにある。
方針次第で自動可"] E -- "true" --> G["人に確認する"] D --> H["Evidence が返る"] F --> H G --> H H --> I["SHA-256 で後から検算できる"]
ディスアセンブラが無い環境で何が動くか
REA は Hopper(商用)か Ghidra(無償)を解析エンジンとして使う。当記事の環境にはどちらも無い。その状態で rea doctor を叩くと、何が足りないかを構造化して返してくる。
healthy: false
scope_checks[10]:
  - name: node     ok: true   detail: 22.22.2
  - name: host     ok: true   detail: ubuntu 24.04
  - name: hopper   ok: false  classification: missing_analysis_engine
    remediation: "Run rea setup to install Hopper, or set HOPPER_LAUNCHER_PATH."
  - name: ghidra   ok: false  classification: missing_analysis_engine
    detail: GHIDRA_INSTALL_DIR is not set
10項目の点検があり、それぞれ classification と remediation がつく。足りないものと直し方が同じ行に出るので、エージェントがそのまま読んで対処できる。5つのクライアント(Claude Code・Codex・Cursor・opencode・VS Code)への登録状態まで点検対象だった。
では「使えない」のはどれかというと、16機能中9件で、理由はすべて unsupported_host(macOS 専用のネイティブ解析ユーティリティ)だった。残り7件は Linux でそのまま動く。
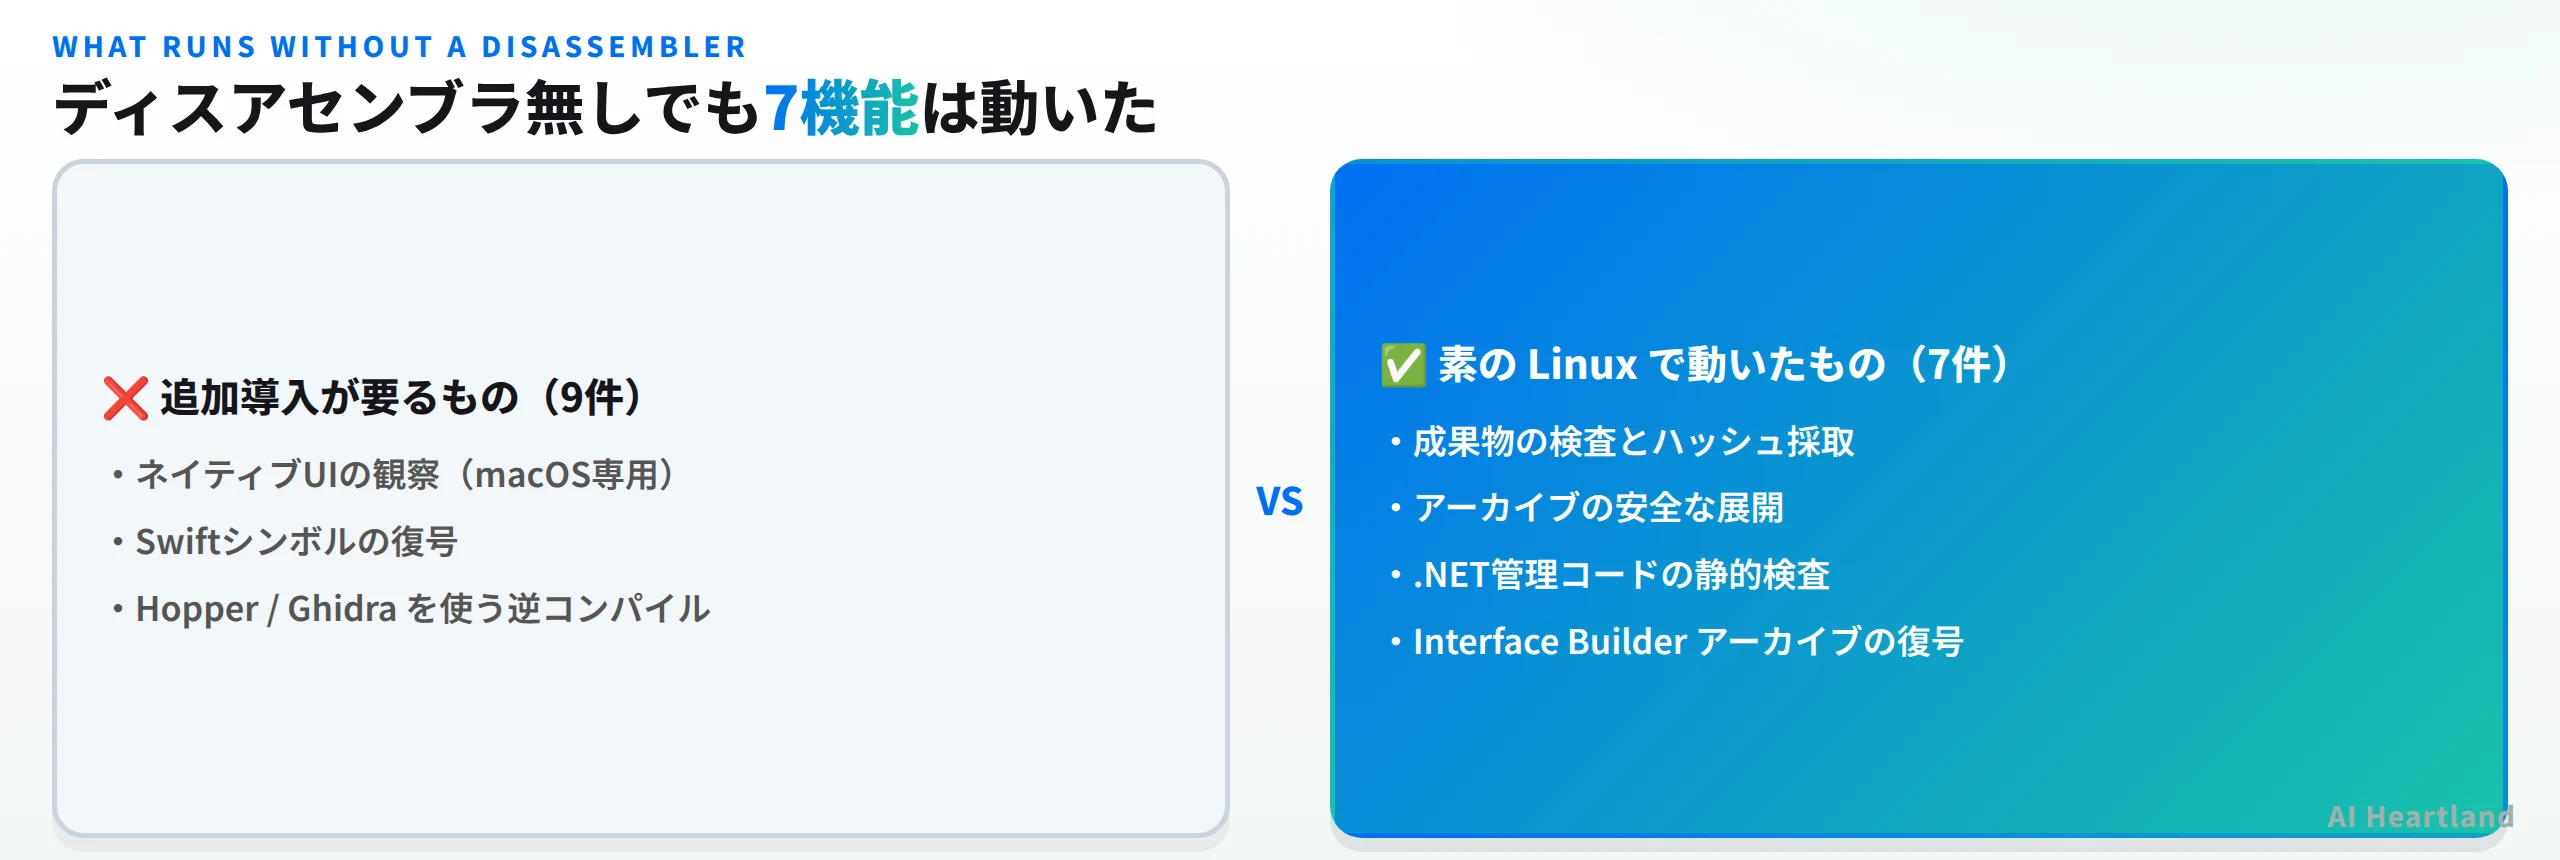
missing_analysis_engine と unsupported_host と config_drift が別の分類として出ているのも実務的だ。足りないのが「入れれば直るもの」か「この機械では無理なもの」か「設定がずれているだけか」で対処が変わる。doctor が一律に false を返すのではなく分類してくれるので、エージェントに読ませてもそのまま判断できる。
動いた7機能は inspect_artifact extract_artifact inspect_keyed_archive inspect_managed_artifact inspect_managed_members inspect_managed_native_boundaries decode_interface_builder で、いずれも静的な検査・展開・復号だ。逆コンパイルだけが外部エンジンを要求する、という素直な切り分けになっている。
出力は「主張」ではなく「証拠」で返る
実際に動かしてみる。手元の node バイナリ(124MB の ELF)を対象にした。
npx rea inspect-artifact /opt/node22/bin/node
返ってきたものがこれだ。
evidence_id: ev_4c41923f5eef1fd3fd9352812a0839b5795dea37428728e288f3d2f0f95d4eea
subject:
  name: node
  digest:
    sha256: 81925c0995b5c1427b5d538e6a90ca2fdc4daffb786b09af749beaf7369d4e90
  format: elf
provider:
  id: rea-artifact-graph
predicate_type: rea.analysis
operation: inspect_artifact
parameters:
  integrity_policy: fail
ここが REA の設計で一番おもしろい点だと思う。predicate_type: rea.analysis は in-toto 系の語彙で、ソフトウェアサプライチェーンの証跡(attestation)と同じ形をしている。結果そのものに evidence_id という内容アドレスがつき、対象には SHA-256 がつき、どの provider がどの parameters で出したかまで残る。
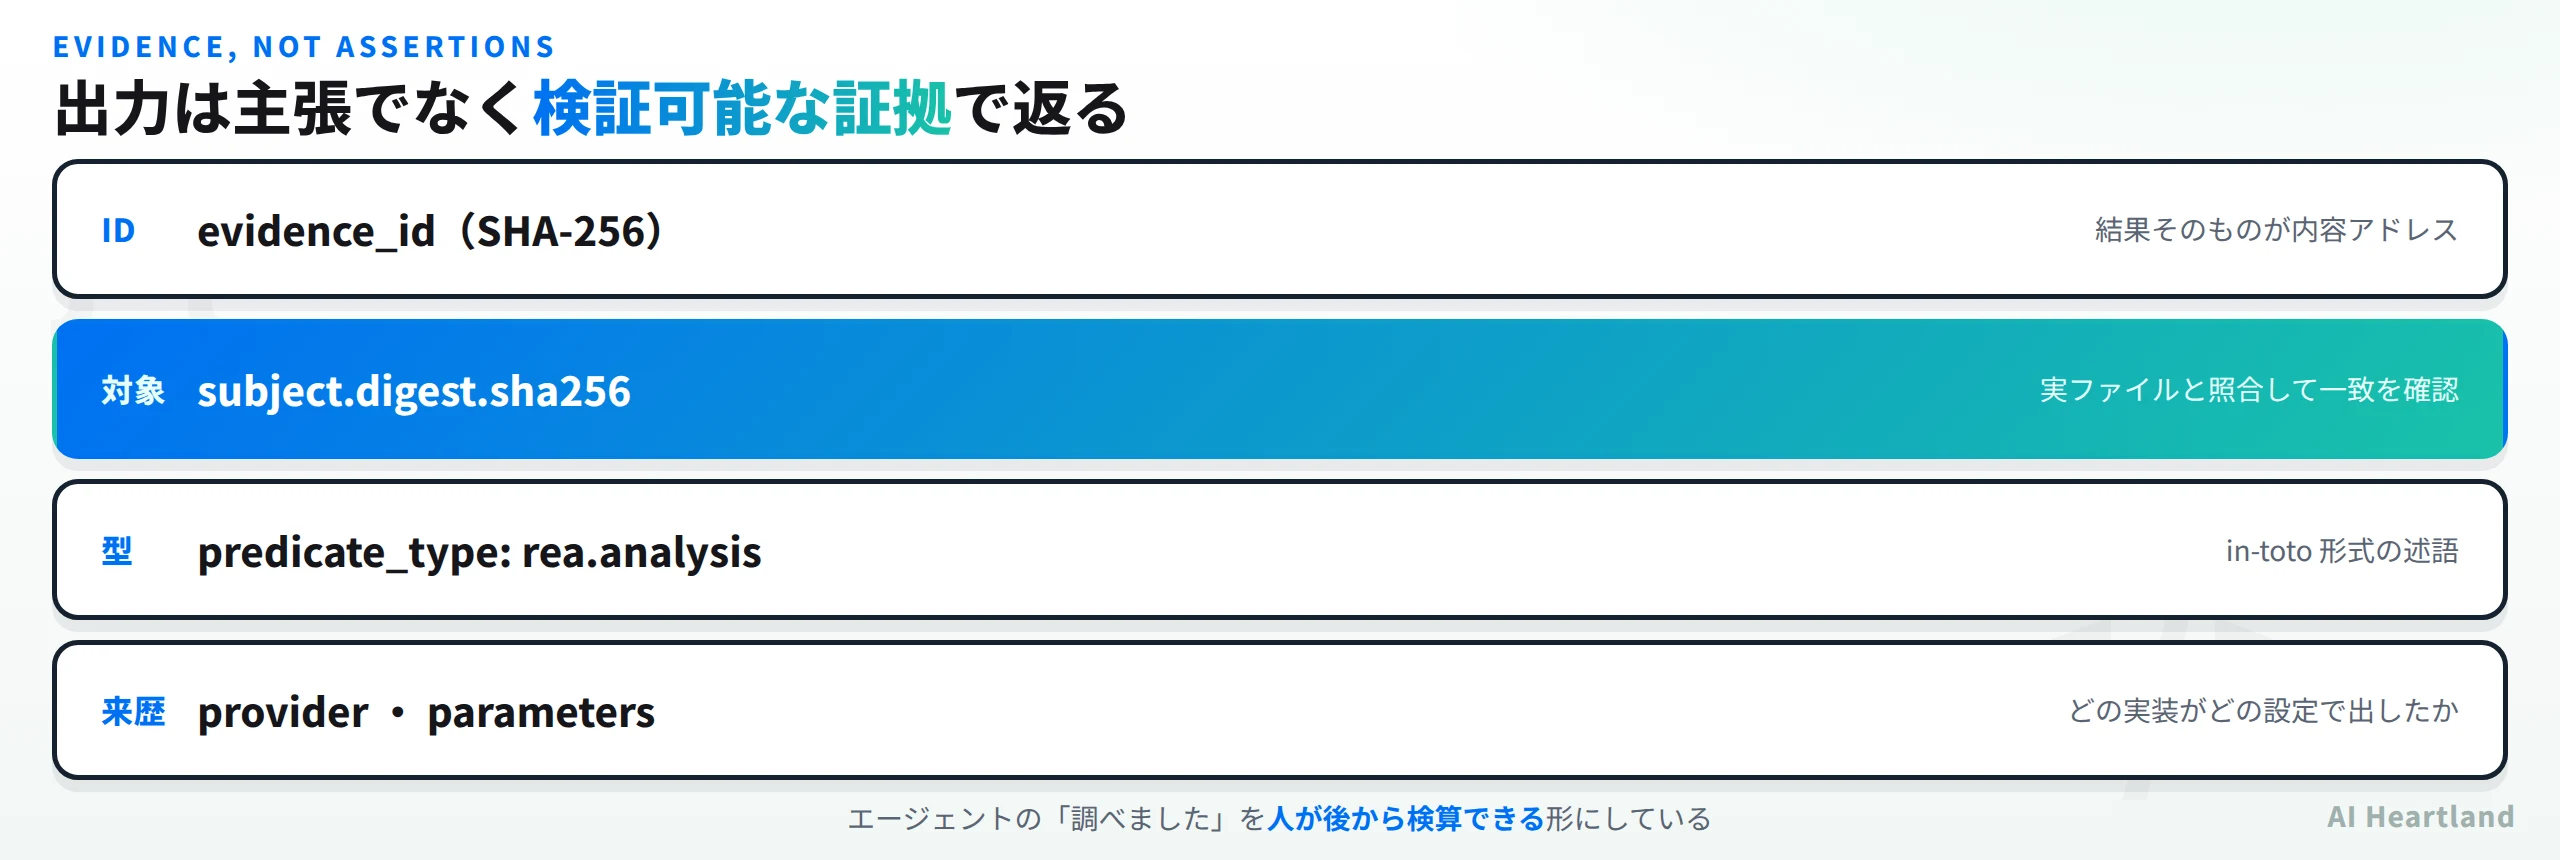
報告された SHA-256 が本物か検算した。
sha256sum /opt/node22/bin/node
# 81925c0995b5c1427b5d538e6a90ca2fdc4daffb786b09af749beaf7369d4e90
完全一致した。あわせて解析後のファイルの mtime を見ると 2026-03-24 のままで、対象は触られていない。
parameters に出ている integrity_policy: fail にも触れておきたい。既定が fail ということは、整合性の確認に失敗したらそこで止まる(fail-closed)設計だ。解析途中でハッシュが合わなくなったときに、黙って続行して誤った結論を出すより止まるほうを選んでいる。README にも “fail-closed” という語が繰り返し出てくる。
エージェントに任せる道具としては、この既定値が重要になる。エージェントは止まるより進もうとするので、止まる判断は道具側が持っているほうが安全だ。
mutates_artifact: false の宣言が実際の挙動と合っていることを、宣言と実測の両方で確認できた。
念のため、この検算は誰でもできることを強調しておきたい。REA が特別な権限で動いているわけではなく、返ってきた値を sha256sum に通すだけだ。道具が「正しいハッシュを返す」と主張しているのではなく、主張の正しさを外から確かめられる形で返しているところに違いがある。
この「検算できる」という性質が、エージェントに調査をさせるときに効く。エージェントは自然言語で「このバイナリは◯◯でした」と報告してくるが、その報告が本当にそのファイルについてのものかは普通わからない。Evidence に対象のハッシュが入っていれば、後から照合できる。当サイトで以前Clefとは|Cloudflareの決定モデルの「Jev互換」を両側のJSONを生成して突き合わせたを書いたときも同じ考え方で、モデルの自己申告を外から数え直すことが検証の基本になる。
72コマンドは何を分担しているか
コマンドが多いので、名前の付き方から構造を読む。rea --help の72コマンドを動詞で分類すると、こう割れている。
| 系統 | 代表的なコマンド | 役割 |
|---|---|---|
inspect-* |
inspect-artifact inspect-keyed-archive inspect-electron-page |
対象を壊さずに観察する |
analyze-* |
analyze-javascript-application analyze-web-bundle |
静的に再構成する |
capture-* |
capture-browser-scenario capture-process |
実行時の挙動を境界つきで記録する |
compare-* |
compare-web-captures compare-application-versions |
2つの Evidence を突き合わせる |
decompile / function |
— | コードとして読む(外部エンジンが要る) |
evidence-* |
evidence-export evidence-import |
証跡を出し入れする |
これだけの数があると「どれを使えばいいか」で迷うが、動詞で引けるようになっているので実際には探しやすい。壊さず見たいなら inspect-、挙動を記録したいなら capture-、差分を見たいなら compare- から探せばいい。
compare-* 系が多いのが特徴的だ。compare-application-versions(版の差分)、compare-source-to-bundle(公開ソースと配布物の突き合わせ)、compare-managed-members(.NET の型とシグネチャの比較)など、単発の解析より2点間の差分に寄っている。
これは用途から逆算すると納得がいく。逆解析の実務で知りたいのは「このバイナリは何か」より「前の版と何が変わったか」「公開されているソースと配布物は一致するか」であることが多い。compare-source-to-bundle の説明には “Compare committed historical source with authenticated application Evidence” とあり、ソースと配布物の乖離を見る用途が明示されている。
capture-* 系の説明に繰り返し出てくる “bounded”(境界つき)という語も設計を表している。capture-browser-scenario は “Run one bounded Playwright browser scenario”、capture-process は “Capture one caller-selected process scenario”。1回の呼び出しで1シナリオに限定し、呼び出し側が対象を選ぶ。エージェントが延々と探索して副作用を広げないための制約だろう。
技術的にできることと、やってよいことは別
ここは技術評価とは別に書いておきたい。
REA 自体は MIT で公開されており、使うこと自体に制限は無い。しかし解析対象のソフトウェアには、それぞれの利用規約がある。逆コンパイル・逆アセンブルを明示的に禁じる EULA は珍しくない。
ここは逆解析ツール一般に言えることで、REA 固有の問題ではない。ただ エージェントに任せると踏み越えやすいという事情が加わる。人間なら「このアプリの規約どうだったかな」と一度止まるところを、エージェントは指示どおり走る。capabilities が副作用を宣言していても、法的な可否までは宣言しない——そこは利用者が決める領域だ。
実例を挙げると、当サイトが先日扱った RevPDF の EULA にはこうあった。
Reverse-engineer, decompile, disassemble, or otherwise attempt to derive source code from the software.
無償配布のアプリであっても、こう書かれていれば逆解析は契約違反になりうる。
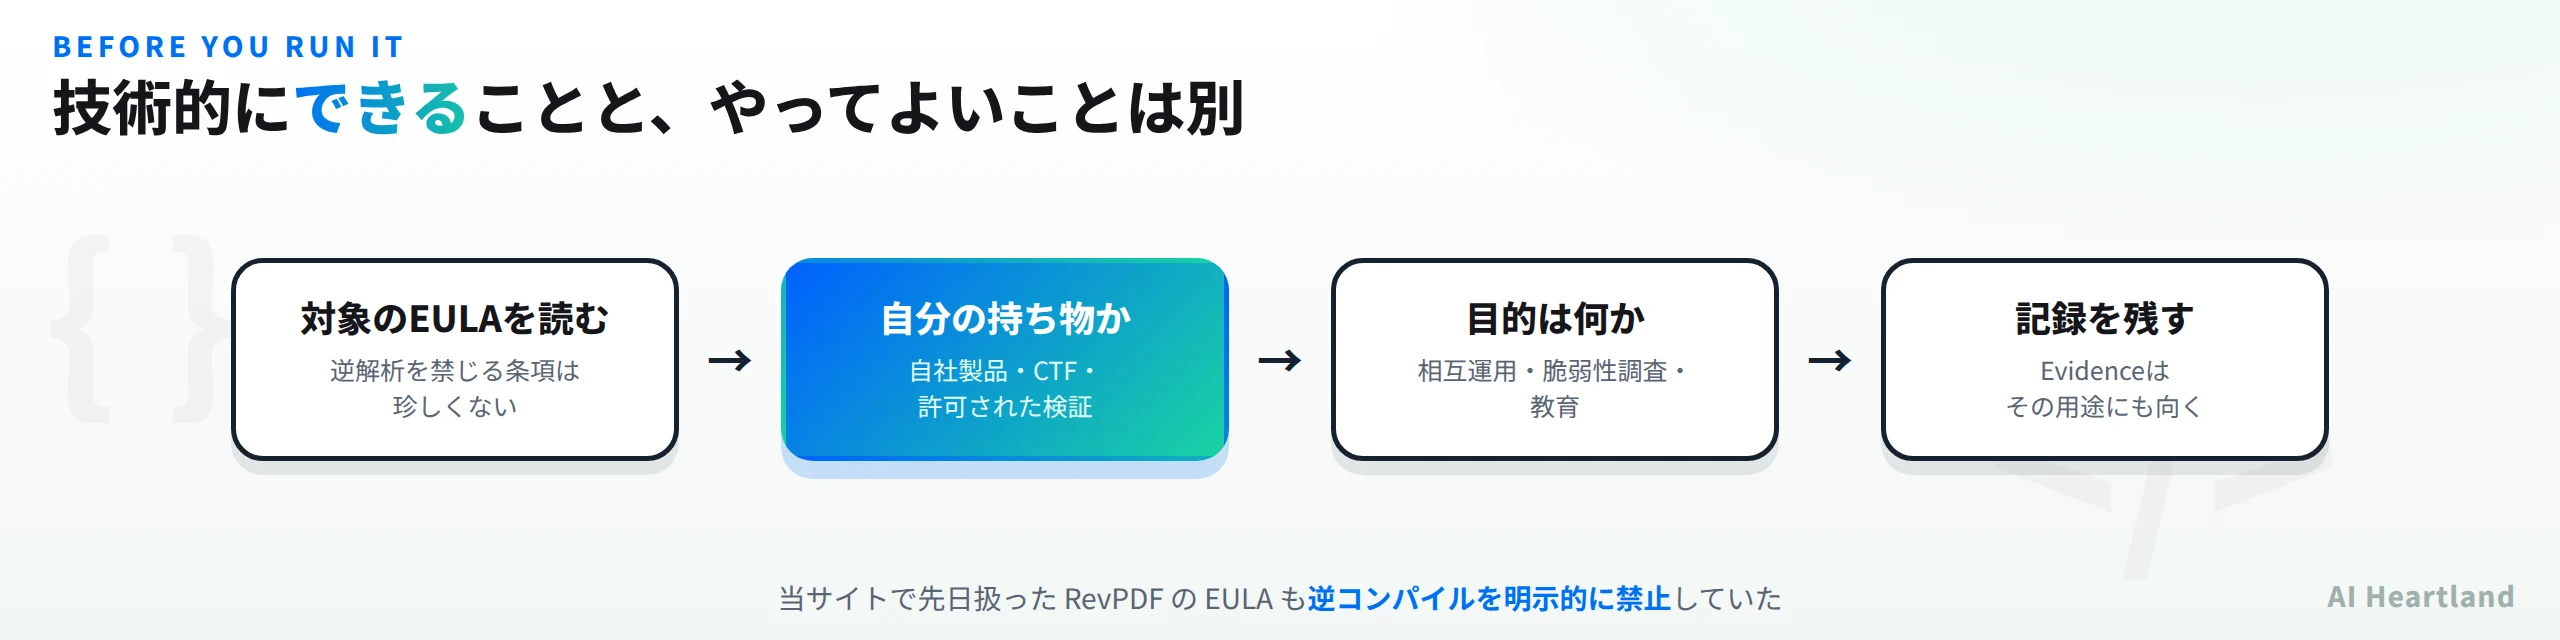
実務で REA が素直に使える場面を挙げると、
・自社製品の解析。ビルド成果物に何が入っているかを確かめる、依存の実体を調べる
・CTF・セキュリティ演習。許可された対象を調べる
・脆弱性調査。自分が運用しているシステム、または調査が許可されている対象
・相互運用。法域によっては明示的に例外として認められている目的
逆に、他社の製品を許可なく解析して競合製品を作る、といった使い方は規約以前の問題になる。対象と目的を先に決めてから道具を選ぶのが順序で、その逆ではない。
なお REA が Evidence という形で来歴を残す設計は、こういう場面でも効く。何をいつどの設定で調べたかが構造化されて残るので、正当な調査であることを後から示す材料になる。
AIエージェント 逆解析ツールとして入れるかの判断材料
使うかどうかの前に、この道具が解いている問題を整理しておく。
エージェントにバイナリ解析をさせようとすると、普通は3つ困る。1つめは何が起きるか分からないこと——逆コンパイラは外部プロセスを起動し、一時ファイルを撒き、場合によってはネットワークに出る。2つめは報告を信用できないこと——エージェントが「この関数は認証を行っています」と言っても、本当にそのバイナリのその関数を見たのかは分からない。3つめは暴走の範囲が読めないこと——「全部調べて」と言うと際限なく広がる。
REA の設計はこの3つにそれぞれ対応している。副作用の機械可読な宣言が1つめ、Evidence の内容アドレスとハッシュが2つめ、capture-* 系の “bounded”(1回1シナリオ)が3つめだ。機能の多さではなく、この3点が揃っていることが選定理由になると思う。
2つめの「報告を信用できない」は道具側だけの問題ではなく、エージェントの出力そのものを外から評価する系統の OSS もある。当サイトで扱ったiFixAiとは|AIエージェントの業務KPI適合を独立監査するLLM-as-Judge型OSSを実機検証は、判定を別のモデルに任せて監査する方向だった。REA はそれより手前で、そもそも検算可能な形で事実を返させることで同じ問題に当たっている。どちらが良いかではなく、層が違う。
向いている場面
・エージェントに調査を任せたいが、何が起きるかを機械的に制御したい場合。副作用の宣言がそのまま方針になる
・調査の結果を他人に示す必要がある場合。Evidence に来歴とハッシュが残る
・macOS でネイティブアプリを扱う場合。16機能のうち9件は macOS 前提で、そこが本領
・版の差分を追いたい場合。compare-* 系が充実しており、「前の版から何が変わったか」が主用途として想定されている
・既存のエージェント環境に乗せたい場合。5クライアントへの登録を doctor が点検するので、設定のずれを自分で探さなくて済む
慎重に見るべき点
・Hopper は商用、Ghidra は要セットアップ。逆コンパイルまでやるなら前提環境の用意が要る
・launches_process が16中10件。エージェントに全権を渡す構成にはしないほうがいい
・コマンドが72もあるので、何から触るかの見通しは自分で立てる必要がある
・v4.0.1 でタグは28本と動きが速い。APIや出力形式が変わる可能性がある
・解析対象の利用規約は自分で確認する必要がある。道具は副作用を宣言するが、法的な可否は宣言しない
当記事で測っていないこと
・Hopper / Ghidra を使う逆コンパイルは未検証。どちらも未導入のため、REA の本丸である逆コンパイル品質は評価していない
・エージェント経由で動かしていない。MCP サーバーとして登録せず、CLI からのみ実行した
・macOS 専用の9機能は未検証(Linux 環境のため)
・ブラウザ観測(CDP)、Electron の V8 Inspector 観測、rea setup による各クライアントへの登録も未実行
・実行したのは inspect-artifact 1コマンドのみで、72コマンドのうち71は動かしていない
・skills/ の Agent Skill をエージェントに読ませての動作確認もしていない
・integrity_policy: fail が実際に失敗時へ止まるかは、失敗ケースを作れていないため未検証
つまり確かめたのは「宣言の中身と、宣言どおりかどうか」であって、「解析の質」ではない。前者だけでも、エージェントに渡してよい道具かの一次判断には足りると思う。
確かめるならどこからも書いておく。導入を検討するなら、順序はこうなるはずだ。
npx rea capabilities --jsonで副作用を読み、自分の環境で許してよい操作を決めるnpx rea doctorで足りない前提(Hopper / Ghidra / クライアント登録)を出す- 自分の持ち物のバイナリに
inspect-artifactを当て、返った SHA-256 をsha256sumと照合する - そこまで通ってから
rea setupでエージェントに登録する
3番目を飛ばさないのが肝心だと思う。Evidence が本物かを一度自分で検算しておくと、以降エージェントの報告をどこまで信じてよいかの基準ができる。当記事がやったのもそれだけで、逆に言えば誰でも5分で再現できる。
参照ソース
・morluto/rea(⭐5,336・MIT・v4.0.1、2026-10-06時点)
・rea-agents — npm(4.0.1・Node ^22.19.0 || >=24.11.0)
・REA 日本語README
本記事の計測レコードは data/measurements/runs/2026-10-06-rea-reverse-engineering.json に登録した。