AI E2Eテスト——エージェントにアプリを操作させるE2Eテストを、実用的な形に落とし込もうとしているのが e2e だ。WebとモバイルのE2Eテストを「自然言語の目標」と「決定的な検証」の組み合わせで書くTypeScriptフレームワークで、開発元は TesterArmy(GitHub organization は tester-army、本記事が扱うのは e2e tester army のこの1本)。ライセンスは Apache-2.0、⭐1,280(2026-10-02時点)、最新は [email protected]。リポジトリの作成は 2026-07-22 で、直近コミットのPR番号は #748——2か月半でこの本数が流れている。
READMEの主張のうち、採用判断に直結するのは次の一文だ。
An agent step that a later assertion verifies records its actions, and the next run replays them with no model calls until the app changes.
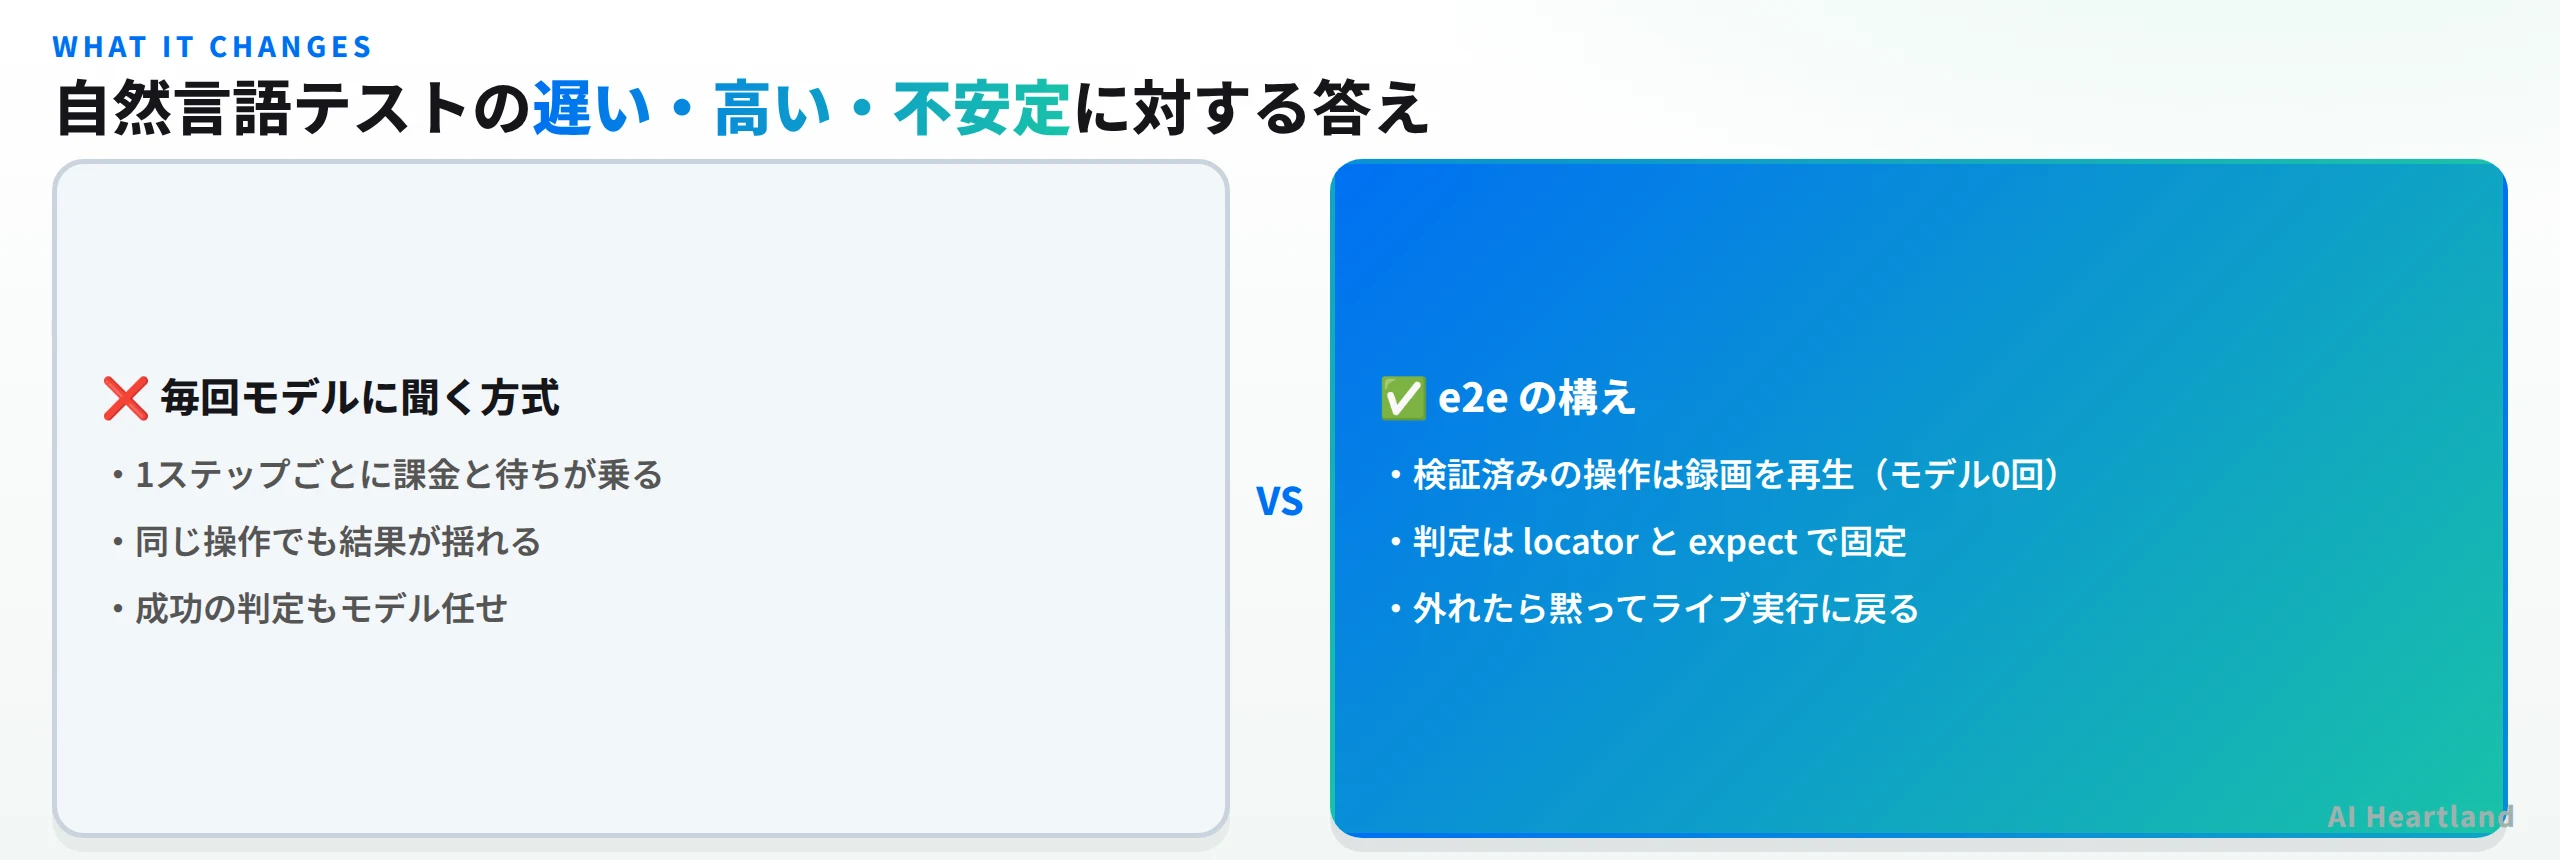
「検証済みのエージェントステップは操作を録画し、次の実行ではアプリが変わるまでモデル呼び出しなしで再生する」。自然言語 テスト自動化の三重苦(遅い・高い・揺れる)にまとめて答える主張で、本当なら効きは大きい。本記事はこの一文を実際に回数を数えて確かめた記録である。
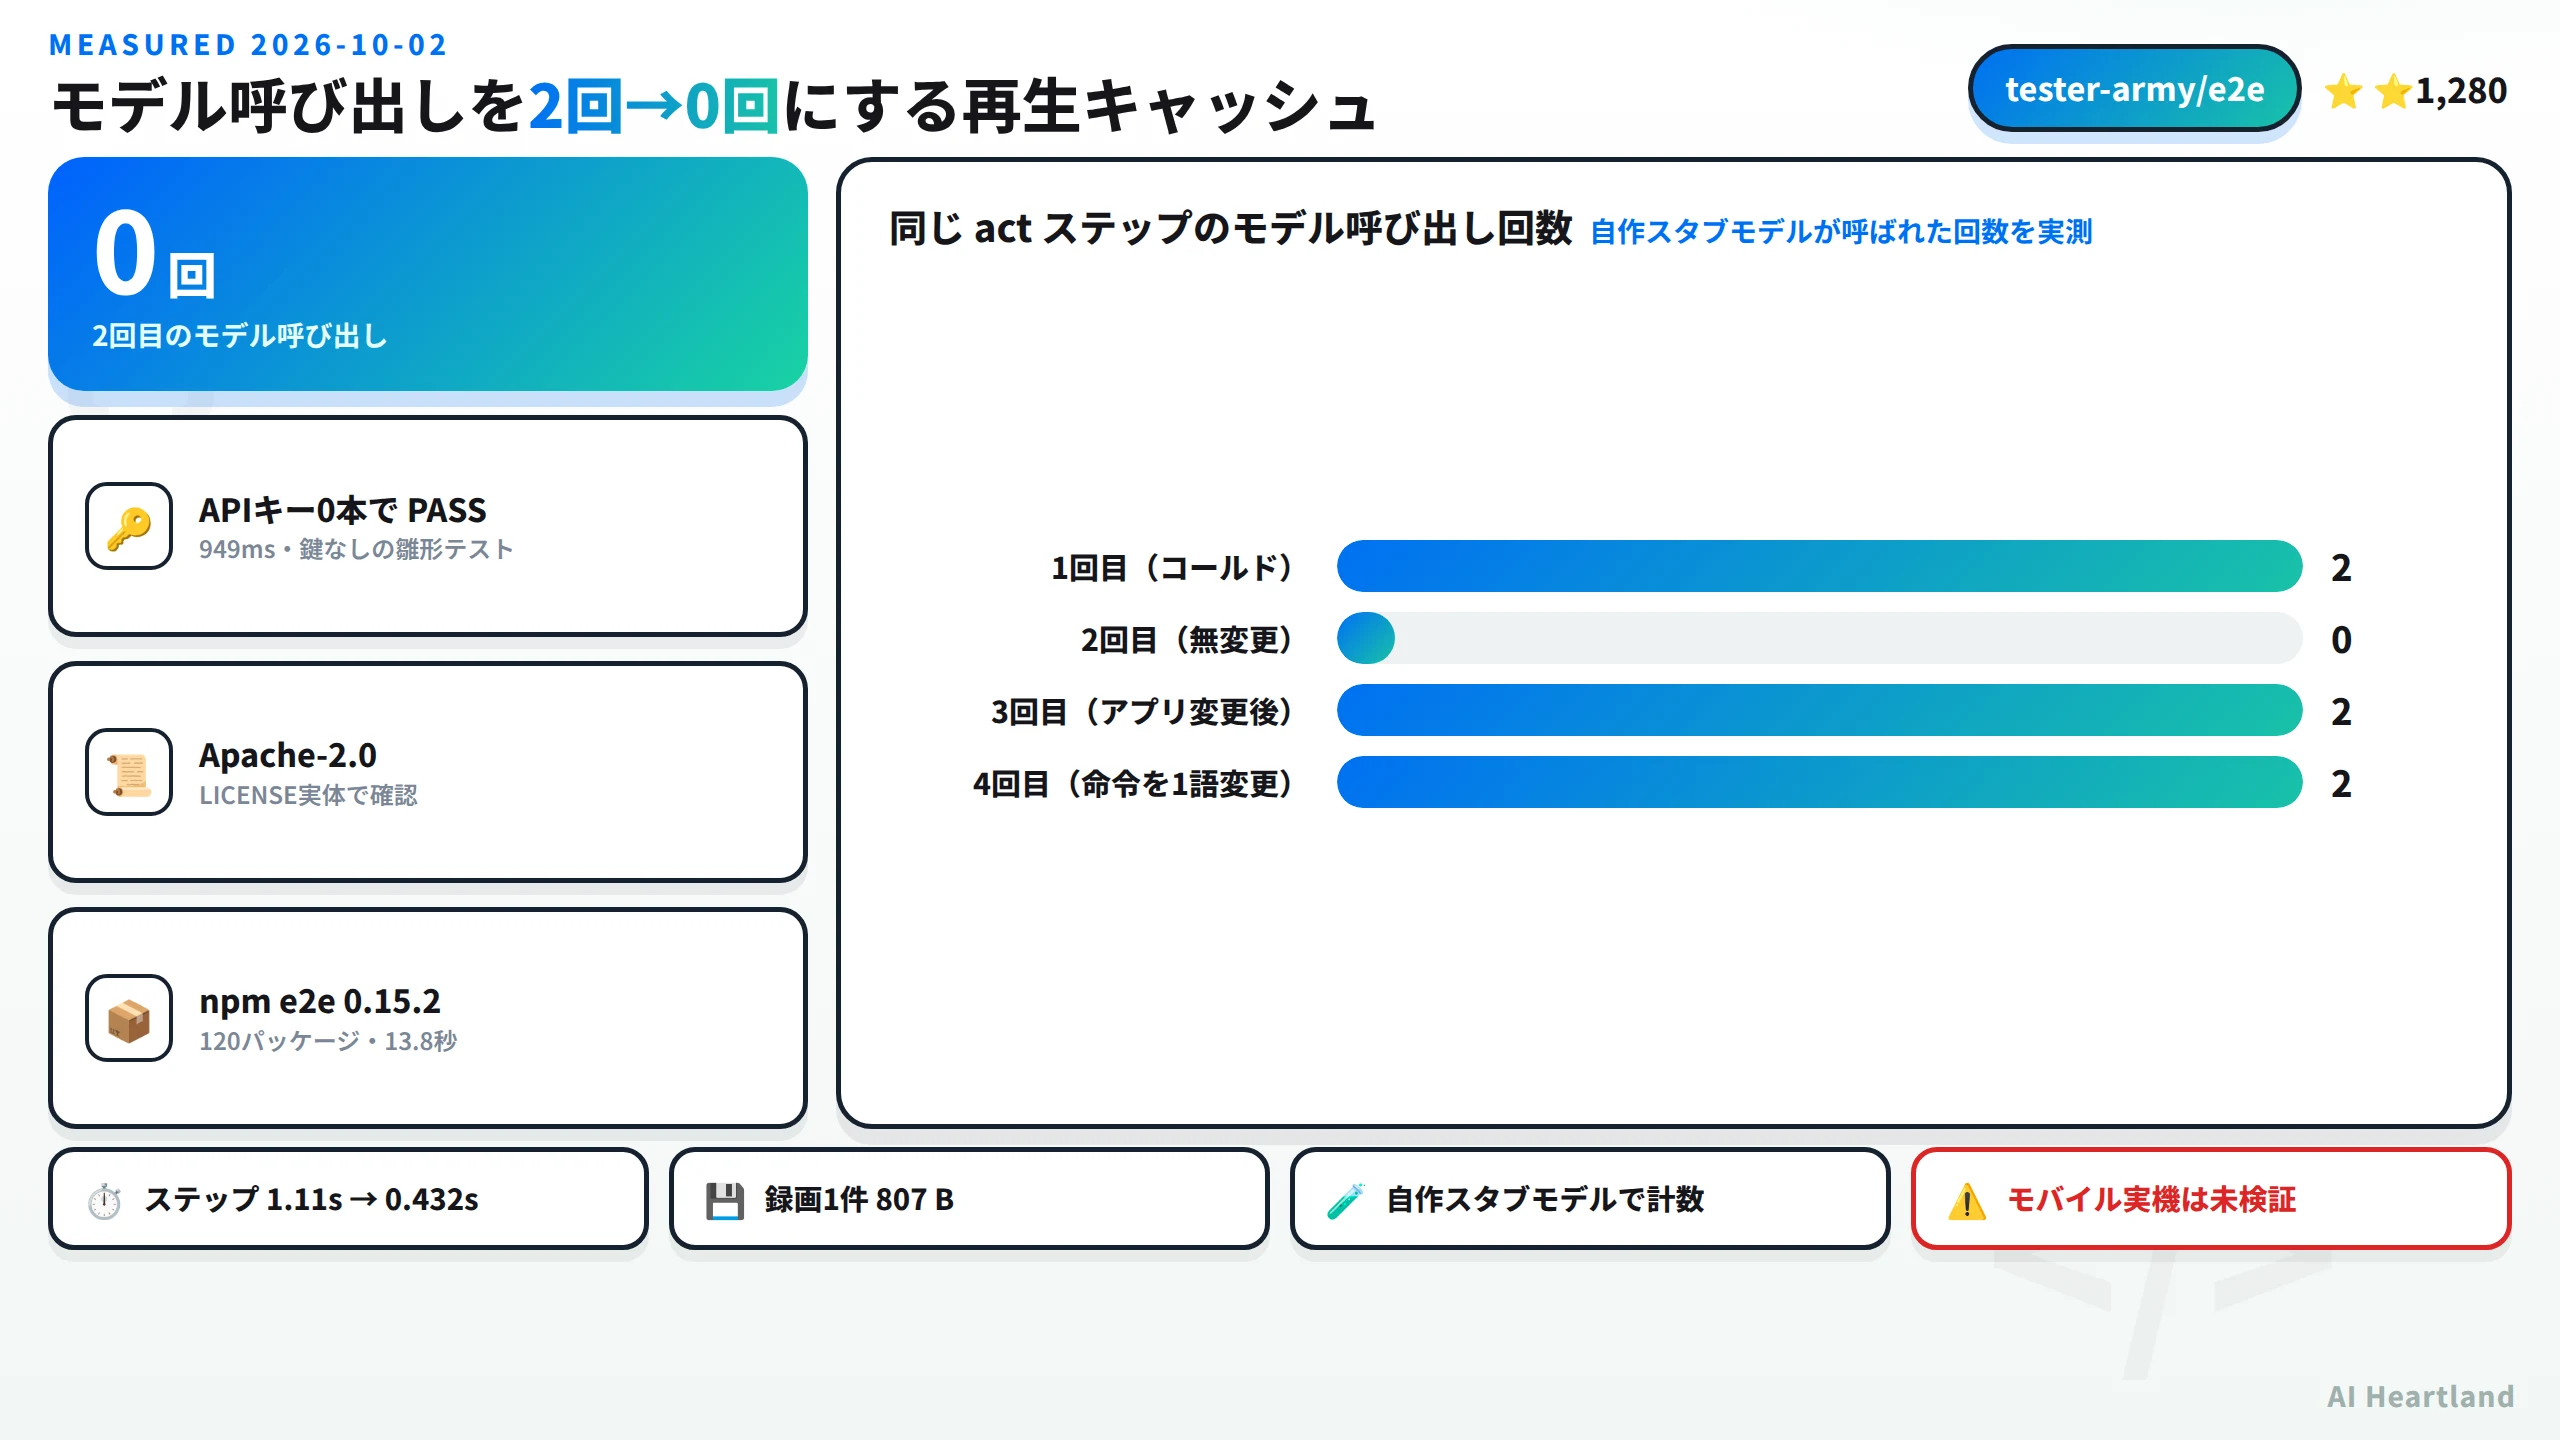
・README の「検証済みのステップはモデル呼び出しなしで再生する」を、自作スタブモデルで**回数を外から数えて**確かめた
・当たれば速いが**外れると通常より遅い**(1.11秒 → 15.45秒)。恩恵が反転する条件まで測った
・モバイル実機と実モデルでの精度は**未検証**。測れた範囲とそうでない範囲を本文で分けて書いた
- ・自然言語の目標とlocator検証を同じテストに書くE2Eフレームワーク。**Apache-2.0**・⭐1,280・`[email protected]`
- ・**APIキー0本で動く**。雛形テストはエージェントステップを含まず 949ms で PASS
- ・リプレイキャッシュでモデル呼び出しが **2回 → 0回**、ステップは **1.11秒 → 0.432秒**
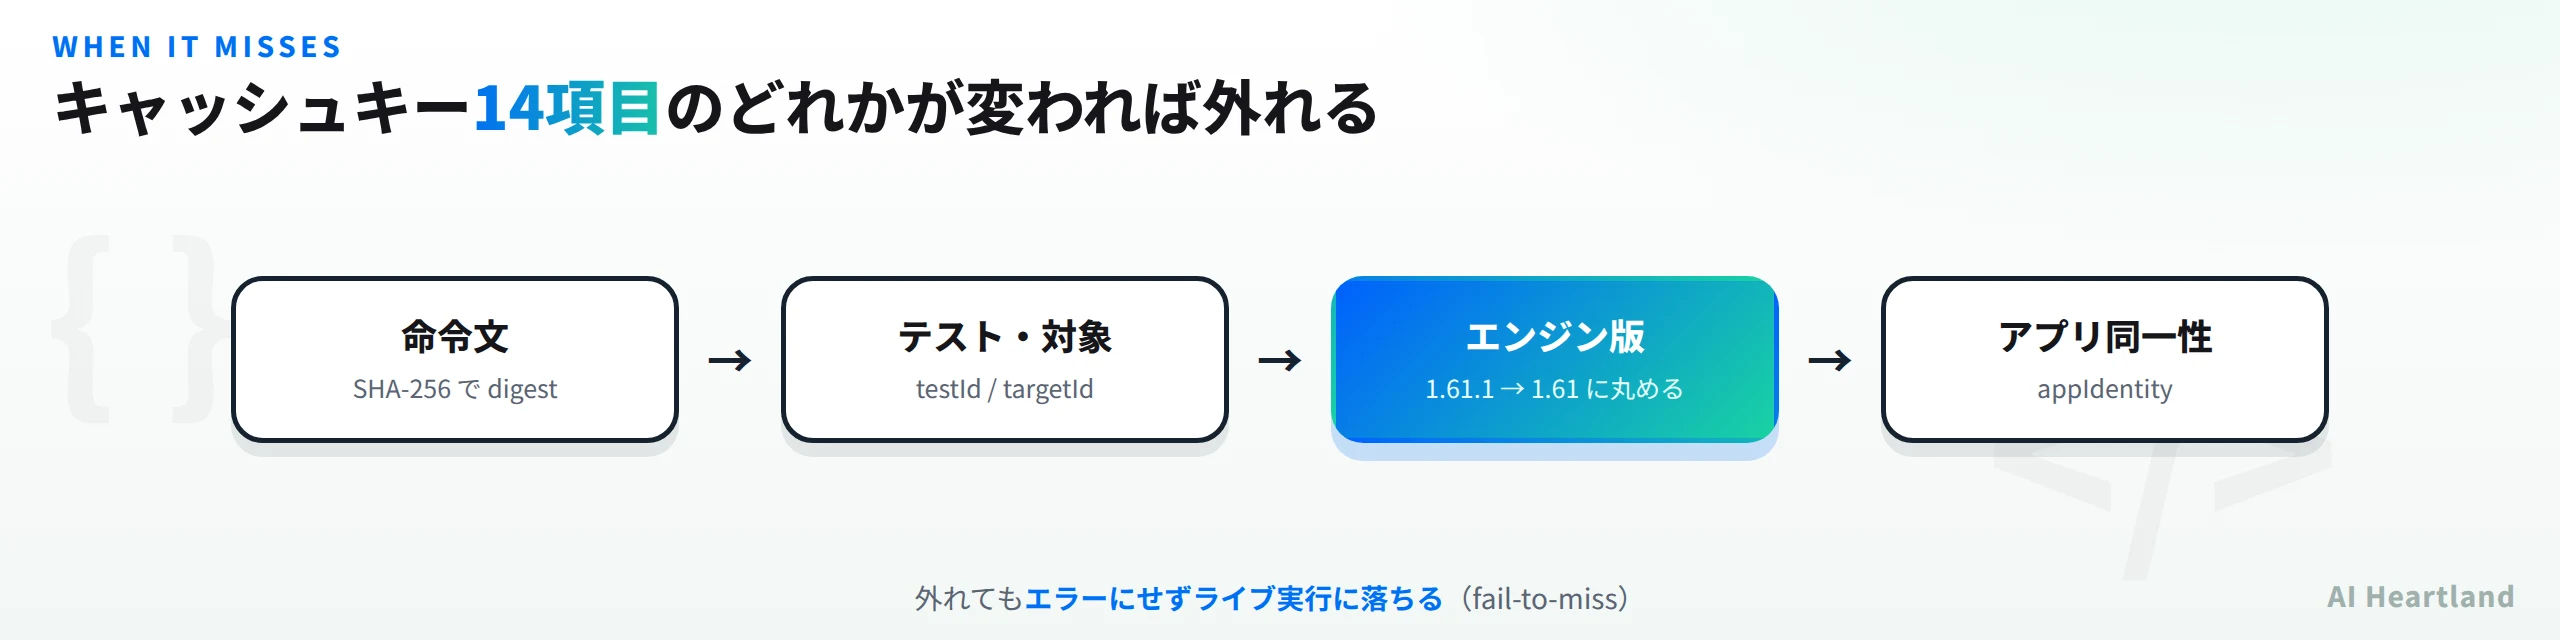
- ・外れる条件はキャッシュキーの **14項目**。命令文1語の差でも別エントリになる
- ・モデルに渡るのは **23個の道具**と4ノードの意味木だけ。セレクタもコードも書かせない
- ・テレメトリは**既定ON**。ただし止め方はREADMEの記載より多い(`DO_NOT_TRACK` も効く)
エージェント基盤全体の選び方はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその枝として、テスト実行という一点に絞った e2e を測る。
AI E2Eテストとは:目標はエージェントに、判定はコードに
まずテストの見た目を押さえる。READMEの例はこうなっている。
test('a member upgrades to Pro', async ({ app, agent, screen }) => {
  await app.open('/settings/billing');
  await agent.act('upgrade the workspace to the Pro plan');
  await agent.assert('the invoice preview shows a prorated amount');
  await expect(screen.getByRole('status')).toContainText('Pro');
});
役割が綺麗に割れている。agent.act が「どうやるか」を引き受け、expect が「どうなったら正解か」を固定する。画面のDOM構造が変わっても act の文言は変えなくていい一方、合否の基準は人間が書いたセレクタで決まる。
この分担が効くことを、筆者は意図せず実演してしまった。後述のスタブモデル実験で間違ったノードをタップさせたとき、エージェントステップ自体は成功扱い(✓)で通過したのに、テストは落ちた。
✓ agent upgrades the plan > agent.act "click the Upgrade button..." 3.13s · 2 model calls
× agent upgrades the plan 8.96s
  ASSERTION_FAILED: expect.toContainText failed
  expected: text containing "Pro"
  observed: text "Free" (match count 1)
エージェントが「やった」と報告した作業を、アサーションが「やれていない」と突き返している。自然言語テストで一番怖いのは、モデルが自己申告で成功を宣言して緑になることだ。e2e はその判定をモデルの外に置いている。
agent が持つメソッドは4つだけだった(packages/e2e/src/types.ts)。
・act(instruction):目標を1つ渡して複数操作を実行させる
・assert(assertion):画面についての問いをモデルに判定させる
・waitFor(condition):条件が真になるまで待つ
・extract(instruction, { schema }):画面から構造化データを取り出す
構成は6パッケージに分かれていて、それぞれ独立したバージョンが切られている(タグは計9本)。
| パッケージ | 役割 | 実測版 |
|---|---|---|
e2e |
SDK・ランナー・CLI | 0.15.2 |
@e2e-dev/web |
ブラウザエンジン(Playwright 経由で Chromium / Firefox / WebKit) | 0.11.1 |
@e2e-dev/mobile |
iOS・Android エンジン(agent-device 経由) |
0.9.0 |
@e2e-dev/github |
結果をPRコメントとして投稿するレポーター | 0.3.1 |
@e2e-dev/kernel |
Kernel のホスト型ブラウザ | 0.1.1 |
@e2e-dev/eas |
EAS Simulators のホスト型 iOS / Android | 0.2.0 |
本体とエンジンが分離しているのが要点で、e2e 本体はどのエンジンにも依存していない。エンジンは「自分に何ができるか」を宣言する仕組みになっていて、実行結果の report.json にそのまま記録されていた。
"engine": { "name": "web", "version": "0.11.1", "spiVersion": 1 },
"capabilities": ["actions","artifacts","browser","keyboard",
                 "location","observation","pointer","state"],
"artifactCapabilities": ["screenshot","trace","video"]
この宣言がモデルに渡す動詞の絞り込みにも効いている。ソース側の動詞定義は23語あるがモバイル専用のもの(dismissKeyboard・longPress など)を含んでおり、実際にWebエンジンで渡された一覧とは中身が違った。READMEの記述ではなく実行時の引数を数えないと、この手の数字は間違える。@e2e-dev/kernel と @e2e-dev/eas が薄い(0.1.x / 0.2.x)のは、ホスト型ブラウザの口が BrowserProvider インターフェースとして切られていて、各社向けの実装が小さく済むためだ。この構造なら、Playwright AI 的な層を自前のブラウザ基盤に載せ替えることもできる。
このうちキャッシュの対象は act だけだ。ソースのコメントに理由が書いてある。「assert は状態を変えてはならないので、その録画はアクション無しになる。判定は規範的ルールにより実行ごとに新しく行う」(cache/identity.ts)。操作は再利用するが、合否判定は毎回やり直すという切り分けになっている。
APIキー0本でどこまで動くか
「まず鍵なしでどこまで動くか」は、採用検討で最初に知りたいことだ。空の npm プロジェクトで試した。
npm install e2e        # 13.8秒・120パッケージ・node_modules 52MB
npx e2e init --yes     # 設定・雛形テスト・スキル・MCP設定を書き出す
npm audit は 0 vulnerabilities。npm 上の配布は 5,235,262 バイト・1,027ファイル(0.15.2、publish は 2026-10-02T10:21Z)。
init --yes が作ったものを数えると、設定ファイル e2e.config.ts、雛形テスト、.agents/skills/e2e/(9ファイル)、.claude/skills/e2e のシンボリックリンク、.mcp.json、.cursor/mcp.json、.gitignore への11エントリ追加だった。書き出し先はすべてプロジェクト配下で、ホームディレクトリは触っていない。
注目したいのは雛形テストの中身だ。
test('app opens', async ({ app, browser }) => {
  await app.open('/');
  await expect(browser.locator('body')).toBeVisible();
});
// With the model key in the environment, uncomment:
// test('the agent drives a flow', async ({ app, agent }) => { ...
エージェントステップがコメントアウトされている。既定の雛形はモデル無しで通る構成になっていて、鍵を入れた人だけがコメントを外す。README の「Tests without agent steps need no model」が、初期状態の設計そのものになっている。
実行してみると、当記事の環境ではブラウザ取得が外に出られず止まった。
ERROR  infrastructure error BROWSER_INSTALL_FAILED (launch)
playwright install chromium exited with code 1
エラーが infrastructure error と分類されている点に注意したい。テストの失敗(ASSERTION_FAILED)、設定の誤り(configuration error)、環境の問題(infrastructure error)が別物として扱われる。CI で「落ちた」を一括で扱わずに済む。
ここは環境側の制約(プロキシが cdn.playwright.dev を遮断)なので、同梱済みの Chromium を自分で起こして CDP で繋いだ。
chrome --headless=new --remote-debugging-port=9222 about:blank
engine: web({ connect: { cdpEndpoint: () => 'http://127.0.0.1:9222' } })
これで鍵0本のまま通った。
✓ |web| tests/example.e2e.ts (1 test) 949ms
  Test Files  1 passed (1)
逆にエージェントステップを鍵なしで回すと、こう止まる。
ERROR  configuration error MODEL_UNAVAILABLE
the agent fixture requires a model, and agents.default has none:
set model on it to an AI SDK model instance, e.g.
agents: { default: { model: gateway('openai/gpt-6-luna-fast') } }
エラーコードと直し方が同じ画面に出る。これも陰性対照として機能していて、「モデルが本当に必要なのはエージェントステップだけ」という主張を裏から確かめられた。
再生キャッシュを実測する:2回→0回、そして外れる条件
ここが本題だ。「モデル呼び出しなしで再生する」を信用するには、モデルが呼ばれた回数を外から数えるしかない。そこで AI SDK の仕様に沿ったスタブモデルを自作し、agents.default.model に差した。
export const stub = {
  specificationVersion: 'v2' as const,
  provider: 'stub', modelId: 'stub-recorder', supportedUrls: {},
  async doGenerate(options: any) {
    appendFileSync('/tmp/calls.log', 'called\n');   // 呼ばれたら必ず書く
    // 1手目: tap(n4) / 2手目: complete_step(passed)
  },
};
ポイントは appendFileSync だ。この関数に入ればログファイルが必ず生まれるので、「0回」を主張するときの陽性対照になる。ランナーの表示を信じるのではなく、ファイルの有無で確かめられる。
同じアプリ・同じテストに対して4通り試した。
| 試行 | 変えたもの | モデル呼び出し | ステップ時間 | ランナーの Cache 行 | スタブのログ |
|---|---|---|---|---|---|
| 1(コールド) | ― | 2回 | 1.11秒 | 1 missed |
2件 |
| 2(ウォーム) | 何も変えない | 0回 | 0.432秒 | 1 replayed |
生成されず |
| 3 | アプリのボタン文言 | 2回 | 15.45秒 | 1 missed |
2件 |
| 4 | 命令文を1語だけ | 2回 | 1.21秒 | 1 missed |
2件 |
試行2でログファイルそのものが作られなかった。doGenerate に一度も入っていないということで、README の主張の前半は確認できた。ステップは2.6倍速く、テスト全体では 1.58秒 → 0.955秒になった。録画は e2e cache stats で 1件・807バイトと出る。
主張の後半「until the app changes」も試行3で確認できた。ボタンの文言を Upgrade → Upgrade now に変えただけで外れ、モデルが呼び直されて録画も更新された。
ただしここは正直に書いておきたい数字がある。試行3は 15.45秒かかっていて、コールドの1.11秒より遅い。まず録画の再生を試し、記録されたアンカーの検証に失敗してからライブ実行に落ちるためだ。つまりキャッシュは「当たれば速い」が、「外れると通常より遅い」。画面を頻繁に変えている最中のブランチでは、キャッシュが足を引っ張る局面があり得る。
試行4も実務的に重要だ。命令文を the workspace → the account と1語変えただけで外れ、しかも古いエントリは消えずに2件目が書かれた(1.6 KiB)。命令文は SHA-256 のダイジェストとしてキーに入るので、表記ゆれがそのままエントリ数になる。e2e cache clear が用意されているのは、この蓄積を掃除するためだろう。
キーの設計は読んでみる価値がある。cache/identity.ts のコメントに意図が書かれていた。
・秘密値はキーに入らない。「秘密はその安定した名前と用途だけを寄与する」
・エンジン版は丸める。1.61.1 を 1.61 にする。理由も明記されていて「厳密なバージョンでキーを作るとパッチリリースのたびに全エントリがコールドスタートして何の利益も無かった」
・古いエントリは誤答にならない。「replay の挙動を変えうる全フィールドをキーに入れてあるので、古いエントリは必ずミスになり、誤った答えにはならない」
そしてキャッシュ判定の実装(cache/decide.ts)の冒頭にはこうある。「純粋かつ fail-to-miss:検証済みエントリが再生できない理由はすべてミスとなりライブ実行を呼ぶ。エラーにはならず、ステップの失敗にもならない」。キャッシュ層が壊れたときにテストを巻き込まない、という方針が型レベルで表現されている。ミスの語彙も5つに固定されていた(retry / no-entry / invalid-entry / truncated / wrong-context)。
モデルを呼ぶ"] B -- "ある" --> C{"14項目のキーが一致?"} C -- "不一致" --> L C -- "一致" --> D{"開始画面が同じ?"} D -- "違う" --> L D -- "同じ" --> R["録画を再生
モデル0回"] L --> S["アサーションが検証"] R --> S S --> W["検証済みなら録画を保存"]
モデルに渡るものを覗く:23個の道具と4ノードの意味木
スタブモデルを挟んだ副産物として、フレームワークがモデルに何を渡しているかをそのまま書き出せた。doGenerate が受け取った options をJSONに落としただけなので、推測は入っていない。
渡された道具は23個(Webエンジンの場合)。
back, check, complete_step, double_tap, drag, hover, hover_at, long_press,
navigate, observe, press, press_at, right_click, screenshot, scroll,
scroll_to, select, select_at, tap, tap_at, type, type_at, upload
tap の入力スキーマは { target: string } ひとつだけで、説明は「この会話のいずれかの画面に出ていて今も存在するノードid、例:"n42"」。モデルはセレクタもコードも書けない。固定された語彙から動詞を1つ選び、ノードidを1つ指すだけだ。
では画面はどう渡るのか。DOMダンプでもスクリーンショットでもなく、意味木だった。
Current screen (revision b2, path /, 4 nodes):
#root document "検証用ページ"
 #n2 heading "AI Heartland 検証用"
 #n3 status "Free"
 #n4 button "Upgrade"
4ノードのページが4行で表現されている。日本語もそのまま通っている。プロンプトには「ノードは "n42" のような安定したidを持ち、存在する限り全画面・全変更を通じてidを保つ」と書かれていた。トークン消費が画面の複雑さにではなく、操作可能な要素の数に比例する設計で、DOM全文を投げる方式より桁で軽い。
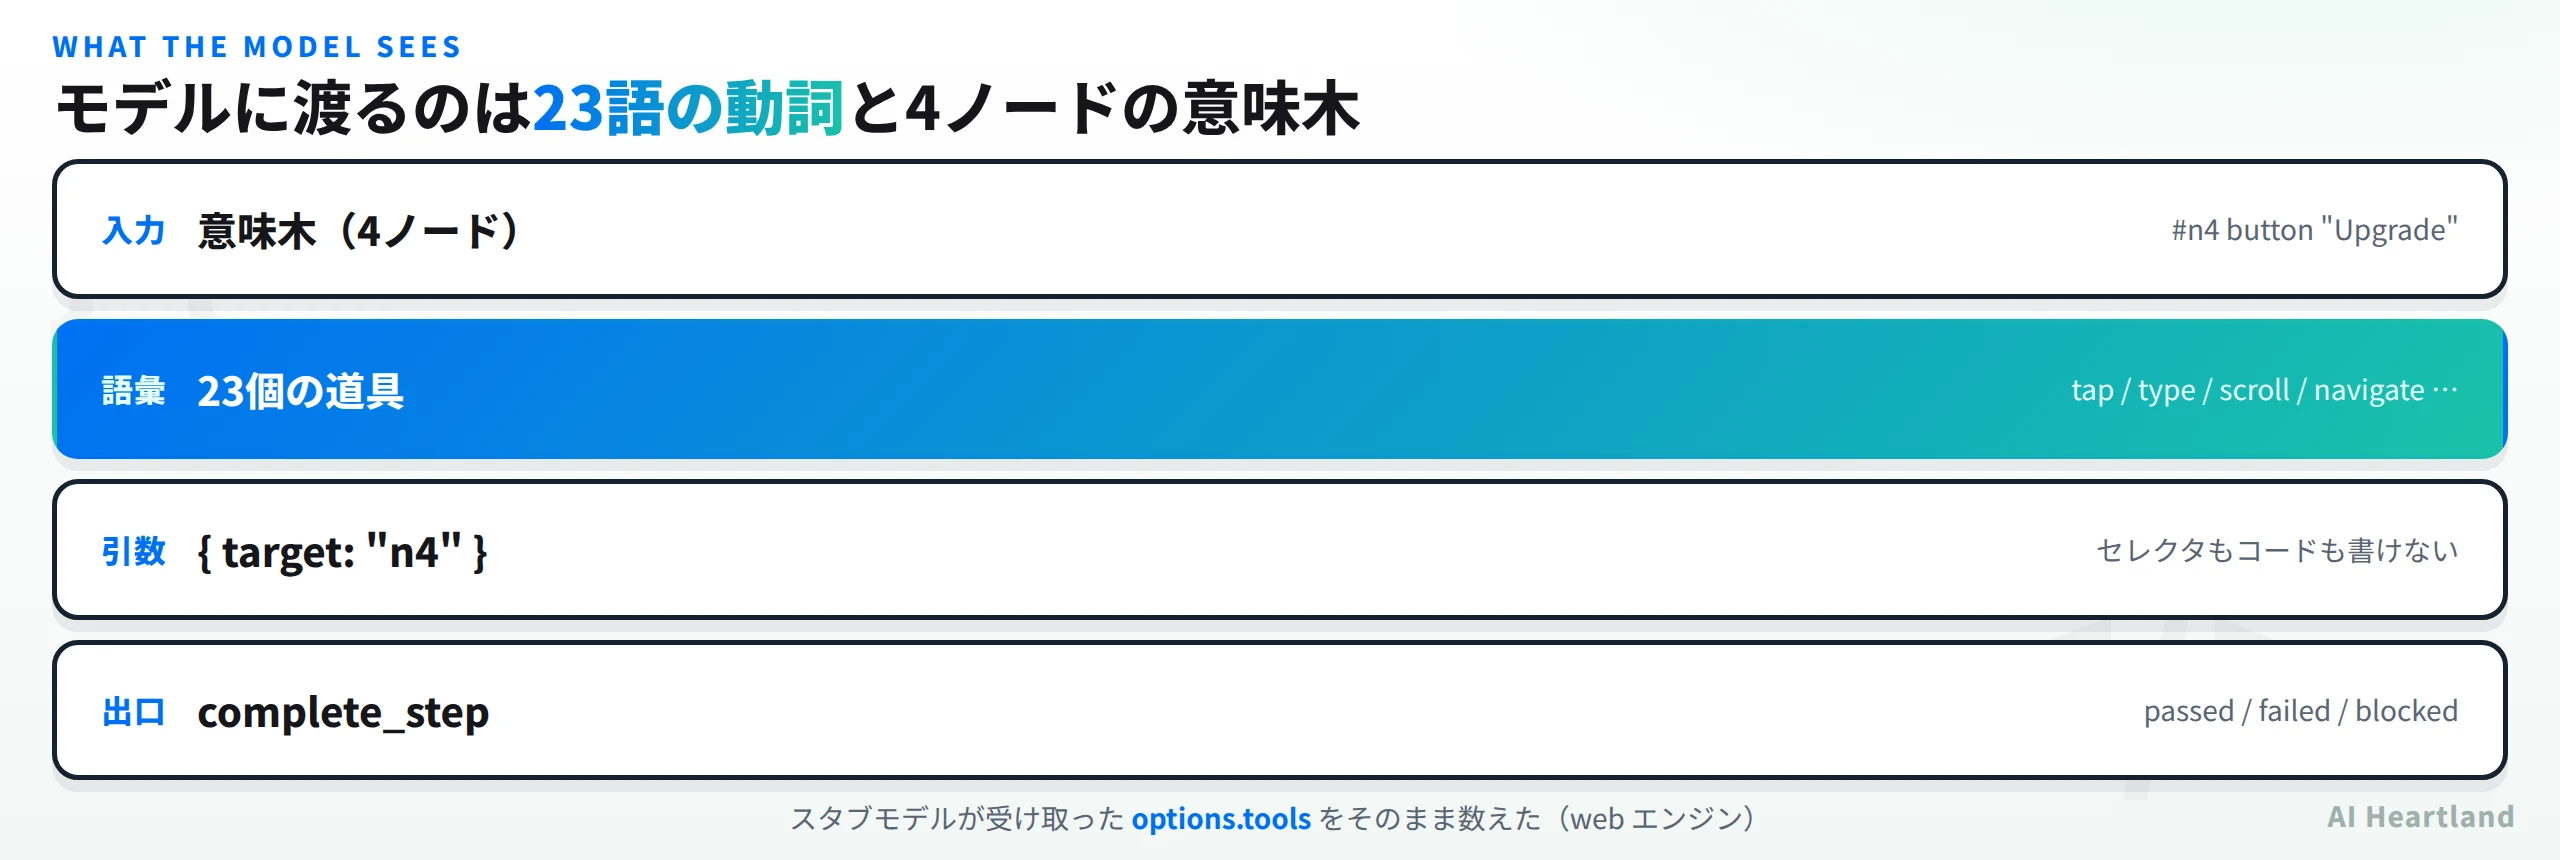
出口の complete_step も作りが細かい。status は passed / failed / blocked の3値、summary は1〜3文で400字未満という指示つき。そして errorCode には13語の enum が与えられていた。フレームワーク全体のエラーコードは26語あるのに、モデルに選ばせるのはその半分だけだ。残りの CONTEXT_OVERFLOW・STEP_TIMEOUT・REPLAY_STALE などはランナー側が事実として決める値で、モデルの判断に委ねていない。
もう一つ実測で分かったのが暴走の止め方だ。筆者が最初に書いたスタブは complete_step のスキーマを間違えていて、延々とループした。結果はこうなった。
STEP_NO_CONCLUSION: agent.act failed:
the agent used 25 of 25 turn(s) without calling complete_step
AI  50 tokens · 25 model calls
既定のステップあたり上限は25回で、そこで打ち切られる。無限ループにも青天井の課金にもならない。
コーディングエージェント向けの同梱物
e2e は人間向けのCLI(13コマンド)とは別に、コーディングエージェント向けの入口を3つ配っている。
1つめは Agent Skill だ。init が .agents/skills/e2e/ に展開し、.claude/skills/e2e からシンボリックリンクを張る。中身は SKILL.md 152行と references 8本で計1,978行。
常駐コストを測ってみた(tools/token_audit.py と同じ heuristic-jp-v1:CJK 1文字=1トークン、それ以外4文字=1トークン)。
| 読み込む範囲 | トークン |
|---|---|
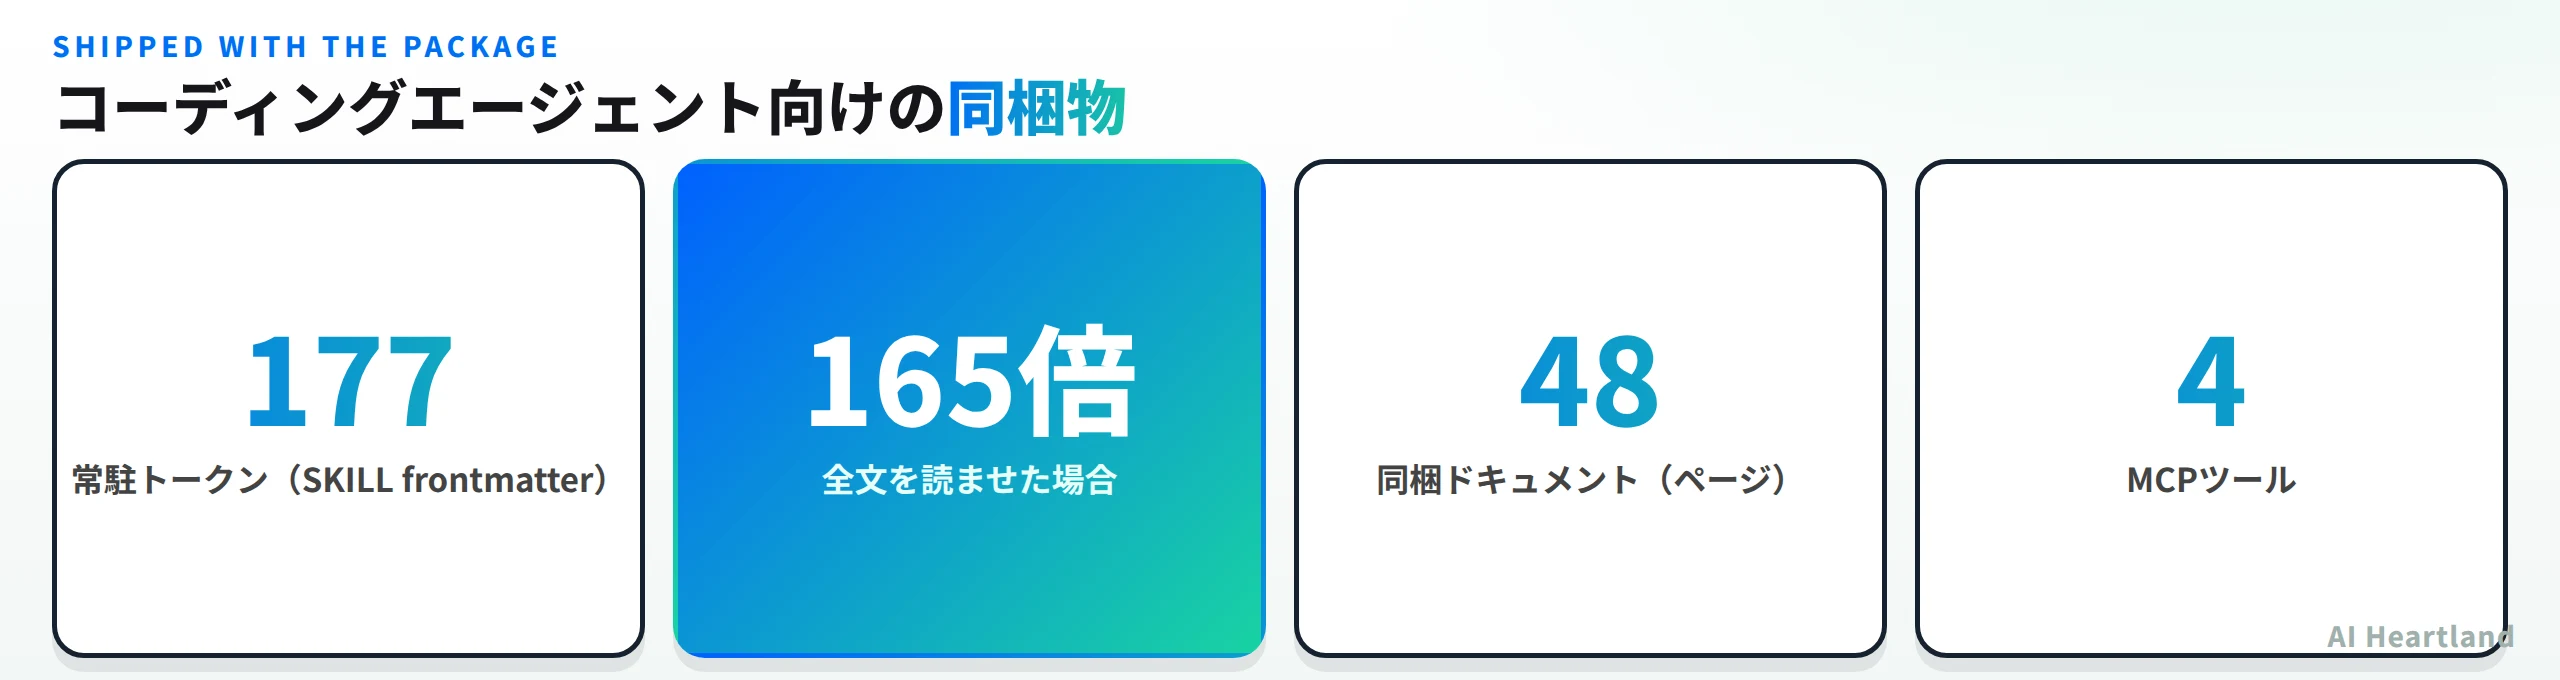
| frontmatter(name + description)だけ | 177 |
| SKILL.md 本体まで | 1,985 |
| references 8本すべて | 27,084 |
| 全部合計 | 29,248 |
常駐177トークンに対して全文は165倍。Agent Skills の progressive disclosure が効く比率が、実物でこの数字になる。スキルの書き方そのものはAgent Skillsの書き方側で扱ったが、こうしてライブラリが自分の使い方を同梱して配るのは素直な応用例だ。
2つめは MCP サーバーで、npx e2e mcp が立つ。プロトコルを直接叩いて確認したところ、公開ツールは4つだけだった。
open_session, tools, call, close_session
23個の動詞を全部 MCP ツールとして並べるのではなく、tools で一覧を取り call で呼ぶ二段構えにしている。コーディングエージェント側のツール一覧を4つで済ませる設計で、常駐コストを抑える狙いが見える。
3つめはドキュメント同梱だ。READMEは「e2e パッケージは全ページを同梱するので、コーディングエージェントは node_modules/e2e/docs でオフラインで読める」と書いている。数えたところ、同梱48ページ・リポジトリ側も48ページで完全に一致した。看板に誇張はない。
テレメトリは既定ONだが、止め方はREADMEより多い
READMEは率直に書いている。「CLIは匿名の利用データを送る。どのコマンドとエンジンが動いたか、どこで失敗したかなど。テスト内容・アプリの内容・認証情報は送らない。npx e2e telemetry disable か E2E_TELEMETRY_DISABLED=1 で停止できる」。
既定が ON なのは事実だった。環境変数を5通り試した結果が次の表だ。
| 設定 | e2e telemetry の表示 |
|---|---|
| 無設定 | Status: enabled |
E2E_TELEMETRY_DISABLED=1 |
Status: disabled (E2E_TELEMETRY_DISABLED is set) |
E2E_TELEMETRY_DISABLED=0 |
Status: enabled |
DO_NOT_TRACK=1 |
Status: disabled (DO_NOT_TRACK is set) |
DO_NOT_TRACK=0 |
Status: enabled |
READMEに書かれていない DO_NOT_TRACK が効く。ツール横断の標準的な opt-out 変数で、ソースを読むと停止理由は5種類定義されていた(E2E_TELEMETRY_DISABLED / DO_NOT_TRACK / checkout / preference / store)。checkout は「リポジトリのソースチェックアウトから動かしている場合」で、コントリビューターは既定で送信対象外になる。
判定ロジックも確認した(internal/env.ts)。
return value !== undefined && value !== '0' && value !== 'false';
0 と false を「設定されていない」として扱う。DO_NOT_TRACK=0 で停止してしまう実装は世の中にあるので、ここが素直なのは好ましい。送信先は https://eu.i.posthog.com(PostHog の EU リージョン)だった。
そして停止判定は送信の直前に置かれている。telemetry.ts の送信系メソッド3箇所すべてが冒頭で if (!this.enabled) return; を通る。初期化時に一度だけ読む実装だと環境変数を後から設定しても効かないことがあるが、ここはその心配がない。
AI E2Eテストの導入判断:効く場面と、まだ測れていないところ
測った範囲で評価する。
効く場面
・画面構造の変更が多く、セレクタの書き直しが負担になっているプロジェクト。手順をエージェントに預け、合否だけ expect で固定できる
・CI でコストが読めないのが導入障壁になっている場合。録画をコミットすれば、変更がない限りモデル呼び出しは0になる
・コーディングエージェントにテストを書かせたい場合。スキル・MCP・48ページのドキュメントが最初から揃っている
慎重に見るべき点
・0.15.2 でありREADME自身が「APIと設定はマイナーリリース間で変わりうる」と明示している。1.0 前提で設計すべきではない
・キャッシュが外れたときは通常より遅い(当記事の計測で 1.11秒 → 15.45秒)。画面を頻繁に変える期間は恩恵が反転する
・命令文の表記ゆれがそのままエントリ数になる。チーム内で文言を揃える運用が要る
・録画のコミットは opt-in(init が .e2e/cache/ を gitignore に入れる)。CI で効かせるには別途判断が要る
当記事で未検証のまま残した部分
・モバイルエンジン(@e2e-dev/mobile、[email protected] 依存)。iOS Simulator も Android Emulator も当環境に無く、一切動かしていない
・実モデルでの精度。動かしたのは自作スタブなので、本物のモデルが23個の動詞をどれだけ正しく選ぶかは測っていない。キャッシュの仕組みは確認したが、録画される操作の質はモデル依存で、そこは別の検証が要る
・ホスト型ブラウザ(@e2e-dev/kernel、@e2e-dev/eas)。外部サービスの契約が要るため未実行
・e2e explore(目標を渡して探索的にバグを探す)と e2e login(ChatGPT・GitHub Copilot・SuperGrok のサブスクリプション連携)。いずれもモデルが要るため未実行
エージェントにブラウザを操作させる方向性そのものはBrowser Use系の系譜にあるが、e2e はテストという用途に絞ったうえで「合否判定だけはモデルの外に置く」という線の引き方をしている。同じくPython側で型つき出力を軸に据えたPydantic AIと並べると、「モデルの出力をどこで固定するか」という共通の問題に、別のレイヤーから答えているのが見えて面白い。
参照ソース
・tester-army/e2e — GitHubリポジトリ(⭐1,280・fork 41・open issues 27件(PRを含む)、2026-10-02時点)
・e2e — npm(0.15.2、unpackedSize 5,235,262 B / 1,027ファイル)
・e2e ドキュメント
・LICENSE(Apache License 2.0)(実体ファイルの先頭2行を確認)
本記事の計測レコードは data/measurements/runs/2026-10-02-e2e-tester-army.json に8件登録した。