humanlayer/skills は、HumanLayer が公開している Claude Code 向けのスキル集だ。⭐4,729・MIT。plugins/ 配下に6つしかない。だが中の1本、improve-claude-md が扱っている問題が、この記事を書くきっかけになった——CLAUDE.md は、無関係な記述が多いほど全体が無視されやすい。当サイトのCLAUDE.mdは毎ターン読み込まれる5,633トークンの塊なので、他人事ではない。
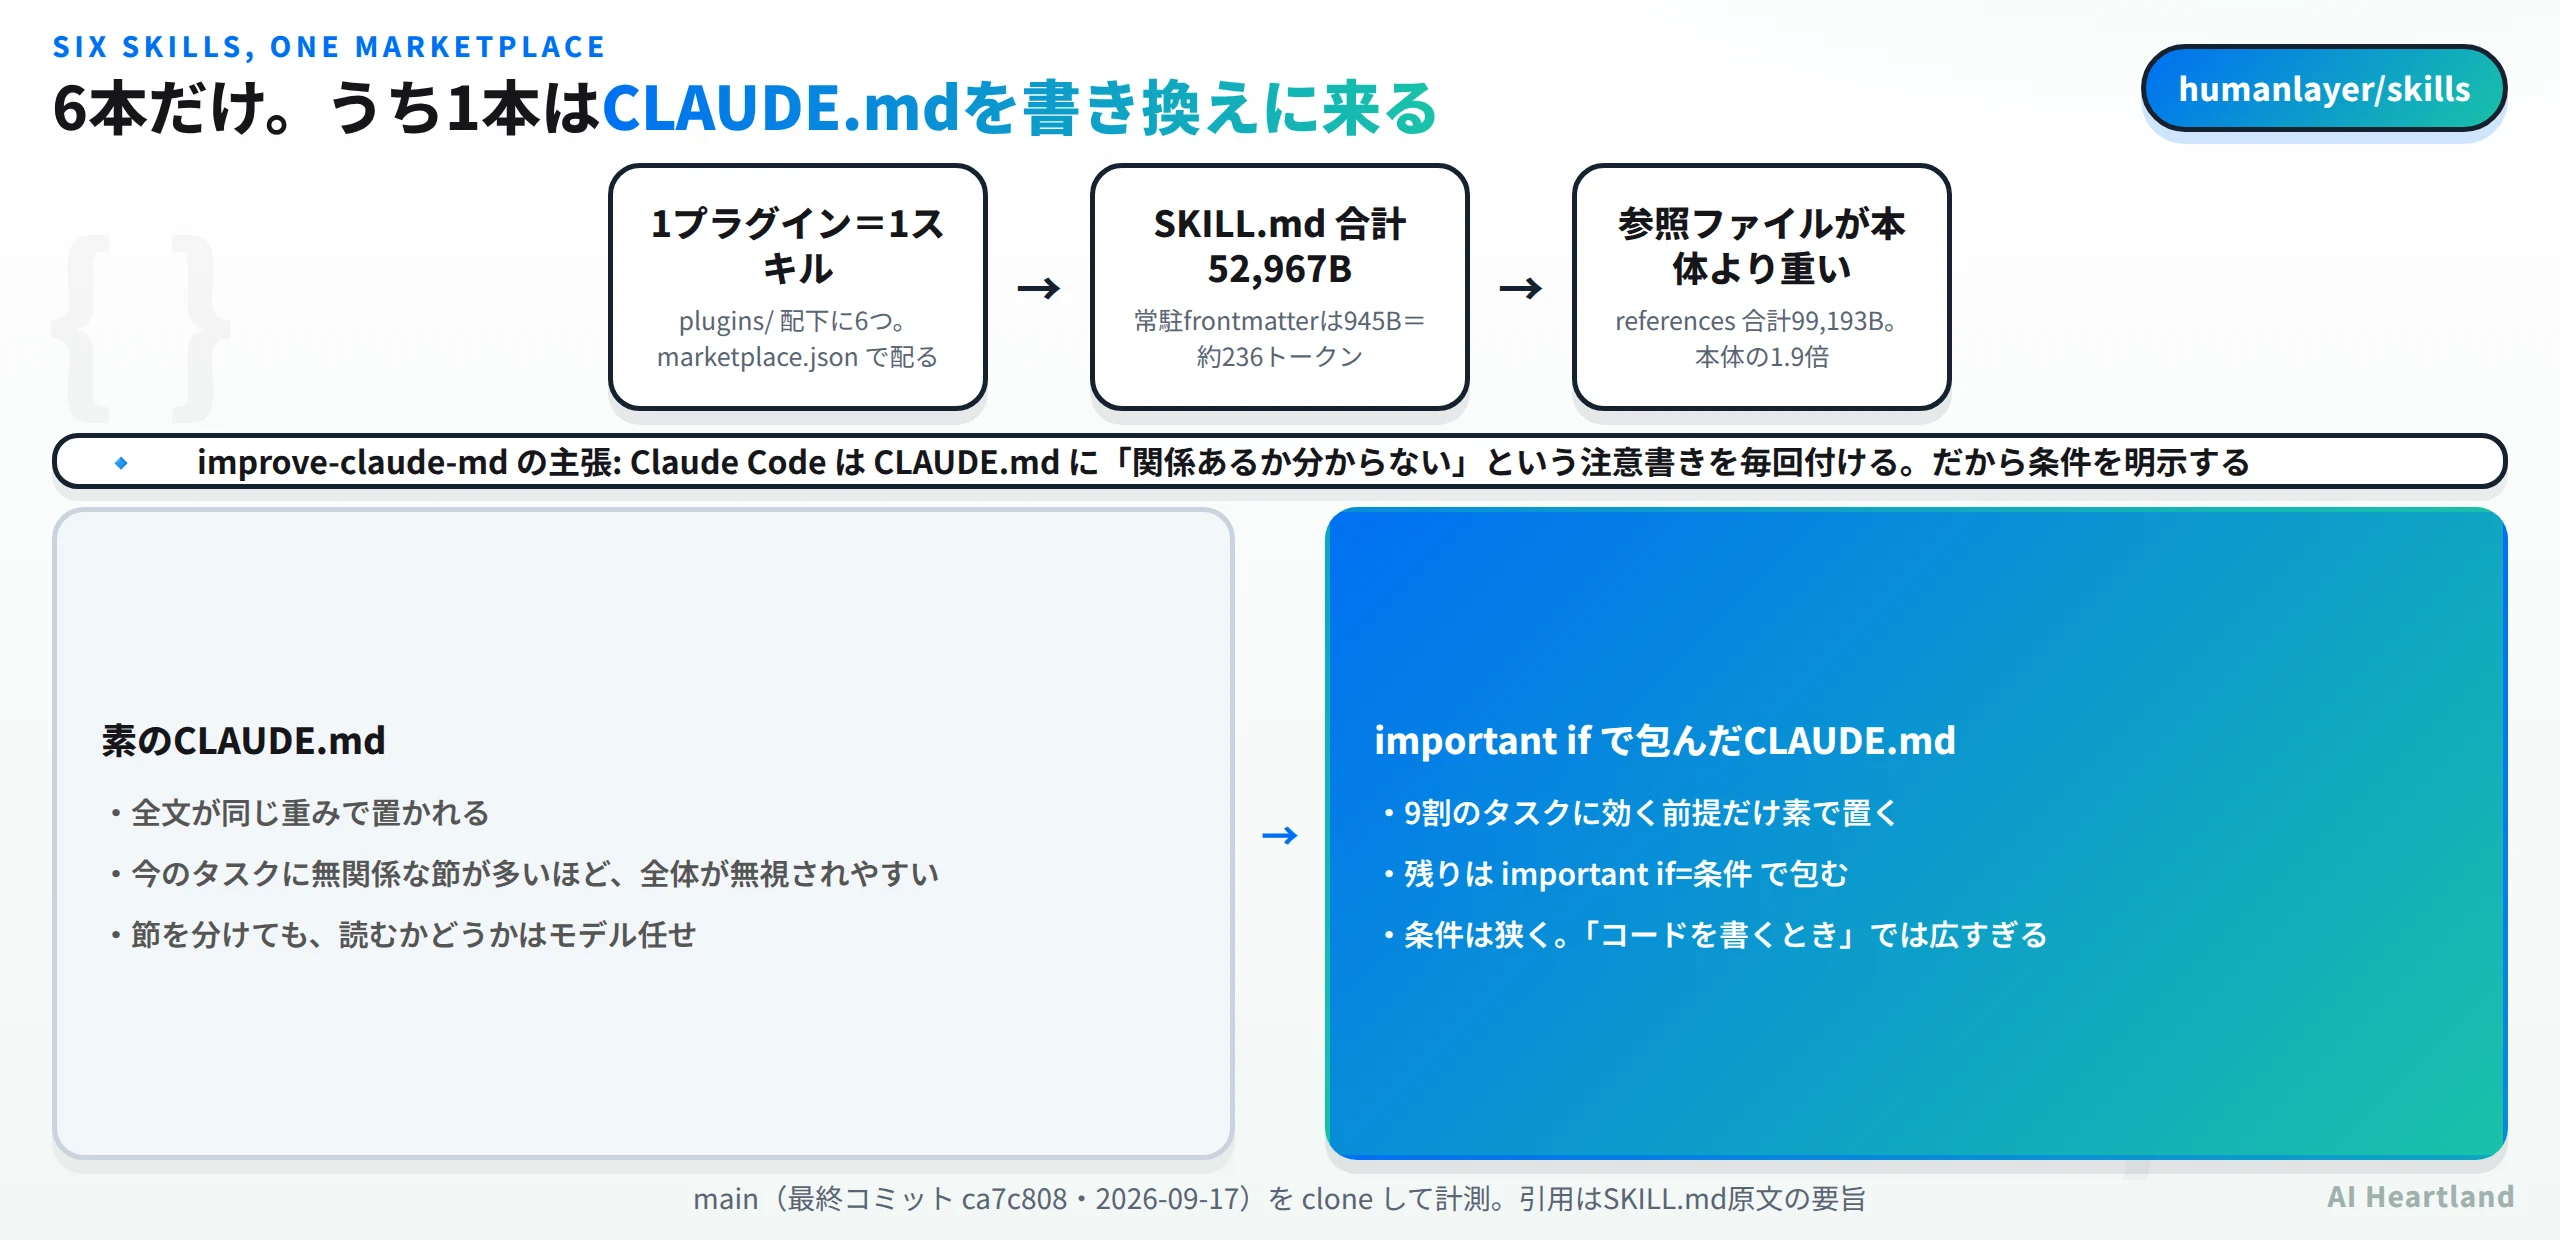
- ・**1プラグイン=1スキル**が6つ。`.claude-plugin/marketplace.json` でマーケットプレイスとしても配られる
- ・SKILL.md 6本で **52,967バイト**。常駐するfrontmatterは **945バイト=約236トークン**と極小
- ・重いのは本体ではなく **参照ファイル99,193バイト**(本体の1.87倍)
- ・**自動起動を止める書き方が3通り混在**(フラグ/Codex用YAML/説明文そのもの)
- ・**`improve-claude-md`** は CLAUDE.md を `important if` の条件付きブロックに組み直す
- ・ループ系2本の共有テンプレ8本のうち **4本はすでに乖離**(`workflow-template.yml` は112行差)
エージェント設計の全体像はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその枝として、「エージェントに渡す指示そのものをどう構造化するか」を扱う。
humanlayer/skillsとは:6本しかない代わりに1本が重い
リポジトリの最終コミットは 2026-09-17 の ca7c808。構成は素直で、plugins/<名前>/skills/<名前>/SKILL.md が6組あり、ルートの .claude-plugin/marketplace.json が6つをプラグインとして列挙している。READMEが案内する導入は npx skills add humanlayer/skills --skill SKILLNAME の1行だ。
6本の内訳はこうなる。
| スキル | 役割 | 本体 | 参照ファイル |
|---|---|---|---|
design-control-loop |
制御ループを聞き取りで設計して作る | 15,495B | 10本・46,384B |
build-iterated-agentic-loop |
反復するエージェントのワークフローを組む | 13,553B | 8本・34,175B |
improve-claude-md |
CLAUDE.mdを条件付きに書き換える | 9,450B | なし |
narrow-react-prop-types |
React の prop 型を実際の使われ方に絞る | 7,764B | 3本・13,195B |
visual-pr |
PR説明を視覚的な要約つきで書く | 3,377B | 3本・5,439B |
show-me |
いまの話題を図・擬似コード・ツリーで見せる | 3,328B | agents/openai.yaml 1本 |
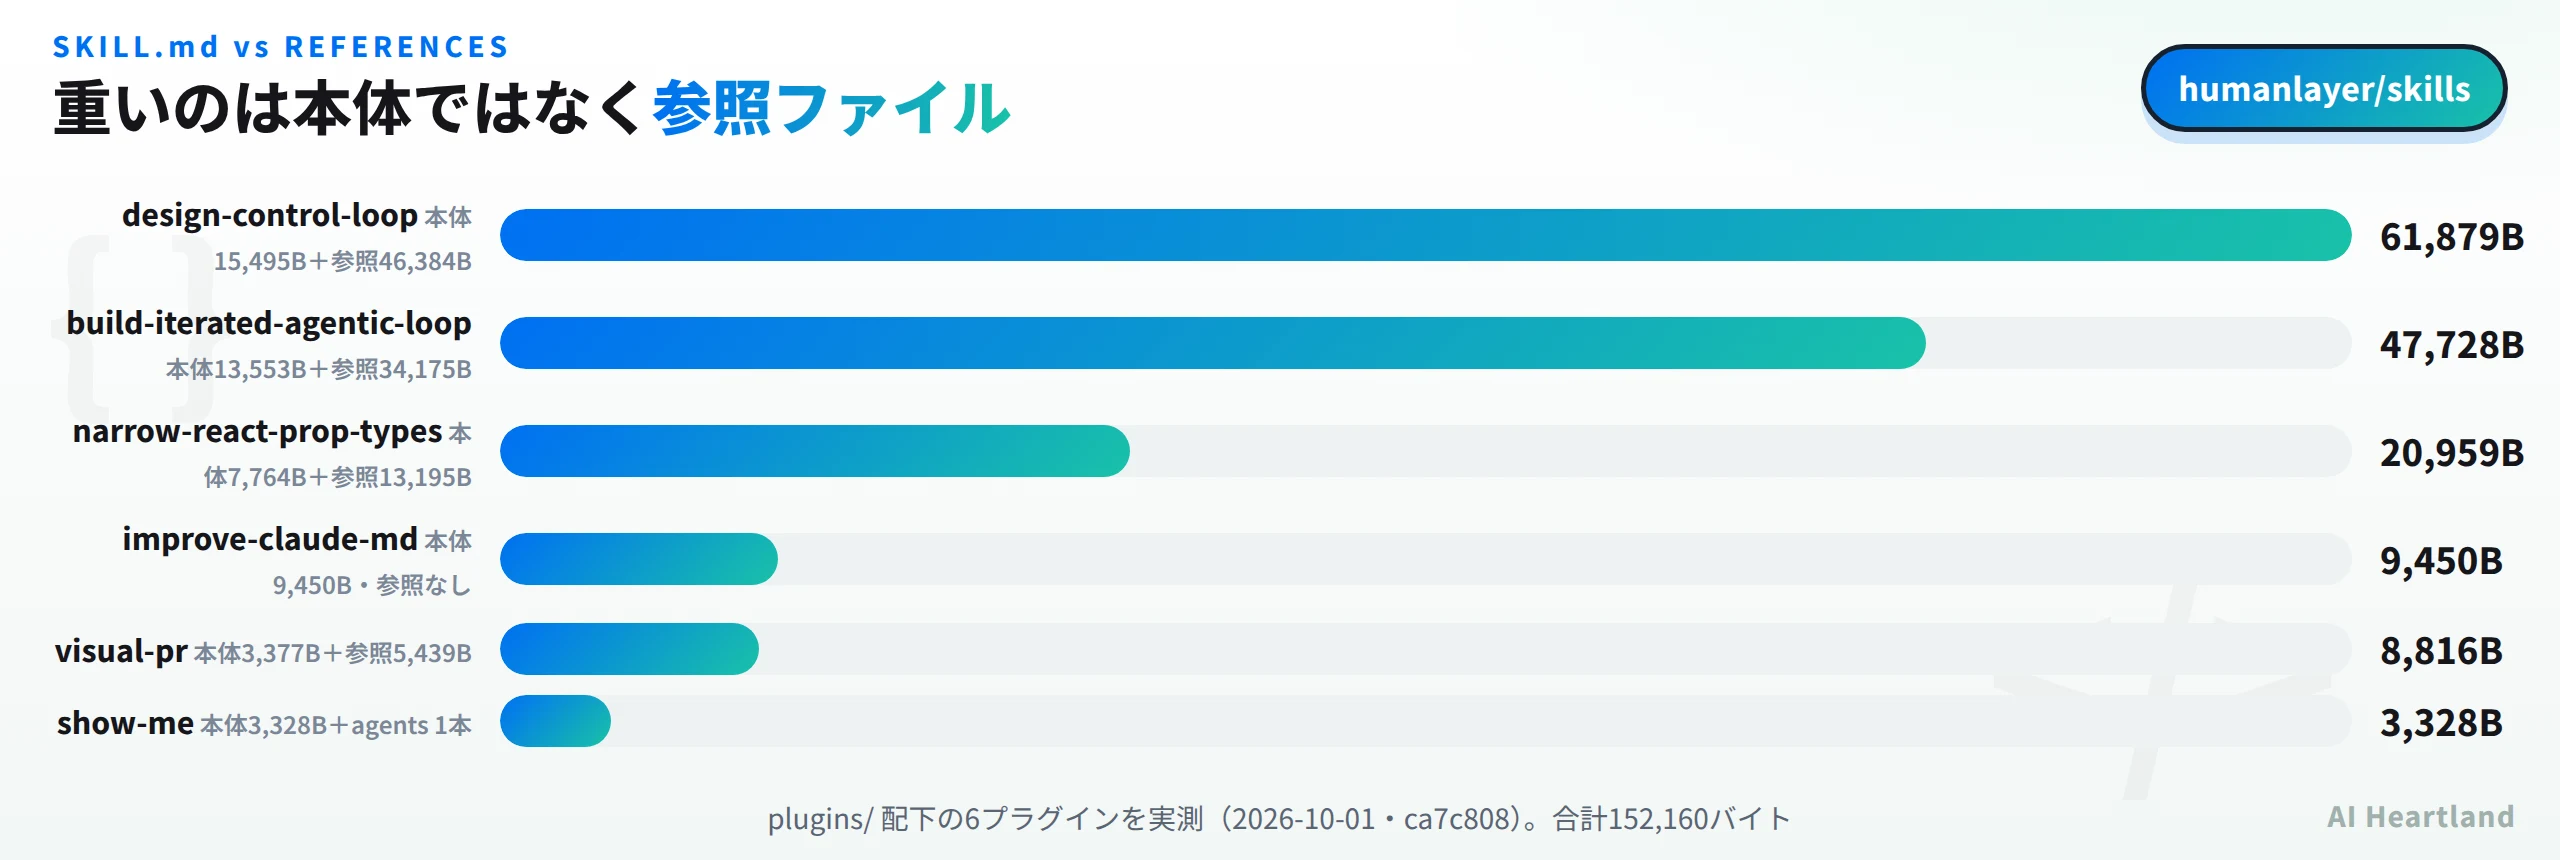
数として効いているのは参照ファイルだ。SKILL.md 本体の合計が52,967バイトなのに対し、references/ の合計は 99,193バイトで 1.87倍。Agent Skills の段階的開示は「本体を薄く、参照を厚く」という形で設計できるが、このリポジトリはそれを素直に実践している。常駐するfrontmatterは6本合わせて945バイト、約236トークン(当サイトの tools/token_audit.py が使う heuristic 近似・CJK 1字=1 / ASCII 4字=1。tiktoken の cl100k_base はBPE辞書の取得がこの環境の外向き通信で遮断され使えなかった)。入れっぱなしのコストとしては、同じ日に測ったBuilderIO/skillsとは|24本の実体と/visual-editを実際に入れて配布版との差を実測の1,769トークンの7分の1程度だ。
「勝手に起動させない」書き方が3通り混ざっている
6本のfrontmatterと agents/ をすべて開いて分かったのが、自動起動を止める書き方が統一されていないことだった。
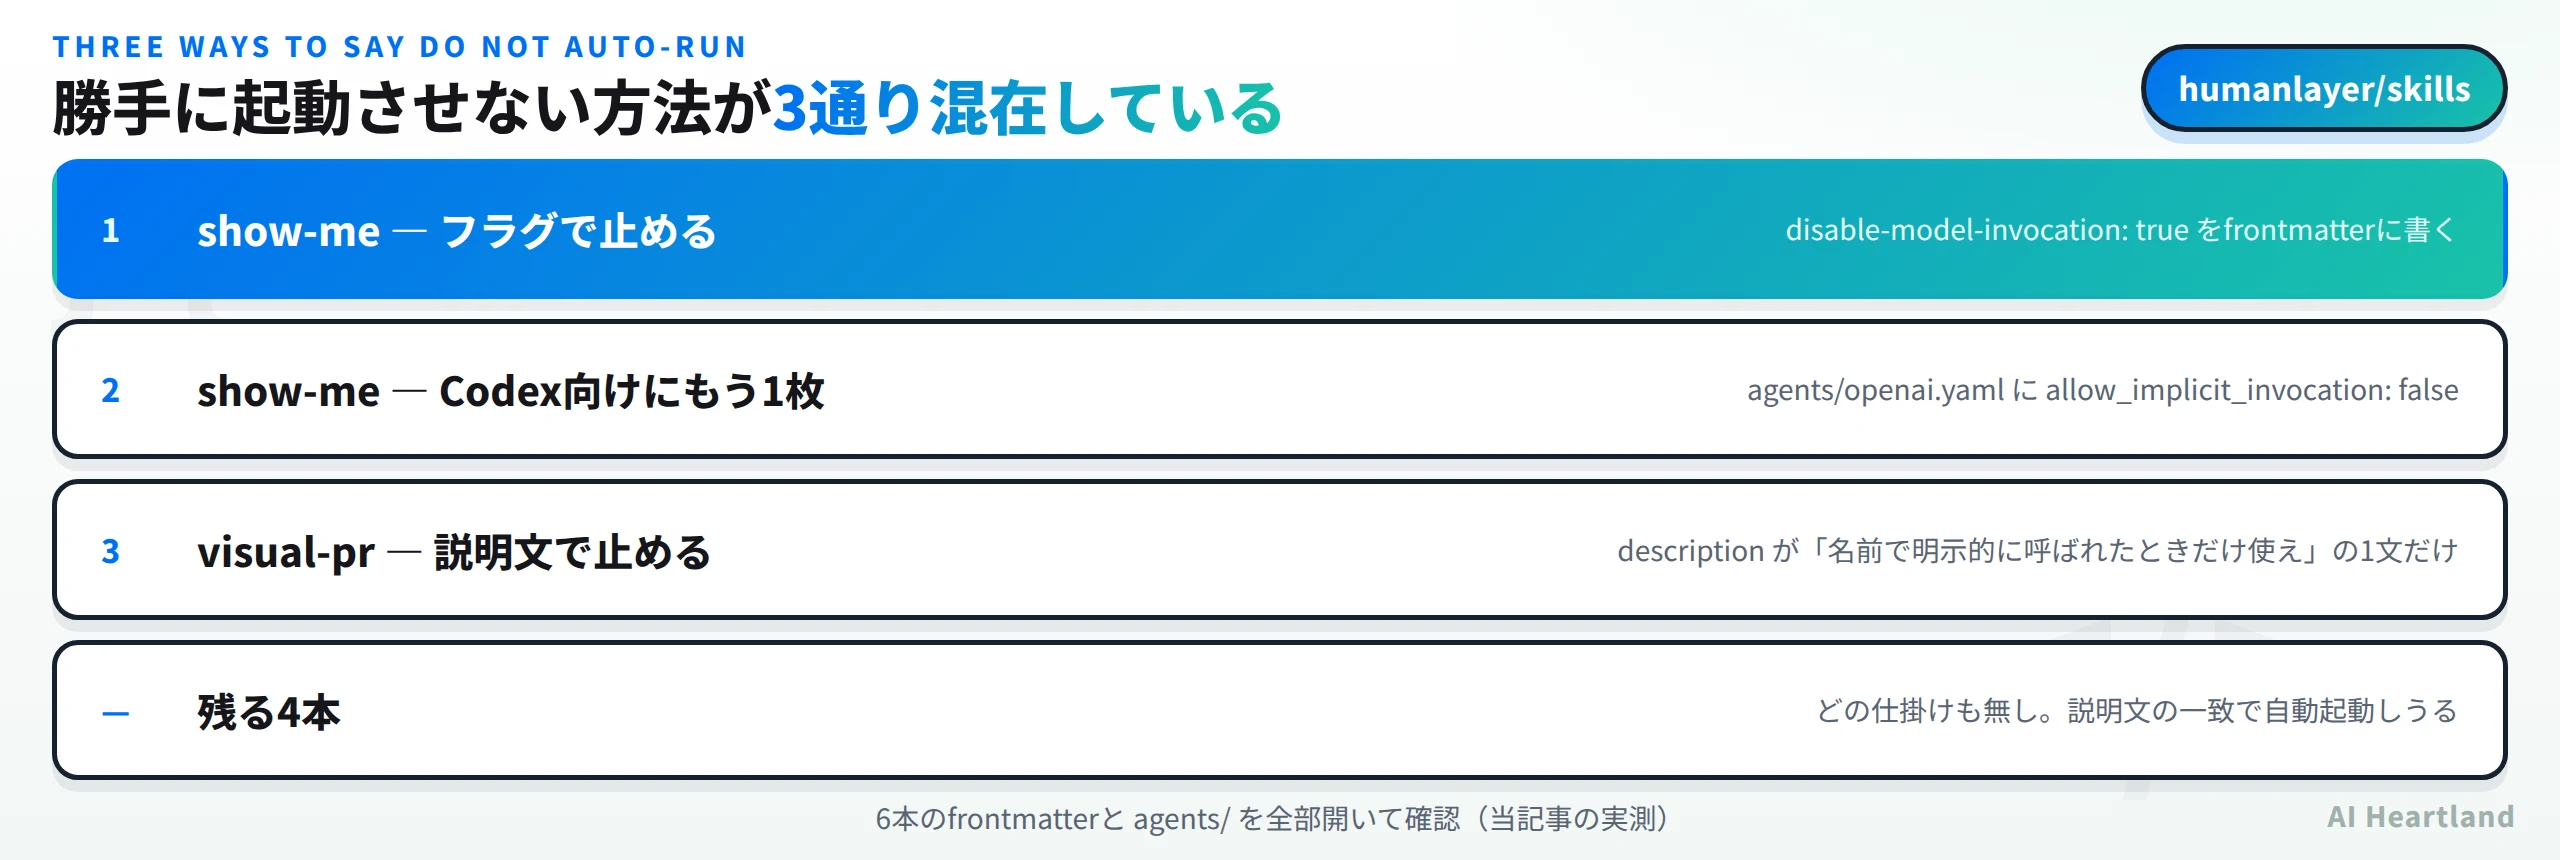
show-me は 2枚重ねだ。frontmatter に disable-model-invocation: true を書いたうえで、agents/openai.yaml という別ファイルを置いている。中身はこれだけ。
policy:
  allow_implicit_invocation: false
つまり Claude 系のフラグと、OpenAI/Codex 系のポリシーの両方に「暗黙に呼ぶな」と書いてある。スキルが複数のエージェント基盤にまたがって配られるとき、止める意思も基盤の数だけ書く必要があるという実例だ。
visual-pr は違う手を使う。フラグは無く、description が丸ごとこの1文になっている——「Only use when the user explicitly invokes this skill by name.(ユーザーがこのスキルを名前で明示的に呼んだときだけ使え)」。説明文は本来「いつ使うか」をモデルに判断させるための欄なので、そこを門番として使っているわけだ。フラグより緩いが、説明文だけを読む段階で効く。
残る4本には仕掛けが無い。improve-claude-md の description は「improve a CLAUDE.md file using <important if> blocks to improve instruction adherence」で、CLAUDE.md の話題が出れば発火しうる。自動起動の考え方はpstackの検証スキルとは|エージェントに自分の作業を証明させる2本をソースで読むが47本中46本を止めていたのと対照的で、6本しかないぶん、どれが自分から動くかを把握しやすいとも言える。
improve-claude-md が言っていること
本題のスキルを読む。出発点はこう書かれている。
Claude Code は CLAUDE.md を渡すたびにシステムリマインダを添えて、「このコンテキストは、あなたのタスクに関係するかもしれないし、しないかもしれない。高度に関係する場合を除いて、このコンテキストに反応すべきではない」と伝える。
この注意書きがあるため、いまのタスクに当てはまらない記述が多いほど、CLAUDE.md 全体が無視されやすくなる、というのがスキルの主張だ。解決策として提示されるのが、条件付きの節を <important if="条件"> というXMLタグで包むこと。Claude Code 自身のシステムプロンプトが使っているXMLタグの型を借りて、「関係あるかもしれない」という枠を突き抜ける明示的な関連性の合図を与える、と説明されている。
書き方の原則として挙がっているのは5つ。
・1. 基礎的な文脈は素のまま、領域別の指針だけ包む。プロジェクトの正体・ディレクトリ構成・技術スタックのような「ほぼ全タスクで要るもの」は素のマークダウンで先頭に置く。目安は9割以上のタスクに関係するなら素のまま
・2. 条件は具体的かつ狭く。「コードを書くとき」は広すぎる悪い例として名指しされている。良い例は「import を足したり直したりするとき」「新しいコンポーネントを作るとき」のように、ルール1つごとに固有の引き金を持つ形
・3. 分割しすぎない。ツール呼び出しで探しにいく必要がある別ファイルへ切り出すのは、よほど分量が多い場合だけ。全部インラインに置いたまま重みだけ条件で変えるのが狙いだから
・4. 少ないほうが良い。リンタ・フォーマッタ・pre-commit フックで強制できる指示は消す。コードベースを数回検索すれば分かるパターンも消す(LLMは文脈内学習をする)。コードスニペットも消してファイルパス参照に置き換える
・5. コマンドだけは全部残す。コマンド表は基礎的なリファレンスなので、使用頻度が低くても落とさない
適用手順は9ステップで、「プロジェクトの正体を1文にして素のまま置く」「ディレクトリマップを素のまま残す」「コマンドは全部残して1つのブロックに包む」「ルールの箇条書きは個別のブロックに割る(無関係なルールを1つの広い条件でまとめるのは禁止)」「リンタの領分を消す」「曖昧な指示——『Xエージェントを活用する』『ベストプラクティスに従う』のような、具体でも実行可能でもないもの——を消す」と続く。最後の1つは、指示ファイルを書いたことがある人なら耳が痛い。
当サイトのCLAUDE.mdに当てるとどうなるか
規則が具体的なので、自分のファイルで試算してみた。当サイトのCLAUDE.mdは18,463バイト・127行・H2が14節で、tools/token_audit.py の見積もりで 5,633トークン。毎ターン読み込まれる固定コンテキストとして、リポジトリのルールで12,000トークンの上限が引かれている。
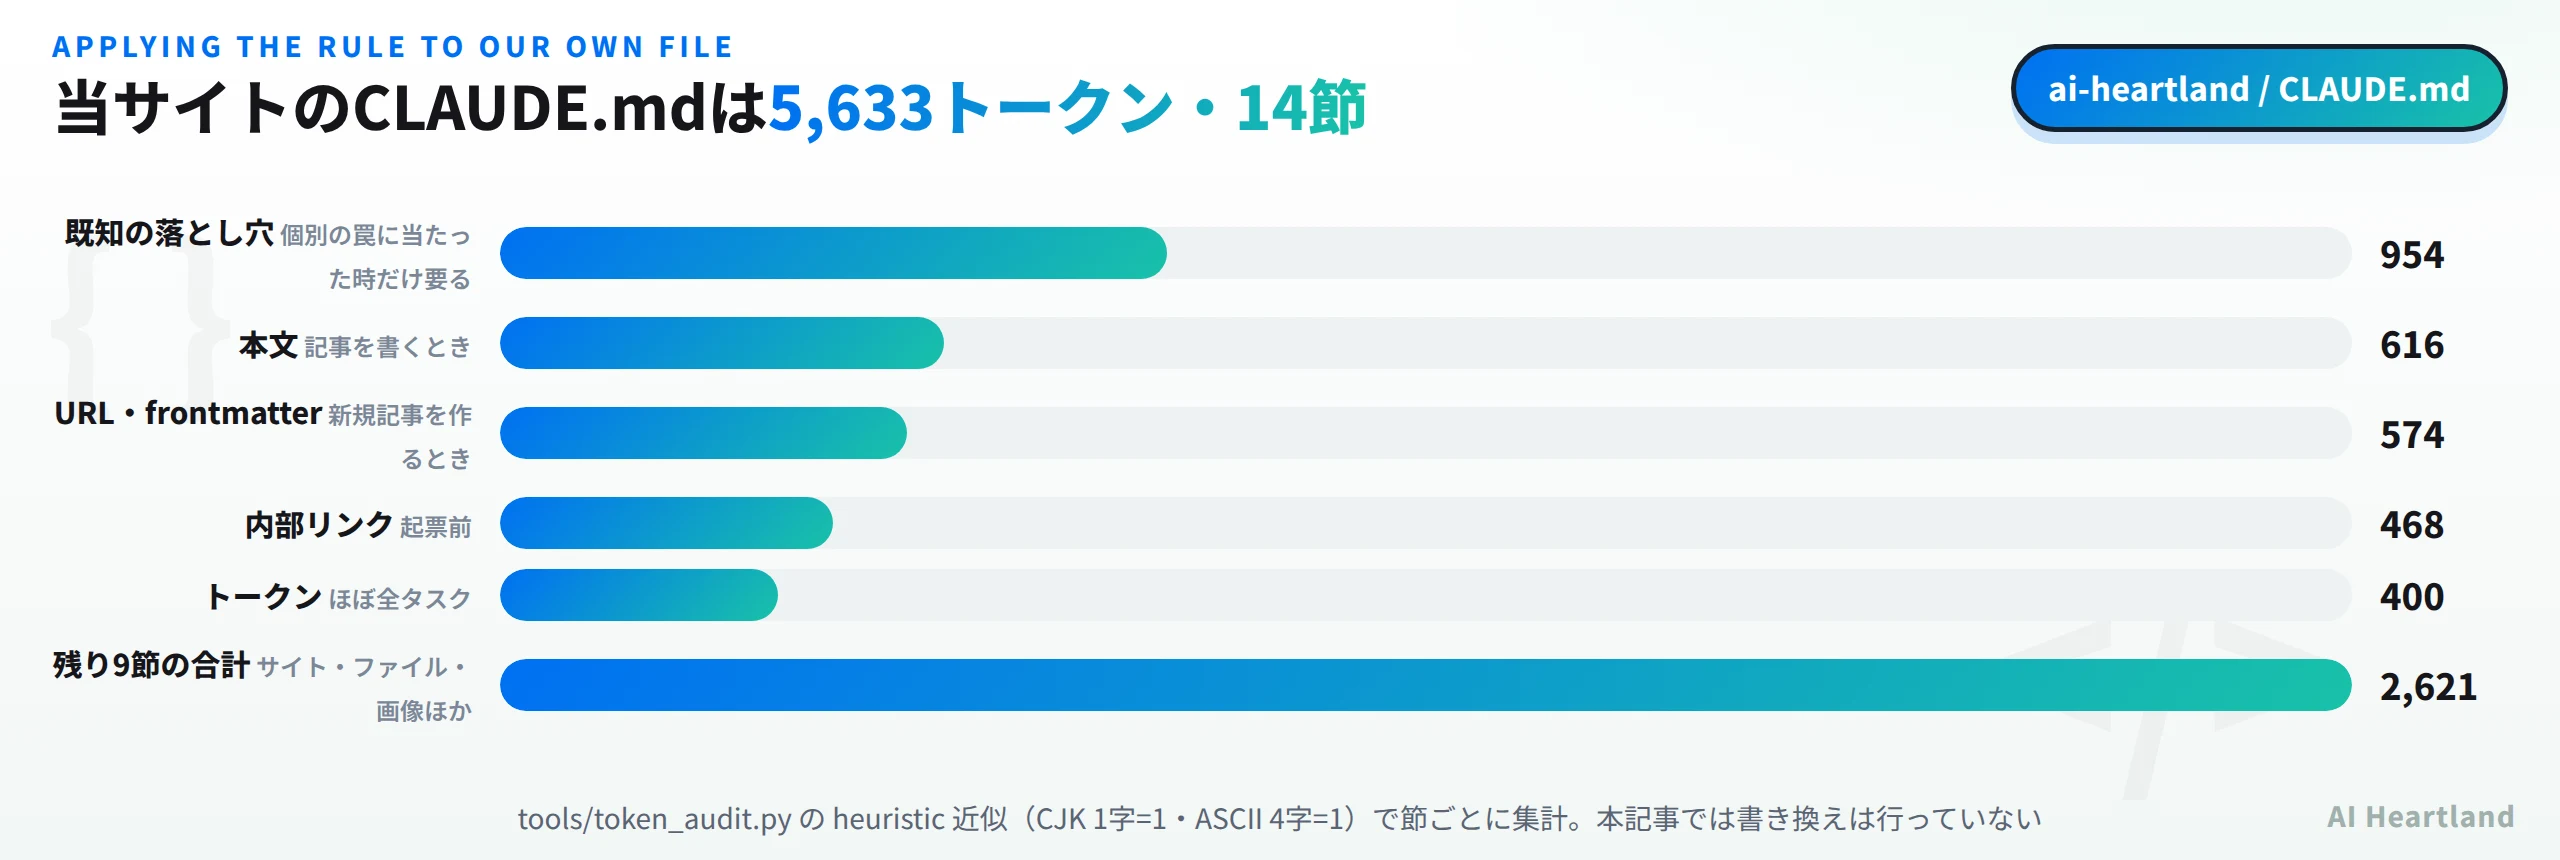
節ごとに「9割のタスクに関係するか」を当てはめると、この規則はそのままでは効きにくいことが分かった。理由は単純で、このリポジトリで発生するタスクがほぼ1種類(記事を書いて起票する)だからだ。「本文」「URL・ファイル名・frontmatter」「画像」「内部リンク」「起票前チェック」は、記事化タスクではほぼ全部が関係する。条件で包んでも、その条件が毎回成立するなら意味がない。
例外が1つはっきりしている。「既知の落とし穴」の954トークンだ。これは14節のうち最大で、全体の 17% を占めるが、中身は「validate_post の TABLE_MISSING はHTML表を数えない」「raw.githubusercontent.com の画像は上流変更で無言404」といった個別の罠に当たったときだけ要る1行索引。9割どころか、1回のタスクで引くのは多くて1〜2行だろう。ここは important if の条件を細かく割るのに向いている。
節ごとのトークン数は、リポジトリに入っている計測ツールで数えた。
# CLAUDE.md を H2 で割って、節ごとのトークン数を出す(当記事で実行)
python3 - <<'EOF'
import re
raw = open('CLAUDE.md', encoding='utf-8').read()
tok = lambda s: (lambda c: c + round((len(s) - c) / 4))(
    len(re.findall(r'[\u3000-\u303f\u3040-\u30ff\u4e00-\u9fff\uff00-\uffef]', s)))
parts = re.split(r'^(## .+)$', raw, flags=re.M)
for i in range(1, len(parts), 2):
    print(f"{tok(parts[i] + parts[i+1]):6}  {parts[i][3:40]}")
EOF
#    954  既知の落とし穴(1行索引。詳細は `.dreaming/archive/CLAUDE
#    616  本文
#    574  URL・ファイル名・frontmatter(新規記事)
#    468  内部リンク(`python3 tools/cluster_link_audit.py article
判断の分かれ目を図にすると、こうなる。
関係するか"} B -- "はい" --> C["素のマークダウンのまま先頭に置く
プロジェクトの正体・構成・スタック"] B -- "いいえ" --> D{"リンタ・フックで
強制できるか"} D -- "できる" --> E["消す。pre-commit に移す"] D -- "できない" --> F{"引き金を1文で
狭く書けるか"} F -- "書ける" --> G["important if=その条件 で包む"] F -- "書けない" --> H["ルールを割ってから包み直す
広い条件で束ねない"] C --> I["コマンド表は全部残して1ブロックに包む"]
つまりこのスキルの効きどころは、ファイルの大きさではなくタスクの多様性にある。
・単一目的のリポジトリ(当サイトのような記事生成)→ 条件で包む余地が小さい。効くのは索引・罠集のような「当たったときだけ」の節
・多目的のリポジトリ(APIとフロントとインフラが同居するモノレポ等)→ テスト規約・API規約・状態管理・i18n が互いに無関係なので、規則がそのまま効く
なお、当記事では実際の書き換えは行っていない。スキル自体を Claude Code に読み込ませて /improve-claude-md を実行する検証はしておらず(未検証)、上記は SKILL.md の規則を手で当てはめた試算だ。書き換えるなら、pre-commit の12,000トークン検査を通したうえで、実際に指示の遵守率がどう変わるかを別途測る必要がある。
ループ系2本は、共有テンプレがもう乖離している
残る大物2本も見ておく。build-iterated-agentic-loop と design-control-loop は、どちらも「スケジュールで回るコーディングエージェントのワークフロー」を作らせるスキルだ。後者は制御理論の語彙を借りてくる。
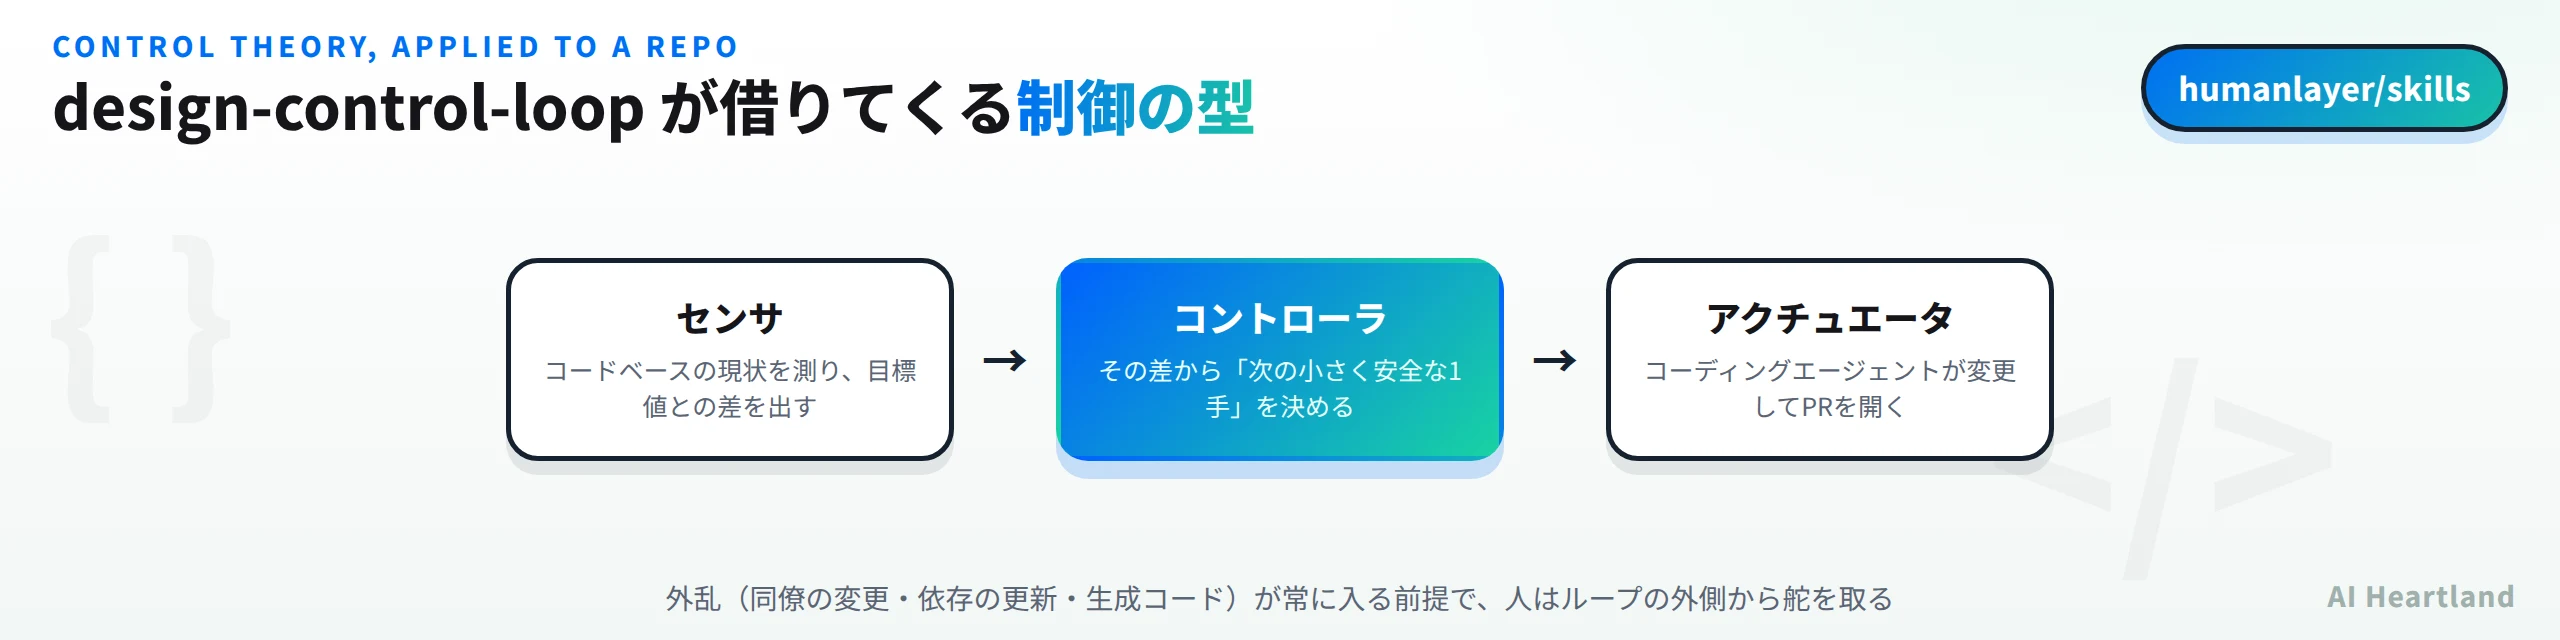
SKILL.md はこう説明する。コードベースは、同僚・依存関係・生成コードによって継続的に変化させられている動的な系(=外乱)である。制御ループは、それを一度に全部ではなく、望ましい状態へ向けて少しずつ駆動する。目標値(ある性質の到達点)、センサ(現状を測って差を出す)、コントローラ(差から次の小さく低リスクな変更を決める)、アクチュエータ(コーディングエージェントが変更しPRを開く)。人はループの中ではなく上に立って舵を取る。
この「人は loop の in ではなく on にいる」という言い回しは、HumanLayer の12-Factor Agents完全解説:本番投入できるLLMエージェント設計12原則を一次ソースで読むから一貫している発想だ。SKILL.md は運用上の釘も刺していて、「テンプレートを再現するのではなく、リポジトリを読んでから提案を持って聞き取りに臨め」「各部品はCIに組み込む前に単体でローカル実行できるようにしろ」「作る前に合意した設計を文章にしろ」と書かれている。
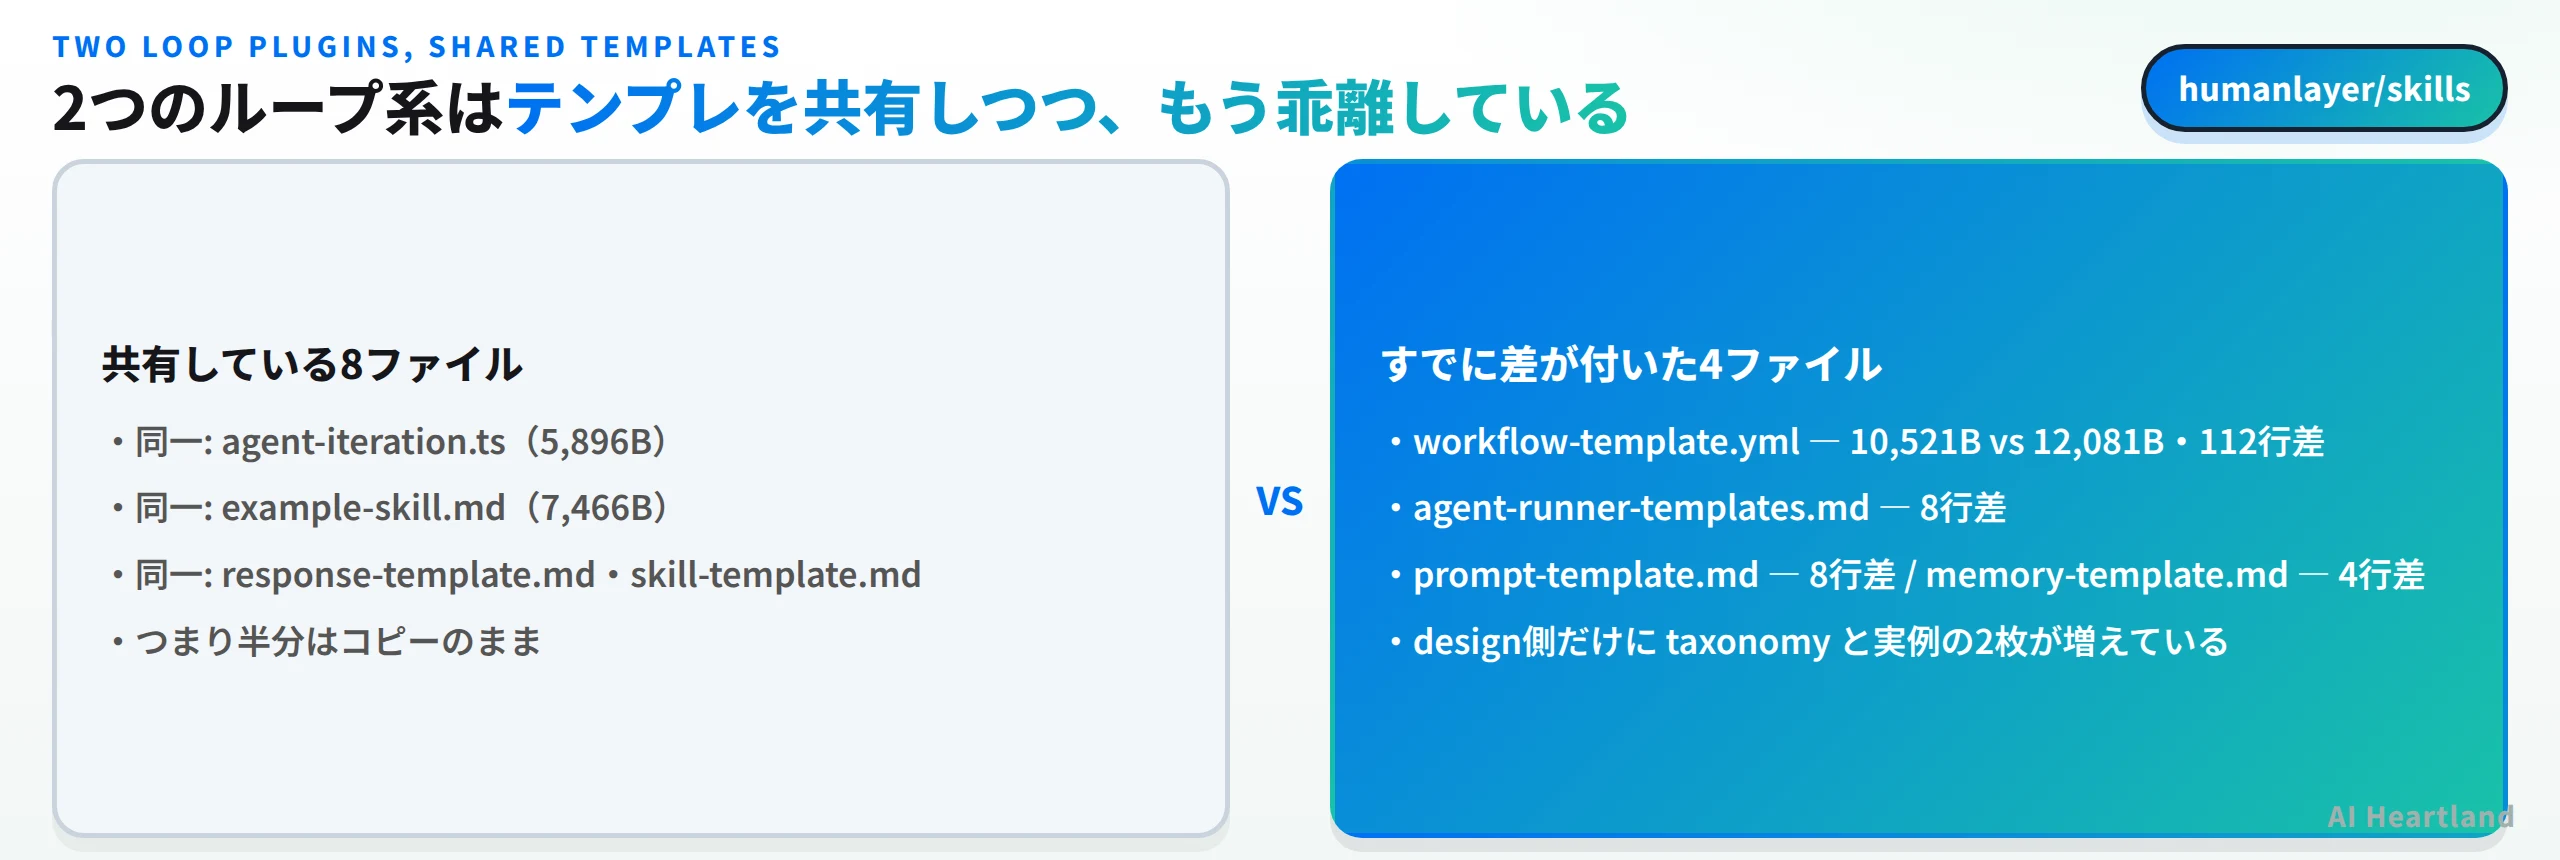
そのうえで、2本を diff した結果が面白かった。参照ファイル8本が共通しているのだが、内容は揃っていない。
比較はこれだけで出る。
# 2つのループ系プラグインが共有する references を1ファイルずつ突き合わせる(当記事で実行)
A=plugins/build-iterated-agentic-loop/skills/build-iterated-agentic-loop/references
B=plugins/design-control-loop/skills/design-control-loop/references
for f in $(ls $A); do
  cmp -s "$A/$f" "$B/$f" && echo "同一 $f" \
    || echo "差あり $f($(diff $A/$f $B/$f | grep -c '^[<>]')行)"
done
# 同一 agent-iteration.ts
# 差あり agent-runner-templates.md(8行)
# 同一 example-skill.md
# 差あり memory-template.md(4行)
# 差あり prompt-template.md(8行)
# 同一 response-template.md
# 同一 skill-template.md
# 差あり workflow-template.yml(112行)
4本はバイト単位で完全一致(agent-iteration.ts 5,896B、example-skill.md 7,466B、response-template.md、skill-template.md)。残る4本は差が付いていて、特に workflow-template.yml は 10,521B 対 12,081B で 112行違う。design-control-loop 側にだけ control-loop-taxonomy.md(5,593B)と example-control-loop.md(4,241B)が増えている。
これはプラグイン単位で配る形式の宿命でもある。1プラグイン=1スキルで独立して配れることと引き換えに、共有したいテンプレートはコピーで持つしかない。片方だけ直せば、そのまま差が残る。npx skills add --skill SKILLNAME で1本だけ入れる使い方が前提なら実害は小さいが、両方入れると同じ名前で中身の違うテンプレートが2組並ぶことになる。
最後に、当記事で確かめた範囲を整理しておく。
| 項目 | 確認方法 | 状態 |
|---|---|---|
| 6プラグインの本体・参照ファイルのサイズ | clone して1本ずつ計測 | 実測 |
| 常駐frontmatter 945B ≈ 236トークン | 6本のfrontmatterを合計 | 実測 |
| 自動起動を止める3通りの書き方 | 6本のfrontmatterと agents/ を全部確認 | 実測 |
| ループ系2本の共有テンプレの一致と乖離 | cmp と diff で8ファイルを比較 |
実測 |
| 当サイトCLAUDE.mdの節別トークン | tools/token_audit.py の heuristic 近似で集計 |
実測 |
improve-claude-md の規則 |
SKILL.md 全文を読解 | 原文どおり |
/improve-claude-md の実行結果 |
スキルを読み込ませていない | 未検証 |
important if で遵守率が上がるか |
効果測定をしていない | 未検証 |
| ループ系2本が実際に作るワークフロー | 実行していない | 未検証 |
6本という数は少ないが、「スキル集をどう配るか」と「エージェントへの指示をどう構造化するか」の両方について、実物で考えさせる材料が入っていた。とくに improve-claude-md は、実行しなくても規則を読むだけで自分の指示ファイルを見直せる。
参照ソース
・humanlayer/skills — GitHubリポジトリ(main・最終コミット ca7c808・2026-09-17 を clone して計測): https://github.com/humanlayer/skills
・improve-claude-md の SKILL.md — important if の原則と適用手順: https://github.com/humanlayer/skills/blob/main/plugins/improve-claude-md/skills/improve-claude-md/SKILL.md
・design-control-loop の SKILL.md — センサ・コントローラ・アクチュエータの定義: https://github.com/humanlayer/skills/blob/main/plugins/design-control-loop/skills/design-control-loop/SKILL.md
・show-me の agents/openai.yaml — Codex向けの暗黙起動ポリシー: https://github.com/humanlayer/skills/blob/main/plugins/show-me/skills/show-me/agents/openai.yaml