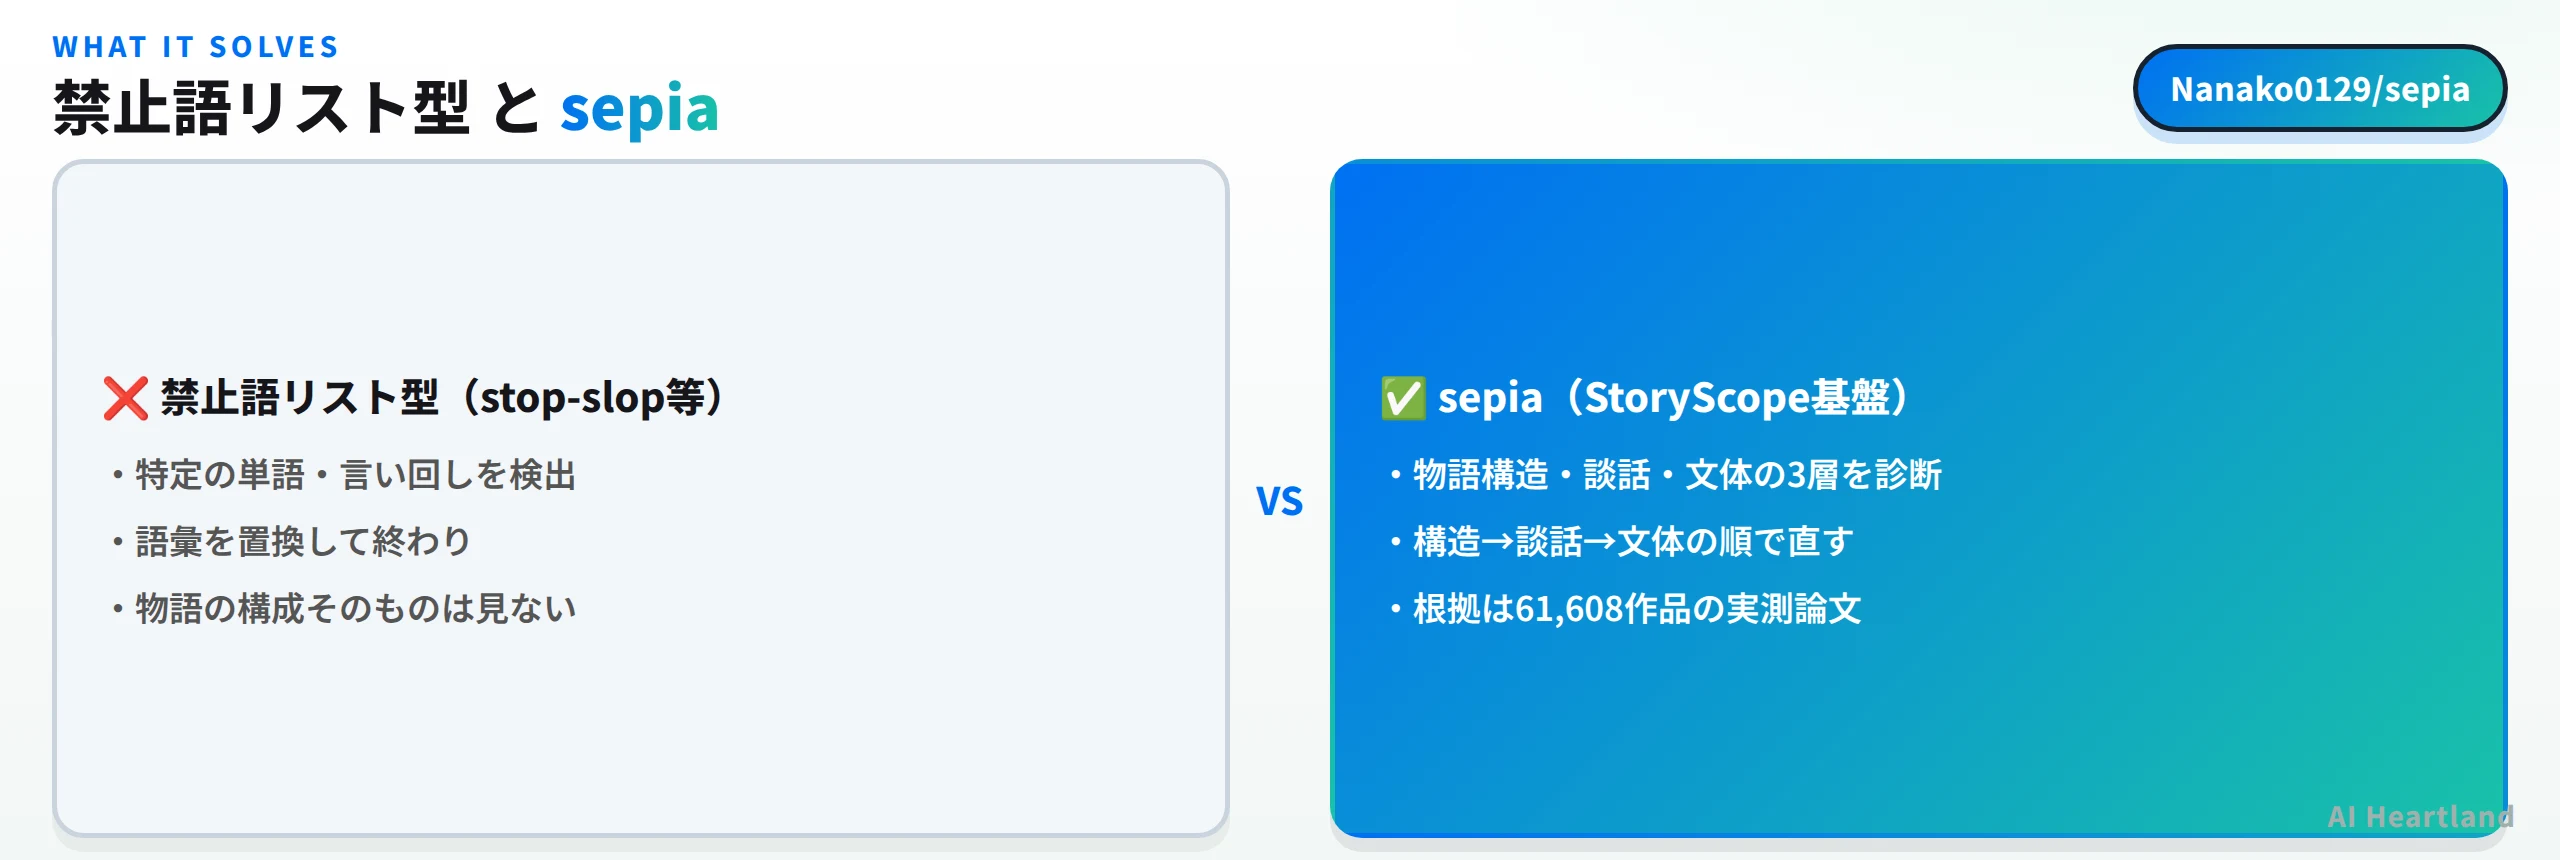
sepia(Nanako0129/sepia)は、AIが書いた文章を人間の文章に近づける「de-AI writing」を掲げるClaude Code向けのAgent Skillsパッケージだ。★2,529・MITライセンスで、公開から約2週間で急成長した個人開発プロジェクトである。この記事では、sepiaが禁止語リスト型の既存スキルと何が違うのか、根拠とする研究論文StoryScopeの中身、そして実際にインストールして中身を確認した結果までをまとめる。
- ・正体:Nanako Tsai氏が個人開発する、AI文章を人間らしく直すAgent Skillsパッケージ(MIT・★2,529)
- ・何ができる:write / review / refactor / recreate の4操作+Hemingwayボイス用スキルで、フィクションと実務文書(リリースノート・ポストモーテム・技術記事等)の両方を扱う
- ・根拠:arXiv論文StoryScope(61,608作品を人間+5フロンティアLLMで比較した実測研究)が示した「物語構造にAIらしさが残る」という知見
- ・実測:`claude plugin marketplace add` / `plugin install` でのインストール成功と、6スキルの実在・構成までを確認した(起動後の対話実行はサンドボックス環境の認証分離により未検証)
- ・注意:pre-1.0(v0.11.0)でcontributor 4人の急成長プロジェクト。日本語向けの較正資料は確認できなかった
Claude Codeのエコシステム全体についてはClaude Code|2026年版・インストールからCLAUDE.md・Hooks・本番運用までの実装手引きにまとめている。sepiaはそのAgent Skillsエコシステムの一角に位置するツールだ。
sepiaとは——語彙でなく物語構造から直すAI臭除去スキル
sepiaは、Claude Code・Codex・Grok Build・Antigravity・QwenPaw向けに配布されているAgent Skillsパッケージだ。公式のSKILL.mdの説明文では「Make AI-generated writing read as human-written, in fiction and in professional prose」と定義されており、フィクション(小説・物語)と実務文書(リリースノート・PR/issue返信・コードレビューコメント・インシデントのポストモーテム・チケット・技術記事・長文ジャーナリズム)の両方を対象にしている。
・何ができる:AIが書いた文章を診断(review)・最小限の修正(refactor)・全面書き直し(recreate)・新規執筆(write)の4操作で扱う
・何を解決する:「禁止語を置換しただけでは残るAI文章の違和感」に、構造レベルから対処する
・何を代替できる:語彙置換型のアンチスロップスキルの代替にはならない(別レイヤーを扱うため併用も想定される設計)
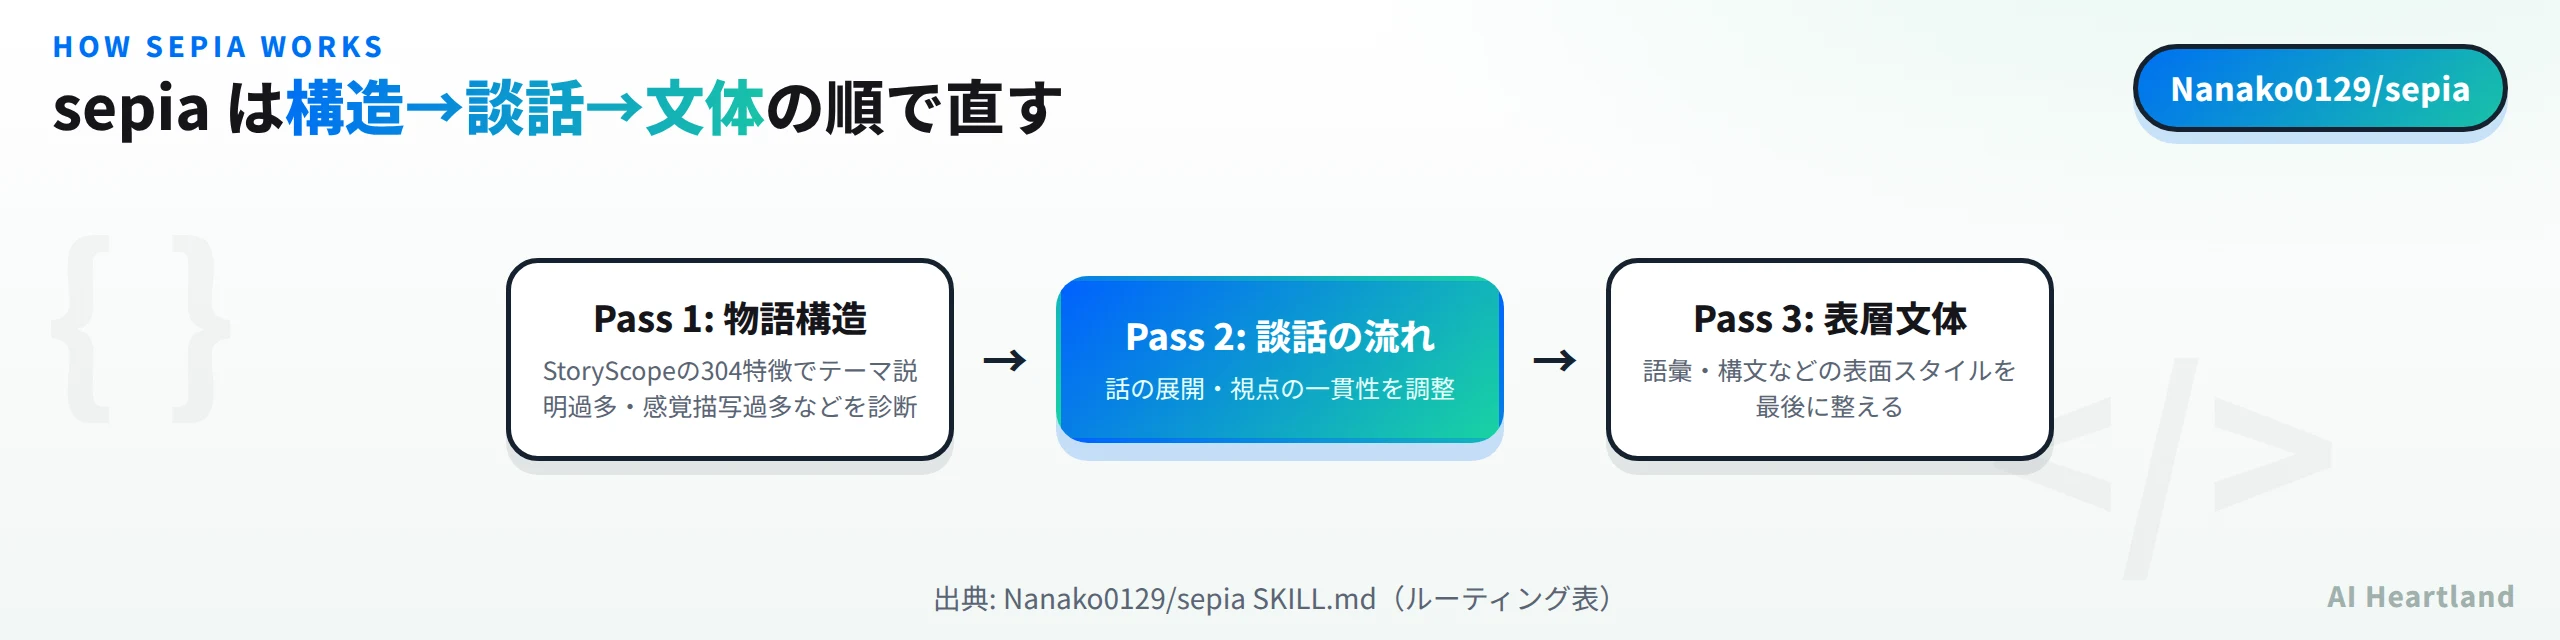
① 何ができる:AI文章の診断・修正・書き直しを、物語構造→談話の流れ→表層文体の順で行う。② 何を解決する:語彙だけを直しても残る「構成の不自然さ」という、既存の禁止語リスト型スキルが扱っていない層の問題。③ 何を代替できる:stop-slop等の語彙チェックとは扱うレイヤーが異なるため、単純な代替関係にはならない。
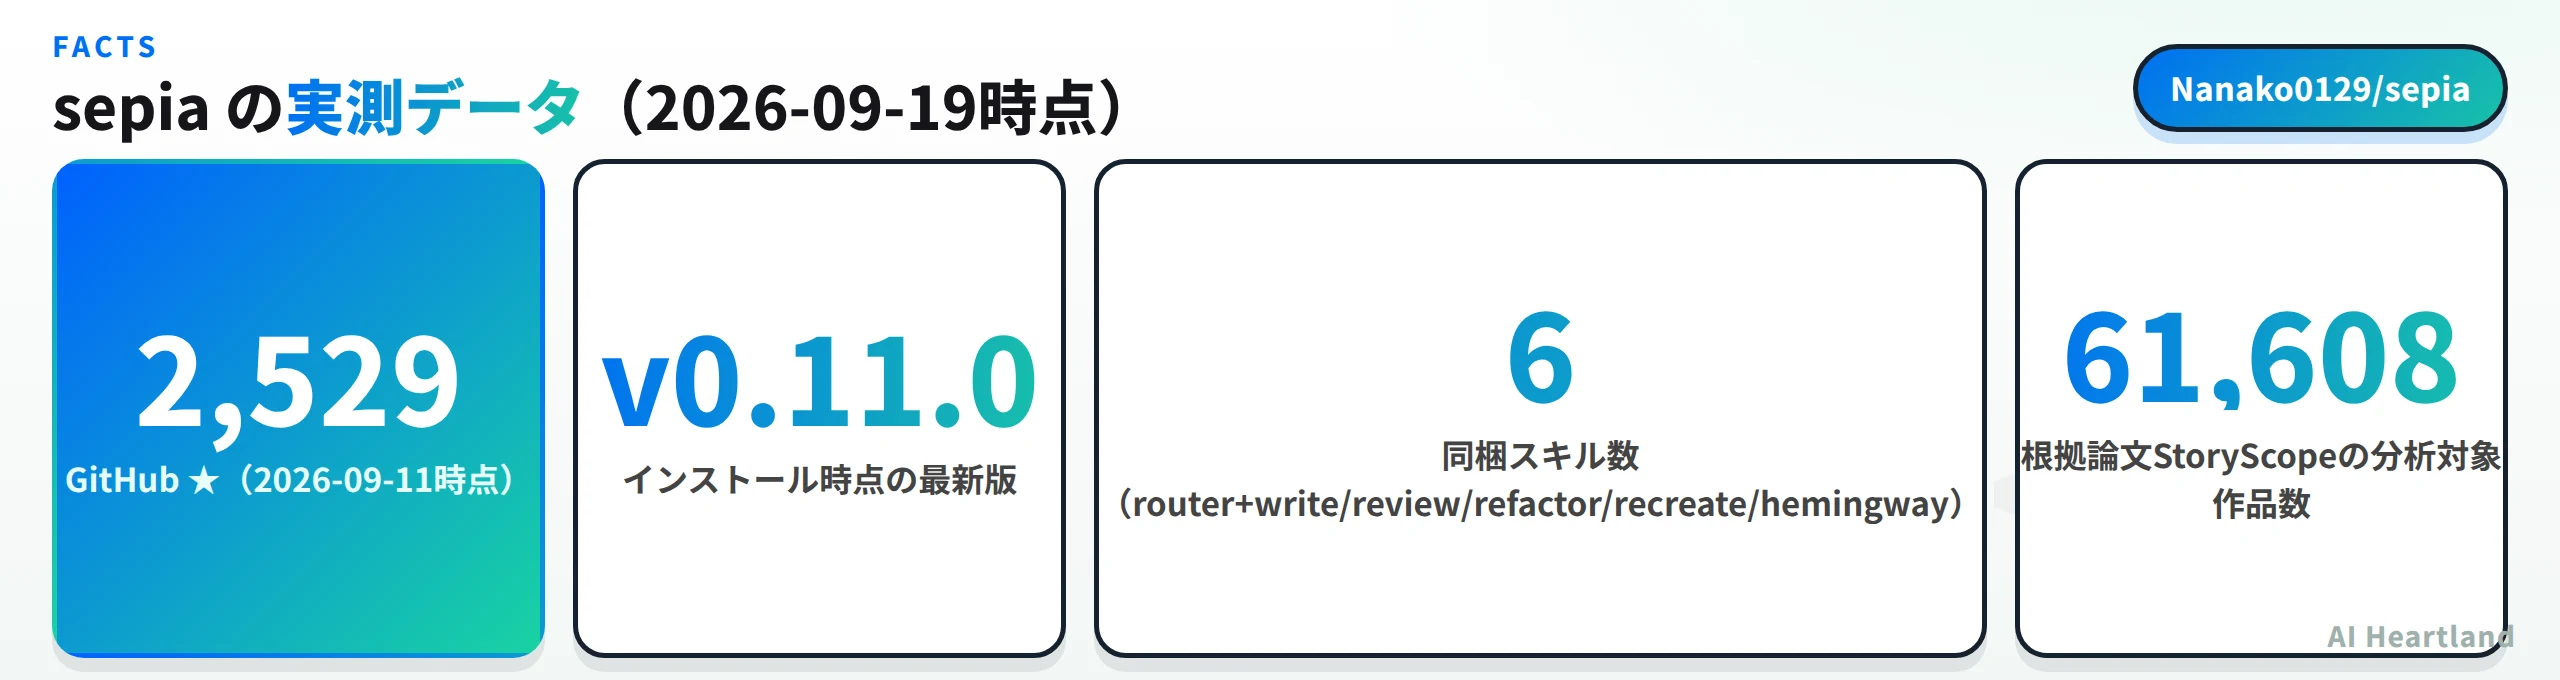
GitHub API実測では★2,529・fork 162・contributor 4人(2026-09-11時点)。リポジトリ作成が2026-08-28、直近のpushが2026-09-10と、公開から約2週間でこの伸びは急速だ。bus factorは低く、中核の開発は実質1〜2名の可能性が高い状態で急成長している点は、採用判断において踏まえておきたい。
なぜ「語彙」でなく「物語構造」なのか——根拠論文StoryScope
sepiaのリポジトリ内資料(research/storyscope.md)によれば、根拠となる論文は次の通りだ。
・論文:Jenna Russell, Rishanth Rajendhran, Chau Minh Pham, Mohit Iyyer, John Wieting(2026)「StoryScope: Investigating idiosyncrasies in AI fiction」(arXiv:2604.03136v6、2026-08-10改訂)
・所属:UMD + Google DeepMind
・データ:Books3由来の10,272件のプロンプトから、人間と5つのフロンティアLLM(Claude Sonnet 4.6・GPT-5.4・Gemini 3 Flash・DeepSeek V3.2・Kimi K2.5)がそれぞれ執筆した計61,608作品(平均約4,753字)
・手法:304個の解釈可能な物語特徴(10次元)を抽出し、XGBoost+SHAPで分析
同じくsepiaのリポジトリ内資料には、304特徴のうち代表的な30個(Table 16)の人間作品とAI作品のスコア差も収録されている。一部を抜粋する。
| 特徴 | 人間 | AI | 傾向 |
|---|---|---|---|
| テーマの説明過多(1-5) | 3.28 | 3.94 | AIは主題を語り手が言葉で説明しがち |
| 結末を主人公の選択のみで解決(比率) | 46% | 69% | AIは結末を主人公の決断だけに頼りがち |
| 実在の作品・人物への名指し引用(比率) | 47% | 24% | 人間の方が実在の固有名詞を直接引用する |
| 時間的な飛躍・非線形構成(1-5) | 2.40 | 2.12 | 人間の方が時系列を崩す構成を使う |
この表からもわかる通り、AI生成文章は「テーマを説明しすぎる」「結末を主人公の内面的な納得だけで閉じる」といった構造的な癖を持ちやすく、逆に人間の文章は時系列を崩したり実在の固有名詞を引用したりする傾向が強い。sepiaが語彙の書き換えより先にこうした構造上の癖を診断するのは、この実測データが根拠になっている。
この研究の核心は「表面的な文体(em-dashや”delve”のような語彙)を消しても、物語構造レベルの特徴だけでAI生成文章を高精度に判別できてしまう」という点だ。sepiaのSKILL.md本文には、StoryScopeの「narrative-onlyの分類器が93.2% macro-F1」という数値がそのまま引用されている。ただし、この93.2%という数値はStoryScope論文側の分類器の性能であり、sepia自身がこの手法を適用した結果どの程度AI検出を回避できるかを独自にベンチマークした記載はリポジトリ内に見当たらなかった。sepiaのSKILL.md自体も「sepiaはいかなる自動AI文章検出器も通過させるようチューニングされたものではない(tuned to pass no automated AI-text detector)」と明記しており、検出回避ツールとしては位置づけていない。
実務文書側についても同様の注意が要る。SKILL.mdには「187個の構造特徴だけでheld-out企業に対して98.0 macro-F1に達した」という記述があるが、これはSLOPSHAPE-2026というプレプリント(LLMでスコアリングした特徴+ChatGPT以前の人間コーパスを使用)の結果を指しており、sepiaが提案する修正手順(プレスクリプション)そのものが検証されたわけではない、とSKILL.md自身が但し書きしている。
仕組み:4つの操作とルーティング表
インストールして中身を確認したところ、sepiaは1個のルーター的スキル(sepia)と、5個の個別エントリ(sepia-write / sepia-review / sepia-refactor / sepia-recreate / sepia-hemingway)の計6スキルで構成されていた。テキストの種類ごとに読み込む参考資料が変わるルーティング表を持つのが特徴だ。
discourse-pass.md
rubric.md"] B -- "リリースノート・ポストモーテム等" --> D["professional-pass.md
domains/配下のルール"] B -- "技術記事・ブログ" --> E["professional-pass.md
domains/tech-articles.md"] C --> F["style-pass.md(語彙・構文の仕上げ)"] D --> F E --> F F --> G["4操作: write / review / refactor / recreate"]
① 何ができる:テキストの種類(フィクション/リリースノート/ポストモーテム/技術記事など)ごとに異なる参考資料を読み込み分ける。② 何を解決する:一律のチェックリストでは拾えない、文書ジャンルごとのAI臭の出方の違い。③ 何を代替できる:ジャンルを問わない汎用の校正ツールの代替にはなるが、専門分野の文体ガイド(社内スタイルガイド等)を代替するものではない。
refactor(最小限修正)とrecreate(全面書き直し)はいずれも「まず欠陥リストを作ってから直す」二段階プロトコルを取ることがSKILL.mdに明記されている。修正の配分についても「置換74% / 削除18% / 挿入8%」という編集比率の目安が示されており、追加より削除・置換を優先する設計思想がうかがえる。ガードレールとして「架空の固有名詞・数値・タイムスタンプ・ベンチマークを創作しない」「引用符や保護範囲は書き換えない」といった項目も含まれていた。
もう一つの特徴が、実行時にどのAIモデルが文章を書いた(book)/実行している(executor)かを識別し、モデルごとの文体の癖(references/model-fingerprints.md)を参照する仕組みだ。ただしSKILL.mdは「文面だけからモデルを推測するな」と明記しており、モデル識別はユーザーからの申告やシステムのメタデータに基づくとされている。
配布面では、README記載の対応プラットフォームはClaude Codeに限らずCodex・Grok Build・Antigravity・QwenPaw の5つに及ぶ。ただしREADME自身が「Verified means the install completes and the sepia entries appear. Whether the entries then behave as documented has not been checked platform by platform.」と断っている通り、インストールの成功と実際の挙動の一致はプラットフォームごとに個別検証されたわけではない。
なお、GitHub API上の主要言語表示は「Python」だが、リポジトリ本体を確認したところスキルの中身はSKILL.md(Markdown)とreferences/配下の参考資料が主体で、Pythonはscripts/配下の2本(check_versions.py:plugin.json等バージョン表記の不一致を検知するCI用スクリプト、check_persona.py:ペルソナ定義ファイルの構造を検証するスクリプト)に限られていた。「Pythonツール」ではなく、実体はMarkdownベースのAgent Skillsパッケージである。
実測:インストールから構成確認まで(Linux x86_64)
以下の手順で実際にインストールし、中身を確認した。
claude plugin marketplace add Nanako0129/sepia
claude plugin install sepia@sepia --scope user
両コマンドとも成功し、claude plugin details sepia@sepia では次の情報が確認できた。
claude plugin details sepia@sepia
# sepia 0.11.0
# Skills (6): sepia, sepia-hemingway, sepia-recreate, sepia-refactor, sepia-review, sepia-write
# Always-on token cost: ~326 tok
brief作成時点(2026-09-11)ではv0.10.0だったが、本記事の検証時点(2026-09-19)ではv0.11.0に上がっていた。1週間強でマイナーバージョンが上がっている点も、急速な開発速度を裏づける。
インストールされたスキルディレクトリを直接確認したところ、skills/sepia/references/languages/ 配下には中国語向けの較正ファイル(zh.md)は存在したが、日本語向けの較正ファイルは見当たらなかった。つまりsepia自体は日本語文章に対して個別のキャリブレーションを持たない状態だ。
検証環境:Linux(x86_64)/2026-09-19。claude plugin marketplace add / plugin install の成功と、スキルファイル一式の実在・構成は確認した。一方で、/sepia-review を実際に日本語テキストへ対話実行して診断結果を得るところまでは、本記事の検証環境(CI相当のサンドボックス)ではネストしたClaude Codeセッションの認証が分離されており実施できなかった。この点は未検証として明記する。
・実測できたこと:プラグインのインストール成功/6スキルの構成/日本語較正資料の不在/バージョンがv0.10.0→v0.11.0に上がっていたこと
・未検証のまま残ったこと:/sepia-review等を実際に対話実行した際の診断内容そのもの
類似ツールとの比較
| 観点 | sepia | stop-slop | humanizer-ja |
|---|---|---|---|
| ライセンス | MIT | MIT | MIT |
| ⭐(実測時点) | 2,529 | 17,006 | 143 |
| アプローチ | 物語構造→談話→文体の3パス(StoryScope根拠) | 禁止語・定型フレーズのリスト検出 | 日本語特化の20パターンチェックリスト+書き換えガイド |
| 対象言語の較正 | 英語中心+中国語較正あり/日本語較正は未確認 | 語彙リスト型(言語非依存の傾向) | 日本語特化 |
| 対象テキスト | フィクション+実務文書(8ジャンル) | 汎用文章 | 日本語の実務・ブログ文章 |
同一クラスタの既存記事では、アンチスロップ・スキル10本を全部cloneして実測比較|AIっぽい文章を消すSKILL.mdの中身で禁止語リスト型のスキル群を横並び比較している。sepiaはその比較対象(公開が2026-08-23で、sepiaの作成日2026-08-28より前)には含まれていない新顔であり、かつ扱うレイヤーが異なるため、単体の深掘り記事として切り出した。
日本語での実測という観点では、AIっぽい文章を機械で消すOSSスキル avoid-ai-writing|日本語で実測したら検出器が動かずが「検出エンジンが空白区切りで語数を数えるため日本語を採点できない」という実測結果を報告している。sepiaは検出エンジンではなくAI自身に診断させる設計のため同じ問題構造ではないが、日本語向けの較正資料が無いという点で「日本語での挙動が未知数」という軸は共通する。
文章以外の領域でAI slopに対処するアプローチとしては、Hallmark デザインスキル解説|AI slopを拒みClaude Code・Cursorで使うがデザイン領域を扱っている。
ライセンスと採用判断
sepiaはMITライセンス(LICENSEファイル冒頭は「Copyright (c) 2026 Nanako Tsai」で、READMEの宣言と一致)。企業スポンサーの記載は確認できず、個人開発として運営されている。
README自体は「Verified means the install completes and the sepia entries appear. Whether the entries then behave as documented has not been checked platform by platform.」と明記しており、インストールの成功と挙動の一致を明確に区別する誠実な書き方をしている。同様に、「Experimental: composing with voice skills」の節も「a worked example, not measured evidence(実測ではなく1件の試行に基づく設計例)」と自ら断っている。この誠実さは評価できる一方、pre-1.0(v0.11.0)でcontributor 4人という体制であることも踏まえ、本番のライティングワークフローに組み込む前に、まずreview操作だけを試して挙動を見る、といった段階的な採用が妥当だろう。
まとめ
・向いている人:フィクションや長文の実務文書を書く機会が多く、語彙置換型のチェックでは物足りなさを感じているClaude Codeユーザー
・待った方がよい人:日本語での挙動の実績を重視する人(現時点で日本語向け較正資料は無い)、pre-1.0の急成長プロジェクトへの依存を避けたいチーム
参照ソース
・Nanako0129/sepia(公式リポジトリ・README・SKILL.md・research/storyscope.md) — インストール手順・4操作の仕様・StoryScope引用内容の一次情報
・StoryScope(arXiv:2604.03136) — sepiaが根拠とする実測研究。著者・所属・改訂履歴はsepiaリポジトリ内research/storyscope.mdの記載による