json-render は Vercel Labs が Apache-2.0 で公開している「生成UI(Generative UI)」フレームワークだ。スター16.8k、パッケージ33本、レンダラ13系統。ただしこの記事の主題は枚数の多さではない。2026年9月18日の v0.21.0 で、UIの組み立てを文章を1文字も生成しないモデル(Jev)に任せる実験的APIが入った。LLMにJSONを書かせるのではなく、アプリが用意した候補の中から選ばせる。この設計変更で何が変わるのかを、npm公開版の 0.21.0 を実際に入れ、APIキーなしで合成パイプラインを走らせて実測した。
- ・正体:Zod でコンポーネントのカタログを定義すると、AI がその範囲内だけで UI の JSON 仕様(Spec)を組み立て、React・Vue・Svelte・Solid・React Native・PDF・メール・動画・端末UI など13系統のレンダラが同じ Spec を描く。Vercel Labs 製・Apache-2.0・⭐16.8k。
- ・v0.21.0 の新機能:
experimental_composeSpecとexperimental_createEvaluator。判定モデル Jev に「どの候補を使うか」「どこに置くか」だけを選ばせ、JSON はコード側が組み立てる。 - ・実測できたこと:4要素のダッシュボードが評価2回で確定。モデルへ渡ったのは候補の
idとdescriptionだけで、¥1,240,000のような prop の実値は一度も送られない。往復のペイロード合計は3,731字。 - ・壊れ方:提示していない選択肢を返すと例外で止まり、Spec は出ない。root で
unavailableを選べばstopReason=unavailableで spec はnull。中途半端な UI が漏れない設計になっている。 - ・README との食い違い:README は実験的APIを「Unreleased」と書くが、npm の 0.21.0 は両方ともエクスポート済みだった。ドキュメントが現物より古い。
なお Jev というモデル自体(文章を返さず型つきの判定と確率だけを返す「System One モデル」)の仕組みは、LLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版 に置いた LLM の全体像の中では、かなり端の方に位置する特殊なモデルだ。生成する側のモデルを押さえてから読むと、なぜ「選ばせる」だけで UI が組めるのかが掴みやすい。
json-renderとは——LLMにUIを「書かせる」のをやめ、カタログから「選ばせる」
公式 README の定義はごく短い。「json-render は Generative UI フレームワークである:AI が自然言語のプロンプトから、あなたが定義したコンポーネントに制約された形でインターフェースを生成する」。掲げている性質は4つ、ガードレール付き(AI はカタログにあるコンポーネントしか使えない)、予測可能(JSON 出力が毎回スキーマに一致する)、高速(モデルの応答に合わせて逐次描画)、クロスプラットフォーム(同じカタログから React・Vue・Svelte・Solid・React Native)。
読者の3問に答えると、こうなる。何ができるか:自然言語の指示から、アプリが許可した部品だけで組まれた UI が出てくる。何を解決するか:LLM に JSX や HTML を書かせたときの「動かないコードが返る」「存在しないコンポーネントを呼ぶ」「XSS になる文字列が混ざる」という問題を、出力の形式そのものを変えて潰す。何を代替するか:dangerouslySetInnerHTML に LLM の出力を流し込む実装と、v0 のような「コードを吐いてビルドする」方式の一部を代替する。
Spec は JSX ではなく、フラットな JSON の木
json-render の中心にあるのは Spec と呼ばれる JSON だ。root に頂点の ID を書き、elements に ID をキーとした要素の連想配列を置く。要素は type(カタログのコンポーネント名)・props・children(子の ID の配列)を持つ。この記事の実験で実際に出てきた Spec を貼ると、次のような形をしている。
| 項目 | 内容 |
|---|---|
root |
"node_0"(頂点の要素 ID) |
elements.node_0 |
type: "Card" / props: { title: "売上" } / slots: { children: ["node_1","node_2","node_3"] } |
elements.node_1 |
type: "Metric" / props: { label: "今月の売上", value: "¥1,240,000" } |
elements.node_2 |
type: "Chart" / props: { kind: "line" } |
elements.node_3 |
type: "Note" / props: { text: "税抜・確定値" } |
state |
{}(バインディング先の状態モデル) |
木構造を入れ子の JSON ではなく「ID の参照」で表すのは、ストリーミングのためだ。モデルが出力している途中でも、届いた行から順に elements へ差し込んでいけば、閉じタグを待たずに描画を始められる。実際、既定の経路では JSONL(1行1 JSON)で RFC 6902 の JSON Patch を流す。createSpecStreamCompiler が push(chunk) でその断片を受け取り、途中経過の Spec を返す。
prop は静的な値だけでなく「式」を書ける
props の値は静的なリテラルに限られない。{ "$state": "/user/name" } で状態モデルから読み、{ "$bindState": "/form/email" } で双方向バインドし、{ "$template": "Welcome, ${/user/name}!" } で補間し、{ "$cond": ..., "$then": ..., "$else": ... } で分岐する。$computed を使えば、アプリ側が登録した関数を引数つきで呼べる。
この「式」がある点が、単なる JSON スキーマ制約との違いだ。AI は値を直接書かなくても、「ここには利用者名を入れる」という参照を置ける。実値はアプリが握ったまま、構造だけが AI 側で決まる。後述する Jev 経路では、この分離がさらに徹底される。
33パッケージ・13レンダラ・36コンポーネント
README の Packages 表に並ぶ出力先を数えると13系統ある。React、Vue 3、Svelte 5、SolidJS、React Native、Next.js(ルート・レイアウト・SSR まで JSON で表す)、TanStack Start、Remotion(動画)、React PDF(PDF 文書)、React Email(HTML メール)、Ink(端末の TUI)、Image(Satori 経由の SVG/PNG・OG 画像)、React Three Fiber(3Dシーン。ガウシアンスプラッティング込みで20コンポーネント)。
@json-render/shadcn は「36個の shadcn/ui コンポーネントを同梱」と書いてある。README の公称値をそのまま書かない方針なので、packages/shadcn/src/catalog.ts(509行)でカタログ定義の数を数えたところ、ちょうど 36 だった。shadcn-svelte 版も同数を掲げている。
状態管理は差し替え式で、StateStore インターフェースに Redux・Zustand・Jotai・XState のアダプタが用意されている。@json-render/mcp は Claude・ChatGPT・Cursor・VS Code 向けの MCP Apps 統合、@json-render/devtools はフレームワーク非依存の開発者ツールで React・Vue・Svelte・Solid のアダプタが別パッケージになっている。リポジトリ直下の skills/ には31本のエージェント向けスキルが入っていて、Claude Code のようなコーディングエージェントがこのフレームワークを扱うときの手引きがパッケージ単位で用意されている。
実測:json-renderのnpm版0.21.0を入れる——READMEの「未リリース」は現物と食い違っていた
ここからは手を動かす。まず公開版を入れる。
npm install @json-render/core zod
Node.js v22.22.2 の環境で1秒、追加されたのは2パッケージだけだった。@json-render/core の依存は zod: ^4.3.6 の1本きりで、peer も zod: ^4.0.0 のみ。実体サイズは core が 1.3MB、zod が 8.2MB。生成UIのフレームワークとしては依存が極端に少ない部類に入る。
ここで1点、README と現物の食い違いを見つけた。packages/core/README.md の実験的APIの節にはこう書かれている。「Unreleased: try a source build before the next package release.(未リリース。次のパッケージリリースまではソースビルドで試すこと)」。だが 0.21.0 の CHANGELOG には「Experimental Jev composition: Added experimental_composeSpec and experimental_createEvaluator」と明記されている。どちらが正しいのか、入れたパッケージのエクスポートを直接数えた。
| 確認項目 | 実測結果 |
|---|---|
| インストールされたバージョン | 0.21.0(2026-09-18 リリース) |
| エクスポート総数 | 73 |
experimental_ で始まるもの |
experimental_composeSpec, experimental_createEvaluator の2つ |
experimental_composeSpec の型 |
function(呼び出し可能) |
engines フィールド |
undefined(公開パッケージには Node のバージョン制約が無い) |
README の記述が現物より古い。実験的APIは 0.21.0 の npm パッケージにすでに入っていて、ソースビルドは要らない。もう1つ、リポジトリのルート package.json には engines: { node: ">=24", pnpm: ">=11" } があり、CHANGELOG 0.20.0 にも「ワークスペースは Node.js 24 と pnpm 11 を要求するようになった」とある。これは開発用ワークスペースの要件で、公開された @json-render/core 側には engines が無い。実際 Node 22 でそのまま動いた。README を読んで「Node 24 が要る」と諦める必要はない。
ただし experimental_ が付いている意味は残る。公式は「experimental_ または Experimental_ の接頭辞が付いた API はどのリリースでも変わりうる。バージョンを厳密に固定し、リリースノートを読んでからアップグレードすること」と書いている。本番に入れるなら 0.21.0 のように完全固定が前提だ。
APIキーなしで合成を動かす——評価2回でダッシュボードが決まるまで
experimental_composeSpec の面白いところは、評価役(evaluator)が差し替え可能なことだ。型は次の一行に尽きる。
({ state, questions, signal }) => Promise<{ answers, usage? }>
questions は「指示文(instructions)と選択肢(criteria)の組」の集まりで、answers は各質問に対して提示された選択肢のキーを1つ返す。Jev はこの役を埋めるモデルの一例にすぎず、公式も「API 名と明示的な model オプションはモデル非依存」と書いている。つまり評価役を自前のスタブに差し替えれば、APIキーもネットワークも無しでパイプライン全体を動かせる。何が聞かれるのかをそのまま覗ける。
次のスクリプトは、売上ダッシュボードの候補を5つ用意し、評価役として「聞かれた内容を全部出力し、use: で始まる選択肢があればそれを選ぶ」スタブを置いたものだ。
import { defineSchema, defineCatalog, experimental_composeSpec } from "@json-render/core";
import { z } from "zod";

const schema = defineSchema((s) => ({
  spec: s.object({}),
  catalog: s.object({ components: s.map({ props: s.zod(), description: s.string() }) }),
}));

const catalog = defineCatalog(schema, {
  components: {
    Card:   { props: z.object({ title: z.string() }), slots: ["children"], description: "カード(子を入れる箱)" },
    Metric: { props: z.object({ label: z.string(), value: z.string() }), description: "数値を1つ見せる" },
    Chart:  { props: z.object({ kind: z.enum(["line", "bar"]) }),        description: "折れ線か棒グラフ" },
    Note:   { props: z.object({ text: z.string() }),                     description: "補足テキスト" },
  },
});

const candidates = [
  { id: "card", description: "ダッシュボードの外枠カード", element: { type: "Card",   props: { title: "売上" } } },
  { id: "kpi",  description: "今月の売上金額を大きく表示", element: { type: "Metric", props: { label: "今月の売上", value: "¥1,240,000" } }, root: false },
  { id: "line", description: "売上の推移を折れ線で見せる", element: { type: "Chart",  props: { kind: "line" } }, root: false, resource: "chart" },
  { id: "bar",  description: "売上の推移を棒グラフで見せる", element: { type: "Chart",  props: { kind: "bar" } },  root: false, resource: "chart" },
  { id: "note", description: "集計条件の注記",             element: { type: "Note",   props: { text: "税抜・確定値" } }, root: false },
];

// Jev の代わりに置くスタブ。何が聞かれるかを全部出し、use: が有ればそれを選ぶ。
let calls = 0;
const evaluate = async ({ state, questions }) => {
  calls += 1;
  console.log(`--- 評価 ${calls} 回目:質問 ${Object.keys(questions).length} 件 / state ${JSON.stringify(state).length} 字 ---`);
  const answers = {};
  for (const [name, q] of Object.entries(questions)) {
    const keys = Object.keys(q.criteria);
    console.log(`  [${name}] 選択肢(${keys.length}): ${keys.join(", ")}`);
    answers[name] = { choice: keys.find((k) => k.startsWith("use:")) ?? keys[0], confidence: 0.9 };
  }
  return { answers, usage: { inputTokens: 123 } };
};

for await (const ev of experimental_composeSpec({
  catalog, candidates, evaluate, prompt: "今月の売上ダッシュボードを作って", initialState: {},
})) {
  if (ev.type === "step") console.log(`[step ${ev.step.index}] choice=${ev.step.choice}`);
  else console.log(`[complete] stopReason=${ev.stopReason} 評価回数=${calls}\n${JSON.stringify(ev.spec, null, 1)}`);
}
これを走らせる。
node compose-demo.mjs
出力の要点はこうだった。
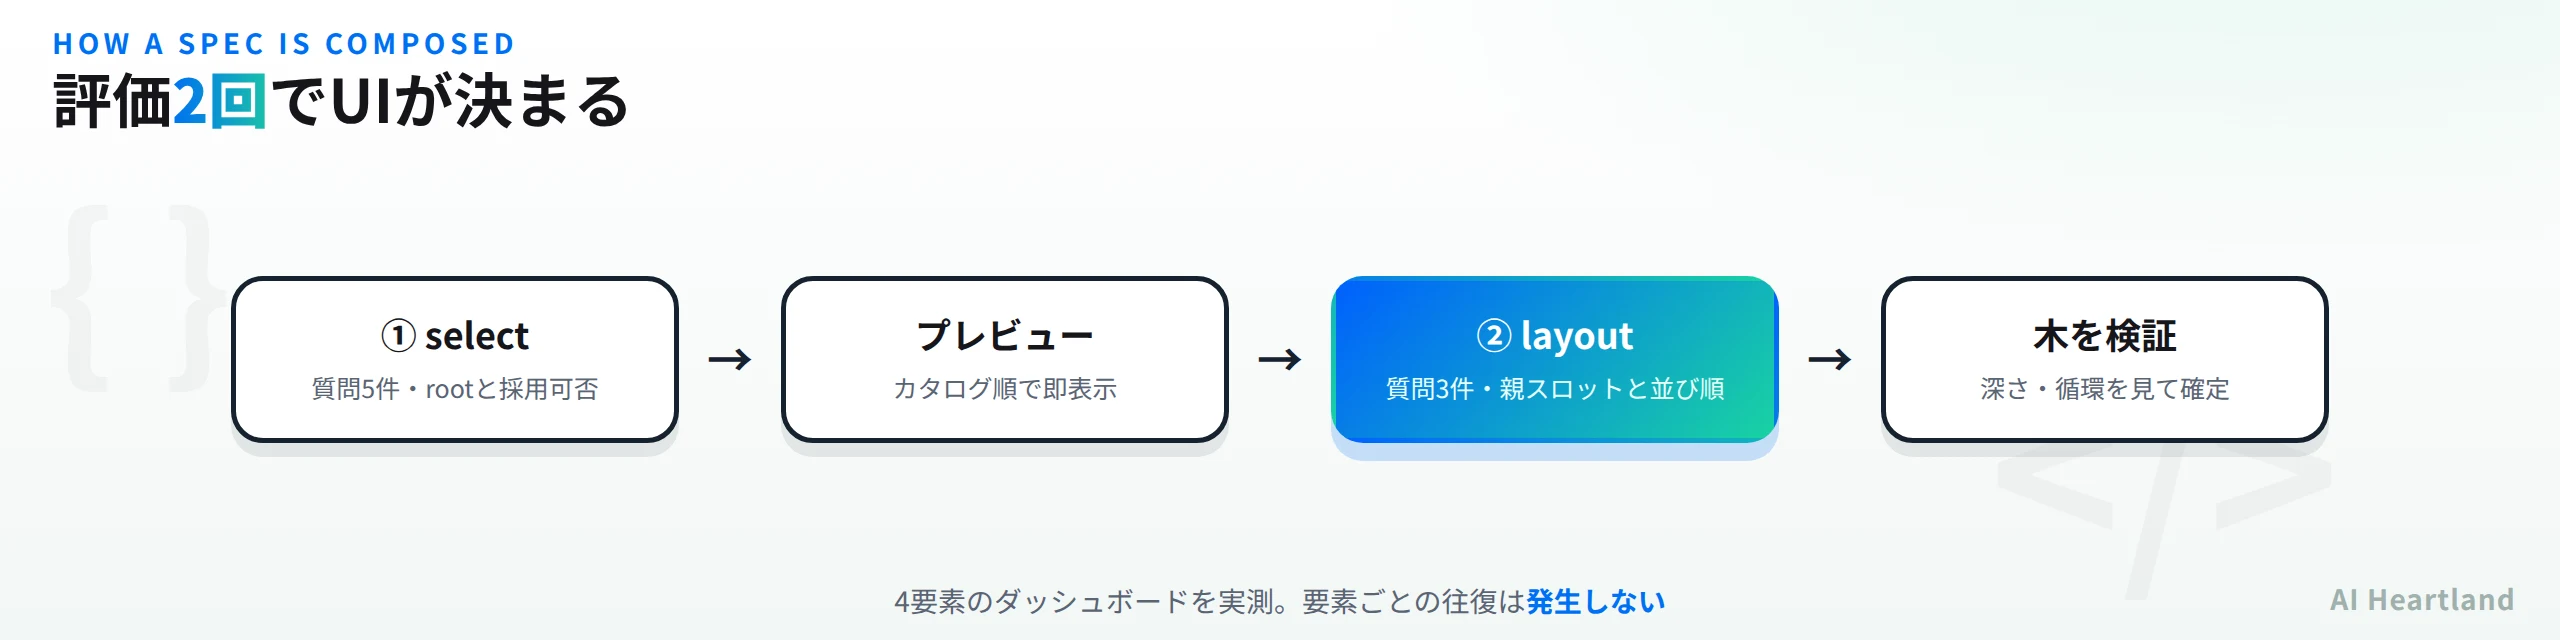
・評価1回目:質問5件。root(選択肢は card と unavailable の2つ)、select_0〜select_3(各要素を使うか外すか)
・評価2回目:質問3件。order_node_1・order_node_2・order_node_3(兄弟の中での表示位置を 1・2・3 から選ぶ)
・合計:評価2回、stopReason=finish、4要素の Spec が確定
「まとめて聞く」設計が効いている
ここがこの実装の肝だ。素朴に作れば「次にどの要素を足す? → その親は? → 次は?」と要素ごとに往復することになる。4要素なら最低でも8回。実際 strategy: "sequential" を指定すればその挙動になるし、既存の評価役アダプタとの互換のために残されている。
しかし既定の strategy: "batch" は違う。1回目で「頂点は何か」と「各候補を採用するか」を同時に聞き、届いた答えでカタログ順のプレビューをすぐ流す。2回目で「実際に選ばれた集合に対して」親スロットと並び順を聞く。公式の実装メモにはっきり書かれている——「バッチ化はコンポーネントごとのネットワーク往復を避ける。Jev は直列化された JSON を書かない。コードがその選択から JSON を組み立てる」。
さらに細かい挙動を2つ実測で確認した。1つは resource による排他。候補 line と bar に同じ resource: "chart" を付けておくと、この2つは別々の質問にならず、select_2 という1つの質問に「omit / use:line / use:bar」の3択としてまとまった。折れ線と棒の両方が同時に採用される事故が、質問の構造の段階で起きなくなっている。もう1つは頂点だけ、あるいは単一スロットに子が1つのときは2回目が不要という点。公式メモの記述どおり、レイアウトを聞く必要が無ければ評価は1回で終わる。
追加の編集は逐次プロトコルに戻る
新規作成はバッチだが、「あとからこの要素を消して」「見出しを変えて」といった追記編集は常に逐次だ。既存の Spec を initialSpec に渡すと、追加・置換・非ルート部分木の削除・移動/並べ替えができる。置換と移動は「対象を選ぶ」「置き換え先の候補または移動先を選ぶ」の2回の評価を消費する。変更しなかった要素の ID・バインディング・状態はそのまま保たれ、入力の Spec は変更されない。
モデルに渡るのはidとdescriptionだけ——ペイロードを実測する
「カタログに制約される」とだけ聞くと、カタログのスキーマ全体がモデルに送られている絵を想像しがちだ。実際はそうではなかった。スタブ評価役が受け取った state と questions をそのまま計測した。
| 評価 | state の長さ |
questions の長さ |
合計 |
|---|---|---|---|
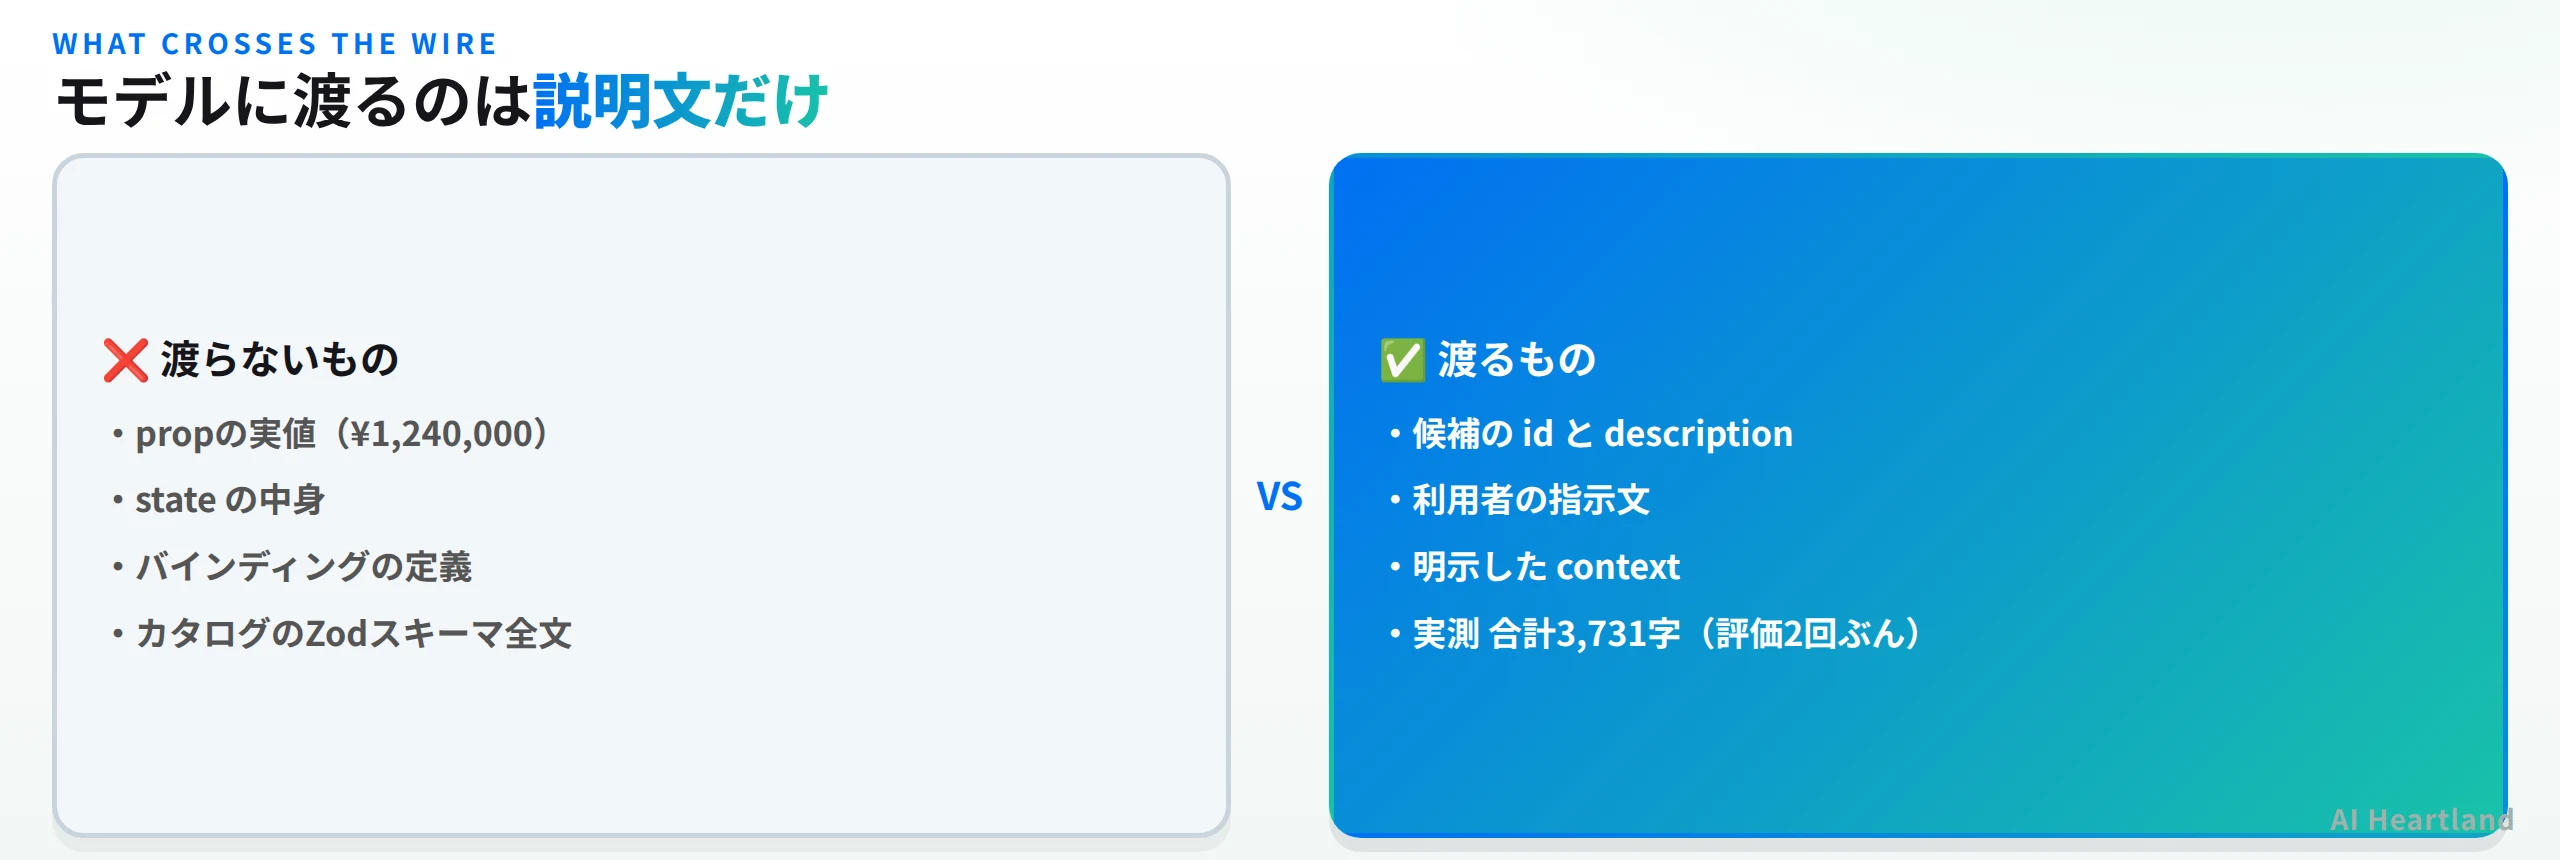
| 1回目(select) | 292字 | 1,950字 | 2,242字 |
| 2回目(layout) | 291字 | 1,198字 | 1,489字 |
| 合計 | — | — | 3,731字 |
state の中身は次の4キーだけだった。user_request(利用者の指示文)、context(アプリが明示的に渡した追加文脈。今回は空)、guidance(追加の指示。今回は空)、capabilities。そして capabilities は候補の id と description のペアの配列でしかない。
つまり ¥1,240,000 も 税抜・確定値 も { kind: "line" } も、モデルには一度も届いていない。2回目の state も同様で、selected_elements として id・type・content(候補の説明文)だけが並ぶ。公式の説明どおりだ——「候補の説明、要素の説明、明示的な context が評価役へ送られる。状態の値と生の props/バインディングは自動的には送られない」。
生成方式と比べるとどれだけ違うのか
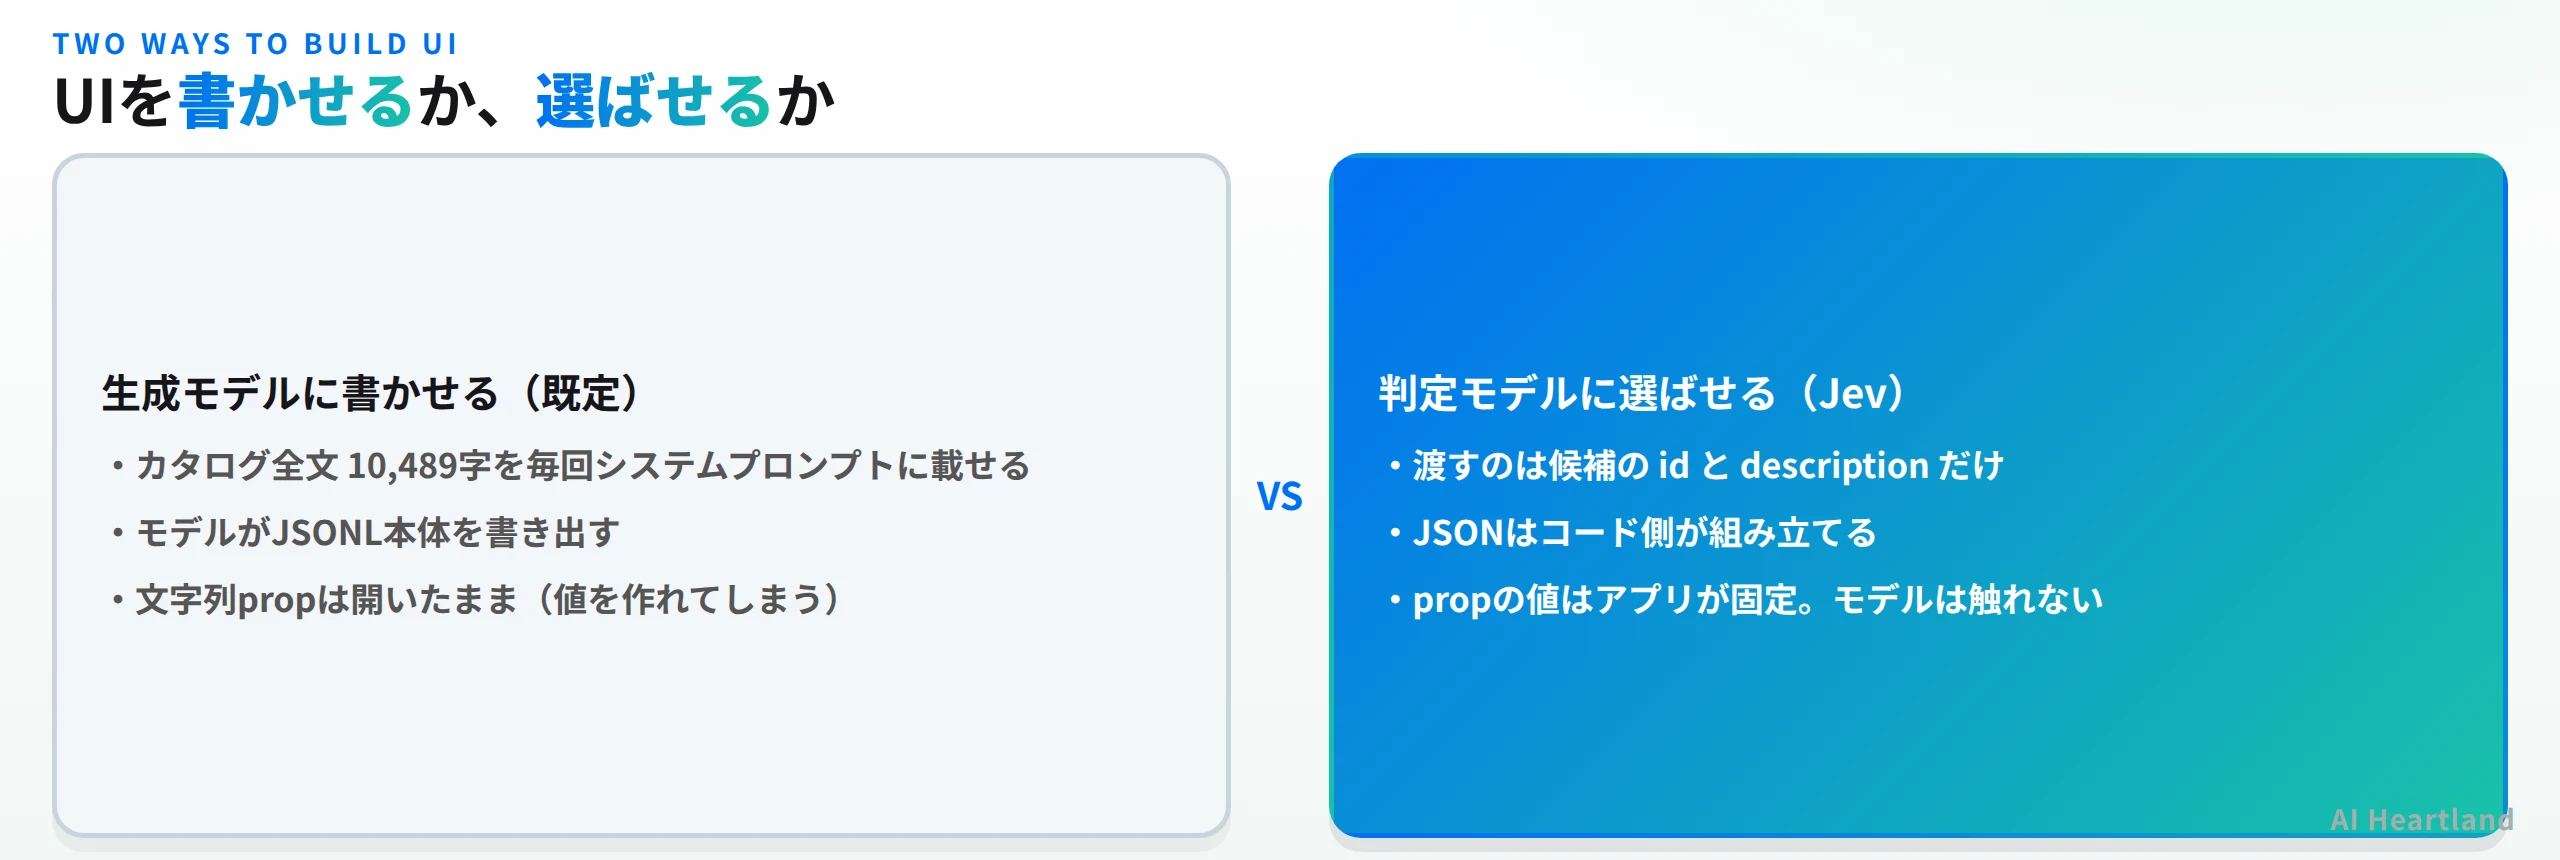
比較のために、同じ4コンポーネントのカタログで既定の生成方式が必要とするプロンプトも測った。catalog.prompt() が返すシステムプロンプトは 10,489字。これは JSONL の出力形式・JSON Patch の書き方・各コンポーネントの Zod スキーマ・式の文法をモデルに教えるためのもので、呼び出しのたびに毎回送る。しかもその上でモデルは Spec 本体を出力する。
| 観点 | 生成モデルに書かせる(既定) | 判定モデルに選ばせる(Jev 経路) |
|---|---|---|
| 毎回送る指示 | catalog.prompt() 10,489字(実測・4コンポーネント時) |
候補の id と description(実測 3,731字/UI 1つぶん・評価2回合計) |
| モデルの出力 | Spec 本体(JSONL の JSON Patch 列) | 質問ごとに選択肢のキーを1つ |
| 文字列 prop の値 | モデルが書ける(開いている) | アプリが固定。モデルは触れない |
| 想定外の出力への耐性 | スキーマ検証と autoFixSpec で後段修復 |
提示外の選択は受理せず例外 |
| 往復回数 | ストリーミング1回 | 新規は2回、編集は操作ごとに1〜2回 |
| 成果物の決定性 | プロンプト次第で揺れる | 同じ選択なら同じ Spec |
カタログが4コンポーネントで10,489字なので、@json-render/shadcn の36コンポーネントをそのまま載せればこの数字は一桁増える。判定方式のペイロードは候補の説明文の長さにしか比例しないので、カタログが育つほど差は開く。ただし判定方式は「候補をアプリ側が作る」コストを別に負う。ここは後述する。
Jev を実際につなぐときの設定
評価役を本物にするときのコードは、公式 README の例では次の形になっている。experimental_createEvaluator({ model: "typesafe-ai/jev", apiKey: process.env.AI_GATEWAY_API_KEY }) を作って evaluate に渡すだけだ。ソースを読むと、通信先は https://ai-gateway.vercel.sh/v4/ai/evaluation-model への POST で、ヘッダに ai-gateway-protocol-version: 0.0.1、ai-evaluation-model-specification-version: 4、ai-model-id: typesafe-ai/jev を載せ、ボディは { state, questions } だけ。タイムアウトは既定10秒、cache: "no-store"。
注意点が2つある。1つは TypeSafe の API キーは要らないこと。プレイグラウンドの実装メモにも「Gateway チームが typesafe-ai プロバイダを許可している必要がある。別途 TypeSafe の API キーは不要」と明記されている。もう1つは サーバー専用であること。型定義のコメントにも「サーバーサイドの Vercel AI Gateway キー。ブラウザのコードで絶対に露出させないこと」と書かれている。
Jev というモデル自体の質問の型(Choice・Noul・Score の3種)と料金構造については、Jevとは|文章を返さないSystem Oneモデルの正体を公式SDKのコードで実測し、Claude Codeで試す に公式 SDK のコードを読んだ記録を残してある。json-render が使っているのは Choice だけだ。
壊れ方を確かめる——カタログ外の答えを返したときに何が起きるか
「ガードレール付き」を掲げる以上、ガードレールを踏んだときの挙動が確かめられていなければ意味がない。評価役が差し替えられるという性質は、ここでこそ効く。わざと不正な答えを返すスタブを4通り用意して、陽性対照(正常系)と並べて走らせた。
| # | 評価役が返した答え | 実測結果 |
|---|---|---|
| ① | カタログにも候補にも無いラベル(Button) |
例外:Evaluator returned a choice outside the permitted catalog operations. |
| ② | 形式は合っているが存在しない候補(use:phantom) |
例外:同上 |
| ③ | root の質問で unavailable を選ぶ |
stopReason=unavailable、spec は null(要素は1つも出ない) |
| ④ | 提示された選択肢を正しく選ぶ(陽性対照) | stopReason=finish、root=node_0 で Spec が確定 |
①②が例外で止まり、④だけが Spec を返す。中途半端な UI が漏れる経路は無い。これは「判定した結果OK」と「判定できなかった」を混ぜない、いわゆる fail closed の設計だ。experimental-evaluator.ts のソース側にも同じ趣旨の検査が別にあり、Gateway の応答を Zod で検証したうえで「返ってきた選択が、提示した criteria のキーに含まれるか」を1件ずつ確かめ、外れていれば Evaluator returned a choice outside the offered criteria. を投げる。モデルの応答を信用していない。
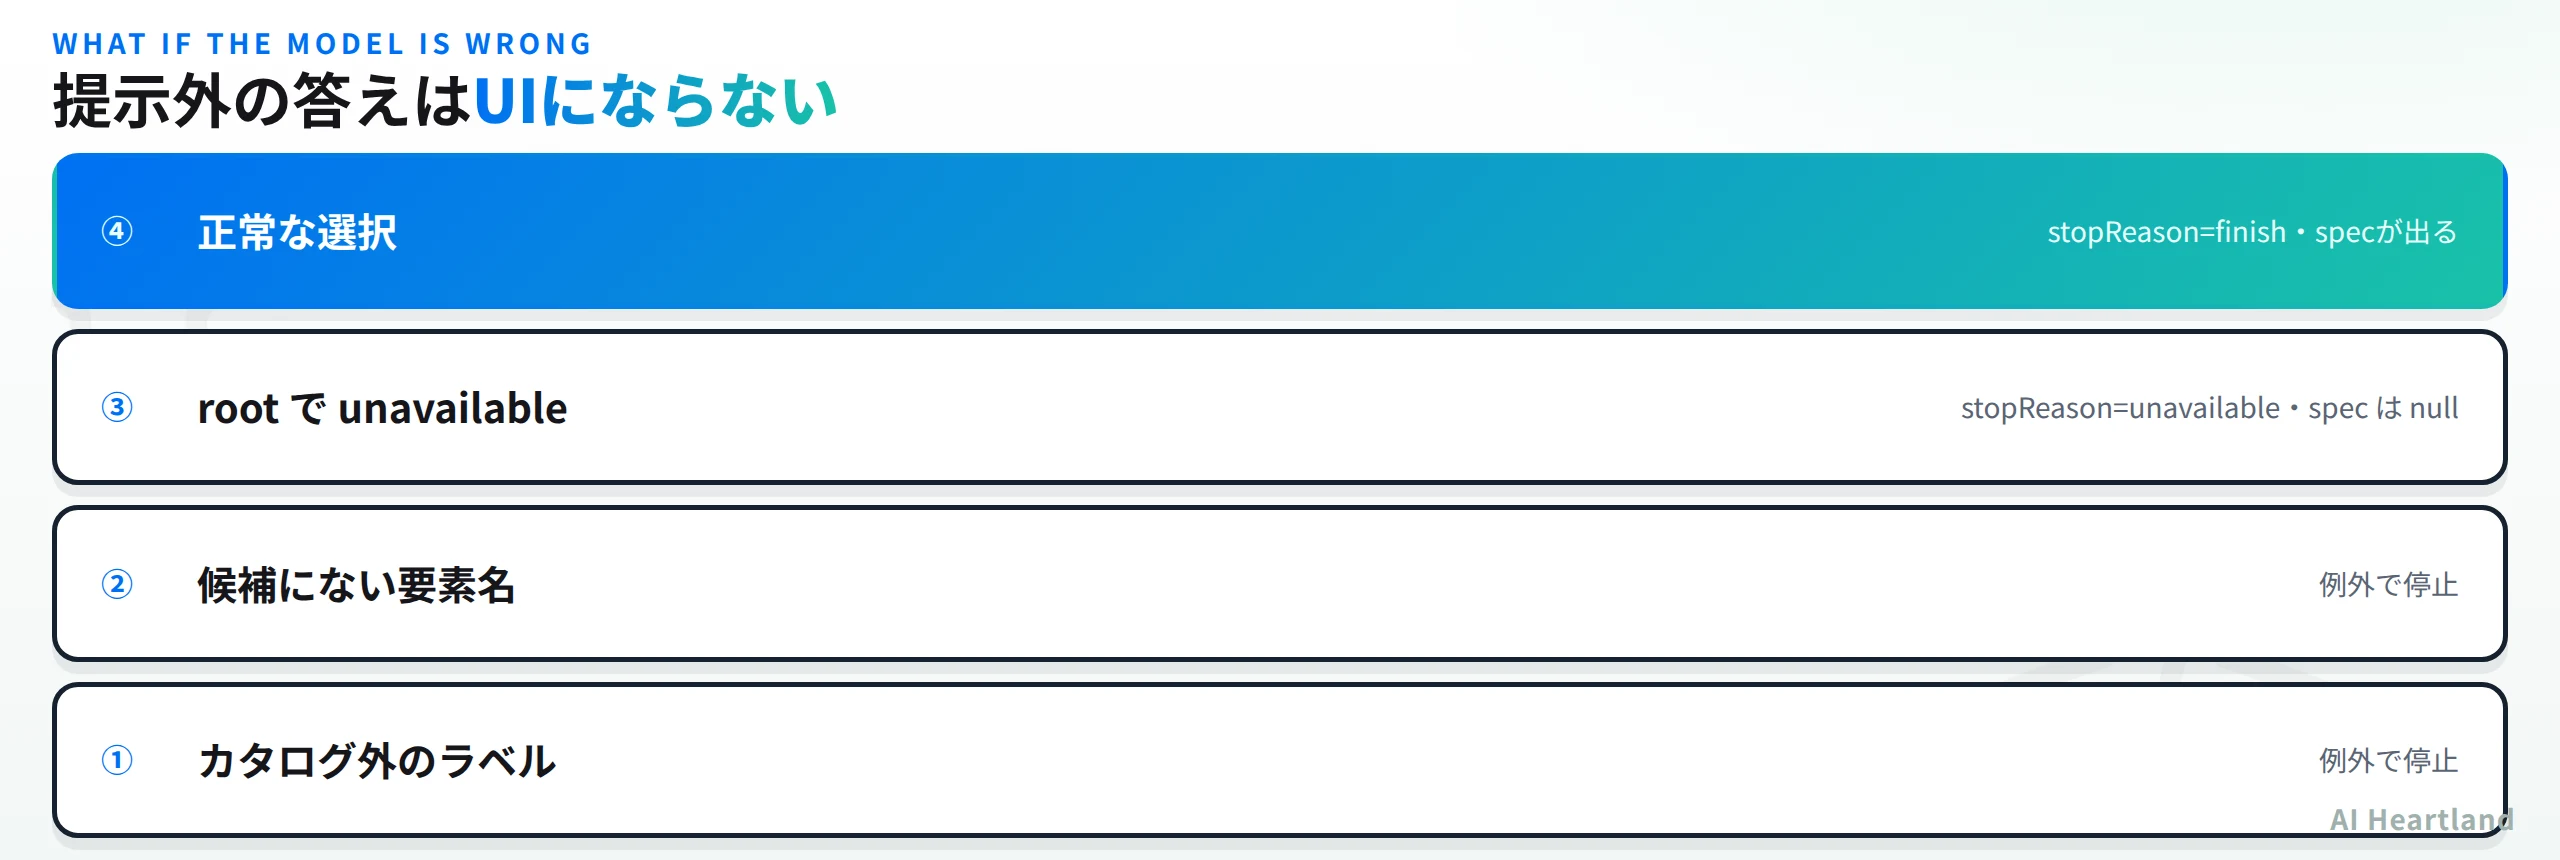
③の unavailable が用意されているのも重要だ。候補が指示に対して足りないとき、モデルが無理に近いものを選んで「それっぽいが違う UI」を作るのではなく、「作れない」と明示して降りられる。アプリ側はその stopReason を見てフォールバック(通常の生成モデルに回す、人手のテンプレートを出す、エラーを見せる)を選べる。
全体の流れを1枚にすると、次のようになる。
id・description・element"] --> B["experimental_composeSpec"] B --> C{"評価1:select
root と各候補の採用可否"} C -->|unavailable| X["stopReason=unavailable
spec は null"] C -->|選択あり| D["カタログ順のプレビューを流す"] D --> E{"評価2:layout
親スロットと兄弟の並び順"} E --> F["木を検証
深さ・循環・スロットの妥当性"] F -->|OK| G["stopReason=finish
spec 確定"] F -->|NG| H["例外。直前のプレビューが部分UIとして残る"] C -->|提示外の選択| H
例外が飛んだ場合も「直前のプレビューは使える部分 UI として残る」と公式が明記している。1回目の select が通っていれば、カタログ順に並んだ状態のものは手元にある。レイアウトの検証で落ちても画面が真っ白にはならない。
既定の生成経路にも検証はある
判定経路だけが安全というわけではない。既定の生成経路にも validateSpec と autoFixSpec がある。validateSpec は missing_child・invalid_visible・repeat_without_children・repeat_item_outside_scope・repeat_state_mismatch といった問題を報告し、autoFixSpec は修復を試みる。面白いのは修復が lossy か lossless か分類されることだ。位置がおかしいフィールドを移すのは lossless、宙に浮いた子参照を刈るのは lossy。公式スキルは「修復ループでは、リトライを使い切るまで lossy な修復を保留せよ」と書いている。autoFixSpec(spec, { lossy: retriesExhausted }) という形だ。
つまり同じフレームワークの中に、生成方式向けの「後から直す」道具と、判定方式向けの「そもそも間違った形を受け取らない」構造の両方が入っている。
何ができて何ができないのか——公式が書いた限界と、実測の突き合わせ
ここまでは動く側の話だ。公式は限界も明示的に書いていて、その率直さがこのプロジェクトの評価できる点でもある。プレイグラウンド実装のメモから、そのまま引く。
・計画が苦手:「合成器は木の構造と候補の値を検証するが、Jev が正しい UI を選んだことは保証しない。root の選択・グループ化・いつ止めるかの判断には計画が必要で、それは Jev の文書化された弱点である」
・確信度に閾値が無い:「確信度は品質ゲート無しで表示される。複数のレイアウト選択がどれも妥当でありうるし、普遍的な閾値は較正されていない」
・指示が短いと拾いきれない:「必要なセクションは明示的に指名すること。たとえば『上部に注文テーブル、売上/注文/顧客の指標を1行に、次に週次の売上チャート』のように。『上部にテーブルのあるダッシュボード』という短い指示では、テーブルだけが選ばれうる」
・候補はアプリが用意する:「カタログだけでは不十分。アプリが値とバインディングのレシピを供給しなければならない」
・V1 の機能制限:フラットな Spec カタログ・名前付きスロット・リテラル・$state・$bindState・状態ベースの可視性まで。repeat/watch、計算式・テンプレート・条件付き prop、候補レシピ内の部分木は対象外
最後の「候補はアプリが用意する」が、実務上いちばん重い。プレイグラウンドの例では、17種類のコンポーネント(Card・Stack・Grid・Heading・Avatar・Badge・Input・Textarea・Select・Checkbox・Switch・Button・Text・Metric・BarGraph・Table・Separator)に加えて、フォームのフィールド・検証ルール・ラベル・合成のプロフィールと商取引データ・許可された2つのアクション(formSubmit と setState)を、grammar.ts という専用ファイルで供給している。「準備された売上の BarGraph は選択も移動もできるが、LineGraph を選ぶには別の候補が必要」という一文がこの方式の性格をよく表している。
生成方式なら「棒グラフでも折れ線でも、モデルが勝手に選ぶ」。判定方式では、選ばせたい選択肢を先に全部並べておく必要がある。自由度をコードに書き下す作業がそのまま設計になる。
プレイグラウンドが自分に課している制限
公式のプレイグラウンドは、実際に運用するときの現実的な数字も公開している。新規バッチは14要素まで、1リクエストあたり14回の評価まで、ネストの深さは4まで、プロバイダへの1リクエストは10秒まで、全体で55秒まで。編集元として選べる Spec は最大100要素。ライブラリの既定値(評価32回・深さ8・要素32・Gateway 1回10秒)より、いずれも絞ってある。共有エンドポイントなのでレート制限も掛かる。
判断:どこで使い分けるか
3つに分けて考えるのが実用的だと思う。
判定方式が向くのは、出せる UI のパターンがあらかじめ列挙できて、業務データを外に出したくない場面だ。社内ダッシュボードの組み替え、フォームの動的構成、権限に応じた画面の出し分け。候補をアプリの実レコードと許可された操作から毎リクエスト組み立てられるなら、モデルには構造の判断だけを任せられる。ペイロードが小さく、往復も2回で済む。
生成方式が向くのは、出したい UI の形が事前に列挙できない場面だ。プロトタイピング、任意のデータに対する探索的な可視化、利用者が自由記述で指示するツール。カタログという制約は残るので、素の LLM に JSX を書かせるよりは何段も安全だ。
どちらも要らないのは、画面のパターンが十数個しかなく、条件分岐で書き切れる場面。AI を挟むこと自体が、レイテンシと非決定性と運用コストの純増になる。
判定モデルを使う側の注意も1つ。当サイトでは同じ Jev を CI の記事検査に組み込んで実データで回したが、初回の測定でモデルではなく質問の立て方が間違っていることが分かった、という経験がある。確信度に較正された閾値が無い以上、判定結果をそのままブロッキングのゲートに昇格させるのは早い。json-render 側が「確信度は品質ゲート無しで表示している」と書いているのは、同じ慎重さの表明だと読める。Jev を呼ぶ周辺 OSS の広がりは Jev対応OSS 11選|ブラウザ操作・MCP・コードレビュー・Claude Code文脈選別まで実測で見る使いどころ にまとめてある。
生成UIというジャンル全体の中での位置づけを見たい場合は、OpenUI徹底解説|LLMがUIを生成する”オープン標準”OSS(OpenUI Lang・ストリーミング) が近い。OpenUI は「LLM が UI を書き出す」側の標準化を狙っていて、json-render の既定経路と同じ層にある。json-render の v0.21.0 が踏み込んだのは、その一段外側だ。
未検証で残したこと
正直に書いておく。
・Jev の実物の応答は見ていない:Vercel AI Gateway のキーと typesafe-ai プロバイダの許可が必要で、本記事の検証環境からは取得できなかった。評価役をスタブに差し替えた合成パイプラインの挙動(質問の構造・ペイロード・壊れ方)は実測だが、Jev がどの選択肢を選ぶかの精度は未検証である
・レンダラは動かしていない:出力された Spec を React 等で描画するところまでは確認していない。13系統のレンダラの実挙動は未検証
・モノレポのテストは走らせていない:公式が案内する pnpm exec vitest run ... は Node.js 24 と pnpm 11 を要求するワークスペースが前提で、検証環境は Node v22.22.2 だった。検証は npm 公開版の @json-render/[email protected] に対して行った
・外部の紹介記事・関連サイトは参照していない:本記事の執筆時、検証環境から json-render.dev・x.com・jevable.com・infoq.com はいずれもネットワーク制限で取得できなかった。記述はすべてリポジトリ現物と npm パッケージ現物に基づく
・star 数の取得方法:api.github.com がブロックされる環境のため、16.8k はリポジトリページの表示値
検証環境:Linux 6.18.44/Node.js v22.22.2/npm 10.9.7/@json-render/[email protected](npm 公開版)/2026-09-20。リポジトリの既定ブランチ main の最新コミットは 3ad3818(2026-09-18・chore(release): prepare v0.21.0)。Jev の実応答・レンダラの描画・モノレポのテストは未検証。
参照ソース
・vercel-labs/json-render — 公式リポジトリ。Apache-2.0、⭐16.8k、fork 900、open issues 62(2026-09-20 時点)
・packages/core/README.md — experimental_composeSpec / experimental_createEvaluator の公式説明
・CHANGELOG.md — 0.21.0(2026-09-18)の “Experimental Jev composition”
・apps/web/lib/jev/README.md — Jev 合成の実装メモ、限界、プレイグラウンドの制限値
・@json-render/core(npm) — 実測に使った公開パッケージ v0.21.0