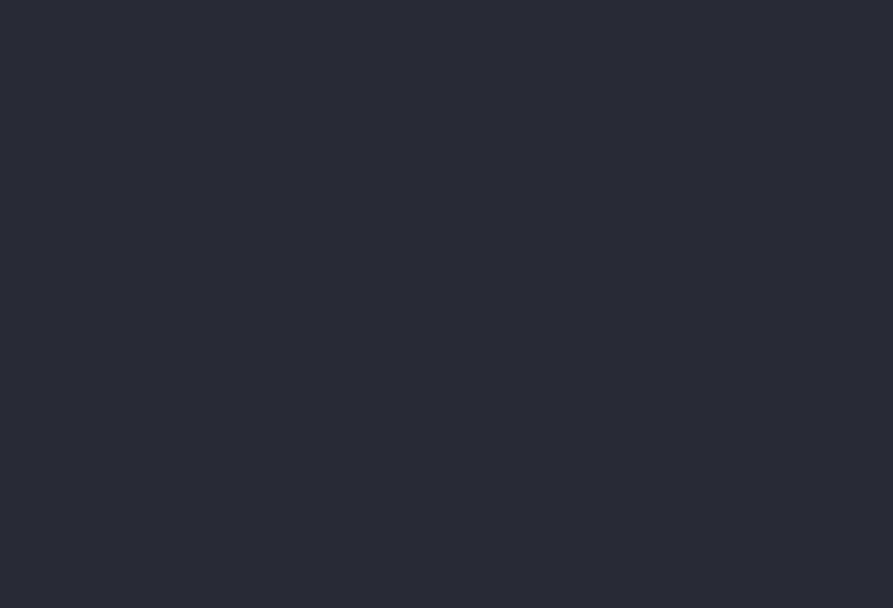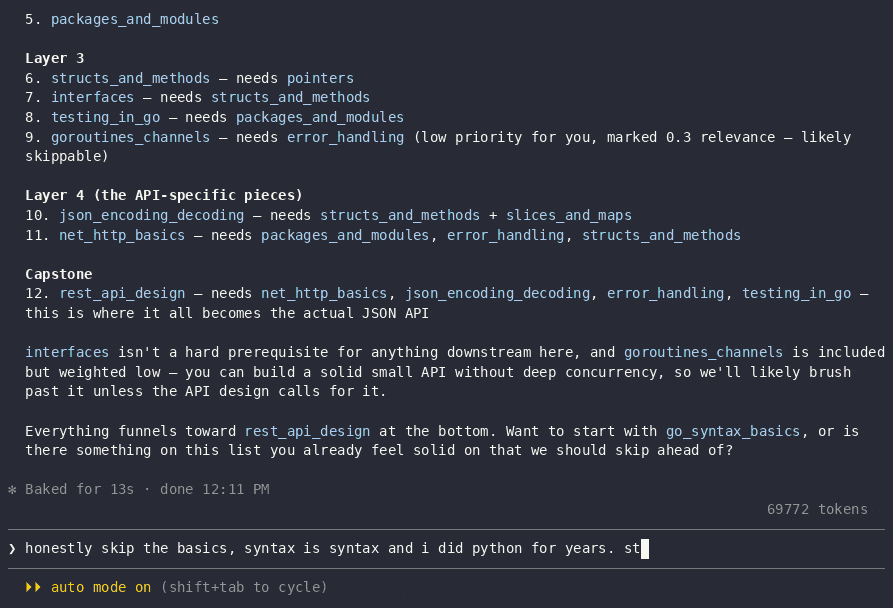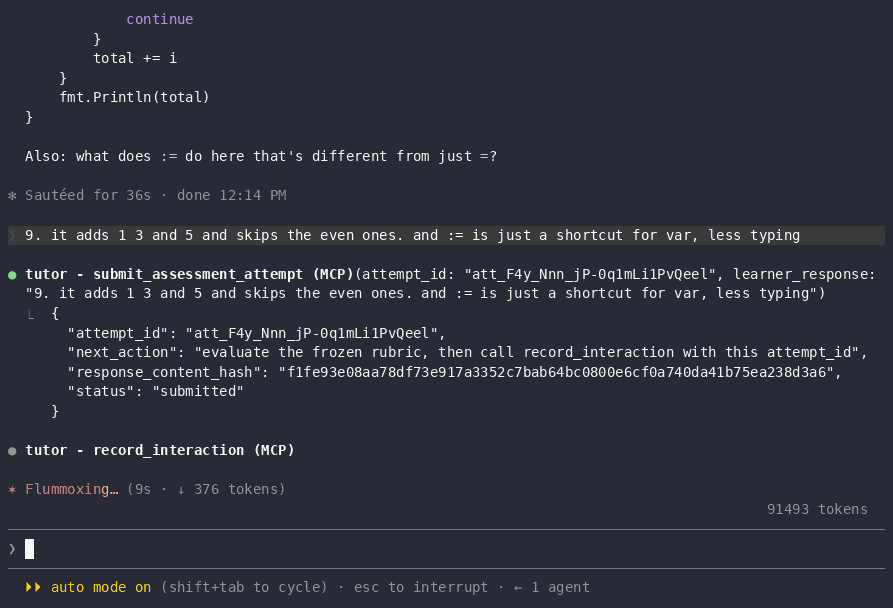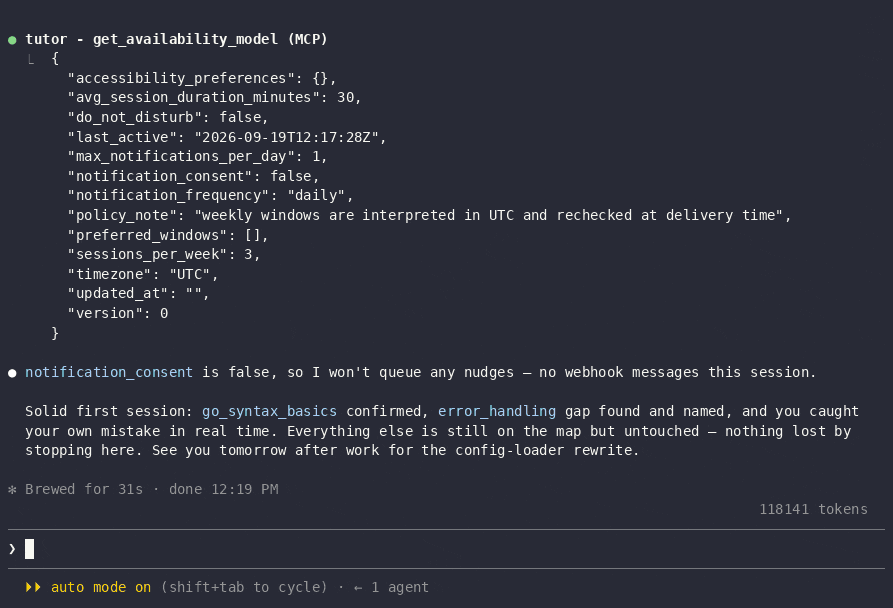
tutor-mcp は、Claude・ChatGPT・Gemini など MCP 対応のどの AI クライアントも、知的学習支援システム(ITS)に変える Go 製の OSS だ。主題と目標を決めると、AI がそれをスキルグラフに写し、診断・個別レッスン・演習・復習までを回す。設計の肝は「生成する教師・決定論的な教え方」——教材を作り説明するのは AI、進度を決めるのは監査可能なエンジン(習得度の BKT、間隔反復の FSRS など)という分担だ。MIT・star 67・alpha(v0.7.3)。まずは公式デモを見てほしい。
30秒でわかるtutor-mcp(v0.7.3・2026-11-02確認)
- ・MCP対応のどのLLMも知的学習支援システム(ITS)に変えるGo製OSS(MIT・開発者 Arnaud Guiovanna)。
- ・生成はAI、進度はエンジン。BKTで習得度を推定し閾値未満なら先へ進ませず、FSRSで復習日を出す。
- ・Local / Hobby / Institution の3プロファイル。データはローカルSQLite〜組織のPostgreSQLから選べる。
- ・alpha・star 67。教材の質は使うモデル次第で、内容は確かめる前提。版を固定して追うのが無難。
MCP そのものの仕組みはMCPサーバーの作り方2026年完全ガイド:TypeScript・Python両対応チュートリアルに、全体像はMCPの仕組み|リクエストの流れ・3つの機能・仕様改訂にまとめている。本記事はその応用として、「AI に“ちゃんと”教わる」ための1本を見る。
tutor-mcp とは:生成はAI、進度はエンジンが決める
生の LLM に「家庭教師して」と頼む弱点は、はっきりしている。毎回ゼロから始まり、あなたの習得度を覚えておらず、頼めばどんどん先へ進めてしまい、復習のタイミングは自己管理——結局「分かった気」で終わりやすい。tutor-mcp は、ここを学習科学の定石で律する。
HOW IT WORKS生成する教師・決定論的な教え方
AIが作り、エンジンが進度を決める
-
主題と目標を決める
『会話スペイン語』から『バックエンド』まで。AIが主題を概念・前提・目標のスキルグラフに写し、Tutorが検証・バージョン管理する
-
診断して個別化
出発点を診断し、個別のレッスンと演習を出す。弱点は復習に回す。narrative memory が会話をまたいで文脈を持つ
-
習得度を推定(BKT)
ベイジアン知識トレースで習得度を推定。閾値(例0.85)に満たなければ先の課題を出さない=飛び級させない
-
復習日を決める(FSRS)
間隔反復FSRSで復習日を算出。評価はルーブリックの証拠で記録し、断定でなく実証で進む
流れはこうだ。主題と目標を決めると、AI がそれを概念・前提・目標のスキルグラフに写し、Tutor がそれを検証してバージョン管理する。出発点を診断し、個別のレッスンと演習を出し、弱点は復習に回す。ここで効くのが決定論エンジンだ。習得度はBKT(ベイジアン知識トレース)で推定し、閾値(デモでは 0.85)に満たなければ先の課題を出さない=飛び級させない。復習日はFSRS(間隔反復)で決め、合否は凍結したルーブリックの証拠で記録する。「できたと言い張る」のではなく「実証して進む」わけだ。narrative memory が会話をまたいで文脈を保つので、別の日でも続きから学べる。
重要なのは、これがマーケティング上の主張ではないことだ。これらのアルゴリズムはリポジトリの algorithms/ に実装されている(bkt.go・fsrs.go・irt.go=項目反応理論・kst.go=知識空間理論・thresholds.go)。生成の自由さと、進度の厳密さを分けたのが、この道具の設計思想だ。
生のLLMと何が違うか:BKTとFSRSの役割
背骨になっている2つのアルゴリズムを、かみ砕いておく。
RAW LLM VS TUTOR直接LLMに教わるのと何が違うか
その場の説明か、続く学習の設計か
LLMに直接『教えて』
tutor-mcp 経由
LLMに直接『教えて』: 毎回ゼロから。習得度を覚えていない
tutor-mcp 経由: 習得度(BKT)と履歴を持ち越す
LLMに直接『教えて』: 頼めば先に進めてしまう(飛び級)
tutor-mcp 経由: 閾値未満なら先の課題を出さない
LLMに直接『教えて』: 復習のタイミングは自己管理
tutor-mcp 経由: 間隔反復(FSRS)で復習日を提示
LLMに直接『教えて』: できた『気』で終わりがち
tutor-mcp 経由: ルーブリックの証拠で実証して記録
BKT(ベイジアン知識トレース)は、正答・誤答の履歴から「この概念を本当に身につけている確率」を更新し続ける手法だ。一度正解しただけでは確率は閾値に届かず、まぐれ当たりや取りこぼしも確率として織り込む。だから tutor-mcp は「2回連続で正解」ではなく「習得している確率が 0.85 を超えた」で先へ進ませる。FSRS(間隔反復)は、人の忘却曲線に合わせて「次にいつ復習すべきか」を算出するアルゴリズムで、Anki などでも使われる考え方だ。覚えたてのものは短い間隔で、定着したものは長い間隔で出すことで、最小の反復で記憶を保つ。この2つが、「生成AIが作った教材」を「続く学習」に変える要になっている。
冒頭のデモ(Claude Code 上の実セッション)は、この仕組みを具体的に見せている。README の説明によれば、学習者が「Go のバックエンド開発」を目標に挙げると、Tutor は主題を18 概念のスキルグラフに写し、学習者の Python の素養から何が転用できるかを診断する。そのうえで、習得度の推定がルーティング閾値 0.85 に対して 0.33 にとどまるため、Feynman(自分の言葉で説明させる)や転用の問いをまだ出さずに断る。練習を2回こなして推定が閾値を超えると、今度は未見のデバッグ場面で転用の問いを出し、結果を「できたと主張させる」のではなく凍結したルーブリックに照らして記録する。「分かったつもり」を機械的に塞いでいく様子が、そのまま映っている。
向くのは、独学で体系立てて積み上げたい人、語学や資格を継続的に進めたい人、そして研修プログラムを設計・共有したい組織だ。逆に、今すぐ一問だけ答えが欲しいだけなら、生の LLM に直接聞けば十分で、この道具の出番ではない。学習を「設計して続ける」ことに価値を感じるかどうかが分かれ目になる。
どのクライアントで、どこにデータを置くか
tutor-mcp は MCP サーバなので、MCP 対応のクライアントから使う。README によれば Claude Code・Claude Desktop・ChatGPT・Gemini CLI・Le Chat・Hermes・Pi などに対応し、ローカルは stdio、リモートは HTTPS/OAuth で接続する。同じ Tutor インストールに繋げば、クライアントを替えても学習履歴は共有される。
データの置き場所は3つのプロファイルから選べる。
| プロファイル | 向き | 構成 |
|---|---|---|
| Local | 自分の PC で学ぶ | 1バイナリ + --local。MCP クライアントが起動し、SQLite に履歴。アカウント・サーバ不要 |
| Hobby | 個人VPS・小グループ | --profile hobby、SQLite + HTTPS プロキシ。SSH で招待、ユーザー名/パスワードでログイン |
| Institution | 学習コミュニティ・研修組織 | --profile institution、公開鍵ID・PostgreSQL・API/worker/migrator を分離。共有カタログと貢献レビュー |
いちばん手軽なのは Local だ。MCP クライアントの設定でサーバとして登録すると、クライアントがバイナリを起動してくれる。
# ソースから(Go が要る)。リリースのバイナリでも可。詳細は docs/installation.md
git clone https://github.com/ArnaudGuiovanna/tutor-mcp
cd tutor-mcp && go build -o tutor-mcp .

# ローカル実行(履歴は手元の SQLite)。通常は下のMCP設定からクライアントが起動する
./tutor-mcp --local
MCP クライアント(例:Claude Desktop)には、stdio のサーバとして次のように登録する(パスは自分の環境に合わせる)。
{
  "mcpServers": {
    "tutor": { "command": "/path/to/tutor-mcp", "args": ["--local"] }
  }
}
組織で使うなら、Windows デスクトップクライアント Tutor ACP がある。メンバーは共有カタログからプログラムを見つけ、自分のペースで学び、会話と進捗に戻れる。オーナーはメンバーとアクセスを管理し、著者や認可されたトレーナーが同じアプリからプログラムを保守する。クライアントは仏/英の2言語とライト/ダーク/システムのテーマに対応し、学習の証拠を扱う仕組み(バッジや修了。リポジトリの auth/badges.go・certification/)も含まれる。公開したプログラムは、明示的な移行があるまで登録済み学習者向けに版を保つため、途中でカリキュラムが足元から変わる心配が小さいのも、組織運用では効く点だ。
# 組織向けサーバ(PostgreSQL・ロール分離)。詳細は docs/installation.md の institutional-deployment
./tutor-mcp --profile institution
使う前に押さえる点
・ステータスは alpha・star 67:新しいプロジェクトで、仕様やコマンドは変わりうる。版を固定して追うのが無難
・生成の質はモデル次第:エンジンは進度を律するが、教材の内容そのものの正しさは保証しない。説明は確かめる前提で使う
・スキルグラフは AI が作る:前提や目標の妥当性は自分でも点検したい。おかしなグラフの上に積み上げない
・データの置き場所を選べる:機微な学習内容は Local プロファイルで手元の SQLite に留めるのが堅実。VPS/組織は HTTPS/認証の設計を確認
・MCP 権限に注意:クライアント側で Tutor に与えるツール権限は、会話や再起動をまたいで記憶させられる。付与範囲を把握しておく
・学習エンジンは共通:どのプロファイル・どのクライアントでも同じエンジン。まず Local で自分の学習に効くか試すのが早い
総括。 tutor-mcp の面白さは、「AI に教わる」をその場の説明から、続く学習の設計へ引き上げた点だ。生成の自由さは AI に任せ、進度は BKT と FSRS という枯れた学習科学の手法で律する——この分担が、生の家庭教師プロンプトとの決定的な違いになる。alpha で小さなプロジェクトだが、アルゴリズムは実装済みで、データは手元に置ける。独学を「分かった気」で終わらせたくない人は、MCP クライアントに Local で挿して、自分のテーマで一度回してみる価値がある。
参照ソース
- ArnaudGuiovanna/tutor-mcp(公式リポジトリ) — README・
algorithms/(bkt/fsrs/irt/kst)・assessment/・mcp_http.goを 2026-11-02 に確認(v0.7.3・MIT) - tutor-mcp リリース(v0.7.3・Tutor ACP 0.0.4 の配布)(版とデスクトップクライアントの入手)
- Model Context Protocol 公式(MCP の仕様。tutor-mcp が載る土台)
- MCPサーバーの作り方2026年完全ガイド(当サイト) / MCPとは?MCPサーバーの仕組みを図解(当サイト) — MCP の基礎