pstack は、Cursor公式のプラグイン集 cursor/plugins(star 9.2k・96プラグイン)に入っているスキル集だ。作者は React コアチームの Lauren Tan(@poteto)で、ライセンスは MIT。その中の /create-verification-skill と /maintain-verification-skill の2本が「ぜひコピーしてほしい」と紹介されていたので、ソースを読んで何を生成し何を維持するのかを確かめた。
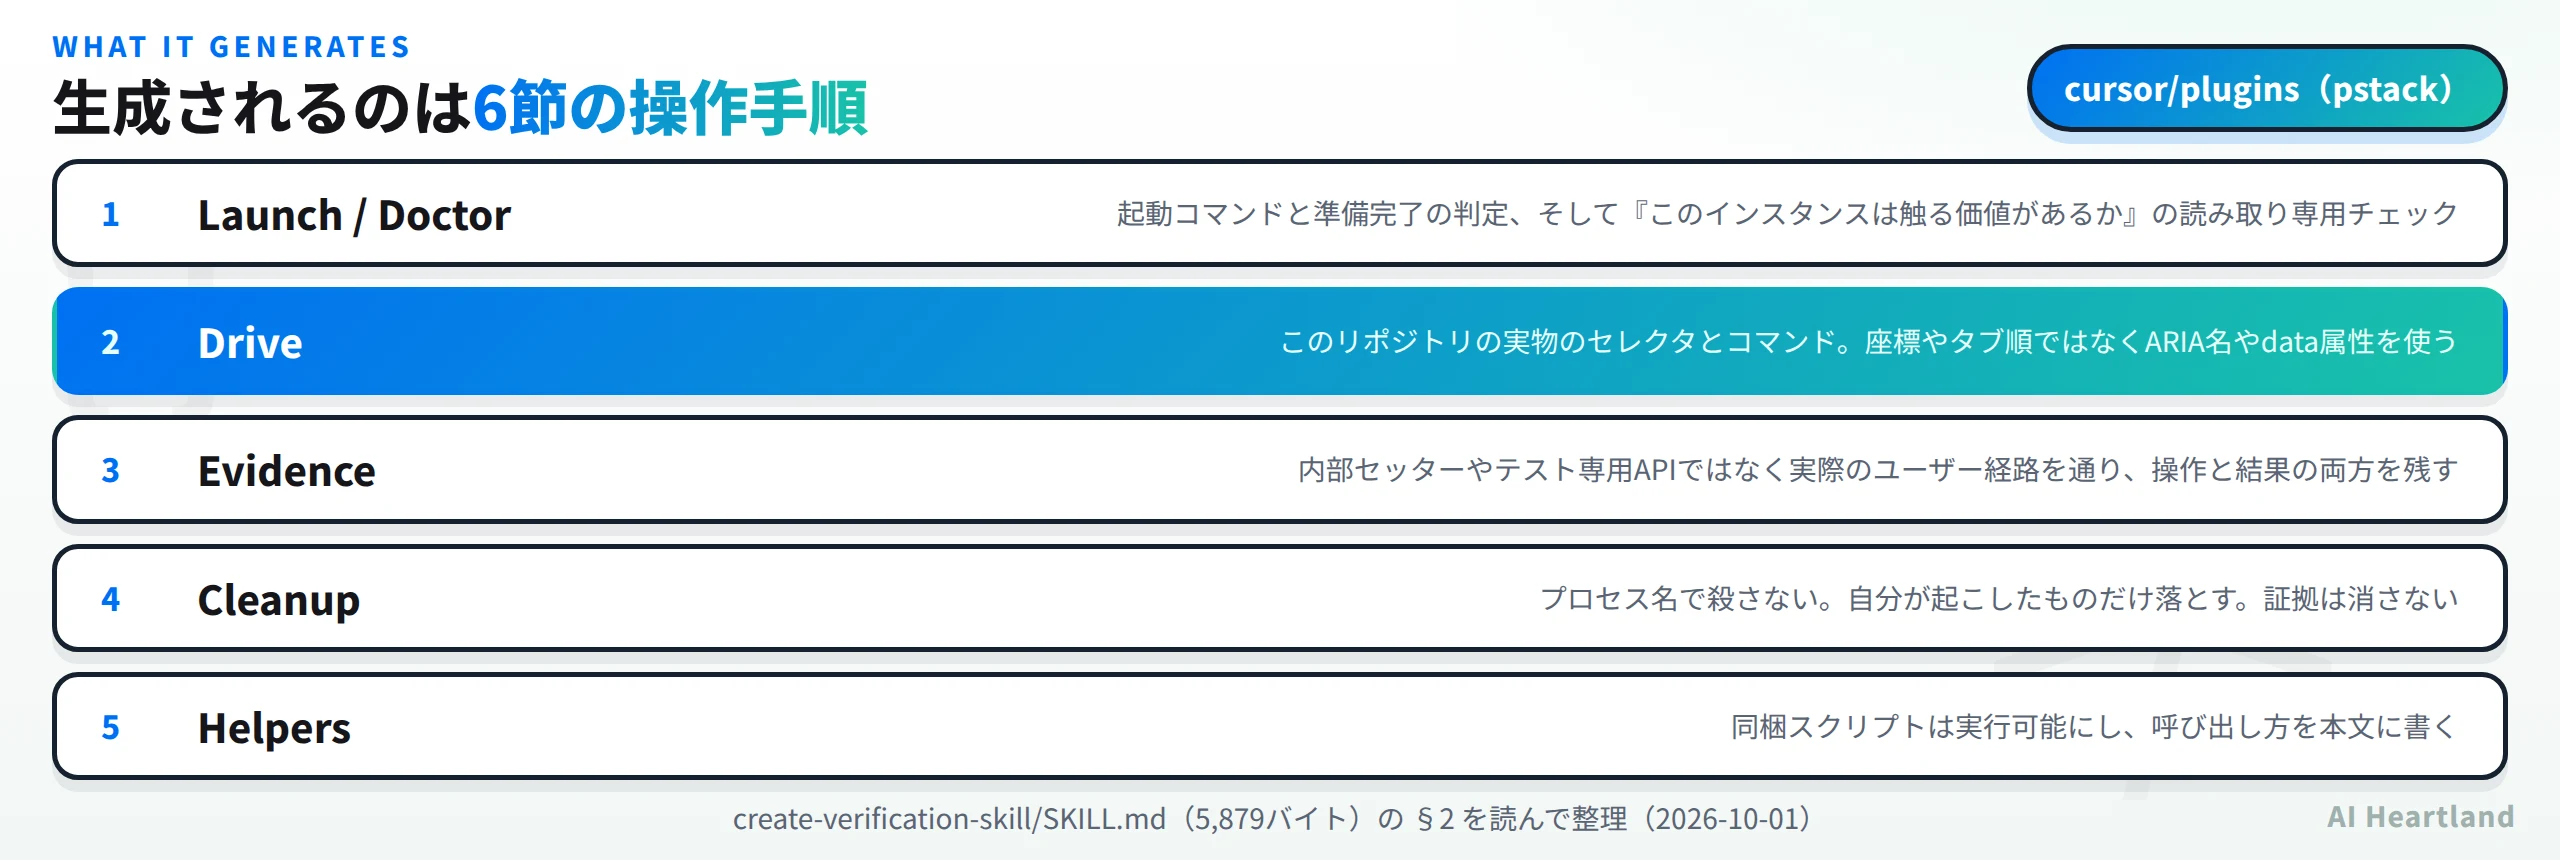
- ・`/create-verification-skill` が**リポジトリ固有の操作手順**を `.cursor/skills/verify-<app>/` に生成する
- ・生成物は **Launch・Doctor・Drive・Evidence・Cleanup・Helpers の6節**。中身はこのリポジトリの実物
- ・あわせて **feature map**(機能ごとのファイル)を作る。H2は**4つに固定**され、ユーザー視点で書く
- ・`/maintain-verification-skill` が**並列で読み、直列で触って**地図の腐りを直す。結末は clean / changed / blocked の3択
- ・pstack は**47スキル**。本文合計は約43,316トークンだが、**常駐は約3,433トークン**
- ・**46/47 が `disable-model-invocation: true`**。勝手に発動しない設計になっている
エージェント基盤の全体像はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその周辺で、「エージェントに自分の作業を証明させる」という一点だけを扱う。
pstackの検証スキルとは:アプリを動かせるエージェントを作る
前提から確認しておきたい。エージェントにコードを書かせたとき、それが本当に動いたかを誰が確かめるのか。テストが通っただけでは「ユーザーが触って動く」ことの証明にはならない。かといってエージェントにアプリを触らせようにも、起動方法も入口も観測方法も知らない。だから多くの場合、検証は人間の仕事として残る。
/create-verification-skill はそこに手を入れる。やることは「アプリを操作して証拠を残す手順」をリポジトリ固有のスキルとして生成することだ。SKILL.md の冒頭に方針がはっきり書いてある——生成物は人間向けではなく、アプリを見たことのない次のエージェントが作業の途中で冷えた状態から読むことを前提に書け、と。
生成の前に「リポジトリへのインタビュー」を5項目でやる。ユーザーが実際に触る面は何か(Web UI・CLI/TUI・デスクトップ・API・モバイル・ライブラリ)、どう起動するか、プログラムからどう操作できるか、何を証拠として捕まえられるか、そして2つのインスタンスを並べて走らせられるか。最後の項目が実務的で、並走できないなら生成物にそう書け、共有インスタンスを二重に叩いて壊すより拒否するほうがマシだと明記している。
インタビュー5項目"] --> B["検証スキルを生成
cursor/skills/verify-app/"] B --> C["feature map を種まき
機能ごとに1ファイル"] B --> D["生成物を1回通しで実行
起動・診断・1機能・証拠・後始末"] D --> E["動いたものだけ引き渡す"] C --> F["maintain-verification-skill
並列で読み直列で触る"] F --> C F --> G["clean / changed / blocked
changed のときだけPR1本"]
導入はプラグインとして入れる形になる。
/add-plugin pstack                 # cursor/plugins のマーケットプレイスから
/create-verification-skill         # 明示的に呼ぶ(自動発火はしない)

# 生成されるもの
.cursor/skills/verify-<app>/
├── SKILL.md                       # Launch / Doctor / Drive / Evidence / Cleanup / Helpers
└── features/
    ├── README.md                  # 索引と前提条件と証明の基準
    ├── <feature-1>.md             # 機能ごとに1枚(まず3〜5本)
    └── <feature-2>.md
配られ方は素の Agent Skills で、特別な実行系は無い。SKILL.md 1枚と(片方は)参考ファイルだけだ。frontmatter を見ると、この2本がどう扱われるつもりなのかが分かる。
head -5 pstack/skills/create-verification-skill/SKILL.md
# ---
# name: create-verification-skill
# description: "Generate a project-local verification skill that drives your app the way a user does ..."
# disable-model-invocation: true
# ---

# 47本ぶんの本文と frontmatter を数える
find pstack/skills -name SKILL.md | wc -l          # 47
cat pstack/skills/*/SKILL.md | wc -c               # 173264  ≈ 43,316 tokens
# frontmatter だけの合計                            # 13732   ≈  3,433 tokens
grep -L "disable-model-invocation: true" pstack/skills/*/SKILL.md   # setup-pstack のみ
disable-model-invocation: true が効いている。これが入ったスキルはモデルの判断で勝手に起動せず、/create-verification-skill と明示的に打ったときだけ動く。47本のうち46本がこの設定で、例外は setup-pstack(使うモデルと推論予算を設定するスキル)1本だけだった。検証のように走らせる場所と時機を人が決めたい作業では、この振る舞いのほうが扱いやすい。
コストも測っておいた。47本の SKILL.md 本文は合計173,264バイト、ASCII換算の heuristic 近似トークナイザで約43,316トークン。ただし Agent Skills は必要になったものだけ読み込む仕組みなので、常時エージェントの文脈にあるのは frontmatter の合計13,732バイト=約3,433トークンにとどまる。47本を抱えたまま普段の作業をしても負担にならない、という設計になっている。なお23本が principle- で始まる設計原則のスキルで、検証の2本だけ抜き出して使うこともできる。
生成物の中身:Launch から Cleanup までの6節
生成される SKILL.md の6節は、それぞれ「何を書くか」だけでなく「何を書いてはいけないか」まで指定されている。ここが読みどころだった。
Launch は起動コマンドと、準備完了をどう判定するか(ログの行・ポートの応答・プロンプト)。短命なCLIやTUIにはサーバーが無いので、起動とは「一度ビルドして、操作ごとに隔離されたPTYかtmuxセッションを立てること」だと定義し直している。
生成の前段にも条件が付く。チェックアウトがそのままビルドも起動もできないなら、まずそれを直すか正確に報告してから生成しろ——壊れた土台に対して書かれたスキルは間違った手順を教えるから、という理由だ。ただし本筋と関係のない不足物(APIが配信しない静的ディレクトリ、サンプル設定)が起動を妨げているだけなら、生成されるスキルがそれを作ってよい。ただし検証用の足場だと明示し、後始末で消すという条件付きになっている。
Doctor は「このインスタンスは触る価値があるか」を答える読み取り専用のチェック1本。プロセスが生きているか、版が正しいか、ポートを握っているのは自分か、認証は有効か。何かおかしいと感じたらまずこれを走らせる。
Drive は操作のレシピで、このリポジトリの実物のセレクタとコマンドを書く。例ではなく実物、と明記されている。しかも座標やタブ順ではなく、ARIAラベル・data属性・プロンプト文字列・ルートパスといった安定した手がかりを選べという指定が入る。
Evidence が一番厳しい。証明の基準として4つ挙がっている。内部セッターやテスト専用エンドポイントではなく実際のユーザー経路を通ること。最終画面だけでなく操作とその結果の両方を捕まえること。目に見えるものと並べて副作用(書かれたファイル・挿入された行・送られたメッセージ)も確認すること。モックは本番の境界がすでに外部システムを切り離している箇所だけに使うこと。加えて、dry-run や test モードを使うときは名前を信じず、何を実際に飛ばしているかをファイル・ネットワーク・gitの参照から観測して確かめろとある。dry-run と名乗りながらネットワークを叩いたりブラウザを開いたりするものがある、という但し書き付きだ。
Cleanup は2つの禁止事項が要点になる。プロセス名で殺すな、自分が起こしたものを殺せ。 そして後始末で証拠を消すな——インスタンスと一時状態は消し、証明のための成果物はスキルが指定した場所に残す。
Helpers は「同梱するスクリプトは実行可能にし、呼び出し方を本文に示せ」。読み手がリバースエンジニアリングしないと使えないヘルパーはヘルパーではない、と切り捨てている。
そして最後の工程が効いている。生成したスキルを引き渡す前に、その手順を自分で一度通しで実行する。 起動し、診断し、地図にある機能を1つ操作し、証拠を捕まえ、後始末する。後始末のあとで証拠がまだ指定の場所にあるかまで確認する(証拠を食う後始末はここで落ちる)。失敗したら直して、失敗した試行のあとにも毎回後始末を走らせるので、壊れた試行がプロセスやポートを取り残さない。SKILL.md の表現を借りれば、一度も実行されていない生成物は成果物ではなく下書きだ。
feature map は次のエージェント宛てに書く
もう一つの生成物が feature map で、これが「アプリ内の全機能を、ユーザーの視点からどう辿ってどう使うかで示した地図」にあたる。
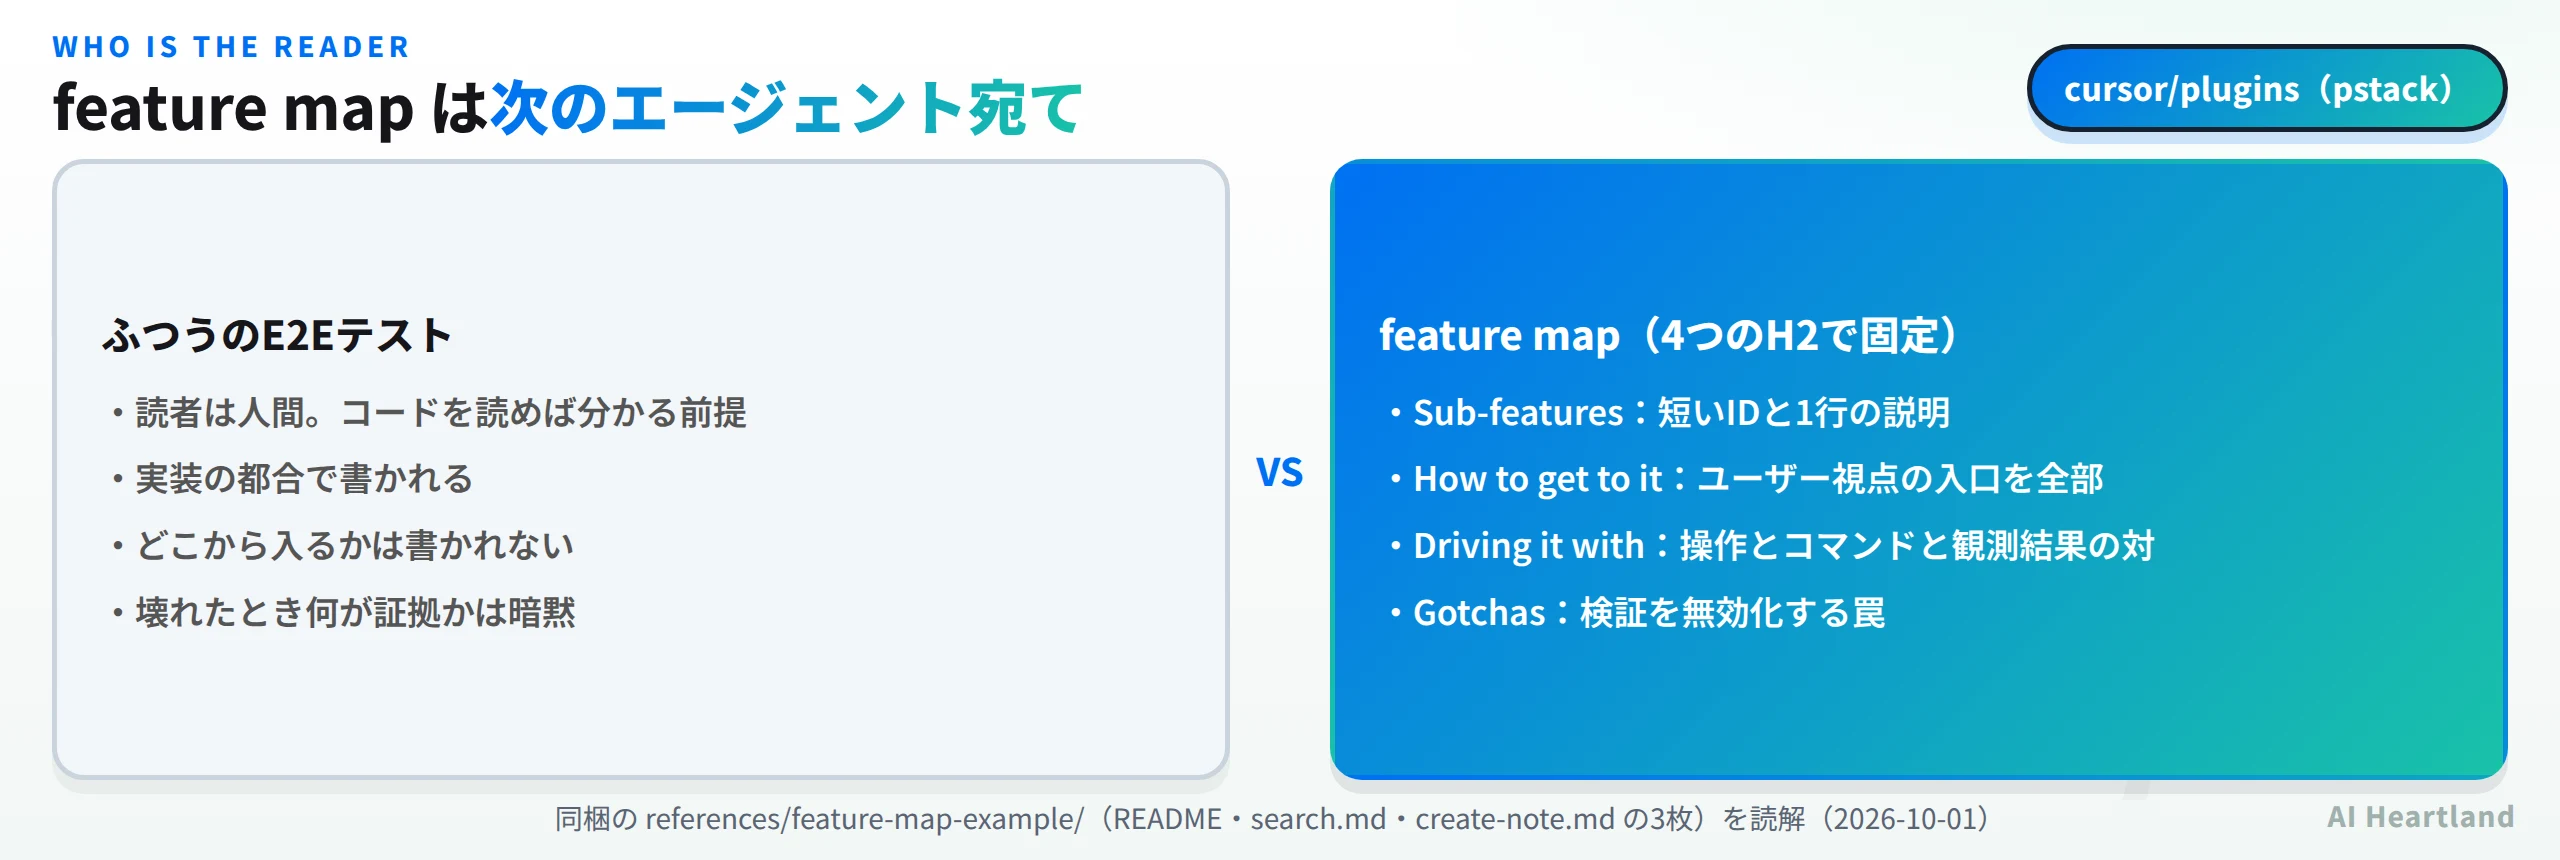
形は完全に固定されている。各ファイルはH1のタイトルと、ユーザーに見える振る舞いを書いた段落1つで始まり、そのあと4つのH2がこの順番で並ぶ。Sub-features(短いIDと1行の説明)、How to get to it (user POV)(ユーザー視点の入口を全部)、Driving it with <harness>(Preconditions: から始まり、操作とコマンドと観測結果を対にする)、Gotchas(検証を無駄にしたり無効にしたりする罠)。実装の詳細は地図に入れるなとも指定されている。書いてよいのはユーザーの経路、安定した手がかり、必要な状態、コマンド、観測できる証拠だけだ。
同梱の実例(架空のメモアプリと control-notes というハーネス)を読むと、粒度が具体的に分かる。
## How to get to it (user POV)
- Choose the `Search` button in the browser toolbar.
- Press `/` in the browser while focus is outside an editable field.
- Run `notes search <query>` in a terminal.

## Driving it with control-notes
- **Title match.** Type `quarterly`.
  Run `control-notes browser fill --role searchbox --name "Search notes" --value "quarterly"`.
  The `Search results` list contains `Quarterly plan` and does not contain `Grocery list`.
- **Empty state.** Reopen search and enter `volcano`. ...
  A status named `No matching notes` appears after search completes.
入口を3つとも書いているのがポイントだ。索引側の README には「地図が他の入口を挙げているのに、都合のよい入口1つだけを通した証明は不完全だ」と明記されている。ツールバー・キーボードショートカット・CLI のうち1つで通しただけでは足りない、という基準になっている。
索引の README は機能ファイルの一覧だけではなく、全機能に共通する前提と作法を先に決める場所になっている。実例では「使い捨てのデータディレクトリを指す環境変数を設定して起動する」「同時実行が状態を共有しないようにする」「決まったタイトルのデータを種まきする」「ハーネスと本体のCLIをPATHに置く」「doctor を走らせて期待するURL・データディレクトリ・ビルドリビジョンを確認する」、そして「この検証実行が起こしたのではないインスタンスは決して操作しない」までが前提条件として並ぶ。
操作の作法も同じ場所にある。各レシピは前提条件が別途指定しない限りベースライン状態から始める。CSSセレクタやDOMの位置よりARIAロールとアクセシブル名を優先する。コマンドは字句どおり扱い、引用された名前やフラグを変えない。ブラウザ操作もターミナル操作もハーネス経由で通す。変更を加えたら種まきデータを復元する——ただし証明の成果物は後始末で消さない。
つまり feature map は機能の説明書であると同時に、そのアプリを安全に触るための運用規約でもある。機能ファイルを1枚読めば操作できるのは、この共通部分が索引に切り出されているからだ。
README には証明と報告の規約も並ぶ。UIの証明にはARIAスナップショットとアプリの識別情報が写ったスクリーンショットを含める。CLIの証明にはコマンド・stdout・stderr・終了コードを含める。変更の証明には保存された値を別経路から読み直した第二の視点を含める。そして「到達できなかった経路を、別の経路で通ったことにして報告するな」。
こうした「スキルを配って作業の型を揃える」やり方は、当サイトで扱ったAgent Skill Creator解説|スキルを自動生成し17プラットフォームへ配るOSSの品質ゲートを実測やClaude-OSINTとは|9本のOSINTスキルの起動条件・常駐トークン・安全弁を実測で確かめたと同じ流れにある。違うのは、pstack の2本が成果物の検証そのものを型にしている点だ。
維持ループ:並列で読み、直列で触る
紹介文にもあったとおり、feature map はすぐ古くなる。/maintain-verification-skill がその上書き担当で、SKILL.md の1行目が「feature map はアプリが変わった瞬間に腐る」から始まる。
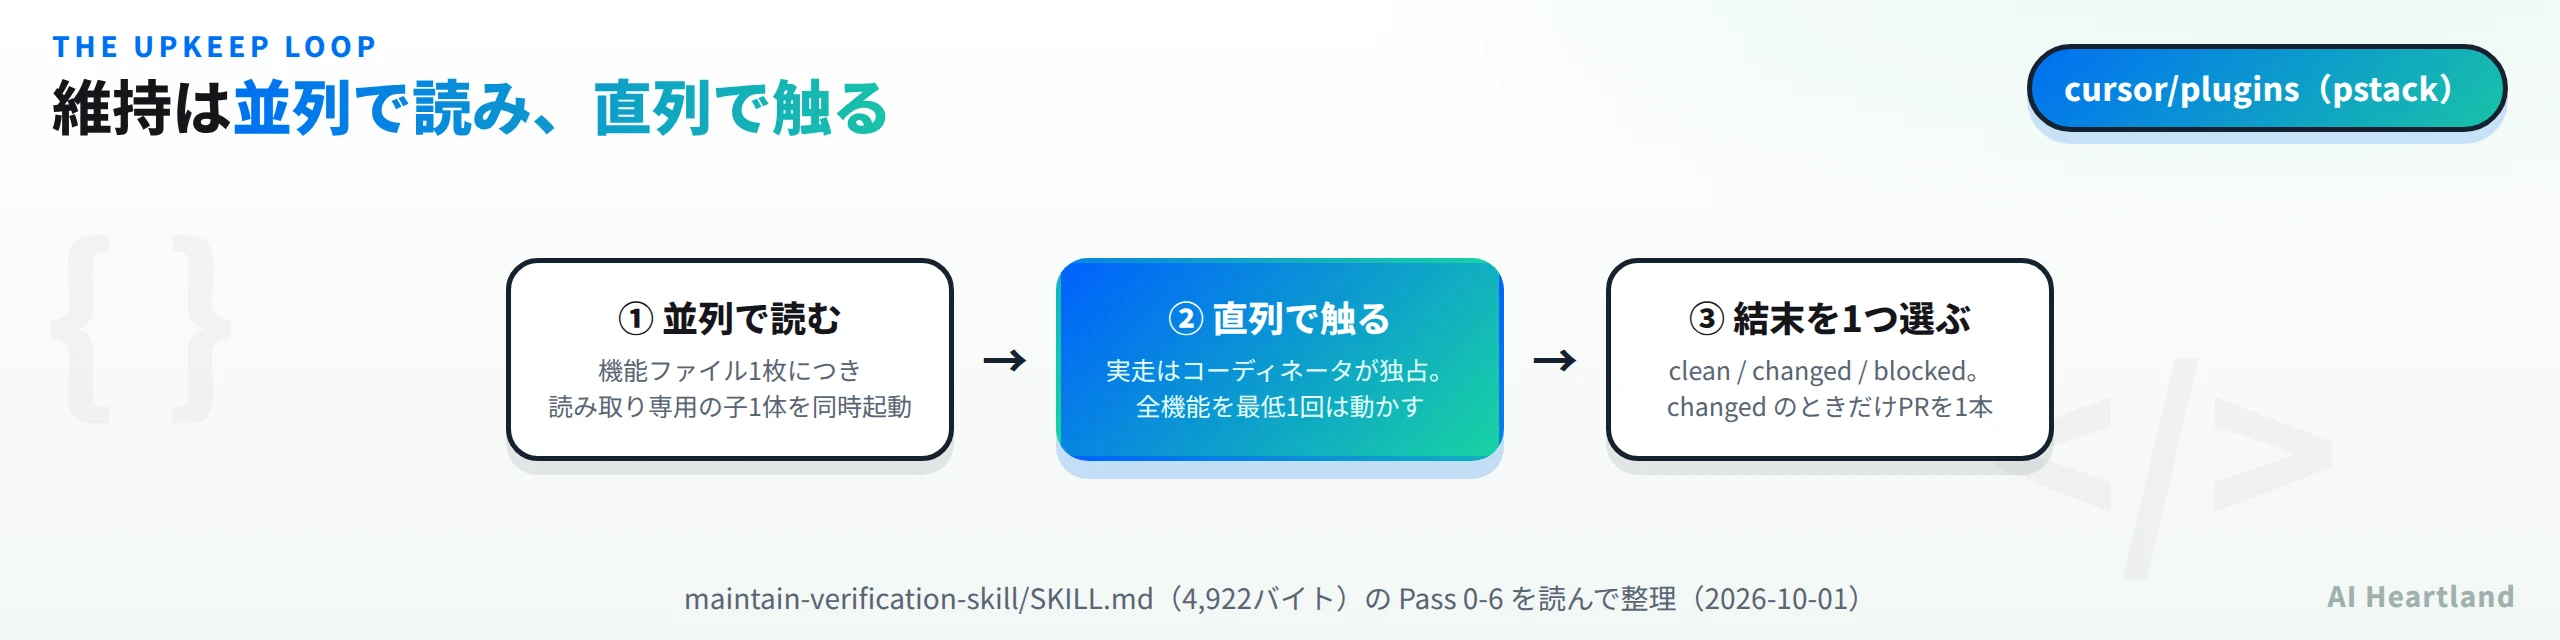
設計で一番きれいだと思ったのが、読む作業と触る作業の非対称な扱いだ。ソースを読む工程は「機能ファイル1枚につき読み取り専用のサブエージェント1体を同時起動」で並列化する。子はアプリを操作しないしファイルも編集しないと明記されていて、返す形も「機能の要約/ソースの入口/ドリフトの疑いかnone/実走用のレシピ1本」に固定されている。一方、実際にアプリを動かす工程はコーディネータが独占する。並列にすると壊れるものは並列にしない、という切り分けになっている。子エージェントが返すのは要約とレシピだけで、判断も実行もコーディネータに集まる。
実走では3つの不変条件を最後まで保つよう指示される。(1) 直近で妙な挙動をしたインスタンスは健全性チェックなしに触らない(最初の操作前、セッション単位ならセッションごと、失敗した操作のあとにもう一度。doctor で見えない異常——プロセスは健全なのにUIが固まっている——なら既知の状態に戻すか起動し直す)。(2) そこまでに集めた証拠はどの後始末でも生き残る、しかも「残っているはず」ではなく指定の場所で確認する。(3) 操作が起こしたものはその操作の用が済んだら残さない。
verified-unreachable という扱いも用意されている。到達できなかった機能は、具体的な前提条件(認証・権限・OS・外部状態)と試した経路を書いたときだけそう記録してよい。そして地図がその前提条件を書いていなかったなら、それ自体がドリフトだ、と続く。逃げ道を塞ぐ書き方になっている。
編集範囲の線引きも明快だ。検証スキル自身のディレクトリしか触らない。実行中にプロダクトのコードは決して編集しない。 地図が書いている振る舞いをアプリがもうしないなら、それはドキュメントのドリフト(地図を直す)か、プロダクトの回帰(報告する)のどちらかで、ドキュメントを書き換えて取り繕うなと明記される。
出口は3つのうち1つを選んで宣言する。
| 結末 | 意味 | PR |
|---|---|---|
clean |
全機能をソースと実走の両方でカバーした。出すものは無い | 作らない |
changed |
ドキュメント・ハーネス・地図の修正を、証明つきで出す | 1本だけ |
blocked |
カバーを完了できなかったか、証明済みの修正を安全に出せなかった | 作らない。何に阻まれたかを正確に書く |
手前の工程にも無駄を省く指定がある。索引の点検は「足りない・余分・重複・死んだ項目を直す」だけの軽い作業で、生成した目録は作らない。突き合わせの工程では、引用付きで指摘されたドリフトだけを抜き取り検査し、問題ないと返ってきた主張は証明し直さない。そして最近の変更を見渡して地図に無いユーザー向けの面を探すときは、具体的なソースのパスを示せないうちは「漏れている」と言わない。エージェントが「たぶん漏れている」と言い出して地図を膨らませる事故を、要件の側で塞いでいる。
トリアージの分岐も3つだ。ユーザー視点の記述が間違っている/足りない → ドキュメントのドリフト、直す。振る舞いは正しいのにハーネスが操作できない → ハーネスの穴、直す(直したら出す前に実走で再確認する)。アプリの振る舞いが実際に壊れている → プロダクトの穴。記録してユーザーに渡し、このPRには入れない。
検証環境:Linux 6.18.44/2026-10-01。cursor/plugins を git clone --depth 1(既定ブランチ main・最終コミット 2eb7ed4・2026-09-30)し、pstack/skills/ 配下の SKILL.md 47本のバイト数と frontmatter を集計した。トークンは tools/token_audit.py の heuristic 近似トークナイザ(ASCII 4字=1)で換算し、tiktoken の cl100k_base はBPE辞書を取得できないため使っていない。2本の検証スキルと同梱の references/feature-map-example/(3枚)は全文を読んでいる。ライセンスはリポジトリ直下に LICENSE ファイルが無く、pstack/LICENSE が MIT(Copyright (c) 2026 Lauren Tan)であることを実体で確認した。未検証:スキルを実際に走らせていない。実行には Cursor と対象アプリのリポジトリが要るため、/create-verification-skill も /maintain-verification-skill も起動しておらず、生成される検証スキルの実際の品質、feature map の精度、維持ループの所要時間やトークン消費はいずれも未確認。紹介文にあった Cursor Cloud Agents での日次自動化も試していない。star 9.2k・fork 860 はリポジトリページの表示値。
pstackを取り込む前に押さえる点
・そのままコピーできる:MIT で、2本とも SKILL.md 1枚(5,879バイトと4,922バイト)。Cursor以外のスキル対応エージェントへ移すのも難しくない
・勝手に発動しない:47本中46本が disable-model-invocation: true。スラッシュコマンドで呼ぶまで動かない設計で、常駐は約3,433トークン
・生成物は次のエージェント宛て:人間向けのドキュメントを書く気で使うと、粒度がずれる
・入口を全部書く:地図が複数の入口を挙げているのに1つで通した証明は不完全、と基準が決まっている
・証拠を消す後始末が落とし穴:後始末のあとに証拠が残っているかまで確認する工程が入っている理由がこれ
・並列化するのは読む側だけ:実走はコーディネータが独占する。ここを真似ないと壊れる
・プロダクトコードは触らない:維持ループの編集範囲は検証スキルのディレクトリのみ。回帰は報告に回す
・日次自動化は別途用意が要る:紹介文の Cursor Cloud Agents での定期実行は、スキル自体ではなく運用側の仕込み
・pstack本体は47スキル:うち23本が principle- 系の設計原則スキル。検証の2本だけ取ることもできる
・ライセンスの置き場所に注意:リポジトリ直下に LICENSE ファイルは無く、pstack/LICENSE が MIT(Copyright (c) 2026 Lauren Tan)。プラグインごとに条件が違いうる構造なので、他のプラグインを取るときは各ディレクトリを見る
・まず1機能で通す:生成工程自体が「地図の1機能だけ実走して引き渡す」設計になっている。最初から全機能を求めない
総括。 この2本の価値は、アイデアの新しさではなく基準の細かさにあると思う。「エージェントに検証させよう」という話は各所にあるが、pstack の2本は内部セッターを使うな/最終画面だけ撮るな/dry-run の名前を信じるな/プロセス名で殺すな/後始末で証拠を消すな/到達できなかった経路を別経路で通ったことにするなと、失敗の形を一つずつ名指しで潰している。これは実際に何度もやらかした人が書いた文章だ。
とくに feature map という発想は、E2Eテストとは読者が違う。テストは人間が書いて人間が読むが、この地図はアプリを見たことのないエージェントが作業の途中で冷えた状態から読むことだけを想定している。だから入口を全部並べ、安定した手がかりを選び、観測できる終状態を書く。そしてそれが腐ることを前提に、維持ループを別スキルとして最初から用意している。
当サイトはまだ実行していないので、生成される検証スキルがどれくらい使い物になるかは分からない。ただ、SKILL.md を2枚読むだけで自分の検証工程に足りないものが見える類の文章ではある。Cursorを使っていなくても、証明の基準の部分だけ取り出して自分のリポジトリの規約に混ぜる価値はある。当サイトも記事の検証手順に同じ発想——実行していない手順は成果物ではない——をすでに置いているので、地図の側をどう保つかは参考にしたい部分だった。
参照ソース
・cursor/plugins(公式リポジトリ) — pstack/ 配下のスキル47本・pstack/LICENSE・.cursor-plugin/marketplace.json を 2026-10-01 に確認
・create-verification-skill/SKILL.md — 生成の手順と証明の基準の出どころ
・maintain-verification-skill/SKILL.md — 維持ループと3つの結末の出どころ