決定モデル(decision model)という分類がある。テキストを生成せず、許された答えそれぞれに確率を返すモデルだ。Cloudflare が 2026-10-01 に公開した Clef は、その自社開発オープンウェイト版にあたる。clef(27B)と clef-flash(9B)の2本立てで、重みは Apache-2.0、Cloudflare Workers AI 上では @cf/cloudflare/clef / @cf/cloudflare/clef-flash として即座に呼べる。
LLMと違ってテキストを生成しない。状態と質問スキーマを渡すと、許された答えそれぞれに確率が返る。当サイトのCIは同種の判定器である Jev を tools/jev_judge.py から叩いており、告知に「Jev-API互換」とあった(以下 Jev互換)。もし本当なら移行コストはほぼゼロになる。
そこで主張を実行で確かめた。両側のクライアントに同じ質問を組ませて、出てくるJSONを突き合わせている。
・**公式ブログもHuggingFaceも読めなかった**ので、公開初日に生えた実装9本から仕様を復元した
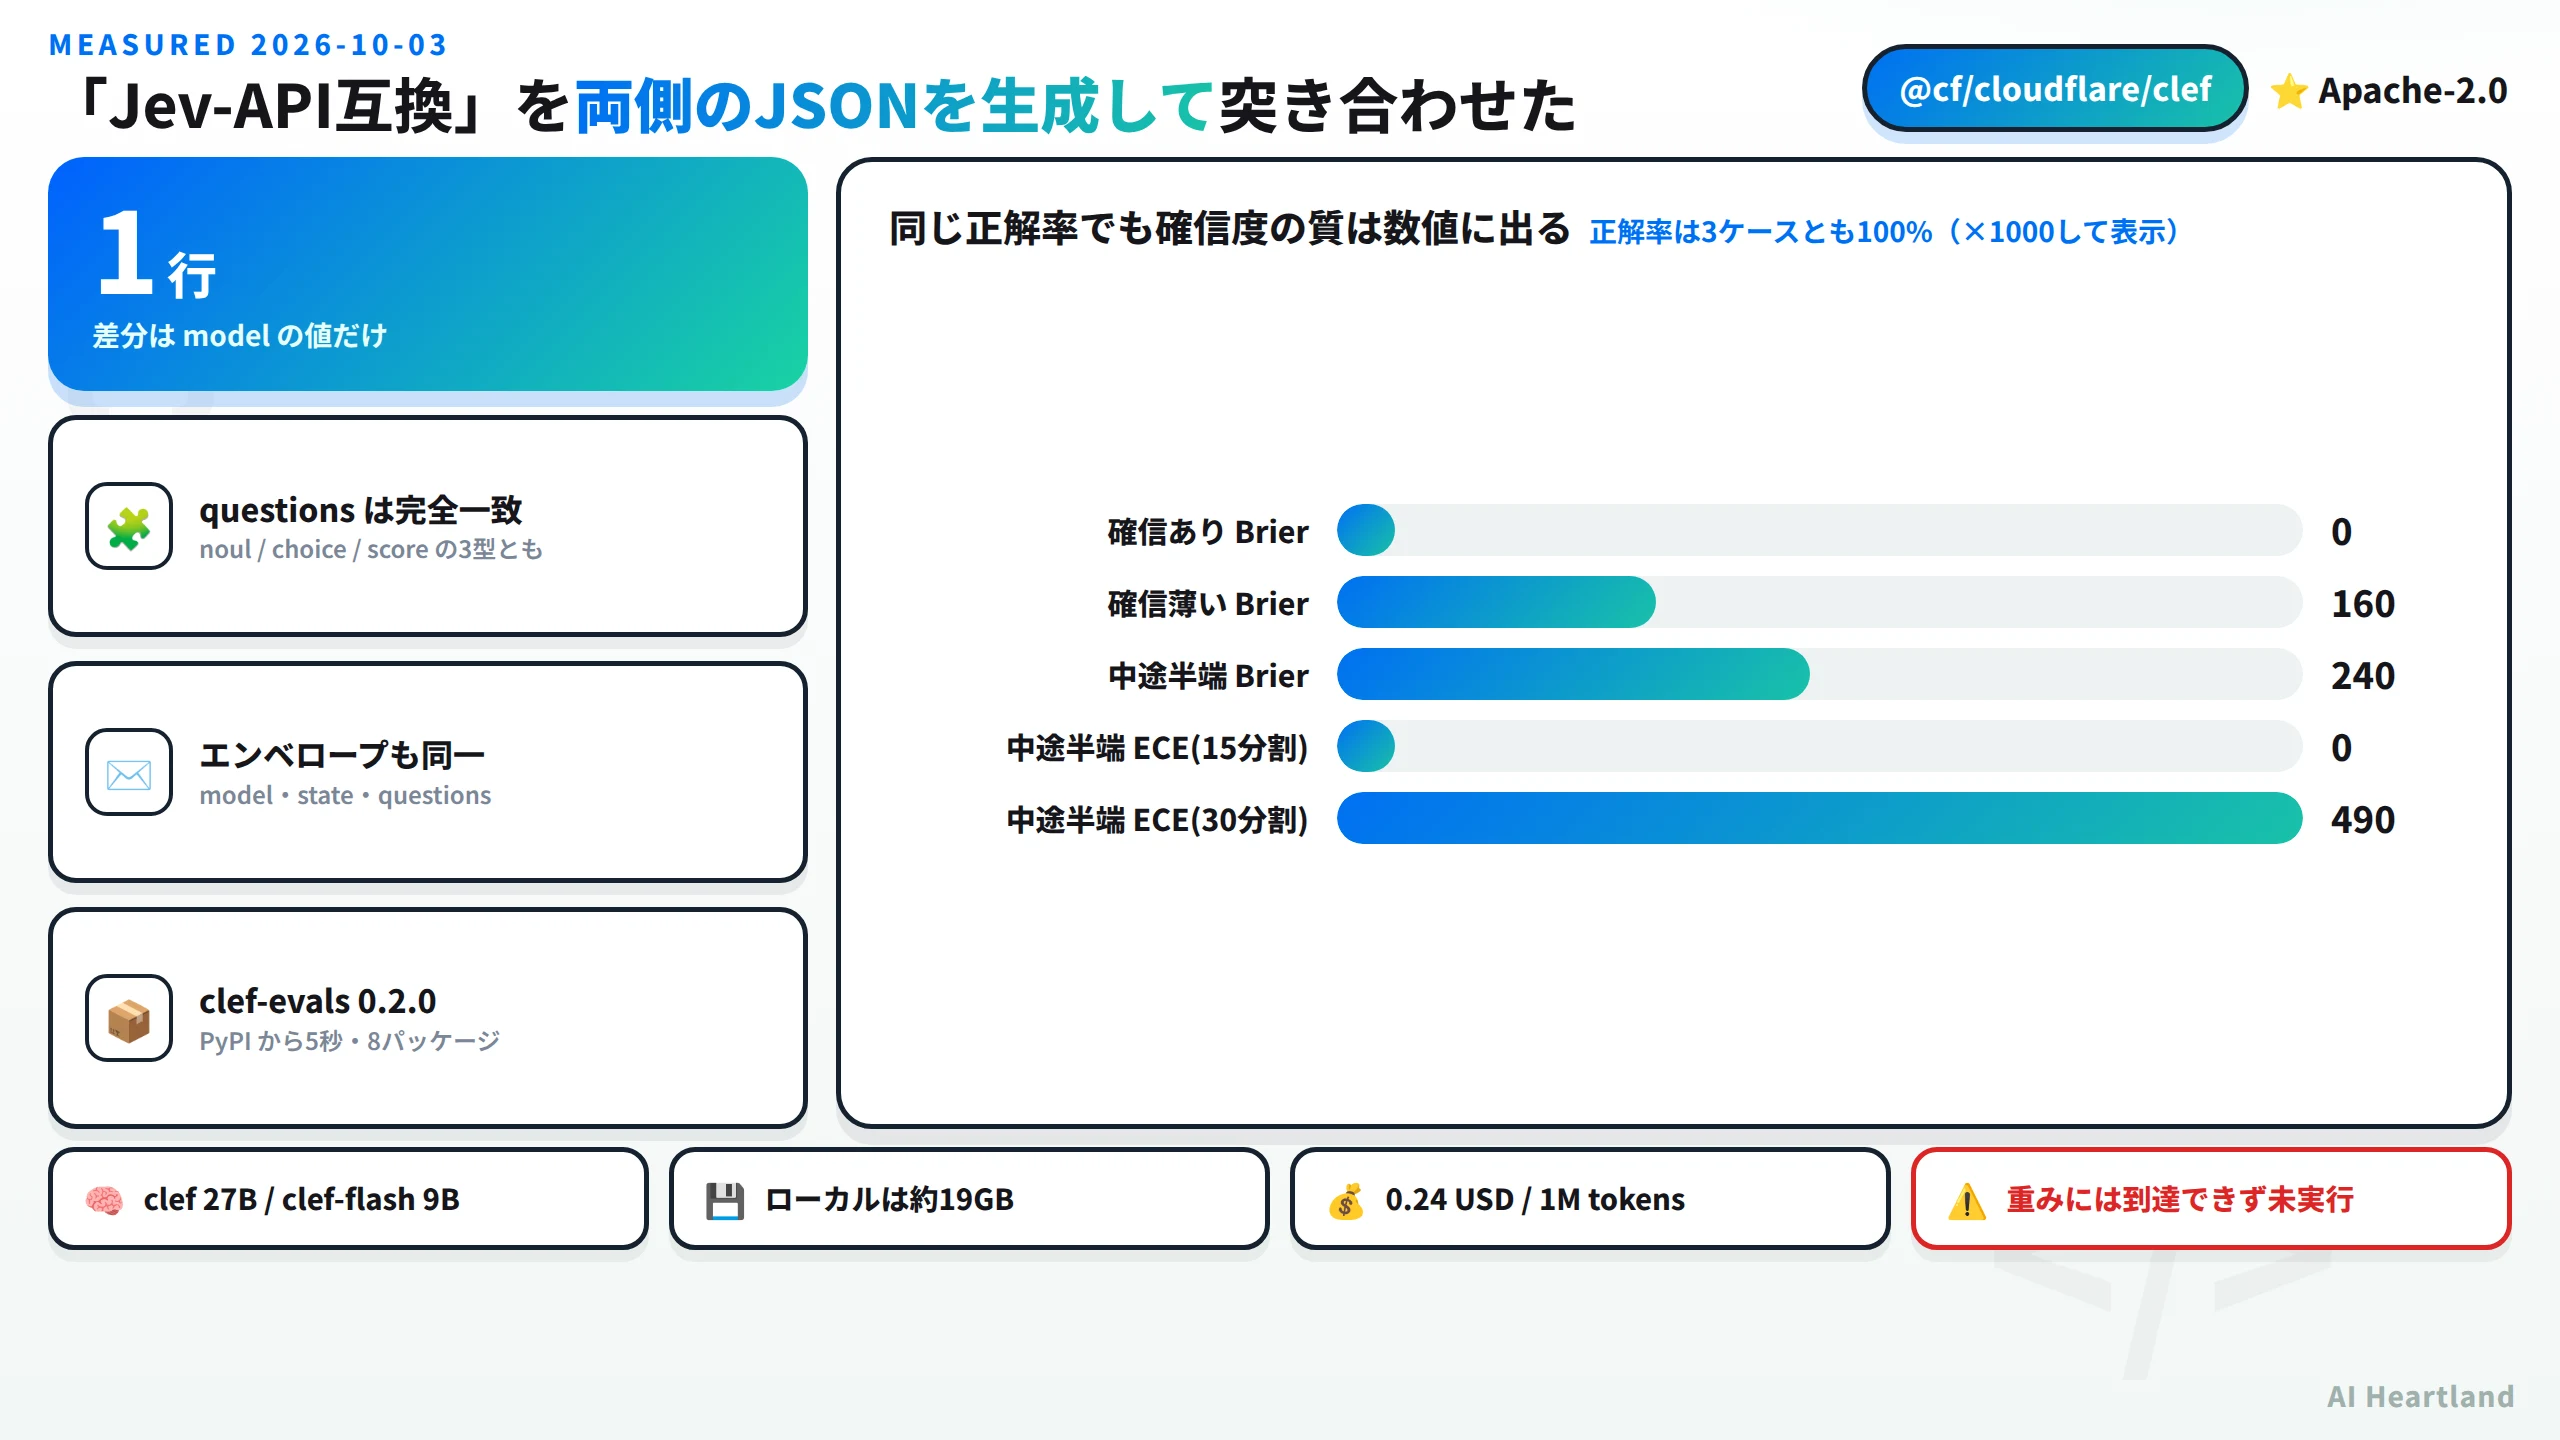
・「Jev互換」は**実行して確認**した。`questions` は完全一致、差分は `model` の値1行だけ
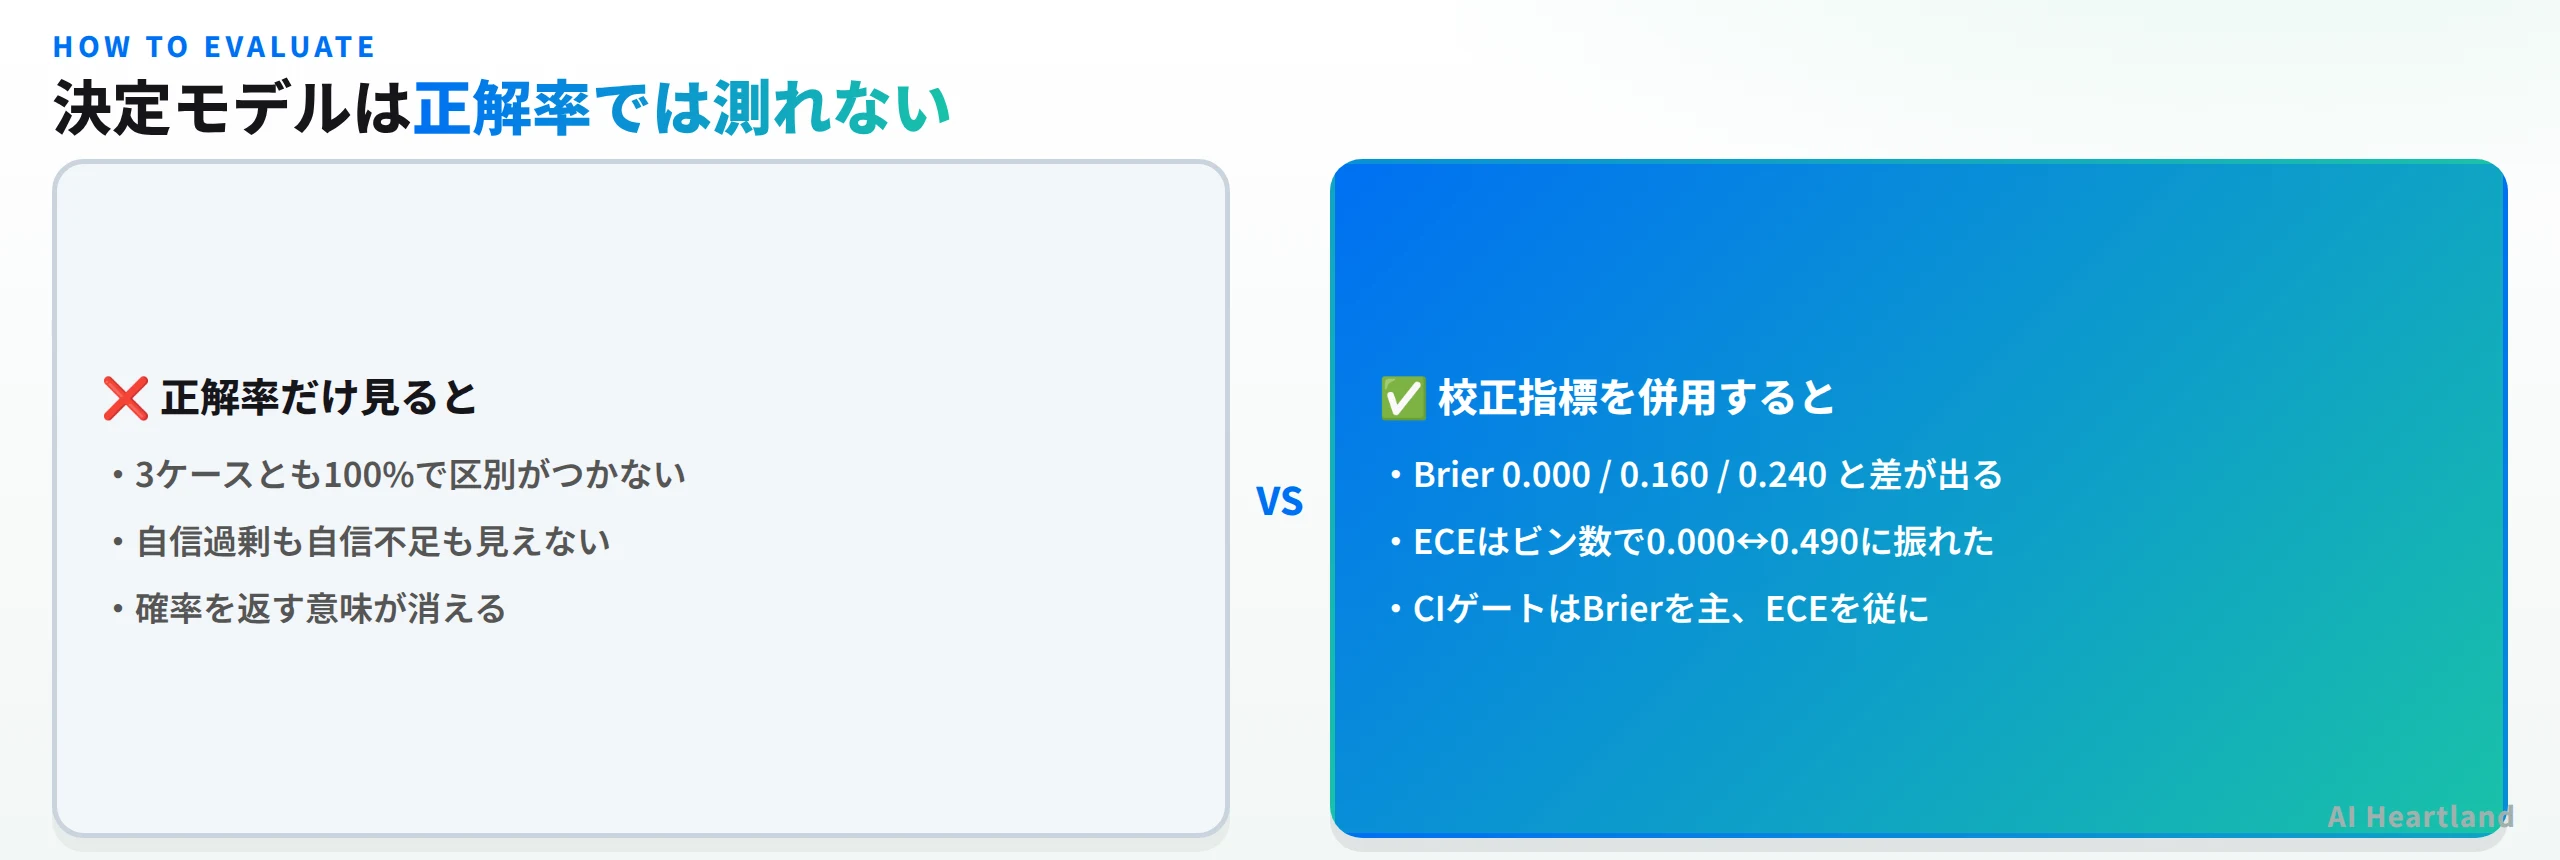
・決定モデルの評価は正解率では足りない。**ECEは同じデータでビン数により0.000↔0.490に振れる**
- ・Cloudflare 初の自社開発オープンウェイトモデル。**Apache-2.0**・`clef` 27B / `clef-flash` 9B
- ・テキストを返さず、**許された答えごとに確率**を返す決定モデル
- ・質問の型は **`noul` / `choice` / `score`** の3つ。Jev / SystemOne と同一
- ・Workers AI のモデルIDは **`@cf/cloudflare/clef`** と **`@cf/cloudflare/clef-flash`**
- ・バックボーンは **Qwen3.5**。配布物に `joint_schema_model.py` と `systemone` 関数が入る
- ・SDK内蔵の価格定数は **0.24 USD / 100万トークン**(入力)
決定モデルという分類そのものについてはDecisions APIとは|Jevの対抗馬と同名OSS実装の差をスキーマ15ケースで実測で扱った。本記事はその系譜に、Cloudflare がオープンウェイトで参入した件を置く。LLM全体の中での位置づけはLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版を参照してほしい。
決定モデルの公式情報に到達できなかったので、方法を変えた
最初に制約を明示しておく。当記事の執筆環境から、以下はすべて egress プロキシに遮断されていた。
blog.cloudflare.com         → EGRESS_BLOCKED
huggingface.co              → EGRESS_BLOCKED
developers.cloudflare.com   → EGRESS_BLOCKED
api.cloudflare.com          → 到達不可(000)
clef-evals.workers-ai-mle.workers.dev → EGRESS_BLOCKED
公式発表も重みもAPIもデモも読めない。普通ならここで「記事にできない」となるが、手が届くものが残っていた。公開から48時間以内に、Clefを実際に呼ぶ実装がGitHubに生えていたからだ。
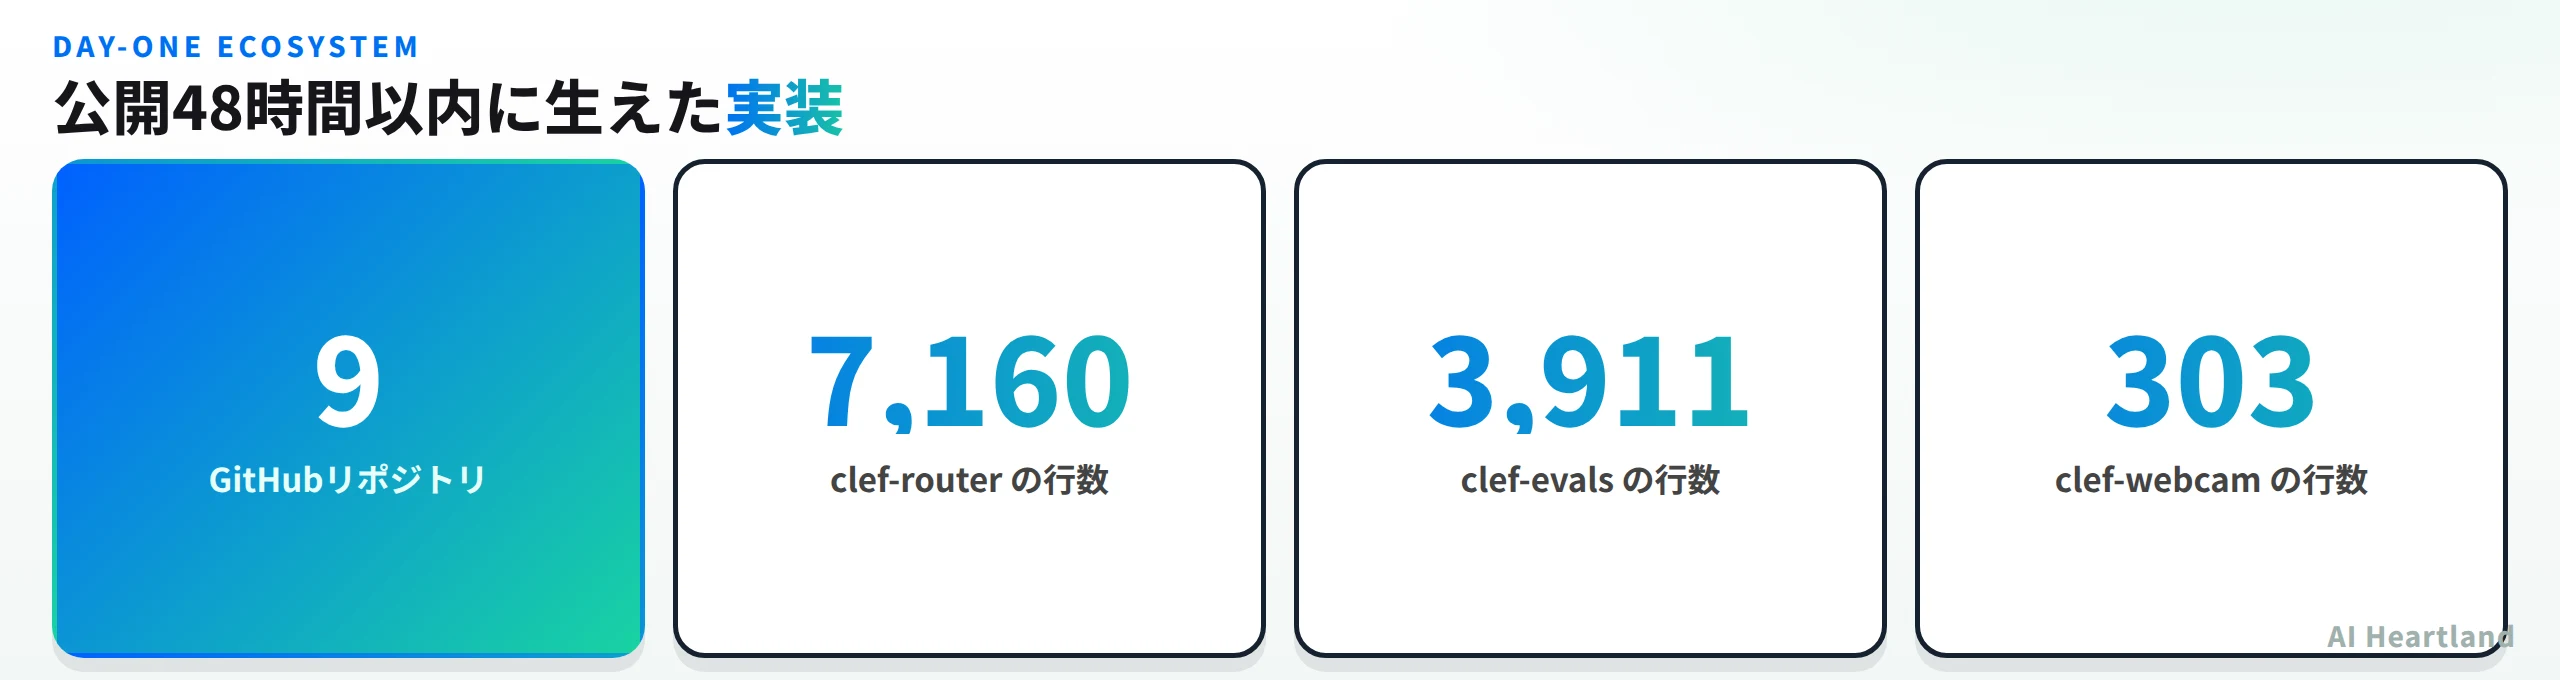
GitHub検索で9本見つかった。いずれも作成日は 2026-10-01 か 10-02 で、公開当日からの反応である。
| リポジトリ | 何をするものか | Python行数 |
|---|---|---|
Gjusev/clef-router |
安いLLMとフロンティアLLMの振り分け | 7,160 |
Gjusev/clef-evals |
校正優先の評価ツールキット(PyPI公開済み) | 3,911 |
MersivMedia/clef-finetune |
LoRA + joint schema head での追加学習 | 2,440 |
lucataco/clef-webcam |
Macでwebcam映像を型つき判定に(⭐22) | 303 |
chandrasekar-r/toolprobe-clef-precheck |
ツール呼び出し前の事前判定 | — |
JordanDalton/clef-playground |
型つき質問・画像・レイテンシの実験場 | — |
tehtommeh/clef-demo |
最小デモ | — |
hanyeol/mindor-clef-trainer |
教師ありファインチューン | — |
akshatdodhiya/ai-code-review-agent |
PRレビューエージェントの判定ゲート | — |
9本のうち clef-evals は PyPI に、clef-router は OpenAI 互換プロキシとして配布されており、公開2日目で「入れて使える」状態まで来ているものが複数ある。モデルの公開そのものより、この速度のほうが記事としては目を引いた。
これらは公式ドキュメントを読んで書かれた実際に動くコードなので、仕様の二次ソースとしては質が高い。もちろん二次は二次なので、各リポジトリの作者が仕様を読み違えている可能性は残る。そこで当記事では、複数のリポジトリで一致した記述だけを採用し、1本にしか出てこない主張は「同リポジトリの記載」と出典を添えて書いている。以下の数値とスキーマは、断りのない限りこの9本から抽出したものだ。
まずモデルIDが確定した。全リポジトリから @cf/ 形式の文字列を抽出して数えると、こうなる。
grep -rhoE '@cf/[a-z0-9._/-]+' . | sort | uniq -c | sort -rn
#  31 @cf/cloudflare/clef
#  24 @cf/cloudflare/clef-flash
#   2 @cf/meta-llama/llama-3.3-70b-instruct
エンドポイントは https://api.cloudflare.com/client/v4/accounts/{account_id}/ai/run/{model}。Hugging Face 側のリポジトリ名は Cloudflare/clef と Cloudflare/clef-flash だった。
「Jev-API互換」を実行して確かめる
ここが本題だ。当サイトには tools/jev_judge.py という最小のJevクライアントがある。CIで記事の判定に使っているもので、質問の型を組み立てる関数が3つ入っている。
def noul(instructions, criteria=None) -> dict:
    q = {"type": "noul", "instructions": instructions}
    ...
def choice(instructions, criteria: dict) -> dict:
    return {"type": "choice", "instructions": instructions, "criteria": criteria}
def score(instructions, criteria: list) -> dict:
    return {"type": "score", "instructions": instructions, "criteria": criteria}
一方 Clef 側は clef-evals が PyPI に出ている。入れてみた。
pip install clef-evals
# Successfully installed clef-evals-0.2.0 ... (8パッケージ・5秒)
公開APIを見ると Noul / Choice / Score という3つのクラスと、build_payload という組み立て関数がある。両方に同じ質問を組ませて、出力JSONを比較した。
# Clef 側
build_payload("@cf/cloudflare/clef", "warmup", {
  "wearing_glasses": Noul("Wearing glasses?"),
  "mood": Choice("mood", {"happy": "", "neutral": "", "tired": ""}),
  "energy": Score("energy", ["low", "medium", "high"]),
})
# 当サイトの Jev 側
{"model": "jev-latest", "state": "warmup", "questions": {
  "wearing_glasses": jev_judge.noul("Wearing glasses?"),
  "mood": jev_judge.choice("mood", {"happy": "", "neutral": "", "tired": ""}),
  "energy": jev_judge.score("energy", ["low", "medium", "high"]),
}}
結果はこうだった。
questions サブツリーは完全一致か: True
エンベロープのキー  Jev: ['model', 'questions', 'state']  Clef: ['model', 'questions', 'state']
値が異なるキー: ['model'] -> {'model': ('jev-latest', '@cf/cloudflare/clef')}
差分は model の値1つだけだった。質問オブジェクトの中身はキー名も入れ子の形も完全に一致している。
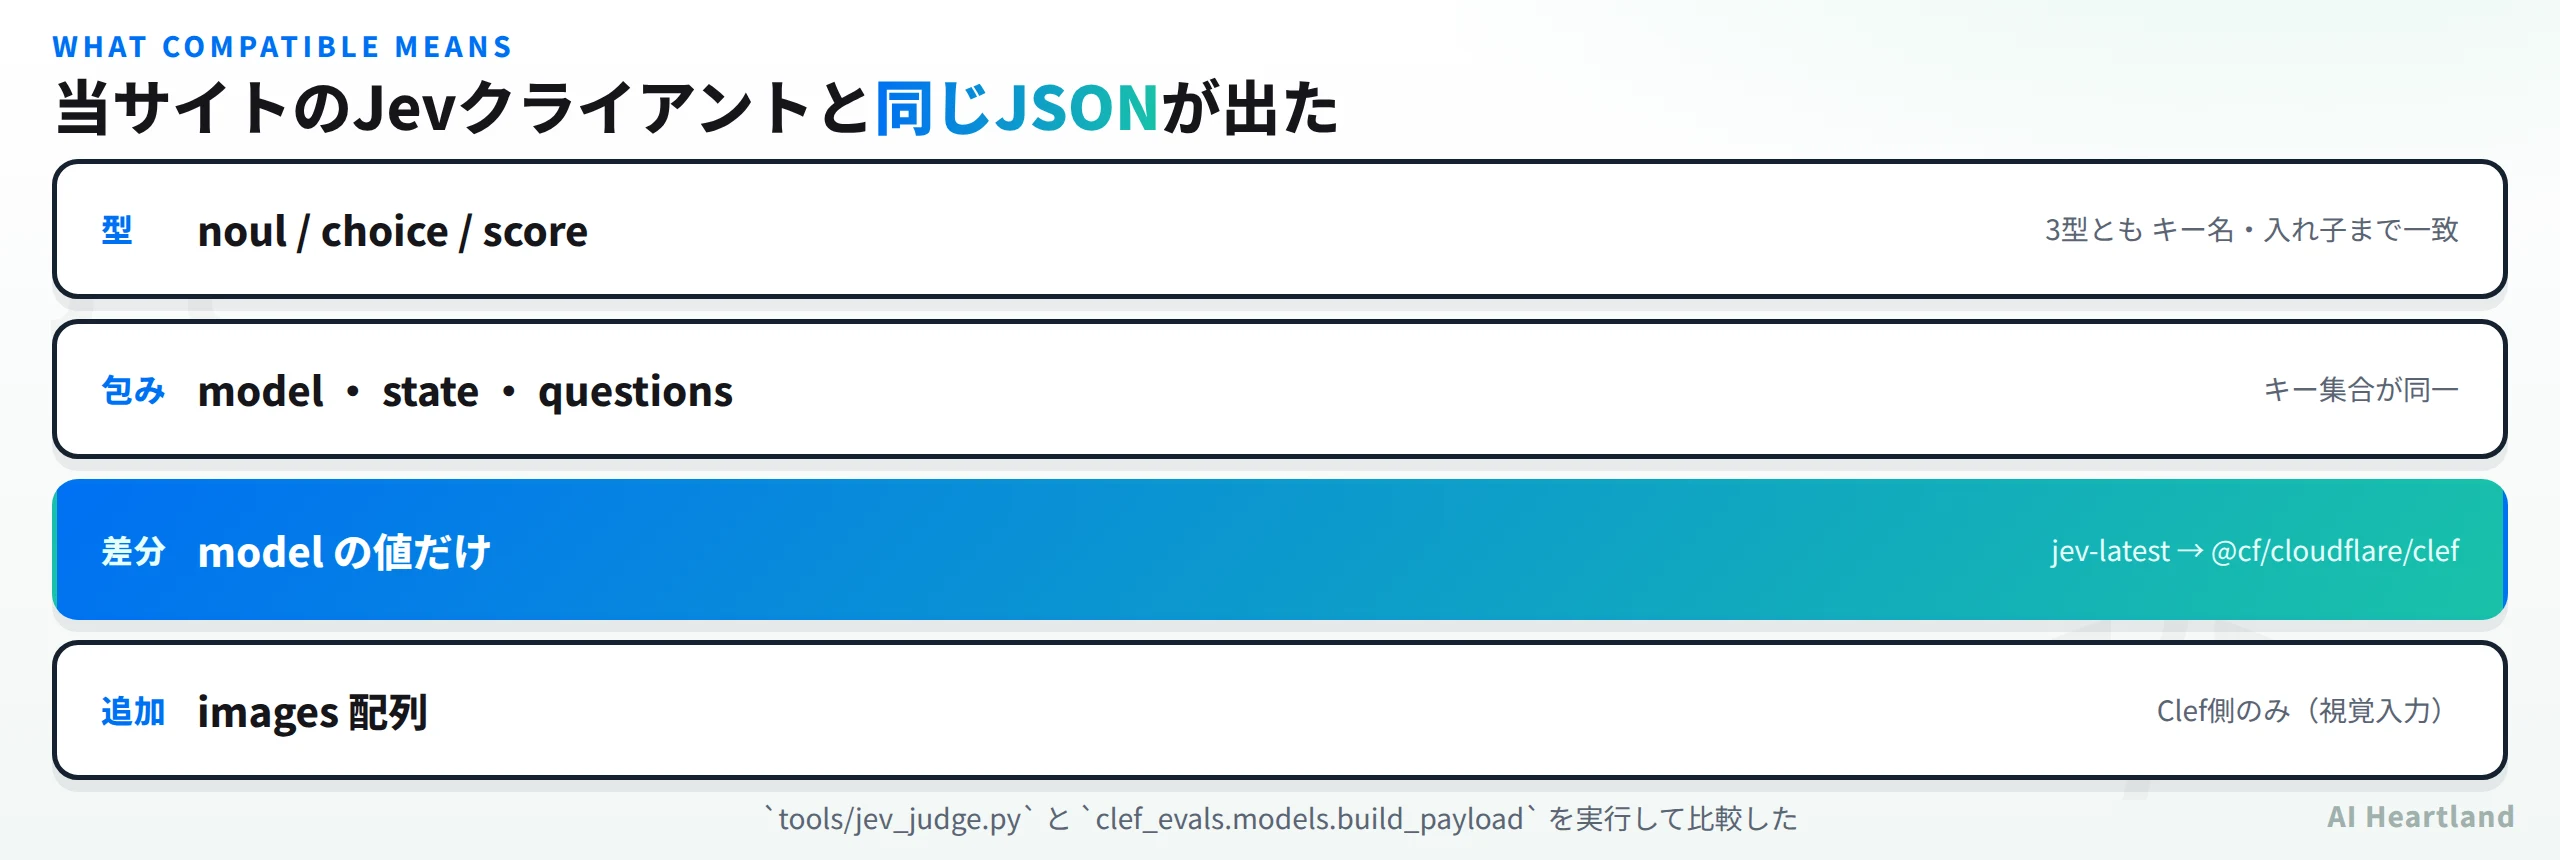
つまり「Jev-API互換」とは、既存のJevコードで1行書き換えれば動くという意味だった。マーケティング上の「互換」は「だいたい似ている」程度のこともあるので、ここが実際に完全一致だったのは意外だった。
裏づけは実装側にもある。clef-webcam の clef.py は冒頭にこう書いている。
"""Load clef-flash locally and answer Jev / SystemOne decision requests."""
そして重みの配布物に含まれる joint_schema_model.py から読み込んでいる関数の名前が systemone だ。
from joint_schema_model import load_release_model, systemone
Cloudflare が配った重みの中に systemone という名前の関数が入っている。互換は後付けではなく設計時の前提だったと読める。
なお Clef 側には images 配列が追加されている。これが Jev との実質的な差で、視覚入力を取れる。
clef.decide({"model": "clef-flash", "state": "warmup",
             "images": [warmup], "questions": {"dark": {"type": "noul"}}})
視覚入力について、clef-webcam の README にもう一つ面白い記述がある。質問を編集するキー操作の説明に、こうある。
E— Edit the questions. They apply live, no retraining
質問を書き換えても再学習が要らない。普通の画像分類器ならクラスを増やすたびに学習し直すところを、決定モデルは質問スキーマを入力として受け取るので、実行中に差し替えられる。「眼鏡をかけているか」を「ヘルメットをかぶっているか」に変えるのが、JSONの編集だけで済む。
これは Jev 系の型つき判定が持っていた性質がそのまま視覚にも及んだ、と読める。当サイトがCIで記事を判定するとき、判定基準を変えるのに再学習が要らないのと同じ構造だ。
この例で注目したいのは {"type": "noul"} だけで instructions が無いことだ。当サイトの実装では instructions を必須にしているが、Clef は省略を許す。互換性は「Clefのほうが緩い」方向なので、既存コードがそのまま通る。
noul / choice / score"] B --> C{"model の値は?"} C -- "jev-latest" --> D["api.typesafe.ai"] C -- "@cf/cloudflare/clef" --> E["Workers AI"] D --> F["型つき確率が返る"] E --> F E -.-> G["images を足せば
視覚入力も可"]
決定モデルは正解率では測れない
もうひとつ、重みに触れなくても確かめられたことがある。この種のモデルをどう評価するかだ。
clef-evals は自らを「Calibration-first evaluations」と名乗り、accuracy のほかに brier_score・brier_multiclass・ece を実装している。なぜ正解率では足りないのか、実際に動かした。
4件の判定について、正解・不正解のパターンは同じまま、確信度だけ変えた3ケースを用意する。
truth = [True, True, False, False]       # 1,2 は正解 / 3,4 は不正解
cases = {"確信あり": [1.0, 1.0, 0.0, 0.0],
         "確信薄い": [0.6, 0.6, 0.4, 0.4],
         "中途半端": [0.51, 0.51, 0.49, 0.49]}
結果はこうなった。
| ケース | 正解率 | Brier | ECE(既定15分割) |
|---|---|---|---|
| 確信あり(1.0 / 0.0) | 100% | 0.000 | 0.000 |
| 確信薄い(0.6 / 0.4) | 100% | 0.160 | 0.400 |
| 中途半端(0.51 / 0.49) | 100% | 0.240 | 0.000 |
正解率は3ケースとも100%で、まったく区別がつかない。確率を返すモデルを正解率だけで測ると、自信満々に正解したのか、ほぼコインフリップで当たったのかが消える。Brier スコアはこれを 0.000 / 0.160 / 0.240 と分離した。
ECE は同じデータでビン数に振り回された
ところが3行目の ECE が 0.000 になっているのが引っかかった。確信0.51でぎりぎり当てているのに、校正誤差ゼロはおかしい。調べると ECE のビン分割が原因だった。
n_bins=  2 -> ece=0.490
n_bins=  5 -> ece=0.000
n_bins= 10 -> ece=0.490
n_bins= 15 -> ece=0.000   ← 既定値
n_bins= 30 -> ece=0.490
n_bins=100 -> ece=0.490
既定の15分割だと 0.49 と 0.51 が同じビン(0.4667〜0.5333)に落ちる。ビン内の平均確信度 0.50 とビン内正解率 0.50 が一致してしまい、差が消える。同じデータ・同じ実装で、ビン数を変えるだけで ECE が 0.000 と 0.490 を行き来した。
これは clef-evals の不具合ではなく、ECE という指標そのものの既知の性質だ。ただし実務上の含意ははっきりしている。CIの回帰ゲートに使うなら Brier を主指標にすべきで、ECE 単独でしきい値を切ると、ビン境界のいたずらで通ったり落ちたりする。同じ3ケースで Brier は 0.000 / 0.160 / 0.240 と安定していた。
ちなみに clef_evals.models には価格定数が直書きされている。
INPUT_PRICE_PER_MILLION_TOKENS = 0.24 # USD
ローカル実行はQwen3.5のカーネルが壁になる
重みが Apache-2.0 で公開されている以上、Workers AI を使わず自分で動かす選択肢がある。clef-webcam の README が要件と実測を書いていた(当記事ではこれを再現していないので、以下は同リポジトリの記載値である)。
・clef-flash の重みは約19GB。Apple Silicon なら32GB以上のメモリが必要
・バックボーンは Qwen3.5 で、線形注意層の高速カーネルはCUDA専用
・Mac では低速な参照実装に落ち、時間の大半が torch.linalg.solve_triangular に消える
・同リポジトリは mps_kernels.py でブロック逆行列に置き換え、MPS/CPU では自動で差し替わる
| リクエスト | transformers on MPS | 同リポジトリの実装 |
|---|---|---|
| テキスト・質問3件 | 566 ms | 155 ms |
| webcam1フレーム・質問3件 | 840 ms | 250 ms |
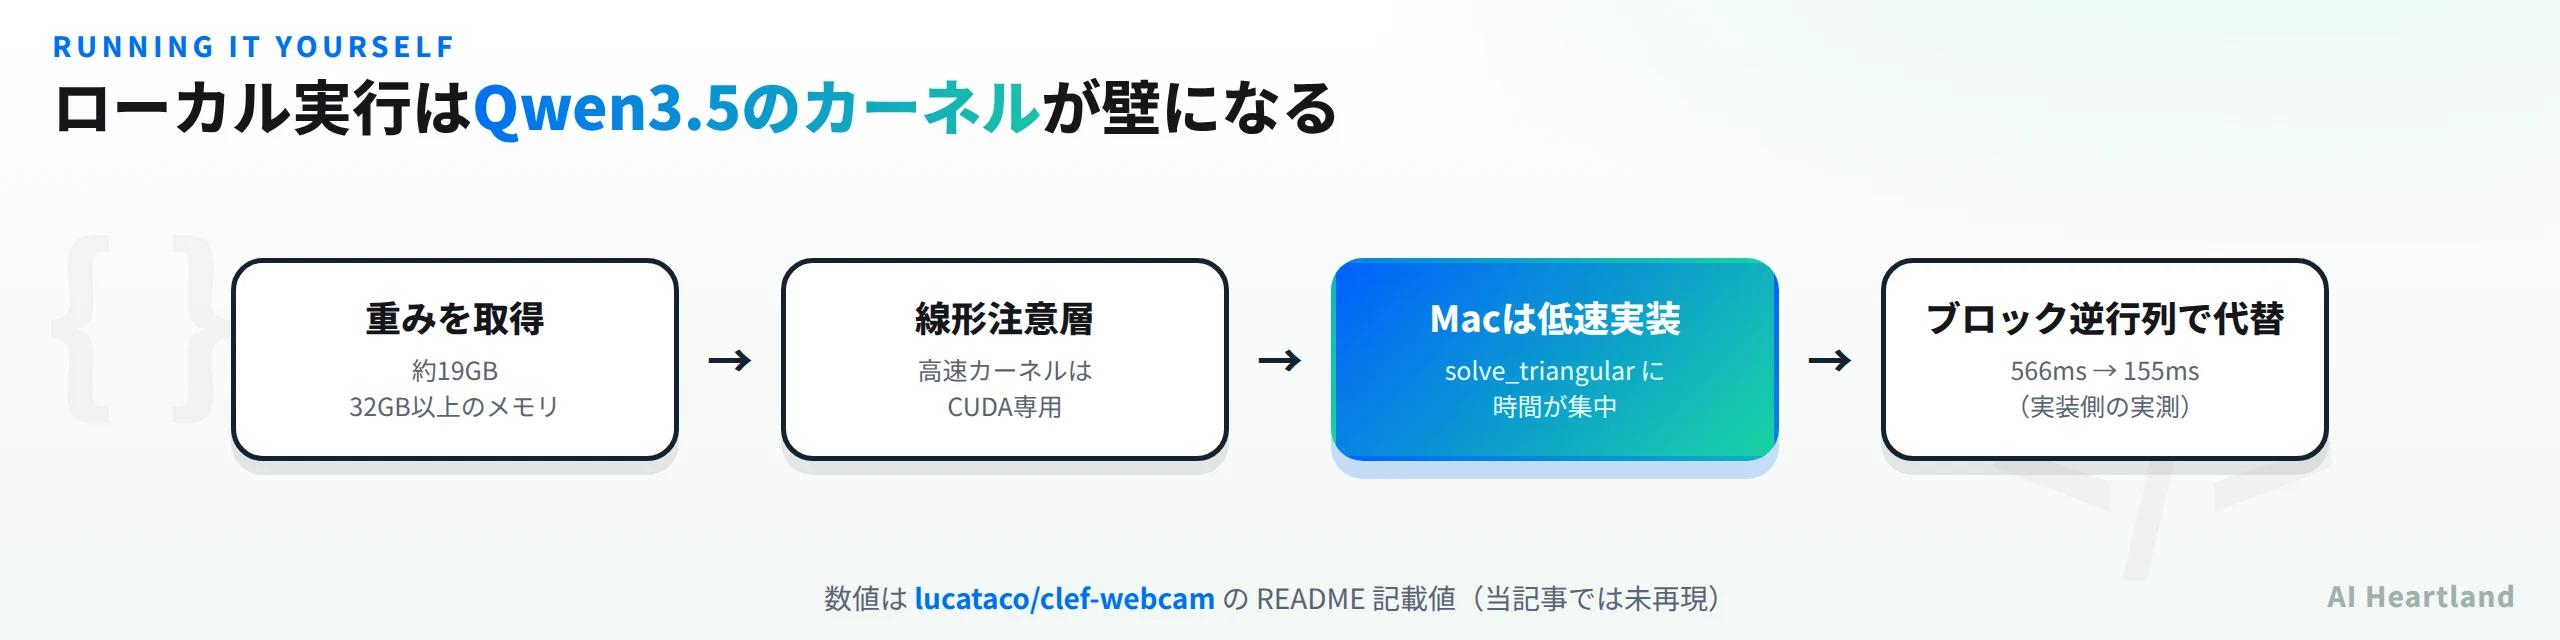
実装コードを読む限り、デバイス選択は cuda → mps → cpu の順で、CUDA のときは flash-linear-attention のカーネルに任せてパッチを当てない作りになっていた。オープンウェイトとはいえ、素直に速いのは今のところ NVIDIA GPU の上だけという読み方になる。
公開されたのは推論コードだけで、学習側は community が埋めた
9本を読んでいて気づいたことがある。MersivMedia/clef-finetune の README がこう書いている。
Cloudflare released inference code only. This repo adds the training side, following the recipe they describe in their launch post: LoRA on the backbone, the joint schema head trained alongside it, and a label-smoothed cross-entropy + Brier loss.
Cloudflare が配ったのは推論コードだけで、学習の手順は告知で説明されているものの、実装は公開されていない。それを公開翌日に第三者が埋めている。オープンウェイト公開の「オープン」がどこまでを指すかの実例として記録しておく価値がある。
このリポジトリから読み取れるアーキテクチャの細部が、いくつか効いてくる。
・損失関数に Brier が入っている。label-smoothed cross-entropy + Brier loss とあり、前節で評価に使った Brier スコアが学習目標でもある。確率の確からしさを訓練時から直接最適化する設計
・Qwen3.5 の線形注意は Gated DeltaNet。同README は「named_modules から対象を探すので q_proj/v_proj だけでなく Gated DeltaNet の射影にもアダプタが付く」と書いており、素朴なLoRA設定では当たらない層があることになる
・vision tower が別に存在する。LoRA の対象から vision tower と lm_head を除外する、と明記されている。画像入力が後付けではなく構造として入っている
・transformers は 5.10.2 以上が必要。Qwen3_5ForConditionalGeneration を使うため
・学習後のエクスポートは joint_head.safetensors と Cloudflare 純正の joint_schema_model.py を同梱し、load_release_model でそのまま読めるようにしている
最後の点は地味だが重要で、追加学習したモデルも公式のローダーで読める形に戻せるということだ。配布フォーマットが固定されているぶん、エコシステムが分岐しにくい。
実際、9本の用途は綺麗に割れていた。clef-router は「安いモデルで足りるプロンプトは安いほうへ、重要なものはフロンティアモデルへ」という振り分けの門番。toolprobe-clef-precheck はツール呼び出し前の事前判定。ai-code-review-agent はPRレビューの判定ゲート。どれも「生成の前に置く安い判断」という同じ形をしている。決定モデルが埋めようとしている穴がどこかは、この一致から読み取れる。
当記事で測っていないこと
範囲をはっきりさせておく。egress の制約が大きいので、ここは丁寧に書く。
・モデルを一度も実行していない。重み(Hugging Face)にも Workers AI にも到達できていない。レイテンシも精度も当記事の実測値ではない
・公式発表を読んでいない。blog.cloudflare.com が遮断されているため、27B / 9B というパラメータ数、Jev との評価比較、RLファインチューニング基盤の詳細は一次ソースで確認できていない。これらは報道と実装側の記述に基づく
・ライセンスの実体ファイルを確認していない。Apache-2.0 は clef-evals のバッジと報道によるもので、Hugging Face 上の LICENSE を開けていない。当サイトでライセンス実体を読む記事を書いたばかりだが、まさにそこで「バッジで済ませてはいけない」と書いた箇所にあたる。よって未確認と明記する
・レイテンシの再現をしていない。566ms→155ms は実装側の記載値で、当記事は検算していない
・確かめたのはスキーマの一致と評価指標の挙動の2点だけ。どちらも手元で実行して再現できる
逆に言えば、この2点は重みが無くても確かめられた。互換性の主張は型の形を比べれば検証でき、評価指標の性質は合成データで試せる。モデルに触れないと何も言えない、ということはない。
使うかどうかの判断材料
既に Jev / SystemOne 系を使っているなら、移行コストは実測で model の1行だった。試す価値は高い。自前GPUがあるなら Apache-2.0 の重みを落として常時稼働させる選択肢も生まれる。判定を外部APIに投げずに済むのは、記事本文や顧客データを判定に渡す用途では大きい。
コストの桁感も押さえておく。SDK内蔵の定数は入力100万トークンあたり 0.24 USD だった。判定1件の状態+質問が仮に500トークンなら、100万回の判定でおよそ120 USD という計算になる(出力側の課金は当記事では未確認)。生成モデルに同じ判断をさせると、プロンプトに加えて出力トークンと、多くの場合もっと高い単価が乗る。決定モデルが「生成の前に置く安い判断」として設計されている理由が、この桁に出ている。
レイテンシ側の構造的な利点もある。実装側の表現を借りると、決定モデルは1回のフォワードパスで全質問の確率を返す。LLMにJSONを吐かせる方式だと、トークンを1つずつ生成するうえ、出力が壊れていれば再試行が要る。質問3件でも1件でもフォワードパスが1回で済むなら、質問をまとめるほど得になる。ただし clef-webcam の README は「レイテンシはプロンプト長とともに伸びるので、短い指示と少ない選択肢が効く」とも書いており、無制限にまとめられるわけではない。
一方で注意点もある。当サイトのCLAUDE.mdには「Jevは文章生成・要約をしない(choice/score/probの型つき判定のみ)」と書いてある。Clefも同じ制約を引き継ぐ。決定モデルは判定器であって、生成器の代わりにはならない。
OpenJevとは|Jev互換のSystem One決定サーバを自前GPUで動かすOSSをソースで実測で扱った OpenJev が「互換サーバを自前で立てる」路線だったのに対し、Clef は「互換のまま重みごと配る」路線だ。同じ System One のスキーマを軸に、実装の選択肢が増えてきている。
参照ソース
・Introducing Clef: our open-source decision models, and new RL fine-tuning platform(公式発表。当環境からは遮断されており未読)
・Cloudflare/clef-flash — Hugging Face(重み配布元。当環境からは遮断されており未読)
・lucataco/clef-webcam(⭐22・ローカル実行とレイテンシ記載の出典・2026-10-01作成)
・Gjusev/clef-evals/clef-evals — PyPI(0.2.0 を実行して校正指標を検証)
・Gjusev/clef-router・MersivMedia/clef-finetune(モデルIDとAPI形状の抽出元)
本記事の計測レコードは data/measurements/runs/2026-10-03-clef-decision-model.json に登録した。