Mantis は、Googleが公開した「AIコーディングエージェントに脆弱性を見つけさせ、再現させ、直させる」ためのツールキットだ。Apache-2.0、star 1.8k、fork 171。公式ブログが導入手順を紹介しているので、そのとおりに入れて、どこまで動いてどこで止まるかを確かめた。
最初に名前の整理をしておきたい。「Mantis」で検索すると、長く使われているバグ追跡システム MantisBT(Mantis Bug Tracker) が出てくる。今回の題材とは無関係の別物だ。
| Google Mantis(本記事) | MantisBT | |
|---|---|---|
| 何か | AIエージェント用の脆弱性探索ツールキット | Webベースのバグ追跡システム |
| 配布 | github.com/google/mantis |
github.com/mantisbt/mantisbt |
| 実体 | 19本の Agent Skills + ADK参照ハーネス | PHPアプリケーション |
| ライセンス | Apache-2.0 | GPL-2.0 |
| 公開 | 2026年(タグなし) | 2000年代から継続 |
- ・中身は**19本の Agent Skills**(SKILL.md)と、Google ADK製の参照ハーネスの二階建て
- ・スキル全体は526,184バイト=**約131,546トークン**。常駐は frontmatter だけの**約1,530トークン**
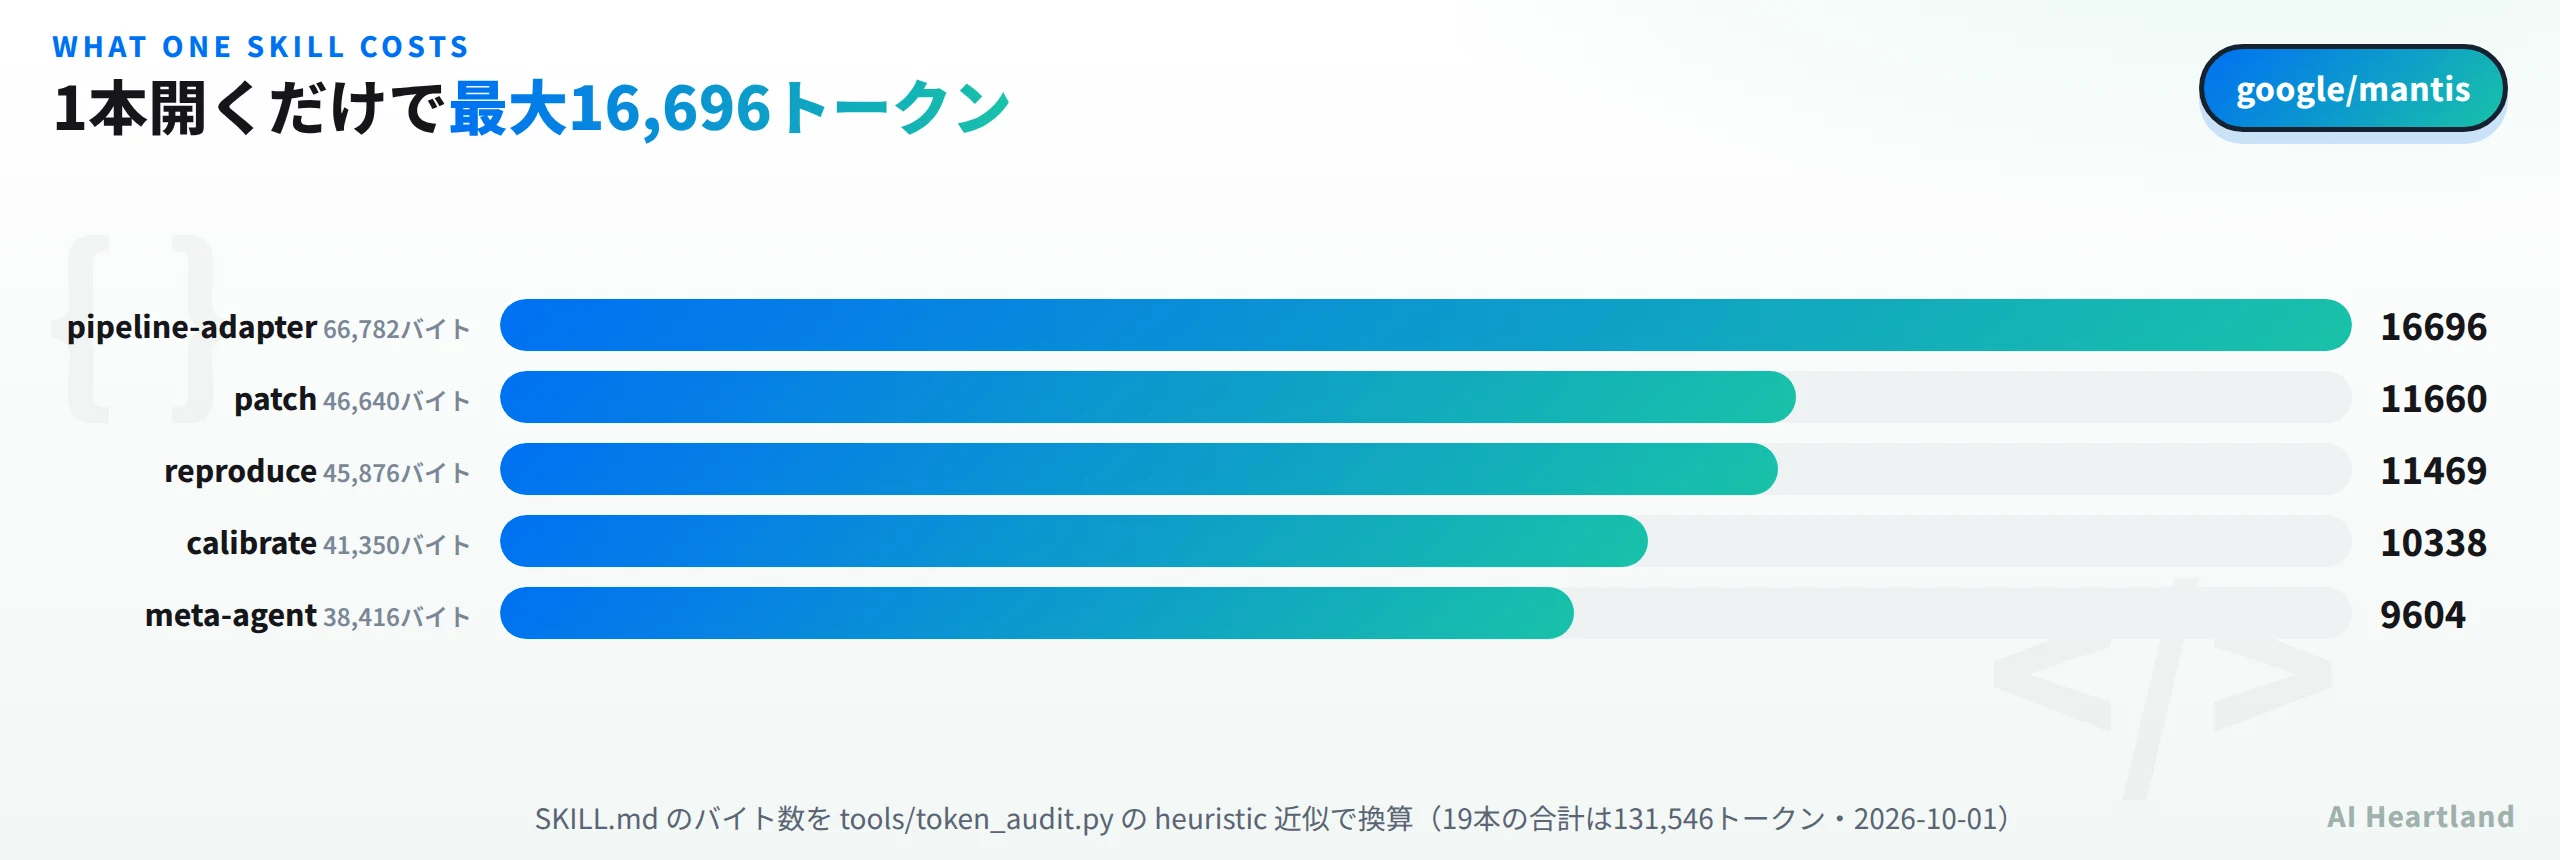
- ・重いスキルは1本で**16,696トークン**。開く順番がそのまま文脈コストになる
- ・**clone しただけでは動かない**。Python 3.12以上が必要で、事前検査はGCPプロジェクト未設定で失敗した
- ・既定バジェットは1回あたり**12時間・1,000万トークン・LLM呼び出し2,000回**
- ・READMEが**「自律生成したコードを実行するので隔離環境でのみ使え」**と警告している
エージェント基盤の全体像はAIエージェントフレームワーク比較2026|LangGraph・CrewAI・Dify等9種をStar数・実コードで検証にまとめてある。本記事はその応用として、セキュリティレビューに特化した公式ツールキットを1つ分解する。
Mantisとは:19スキルと参照ハーネスの二階建て
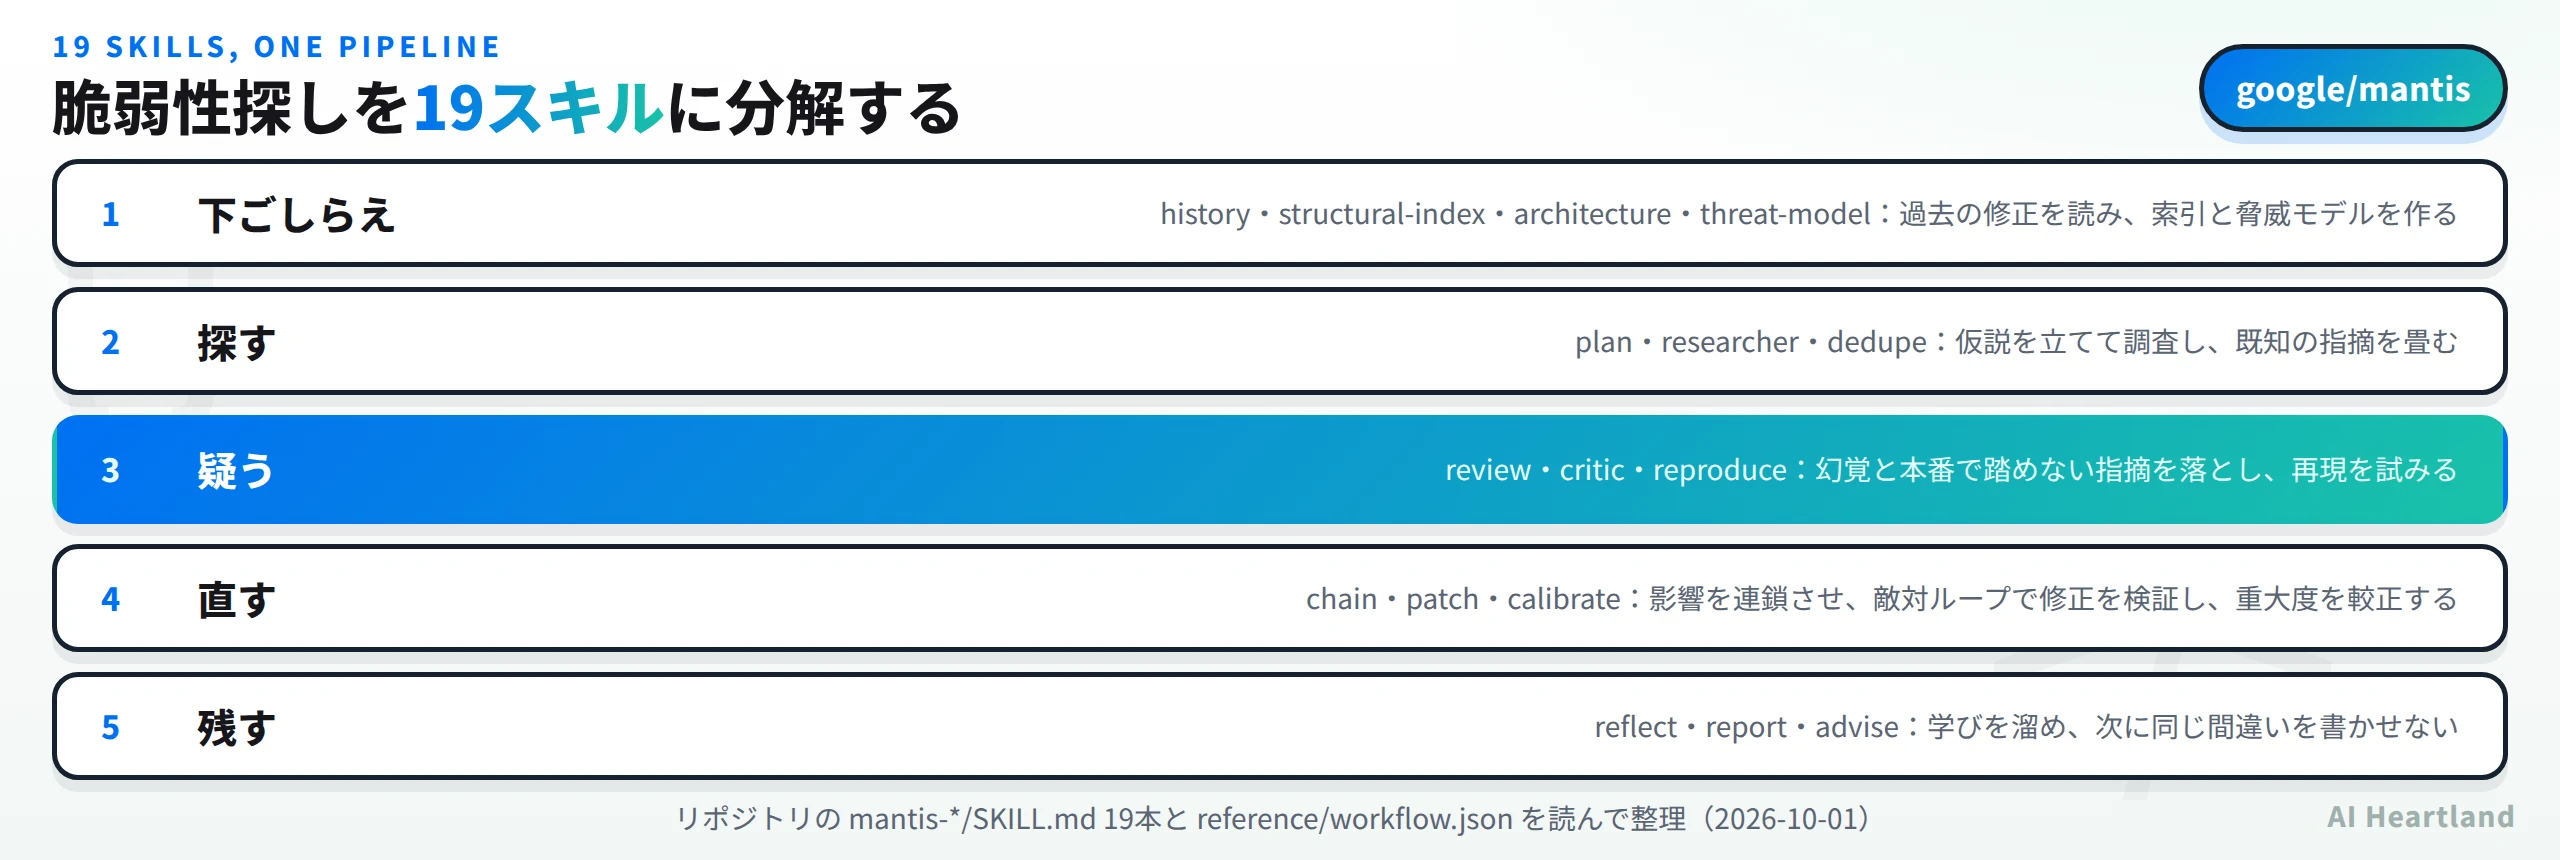
リポジトリを開くと、mantis- で始まるディレクトリが19個並んでいる。中身はどれも SKILL.md 1枚(一部は references/ 付き)で、プログラムではなくAgent Skillsの集合だ。だから Claude Code でも Codex でも Antigravity でも、スキルを読める道具なら何にでも載せられる。
役割分担は名前どおりで、脆弱性探しの工程がそのまま分解されている。history が過去の修正履歴から「繰り返したくない失敗」を読み、structural-index が索引を作り、architecture と threat-model が設計と脅威モデルを起こす。plan が仮説を立て、researcher が調べ、dedupe が既知の指摘を畳む。ここまでが前半だ。
後半が面白い。review と critic が指摘を疑い、reproduce が実際に踏めるかを試し、chain が複数の欠陥をつないでより深刻な経路を作れないか探す。patch が修正を当て、敵対ループで本当に直っているかを検証する。calibrate は「LLMが重大度を盛る」問題に対処するもので、READMEの表現を借りれば何千もの『Critical』を吐かせないための較正工程だ。最後に reflect が学びを溜め、advise がそれを次回のコード実装時に効かせる。
もう一階が reference/ にある ADK 製のハーネスで、Python 54ファイル・46,309行。workflow.json が実際のパイプラインをグラフとして持っていて、中身は18ノード・21エッジ。内訳はエージェント15本と分類器3本(reviewer_classifier critic_classifier repro_classifier)で、分類器が各段の合否を判定して次に流す作りになっている。
過去の修正と索引"] --> B["architect / threat_modeler
設計と脅威モデル"] B --> C["planner / researcher
仮説を立てて調べる"] C --> D["deduplicator
既知の指摘を畳む"] D --> E["reviewer / critic
分類器が合否を判定"] E --> F["reproducer
再現できるか試す"] F --> G["chainer / patcher
連鎖と修正"] G --> H["calibrator
重大度を較正"] H --> I["reflector / reporter
学びを残して報告"]
Agent Skills を大量に配る構成としては、当サイトで扱ったClaude-OSINTとは|9本のOSINTスキルの起動条件・常駐トークン・安全弁を実測で確かめたと同じ形だ。セキュリティ作業をエージェントに任せるという狙いではHackerAI徹底解説|40種のセキュリティツールをAI対話で操るペンテスト自動化OSSとも並ぶ。違いは、Mantis が探すだけでなく直すところまでを1本のグラフに入れている点にある。
実測:clone しただけでは動かない
公式ブログは git clone して既存のコーディングエージェントに読ませる使い方を紹介している。スキルだけならそれで足りるが、参照ハーネスを動かすとなると話が変わる。手順どおりにやってみた。
cd reference && ./install.sh
# ERROR: Mantis requires Python 3.12 or newer.
#        Current interpreter: Python 3.11.15

# Python 3.13 を PATH の先頭に置いて再実行
PATH=/tmp/pybin:$PATH ./install.sh
# ...(google-adk 2.9.1 / litellm / google-cloud-aiplatform / anthropic / microsandbox ほか)
# Attempting to build sandbox image with docker...
# ERROR: Cannot connect to the Docker daemon ... Building with docker failed
# No container builder found; pulling base image 'mirror.gcr.io/library/python:3-slim' ...
#    ✓ Pulled       mirror.gcr.io/library/python:3-slim (5.2s)
# Setup complete! You can now run ./run.sh
du -sm .venv    # 673
導入されるのは google-adk 2.9.1、litellm、google-cloud-aiplatform、anthropic、openai、microsandbox、tiktoken といった顔ぶれだ。Python 3.11 では最初のゲートで止まる(最新コミットが「Support Python 3.12+」なので、ここは意図的な引き上げだ)。3.13 に替えると完走し、仮想環境は673MBになった。Docker が無い環境でもビルドを諦めてベースイメージのプルへ落ちる作りで、フォールバックは丁寧だ。
次が本番の関門になる。
python3 scripts/configure.py --auto
# ⚠️  Sandbox is 'static-only' (no supported isolation tier detected on this host).
#     Dynamic exploit reproduction is DISABLED.
# ✅ Auto-configured Mantis settings saved to reference/workflow.local.json
#
# Default Model:   vertex_ai/gemini-3.7-flash
# Sandbox Type:    static-only
#   [LLM PREFLIGHT]     ❌ FAILED: You must set VERTEXAI_PROJECT or GOOGLE_CLOUD_PROJECT
#   [SANDBOX PREFLIGHT] ✅ PASSED: Static-only sandbox ready (dynamic execution disabled)
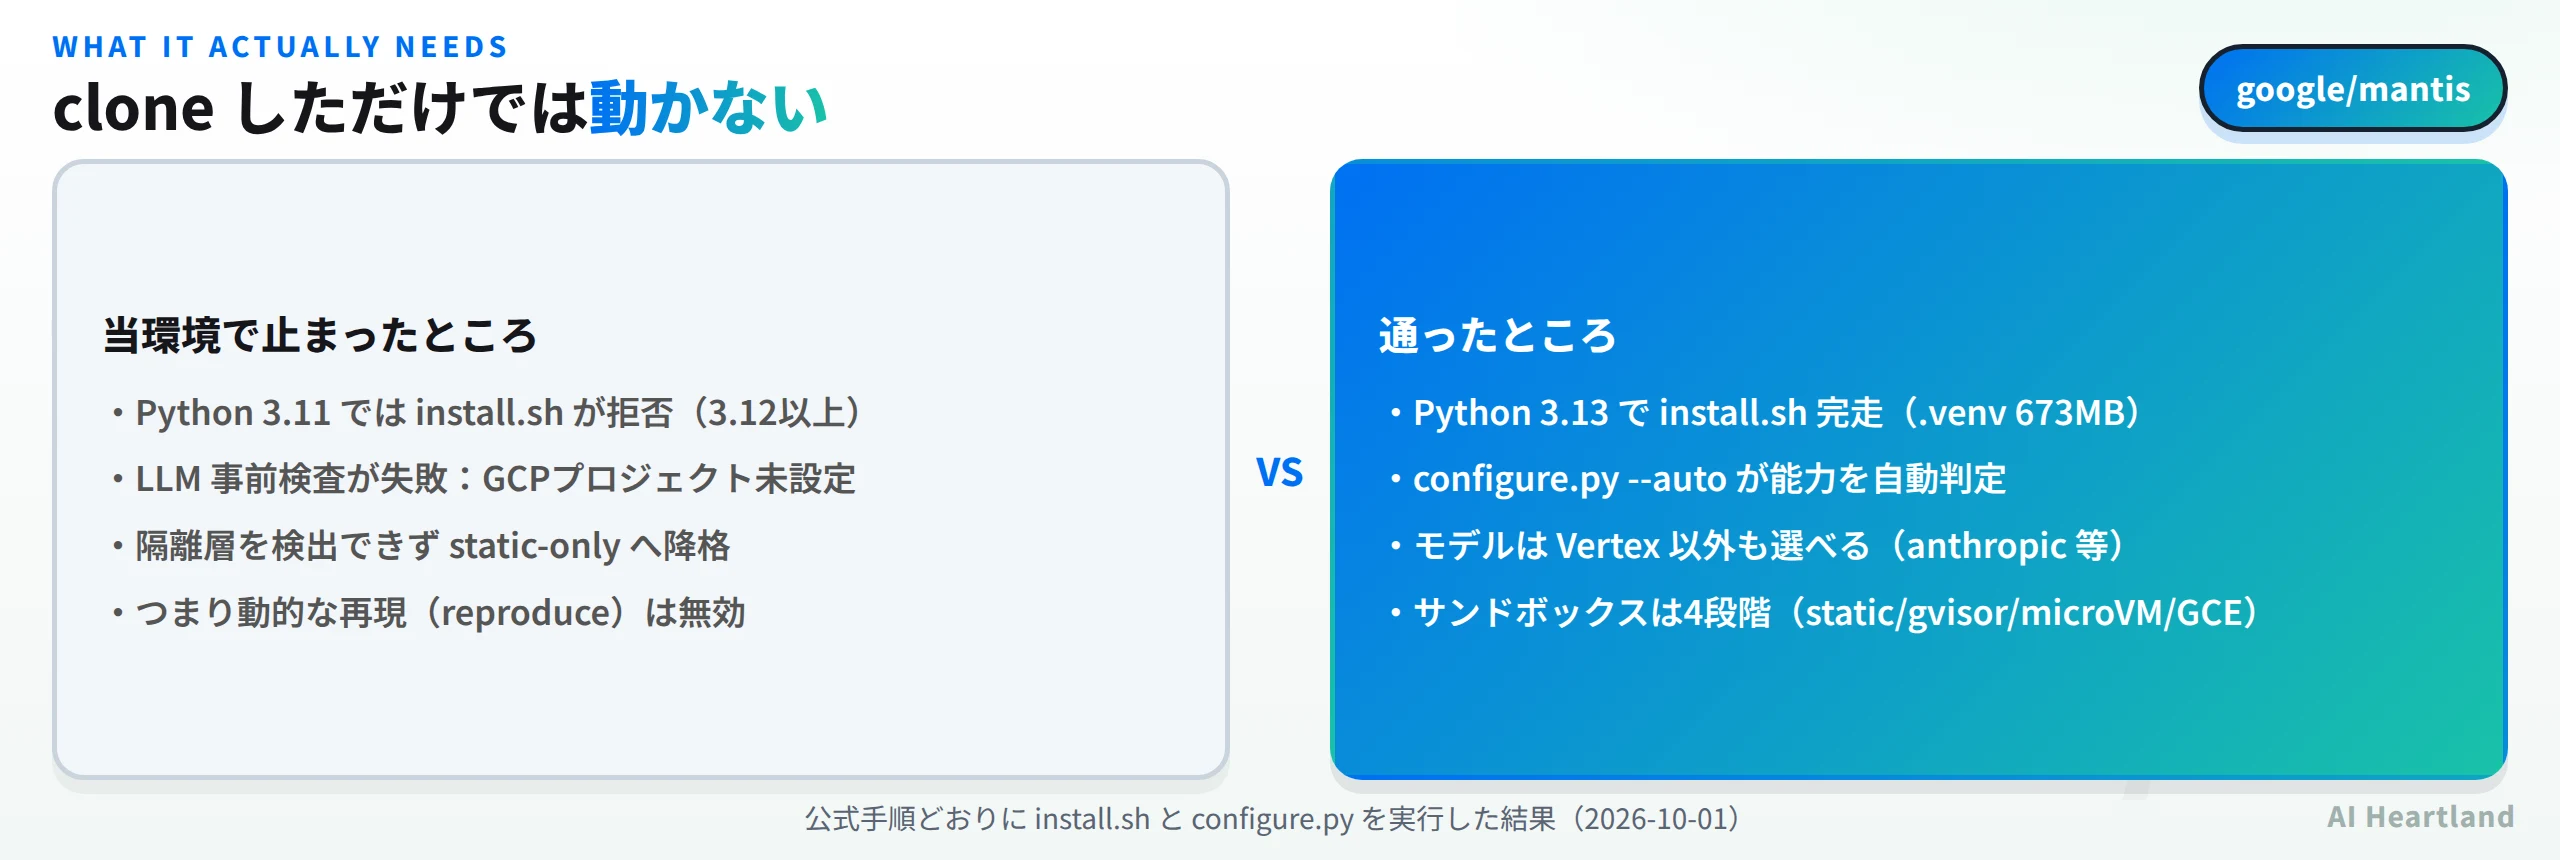
二か所で落ちた。 ひとつはモデルで、既定の vertex_ai/gemini-3.7-flash は Google Cloud のプロジェクトを要求する。もうひとつが隔離環境で、当ホストは対応する隔離層を検出できず static-only に降格した。降格自体はエラーではないが、その瞬間に reproduce(動的な再現)が無効になる。Mantisの売りである「再現まで試す」部分は、隔離環境が用意できて初めて効く。
ただし Google Cloud が必須というわけではない。configure.py のコードには Gemini・Claude・GLM・OpenAI互換の分岐がある。実際にモデルを差し替えると、止まる理由が変わることを確認できた。
python3 scripts/configure.py --model "anthropic/claude-sonnet-5" --test
# [LLM PREFLIGHT]     ❌ FAILED: Anthropic model requires ANTHROPIC_API_KEY environment variable.
# [SANDBOX PREFLIGHT] ✅ PASSED: Static-only sandbox ready (dynamic execution disabled).
エラーが「GCPプロジェクトが要る」から「ANTHROPIC_API_KEY が要る」に変わった。プロバイダの切り替えは実装されているという陰性対照になる。手元のAPIキーで回したい人にとっては重要な点だ。
スキル1本16,696トークン、全部で131,546トークン
スキル集として使う場合のコストを測った。19本の SKILL.md は合計 526,184バイト。tools/token_audit.py の heuristic 近似トークナイザ(ASCII 4文字=1)で 約131,546トークンになる。
ただし131,546トークンが常に乗るわけではない。 Agent Skills は必要になったものだけを読み込む仕組みで、常時エージェントの文脈にあるのは frontmatter の name と description だけだ。19本ぶんの frontmatter を合計すると6,120バイト、約1,530トークン。MCPサーバーを1本足すのと同程度で、これなら常駐させても負担にならない。
効いてくるのは開いた瞬間だ。最大の mantis-pipeline-adapter は66,782バイト=約16,696トークンあり、1本読ませるだけで当サイトが測った Hindsight のMCPツール定義全体(16,603トークン)とほぼ同じ量になる。patch(11,660)、reproduce(11,469)、calibrate(10,338)と、1万トークン超えが4本続く。パイプラインを通しで回せば複数本が順に開くので、文脈の消費はスキルの本数ではなく、どれを何本開いたかで決まる。
公式ブログは、大きなリポジトリを扱うために階層的なセキュリティ要約ツリーを作り、ファイル単位の要約をディレクトリ単位・ルート単位へ畳むことでトークン負荷を85%以上削減した、と述べている。この数値自体は当サイトでは再現していないが、対応する実装はリポジトリにある。mantis-summarize は「ディレクトリごとに mantis-summary.md というセキュリティ観点の要約を生成し、脅威モデリングと計画の前にコードベースを地図にする」スキルで、mantis-structural-index は「コンテンツアドレスによる意味単位の索引を作り、構造的な相互参照を与える」スキルだ。全文をモデルに読ませず、要約と索引を先に作ってから探しに行くという組み立てになっている。レビュー対象が大きいほど効く設計で、逆に小さなリポジトリではこの前処理ぶんが単純な上乗せになる可能性もある。
description の書き方も実務的だった。たとえば mantis-critic は「findings の本番での実現可能性を評価し、デバッグ専用機能やアサーション罠を除外する」と役割を書いたうえで、「再現スクリプトやパッチを書く用途には使うな」と明記している。19本すべてがこの「使うとき/使わないとき」の形で書かれていて、エージェントが誤って重いスキルを開かないよう設計されている。常駐1,530トークンの中身がほぼこの誘導文だと考えると、配分としては理に適っている。
既定のバジェットとサンドボックス4段階
reference/workflow.json には budget セクションがあり、1キャンペーンの上限が数値で書かれている。あわせて config には既定モデル(vertex_ai/gemini-3.7-flash)、リトライ回数3、タイムアウト180秒、知識ベースの保存先 knowledge.db が並ぶ。ノードによっては軽いモデル(gemini-3.5-flash 系)が個別に指定されていて、前処理は安いモデル、判断は既定モデルという振り分けになっている。
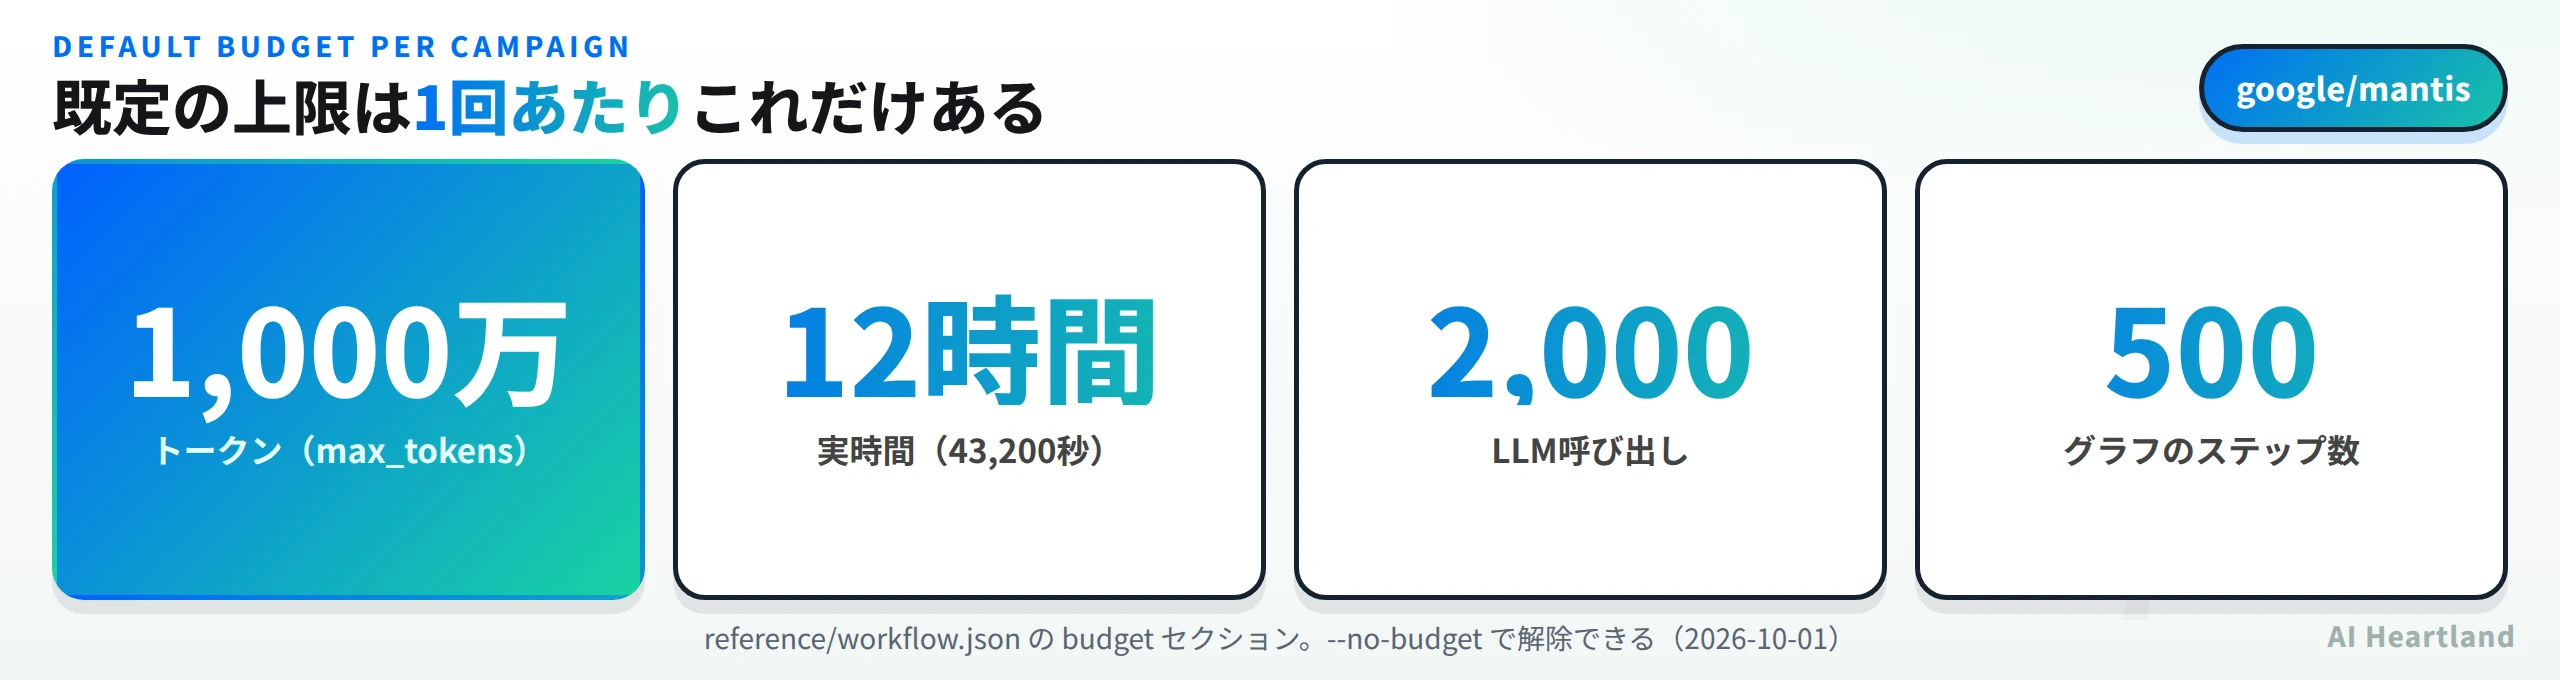
1,000万トークン、12時間、LLM呼び出し2,000回、グラフのステップ500、ノードあたりツール呼び出し200。 これが「上限」であって標準消費量ではない点は注意が要るが、そこまで走りうる前提で設計されているということでもある。READMEは長時間の無人実行向けに ./run.sh path/to/code --no-budget --parallel 32 という例を出していて、上限を外して32並列で回す使い方を想定している。コスト管理は利用者側の仕事だ。
もうひとつ、workflow.json の固定パイプライン以外にグラフそのものを生成させる経路がある。READMEが Research Graph Synthesis と呼んでいるもので、./run.sh target --objective "Audit for Server-Side Request Forgery and SSRF in webhook handlers" のように目的を自然文で渡すと、その目的に合わせたエージェントグラフの構成を設計させる。18ノードの既定パイプラインは「まず一通りやる」ための形で、目的が絞れているならノードの並びごと作り替えてよい、という思想だ。mantis-meta-agent(38,416バイト)がこの設計を担当するスキルにあたる。固定ワークフローを配るのではなく、ワークフローの作り方を配っている、と言ったほうが近い。
工程の最後に置かれた mantis-advise も方向が違って面白い。こちらは脆弱性を探すためではなく、溜まった知見を使って最初から安全なコードを書かせるためのスキルだ。過去に見つけた失敗、生成した脅威モデル、ナレッジベースを踏まえて、同じ間違いを繰り返させない。探して直すループの出口を、次の実装の入口につないでいる。19本のうちこれだけが「レビュー後」ではなく「実装中」に効く。
サンドボックスは4段階が用意されている。static-only(静的解析のみ・動的実行なし)、gvisor、microsandbox(microVM)、gce(Google Compute Engine 上の隔離環境)。configure.py --auto がホストの能力を見て選び、当環境のように何も検出できなければ最も安全な static-only に落ちる。既定で安全側に倒れる設計だ。
そして、この記事で一番伝えるべきなのはREADMEの2つの警告だと思う。1つ目は運用環境について。
自己責任で使うこと。極めて慎重に。 このスイートは自律的に生成されたコードを実行するよう設計されており、それは不安定だったり予期しない動作をする可能性がある。隔離された制限環境でのみ使うこと。 本番システム・機微データ・内部ネットワークにアクセスできるマシンでは決して実行しないこと。
2つ目は成果物の扱いについてで、こちらのほうが踏み込んでいる。
AIモデルは非決定的で、findings を幻覚したり誤った修正を生成しうる。すべての findings は報告前にセキュリティ専門家が手作業で検証しなければならない。未検証のAI生成レポートをOSSメンテナへ大量に送りつけてはならない。 自動での再現失敗は偽陽性の確証にならないし、再現成功もあらゆる文脈で悪用可能であることを保証しない。
ツールを出した側が「これで出た報告をそのまま投げるな」と書いている。 AI生成のバグ報告がOSSメンテナの負担になっている現状を踏まえた但し書きで、Mantisを評価するときはこの一文を前提に置くべきだろう。critic や calibrate といった工程が存在する理由も、ここから逆算すると分かりやすい。
検証環境:Linux 6.18.44/Python 3.11.15 および 3.13/2026-10-01。google/mantis を git clone --depth 1(既定ブランチ main・最終コミット 47099ed「Support Python 3.12+」・2026-09-28)し、19本の SKILL.md のバイト数と frontmatter を数えた。トークンは tools/token_audit.py の heuristic 近似トークナイザ(ASCII 4字=1)で換算し、tiktoken の cl100k_base はBPE辞書を取得できないため使っていない。参照ハーネスは公式手順どおり reference/install.sh を実行し(3.11で拒否・3.13で完走・.venv 673MB)、scripts/configure.py --auto と --model anthropic/… --test を実行して事前検査の結果を確認した。バジェットとグラフ構成は reference/workflow.json を直接読んでいる。未検証:脆弱性レビューを1回も実行していない。Vertex AI のプロジェクトもAPIキーも用意していないため、./run.sh は走らせておらず、検出精度・誤検知率・実際のトークン消費・パッチの品質はいずれも未確認。動的な再現(reproduce)も当ホストでは static-only に降格したため試せていない。公式ブログが述べる「一般的なAIコードスキャンの真陽性率は7%未満」「階層的サマリでトークン負荷を85%以上削減」という数値も当サイトでは再現しておらず、出典の主張として扱う。star 1.8k・fork 171・open issues 2 はリポジトリページの表示値。
Mantisを試す前に押さえる点
・まずスキルだけ試す:19本の SKILL.md を既存のエージェントに読ませる使い方なら、Python もGCPも要らない。常駐は約1,530トークン
・参照ハーネスは別物:Python 3.12以上・673MBの仮想環境・モデルの資格情報が要る。ここを混同すると「動かない」と誤解する
・隔離環境が無いと半分になる:reproduce は動的実行が要る。static-only に落ちた時点で、再現までやる価値の大半は外れる
・モデルはGoogle以外も選べる:Gemini・Claude・GLM・OpenAI互換。--model で切り替わることは確認した
・バジェットを先に決める:既定でも1回1,000万トークン。--no-budget --parallel 32 は本当に無人運用する人向けの設定
・出た指摘をそのまま投げない:READMEが明示的に禁じている。人間の検証を工程に入れてから使う
・本番から隔離する:自律生成コードを実行する前提のツール。READMEの警告は誇張ではない
・タグが無い:リリースが切られていないので、固定するならコミットハッシュで留める
・MantisBTと混同しない:検索でも社内の会話でも紛れる。google/mantis と明示するのが安全
・知識ベースが育つ前提:knowledge.db に findings と学びが溜まり、reflect と advise がそれを次に回す。1回だけ走らせて評価すると、この設計の利点は出ない
・目的が決まっているなら固定パイプラインを使わない:--objective でグラフ自体を設計させる経路がある。既定の18ノードは汎用の入口と考える
総括。 Mantis の面白さは、脆弱性探しという曖昧な作業を19個の名前付きの工程に割り、それぞれに「使うとき/使わないとき」を書いたところにある。とくに critic(本番で踏めない指摘を落とす)と calibrate(重大度の盛りを較正する)は、AIにセキュリティレビューをさせたときに必ず出る問題への回答になっていて、ここだけ取り出して自分のレビュー工程に混ぜる価値がある。1本あたりのトークンは重いが、常駐は1,530トークンで済む設計も理に適っている。
一方で、参照ハーネスまで含めた完全な姿を動かすハードルは高い。Python 3.12以上、モデルの資格情報、そして隔離環境。当環境では最後のひとつが無く、動的な再現は最初から無効になった。加えて既定バジェットが1回1,000万トークンという規模なので、試すにも本気の準備が要る。
それでも、Googleが自分で「出た報告をメンテナに投げるな」と書いたツールを公開した意味は小さくないと思う。AIに脆弱性を探させること自体は誰でもできるようになったが、幻覚を落とし、重大度を較正し、人間の検証を工程に組み込むという部分は各自が作るしかなかった。その部分がApache-2.0で読める形になった、というのがこのリポジトリの一番の価値だ。動かす準備が整っていなくても、mantis-critic と mantis-calibrate の2本を読むだけで、自分のレビュー工程に足りないものが見えてくると思う。
参照ソース
・google/mantis(公式リポジトリ) — README・mantis-*/SKILL.md 19本・reference/workflow.json・reference/scripts/configure.py を 2026-10-01 に確認
・Getting started with the Mantis harness to find and fix bugs(Google Cloud 公式ブログ) — 導入手順と設計意図の出どころ
・mantisbt/mantisbt — 同名の別プロジェクト(バグ追跡システム)