Gemini 4 Argon は、Google が 2026-09-30 に発表した最前線モデルだ。出力トークン上限を 64K から 100万へ引き上げ、知識労働・エージェント的コーディング・サイバー防御の3領域で数字を並べている。ただし調べ始めて最初に分かったのは、性能の話より手前のことだった——今日、APIキーでこれを呼べる人はほとんどいない。
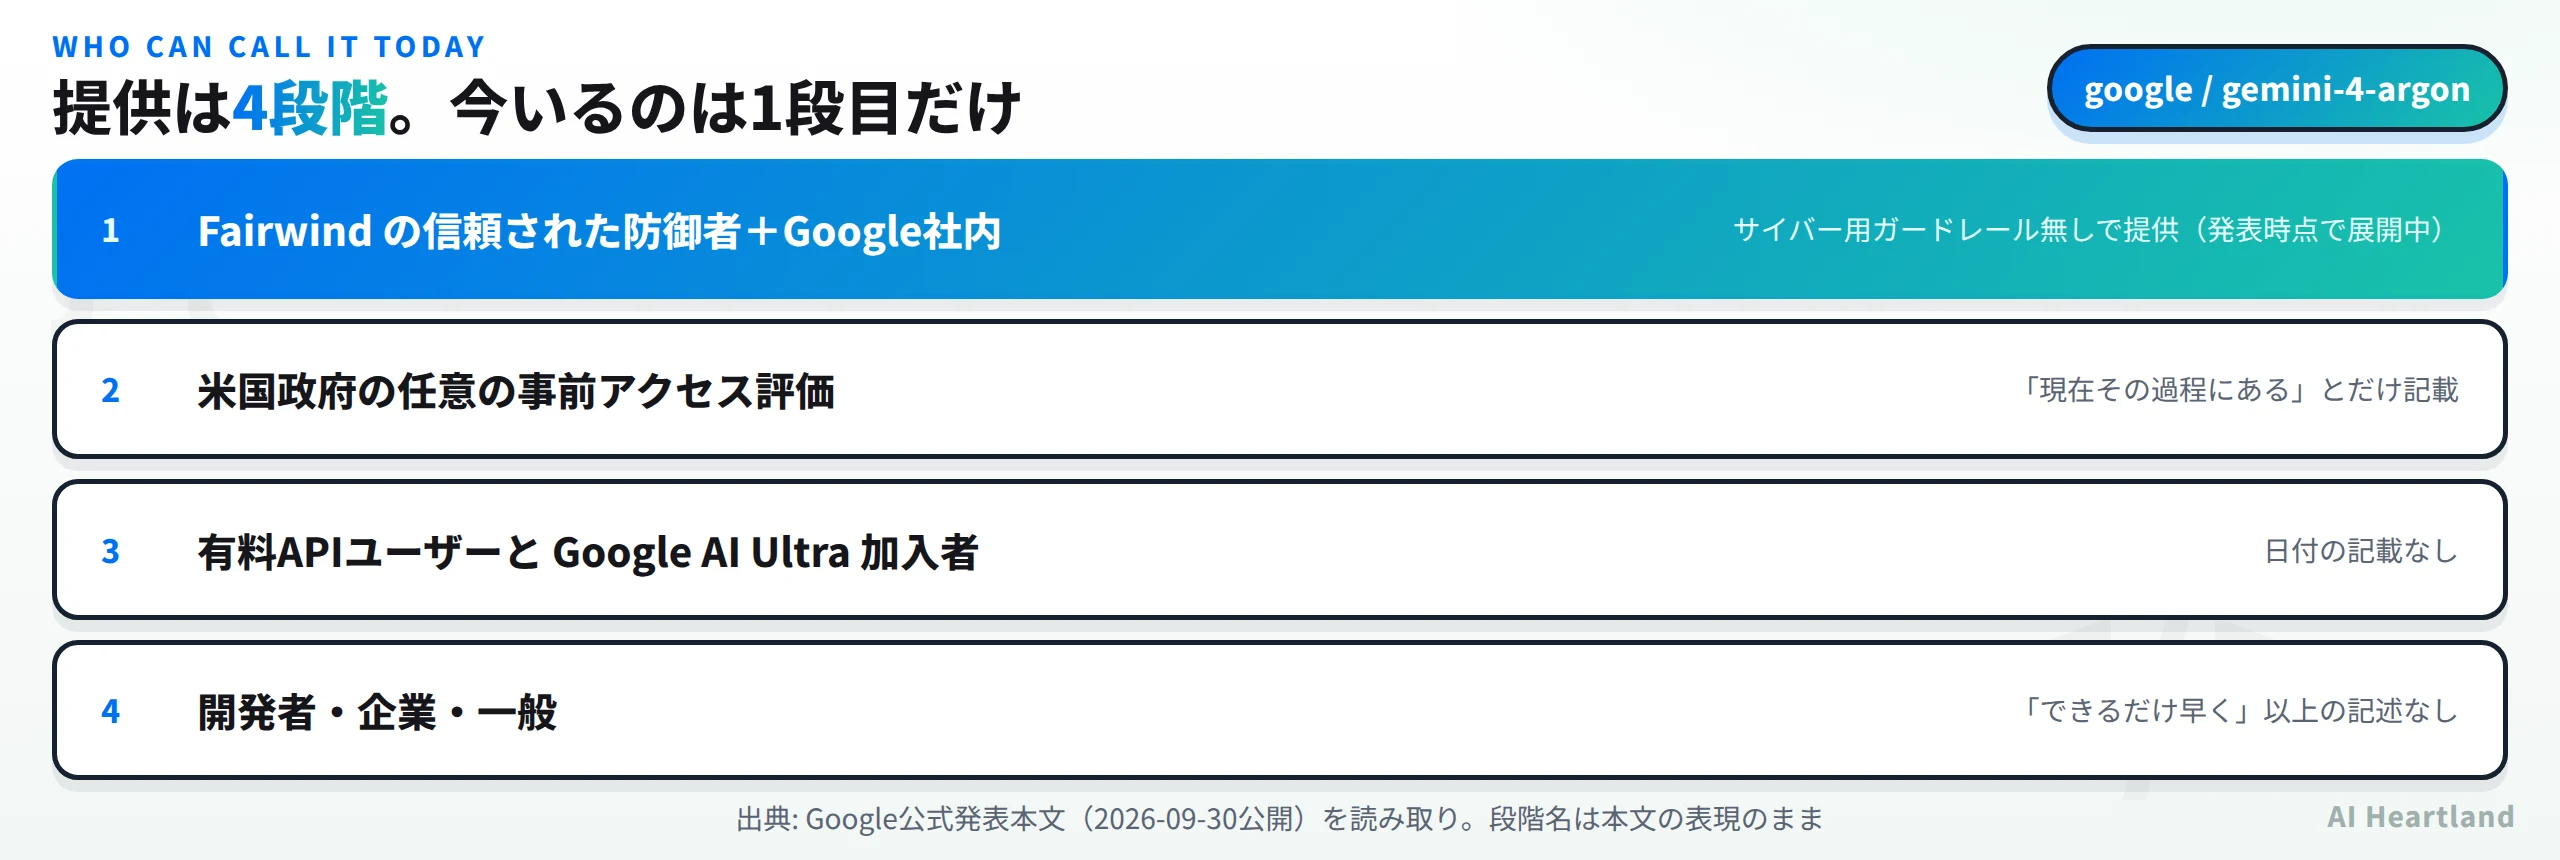
- ・Googleが2026-09-30に発表。展開先は **Fairwind Program の信頼された防御者とGoogle社内**のみ
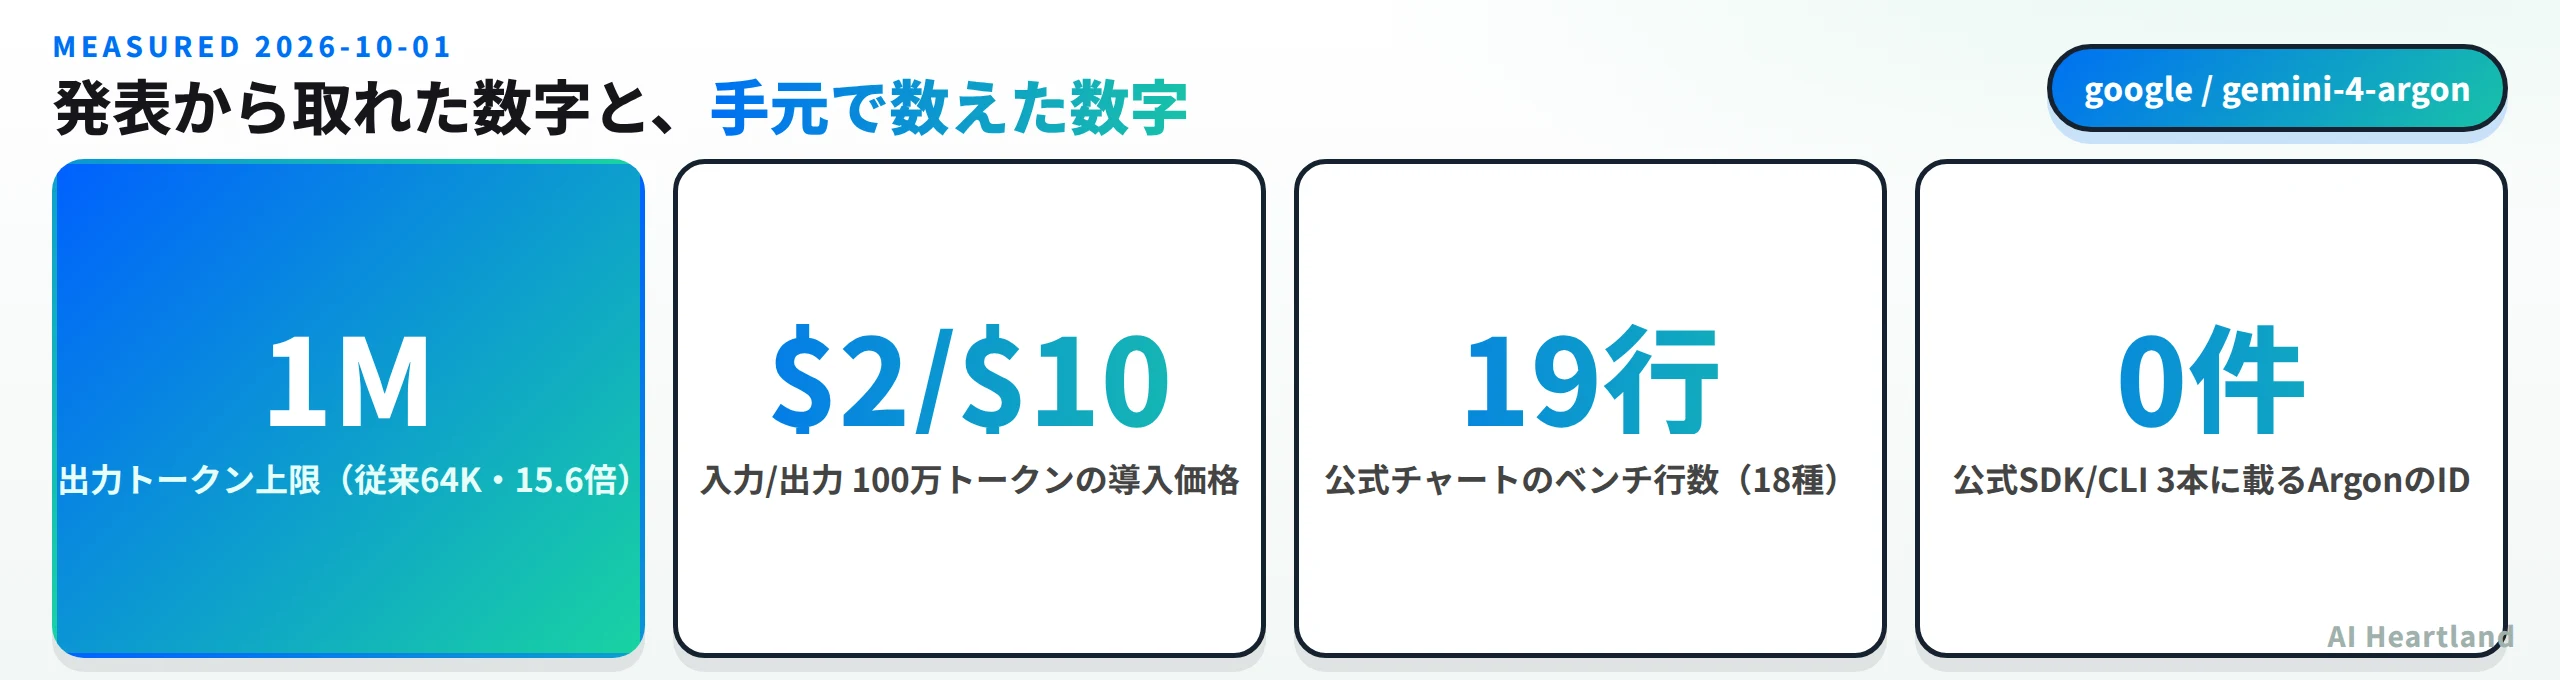
- ・**出力トークン上限が64K→100万**(15.6倍)。入力の文脈長ではなく出力側の天井が変わった
- ・導入価格は入力100万トークンあたり2ドル、出力10ドル。キャッシュ入力は入力の95%引き
- ・公式チャートは18種19行。**Argon単独最高が13行、同点1行、負け5行**(塗り分けを数えて確認)
- ・信頼された防御者には**サイバー用ガードレールを外して**提供すると明記
- ・公式SDK/CLI 3本の2026-09-30時点HEADに **Gemini 4 系のモデルIDは0件**
LLM全般の仕組みやモデルの選び方はLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめてある。本記事はその枝として、「発表は済んだが提供されていないモデル」をどう扱うかを見る。
Gemini 4 Argonとは:発表で確定した事実だけを並べる
まず、発表本文から取れる事実だけを並べる。Gemini 4 Argon は「複雑で長期にわたるワークフローにわたって深い推論を維持する」ことを目的に作られたモデルで、狙う領域は実世界のソフトウェア工学、法務・財務のような企業の知識労働、そしてサイバー防御の3つだ。
提供は段階的で、本文は順序をこう書いている。
・1段目:Fairwind Program の信頼された防御者と、Google社内のチーム
・2段目:米国政府による事前リリース版アクセスの任意プロセス(「現在その過程にある」と記載)
・3段目:有料APIユーザーと Google AI Ultra 加入者
・4段目:開発者・企業・一般
重要なのは、2段目以降に日付が1つも書かれていないことだ。「ガードレールを反復しながらできるだけ早く」という表現までで、四半期の目安すら無い。価格だけが先に決まっている——導入価格として入力100万トークンあたり2ドル、出力10ドル、キャッシュ入力は入力価格の95%引き。
Google社内での使われ方として、発表は3つの事例を挙げている。数字が具体的なので引いておく。
・量子アルゴリズムの最適化:重要な応用のボトルネックになるサブルーチンの時空間資源(量子ビット数×ゲート数)を最適化し、ある例では公開されているベースラインを数分で40%上回った
・メモリ効率化:Argonのエージェント群が全社規模のプロファイリング情報を解析し、データセンター全体で自律的にメモリ最適化を適用。展開後に300 TiB超を解放し、総節約は500 TiB〜1 PiBと見積もり
・大規模なコードベース移行:C/C++からRustへの移行を、re2 や libgav1 のような中核ライブラリの数万行から、Fuchsia OS の Zircon カーネルの80万行超まで進行中
3つ目には但し書きがあり、「多くが重要なシステムであるため、厳格な自動・手動の監査、エミュレーションテスト、レビューを経てから本番投入する」と書かれている。Argonが書いたものをそのまま入れているわけではない、という注記だ。ここは自社導入を考えるときにそのまま効いてくる。
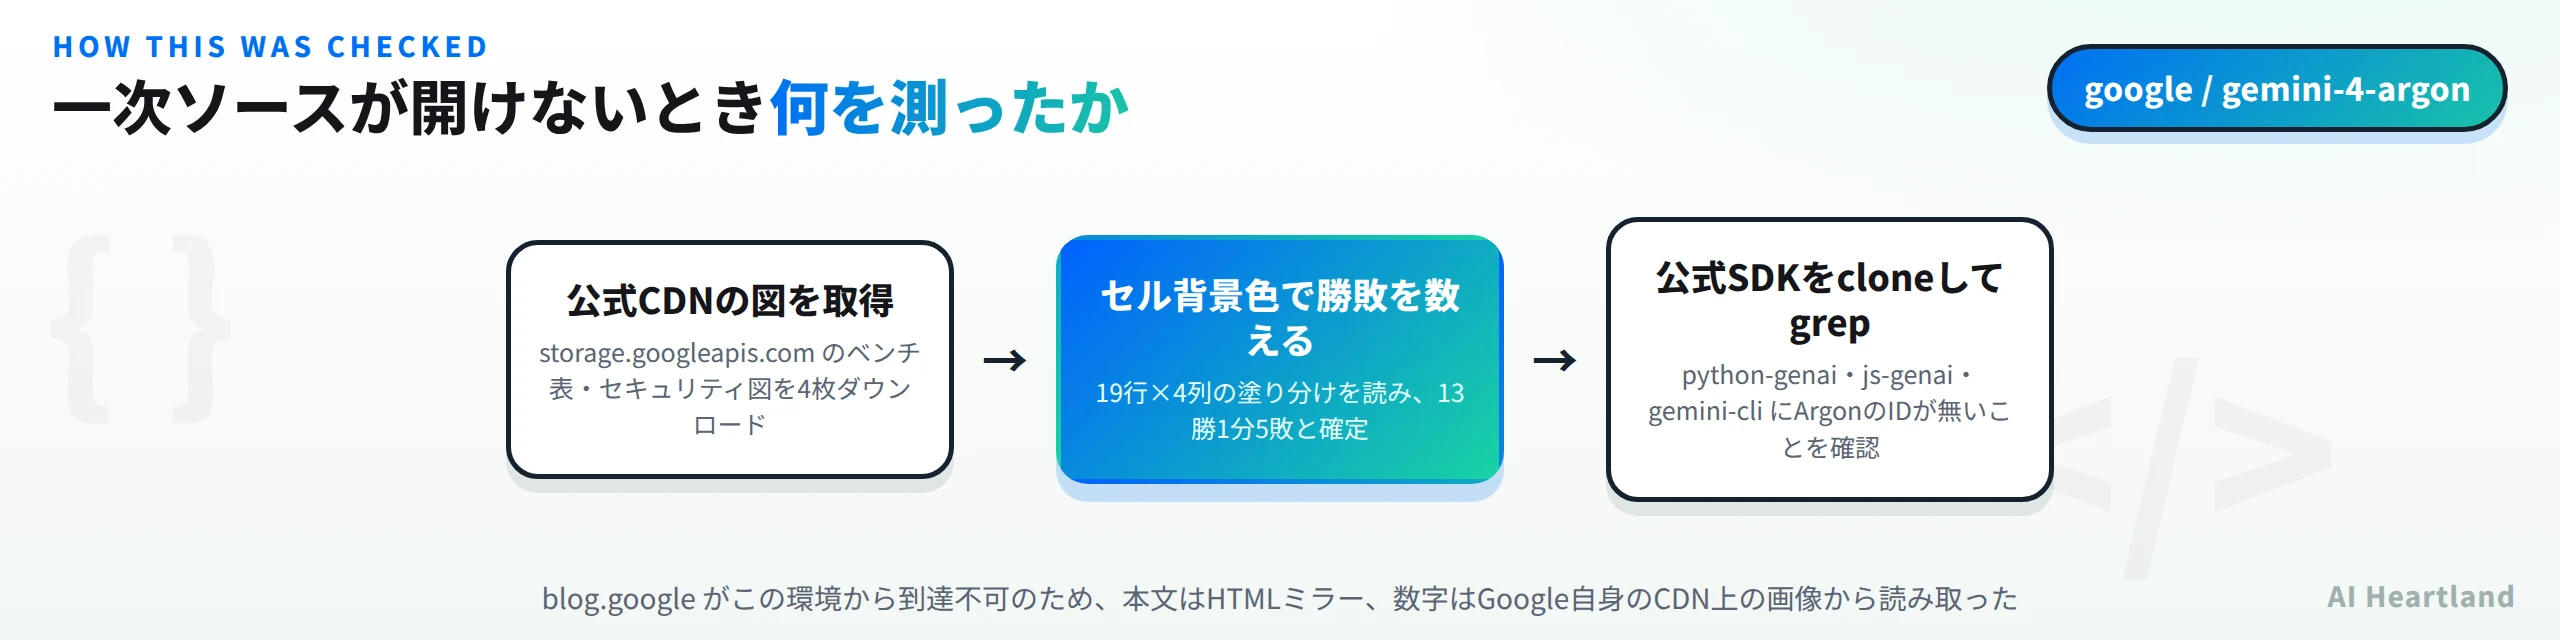
なお、当サイトの環境からは blog.google と deepmind.google の双方に到達できなかった。本文は同一記事のHTMLミラーから読んでおり、発表ページそのものをブラウザで開いての確認はできていない(未検証)。ただし後述するベンチマーク数値は、Googleが自社のCDN(storage.googleapis.com)に置いた画像を直接取得して読み取っているので、数字の出所は一次のままだ。
出力上限64K→1Mが変えるのは「1回の応答の値段」
発表で最も実務に効くのは、ベンチマークではなく出力トークン上限の変更だと思う。本文の表現はこうだ——「モデルの出力トークン上限を、従来の64Kから業界最高水準の100万トークンへ大幅に拡張する」。
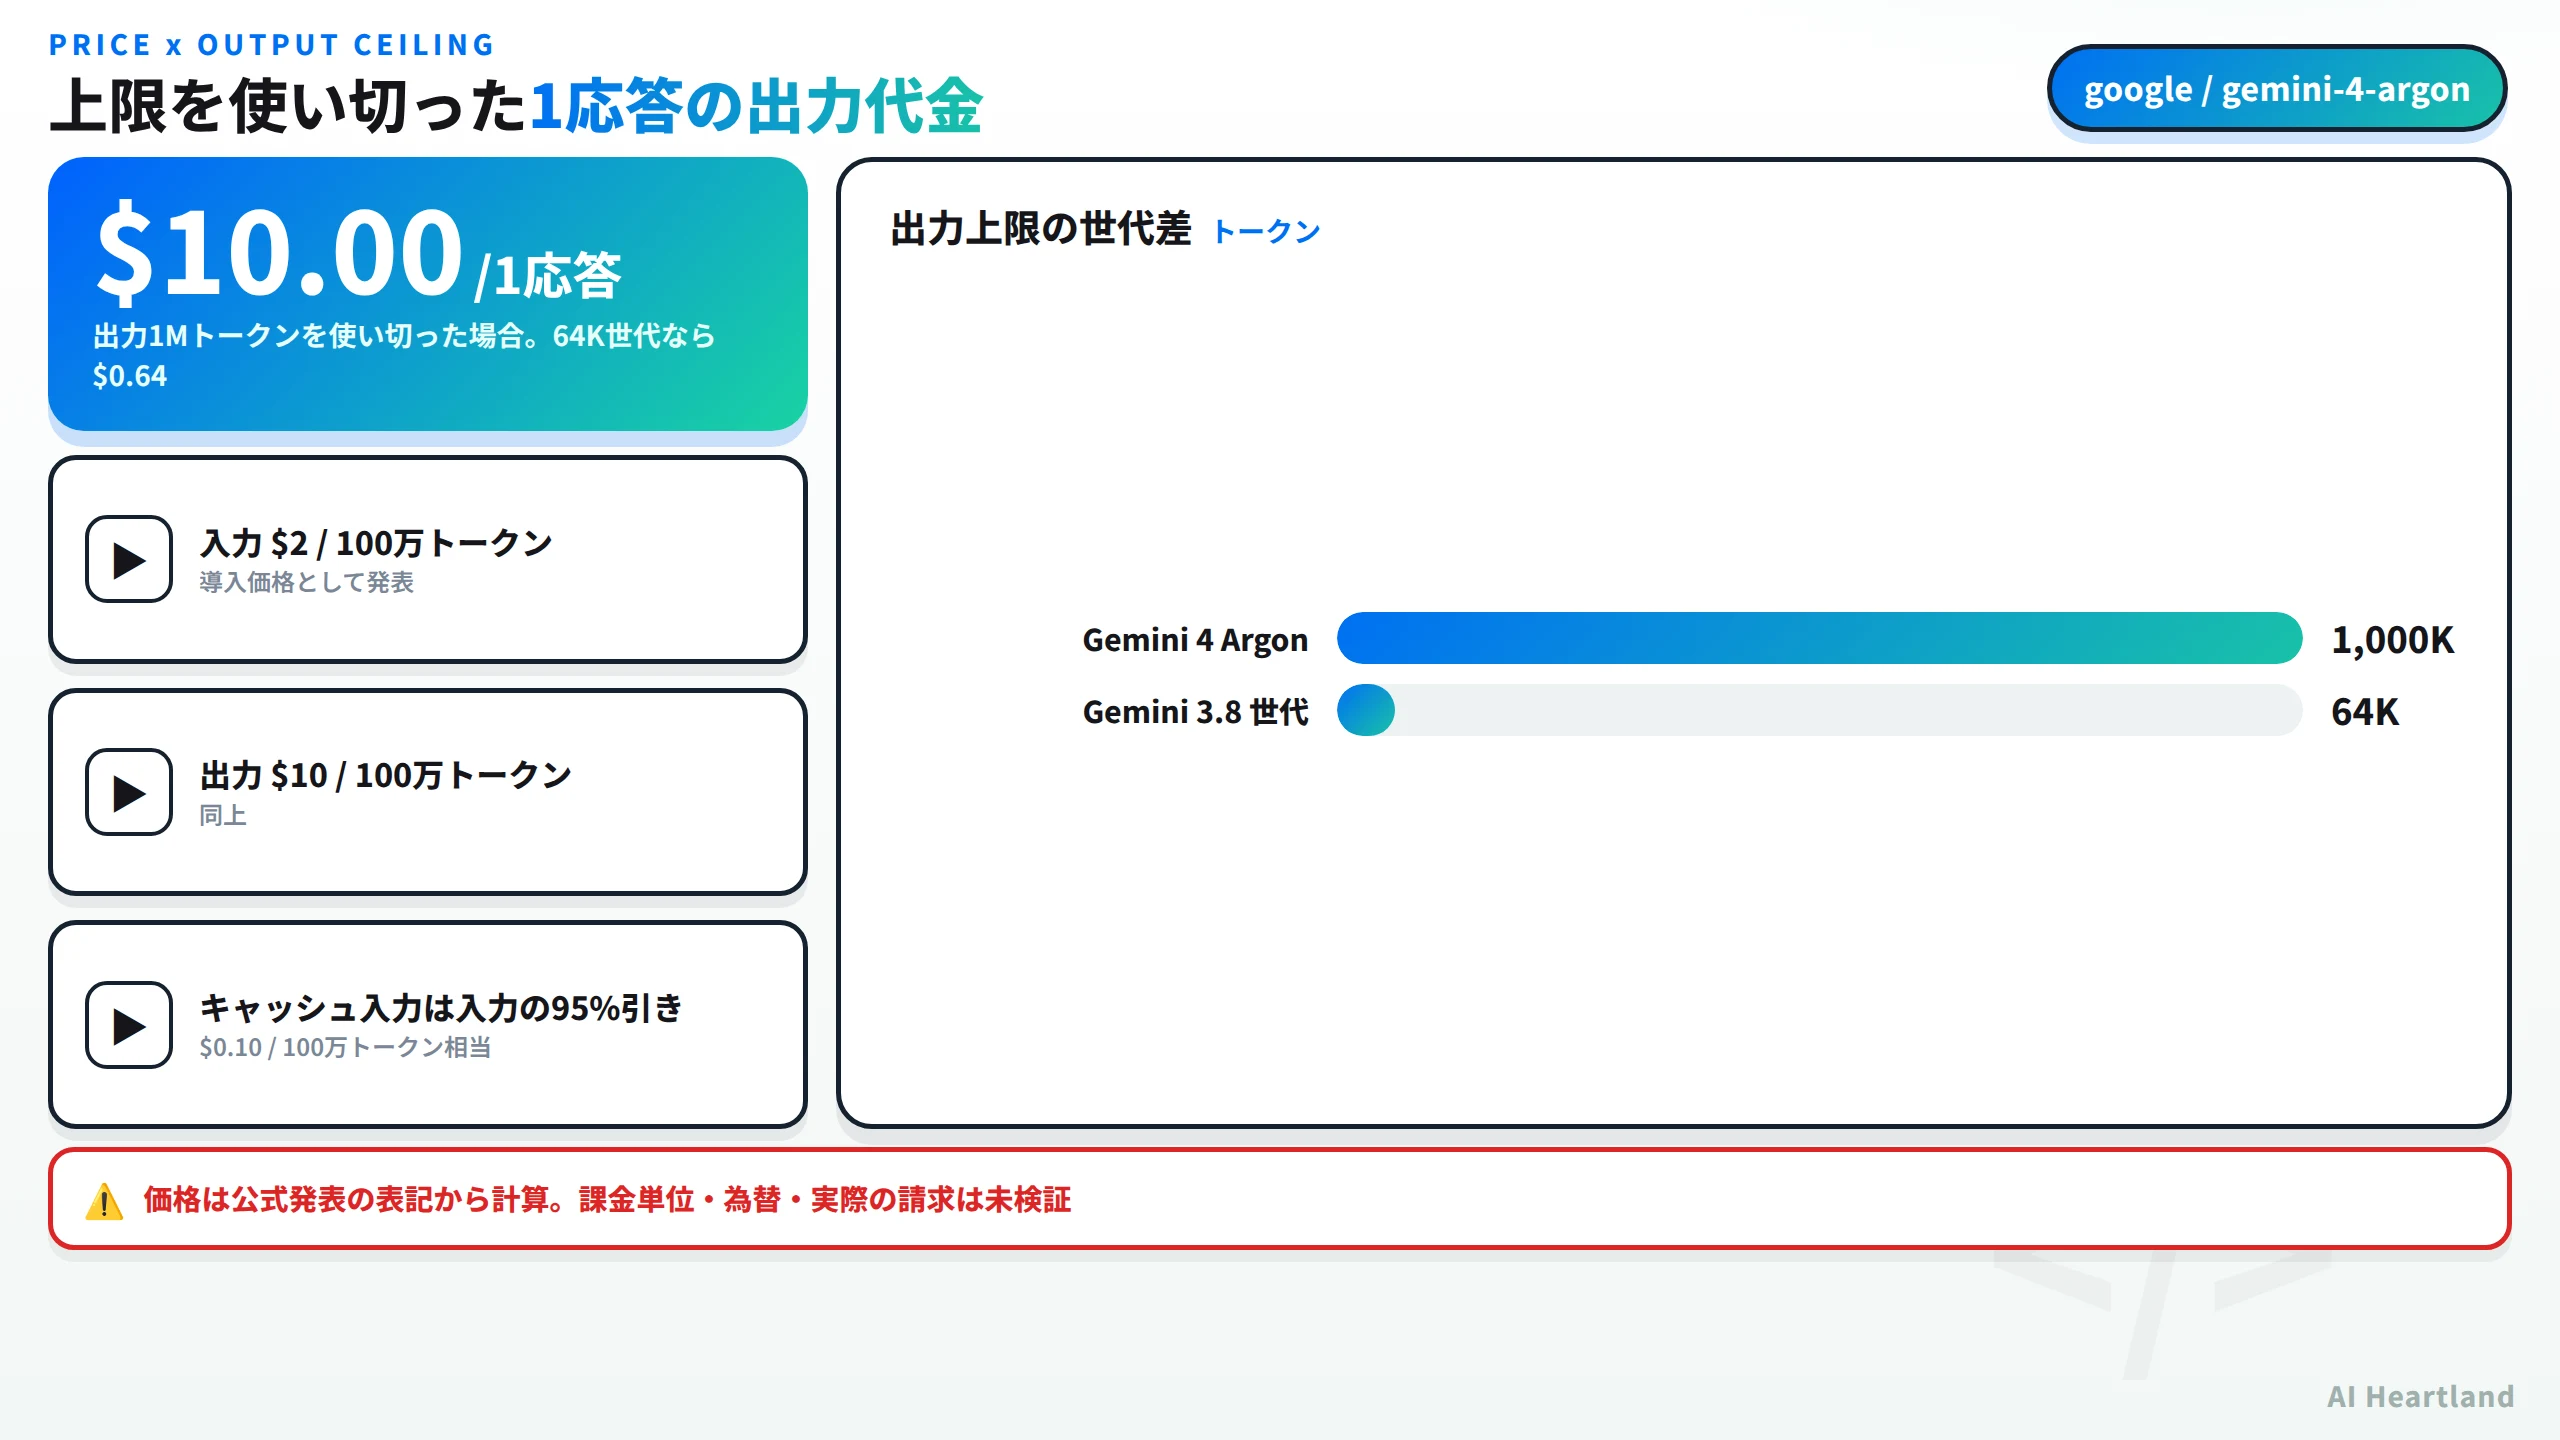
数字にすると 1,000,000 ÷ 64,000 = 15.625倍。よく誤解されるが、これは文脈長(入力側)の話ではない。Gemini は以前から100万トークンの文脈を扱えており、変わったのは出し切れる長さのほうだ。長い入力を読ませて短くまとめる用途には影響しないが、「1回の呼び出しで長大な成果物を最後まで出す」用途の天井が動く。
ここに価格を掛けると、見え方が変わる。出力100万トークンあたり10ドルということは、上限いっぱいまで出力した応答1回の出力代金が10.00ドルになる。64K世代では同じ計算が0.64ドルだった。上限が15.6倍になったということは、1回の呼び出しで事故ったときの金額も15.6倍になるということだ。
・エージェントに長時間の自走を許す構成では、max_output_tokens を明示しないと上限が既定で効く場合がある
・ループに落ちたエージェントが上限まで書き続けたときのコストが、これまでとは桁で変わる
・予算やタイムアウトの計算式が64K前提で書かれていれば、そこは見直しが要る
第三者のモデルカタログを読んでいると、実装者側も同じ点を気にしていた。あるOSSのモデルカタログは、Argonを収録しない理由を説明する長いコメントの中で「maximum_output_tokens がこれほど大きな値を持ったことは一度も無いので、予算・打ち切りの計算はそのまま入ると仮定せずに確かめたい」という趣旨を書き残している。同じ懸念が、実装する側でも先に立っているということだ。
Gemini 4 Argonの公式ベンチ19行を塗り分けから数え直す
発表と同時に、Googleは比較表を1枚の画像で出している。文章側では DeepSWE v1.1 の 77.9%、AutomationBench の 51.3%、LVBench の 91.7% といった勝っている数字だけが引用されているので、表そのものを取得して全行を読んだ。
画像はGoogle自身の配信CDNに置かれていて、この環境から取得できた。3936×3948ピクセル、341,364バイトのGIFだ。
# Googleが配信している公式ベンチ表の画像を取得して寸法を確認する
curl -sS -o table.gif \
  "https://storage.googleapis.com/gweb-uniblog-publish-prod/original_images/gemini-4-argon_table_blog.gif"
python3 -c "from PIL import Image; im=Image.open('table.gif'); print(im.size)"
# => (3936, 3948)
この表は勝っているセルを色で塗り分けている。Argonが最高値なら青、他モデルが最高値ならそのセルが灰色だ。目で数えると間違えるので、セルの背景色を機械で判定した。各セルの領域から文字(暗い画素)を除いた最頻色を取り、青・灰・白に分類している。陽性対照として、灰色が出た行は必ず「Argonが白」であることを確認した——分類器が無関係な場所を拾っていれば、この対応は崩れる。
結果はこうなった。18種19行のうち、Argon単独の最高値が13行、同点首位が1行(CWE-bench v1)、他モデルが上なのが5行。
| 分類 | ベンチマーク | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 知識労働 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 知識労働 | AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| 知識労働 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 知識労働 | Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| コーディング | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| コーディング | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| コーディング | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| コーディング | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| ML工学 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科学・数学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科学・数学 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科学・数学 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 長文脈 | GraphWalks(128kまで・BFS F1) | 99.7% | 98.7% | 91.4% | 90.6% |
| 長文脈 | GraphWalks(256k〜1M・BFS F1) | 84.2% | 71.8% | 65.0% | 66.8% |
| PC操作 | Agent’s Last Exam(通過率) | 39.5% | 34.2% | — | 38.2% |
| PC操作 | OSWorld-2.0(オフライン部分点) | 69.2% | 72.6% | — | — |
| マルチモーダル | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| マルチモーダル | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| サイバー | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
読んで気づくことを3つ挙げる。
第一に、負けている5行に偏りがある。FrontierSWE v2、Terminal-bench 4.0、PostTrainBench、Terminal-Bench Science 0.1、OSWorld-2.0。どれもターミナルや実環境で手を動かし続ける系の評価だ。逆に Argon が大差をつけているのは Harvey’s Legal(19.6% 対 5.4%)や GraphWalks の長文脈側(84.2% 対 71.8%)といった、読解と長期の一貫性が効く側だった。「長時間の推論を維持する」という設計の主張とは整合している。
第二に、比較対象の選び方だ。表の列は GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 の3つ。後述するように、同じ発表の別の図には Grok 4.7 が Argon と同点で載っているのに、この表には Grok が1列も無い。自社発表の比較表としては珍しい話ではないが、表に無いモデルが上にいる可能性は表からは読めない。
第三に、条件の注記が表の外にあること。表の脚注は評価方法のURLを指しているだけで、条件は別ページにある。第三者が抽出した条件メモを見ると、既定は「Gemini API経由で思考設定は最高、特記が無ければ pass@1」で、個別には「自己計測」「公式リーダーボード」「OSWorldは3回の単発実行の最大値」など、行ごとに測り方が違う。横一列に並んだ数字が同じ手続きで出ているとは限らない。
セキュリティ:ガードレール無し提供とCWE-bench 68%の読み方
当サイトはセキュリティを柱の1つに置いているので、ここは丁寧に見る。発表で最も踏み込んだ記述は性能ではなく提供条件のほうだった。
信頼された防御者と我々自身の社内チームに対しては、サイバー用のガードレールを外した Argon を提供する。最前線レベルのサイバー防御能力を完全に活用できるようにするためである。
つまり Fairwind Program は、単なる早期アクセス枠ではない。同じモデルの別バージョンを配る枠だ。攻撃的な操作を拒む層を外した状態で渡す相手を、審査で絞る。これは同じGoogleが公開しているサイバー防御ハーネス Mantis の延長線上にある考え方で、あちらは「ハーネスを公開し、モデル側の判断に安全境界を持たせる」構成だった。Argonでは、その安全境界を外す相手を人間の審査で決めるという一段強い切り方をしている。
具体例として挙がっているのが Wiz の Scan for Good だ。重要な公共インフラの露出を無償で見つけて直す取り組みで、発表によれば Argon は世界中の病院で使われている医療ソフトの、個人情報を露出させる重大な脆弱性を発見した——以前の最前線モデルが見逃していたものだ、としている。この件のCVE番号や対象製品は書かれていないため、影響範囲の確認は読者側ではできない(未検証)。
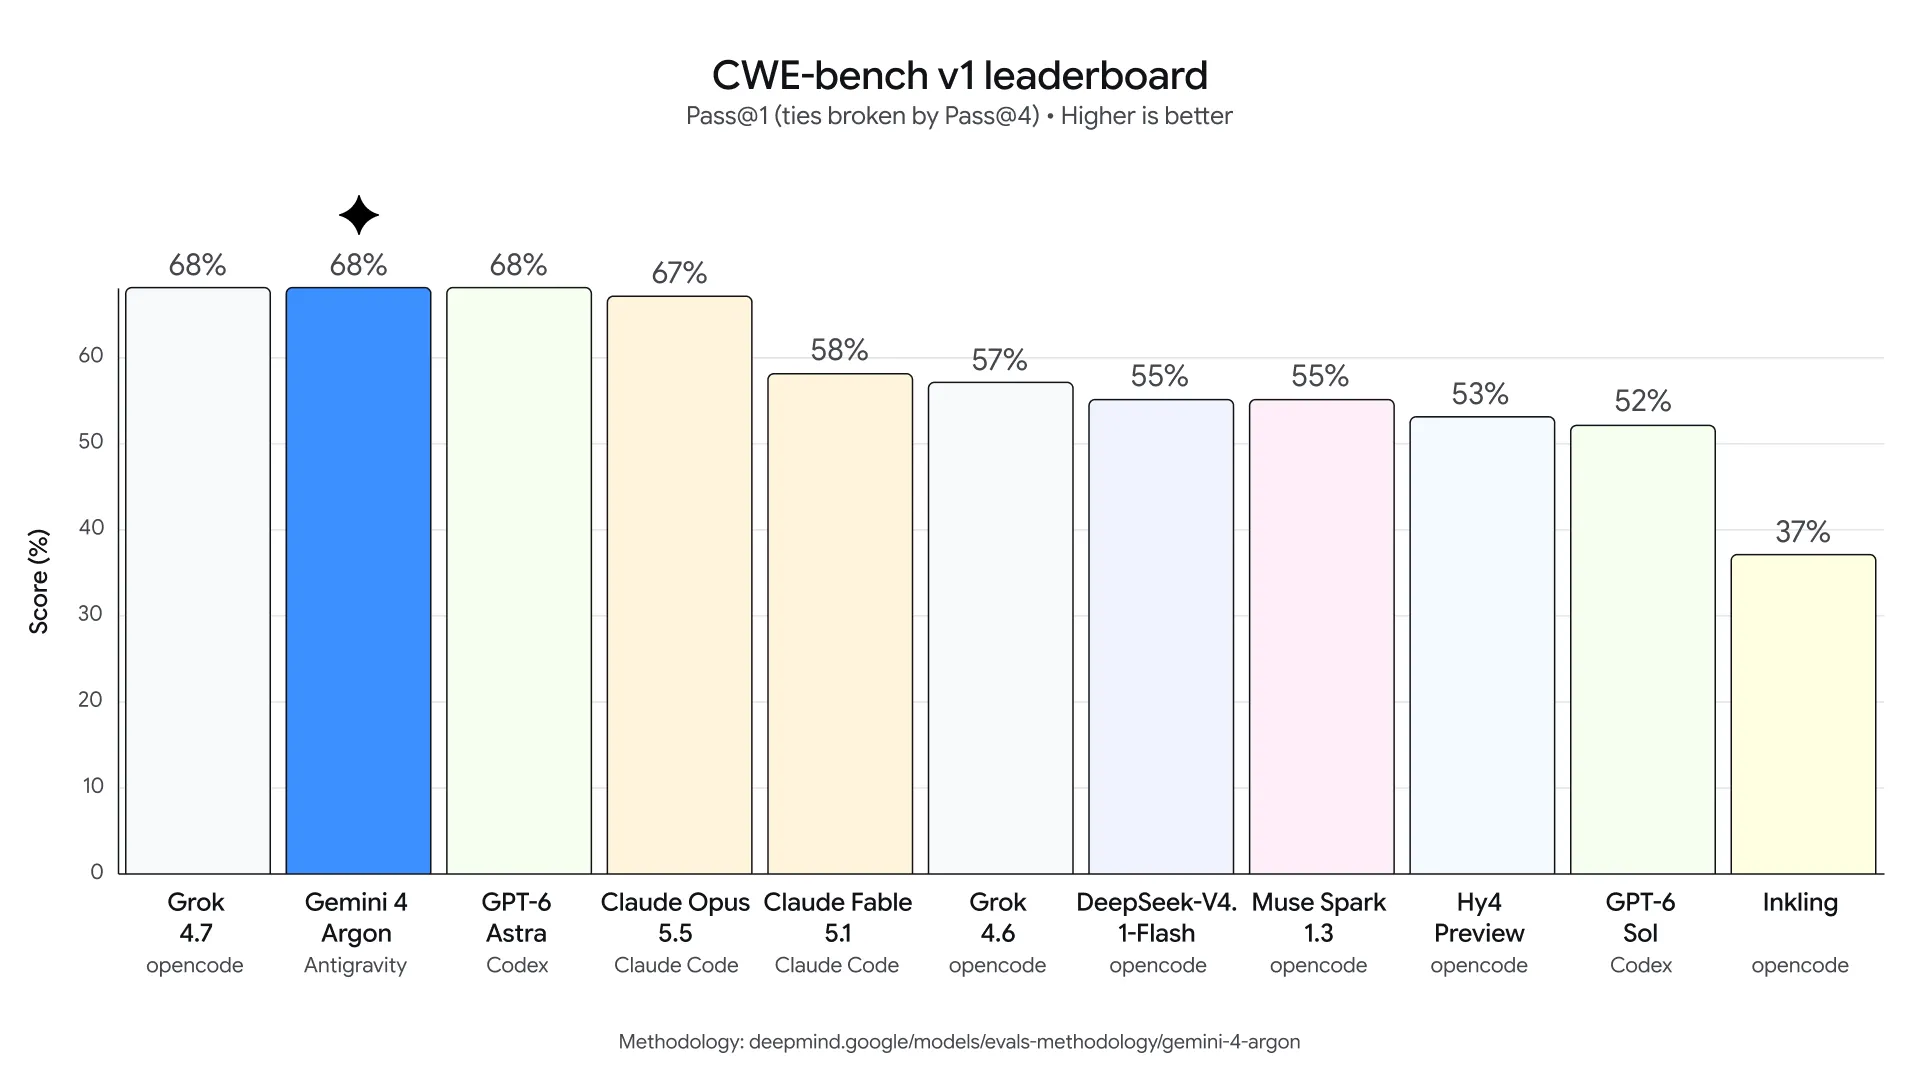
性能側の数字は CWE-bench v1 だ。発表本文は「68%で同点首位」と書いている。この「同点」がどういう状態なのか、リーダーボードの画像を取得して確かめた。
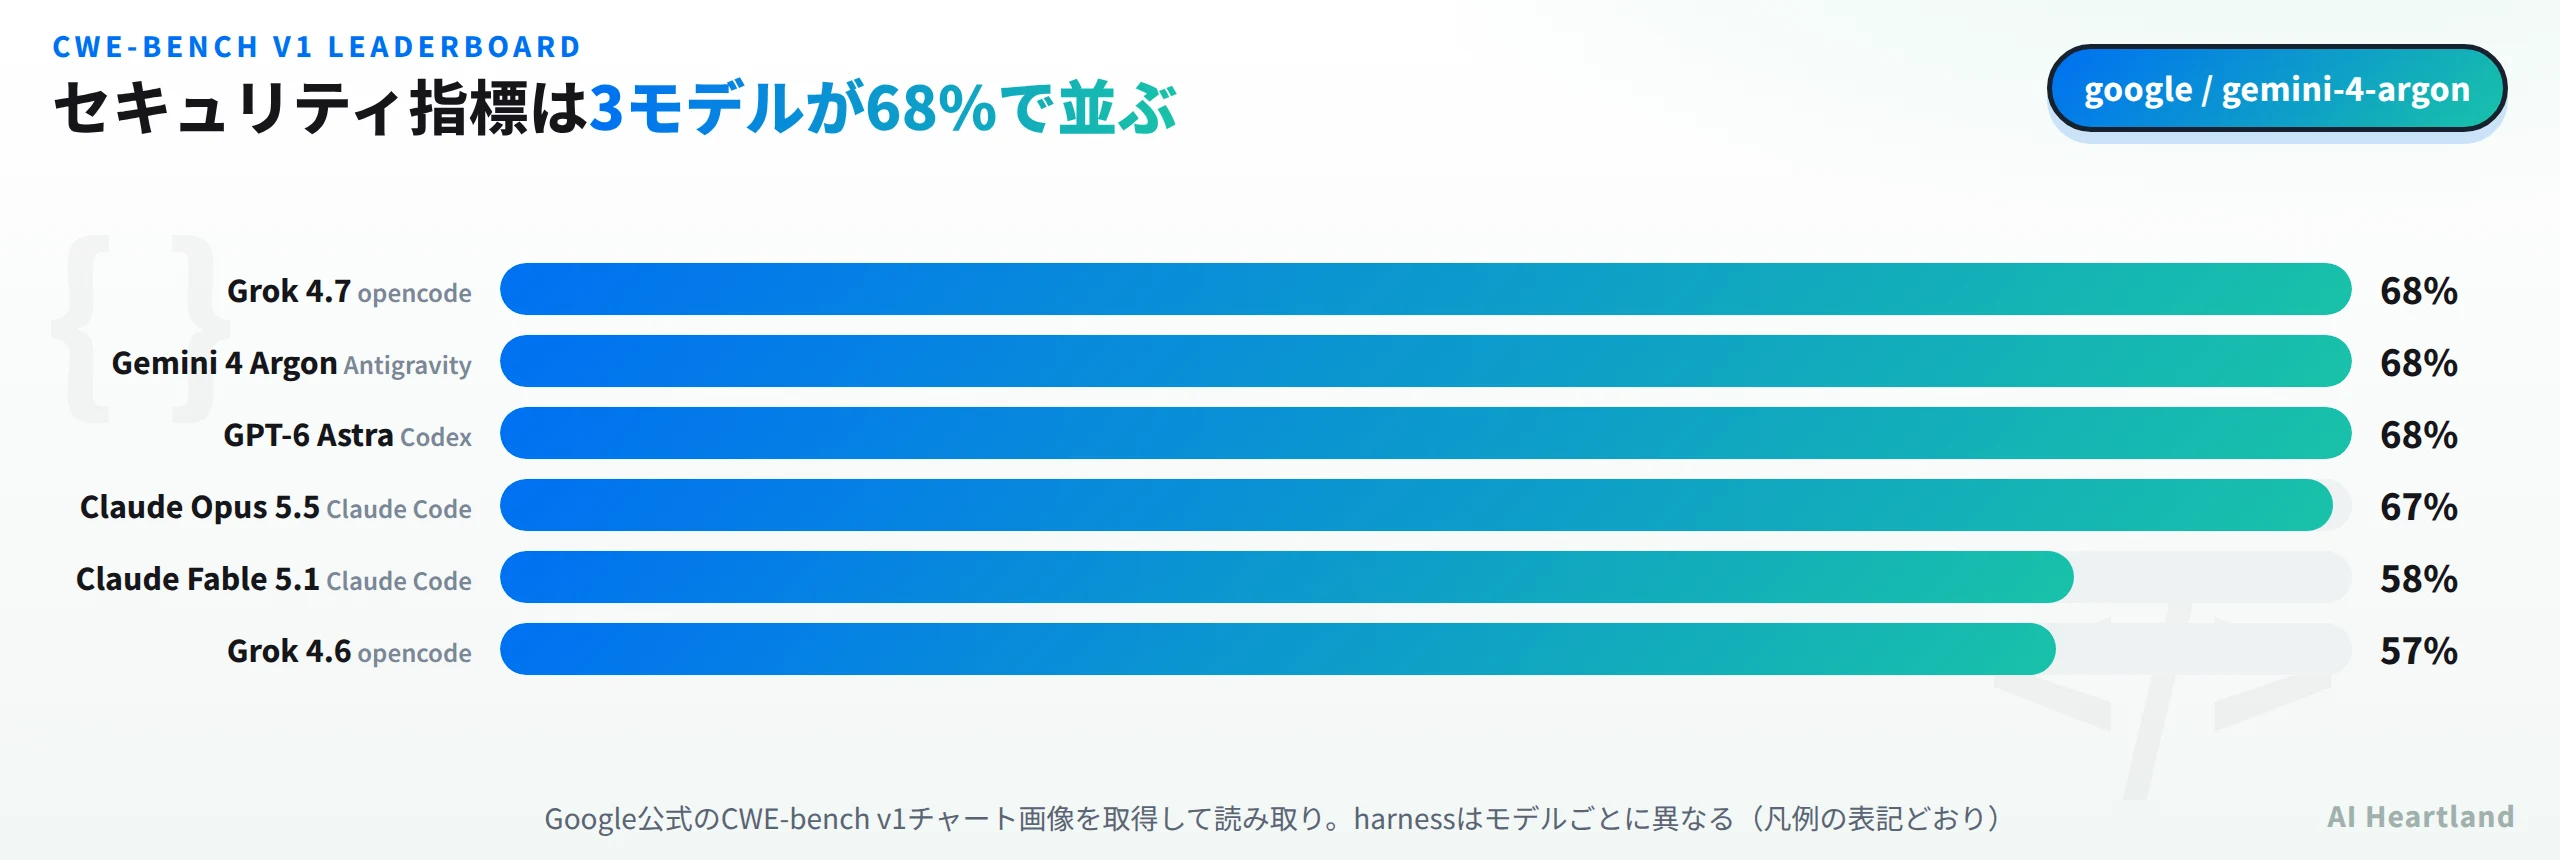
68%に並んでいるのは3モデルだった。Grok 4.7、Gemini 4 Argon、GPT-6 Astra。Argonには首位の印が付いているが、これは図の注記どおり pass@4 でタイブレークした結果であって、pass@1 の値そのものは3つとも同じだ。そして先ほどの比較表には、Grok の列が無かった。
さらに重要なのが、棒の下に書かれた harness 名がモデルごとに違うことだ。Argon は Antigravity、GPT-6 Astra は Codex、Claude 勢は Claude Code、Grok 勢は opencode。つまりこのリーダーボードが測っているのはモデル単体ではなく「モデル+実行環境」の組であり、脆弱性修復というタスクの性質上、ツールの与え方で結果は動く。モデルだけを入れ替えても同じ差が出るとは限らない。
脆弱性の発見側では、比較相手が競合ではなく自社の前世代(Gemini 3.8 Flash Cyber)になっている。社内の網羅的な脆弱性ベンチで 85.8% 対 71.0%、Wiz のブラックボックス侵入テストベンチで 70.9% 対 58.2%。ただし取得した図を見ると、縦軸が0ではなく20から始まっている。棒の高さの印象は実際の差より大きく見えるので、数字のほうで読んだほうがいい。
間接プロンプトインジェクション耐性は Gray Swan IPI で示されていて、k=15回試行時の攻撃成功率が 0.7%(低いほど良い)。同じ図では Claude Opus 5.5 と Claude Fable 5.1 が 1.0%、Gemini 3.8 Flash が 5.5%、GPT-6 Astra が 8.5%、最も高いものは 52.7% だった。上位3社が1%前後に固まっていて、そこから先は桁が違うという分布になっている。
2026-09-30 発表"] --> B{"サイバー用
ガードレール"} B -->|"外す"| C["Fairwind の信頼された防御者
+ Google社内チーム"] B -->|"有効"| D["それ以外の提供先"] D --> E["米国政府の任意の
事前アクセス評価"] E --> F["有料APIユーザー
Google AI Ultra 加入者"] F --> G["開発者・企業・一般"] C --> H["Wiz Scan for Good
医療ソフトの重大脆弱性を発見"] E -.->|"日付の記載なし"| F F -.->|"日付の記載なし"| G
「今日は呼べない」を公式SDKで確かめる
発表文の「できるだけ早く」がどれくらいの距離なのかは、公式の実装側を見ると輪郭が出る。モデルIDが配られていれば、SDKやCLIに文字列が入るからだ。そこで公式リポジトリ3本を取得して調べた。
# 公式SDK/CLIの2026-09-30時点のHEADに Gemini 4 系のIDが入っているか数える
for r in googleapis/python-genai googleapis/js-genai google-gemini/gemini-cli; do
  git clone -q --depth 1 https://github.com/$r.git
done
for d in python-genai js-genai gemini-cli; do
  printf '%-14s gemini-4=%s  gemini-3=%s\n' "$d" \
    "$(grep -riIl --exclude-dir=.git -- 'gemini-4' $d | wc -l)" \
    "$(grep -riIl --exclude-dir=.git -- 'gemini-3' $d | wc -l)"
done
# python-genai   gemini-4=1  gemini-3=17
# js-genai       gemini-4=0  gemini-3=19
# gemini-cli     gemini-4=0  gemini-3=84
gemini-3 を陽性対照に置いているのがこの確認の要点だ。現行世代のIDは17/19/84ファイルで見つかるのに、Gemini 4 系は実質0。検索そのものが機能していないわけではない、と示せる。
python-genai の1件は中身を見ると CHANGELOG の1行で、ローカルトークナイザのマップに関する過去の記述だった。マップ本体の google/genai/_local_tokenizer_loader.py を開くと、登録されているのは gemini-2.0 系から gemini-3.5-flash / gemini-3.1-pro-preview までで、gemini-4 で始まる項目は1つも無い。つまり3本とも実質0件だ。
gemini-cli 側はもう少し踏み込める。packages/core/src/config/models.ts に並ぶ定数は gemini-3-pro-preview から gemini-3.8-flash までで、最新の既定は Flash 系だ。さらに同ファイルには世代判定の正規表現が置いてある。
return /^gemini-3(\.|-|$)/.test(resolved)
gemini-4- で始まるIDが来たら、この判定は false を返す。Gemini 3 世代向けの分岐に一切入らない、ということだ。これは「未対応」の強い証拠ではないが、現時点のコードは Gemini 4 の存在を前提にしていないとは言える。逆に言えば、この定数表と正規表現に変更が入った日が、実質的な提供開始の先行指標になる。
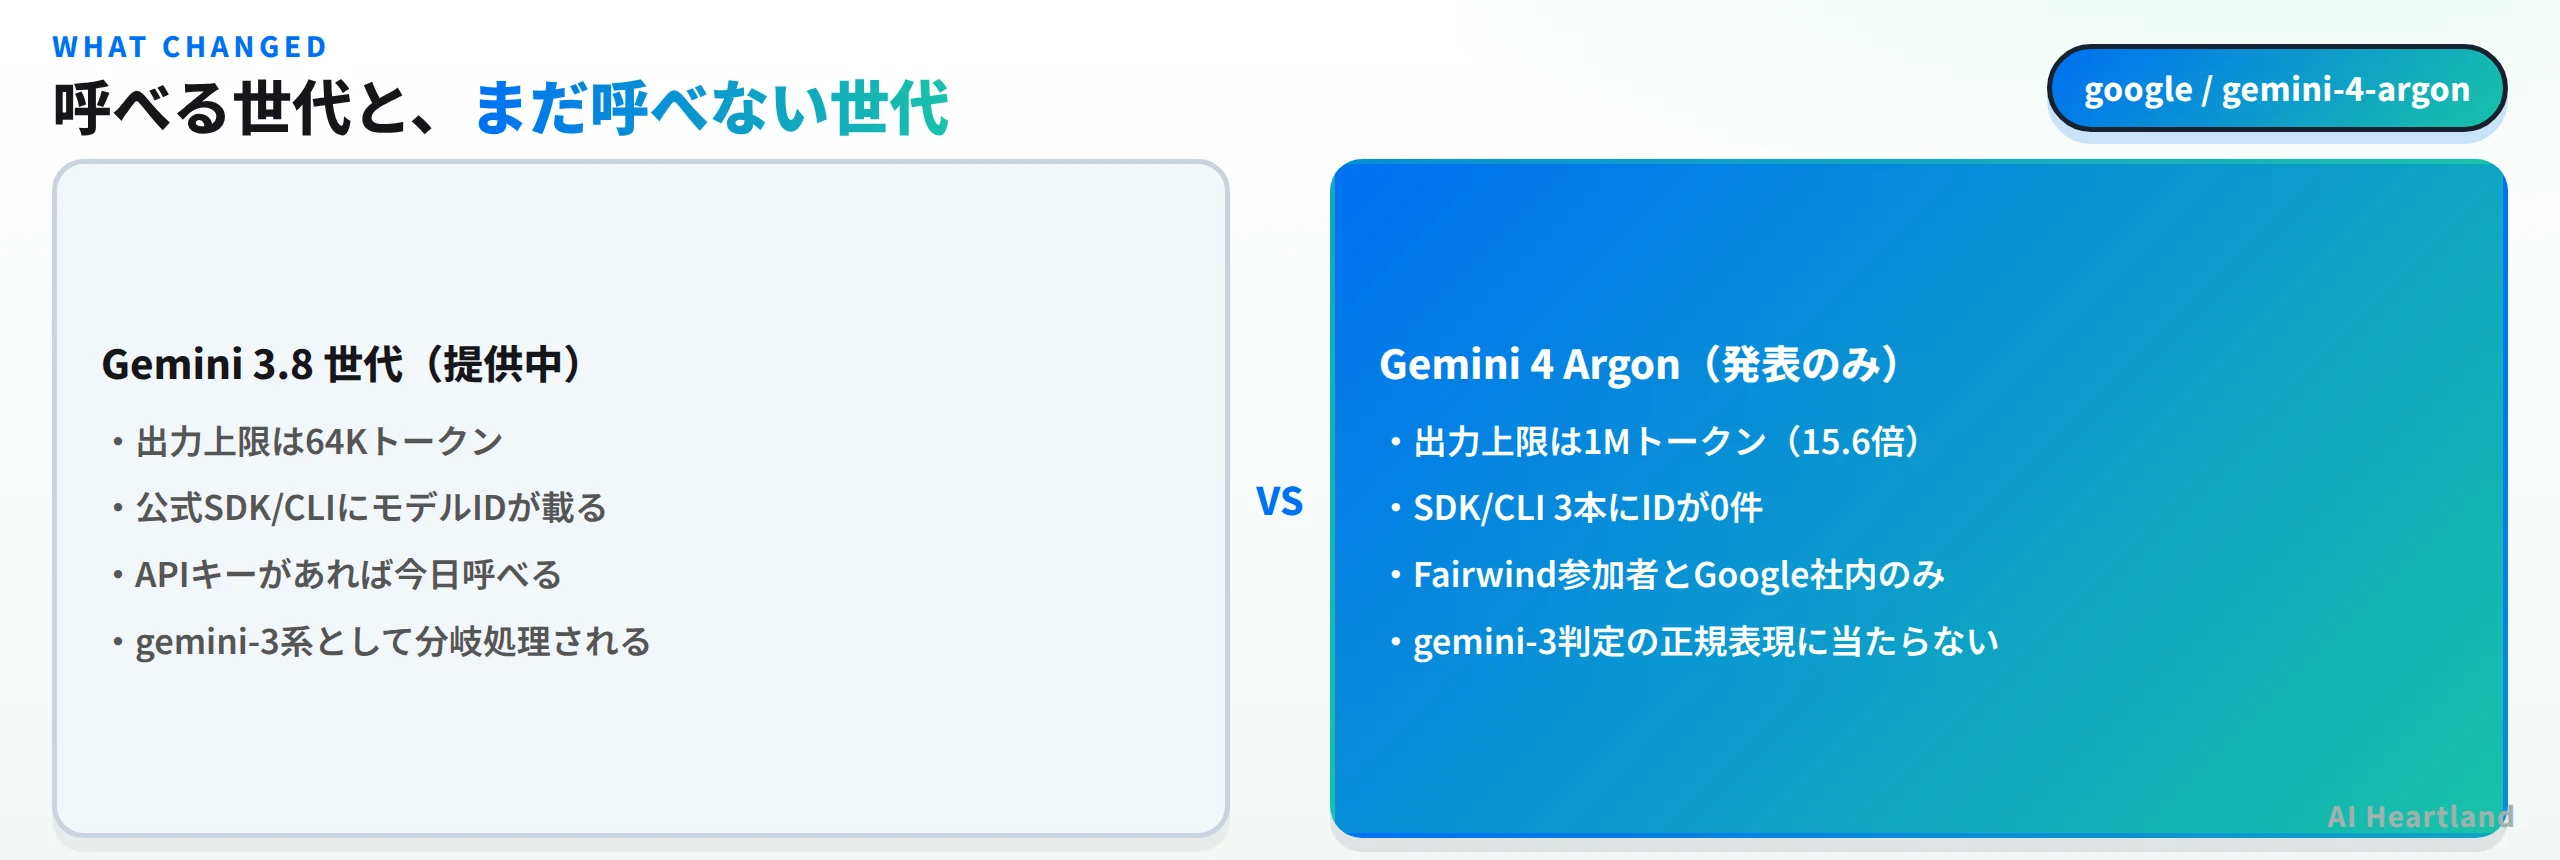
なお、generativelanguage.googleapis.com のモデル一覧をAPIキー無しで叩くと403が返るため、サーバ側の一覧に Argon が載っているかどうかは確認できていない(未検証)。ここで言えるのは「公開されている実装側にIDが無い」までだ。
Gemini 4 Argonを待つあいだ、何を使うか
ここまでを踏まえると、いま取るべき行動は3つに分かれる。
1. Fairwind の対象なら、条件を確かめて申し込む。 サイバー防御の実務組織で、かつガードレール無しのモデルを扱う体制(ログ、承認、隔離環境)が既にあるなら、1段目に入る資格を検討する価値がある。逆に体制が無い状態で「外れているモデル」を受け取るのは、リスクだけが先に来る。
2. それ以外は、発表を設計の前提に入れない。 3段目に日付が無い以上、Argon を織り込んだロードマップは日付を持てない。出力上限1Mを前提にした設計は、上限が64Kのモデルでは動かない。今日動くモデルで組み、上限だけ設定値で外に出しておくのが安全だ。
3. 「発表と提供のあいだ」を測る習慣を持つ。 今回やったのは、公式SDKに文字列があるかを数えるだけの確認だ。数分で終わるのに、「使えるかどうか」の答えが出る。同じ手は他社の発表にも効く。当サイトではDecisions APIとは|Jevの対抗馬と同名OSS実装の差をスキーマ15ケースで実測でも同じ構図に当たっていて、あちらは「発表はされたが契約が未公開で、正直な実装者は待つしかない」という状態だった。Argonは価格まで公開されている分、一歩進んでいる——ただし呼べないという一点では同じ場所にいる。
オープンウェイト側で同等クラスを自前に置きたい場合は、Kimi K2.6とは|Moonshot AIの1兆パラメータ・オープンLLMを使い方まで解説のような選択肢が比較対象になる。提供条件で待たされないことそれ自体が、要件になる場面はある。
最後に、この記事で書いた数字がどこまで検証済みかを整理しておく。
| 項目 | 確認方法 | 状態 |
|---|---|---|
| 提供の4段階・ガードレール無し提供 | 発表本文(HTMLミラー経由で読了) | 本文どおり・原典は未閲覧 |
| 出力上限 64K→1M・価格 2ドル/10ドル | 同上 | 本文どおり・実際の課金は未検証 |
| ベンチ19行の値と勝敗 | Google配信CDNの画像を取得し塗り分けを機械判定 | 実測 |
| CWE-bench v1 の3モデル同点・harness差 | 同上(リーダーボード画像) | 実測 |
| 公式SDK/CLIにモデルIDが無い | 3リポジトリをcloneしてgrep(陽性対照あり) | 実測 |
| サーバ側のモデル一覧にArgonがあるか | APIキーが無く403 | 未検証 |
| Wizが見つけた脆弱性の対象・CVE | 発表に記載なし | 未検証 |
「最前線モデルが出た」というニュースの本体は、性能表ではなく誰がいつ触れるかのほうにある。Gemini 4 Argon はその点で、価格まで出しておきながら提供日を1つも書かなかった。数字を追いかける前に、まずそこを見ておきたい。
参照ソース
・Gemini 4 Argon 公式発表(Google・2026-09-30公開): https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
・公式ベンチマーク表の画像(Google配信CDN・本記事で取得して読み取り): https://storage.googleapis.com/gweb-uniblog-publish-prod/original_images/gemini-4-argon_table_blog.gif
・CWE-bench v1 リーダーボードの画像(同上): https://storage.googleapis.com/gweb-uniblog-publish-prod/images/gemini_4_cyber_evals_cwe_bench.width-2000.format-webp.webp
・googleapis/python-genai(公式Python SDK・2026-09-30時点HEADを取得): https://github.com/googleapis/python-genai
・google-gemini/gemini-cli(公式CLI・同上): https://github.com/google-gemini/gemini-cli