Edge0 は、大きな MoE(mixture-of-experts)のモデルを手元の機材で動かすためのオープンソースの推論フレームワークだ。 2026年11月13日に、1450億パラメータの Edge0 145B と、1200億パラメータの Edge0 120B を公開した。仕組みの要は、1トークンを処理するときに使う「専門家(エキスパート)」だけを GPU に流し込むことにある。145B のうち、1トークンで実際に動くのは約101億パラメータだけだ。
30秒でわかる Edge0
- ・何か:MoE のモデルを、使う専門家だけ VRAM に置き、残りを RAM や SSD から流して動かす推論エンジン。GitHub のスターは約1.1万(2026年11月15日)
- ・何ができる:145B のモデルを、24GB の GPU 1枚か Apple Silicon の Mac で動かす。OpenAI・Anthropic 互換の API で使える
- ・必要な機材:CUDA 13 の NVIDIA GPU(Linux・Windows)か Apple Silicon。145B の Q3_K 版は重みだけで 40.81 GiB
- ・ライセンス:コードは Apache-2.0。モデルは独自のライセンスで、商用の推論サービスなどには許可が要る
ローカル LLM の全体像と、ツールの選び方は ローカルLLMとは?おすすめモデル・ツールの選び方と必要なPCスペック、無料で動かす方法【2026】 にまとめている。
Edge0 の仕組み:使う専門家だけを GPU に流し込む
WHAT IT REPLACES何が違うか
全部を載せずに、使う専門家だけを GPU に流し込む
ふつうのローカル実行
重みを VRAM と RAM に載せきる
- 145B なら数十 GB の VRAM が要る
- GPU 1枚に収まらない
- 収まらない分は極端に遅くなる
Edge0(edge0-strata)
1トークンで使う専門家だけを動かす
- 145B のうち動くのは約101億
- よく使う専門家を VRAM、残りを RAM や SSD に
- GPU 1枚(24GB)か Apple Silicon で動く
MoE のモデルは、層ごとにたくさんの「専門家」と呼ばれる小さなネットワークを持ち、トークンごとにその一部だけを使う。Edge0 145B は、各層に512の専門家を持ち、1トークンで使うのは10個と、共有の1個だけだ。
Edge0 はこの性質を使い、よく呼ばれる専門家を GPU の VRAM に置き、残りを PC の RAM に、さらに足りなければ SSD に置く。必要になった専門家だけを GPU に送るので、費用はモデル全体の大きさではなく、VRAM に置いている専門家の数で決まる、と公式の資料は説明している。
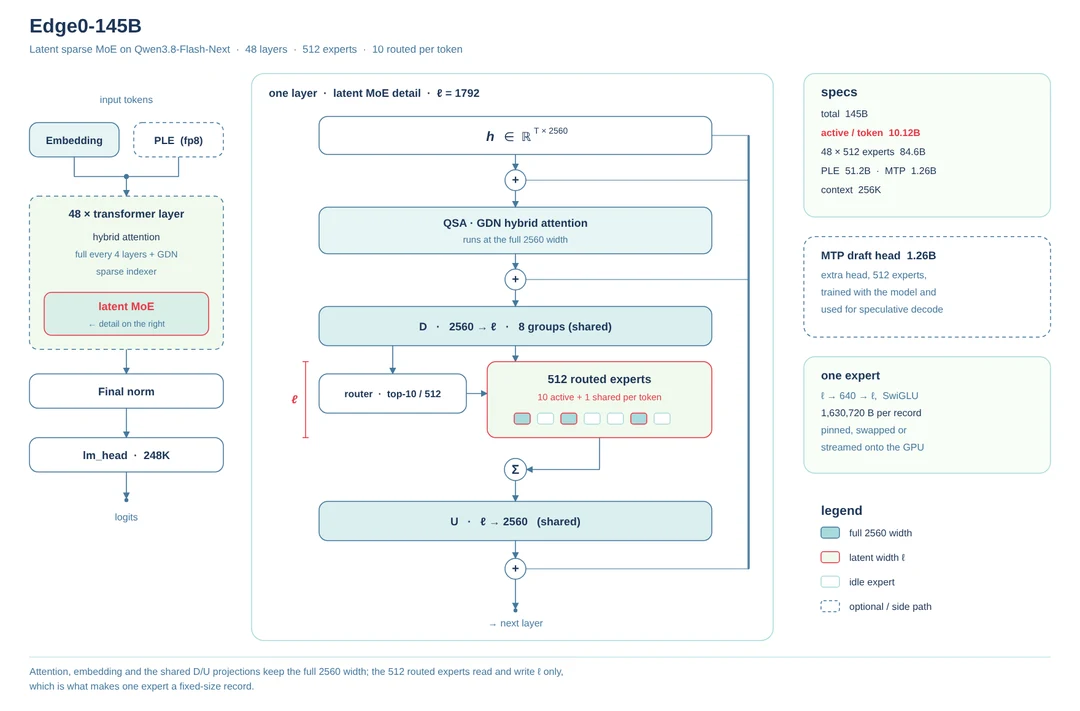
145B は、Qwen3.8-Flash-Next をもとに作られ、4ビットで学習されている。専門家への入力を 2560 次元から 1792 次元に圧縮する「latent MoE」という構造で、専門家1つあたりの大きさを小さくしている。動かすエンジン(edge0-strata)は、Strata という OSS をもとにしたものだ。
| 項目 | Edge0 145B | Edge0 120B |
|---|---|---|
| 総パラメータ | 145B | 120B |
| 1トークンで動くパラメータ | 10.12B | 8.64B |
| 専門家 | 各層512(10個+共有1個を使う) | 同じ |
| コンテキスト | 256K | 256K |
| 重みのサイズ(Q3_K) | 40.81 GiB | 27.98 GiB |
| 重みのサイズ(NVFP4) | 47.79 GiB | 32.96 GiB |
Edge0 145B に必要な機材とメモリ
話題になった「ノートパソコンのメモリ29GBで145Bが動く」という説明は、公式の資料からは確かめられなかった。公式の対応環境と、公表されている計測の構成は次のとおりだ。
| 環境 | 145B・120B への対応 |
|---|---|
| Linux・Windows | CUDA 13 の NVIDIA GPU |
| macOS | Apple Silicon(Metal)。Q3_K 版だけ |
| iOS・Android | 対象外(以前の 35B は対応) |
公表されている計測のうち、最も小さい構成は「VRAM 16GiB・RAM 20GiB」だ。これは RTX 5090 D 24GB を cgroup で制限して測ったもので、別の GPU ではない。メモリを減らす設定として、RAM に置く専門家の上限を決める --resident-budget-gib と、置ききれない専門家を SSD から読む --mmap-experts がある。
VENDOR BENCHMARKEdge0 の公称値
145B(Q3_K)は RTX 5090 D で毎秒121トークン
速さはすべて Edge0 自身の計測だ。品質の比較表では、145B が SWE 系やターミナル操作の評価で元の Qwen3.8-Flash-Next を上回るとしているが、これも当サイトでは確かめていない。
Edge0 を動かす手順
公式の手順では、エンジン(edge0-strata)と、起動用の edge0-infer を自分でビルドする。Windows と macOS には、モデルのフォルダを選ぶだけで使えるデスクトップアプリ(Edge0 Chat)も GitHub Releases にある。
git clone https://github.com/Edge0-AI/Edge0.git edge0
ビルドしたあと、edge0-infer/ で、ダウンロードしたモデルのフォルダを指定して起動する。OpenAI と Anthropic の形式の API が 127.0.0.1:8000 で開く。
build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-q3k
起動したら、OpenAI 形式のエンドポイントに送って確かめる(公式の README の例)。
curl localhost:8000/v1/chat/completions -H 'content-type: application/json' -d '{"model":"edge0_145b","messages":[{"role":"user","content":"hi"}],"max_tokens":64}'
本記事で確かめたのは、リポジトリの取得と、資料・ライセンスの中身までだ。ビルド、起動、API の応答、速度は未検証で、上の起動とリクエストのコマンドは公式の README のものをそのまま載せている。
既存のツールとの違いは次のとおりだ。
| Edge0 | Ollama・LM Studio | llama.cpp | |
|---|---|---|---|
| 得意なこと | 大きな MoE を小さな VRAM で | 手軽に色々なモデルを動かす | 細かく調整して動かす |
| 対応モデル | Edge0 用のモデルだけ | 多数 | 多数(GGUF) |
| 載せきれない分 | 専門家を RAM・SSD から流す | CPU・RAM に回す(遅くなる) | 層ごとに CPU に回す |
| ツールのライセンス | コード Apache-2.0(モデルは独自) | Ollama は MIT、LM Studio は無料の独自アプリ | MIT |
手軽さを優先するなら Ollamaとllama.cppの違い2026|ローカルLLMはどちらで動かすべきか徹底比較 や LM Studioとは?使い方をインストールから解説|モデル選び・lms・API・MCP・Ollamaとの違い の道具のほうが向いている。
Edge0 のライセンス:コードとモデルで違う
LICENSE使える範囲
オープンなのはコード。モデルには商用の制限がある
対象
条件
対象: フレームワークのコード
条件: Apache-2.0(自由に使える)
対象: モデル:個人・研究・社内利用
条件: Edge0 Community Model License で可
対象: モデル:生成物の商用利用
条件: 可
対象: モデル:推論サービス・有料配布・商用のコーディング支援
条件: Edge0 の書面の許可が必要
対象: 元になった Qwen の部分
条件: Qwen のライセンスにも従う
「オープンソース公開」と紹介されることが多いが、Apache-2.0 なのはフレームワークのコードだけだ。モデルの重みには Edge0 Community Model License 1.0 が付き、次の用途には Edge0 の書面の許可が要る。
・モデルの販売・有料配布:アダプタや差分、モデルを主な価値とする商用の組み合わせを含む
・商用のモデルサービス:料金・購読・広告などで成り立つ推論や微調整の提供
・独立した商用のコーディング支援・事務支援の製品:サーバーで動かすか利用者の端末で動かすかを問わない
元になった Qwen の部分には、Qwen Community License 1.0 も別に適用される。社内で試すだけなら問題は少ないが、製品に組み込むなら、ライセンス本文で条件を確かめてから使う。
参照ソース
・Edge0-AI/Edge0(GitHub)
・Edge0 145B and Edge0 120B(docs/models/edge0-145b.md)
・Edge0 Community Model License 1.0(GitHub)
・The Other Half of the Memory Wall: Serving 35B MoEs from SSD with Trained Routing Prediction(arXiv 2609.18063)