Postgres 自然言語クエリの実装はいくつもあるが、pg-jev は置き場所が変わっている。SQLを生成するのではなく、WHERE句の述語そのものを自然言語で書く。
SELECT * FROM people WHERE jev(people, 'the person is a pilot');
各行が TypeSafe の Jev(型つき確率を返す System One モデル)で1件ずつ判定される。インデックスも埋め込みも使わない。⭐617、ライセンスは PostgreSQL License、実体は plpython3u で書かれた566行のSQLで、C拡張ではない素の PostgreSQL 拡張である。
この構えだと行数がそのまま課金になる。だから読む側が本当に知りたいのは「何行がAPIに届くのか」で、READMEもそこに答えている。本記事はその答えをモックAPIを立てて外から数え直した記録である。
・同梱のモックAPIのおかげで**APIキー0本で実走**でき、回帰テスト4本も通った
・READMEの「2,000行=100リクエスト」「2回目は無料」「LIMITで止まる」は**そのまま再現**できた
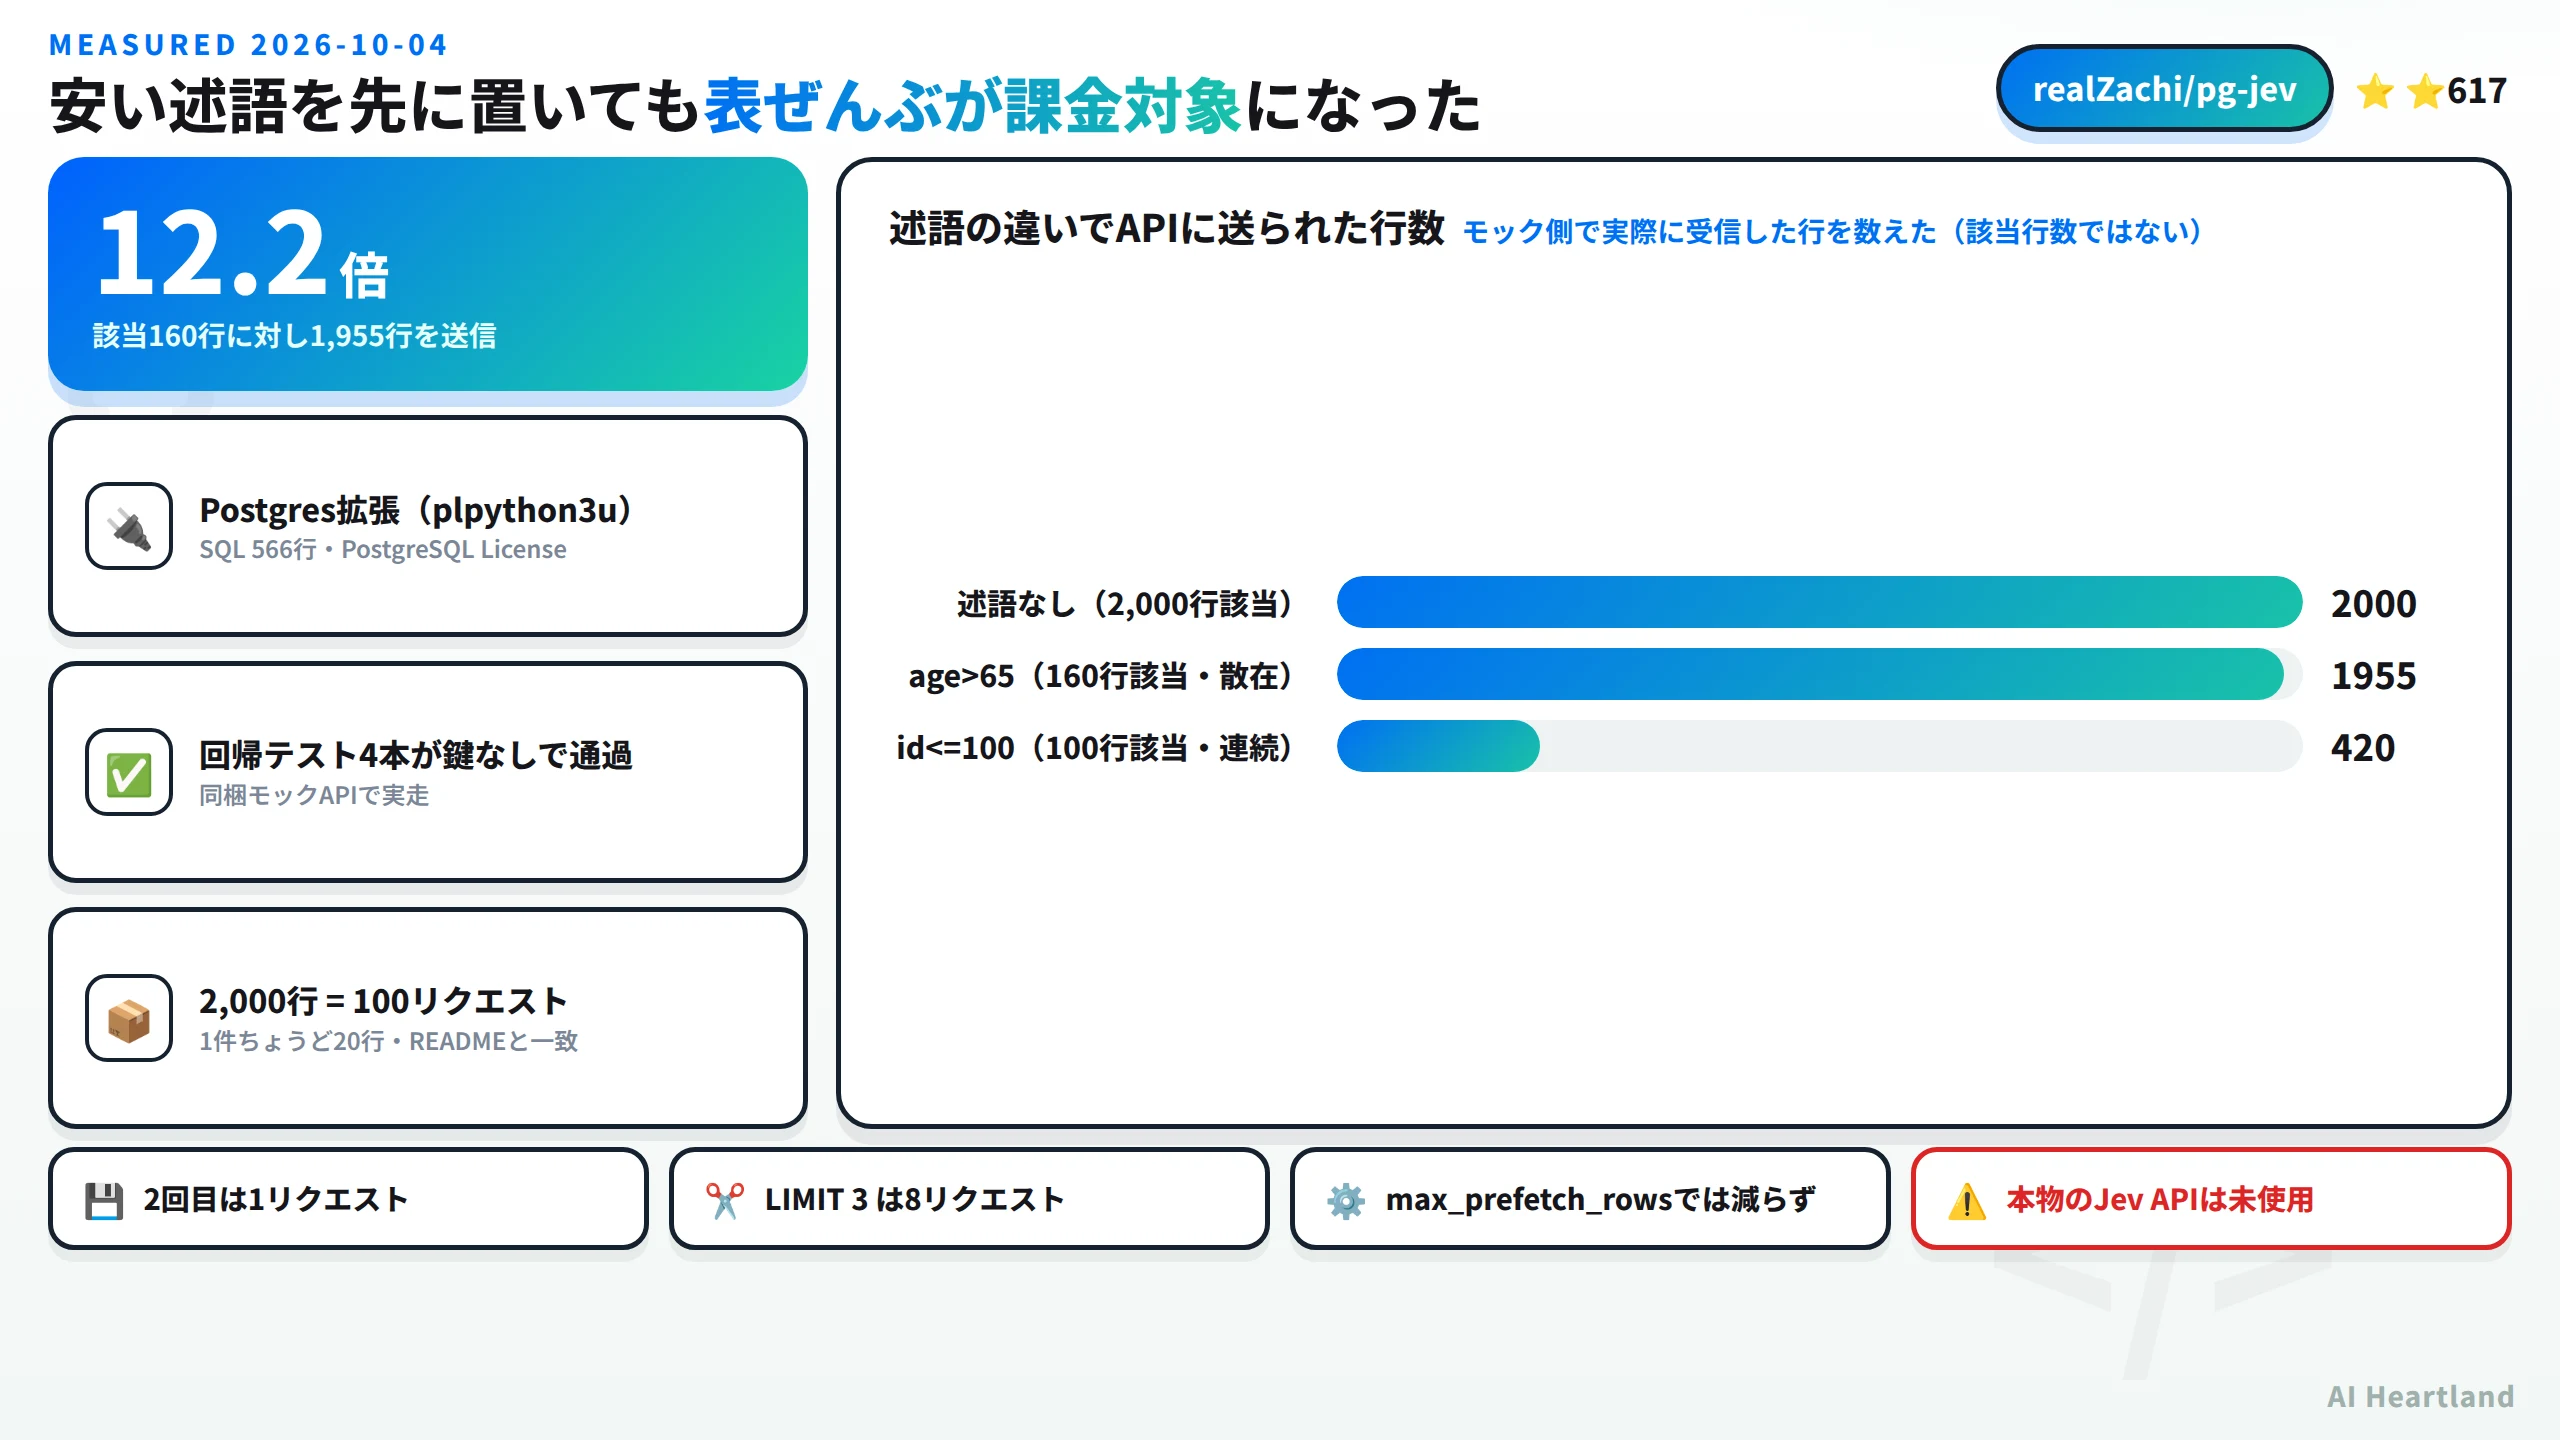
・ただし「安い述語で弾かれた行は判定されない」は再現できず、**該当160行に対し1,955行**が送信された
- ・WHERE句に自然言語の述語を書けるPostgres拡張。**PostgreSQL License**・⭐617・v0.2.1
- ・実体は **plpython3u の566行SQL**。C拡張ではないのでビルド不要
- ・既定の**バッチサイズ**は **20行**・16並列・先読み上限5,000行
- ・2,000行の判定は **100リクエスト**(1件ちょうど20行)で実測一致
- ・**キャッシュはバックエンドセッション単位**。接続が変われば消える
- ・**述語で絞っても送信行数は選択率どおりには減らない**(4.2〜12.2倍)
Jev そのものの位置づけはLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版の系譜にあるが、より近いのはOpenJevとは|Jev互換のSystem One決定サーバを自前GPUで動かすOSSをソースで実測で扱った互換サーバ路線だ。pg-jev はその判定器をデータベースの述語に埋めるという応用になる。
Postgres 自然言語クエリをAPIキー0本で動かす
このリポジトリの親切な点は、Jev互換のモックAPIが test/mock_api.py として同梱されていることだ。test/run.sh は冒頭で unset TYPESAFE_API_KEY してからモックを立ち上げ、一時クラスタに対して回帰テストを回す。
PostgreSQL 16 の環境に plpython3u を入れて、そのまま実行した。
apt-get install -y postgresql-plpython3-16
make install
bash test/run.sh
ok 1         - 01_basic                                  588 ms
ok 2         - 02_errors                                 199 ms
ok 3         - 03_streaming                             7826 ms
ok 4         - 04_local                                  282 ms
# All 4 tests passed.
jev: all regression tests passed
鍵なしで4本とも通る。ビルドが要らないのは plpython3u 拡張だからで、make install がやるのは SQL ファイルを extension ディレクトリに置くだけだった。
ここからは測定のために、モックを受信した行をすべて記録する版に差し替えた。応答のロジックは同梱モックと同じ(条件の最終語が行のJSONに含まれれば noul 0.9、なければ 0.1)で、リクエスト数と行の中身だけを追記していく。
with lock:
    with open(LOG, "a") as f:
        for r in rows: f.write(json.dumps(r, sort_keys=True) + "\n")
なお最初に書いたモックは単一スレッドの HTTPServer で、RemoteDisconnected を連発して動かなかった。pg-jev は永続HTTPS接続を16並列で使うので、ThreadingHTTPServer にする必要がある。これ自体が並列度の裏づけになっている。
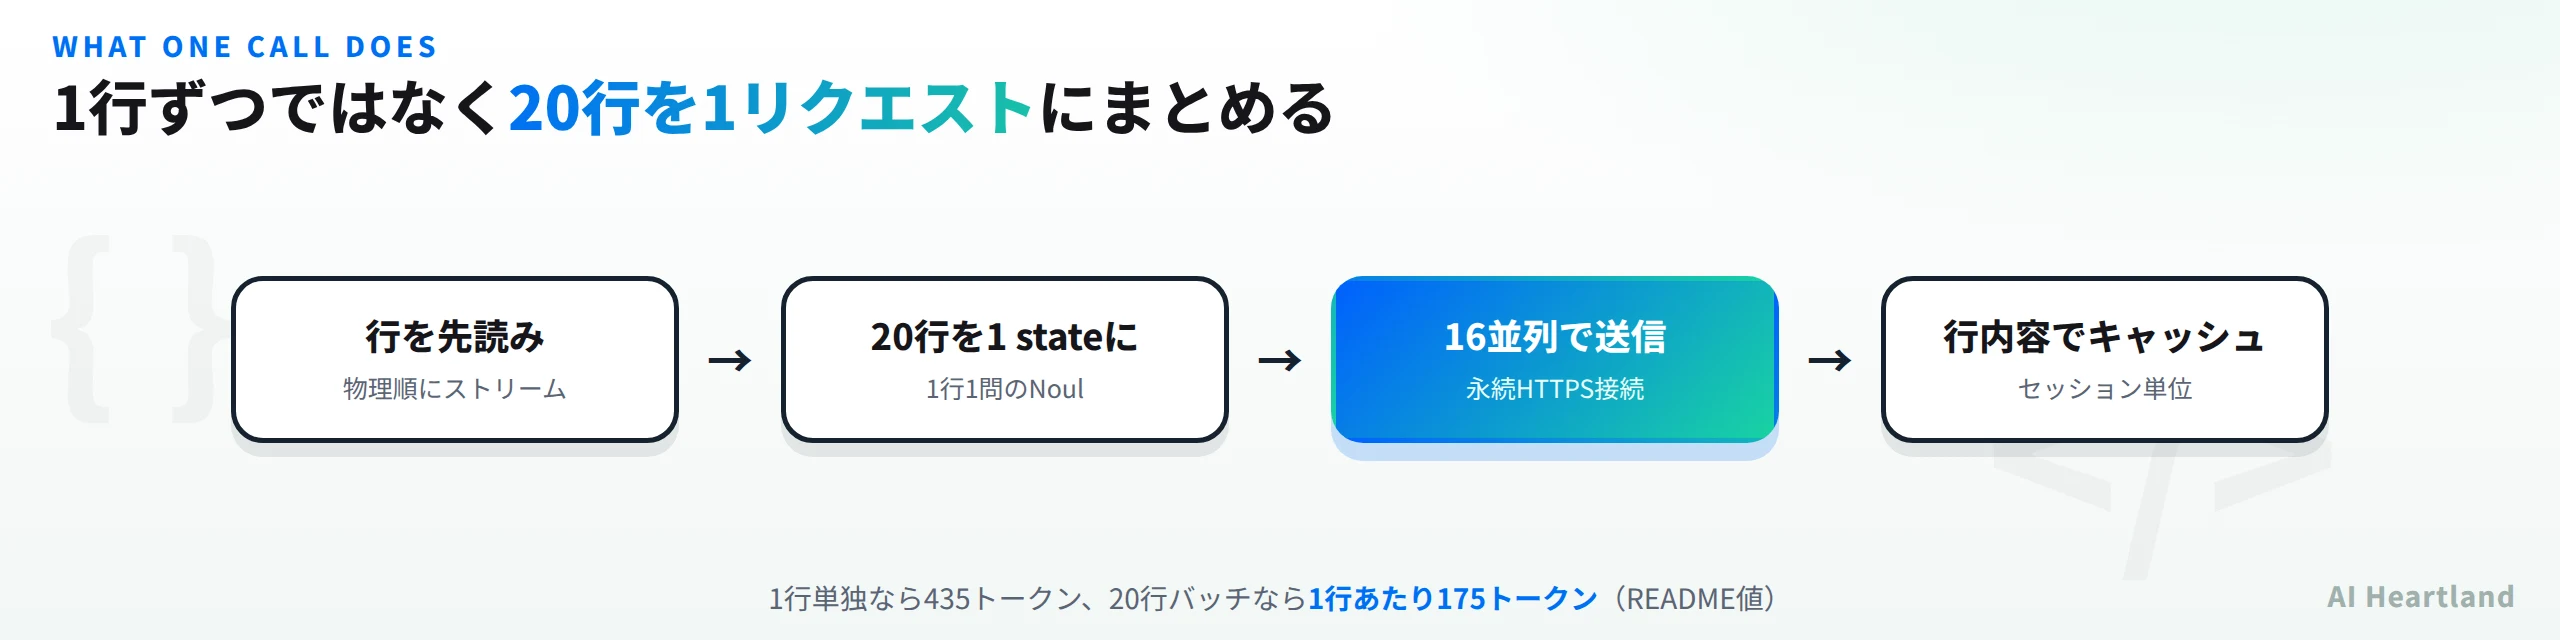
2,000行で100リクエスト:READMEの数字はそのまま出た
2,000行のテーブルを作って、述語なしで全件判定させた。
CREATE TABLE people AS
  SELECT g AS id,
         (ARRAY['engineer','teacher','nurse','pilot'])[1+g%4] AS job,
         20 + (g % 50) AS age
  FROM generate_series(1,2000) g;

SELECT count(*) FROM people WHERE jev(people, 'the person is a pilot');
拡張自身がこう報告した。
NOTICE:  jev: noul → judged 2000 rows of people in 100 requests,
         80723 input tokens (≈$0.0034), 300 ms
 matched
---------
     500
そしてモック側で数えた結果がこうだ。
リクエスト数: 100 / 延べ行数: 2000 / 最大 20行 最小 20行
  20行: 100件
完全に一致した。100リクエスト、全件ちょうど20行、合計2,000行。2,000 ÷ 20 = 100 で端数も出ない。該当した500行も 2000 ÷ 4 = 500(pilotは4職種の1つ)で正しい。拡張が自分で出す統計と、外から数えた実測がずれていないことがまず確認できた。
この「自己申告と外部計測が一致する」という確認は地味だが外せない。以降の節では拡張が出す NOTICE ではなくモック側の受信記録だけを根拠にするが、両者が一致することを先に確かめておかないと、どちらを信じるかの判断がつかなくなる。
なお、このとき報告された入力トークン数(80,723)は README の例(2,000行で約296k)より大幅に少ない。当記事のダミー行が id / job / age の3カラムしかなく、1行が短いためだ。トークン数は行の幅に比例するので、README の値と直接比べることはできない。リクエスト数のほうは行の幅に依存しないので、そちらで突き合わせている。
誤りを1つ潰した:モックが単一スレッドだと測れない
ここは実験の落とし穴として書き残しておく。最初に用意した計測モックは標準の HTTPServer(単一スレッド)だったが、クエリを流すと拡張がこう落ちた。
ERROR:  plpy.Error: jev: TypeSafe API unreachable after retries:
        RemoteDisconnected: Remote end closed connection without response
「APIに到達できない」というメッセージなので、最初はURLかポートを疑った。実際の原因はこちら側が並列に捌けていなかったことだ。pg-jev は jev.concurrency(既定16)本の永続HTTPS接続を張り、2 × concurrency までリクエストを同時に飛ばす。単一スレッドのサーバは1本目の keep-alive 接続を掴んだまま次を受けられず、残りが切断される。
ThreadingHTTPServer に替えたら一発で通った。つまり「並列16・永続接続」というREADMEの記述が、こちら側の失敗を通じて裏づけられたことになる。エラーメッセージがネットワーク側を指していても、原因が自分の計測装置にあることはある。
「なぜ20行か」が公開されているのは珍しい
READMEに ### Why 20 rows per request という節がある。定数の根拠を書いているOSSは多くない。
Jev has to find
rows[i]by position in the array, and that gets unreliable in long arrays.
構造化カラム(職種、EU加盟の有無、自由記述中のフレーズ)から作った正解データ各400行に対して測った結果として、こうある。
・1〜20行のバッチ:正答率 100 %
・40行:92〜98 %
・80行:77〜94 %
・行が長く(1,000文字)なっても20行なら影響なし
・行に名前を付けて参照する案も試したが改善せず
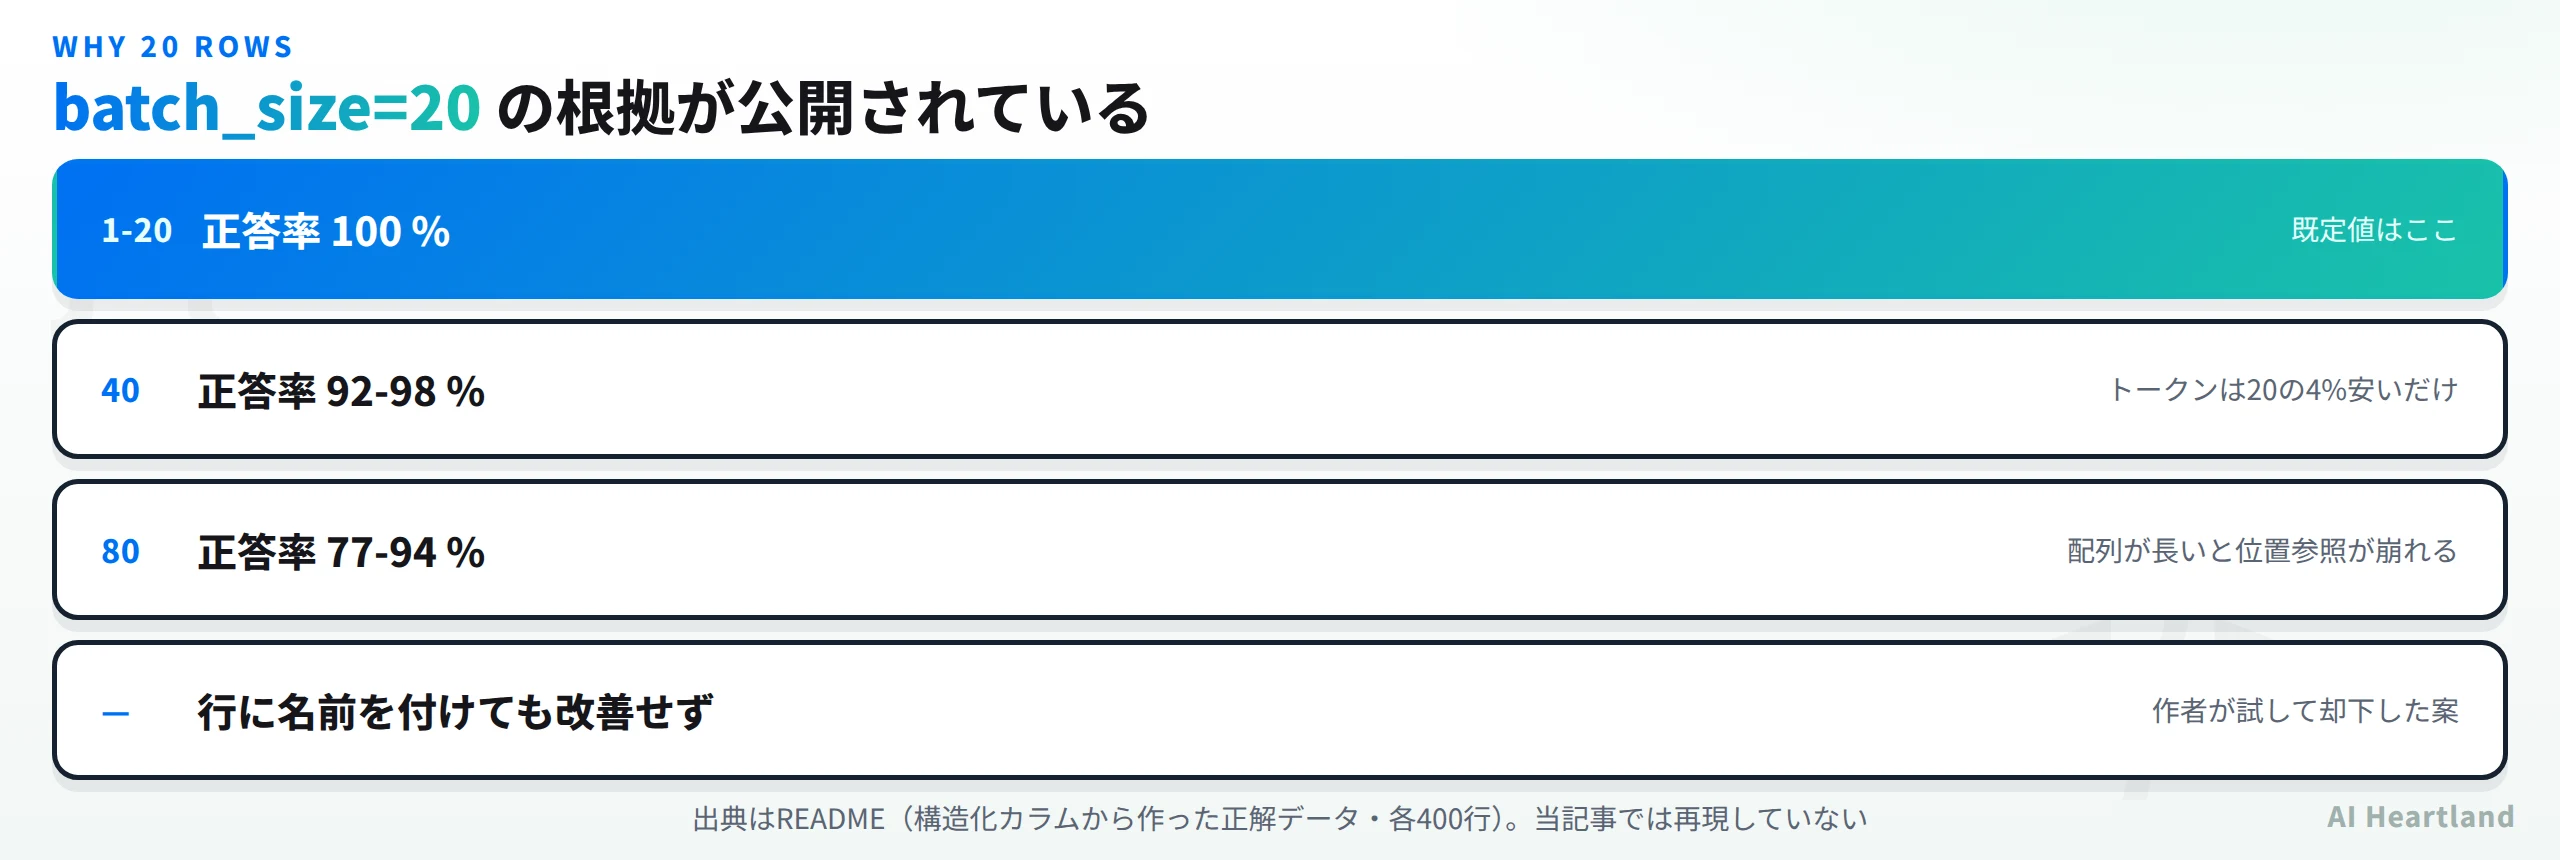
40行にしてもトークンは4%しか減らず、レイテンシもほぼ変わらない。だから精度が落ちる側に倒す理由がない、という判断だ。ソースのコメントにも「accuracy drops measurably above ~20-25 rows」と書かれている。
これは pg-jev 固有の話に見えて、LLMに複数項目をまとめて判定させるとき全般に効く知見だと思う。位置で参照させる設計は、まとめる数を増やすほど静かに壊れる。
判定の型は4つ、設定は13個
jev() だけの拡張ではない。インストール後に pg_proc を引くと、公開関数が8本あった。
SELECT proname, procost, provolatile FROM pg_proc p
JOIN pg_namespace n ON n.oid = p.pronamespace
WHERE proname LIKE 'jev%' AND n.nspname = 'public';
| 関数 | 返すもの | 揮発性 |
|---|---|---|
jev(rec, query, threshold) |
真偽(確率を閾値で切る) | stable |
jev_prob(rec, query) |
確率そのもの | stable |
jev_score(rec, query, levels) |
順序尺度のスコア | stable |
jev_score_norm(rec, query, levels) |
正規化したスコア | stable |
jev_choice(rec, query, options) |
選択肢から1つ | stable |
jev_confidence(rec, query, kind, options) |
確信度 | stable |
jev_eval(rec, query, kind, options) |
生の判定結果 | stable |
jev_cache_clear() |
キャッシュ破棄 | volatile |
判定系がすべて stable(同一トランザクション内で同じ入力なら同じ結果)で宣言されているのは理にかなっている。volatile だとプランナが最適化を諦めるし、immutable だと嘘になる(モデルの応答は不変ではない)。procost はいずれも100で、これが「安い述語を先に評価する」挙動を支えている。
jev() の真偽だけでなく jev_score や jev_choice があるのは、Jev の3つのプリミティブ(noul / score / choice)をそのままSQLに持ち込んでいるからだ。ORDER BY jev_prob(t, 'how urgent is this ticket') DESC のような書き方ができる。この3プリミティブの意味づけはDecisions APIとは|Jevの対抗馬と同名OSS実装の差をスキーマ15ケースで実測で整理したものと同じで、pg-jev はそれをSQLの式に写しているだけだと分かる。
実際に書くとこうなる。真偽で絞る、確率で並べる、選択肢に振り分ける、の3通りが素直だ。
-- 絞る(閾値は第3引数か jev.threshold)
SELECT * FROM tickets WHERE jev(tickets, 'the customer is angry', 0.7);

-- 並べる(確率をそのまま ORDER BY に使う)
SELECT id, jev_prob(tickets, 'this needs a refund') AS p
FROM tickets ORDER BY p DESC LIMIT 20;

-- 振り分ける(選択肢から1つ)
SELECT id, jev_choice(tickets, 'which team should own this',
                      ARRAY['billing','shipping','technical']) AS team
FROM tickets;
SQLとして自然に合成できるのが、この置き方の利点になっている。確率が普通のカラム式なので ORDER BY にも GROUP BY にも乗るし、前述のとおり同じセッションなら閾値を変えても再課金されないので、0.5 → 0.7 → 0.8 と動かしながら当たりを探す使い方が現実的だ。
設定は jev. 名前空間に13個あった。ソースから既定値を読むとこうなっている。
・jev.batch_size 既定 20(「~20-25行を超えると精度が測定可能なほど落ちる」とコメントあり)
・jev.concurrency 既定 16(並列リクエスト数)
・jev.max_prefetch_rows 既定 5000(先読みが1行を探す範囲)
・ほかに threshold timeout keepalive api_key api_url model notices max_rows_per_statement max_chars_per_statement get
末尾2つの max_rows_per_statement / max_chars_per_statement は暴走防止の安全弁だ。自然言語の述語は書き間違えると巨大なテーブル全体を判定しかねないので、この種のガードが最初から入っているのは好ましい。
なお、これらは plpython3u の素のカスタムGUCなので、SET する前は SHOW jev.batch_size が unrecognized configuration parameter で落ちる。既定値はセッションの設定値ではなくSQLコード側に書かれている、という作りだった。
再実行と閾値変更が無料になる
同じセッション内で何回か条件を変えて、モックへのリクエスト数をステップごとに数えた。
| 実行 | リクエスト数 | 何が起きたか |
|---|---|---|
| (1) 1回目 | 101 | 2,000行を判定 |
| (2) 同じ条件を再実行 | 1 | キャッシュヒット |
(3) threshold を変えて再実行 |
1 | 確率は保持済み、閾値だけ再適用 |
(4) 新しい条件 + LIMIT 3 |
8 | 先読みが早期に停止 |
READMEの「再実行・閾値変更・確率でのソートは無料」「LIMIT は先読みを止める」はそのまま再現できた。(3) が1リクエストで済むのは実用上大きい。閾値を探りながら何度も叩くのが定石になるので、そこが無料なのは設計が効いている。
ただし注意点を1つ実測した。キャッシュはバックエンドセッション単位である。最初に別々の psql プロセスで (1) と (2) を実行したときはキャッシュに乗らず、2回目も101リクエストかかった。READMEにも “for the backend session” と書いてあるが、接続プールを挟むアプリケーションではヒット率が想定より下がりうるということだ。
安い述語を先に置いても、表ぜんぶが判定された
ここが本記事でいちばん報告したい点だ。READMEにはこうある。
rows that cheaper predicates filter out before
jev()runs (WHERE age > 60 AND jev(...)) are skipped rather than judged
安い述語で弾かれた行は判定されない、と読める。実際に同じ形で試した。
SELECT count(*) FROM people WHERE age > 65 AND jev(people, 'the person is a teacher');
age は 20〜69 の範囲なので age > 65 に該当するのは 160行。結果は40行(160行の4分の1が teacher)で正しい。ところがモックに届いた行を数えると、こうなった。
送られた延べ行数: 1955
ユニークな行数: 1955
age>65 の行: 160 / 送られた全行: 1955  (8.2%)
送られた age の範囲: 20 〜 69
1,955行が送られ、そのうち条件に合うのは160行だけだった。テーブル全体の age 範囲がそのまま届いている。課金対象で言えば12.2倍だ。
原因は実行計画ではなかった。EXPLAIN を見ると述語の順序は正しい。
Filter: ((age > 65) AND (((_jev_eval(...) ->> 'noul'))::double precision >= ...))
jev 関数は procost = 100 で宣言されているので、Postgres は安い age > 65 を先に評価する。判定を呼んでいるのは行ごとの評価ではなく、先読みのほうだ。READMEの説明どおり、最初の jev() 呼び出しが「テーブルを物理順にストリームする read-ahead」を開始し、その過程で読んだ行を20行ずつまとめて判定してしまう。
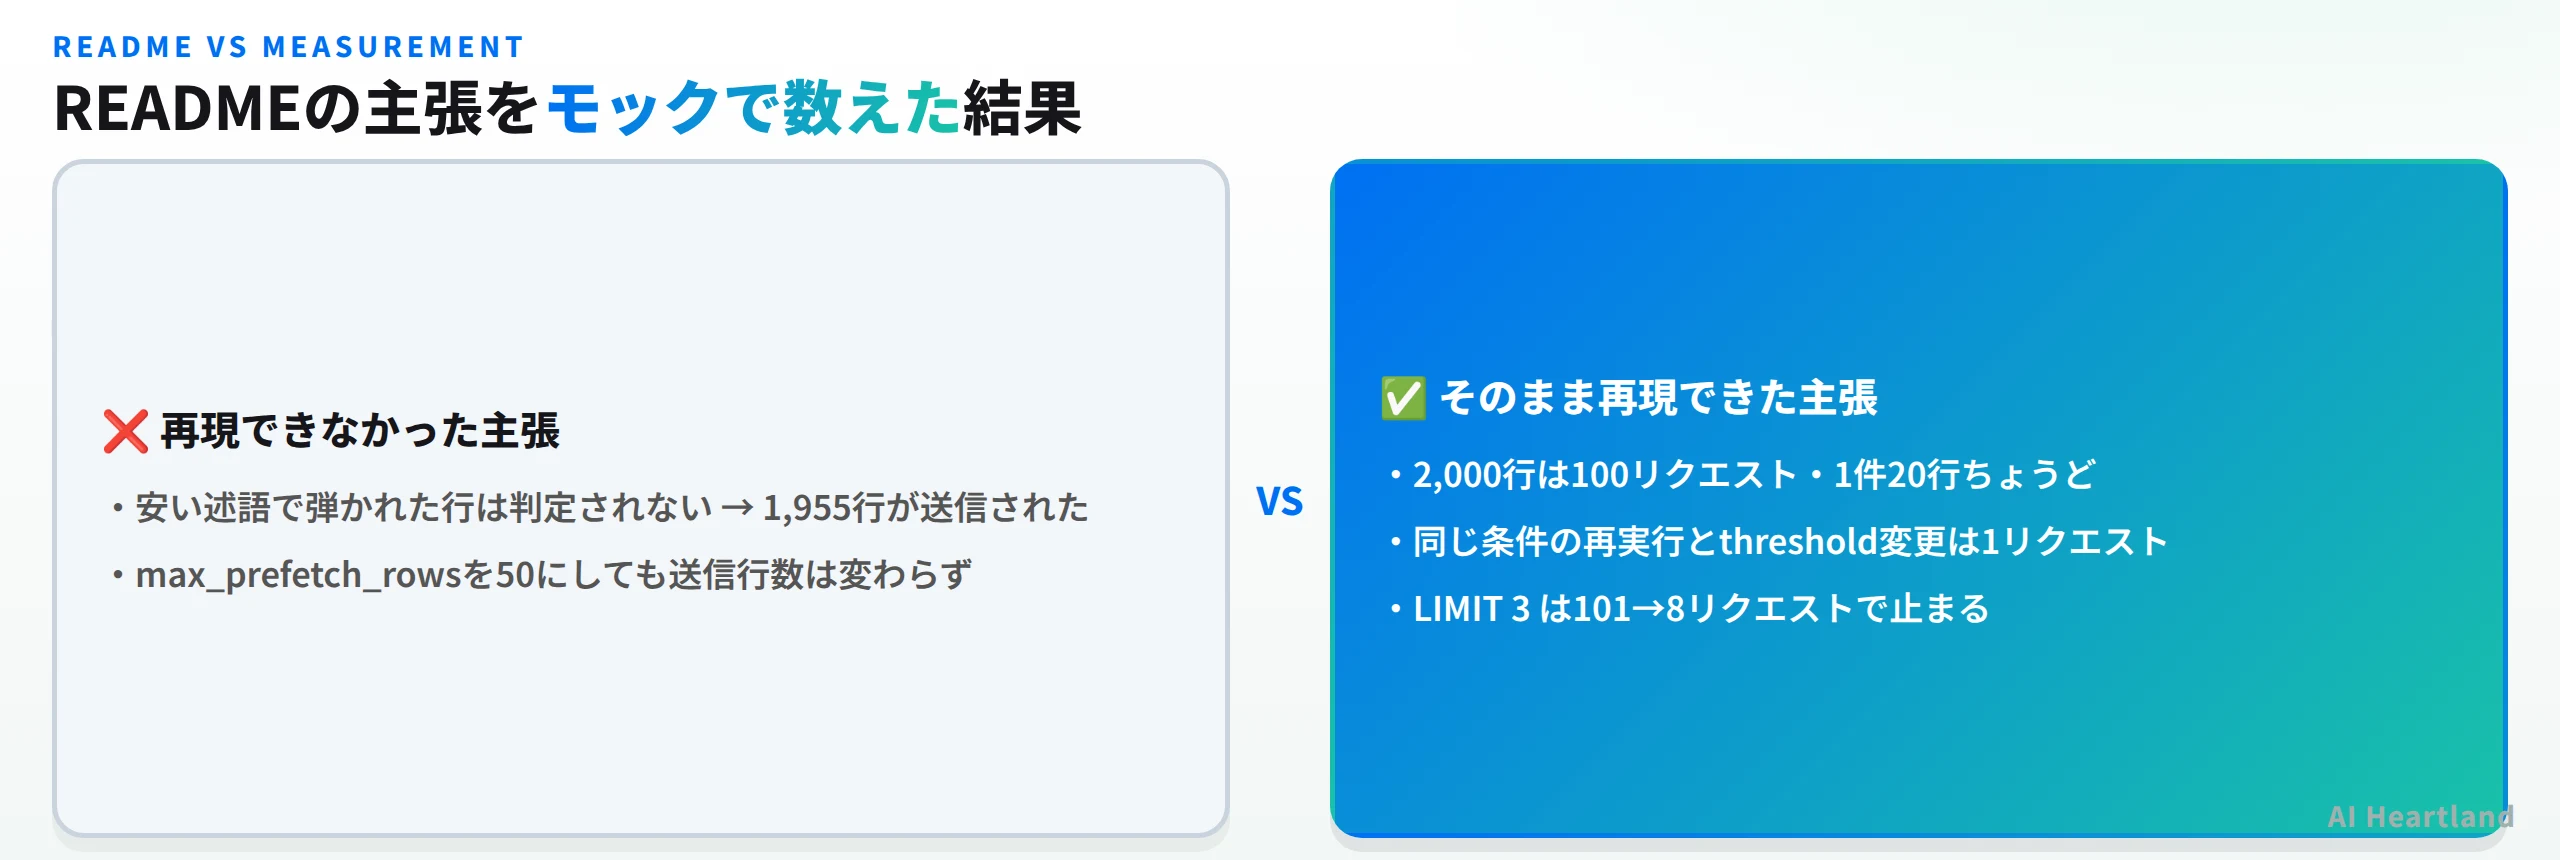
緩和できないか試した。先読みの上限 jev.max_prefetch_rows(既定5,000)を50まで下げても——
max_prefetch_rows=50 のとき → APIに送られた行: 1955 うち age>65: 160
変わらなかった。このGUCはREADMEの説明どおり「1行を探すためにどこまで先を見るか」を制限するもので、累計の判定行数は抑えない。
ただし述語の性質で差は出る。物理順に連続する述語なら overshoot は小さい。
| 述語 | 条件に合う行 | APIに送られた行 | 倍率 |
|---|---|---|---|
| なし | 2,000 | 2,000 | 1.0倍 |
id <= 100(物理的に連続) |
100 | 420 | 4.2倍 |
age > 65(物理的に散在) |
160 | 1,955 | 12.2倍 |
つまり 「安い述語で絞る」は効くが、効き方は述語が物理順に沿っているかで決まる。2,000行なら小さい話だが、実運用のテーブルで散在する条件を使うと、想定の10倍のコストが出る可能性がある。
物理順にテーブルを走査"] F --> G["読んだ行を20行ずつ判定"] G --> H["述語を通らない行も
ここで判定される"] D -.-> H
公平を期すと、これは「READMEが嘘」という話ではない。行ごとの評価経路では確かにスキップされている。スキップされた行を先読みが拾ってしまうという、2つの仕組みの相互作用だ。実装を読めば筋は通っている。ただ採用判断としては、READMEの一文から読み取れる期待と実測が合わないので、ここは測ってから入れたほうがいい。
入れる前に読むべき制約は README が自分で書いている
## Caveats の節が率直なので、そのまま引いておく。採用判断で効くのはここだ。
This is a full scan by design: every row the executor asks about goes to the API.
全件走査が設計だと明言している。インデックスで絞る仕組みは無い。前節で測った overshoot も、この設計の素直な帰結だと分かる。同じ節が「安い述語の reject はスキップされる」とも書いているので、設計意図と実測のズレは先読みの部分に限られると読むのが公平だろう。
Row contents are sent to a third-party API. Do not use it on data you may not share.
行の中身がそのまま第三者APIに送られる。当記事のモック実験でも、届いたリクエストには行のJSONが丸ごと入っていた。顧客データや個人情報の入ったテーブルにそのまま jev() を書くわけにはいかない。READMEは ### Local Jev-compatible servers という節も用意していて、自前の互換サーバに向けられる。この逃げ道があるかどうかは、社内データで使えるかの分かれ目になる。
plpython3uis an untrusted language: only superusers can create the extension, and functions run with the server’s OS privileges.
これが運用上いちばん重い制約だ。plpython3u は untrusted 言語なので、
・拡張を作れるのは superuser だけ
・関数は Postgres サーバのOS権限で動く
・つまり拡張を入れた時点で、その中のPythonはDBサーバ上で任意のことができる
マネージドなPostgres(RDS や Cloud SQL など)は untrusted 言語を許可していないことが多いので、そもそも入らない環境がある。当記事で動かしたのも、自前で initdb した一時クラスタに superuser で入れている。
キャッシュについても正直だ。「jev.max_prefetch_rows はキャッシュを制限しない」「接続プールは各セッションが自分のキャッシュを温める」と書かれており、これは当記事の実測(別プロセスの psql ではキャッシュに乗らなかった、max_prefetch_rows を下げても送信行数が変わらなかった)とそのまま一致した。
インストール手段は4つ用意されている。PGXN、ソース(PGXS)、Docker、そして ### With an AI agent (easiest) ——リポジトリに AGENTS.md(101行)を置き、コーディングエージェントに手順を読ませて入れさせる、という項目が最初に来ている。拡張のインストールは環境差が出やすい作業なので、手順書をエージェント向けに整備するのは理にかなっている。
Postgres 自然言語クエリを入れるかの判断材料
効く場面
・判定基準が頻繁に変わる絞り込み。インデックスも埋め込みも作り直さずに条件文だけ書き換えられる
・閾値を探りながらの分析。2回目以降が1リクエストで済む
・小〜中規模のテーブルに対するアドホックな分類・ランキング
・自前の Jev 互換サーバを立てられる場合。行の中身を外に出さずに済むうえ、課金行数の問題もコストではなく自前GPUの時間に変わる
慎重に見るべき点
・コストは行数に比例し、述語で絞っても選択率どおりには減らない(実測4.2〜12.2倍)
・キャッシュはバックエンドセッション単位。接続プール越しだと効きにくい
・サブクエリやCTE(匿名の record 型)の行は先読みできず1行1リクエストになるとREADMEが明記している。jev() は基底テーブルかビューに置く
・v0.2.1、タグはまだ1本。APIは動きうる
当記事で測っていないこと
・本物の Jev API を一度も叩いていない。精度・レイテンシ・実課金額は当記事の実測値ではない。測ったのはリクエスト数と送信行数という、モデルに依存しない量だけである
・READMEのバッチ精度実験(20行100%、40行92〜98%、80行77〜94%)は再現していない。本物のモデルが要るため
・トークン数はモックが返す擬似値(len(body)//4)なので、実トークンとは一致しない
・v0.1.0 → v0.2.x の高速化(8.5秒→3.5秒)もREADME記載値で未検証
どう測ってから入れるかも書いておく。当記事と同じことは、本番データに触れずに再現できる。
test/mock_api.pyをコピーして、受け取った行をファイルに書く版にする(並列を捌くためThreadingHTTPServerにする)- 本番に近いサイズ・分布のダミーテーブルを作る
jev.api_urlをモックに向け、実際に投げたいクエリを流す- モックが受けた行数を数え、
1行あたりの単価 × 行数で月額を見積もる
ここで見るべきは「該当した行数」ではなく「送られた行数」だ。当記事の例では前者が160行、後者が1,955行で、請求に効くのは後者である。述語を物理順に沿わせられるか(新しい行ほど見たい、ならIDや時刻での絞り込みが効く)が、そのままコストに跳ね返る。
逆に、APIキーがなくてもここまで測れたのは同梱モックのおかげだ。外部APIに依存するOSSがテスト用のモックを配ることの価値が、そのまま読者の検証可能性になっている。
参照ソース
・realZachi/pg-jev(⭐617・PostgreSQL License・v0.2.1、2026-10-04時点)
・pg-jev LICENSE(実体ファイルで PostgreSQL License を確認)
・TypeSafe Jev — Noul プリミティブ(判定に使われる型)
本記事の計測レコードは data/measurements/runs/2026-10-04-pg-jev-postgres.json に登録した。