ggml は、llama.cpp や whisper.cpp の下で計算を受け持つテンソル計算のライブラリで、2026年11月13日に初めての 1.0(v1.0.0)を出した。 ローカル LLM の「いちばん下の層」が 1.0 になったことになるが、中身は速さの話ではなく、古い API を片づける版だ。本記事は、ggml が何に使われているか、1.0 で何が消えて何に置き換えればよいかを、v0.29.0 と v1.0.0 で同じコードをビルドして確かめた結果とともにまとめる。
WHERE IT SITSggml の位置
ローカル LLM のいちばん下の層が 1.0 になった
-
アプリ
Ollama・LM Studio など
-
推論エンジン
llama.cpp・whisper.cpp
-
ggml
テンソル計算のライブラリ(v1.0.0)
-
ハードウェア
CPU・CUDA・Metal・Vulkan・SYCL など
30秒でわかる ggml 1.0
- ・何か:llama.cpp や whisper.cpp を動かしているテンソル計算のライブラリ。MIT、GitHub のスターは約1.58万(2026年11月14日)
- ・1.0 の中身:非推奨の関数13個と古い演算3つを削除。YaRN の丸めの設定、CUDA の FP8 など各バックエンドの改良
- ・対応が要る人:ggml を直接組み込んでいる開発者だけ。Ollama・LM Studio の利用者は何もしなくてよい
- ・注意:RPC の通信方式の版が上がったので、RPC でつないだ機械は全部同じ版に上げる
ローカル LLM の道具の選び方の全体は ローカルLLMとは?おすすめモデル・ツールの選び方と必要なPCスペック、無料で動かす方法【2026】 にまとめている。
ggml とは:llama.cpp の計算を受け持つライブラリ
ggml は、行列などのテンソルの計算を、さまざまなハードウェアで速く行うための C と C++ のライブラリだ。llama.cpp は LLM の推論に、whisper.cpp は音声認識に、ggml の計算を使っている。Ollama や LM Studio は、さらにその上に作られている。
| 項目 | 内容 |
|---|---|
| 言語 | C・C++ |
| ライセンス | MIT |
| 対応する計算の場所 | CPU、CUDA、Metal、Vulkan、SYCL、OpenCL、WebGPU、Hexagon、CANN など |
| 主な利用先 | llama.cpp、whisper.cpp |
| GitHub | スター約1.58万、フォーク約1,900(2026年11月14日) |
開発の多くは llama.cpp のリポジトリで行われ、ggml のリポジトリに同期される。今回の 1.0 でも、v0.29.0(11月4日)からの119件のコミットの多くは「sync : llama.cpp」で入っている。
ggml 1.0 で変わったこと:消えた API と置き換え先
リリースノートの概要は「非推奨の公開 API と古い DIAG_MASK の演算を削除し、YaRN の丸めの調整と FP8 対応を加え、各バックエンドを改良した」というものだ。v0.29.0 と v1.0.0 の include/ggml.h を比べると、公開の関数13個と、演算の種類3つ(GGML_OP_ADD1、GGML_OP_DIAG_MASK_INF、GGML_OP_DIAG_MASK_ZERO)が消えていた。
MIGRATION消えた API と置き換え先
公開の関数13個と演算3つが消えた
v1.0.0 で消えたもの
置き換え先
v1.0.0 で消えたもの: ggml_add1・ggml_add1_inplace
置き換え先: ggml_add・ggml_add_inplace
v1.0.0 で消えたもの: ggml_rope_custom(_inplace)
置き換え先: ggml_rope_ext(_inplace)
v1.0.0 で消えたもの: ggml_mul_mat_set_prec・ggml_flash_attn_ext_set_prec
置き換え先: ggml_prec_set_acc
v1.0.0 で消えたもの: ggml_upscale_ext・ggml_type_sizef
置き換え先: ggml_interpolate・ggml_row_size
v1.0.0 で消えたもの: ggml_diag_mask_inf・ggml_diag_mask_zero(_inplace)
置き換え先: マスクを作って ggml_add
置き換え先の多くは、v0.29.0 の ggml.h に「use 〇〇 instead」と書かれていたものだ。例外が2つある。
・ggml_diag_mask_inf・ggml_diag_mask_zero:一対一の置き換え先がない。公式の examples(GPT-2 など)は、マスクの tensor を作って値を入れ、ggml_add で足す形に書き換えている(下にコードの例)
・ggml_rope_yarn_corr_dims:公開のヘッダーから外れ、内部用の ggml-impl.h に移った
加わったものとして、YaRN の丸めを調整する ggml_rope_set_truncate・ggml_rope_get_truncate がある。バックエンドでは、CUDA の OCP FP8 対応、Vulkan の Intel 向け FlashAttention、Hexagon の Q5_0・Q5_1 対応などが入った。リリースノートに速度向上の数字は書かれていない。
RPC の版:RPC は、llama.cpp で複数の機械の GPU をつなぐときに使う通信の仕組みだ。リリースノートは「RPC の通信方式を v9 に上げた」と書いているが、v1.0.0 の include/ggml-rpc.h の値は RPC_PROTO_MAJOR_VERSION 10 だった(v0.29.0 は 8)。いずれにしても版の違う相手とはつながらなくなるので、RPC でつないだ機械はすべて同じ版に上げる。
ggml 1.0 で古いコードが壊れるかを確かめた
v0.29.0 と v1.0.0 を CPU 向けにビルドし、消えた関数 ggml_diag_mask_inf を使う小さな C のプログラムを両方で組み立てた。
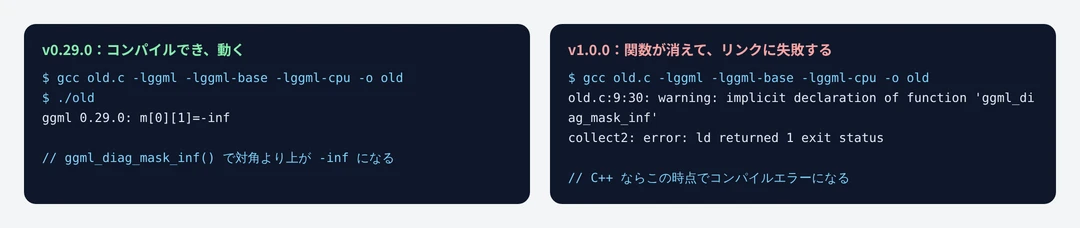
v0.29.0 では動き、v1.0.0 ではリンクの段階で失敗した。C では暗黙の宣言の警告だけで先に進み、リンクで止まるので、警告を読み飛ばしていると原因に気づきにくい。
同じ計算を、公式の examples と同じ「マスクを作って足す」形に書き直すと、v1.0.0 で m[0][1]=-inf(対角より上が -inf、下は元の値のまま)となり、前と同じ結果になった。
/* v0.29.0 まで:m = ggml_diag_mask_inf(ctx, a, n_past); */
struct ggml_tensor * KQ_mask = ggml_new_tensor_2d(ctx, GGML_TYPE_F32, n_kv, N);
for (int i1 = 0; i1 < N; ++i1)
    for (int i0 = 0; i0 < n_kv; ++i0)
        ((float *) KQ_mask->data)[i0 + i1*n_kv] = i0 > n_past + i1 ? -INFINITY : 0.0f;
struct ggml_tensor * m = ggml_add(ctx, a, KQ_mask);
ここではコンテキストにデータを置く設定(no_alloc が false)なので、作った直後にマスクへ値を入れている。バックエンドで計算するときは、公式の examples のように ggml_set_input で入力の印を付け、計算の前に値を入れる。
自分のコードに消えた API が残っていないかは、次の grep で探せる。プロジェクトの最上位で実行する。ggml のソースを取り込んでいる場合は、そのフォルダを --exclude-dir で外す(ggml の中では、内部用に残った関数が当たる)。
grep -rnwE "ggml_(add1|add1_inplace|diag_mask_inf|diag_mask_inf_inplace|diag_mask_zero|diag_mask_zero_inplace|flash_attn_ext_set_prec|mul_mat_set_prec|rope_custom|rope_custom_inplace|rope_yarn_corr_dims|type_sizef|upscale_ext)|GGML_OP_(ADD1|DIAG_MASK_INF|DIAG_MASK_ZERO)" --include=*.c --include=*.cpp --include=*.h --include=*.hpp --include=*.cu --exclude-dir=ggml .
v0.29.0 の examples で実行すると5件(GPT-2 の例の ggml_diag_mask_inf など)当たり、対応済みの v1.0.0 の examples では0件だった。マクロや別名で呼んでいる場合は当たらないので、最後はビルドが通るかで確かめる。
誰が対応すべきか:ggml 1.0 への上げ方
BEFORE UPGRADING上げる前に確かめる
ggml を直接組み込んでいる人だけが対応する
-
1.消えた API を使っていないか
本文の grep で、自分のコードを探す
-
2.RPC を使っているか
通信方式の版が 8 から 10 に上がった。サーバーとクライアントを両方上げる
-
3.llama.cpp 経由で使っているか
今回の削除は llama.cpp 側から入った変更。llama.cpp を上げれば足りる
-
4.Ollama・LM Studio だけを使っているか
自分では何もしなくてよい。製品の更新を待つ
| 使い方 | やること |
|---|---|
| Ollama・LM Studio を使うだけ | 何もしない。製品の更新を待つ |
| llama.cpp を使う | llama.cpp を新しい版に上げる。今回の削除は llama.cpp の #29801 から入った変更 |
| llama.cpp の RPC で複数の機械をつなぐ | すべての機械を同じ版に上げる |
| ggml を直接組み込む | 上の grep で探し、置き換え先に書き換えてビルドする |
ビルドは公式の手順どおり、CMake で行える。CPU だけなら追加の設定は要らない。
git clone https://github.com/ggml-org/ggml && cd ggml
cmake -B build -DCMAKE_BUILD_TYPE=Release && cmake --build build -j4
Ollama と llama.cpp のどちらを使うかの違いは Ollamaとllama.cppの違い2026|ローカルLLMはどちらで動かすべきか徹底比較 で、Ollama の使い方は Ollamaとは?使い方をインストールから解説|基本コマンド・API・必要スペック・モデル選び2026 で扱っている。
参照ソース
・ggml-org/ggml(GitHub)
・ggml v1.0.0 のリリースノート(GitHub)
・Releases and versioning of ggml-org projects(GitHub Discussions #1579)