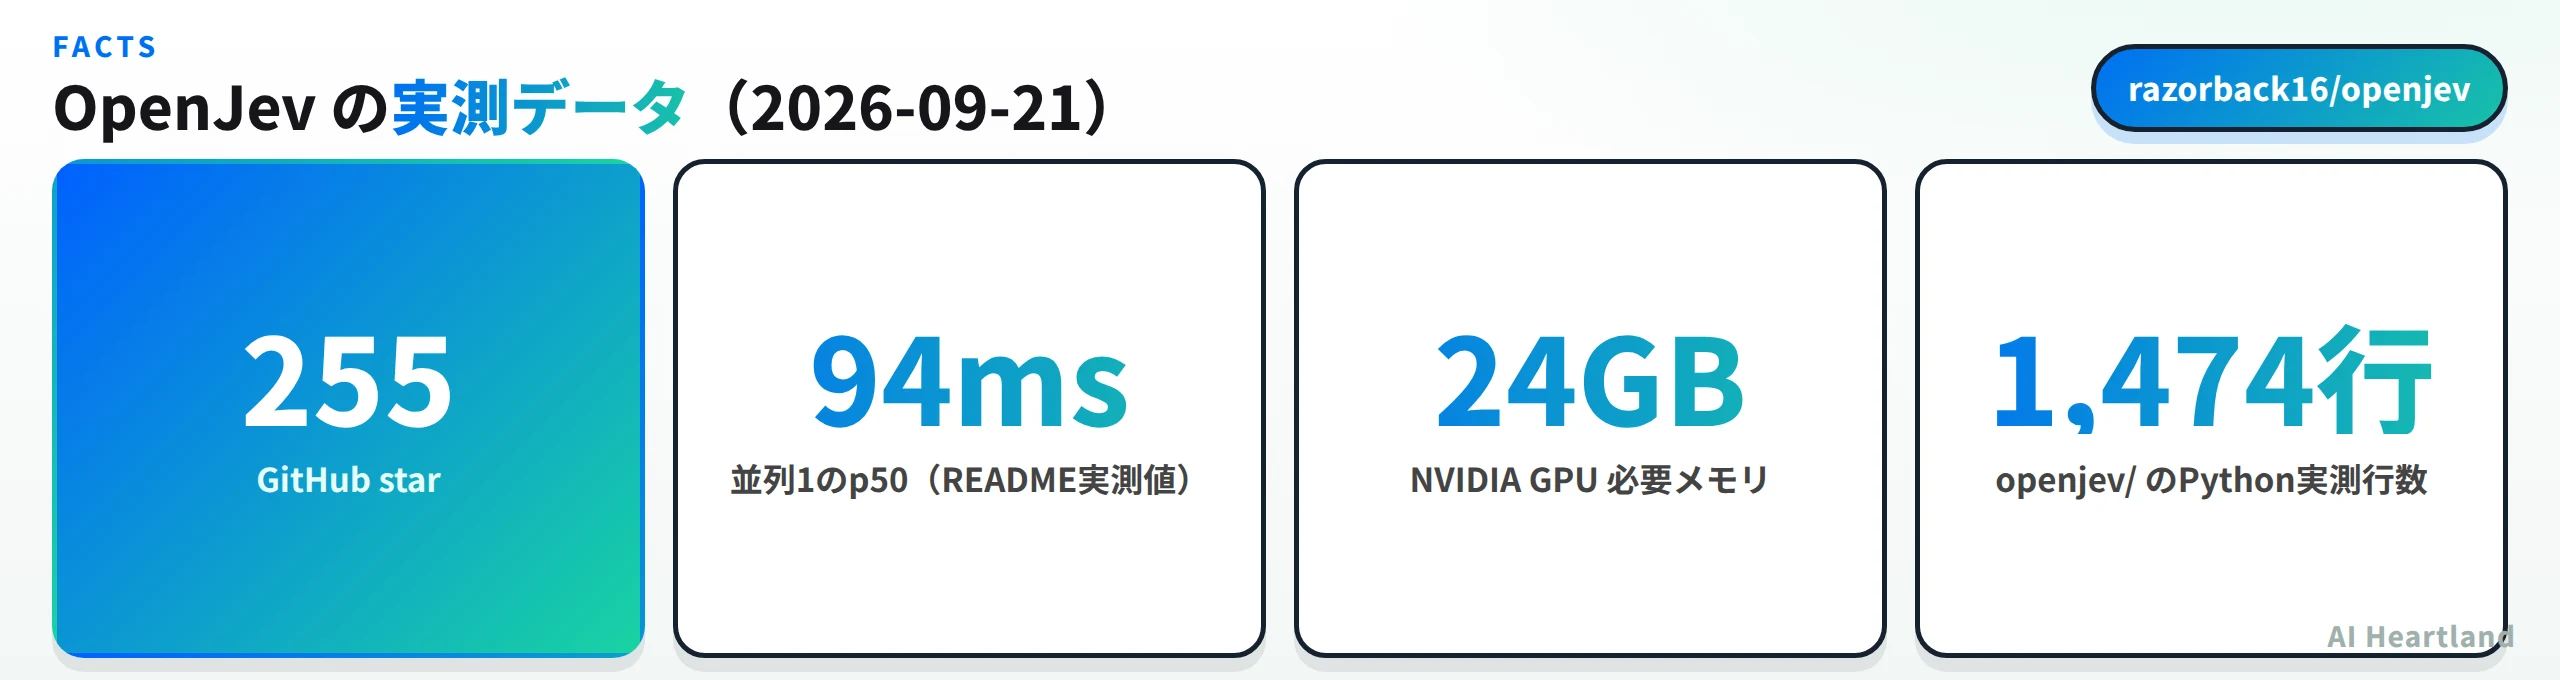
OpenJevは、TypeSafeのJevと同じwire APIを自前のGPUで提供するApache-2.0のOSSだ。状態と型つきの質問を送ると、各回答の確率と確信度がミリ秒単位で返る。文章は1文字も生成せず、拡散モデルDiffusionGemma 26B-A4Bを1回読むだけで答えを取り出す。2026年9月21日時点でstar 255・fork 22、バージョン0.3.0でタグは未発行。本記事では本体1,474行のPythonをソースで追い、GPUのないLinuxでどこまで動くかを実際に試した結果と、自前運用に必要な要件を整理する。
- ・正体:Jev互換のSystem One決定サーバ。ライセンスはApache-2.0(LICENSE実体ファイルで確認)
- ・何ができる:yes/no・選択・スコアの型つき質問に、確率と確信度で答える。画像への質問とテキスト生成も同じサーバで扱える
- ・実測:依存が軽くpip導入とimportは通った。起動時にモデルとトークナイザを取りに行くため、重みを置けない環境では立ち上がらない
- ・注意:既定構成はNVIDIA GPU 24GB以上。依存する vLLM のPRは未マージで、fork のコミットを固定している
「文章を返さないモデル」という発想そのものについてはJevとは|文章を返さないSystem Oneモデルの正体を公式SDKのコードで実測し、Claude Codeで試すで扱った。モデルの選択肢とローカル実行の全体像はLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめている。
OpenJevとは——Jev互換のSystem One決定サーバ
System Oneモデルという呼び方は、判断を「速い直感」と「遅い熟考」に分ける発想から来ている。文章を書くモデルが後者だとすれば、Jevのようなモデルは前者にあたる。理由を語らず、あらかじめ決めた選択肢の上の確率だけを返す。
OpenJevはこの種のモデルを、オープンな重みと自前のGPUで提供する。提供するエンドポイントは3つだけだ。
・POST /v1/systemone:状態と質問群を受け取り、回答と使用トークンを返す。これが本体
・POST /v1/chat/completions:OpenAI互換のテキスト生成。同じ重みを使い、GPUメモリの追加消費なし
・GET /v1/models:openjev-0.1 と別名 openjev-latest を返す
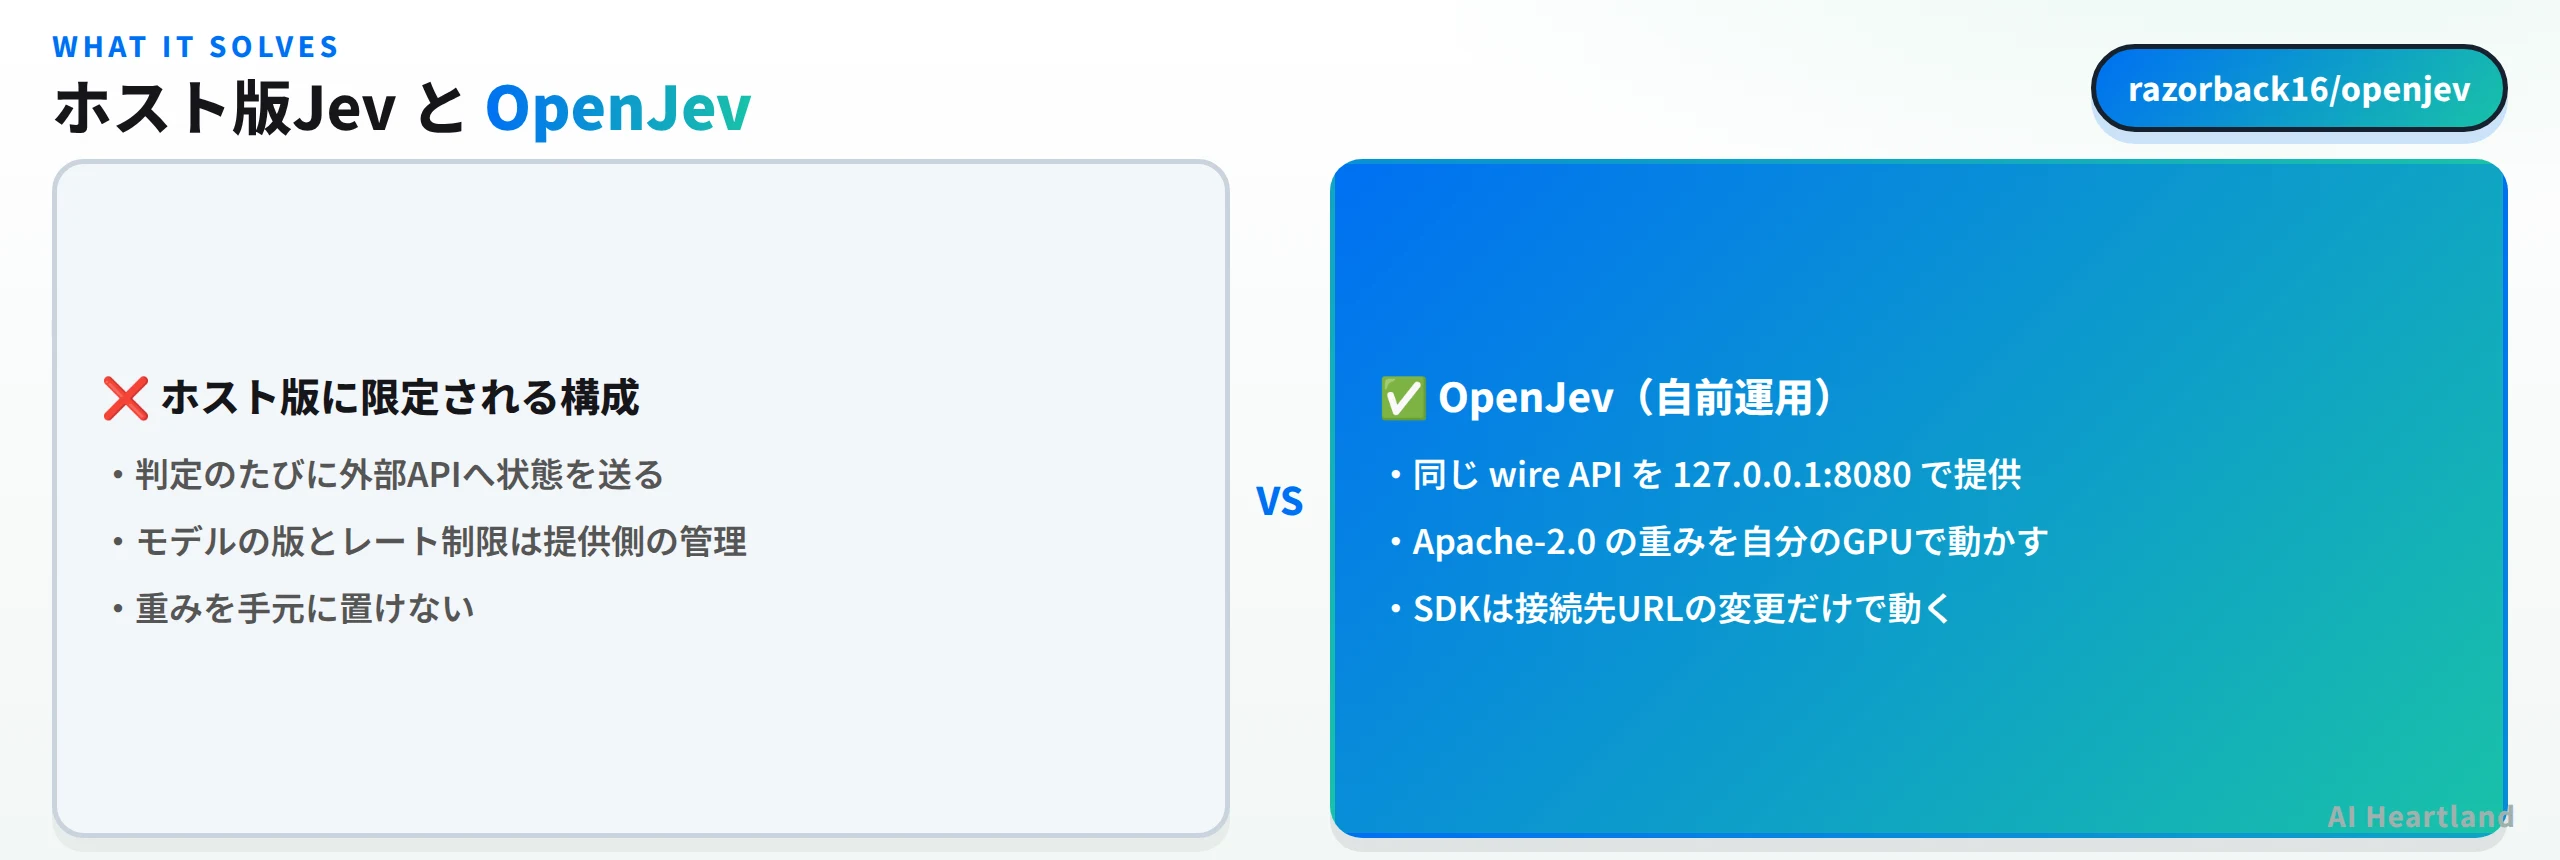
互換性の作り込みは名前のレベルまで及んでいる。openjev/config.py を読むと、受け付けるモデル名の集合に jev-latest と jev-preview が明示的に含まれており、コメントには「TypeSafeのSDKが変更なしで動くように受け付ける(SDKの既定は jev-latest)」と書かれている。接続先URLを差し替えるだけで既存コードが動く、という主張はソースの側から裏が取れる。
質問の型は3つある。noul(yes/no)は P(yes) を返し、choice は選択肢ごとの確率と確信度、score は水準2〜10段階の期待値と確率分布を返す。確信度の定義もREADMEに式で書かれている。confidence は 1 − H(p)/ln K、つまり分布のエントロピーを選択肢数で正規化した値であり、モデルが自分の自信を申告した数字ではない。
READMEは「OpenJevは独立したプロジェクトであり、TypeSafe AIとの提携も同社の推奨も受けていない」と明記している。互換なのはAPIの形だけで、モデルも実装も別物だ。ホスト版のJevで測った精度や速度がそのまま当てはまる保証はない。
仕組み——答えを書かせず1回の読み取りで確率を取る
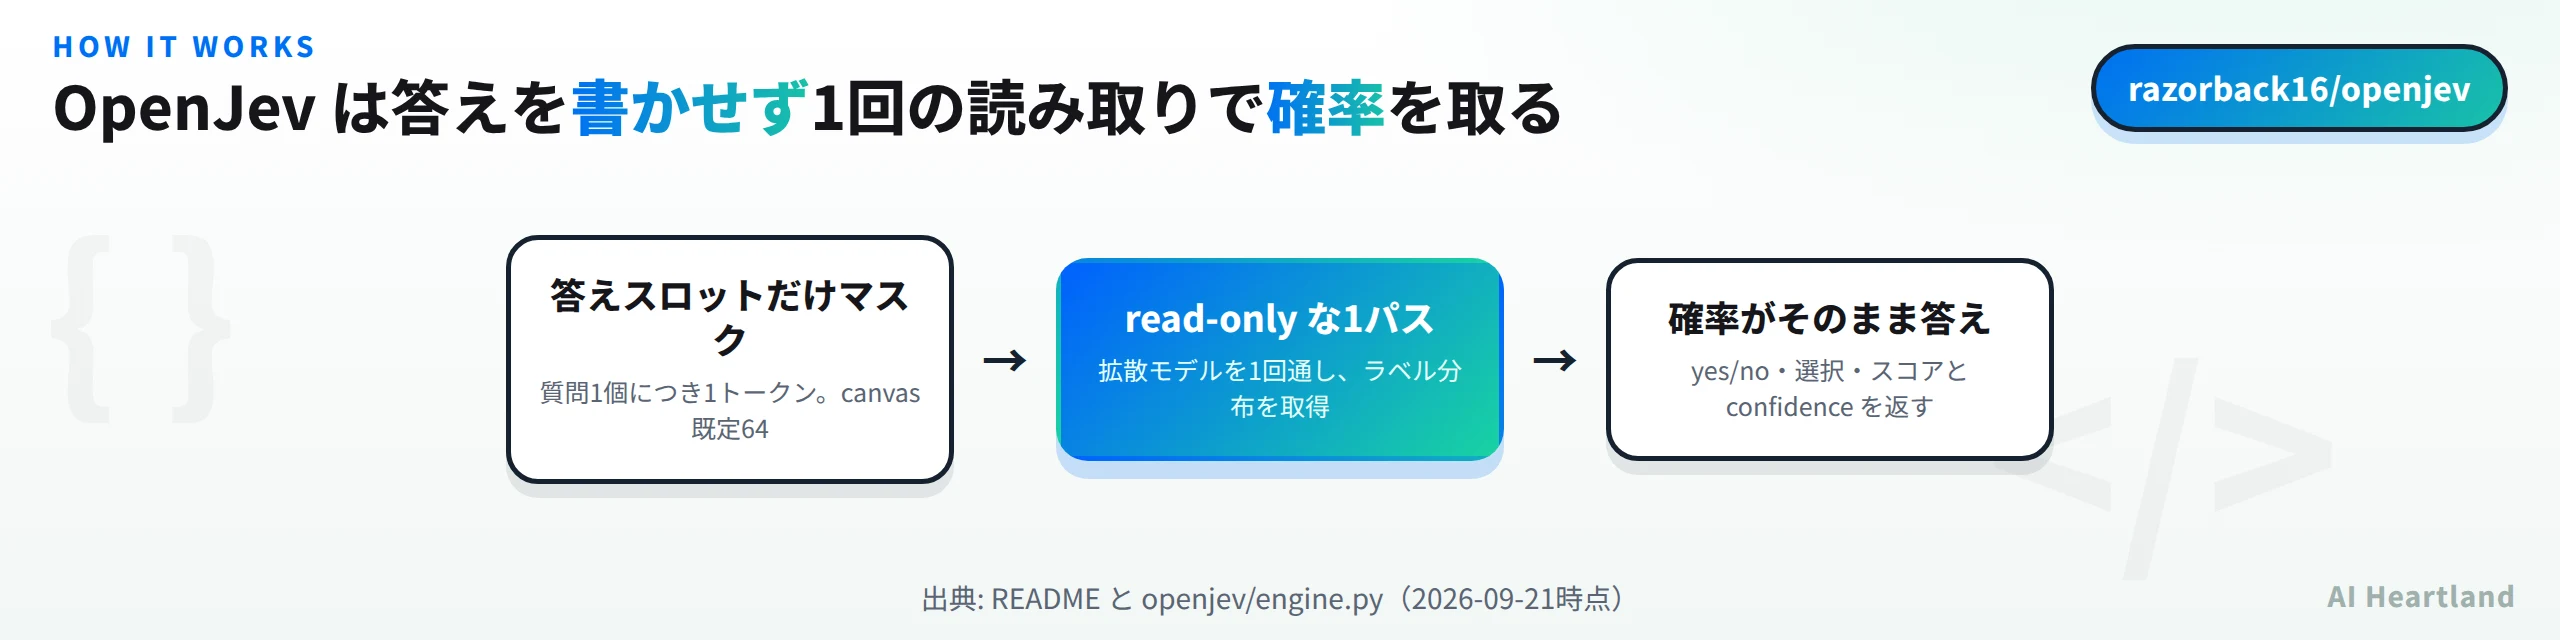
OpenJevの中身で面白いのは、拡散モデルの性質を判定に使い切っている点だ。DiffusionGemmaは離散拡散モデルで、左から右へ1トークンずつ生成するのではなく、トークンのキャンバス全体を1回の順伝播でノイズ除去する。OpenJevはこれを「書く」ためでなく「読む」ために使う。
答えスロットだけマスク
1質問=1トークン"] B --> C["read-only の1パス
DiffusionGemma"] C --> D["ラベルの確率分布"] D --> E["エントロピーが 0.1 超?"] E -->|はい| F["新しいノイズで再読取
最大4回・平均する"] E -->|いいえ| G["回答と confidence を返す"] F --> G
ラベルはすべて1トークンに収まるように設計されている。noul なら yes と no、選択なら A B C、スコアなら 0 1 2。モデルはそのスロットに何かを書き込むのではなく、スロット位置の確率分布が読み出されるだけだ。この作りから2つの性質が出てくる。答えがスキーマから外れようがないこと、そして確信度がモデルの自己申告ではなくモデル自身の分布から計算されることだ。
不確かなときの挙動もソースで確認できる。openjev/config.py の auto_threshold の既定値は 0.1、auto_max は 4。いずれかのスロットのエントロピーがしきい値を超えると、別のノイズで最大4回まで読み直して平均する。READMEの記述とコードの既定値は一致していた。
質問が多いときの扱いも実装を見ると分かる。engine.py の groups() は「答えのテンプレートがキャンバスに収まる範囲で、質問を順序どおり最小個数のグループに分ける」処理だ。キャンバス長の既定は64トークンで、READMEはこれを「1回の読み取りあたり12問前後のチャンク」と説明している。チャンクは既定では並列に処理されるが、sequential を指定すると順番に読み、各チャンクが前のチャンクで選ばれたラベルを見た状態で判断する。
質問のIDがモデルに渡らない点も明記されている。モデルが見るのは q1 q2 q3 であり、is_billing のような意味のあるキー名から答えが引きずられることはない。細かいが、判定モデルの設計としては妥当な配慮だ。
拡張フィールドも用意されている。いずれもJevの契約にはないOpenJev独自の追加で、送らなければJevと同じ挙動になる。
| フィールド | 値 | 何をするか | 費用 |
|---|---|---|---|
images |
最大8枚 | 質問が参照する画像を状態の前に置く。JPEG/PNG/WebP/GIF・各5MBまで | 1枚あたり約280入力トークン |
steps |
1〜8(既定1) | 1回の読み取りあたりのノイズ除去回数 | トークンは同じ・GPU時間が増える |
samples |
1〜32 | 異なるノイズでN回読んで平均する | N倍の入力トークン |
think |
0〜4096トークン | 先に思考を書かせてから読み取る。数値は上限 | 入力トークン2回分+思考の出力トークン |
sequential |
true | チャンクを順番に読む | チャンクごとに1回・直列 |
think と sequential はテキストの状態を必要とするため、images とは併用できず400が返る。この種の制約が「できません」ではなく明示された条件として書かれているのは、実装を読む側にはありがたい。使用量の数え方も明確で、usage.input_tokens は画像のトークンを含むプロンプト全体、usage.output_tokens は think を指定しない限り0になる。読み取りは出力トークンを消費しない、という原則がそのまま数値に出る。
テキスト生成の側には互換のための調整が入っている。vLLMは拡散モデルに対して一部のフィールドを拒否するため、OpenJevはリクエストを失敗させずに調整する。temperature・seed・min_p・logit_bias・各種ペナルティは無視され、response_format は「JSONだけで答えよ」という指示に変換されて最初のJSONオブジェクトが本文として返る。max_tokens の既定は1024で上限は8192。生成は64トークンのブロック単位でノイズ除去するため、判定の読み取りよりGPU時間をはるかに多く使う。
実測:依存の導入から起動試行まで(GPUなしのLinux)
ここからは2026年9月21日にLinux(x86_64・GPUなし)で試した結果だ。結論から言うと、GPUのない環境ではサーバは起動しない。ただし、どこで止まるかを確かめておく価値はあった。
git clone https://github.com/razorback16/openjev.git
cd openjev
python3 -m venv /tmp/oj-venv
/tmp/oj-venv/bin/pip install -e .
/tmp/oj-venv/bin/python -c "import openjev; print('import ok')"
依存は驚くほど軽い。pyproject.toml の dependencies は fastapi・uvicorn・httpx・transformers・tokenizers・jinja2 の6つだけで、vLLM は入っていない。推論エンジンはDockerイメージの中か外部のvLLMサーバに任せる設計だからだ。インストールとimportはどちらも問題なく通った。
次に python -m openjev でサーバを起動してみた。__main__.py は8行しかなく、create_app() を uvicorn に渡すだけだ。起動は始まるが、FastAPIのlifespanフック(openjev/api.py の157行目付近)が AutoTokenizer.from_pretrained() を呼ぶところで止まる。
OSError: Can't load the configuration of 'nvidia/diffusiongemma-26B-A4B-it-NVFP4'.
ERROR:    Application startup failed. Exiting.
この環境はHugging Faceへの接続が塞がれているため、トークナイザの設定を取得できずに終了した。重みだけでなくトークナイザも起動時に必要で、完全なオフライン環境で動かすなら事前にキャッシュを用意しておく必要がある、という実務上の前提がここで分かる。
テストも同じ壁に当たる。実行結果は次のとおりだった。
/tmp/oj-venv/bin/pip install pytest 'typesafe-sdk>=0.7'
/tmp/oj-venv/bin/python -m pytest tests/ -q
# 2 passed, 16 skipped, 48 errors in 13.79s
48件のエラーはすべて実モデルまたはトークナイザの取得失敗に由来するもので、コードの不具合ではない。逆に言えば、このリポジトリのテストはほぼすべて実物のモデルを前提にしている。モックで固めた単体テストではなく、実際の読み取り結果を検証する構成だ。READMEにも OPENJEV_MLX_TEST_MODEL に重みのパスを渡して実モデルに対してテストを走らせる手順が載っており、この方針は意図的なものだと分かる。
モジュール構成も見ておいた。openjev/ は8ファイルで、api.py(255行)がFastAPIのエンドポイントとモデル別名の検証、engine.py がキャンバス生成と読み取りの中核、mlx_backend.py がApple silicon用のプロセス内実行、config.py が環境変数からの設定読み込み、warmup.py が起動前のウォームアップ、chat.py がOpenAI互換のテキスト生成を担当する。責務の分かれ方が素直で、判定の挙動を追いたいときに読むべき場所がすぐ分かる。
依存6つ・成功"] --> B["import openjev
成功"] B --> C["python -m openjev"] C --> D["lifespan で
AutoTokenizer.from_pretrained"] D --> E["重みとトークナイザの取得"] E -->|取得できる環境| F["127.0.0.1:8080 で待受"] E -->|取得できない環境| G["OSError で起動失敗"]
検証環境:Linux(x86_64・GPUなし)/2026-09-21/openjev 0.3.0(main・2050fdb)。確認したのは依存の導入・import・起動試行・テスト実行の4点。判定そのもの(/v1/systemone の応答)は未検証。vLLM構成・MLX構成・Dockerイメージ・スループットの再現もいずれも未実施で、本文中の速度値はREADMEの記載である。
コード量も測っておいた。openjev/ 配下のPythonは1,474行、tests/ は1,173行。本体に対してテストがほぼ同量あり、8ファイルで構成されている。数万行のフレームワークではなく、読み切れる規模のサーバ実装だ。
自前運用の要件——NVIDIA GPUとApple siliconの2系統
OpenJevは同じ /v1/systemone を2通りの方法で提供する。選択は完全にハードウェア次第だ。
| 観点 | vLLM(既定) | MLX |
|---|---|---|
| ハードウェア | NVIDIA GPU・24GB以上 | Apple silicon・空きメモリ約16GB |
| 導入 | Dockerイメージ | pip install -e '.[mlx]' |
| 同時読み取り | 最大64件 | 1件ずつ |
| 画像・steps・think | いずれも対応 | いずれも対応 |
| テキスト生成 | 対応 | 対応(ストリーミング含む) |
NVIDIA側はDocker Hubにビルド済みイメージがあり、docker compose up -d で起動する。重み約18GBが初回に ~/.cache/huggingface へ落ちてくる。READMEが載せるスループットは、RTX PRO 6000 をGPU使用率38%で回し、質問3個のリクエストをキャッシュが効かない状態で投げた測定だ。
| 並列度 | req/s | p50 | p95 |
|---|---|---|---|
| 1 | 10.7 | 94 ms | 94 ms |
| 16 | 43.3 | 367 ms | 369 ms |
| 32 | 51.7 | 545 ms | 618 ms |
| 64 | 57.4 | 760 ms | 1,109 ms |
Apple silicon側はDockerもvLLMも要らず、OPENJEV_BACKEND=mlx python -m openjev でプロセス内にモデルを載せる。4bitの重みで約16GB。README によればM3 Ultraで質問3個のリクエストが0.2〜0.4秒程度、M4 Maxで約0.39秒、16並列でも約4 req/s にとどまる。読み取りが直列なので、サーバというより開発機での利用に向く、という位置づけが明記されている。
設定はすべて環境変数だ。OPENJEV_API_KEY を設定すればBearer認証を要求し、OPENJEV_MAX_QUEUE(既定512)を超えると529を返す。OPENJEV_UPSTREAM を指定すれば、コンテナ内蔵のvLLMを起動せず既存のvLLMサーバに繋げる。運用の勘所が環境変数で外から触れる作りになっている。
OpenJevが使う読み取り専用の推論機能は vllm-project/vllm#57250 に由来し、このPRはまだマージされていない。使用するリクエストフィールド(`vllm_xargs`)は暫定仕様のため、プロジェクトは `razorback16/vllm` のブランチのコミットを固定している。そのブランチはPRのHEADに、vLLMのエンジンがクラッシュしないための修正3件を足したものだと説明されている。上流が動けば固定先の作り直しが必要になる構成であり、長期運用の前提としては弱い。
ホスト版Jevとの違いとOpenJevを選ぶ判断
移行を考えるとき役に立つのは、READMEの「Known differences from Jev」の節だ。互換を謳う実装が自分から差分を列挙しているのは珍しく、そして実用的だ。
・選択肢の上限は128個(Jevは255個)。拒否のメッセージは同じ文面
・モデル名はOpenJev独自。jev-1.13.0 のような固定版を指定すると400の Unknown model が返る
・選択肢1個の質問やスコア1段階の質問は、読み取りをせずに確率1で即答し、トークンを消費しない(Jevは同じ値を返すが課金する)
・1,000階層の入れ子ボディにOpenJevは422、Jevは500を返す
・エラーの形(422・400・401/403・429・529)はJevに合わせており、実APIと突き合わせて確認したと明記されている
こうした差は、SDKを差し替えずに接続先を変える運用では表に出にくい。選択肢が128個を超える設計にしているかどうかだけは、移行前に確認しておくべき項目だ。
採用判断の軸は3つに整理できる。第一に状態を外に出せるか。判定に渡す「状態」は顧客の問い合わせ文や社内文書そのものであることが多く、ここを外部APIに送れない要件があるならOpenJevは事実上ただ1つの選択肢になる。第二にハードウェアがあるか。24GBのNVIDIA GPUか、メモリに余裕のあるAppleマシンが要る。第三に未マージPRへの依存を許容できるか。上流の仕様が動けば追随の手間が生じる。
判定を他のOSSと組み合わせる使い方については、Jev対応のツールがどの層にどれだけあるかをJev対応OSS 11選|ブラウザ操作・MCP・コードレビュー・Claude Code文脈選別まで実測で見る使いどころで一覧にした。実際にJevの判定をアプリケーションの中心に置いた例としては、ブラウザ操作を生成でなく選択で進めるjev-ultrafastとは|ブラウザを生成でなく選択で動かすエージェントを全ソース1,094行で実測が分かりやすい。いずれもホスト版Jevを前提に書かれているが、OpenJevは接続先を差し替える対象としてそのまま使える位置にある。
まとめ——OpenJevは誰のための実装か
OpenJevは、これまでホスト型のサービスとしてしか触れなかった「文章を書かない判定モデル」を、Apache-2.0の重みと読み切れる量のコードで自分の設備に置けるようにした実装だ。答えスロットだけをマスクして1回読む設計、エントロピーが高いときだけ読み直す既定値、キャンバスに収まる単位で質問を分けるグルーピング。いずれもソースで確認でき、READMEの説明と食い違う箇所は見つからなかった。
待ったほうがよい:GPUを用意できない環境(起動自体しない)。長期の安定運用が最優先で、未マージPRへの依存を避けたい場合。選択肢が128個を超える判定を設計している場合
本記事で確認していないのは判定そのものの品質だ。GPUのない環境では /v1/systemone を叩けておらず、速度表も精度に関する記述もREADMEの引用である。手元で評価するなら、まず pip install -e . とテスト実行までを通し、重みを置ける環境を確保してから、自分のタスクの質問セットで確信度の分布を見るのが順序として素直だろう。判定モデルは平均正解率より「迷ったときにどう迷うか」が効く道具なので、そこを自分の目で見られることが自前運用のいちばんの利点になる。
参照ソース
・razorback16/openjev(公式リポジトリ) — README・LICENSE・pyproject.toml・openjev/config.py・openjev/engine.py(2026-09-21時点で確認)
・vllm-project/vllm#57250 — OpenJevが依存する読み取り専用推論の未マージPR
・nvidia/diffusiongemma-26B-A4B-it-NVFP4(Hugging Face) — 既定で使われる重み