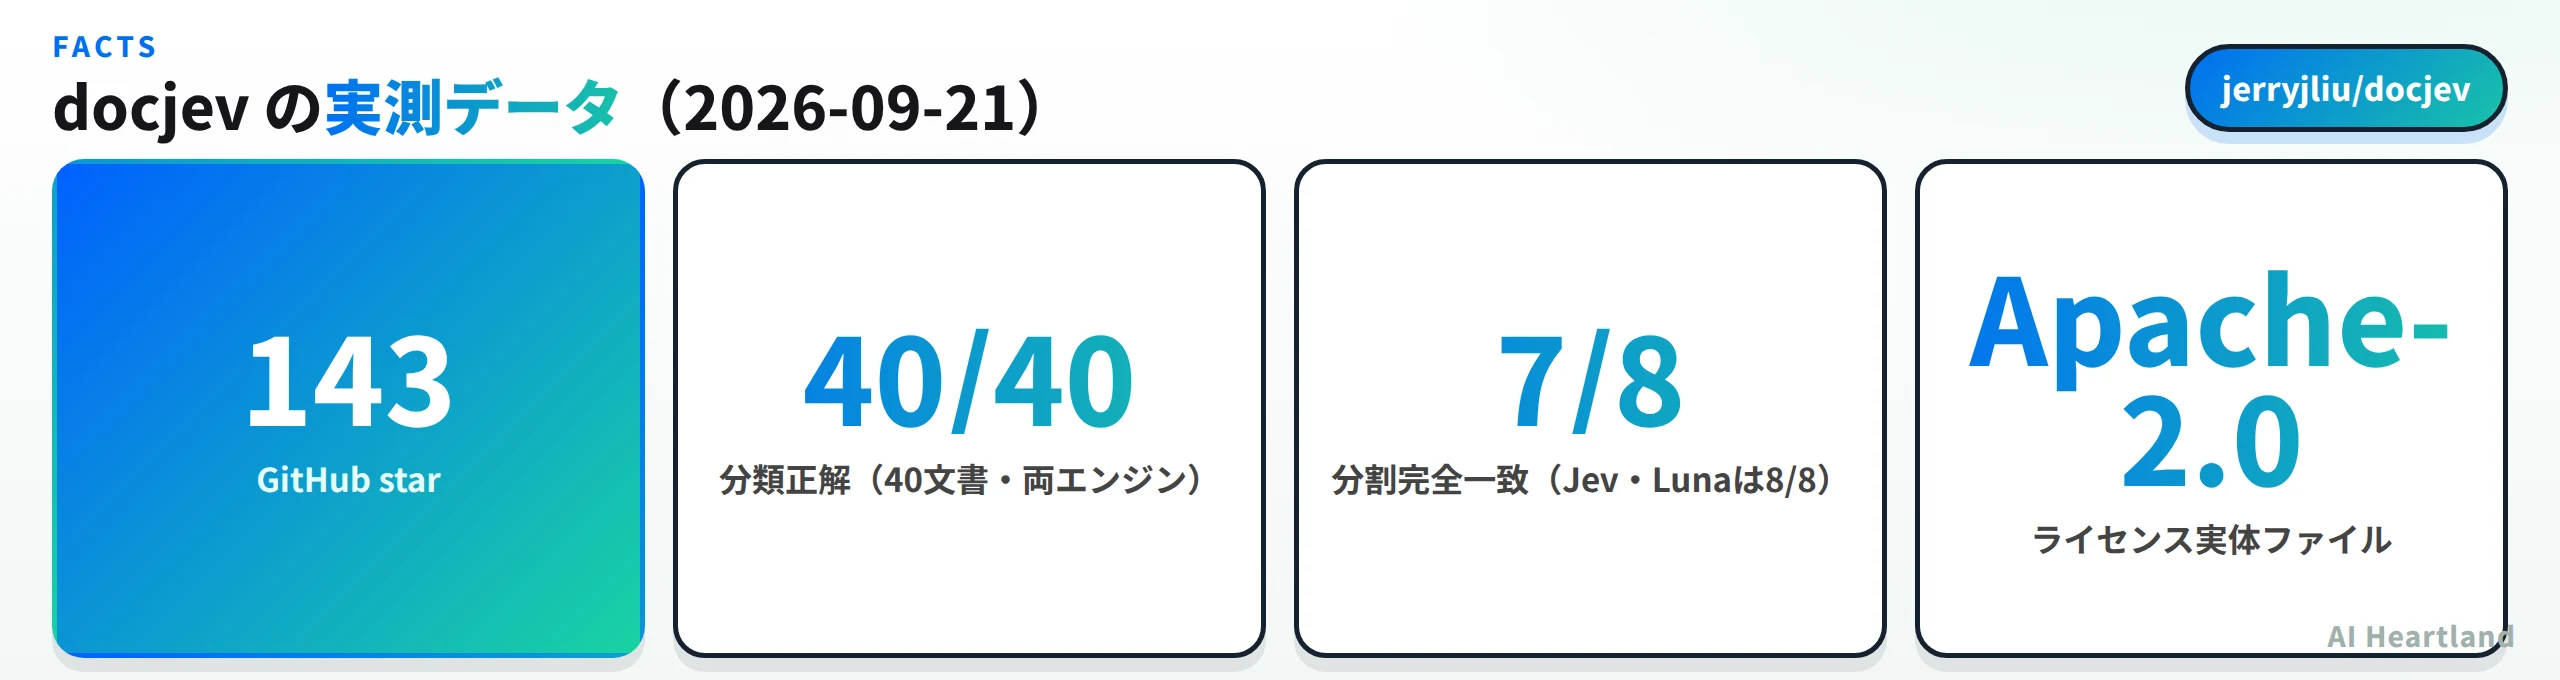
docjevは、PDF・DOCX・PPTXを自然文のカテゴリ定義で仕分けるApache-2.0のOSSだ。文字の取り出しはローカルのLiteParseが行い、カテゴリと文書境界の判定はTypeSafeのJevが確率で返す。作者はLlamaIndex創業者のjerryjliu氏。2026年9月21日時点でstar 143・fork 11、バージョンは0.1.0でタグは未発行という、公開直後のリポジトリだ。本記事ではLinux上で実際にインストールし、OCRの起動確認と10ページのスキャンPDFの処理まで測った結果と、リポジトリに同梱された40文書のベンチマークの読み方を扱う。
- ・正体:文書の分類と分割を行うPythonライブラリ兼CLI。ライセンスはApache-2.0(LICENSE実体ファイルで確認)
- ・何ができる:1文書のカテゴリ判定、複数文書が連なった束の境界検出、境界ごとのPDF書き出し
- ・実測:uv syncとdoctorは通り、10ページのスキャンPDFから54,477文字を取り出せた。判定側(classify・split)はAPIキーが必要で未検証
- ・注意:タグ未発行の0.1.0。Jevはホスト型の有料サービスで、ローカルOCRがあっても推論はオフラインにならない
Jevそのもの(文章を生成せず型つきの判定だけを返すモデル)の設計はJevとは|文章を返さないSystem Oneモデルの正体を公式SDKのコードで実測し、Claude Codeで試すで扱った。モデル側の前提を含めた全体像はLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめている。
docjevとは——JevでPDFを分類・分割するOSSの正体
docjevが解くのは、実務で「書類の山をどう仕分けるか」と呼ばれてきた問題だ。請求書と発注書と社内通知が混ざったPDFの束を、種類ごとに分け、1つのファイルに複数の文書が連なっていれば元の単位に切り戻す。docjevはこれを2つのコマンドに分けている。
・classify:1ファイル(またはディレクトリ内の各ファイル)に1つのカテゴリを割り当て、確率とレビュー要否のフラグを返す
・split:1つの束の中から連続する元文書を見つけ、カテゴリとページ範囲の並びを返す。必要ならページ範囲ごとにPDFを書き出す
・parse:判定を一切呼ばず、ページ順の全文テキストだけを返す
・doctor:インストール・変換系ツール・認証情報の有無を、APIを呼ばずに点検する
カテゴリはYAMLに自然文で書く。IDと「その文書は何のために存在するか」の説明を並べるだけで、学習データもラベル付きサンプルも要らない。READMEのサンプルは請求書を「売り手が、すでに供給した商品やサービスへの支払いを求めるもの」、発注書を「買い手が、商品やサービスの供給を認可するもの」と説明する。other は書かなくても自動で追加される。
分割側には splitting_instructions という別の指示欄がある。ここが実務では効く。「継続ページは同じ文書にまとめる」「請求書番号が違えば、カテゴリが同じで隣接していても別の文書」といった、カテゴリ定義では表せない境界の規則を書く場所だ。README が強調するデモも、15ページの束に同じカテゴリの財務省入札結果が2件連続で入っている構成になっている。
名前まわりに1つ注意点がある。パッケージとCLIの名前は docjev だが、Pythonのimportは jev_docs、環境変数は JEV_DOCS_*、ローカルキャッシュのディレクトリは .jev-docs/ のままだ。jev-docs コマンドも互換の別名として残っている。改名の途中にあるリポジトリなので、検索するときは両方の綴りを試したほうが早い。
READMEは冒頭で「独立したオープンソース実装であり、LlamaIndexのホスト型 Classify・Split API を呼ばず、その実装も使わない」と明記している。LlamaParseは任意のクラウドOCRとしてのみ登場する。作者はLlamaIndex創業者だが、これは同社の製品ドキュメントではない。
docjevの仕組み——ローカルOCRと型つき判定を分ける
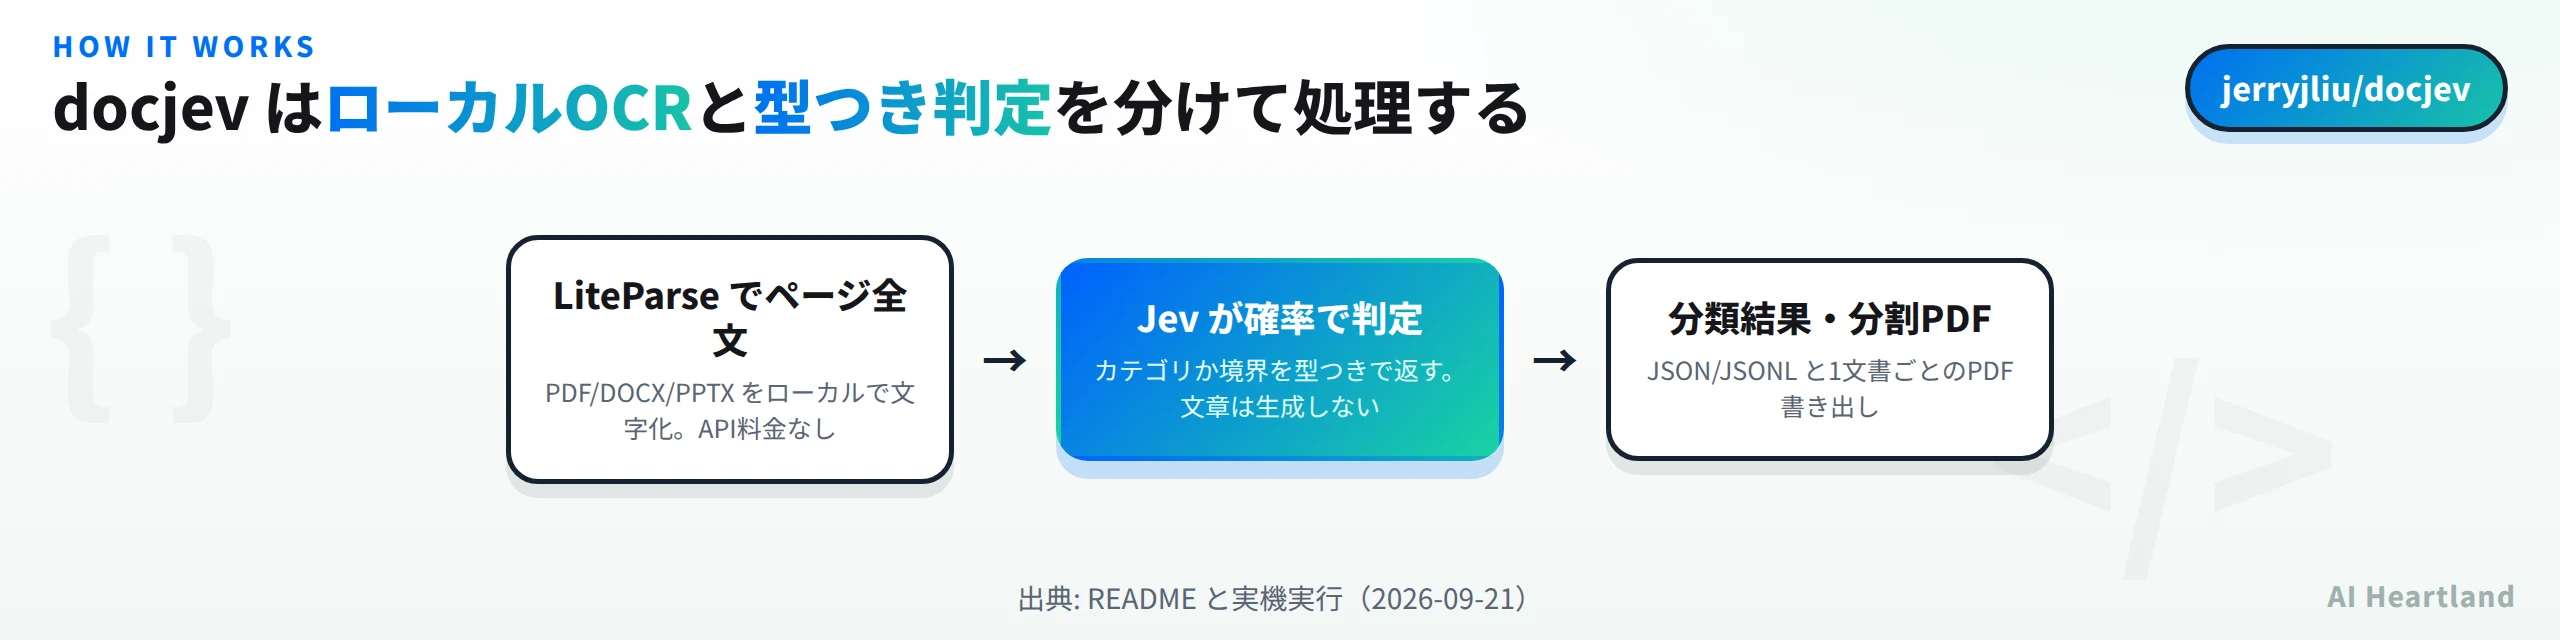
docjevの設計上の主張は「文字を取り出す工程と、判定する工程を混ぜない」ことに尽きる。多くの実装はPDFをそのままマルチモーダルLLMに渡し、分類結果を文章やJSONで書かせる。docjevはまずLiteParseでページ全文をローカルに取り出し、正規化したページテキストだけを判定エンジンに送る。
ローカルOCR・API料金なし"] B --> C[".jev-docs/cache
抽出テキストと正規化PDF"] C --> D["Jev
型つき判定・確率を返す"] D --> E["classify: カテゴリ+確率"] D --> F["split: 境界+ページ範囲"] F --> G["export: 1文書ごとのPDF"]
この分離には実務上の効き目が3つある。第一に、再実行のコストが下がる。OCR結果はローカルにキャッシュされるので、ルールを書き換えて判定だけやり直すとき文字起こしは繰り返されない。第二に、課金の境界がはっきりする。LiteParseにはAPI料金がなく、金がかかるのは判定呼び出しとLlamaParseを選んだときだけだ。第三に、PDFのバイト列が外に出る条件が限定される。READMEは「PDFのバイト列がアップロードされるのはLlamaParseを選んだときだけで、既定では正規化されたページテキストのみが判定エンジンへ送られる」と書いている。
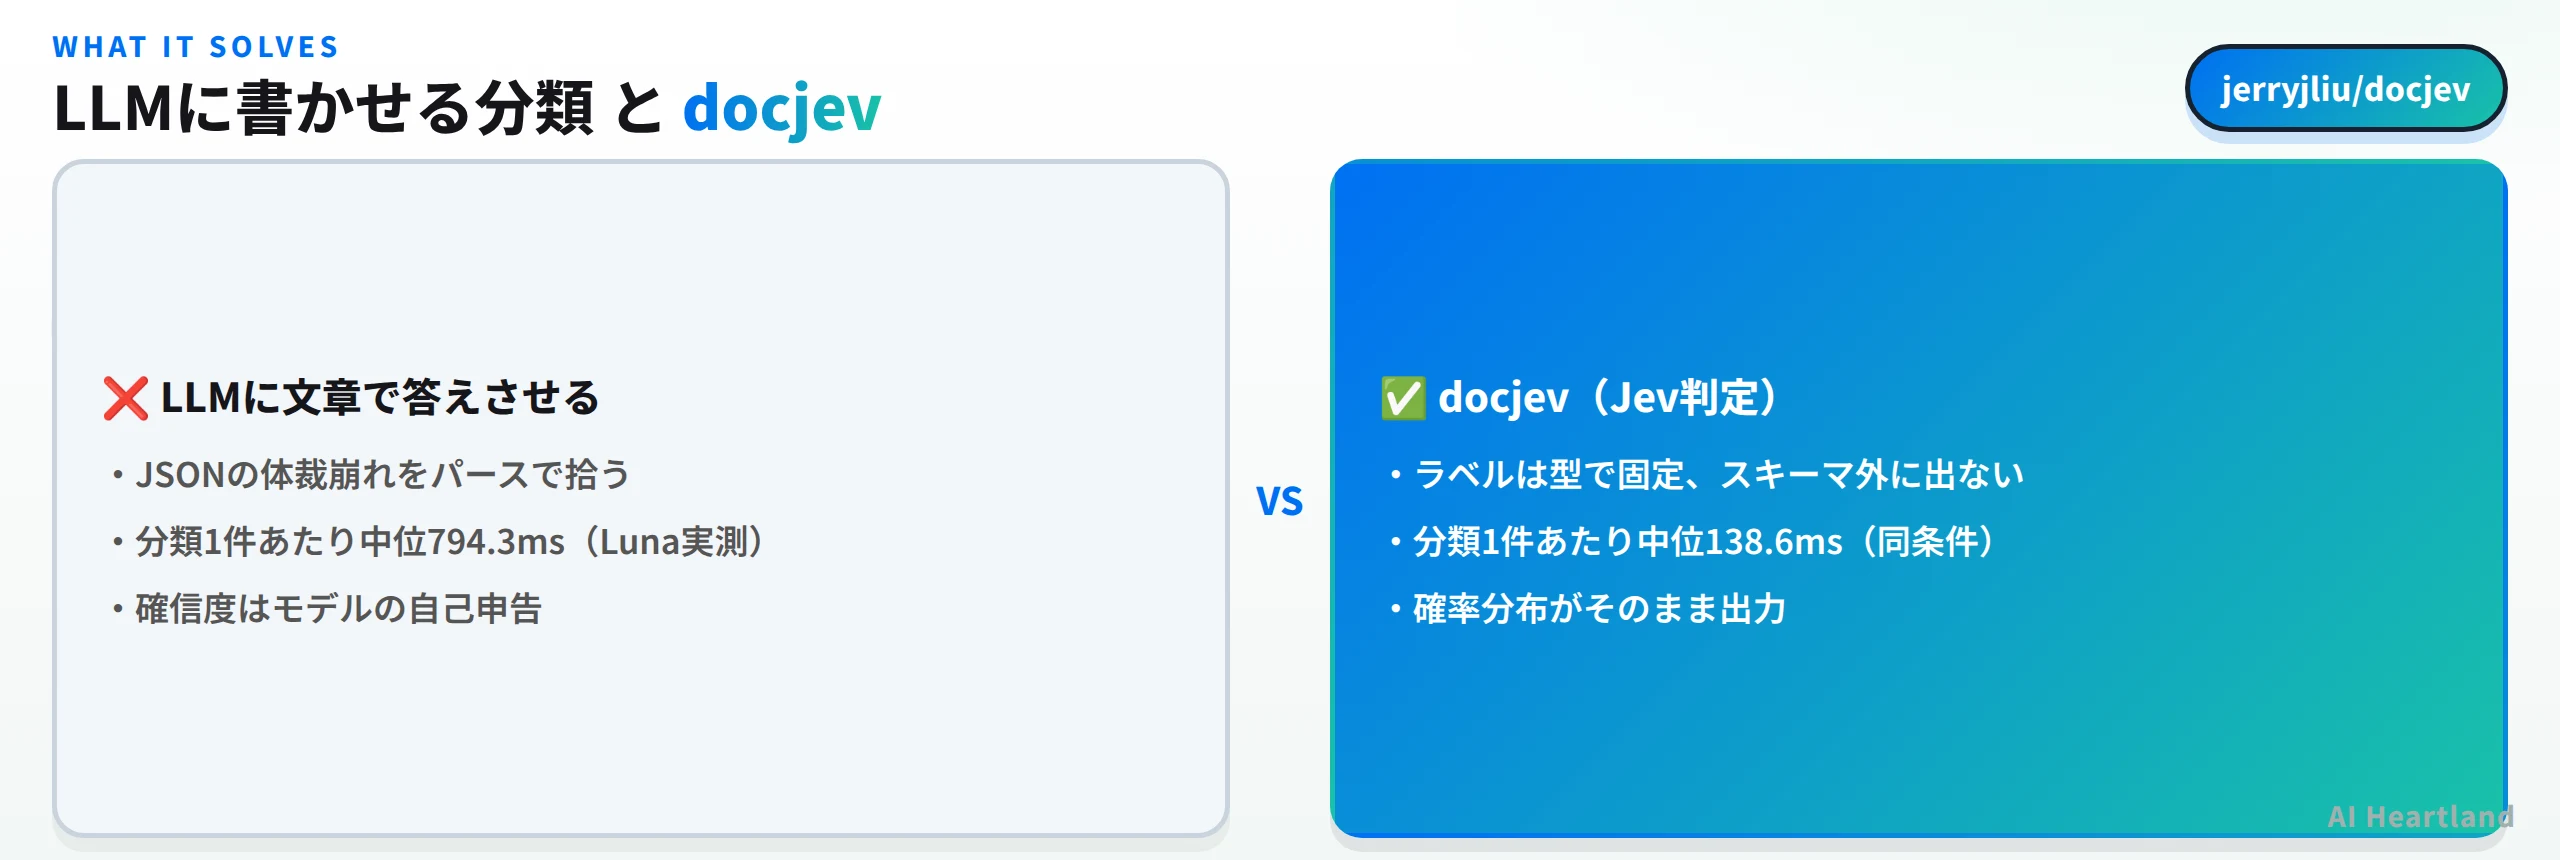
判定側の性質は、Jevというモデルの性質そのものだ。Jevは文章を書かず、あらかじめ決めた選択肢の上の確率分布を返す。docjevはこれを利用して、カテゴリの選択と、ページごとの「ここが新しい文書の先頭か」の判断を型で固定している。出力がスキーマから外れないので、JSONのパース失敗をリトライで吸収する必要がない。
ただしREADMEは確率の扱いについて、珍しく抑制的な断り書きを置いている。選択されたカテゴリの確率とプロバイダのconfidenceは別の値であり、どちらも較正済みだとは主張しない、そしてセグメントの平均カテゴリ確率は「ページ単位スコアの平均であって同時確率ではない」と明記している。しきい値を決めて自動処理に流す設計を考えているなら、この2文は読み飛ばさないほうがいい。
判定が説明文を返さない点も設計として明言されている。「Jevは判定と分布を供給するので、このパッケージは説明的な理由づけを捏造しない」。なぜそのカテゴリなのかを文章で欲しい用途には、そもそも向いていない道具だ。
実測:インストールからOCR起動確認まで
ここからは2026年9月21日にLinux(x86_64・Python 3.11系のホストにuvを導入)で実際に動かした結果だ。手順はREADMEのQuick startそのままで、追加の細工はしていない。
git clone https://github.com/jerryjliu/docjev.git
cd docjev
uv sync
uv run docjev doctor --smoke
uv sync は問題なく完了し、docjev --help は doctor / parse / classify / split / demo の5コマンドを表示した。doctor --smoke はJSONを返す。実機の出力から要点を抜くと、認証情報は3つとも未設定(TYPESAFE_API_KEY・LLAMA_CLOUD_API_KEY・OPENAI_API_KEY がすべて false)、LibreOffice 24.2.7.2 を検出、PDF・DOCX・PPTXの3形式とも取り扱い可、そして local_ocr が failed だった。
local_ocr の失敗には理由がある。スキャンPDFを初めて読むとき、LiteParseは英語のOCR言語データ(tessdata)を github.com から取りに来る。この環境ではそこが塞がれているため、ページ1の時点で次のように落ちた。
[ocr] failed for page 1: failed to download tessdata for language "eng" from
https://github.com/tesseract-ocr/tessdata_best/raw/main/eng.traineddata: HTTP 403 Forbidden
同梱のサンプル5本(examples/real/originals/r01〜r05.pdf)はいずれも実物の官庁刊行物のスキャンで、全部が同じ場所で止まった。回避策は単純で、eng.traineddata をどこかに置き、その場所を TESSDATA_PREFIX で教えるだけでよい。ファイル自体は raw.githubusercontent.com から取得できた。
mkdir -p /tmp/tessdata
curl -sSL -o /tmp/tessdata/eng.traineddata \
  https://raw.githubusercontent.com/tesseract-ocr/tessdata_best/main/eng.traineddata
TESSDATA_PREFIX=/tmp/tessdata uv run docjev doctor --smoke
TESSDATA_PREFIX=/tmp/tessdata uv run docjev parse examples/real/originals/r04.pdf
これで local_ocr は passed に変わった。docjevのdoctorは、ラスタのみのPDFを1枚その場でOCRし、期待した数値が読めたかまで確認する作りになっている。実測値は次のとおりで、「OCRが動いていること」を別条件で示してから本番のPDFに進める構成は、検証手順としてよくできている。
| 実測項目 | 値 | 備考 |
|---|---|---|
| doctorのOCR確認 | status: passed / ocr_ms 252.66 | 1ページのラスタのみPDF。期待数値の検出に成功 |
| 10ページのスキャンPDF | 10ページ・54,477文字 | 米経済分析局の2025年7月個人所得統計(r04.pdf) |
| 3ページのPDF・初回 | 4.394秒 | OCRあり。キャッシュなしの状態 |
| 同・2回目 | 0.344秒 | .jev-docs/cache から再利用 |
| キャッシュ容量 | 2.4MB | サンプル数本を処理した時点 |
10ページのPDFから取り出したテキストは、統計表の見出しや連絡先の電話番号・メールアドレスまで拾えていた。一方で棒グラフの中の数値ラベルは読み取り結果が崩れており、「図の中の数字」をそのまま信用する用途には向かない。ページ本文のテキストとして使う分には十分な品質だ。
docjev parse --help を叩くと、OCRの切り替え口も確認できる。既定は --ocr liteparse(ローカル)で、--tier の既定値は agentic、--parser-version の既定は latest。クラウドOCRに切り替えるとこのティア指定が効き、LlamaParseのCost Effective・Agentic・Agentic Plusの3段階を選べる。--no-cache はローカルの再利用を止めると同時にサーバ側のキャッシュも無効化する。出力ファイルは既定で上書きされず、--overwrite を明示しない限り保護される作りだった。
検証環境:Linux(x86_64)/2026-09-21/docjev 0.1.0(main・9ed0fe0)。確認したのは uv sync・doctor –smoke・parse の3つ。classify と split は TYPESAFE_API_KEY が必要なため未検証。ローカル可視化アプリ(docjev demo)とLlamaParseの各ティア、GPT-5.6 Lunaとの比較画面も未検証。
判定を伴うコマンドはREADMEに次のように示されている。以下は実行していない(APIキー未取得のため)ことを明記しておく。
# 未検証:TYPESAFE_API_KEY が必要
uv run docjev classify examples/real/originals/r04.pdf \
  --rules examples/real/classify/rules.yaml

uv run docjev split examples/real/public-finance-packet.pdf \
  --rules examples/real/split/rules.yaml \
  --export-dir output/real-segments \
  --output output/real-split.json
公式ベンチマークの読み方——40文書で何が測られたか
docjevにはベンチマークが同梱されている。数字だけ拾うと「Jevは6倍速い」という話になりがちだが、リポジトリのレポートを読むと、そう単純ではない。
対象は英語圏の公的文書40本(カテゴリごとに8本、ユニークなページ数は116)。この40本を組み替えて5文書ずつの束を8つ作り、分類40件と分割8件の計48タスクを2エンジンで、合計96タスク回している。両エンジンには同じLiteParseのテキストが渡され、判定時間からOCRは除外、並列度1・リトライなしという条件だ。
| タスク | Jev 1.13.0 | GPT-5.6 Luna | Jev中央値 | Luna中央値 | 時間比 |
|---|---|---|---|---|---|
| 分類 | 40/40 正解 | 40/40 正解 | 138.6 ms | 794.3 ms | 5.73倍 |
| 分割 | 8束中7束が完全一致 | 8束中8束が完全一致 | 209.6 ms | 1,352.3 ms | 6.45倍 |
注目すべきは分割の1本の差だ。レポートによれば、両エンジンとも32個の真の境界をすべて発見し、同一カテゴリが隣接する4箇所の境界も取りこぼさず、116ページすべてに正しいラベルを付けている。差が出たのは、Jevが連邦準備制度の声明文の「実施に関する付属文書」の前に境界を1つ多く引いた点だけだ。凍結されたルールではそこは同じ刊行物の一部と扱うため不一致になったが、文書の切り方としてどちらが自然かは、運用ルール次第で評価が割れる種類の差である。
費用も記録されている。この1回の測定でJevの判定が約$0.0117、Lunaが約$0.0469、ウォームアップ込みの全体で$0.0681。準備段階(ローカルOCR)に56.6秒、課金の走る段階に58.1秒かかっている。ただしレポート自身が「Lunaの計測は入力の繰り返しによるキャッシュの恩恵をほぼ全面的に受けており、ここでは費用が安かった」と書き添えている。プロバイダのキャッシュ状態は制御されていない。
さらに古い「タイミングパイロット」も別に残っており、10ページのBEA刊行物と15ページの束を3回ずつ測って、分類182.5ms対785.4ms(4.30倍)、分割293.8ms対1,590.8ms(5.41倍)という数値が出ている。倍率が測定ごとに4.3〜6.45倍で動く事実のほうが、単一の倍率より実態に近い。
レポートは自ら制約を列挙している。小規模な便宜的サンプルであること、出典・テンプレートの系統が共有されていること、プロバイダのキャッシュが制御されていないこと、8束では分割精度の一般化はできないこと、信頼区間も再現安定性の主張も行わないこと、そして人手によるラベル検証は実施していないこと。速度差は再現性がありそうだが、精度差は8束の観察にすぎない。
代替手段との比較とライセンス・採用判断
同じ問題に対する選択肢は主に3つある。マルチモーダルLLMに直接PDFを投げる、ベンダーのドキュメント理解APIを使う、そしてdocjevのようにOCRと判定を分ける。それぞれの性質は次のように整理できる。
| 観点 | docjev(Jev判定) | 汎用LLMに直接投げる | ベンダーのDocument AI |
|---|---|---|---|
| 出力の形 | 型で固定・スキーマ外に出ない | 生成物をパースして検証が要る | 製品ごとの固定スキーマ |
| カテゴリ定義 | 自然文のYAML・学習不要 | プロンプト | 事前学習またはテンプレート登録 |
| 分割の指示 | splitting_instructions で別途記述 |
プロンプト内に混在 | 製品仕様に依存 |
| 判定の所要時間 | 中央値138.6ms(同梱ベンチ) | 中央値794.3ms(同条件のLuna) | 製品による |
| OCRの実行場所 | ローカル(LiteParse)/任意でクラウド | 通常はモデル側 | クラウド |
| 判定のオフライン化 | 不可(Jevはホスト型) | モデル次第 | 不可 |
| ライセンス | Apache-2.0 | — | 商用契約 |
docjevの位置はこの表の左端に固有だ。OCRをローカルに閉じつつ、判定だけを外部の確率モデルに出す。文字起こしの結果を自分で確認・保存でき、ルールを変えて何度も判定し直せる構成は、仕分け規則が固まっていない導入初期に向く。
逆に採用を待つべき条件もはっきりしている。判定をオフラインで完結させたい場合、docjevだけでは要件を満たさない。READMEも「Jevはホスト型のサービスであり、ローカルOCRは推論をオフラインにしない」と明記している。判定側まで自分の設備に置きたいなら、Jevと同じwire APIを自前GPUで提供する OpenJev のような選択肢を別途組み合わせる必要がある。Jev対応のOSSがどの層に何本あるかはJev対応OSS 11選|ブラウザ操作・MCP・コードレビュー・Claude Code文脈選別まで実測で見る使いどころで一覧にしている。
成熟度の評価も冷静に見ておきたい。バージョンは0.1.0でリリースタグは1つも切られておらず、既定ブランチの最新コミットは2026-09-19。star 143は公開直後の数字で、長期のメンテナンス実績を示すものではない。ライセンスはLICENSE実体ファイルの先頭2行がApache License Version 2.0であることを確認済みで、NOTICEファイルも同梱されている。業務に入れるなら、今の時点ではバージョンをコミットハッシュで固定し、.jev-docs/ のキャッシュ形式が変わる前提で運用したほうが安全だ。
取り出したページテキストを検索や質問応答に回すなら、その先は別の設計問題になる。分割された文書を索引に載せる流れはRAGとは?仕組み・構築・ベクトルDB選定までの2026年実装マップの範囲だ。docjevはその前段、つまり「何が1つの文書か」を決める工程を担当する道具だと捉えるのがいい。
まとめ——docjevはどんなチームに向くか
docjevは、書類の仕分けを「LLMに文章で答えさせる」構図から外し、文字起こしと判定に分解して、それぞれに向いた道具を当てる実装だ。実機で確認できた範囲では、インストールは uv sync の一発で通り、doctorがOCRの可否をその場で陽性確認まで含めて教えてくれる。スキャンPDFの初回に必要な言語データの取得だけは環境によって詰まるが、TESSDATA_PREFIX で回避できることも確かめた。
待ったほうがよい:判定までオフラインで完結させたい要件。分類理由の説明文が必要な業務。バージョン固定なしで本番に載せたい場合(タグ未発行の0.1.0)
本記事で確かめていないのは判定そのものだ。classify と split は TYPESAFE_API_KEY を要するため実行しておらず、掲載した精度・速度の数値はすべてリポジトリ同梱のレポートからの引用である。自分の書類で試すときは、まず docjev parse でテキストが期待どおり取れるかを無課金で確認し、それから判定に進むのが手戻りの少ない順序になる。
参照ソース
・jerryjliu/docjev(公式リポジトリ) — README・LICENSE・pyproject.toml(2026-09-21時点で確認)
・40文書の精度パイロット レポート — 分類・分割の正解数、中央値、費用の記録
・LiteParse(PyPI) — 実機で導入された2.14.6のメタデータ(tessdata_pathオプションの記載)