jev-seo は、ホームページのURLを1本渡すだけでサイト全体のSEO監査を作るPython製のツールだ。巡回して52のルールで検査し、ページの意味だけを Jev に型つきで聞き、PDF・Excel・Markdownを同じ audit.json から生成する。MITライセンス、⭐361(2026-10-01時点)。興味を持ったのは性能ではなく設計のほうで、この道具はLLMに文章を書かせたあと、その文章を機械で検査して突き返す。実際にそこまで動くのかを確かめた。
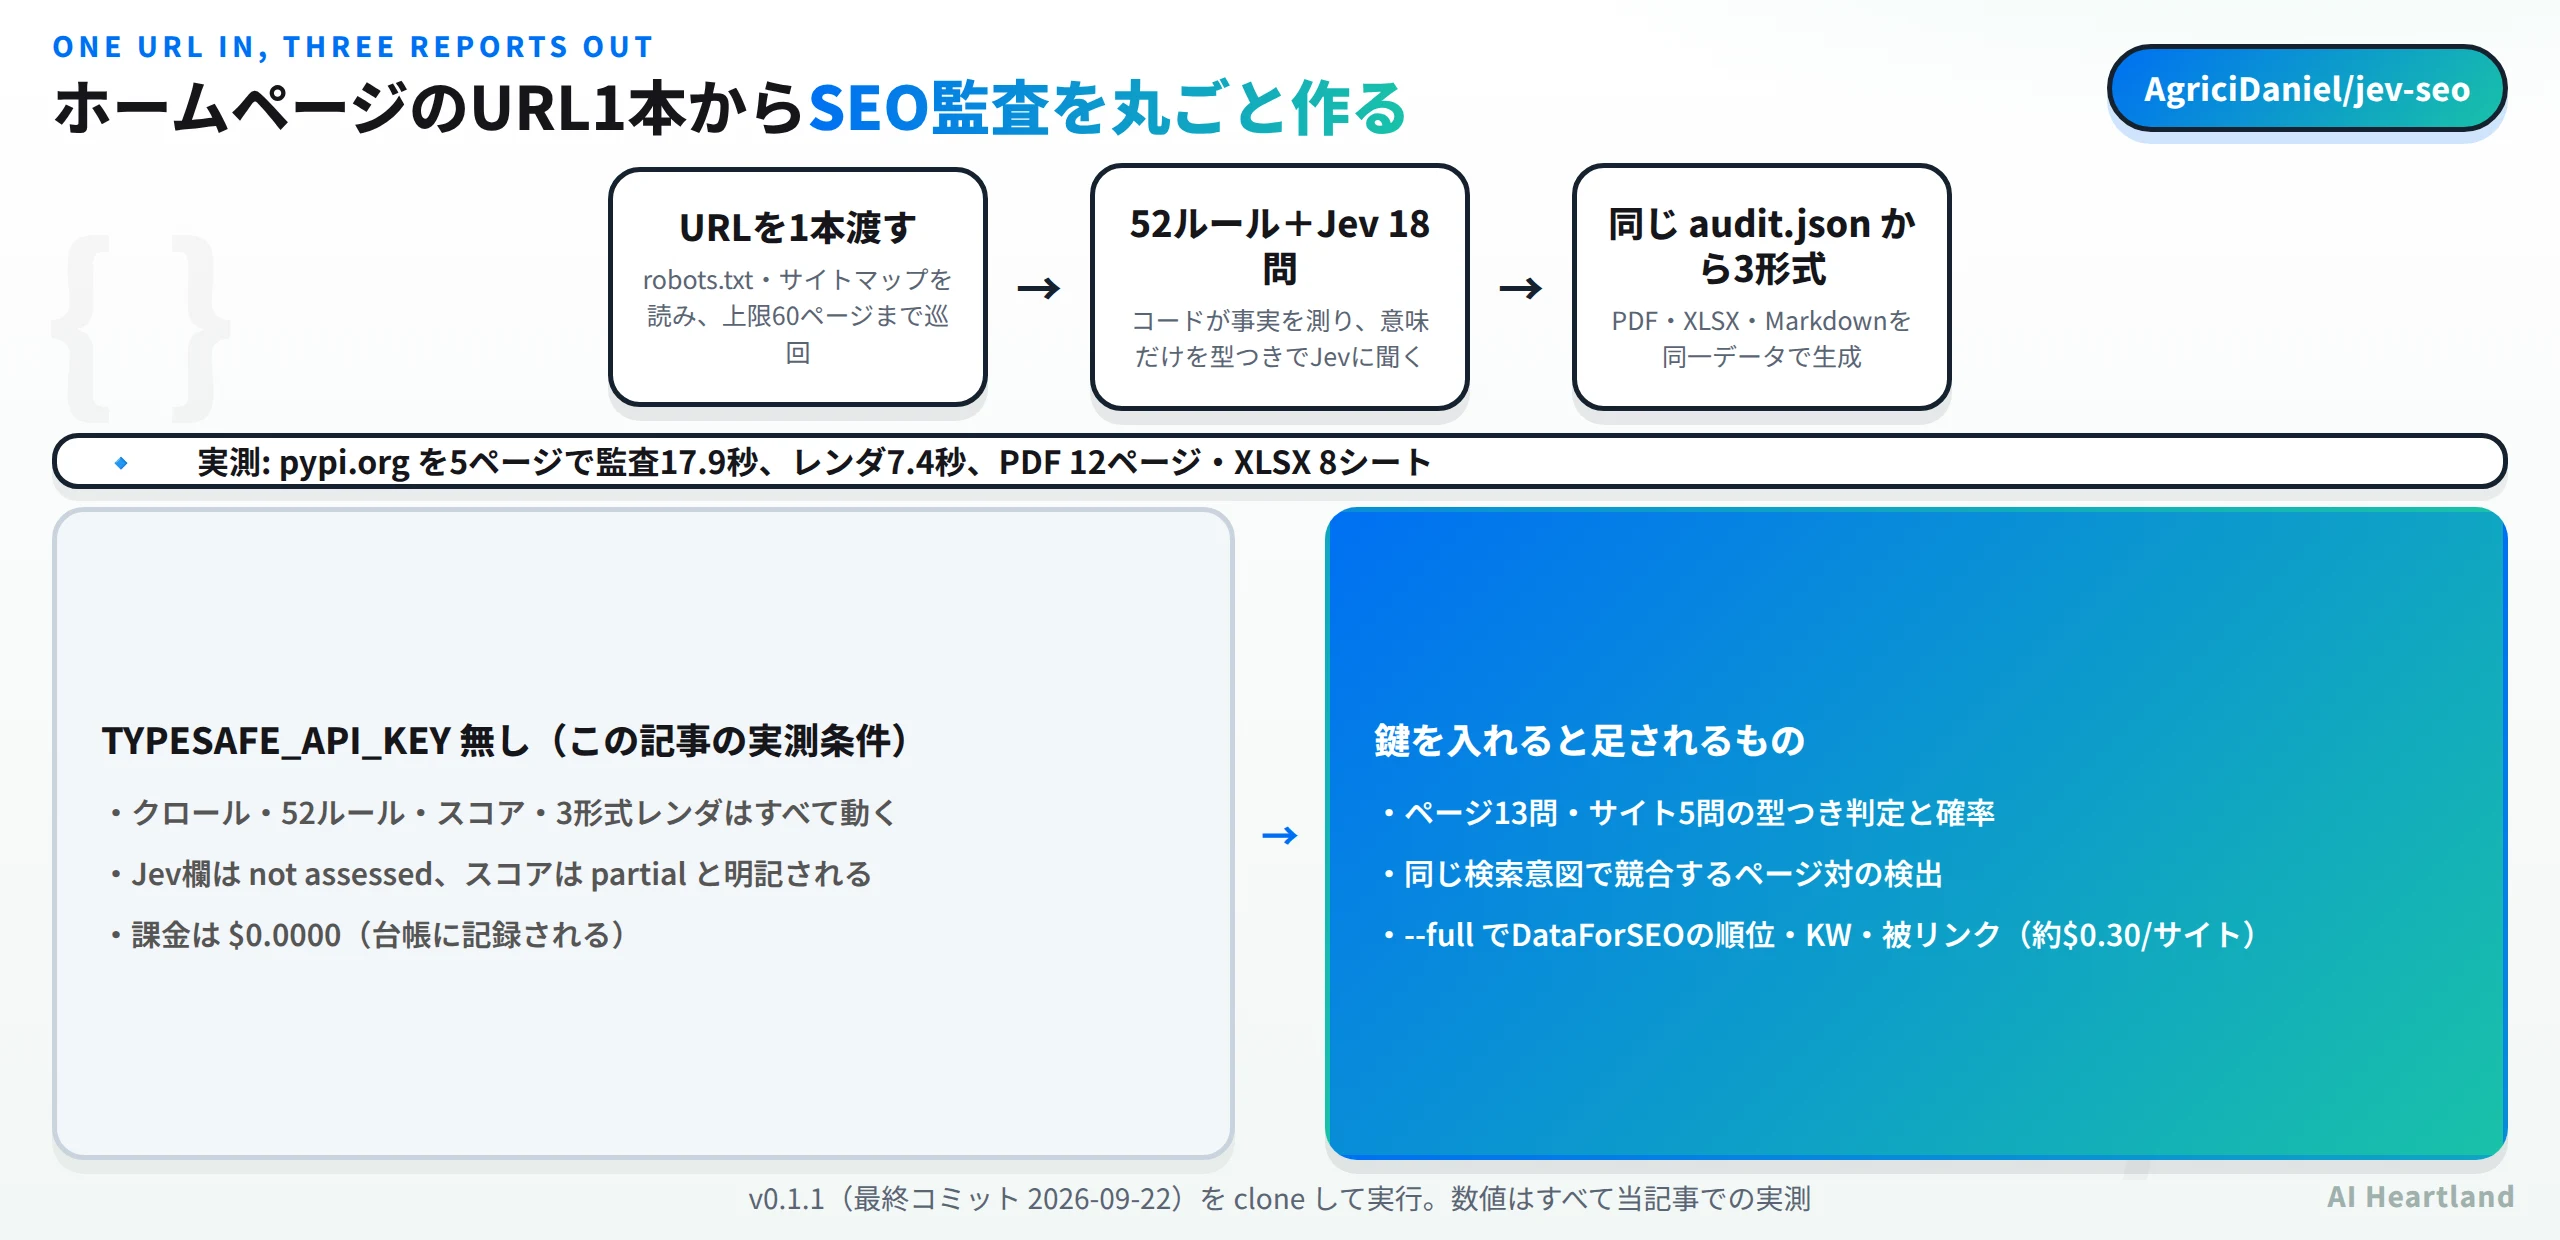
- ・URL1本でクロール→52ルール→Jev判定→採点→**PDF・XLSX・Markdown**を1コマンドで作る
- ・**APIキー無しでも全工程が動く**。Jev欄は not assessed、スコアは partial と明示される
- ・実測:pypi.org を5ページ、**監査17.9秒・レンダ7.4秒・PDF 12ページ・XLSX 8シート**
- ・ルールは**52本ちょうど**(違反11+通過41を `audit.json` で数えて一致)
- ・Jevに聞くのは**サイト5問+ページ13問**。コードが見れば分かることは聞かない設計
- ・**3つの拒否を再現**:ループバック宛のクロール、存在しないアクションID、監査に無い数値
LLMの仕組みやモデルの使い分けはLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめてある。本記事はその枝として、「文章を返さない判定モデル」を実務ツールに組み込むとどういう形になるかを見る。
jev-seoとは:URL1本でSEO監査を1本作る道具
リポジトリは 2026-09-22 に作られ、最新コミットも同日の 55a184a。バージョンは 0.1.1、Python 3.10以上、MITライセンス(同梱フォントの Inter と JetBrains Mono は SIL OFL)。Pythonのコードは11ファイル・2,566行と、この種のツールとしては小さい。
やることは単純だ。ホームページのURLを1つ渡すと、robots.txt と Crawl-delay を尊重しながら既定で最大60ページまで巡回し、集めた事実を52のルールにかけ、ページの意味を Jev に聞き、Core Web Vitals を PageSpeed Insights から取り、全部を1つの audit.json にまとめてから3形式にレンダリングする。
工程は実行時のログにそのまま出る。
robots.txt・サイトマップ・ページ"] --> B["2/7 ルール検査
52本"] B --> C["3/7 DataForSEO
--full のときだけ"] C --> D["4/7 Jev判定
サイト5問・ページ13問"] D --> E["5/7 PageSpeed
Core Web Vitals"] E --> F["6/7 採点
audit.json を書く"] F --> G["7/7 レンダ
PDF・XLSX・Markdown"]
注目したのは、Jev がどこに置かれているかだ。Jev は文章を生成しないSystem Oneモデルで、choice / noul / score という型つきの判定だけを返す。このツールはその性質を前提に、集計と事実の確認をコードに、意味の判断だけを Jev に割り振っている。当サイトが tools/jev_seo.py でやっていることと考え方は同じだが、対象と守備範囲が違う。そこは最後の節で比べる。
同じ名前で紛らわしいものは無いか確認した。pyproject.toml の name は jev-seo、version は 0.1.1 だが、PyPI に jev-seo も jevseo も存在しない(どちらも JSON API が 404 を返すことを確認した)。pip install ではなく clone して使う形になる。Jev 対応OSSの全体像はJev対応OSS 11選|ブラウザ操作・MCP・コードレビュー・Claude Code文脈選別まで実測で見る使いどころにまとめてあるが、SEO監査という用途はそこには無かった系統だ。
鍵なしで実走させる:pypi.orgを5ページ監査した17.9秒
READMEは「標準モードは1サイト1セント前後」「1〜4分」と書いている。鵜呑みにせず、TypeSafeのAPIキーを持たない状態で動かした。READMEには「鍵が無くても監査は動き、Jev部分は not assessed、スコアは partial になる」とあるので、そこがそのとおりかも同時に確かめられる。
手元の環境(Linux・Python 3.11.15)で入れて、まず doctor を叩いた。
git clone https://github.com/AgriciDaniel/jev-seo.git
cd jev-seo
python3 -m venv .venv && . .venv/bin/activate
pip install -r requirements.txt
cp .env.example .env            # キーは入れない
bin/jevseo doctor
返ってきたのはJSONで、依存とキーの有無だけが並ぶ。
・weasyprint matplotlib openpyxl などは ok
・playwright は missing (playwright)(JavaScript依存ページは生HTMLで監査される旨の注記つき)
・TYPESAFE_API_KEY は missing: Jev judgments will be skipped
・PAGESPEED_API_KEY は missing: PageSpeed runs unkeyed and may be rate limited
キーの値は一切出力されない。有無だけを返す実装で、ログを貼って相談するときに事故りにくい。地味だが良い。
次に本番。当サイト自身を監査したかったが、この検証環境の外向き通信は許可制で ai-heartland.com に到達できなかったため、到達できた公開サイトのうち robots.txt が明示されている pypi.org を、5ページだけ、PageSpeed を切って監査した。相手のサーバへの負荷は数リクエストで、robots.txt と Crawl-delay はツール側が守る。
bin/jevseo audit https://pypi.org --max-pages 5 --no-psi --out ./out
bin/jevseo render ./out
監査の出力(抜粋、実行そのまま)はこうなった。
[jevseo 00:00] == 1/7 Crawl: robots.txt, sitemaps, then pages
[jevseo 00:09] robots.txt found; sitemap URLs 188068
[jevseo 00:17] == 2/7 Rule checks
[jevseo 00:17] 11 rule findings from 52 rules
[jevseo 00:17] == 4/7 Jev judgments: 3 pages, budget $0.25
[jevseo 00:17] TYPESAFE_API_KEY not found: Jev judgments skipped; semantic sections will be marked not assessed.
[jevseo 00:17] score 96 (A, partial), 10 actions, Jev $0.0000
監査17.9秒、レンダ7.4秒。READMEの「1〜4分」は60ページ想定なので、5ページならこのくらいで妥当だ。出来上がったものを数えた。
| 生成物 | 実測 |
|---|---|
audit.json |
298,815バイト(全データの単一ソース) |
report.pdf |
12ページ・204,682バイト |
report.xlsx |
8シート(Summary / Actions / Pages / Jev judgments / Technical / Performance / Charts / Method)・255,199バイト |
report.md |
9,971バイト |
digest.md |
3,507バイト(エージェントが読む要約) |
charts/ |
PNG 11枚 |
同梱の実例(--full・59ページ) |
report.pdf は 21ページ |
面白いのは、鍵が無くても Jev judgments シートも Jev の台帳も必ず出ることだ。audit.json の jev.ledger は requests: 0, failed: 0, input_tokens: 0 と0のまま記録される。「使わなかった」ことが記録として残る形になっている。
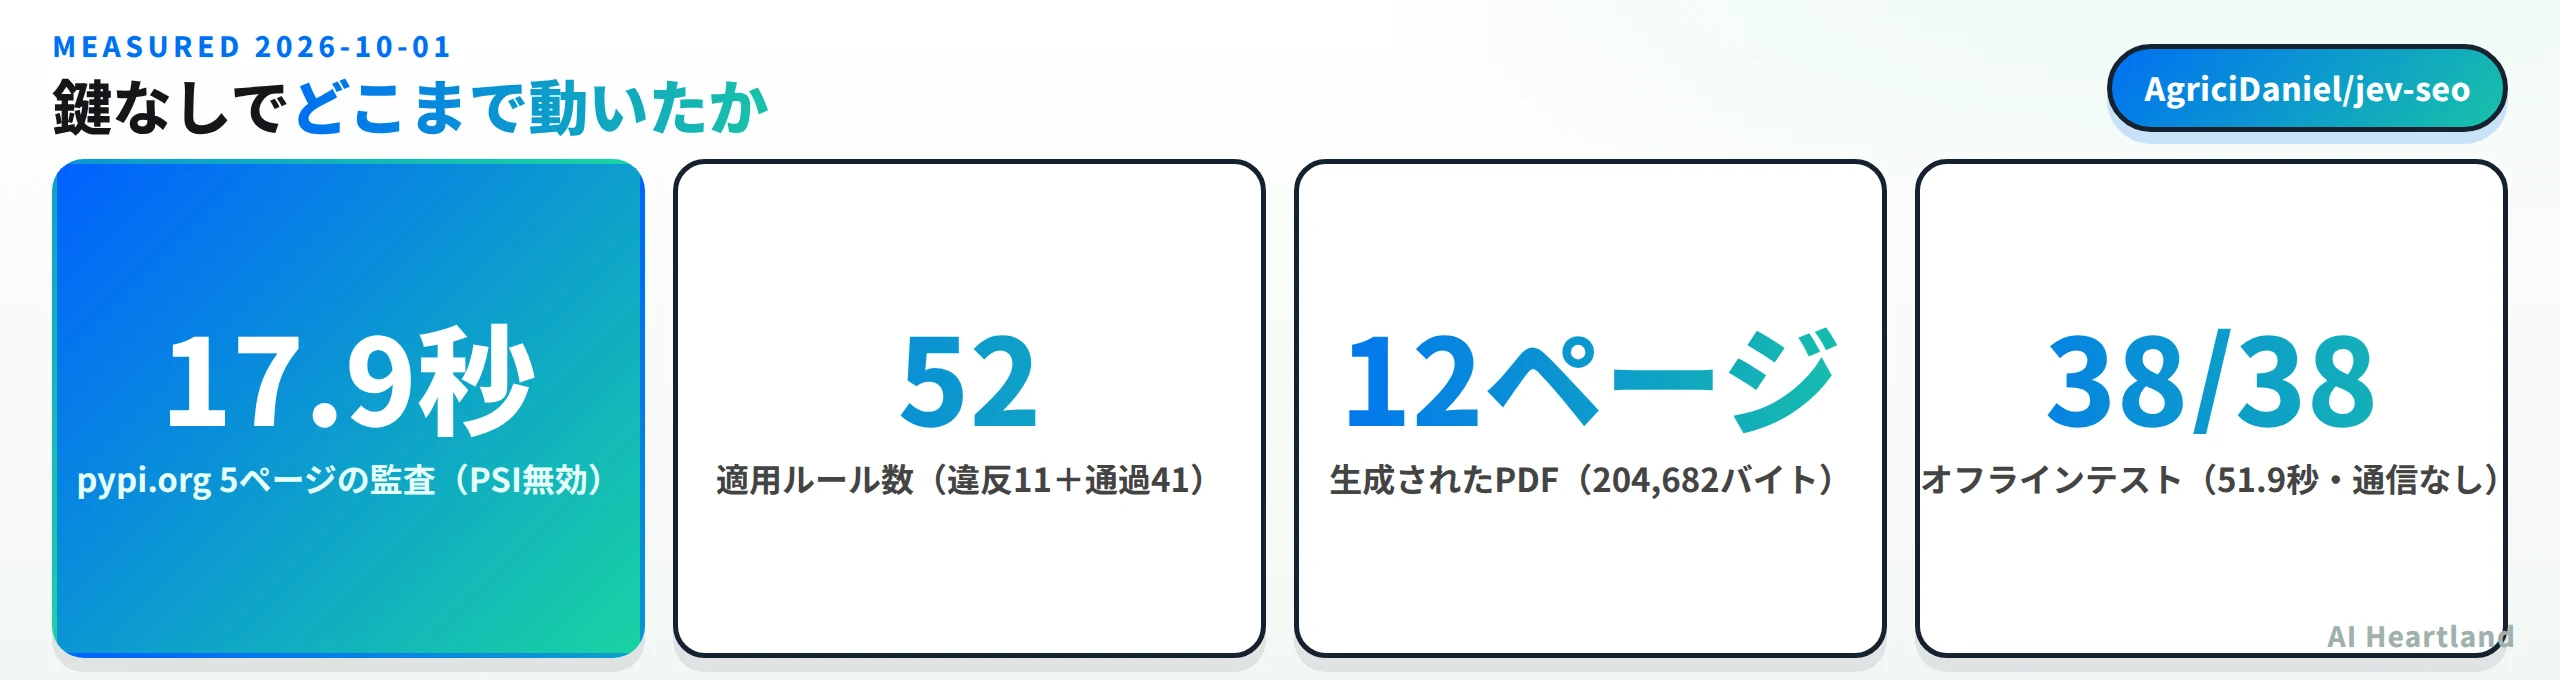
オフラインテストも通した。python -m unittest discover -s tests -v で 38本すべて通過、51.9秒、通信もキーも不要。テスト名を見ると test_malformed_jev_response_is_recorded_not_raised(Jevの壊れた応答は例外にせず記録する)、test_missing_usage_still_counts_toward_budget(usageが返らなくても予算に計上する)、test_no_jev_audit_renders_and_is_marked_partial(Jev無しでもレンダして partial と印字する)といった、外部APIが期待どおりに振る舞わない側を明示的に固定している。
52ルールとJev 18問の役割分担
READMEの「52 rules」は看板数値なので、コードの出力で数え直した。audit.json の findings(違反)が11件、passed_rules(通過)が41件。ユニークなルールIDを集合にするとちょうど52で、公称と一致する。
ルールの粒度は、たとえばこうだ(実際の出力から)。
- JEV-001 P2 impact 100 effort 2 [rule/structured/medium] No structured data on the homepage x1
- JEV-003 P2 impact  73 effort 1 [rule/onpage/medium]     Pages without a meta description x1
- JEV-005 P2 impact  33 effort 1 [rule/crawl/low]         Indexable pages missing from the sitemap x3
1件ごとに アクションID(JEV-###)・優先度・インパクト・工数・カテゴリ・深刻度・根拠・直し方・公式の出典URL が付く。出典は Google Search Central の該当ページで、heuristic フラグが別に立っていて、検索エンジンの要件ではなく編集上の慣習にすぎないルールは正直に heuristic と印字される。AIクローラの可否も10種(GPTBot・OAI-SearchBot・ChatGPT-User・ClaudeBot・Claude-SearchBot・PerplexityBot・Google-Extended・Applebot-Extended・CCBot・Bytespider)を個別に見ていた。
対して Jev に聞くのは18問だ。references/judgments.md の表を数えると、サイト5問・ページ13問で、これも公称どおり。
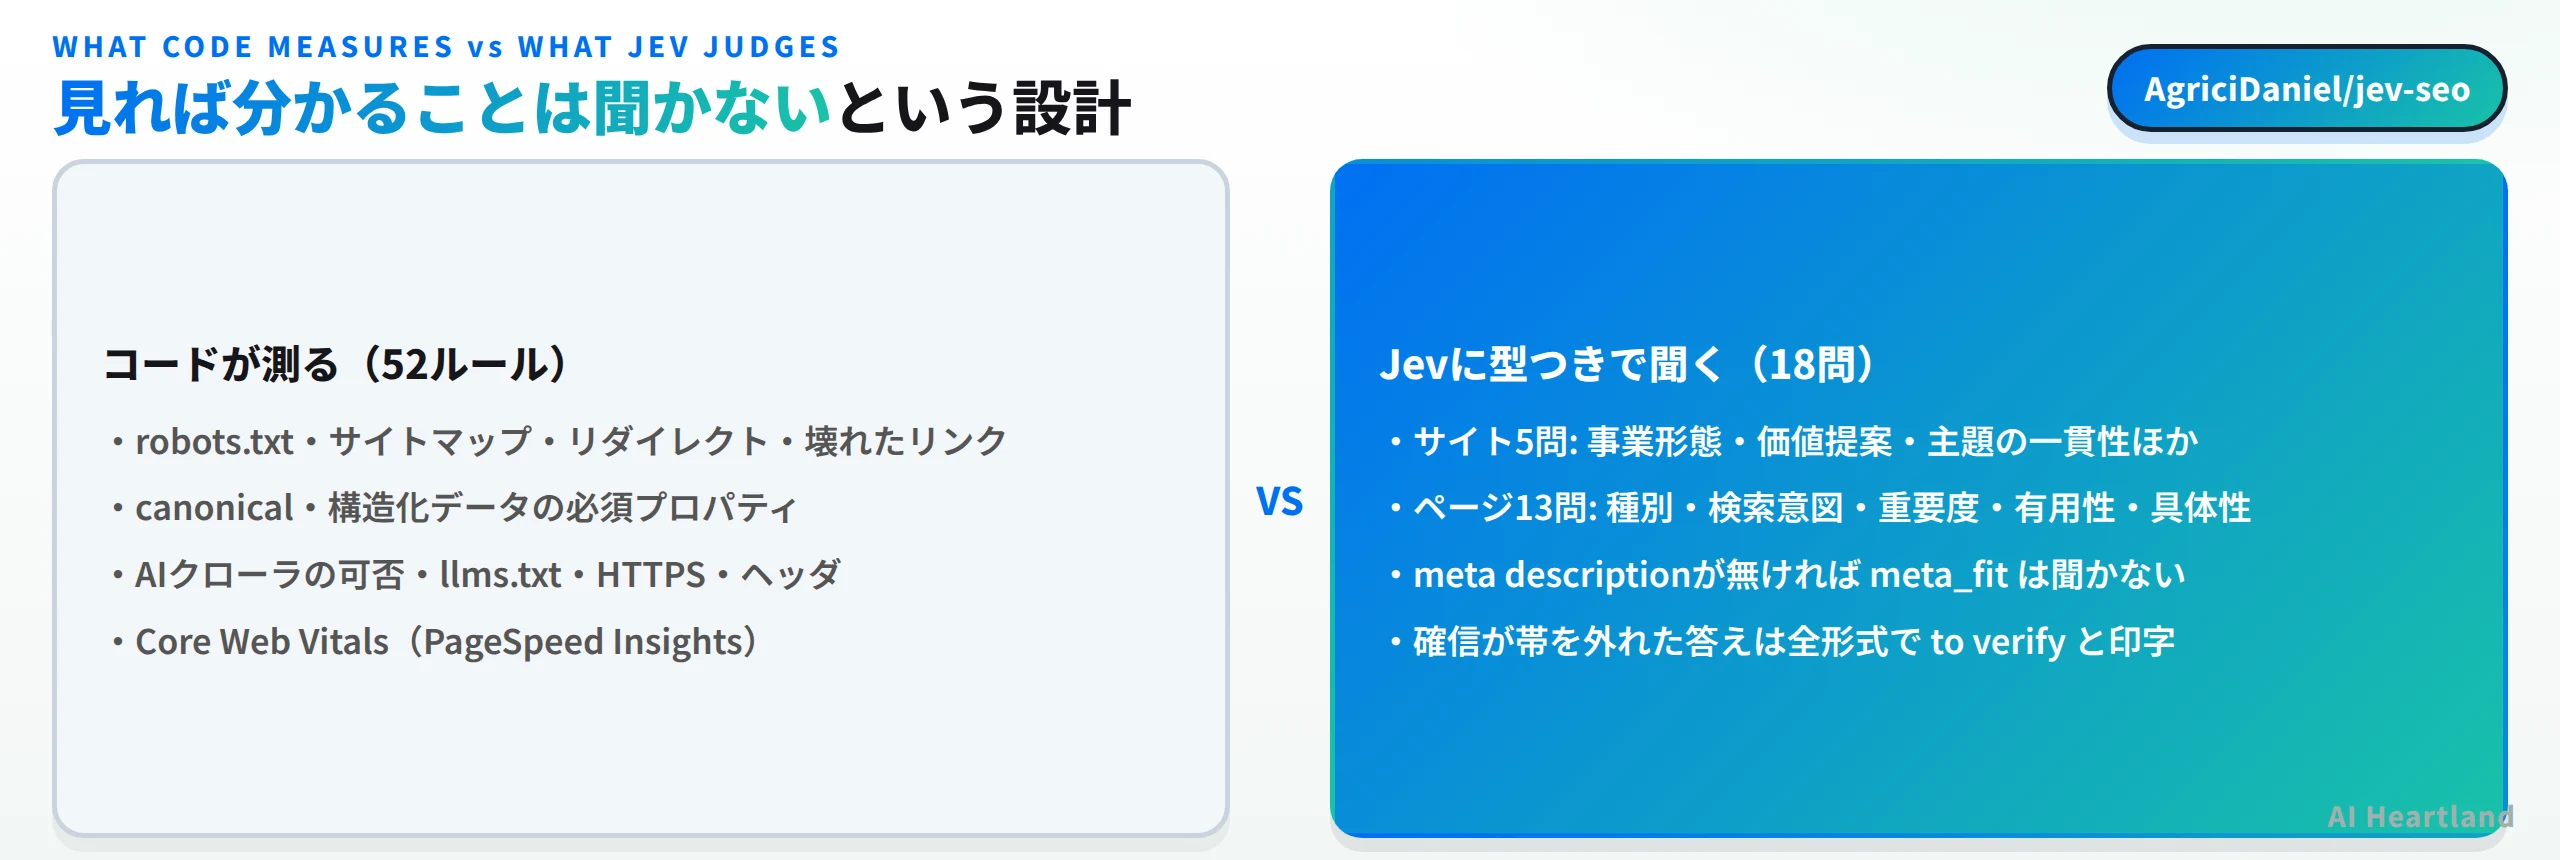
設計規則として明文化されているものが、読んでいていちばん納得できた部分だった。
・コードが見れば分かることは聞かない。meta description が無ければ meta_fit を聞かないし、H1が無ければ h1_fit を聞かない
・Choice には必ず「該当なし」の選択肢を置く(other / unclear)
・Score の水準は状況の記述で、0〜1に score / (levels - 1) で正規化する。1〜10に引き伸ばさない
・ページ本文は6,000字で打ち切り、打ち切ったこと自体を state に立てる
・ホームページの種別はコードが決め、Jevには聞かない
そして決定帯の定義が明快だ。Choice は confidence 0.80以上で決定的、Score は確率の0.80以上が中央値の片側に寄っていれば決定的(隣り合う水準に割れているのは迷いとみなさない)、Noul は confidence を持たないので P(yes) が 0.80以上か 0.20以下で決定的。それ以外はすべて「to verify」として全形式に印字される。以前Decisions APIとは|Jevの対抗馬と同名OSS実装の差をスキーマ15ケースで実測で confidence が確率そのものではないことを確かめたが、この実装はそこを踏まえて閾値ではなく帯で扱っている。
references/evaluation.md には 2026-09-22 時点の自己評価も載っている。同じ59ページを2回判定してスコアの移動が平均0.03以下、確信のあるページ型は44/44一致。別モデルを盲検の第二判定者に置いた一致率は helpfulness と specificity で28/29、answer-first 23/23、next step 16/16、キーワード関連性 27/30。ただしリポジトリ自身が「第二判定者は人間ではないので、これは Jev が一貫していて妥当だと示すだけで、正しいと示すものではない」と書いている。当記事の環境では鍵が無いためこの評価は再現できていない(未検証)。
jev-seoが拒んだ3つのこと
このツールを評価する上で一番確かめたかったのは、断る側の実装だ。3つ試した。
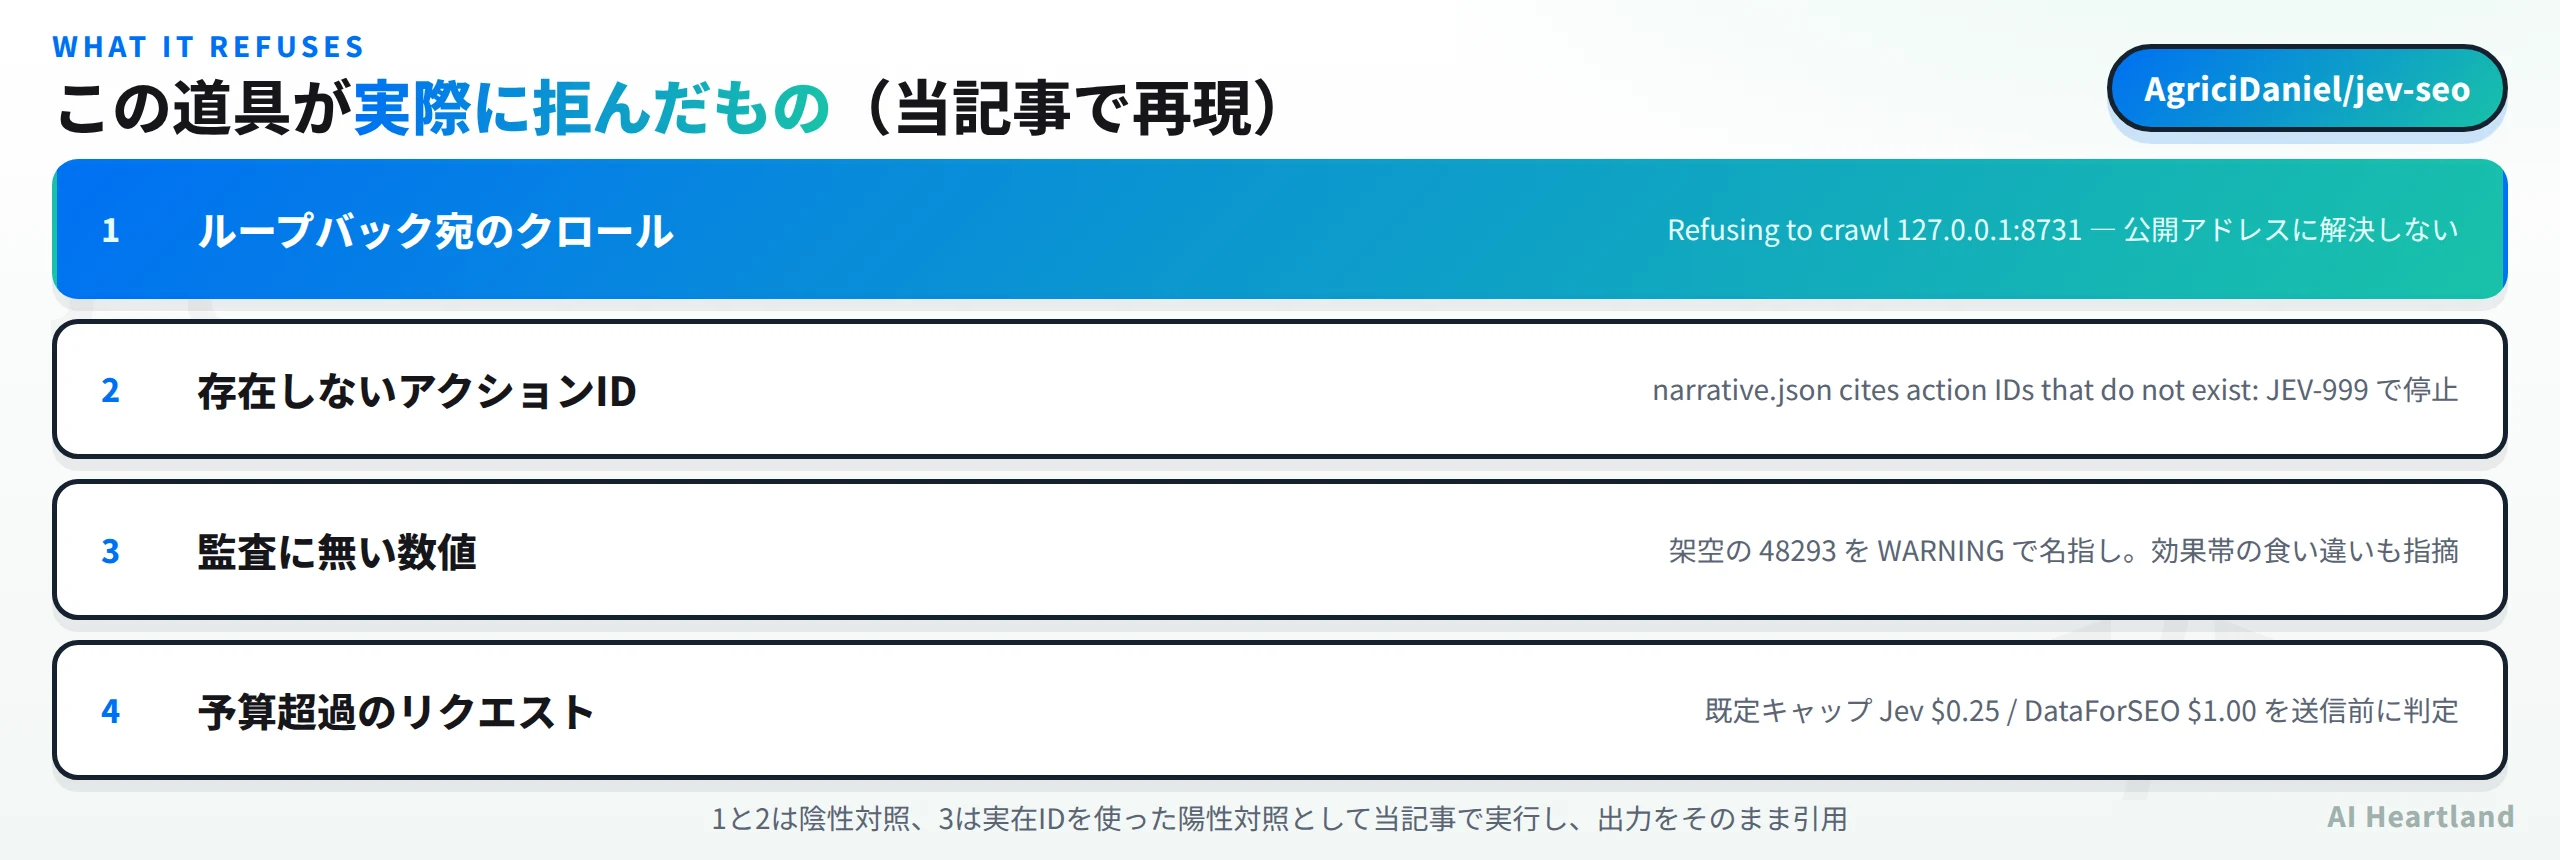
1つ目はSSRFガード。手元で静的サーバを立てて http://127.0.0.1:8731 に向けたところ、クロールの最初で止まった。
Refusing to crawl 127.0.0.1:8731: it does not resolve to a public address.
crawl.py を読むと、名前解決した結果が is_private / is_loopback / is_link_local / is_reserved / is_multicast のいずれかなら拒否する実装で、しかもリダイレクトを自前で追って各ホップに同じ判定をかけている。URLを人から受け取って巡回する道具としては当然の備えだが、実際に入っているものは多くない。陽性対照として、先ほどの pypi.org(公開アドレス)は同じコードパスを通って普通に巡回できている。
2つ目は、LLMが書いた文章の検査だ。このツールのClaude Codeスキルは、監査後に digest.md を読んでエグゼクティブサマリを narrative.json に書く。そこに存在しないアクションIDを混ぜてみた。
# 陰性対照: 監査に存在しない JEV-999 を narrative.json に書いてレンダする
python3 - <<'PY'
import json, pathlib
n = {"executive_summary": ["構造化データが最大の課題で、JEV-999 を最優先とする。"],
     "strengths": ["HTTPSとヘッダは問題なし。"],
     "risks": ["JEV-999 構造化データが無い。"],
     "plan": [{"horizon": "This week", "items": ["JEV-999 JSON-LDを追加する (hours)"]}]}
pathlib.Path("./out/narrative.json").write_text(json.dumps(n, ensure_ascii=False))
PY
bin/jevseo render ./out
# => narrative.json cites action IDs that do not exist: ['JEV-999']
レンダは停止した。警告ではなく SystemExit で、レポートは作られない。report/__init__.py は narrative.json の全文から JEV-\d{3} を正規表現で拾い、audit.json の実在IDとの差集合が空でなければそこで打ち切る。
3つ目は数値の検査。同じファイルを、今度は実在するID(JEV-001)にしたうえで、監査のどこにも無い「48293」という数字と、アクション表と食い違う工数帯を書き込んだ。こちらは陽性対照で、レンダ自体は通る。
WARNING narrative effort mismatch: JEV-001 says 'several days' but the action table says 'about a day'
WARNING narrative.json contains numbers not found in the audit: 48293. Check them against digest.md and re-render.
両方とも名指しで出た。unverified_numbers() はURL・日付・アクションIDを本文から除いてから数字を拾い、丸めやミリ秒→秒の換算まで許容したうえで、それでも監査データのどこにも無い数値だけを報告する。effort_mismatches() は計画項目の末尾の工数表記(hours / about a day / several days / a project)をアクション表と突き合わせる。
references/narrative.md の書き方規則も、そのまま編集ガイドラインとして読める内容だった。「すべての主張は digest か自分で確認した事実から取る。新しい数字を発明しない」「ルールが測ったことと Jev が判断したことを分けて書く」「『owns』『dominates』『healthy』のような宣伝語を使わない」「『every』『all』『none』は digest がそう示しているときだけ」。LLMに書かせる前提で、書かせてよい範囲を契約として先に決めてある。
コストと上限:1サイト1セント、キャップは送信前に効く
料金の設計も見ておく。
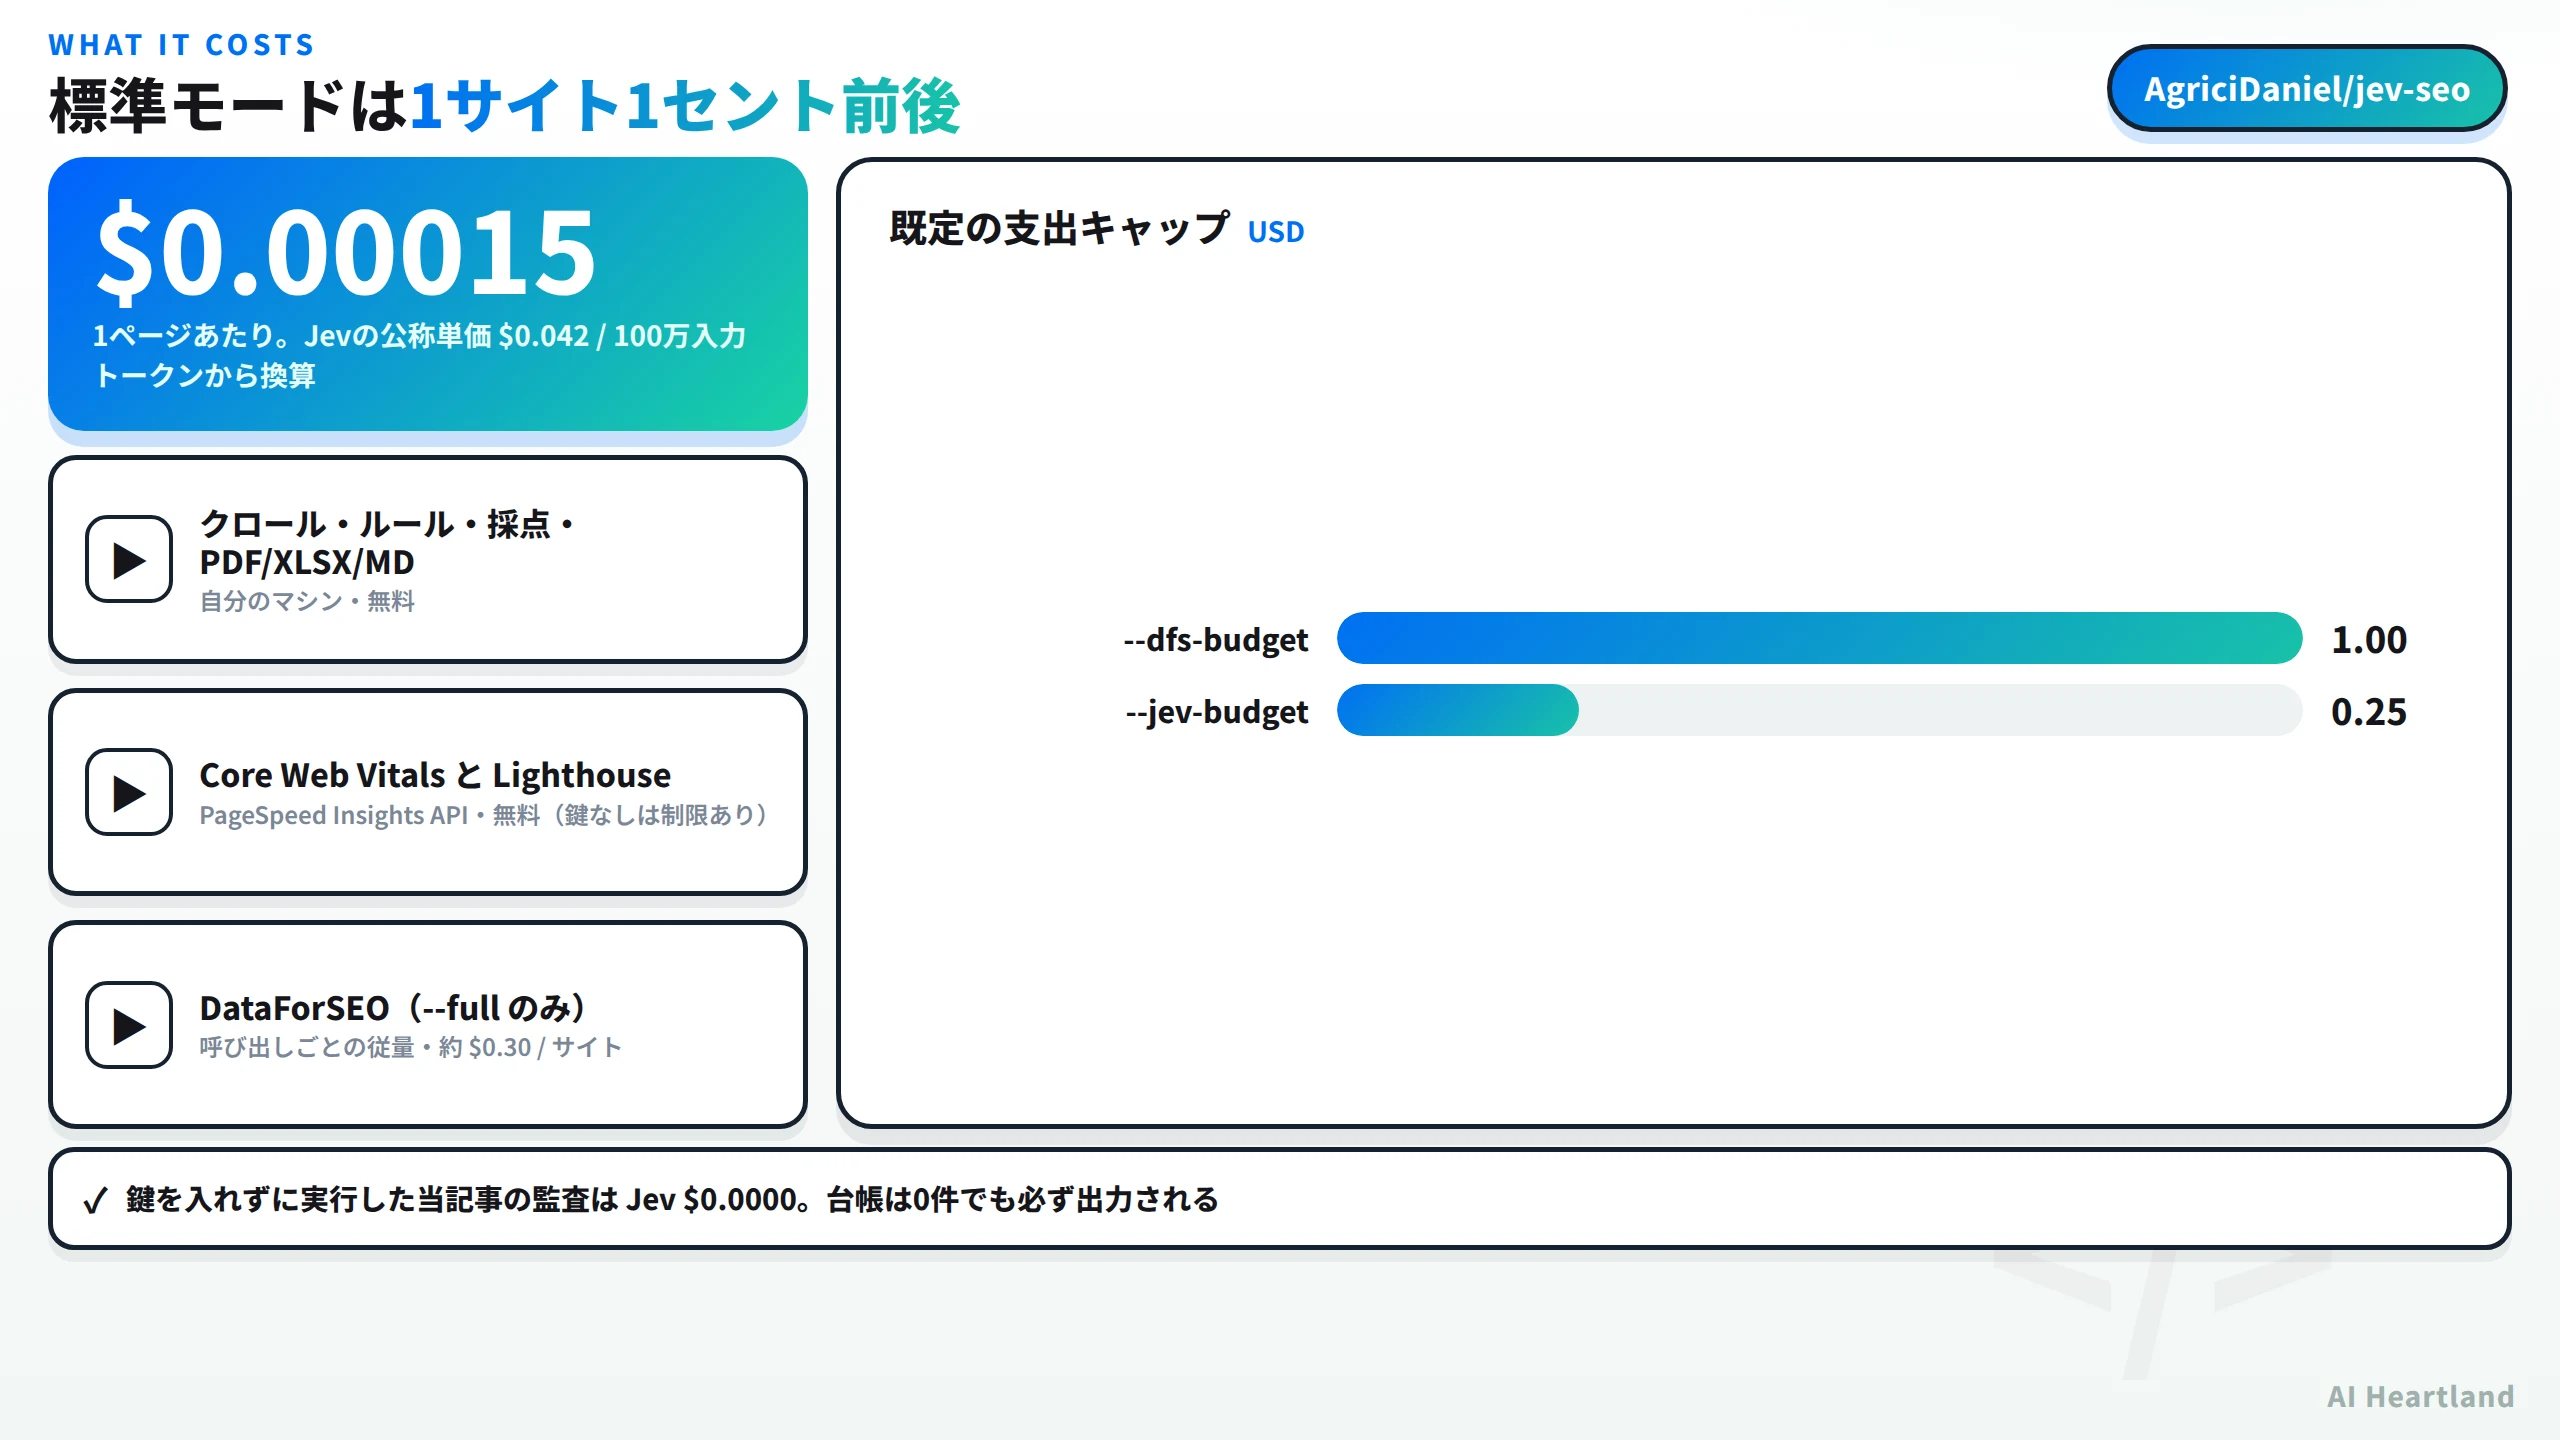
jev.py の先頭には単価がコメント付きで定数になっている。
USD_PER_MTOK = 0.042 # docs.typesafe.ai/models, retrieved 2026-09-20; re-check with the Jev brain staleness rule
取得日つきで、しかも「古くなっていないか確かめ直せ」と書いてある。価格の定数をこう扱っているのは珍しい。1ページあたり約0.00015ドル、1サイトで1セント前後という説明はこの単価からの換算だ。
上限の効き方も重要で、--jev-budget(既定0.25ドル)と --dfs-budget(既定1.00ドル)はリクエストを送る前に判定される。送信前の見積もりは本文の長さを3で割った保守的なトークン数で、超えそうなら送らずに skipped_budget を1増やす。さらに、APIが usage を返さなかった場合でも見積もり値を予算に計上する——先ほどのテスト test_missing_usage_still_counts_toward_budget はまさにそこを固定している。上限の甘いところから漏れる、という典型的な事故を潰してある。
限界もREADMEが自分で書いている。大きいサイトはページ上限(既定60)でサンプリングされ、レポートにその旨が出る。Jevの閾値は人手のラベルに対してまだ調整されていない。PageSpeed のラボスコアは実行ごとにぶれ、フィールドデータはChromeの流量が足りるサイトにしか存在しない。DataForSEOの検索ボリューム・難易度・流入は推定値。「これは証拠を作る道具であって、順位トラッカーでも Search Console の代わりでもない」と明記されている。
当サイトの tools/jev_seo.py とどう違うか
当サイトは tools/jev_seo.py(1,773行)という自前のJev活用ツールを持っていて、「Jev を SEO に活用する15の方法」をどこまで実装できたかの対応表を知識ファイルに置いている。名前が近いので、違いをはっきりさせておく。
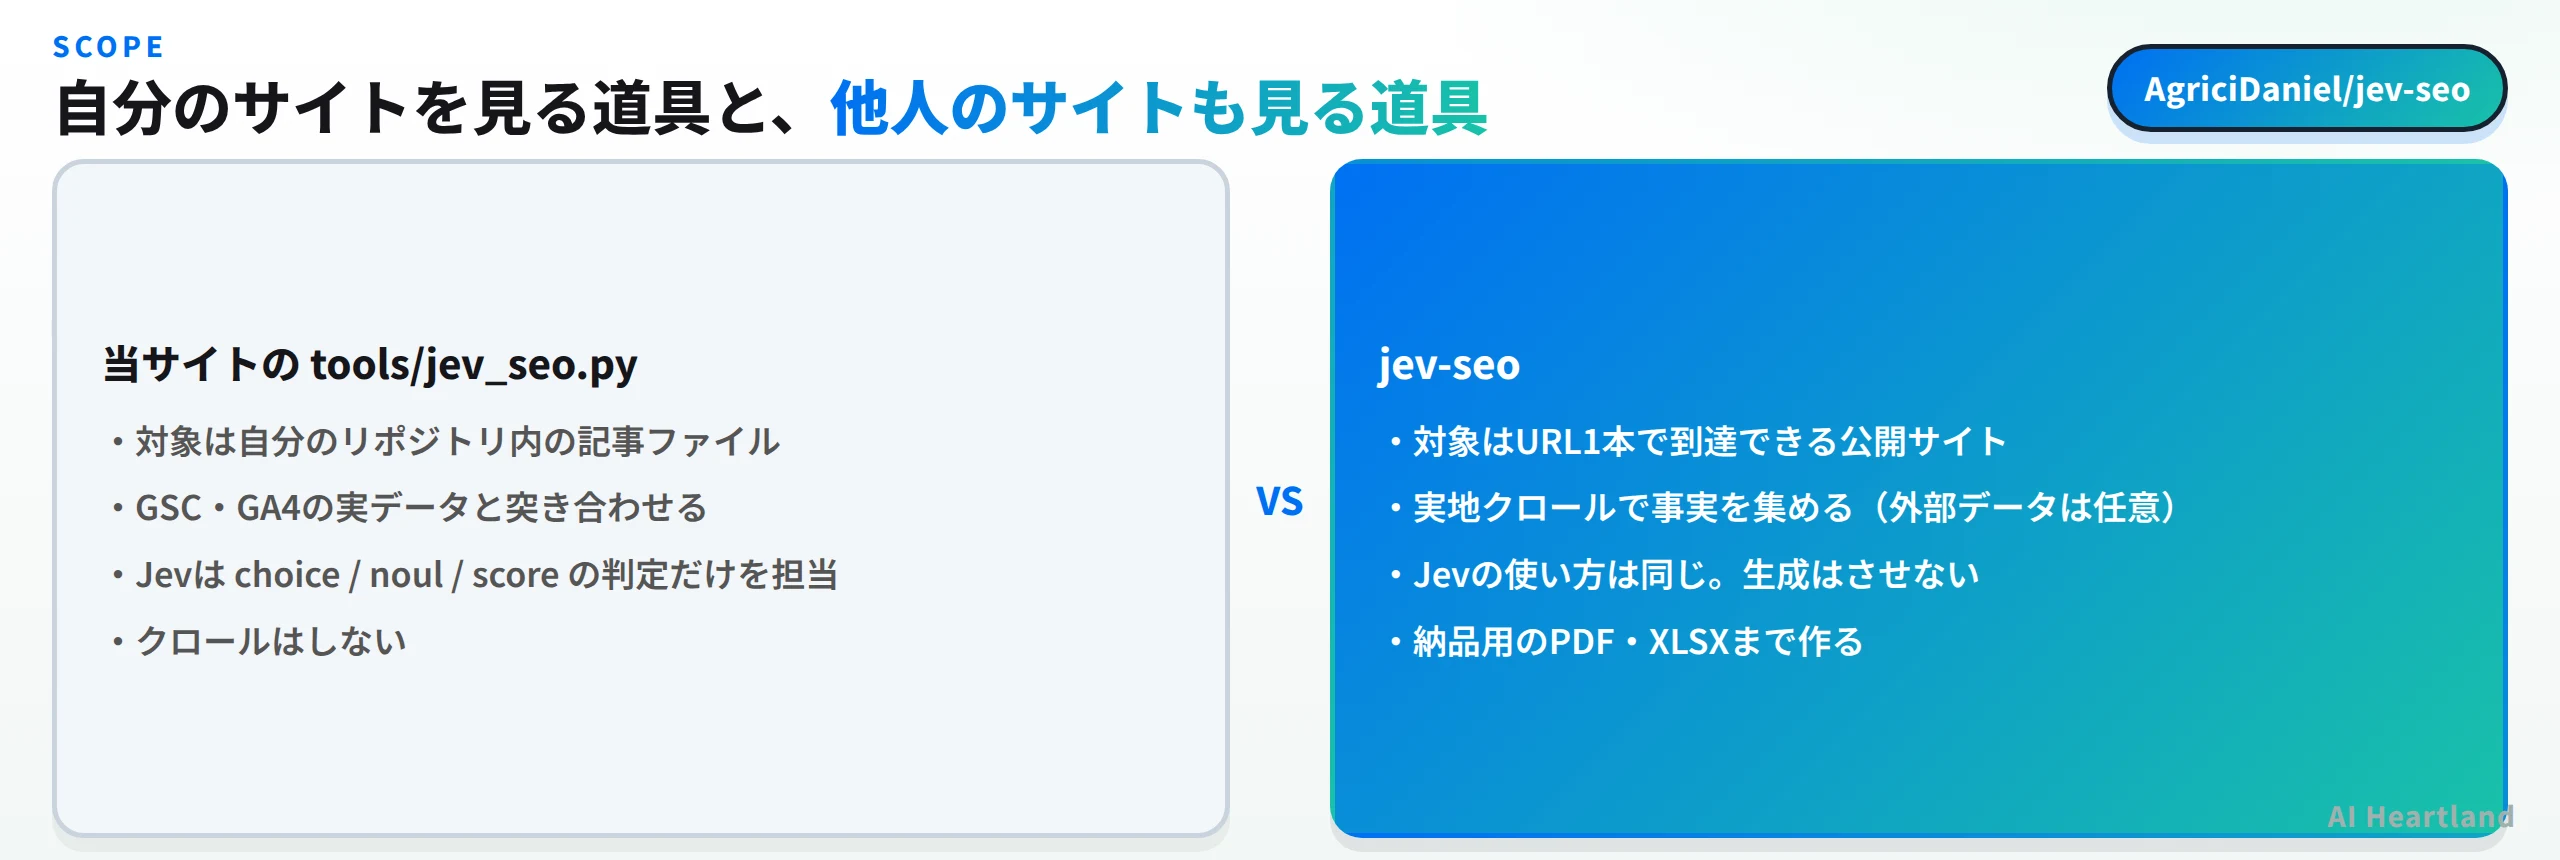
決定的な差は対象だ。自前の方はリポジトリ内のMarkdownとSearch Consoleの実データを突き合わせる。クロールはしない代わりに、実際のクリック数・表示回数・掲載順位という手元にしか無いデータを使える。jev-seo はその逆で、外部データは任意だがURL1本あれば誰のサイトでも監査できる。
・自分のサイトの改善なら、GSCと繋がっている自前の方が精度が出る
・他人のサイトの診断(受注前の提案、競合調査、クライアントワーク)なら jev-seo が圧倒的に速い
・納品物が要るなら jev-seo 一択。PDFとExcelのアクショントラッカーまで自動で出る
原則は共通していて、どちらも「集計・比較・日付の前後関係はコードがやる。Jev は型つきの判定だけ」という線を守っている。Jev互換のサーバを自前GPUで動かす選択肢(OpenJev など)もあるが、jev-seo のエンドポイントは api.typesafe.ai/v1/systemone 固定なので、差し替えるならコード側に手を入れる必要がある(未検証)。
最後に、当記事で確かめた範囲を整理しておく。
| 項目 | 確認方法 | 状態 |
|---|---|---|
インストールと doctor |
実行(依存の解決・キーの有無表示) | 実測 |
| 52ルール | audit.json の findings 11+passed_rules 41=52 |
実測 |
| 実地監査と3形式レンダ | pypi.org 5ページ・17.9秒+7.4秒 | 実測 |
| サイト5問・ページ13問 | references/judgments.md の表を数えた |
実測 |
| SSRFガード | ループバック宛で拒否・公開サイトで通過(陰陽対照) | 実測 |
| narrative の検査 | 架空ID で停止・架空数値と工数不一致で警告 | 実測 |
| オフラインテスト | 38本すべて通過・51.9秒 | 実測 |
| Jevの判定精度・再現性 | キーが無く実行できず | 未検証 |
--full(DataForSEO) |
認証情報が無く実行できず | 未検証 |
| Claude Codeスキルとしての起動 | スキル登録は環境の都合で行っていない | 未検証 |
| 60ページ規模での所要時間 | 5ページでしか走らせていない | 未検証 |
「LLMでSEOを自動化する」と書かれた道具は多いが、この実装が他と違うのはLLMに書かせないことを決め、書かせた分は機械で検査して突き返すところにある。使うかどうかとは別に、設計として読む価値がある1本だった。
参照ソース
・AgriciDaniel/jev-seo — GitHubリポジトリ(v0.1.1・最終コミット 2026-09-22・当記事で clone して実行): https://github.com/AgriciDaniel/jev-seo
・references/judgments.md — Jev質問レジストリ(サイト5問・ページ13問と決定帯の定義): https://github.com/AgriciDaniel/jev-seo/blob/main/references/judgments.md
・references/evaluation.md — 2026-09-22 時点の自己評価: https://github.com/AgriciDaniel/jev-seo/blob/main/references/evaluation.md
・references/narrative.md — narrative.json の契約と書き方規則: https://github.com/AgriciDaniel/jev-seo/blob/main/references/narrative.md