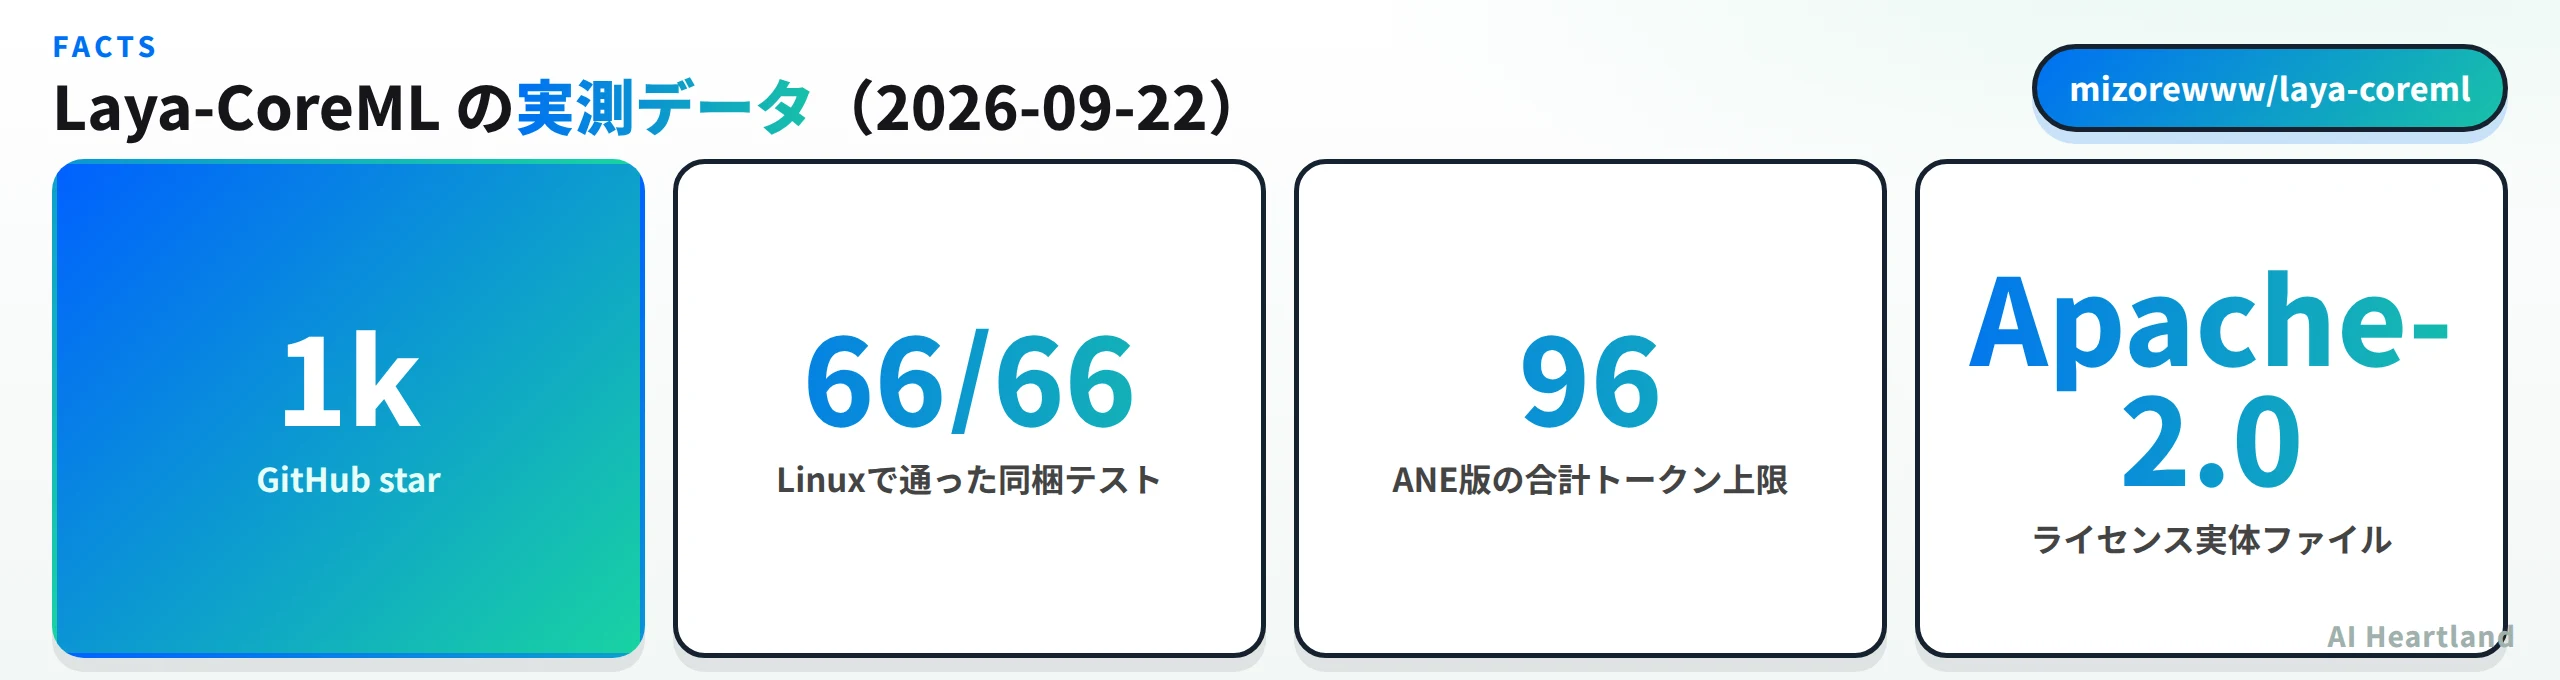
Laya-CoreMLは、Apple SiliconのNeural Engine上で型つきの判定だけを返すApache-2.0のOSSだ。文章は1文字も生成せず、yes/no・選択・順序スコアの3種類の質問に確率で答える。推論にPyTorchもTransformersもMLXも要らず、重みを一度落とせば端末内で完結する。2026年9月22日時点でstar 1k・fork 65、最終コミットは同日、PyPIにも laya-coreml として公開されている。本記事ではLinux(x86_64)に導入して同梱テストを通し、Apple機なしで確かめられる範囲とそうでない範囲を切り分けたうえで、公称されている速度と電力の数字がどう測られているかを読む。
- ・正体:Apple SiliconのCore ML/Neural Engineで動く型つき判定モデルの実装。Apache-2.0・star 1k
- ・何ができる:状態と質問を渡して確率を受け取る。重みを落とした後はオフラインで完結する
- ・実測:Linuxでも導入とimportは成功し、同梱テスト66件が全て通った。推論自体はApple機が必要で未検証
- ・注意:ANE版は合計96トークンの上限。較正温度に制限が入る仕様変更が入ったばかり
文章を返さない判定モデルという考え方そのものはJevとは|文章を返さないSystem Oneモデルの正体を公式SDKのコードで実測し、Claude Codeで試すで扱った。モデルをローカルで動かす選択肢の全体像はLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめている。
Laya-CoreMLとは——ANEで動く「文章を書かない」モデル
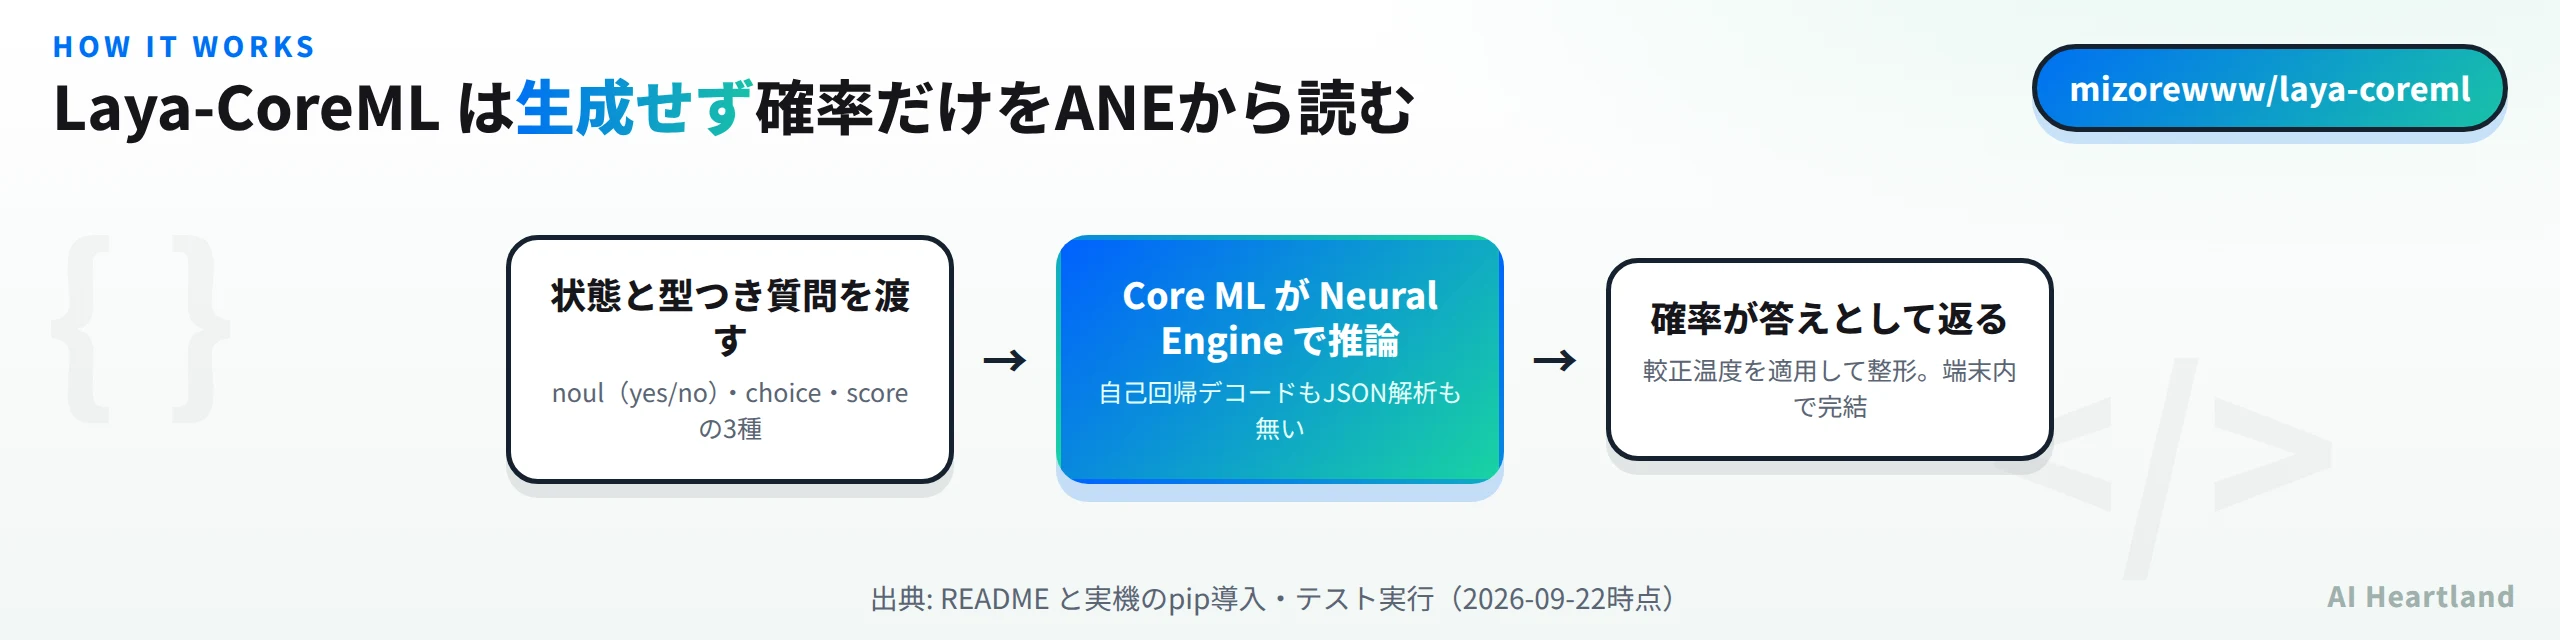
READMEの1行目は「Apple Siliconの上のオープンウェイトな型つき判定。Core ML、Neural Engine、生成トークンはゼロ」だ。返ってくるのは3種類の質問に対する確率で、noul(yes/no)、choice(選択肢から1つ)、score(順序つきの段階)という型が用意されている。
import laya_coreml as laya

agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
    "The customer requests a refund of a duplicate payment.",
    {"refund": {"type": "noul", "instructions": "Does the customer request a refund?"}},
)
print(result["answers"]["refund"])
自己回帰デコードが無いということは、出力を構文解析する工程も、それが失敗したときの再試行も無いということだ。解析できる形で返ってくるかどうかを心配しなくてよいという性質は、判定を分岐条件として使う用途では速度以上に効く。
配布されているチェックポイントは6種類ある。用途と容量が明確に分かれているのが特徴だ。
| バンドル | 既定エンジン | 容量 | 用途 |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512トークン | 原型の英語モデル |
| Multilingual 322M | CPU + GPU | 1024トークン | 汎用の多言語判定 |
| Typed Decisions 421M | CPU + GPU | 1024トークン | 原型の特化チェックポイント |
| Snake GPU | CPU + GPU | B3 / L64 | ゲーム用の3問をまとめて処理 |
| Multilingual ANE | CPU + ANE | B1 / L96 | 短い判定・FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | 近似のパレット圧縮つき |
各バンドルにはトークナイザと設定、モデルカード、来歴、チェックサム、パッケージ時の検証結果が入っており、元の学習環境を用意しなくても使えると書かれている。ANE版のバンドルには、動作に必要な元のホスト側の埋め込みと行動テンソルもそのまま同梱される。配布物を開けば中身と出所が追える形になっている。
看板になっているのはターミナルでSnakeを遊ばせるデモだ。READMEによれば、上限を設けない600ステップのエピソードを3回走らせて毎秒49.1〜50.0判定を維持し、死亡ゼロ・安全介入2回という結果になっている。判定のたびに確率・スコア・長さ・遅延・安全介入が画面に出るので、モデルが何を根拠に曲がったのかが見える構成になっている。
デモの作りも明記されている。盤面をそのままモデルに解かせるのではなく、明示的なプランナー特徴量を与えたうえで、目に見える循環回避の安全層を重ねている。つまりモデルが賢いから死なないのではなく、どこをモデルに任せどこをルールで守るかを分けている。判定モデルを実用に載せるときの現実的な形で、そこを隠さず「安全介入2回」と数えて出しているのが誠実だ。
動かすための前提も具体的だ。Apple Silicon・macOS 15以上・Python 3.11〜3.13で、ターミナルは104桁×35行が必要。スペースで一時停止、上下キーで速度変更、Rでリセット、Qで終了。そして初回のCore ML初期化には数十秒かかる場合があると断りがある。重みは一度落とせばよく、以後はオフラインで遊べる。
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
測られている数字の読み方——5msと2.78倍の中身
この種のリポジトリでは速度の主張が独り歩きしやすいが、ここは測定条件が細かく書かれている。M3 Max(40コアGPU・128GiB・macOS 27.2)で、91トークンの質問を96に詰めた1問を、プロンプト準備・トークン化・配列生成・同期推論・較正・整形まで含めて測る。読み込みとウォームアップは除外。実装ごとに20秒のブロックを6回交互に回し、安定した呼び出し65,598回を集めている。
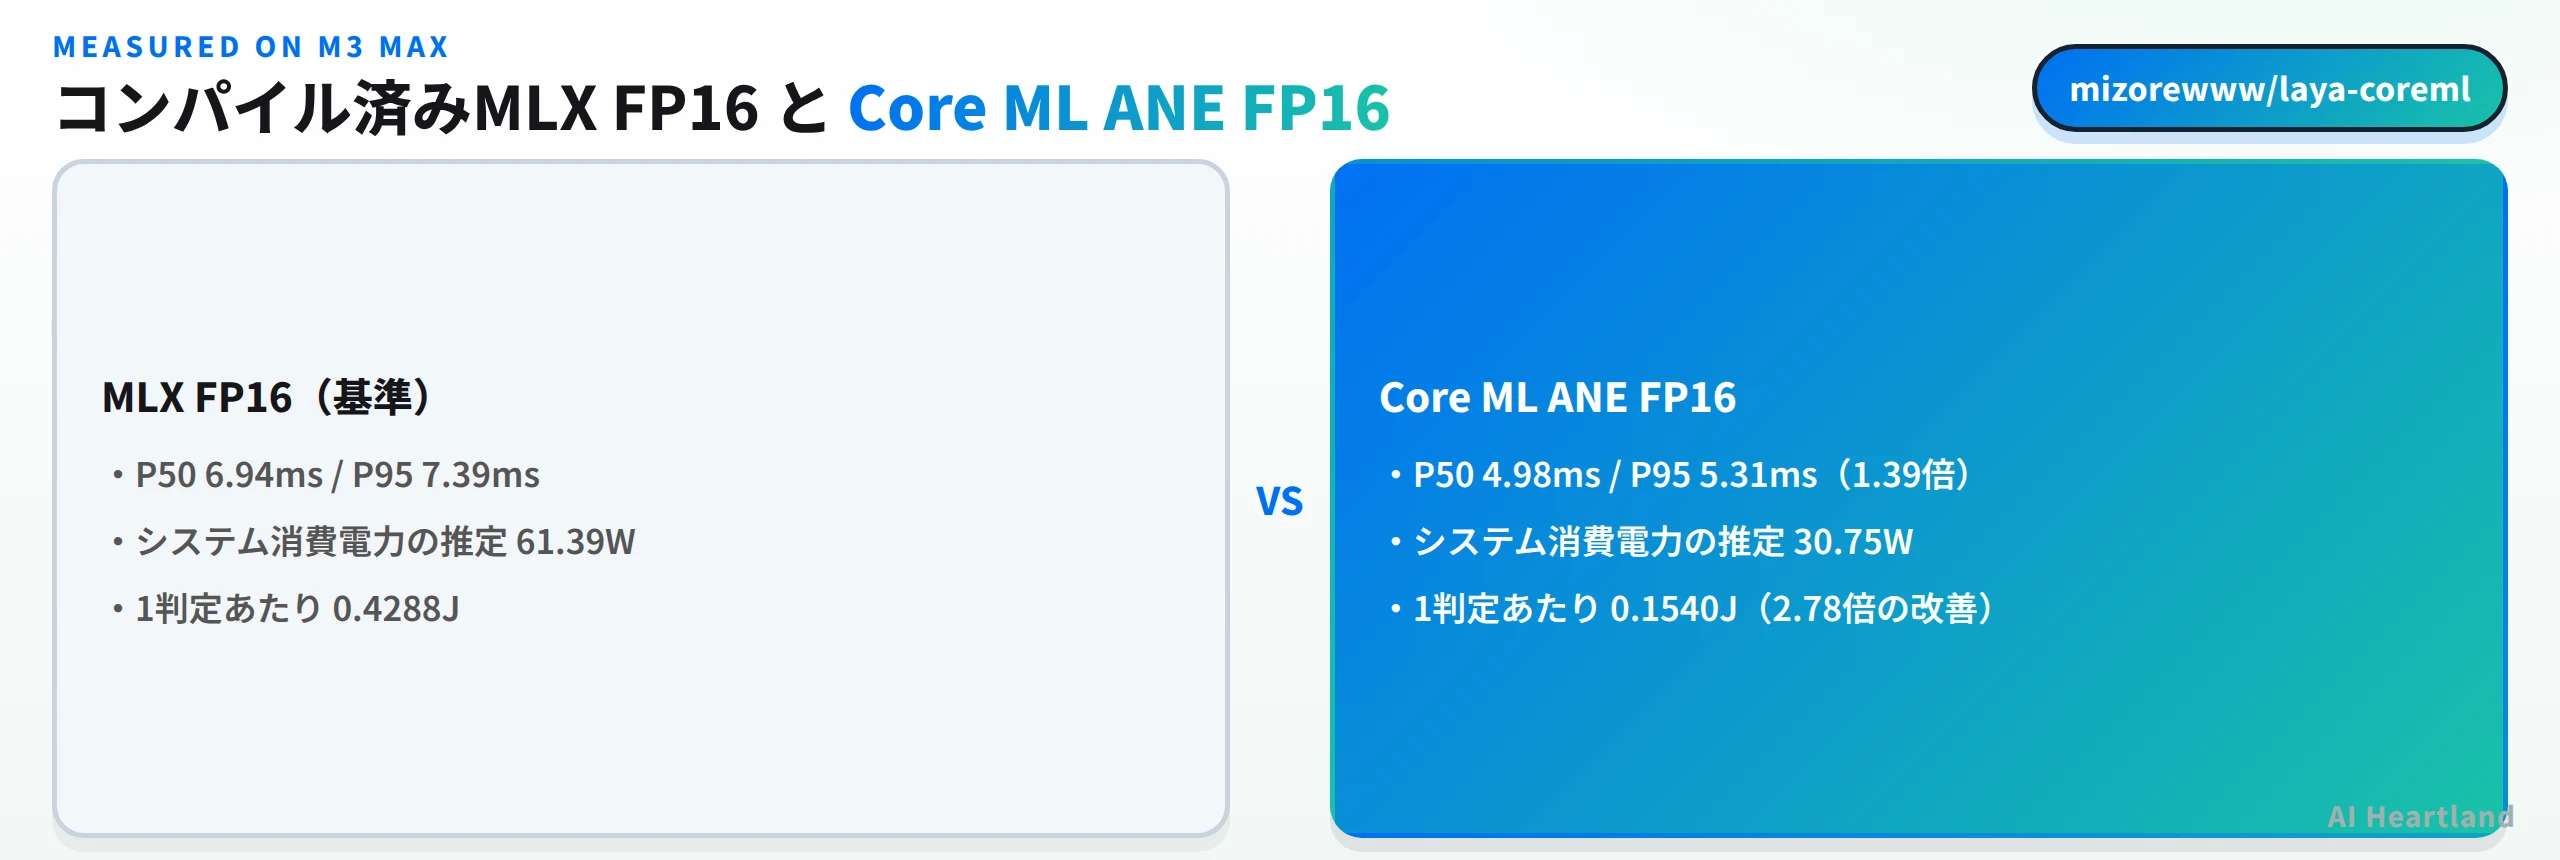
数字を並べると、速度の改善は1.39倍(ANE FP16)から1.42倍(ANE W8)にとどまる。一方で1判定あたりのシステム全体のエネルギーは0.4288Jから0.1540J(2.78倍)、W8では0.1344J(3.19倍)まで下がる。速い以上に電気を使わないというのがこの移植の本質だ。バッテリー駆動の端末で判定を連打する用途では、この差のほうが体感に効く。
電力の出し方も明記されている。SMCのPSTRセンサーの直接読み出しを使い、生サンプルと明示的な異常値除去を伴う。READMEはそのうえで「センサーと背景負荷の不確かさを含む推定である」と断り、さらに「速度比 × 平均電力比 = エネルギー比であり、エネルギーにもう一度時間を掛けると二重計上になる」という注意書きまで置いている。数字を大きく見せる方向の誤用を、著者自身が先に塞いでいる。
もうひとつ目を引くのが、README本文にある「要求されていた10倍の改善は達成できなかった」という1文だ。誰かが期待値として10倍を提示し、それに届かなかったことを成果表のすぐ後に書いている。未達を消さずに残す姿勢は、この手のベンチマークを読むときの信頼度を上げる。
なお1問あたりの数字とSnakeのフレーム時間は別物だとも明記されている。Snakeの毎秒49〜50判定という値には描画の直列化が含まれ、ターミナルへの描画自体は除外されている。用途が違えば見るべき数字も違う、という整理がドキュメント側で済んでいる。
実測:Linuxでどこまで動き、どこで止まるか
ここからは2026年9月22日にLinux(x86_64・Apple機なし)で試した結果だ。Apple専用のはずのパッケージがどこまで動くのかを確かめたかった。
python3 -m venv /tmp/laya-venv
/tmp/laya-venv/bin/pip install laya-coreml
/tmp/laya-venv/bin/python -c "import laya_coreml; print('import ok')"
結論から言うと、導入とimportはLinuxでも成功する。依存は coremltools・huggingface-hub・numpy・safetensors・tokenizers の5つで、PyTorchもTransformersも入らない。READMEの「推論にPyTorch・Transformers・MLXは不要」という主張は、依存関係の実体としても裏が取れる。
一方でバージョンには差がある。PyPIから入るのは0.1.0で、リポジトリの pyproject.toml は0.1.1だった。リポジトリのほうが先行しているので、後述する較正温度の変更のような新しい挙動を試すならソースから入れる必要がある。
モデルの読み込みを試すと、Core MLに到達する前に止まった。
/tmp/laya-venv/bin/python -c "
import laya_coreml as laya
laya.load('aac6fef/laya-multilingual-coreml-ane', local_files_only=True)"
# LocalEntryNotFoundError: Cannot find an appropriate cached snapshot folder ...
重みはHugging Faceから取得する設計で、この環境は当該ドメインへの通信が遮断されているため、キャッシュ無しの読み込みはここで失敗する。つまりLinuxでの限界は「Core MLが無いから」ではなく、まず「重みが無いから」だった。
この失敗の出方自体は扱いやすい。local_files_only=True を渡すとキャッシュ済みの重みだけを使うよう要求でき、無ければ今回のように明示的な例外で止まる。ローカルのディレクトリを直接指定して読み込むこともできるので、重みを配布物として自前で持ち回る運用にも寄せられる。逆に言えば、既定ではHub側を見に行くので、閉じた環境に置くなら最初にこの経路を塞いでおく必要がある。
同梱テストは別だ。Core MLを必要としない範囲は、Apple機なしでも全て通る。
/tmp/laya-venv/bin/pip install pytest Pillow rich
python -m pytest tests/ -q \
  --ignore=tests/test_ane_layout.py --ignore=tests/test_energy.py --ignore=tests/test_model.py
# 66 passed in 0.46s
除外した3モジュール(test_ane_layout.py・test_energy.py・test_model.py)は torch を要求して収集の時点で落ちる。変換・検証側の依存であり、推論には不要という切り分けがテストの構成にもそのまま出ている。残りの66件は全て成功した。最初は6件が失敗したが、原因はいずれも PIL と rich の未導入で、デモ用の追加依存を入れると解消した。テストの中には、公開されているSnakeの記録を読み込んで盤面と行動が1手ずつ完全に再現できるかを確かめるものがあり、公開デモの来歴が機械で検証されている点は好感が持てる。
検証環境:Linux(x86_64・Apple Silicon機なし)/2026-09-22/laya-coreml 0.1.0(PyPI)とリポジトリ main(4619e04)。確認したのは導入・import・依存関係・読み込み時の失敗地点・同梱テスト66件の5点。Core MLでの推論、ANEの速度と電力、Snakeデモは未検証。記事中の速度・電力の数値はすべてREADMEとベンチマーク資料の記載であり、当方の測定ではない。
使う前に知る制約——96トークンと較正温度
導入判断に直結する制約が2つある。どちらもREADMEに明記されているが、見落とすと挙動の説明がつかなくなる種類のものだ。
第一にANE版の合計96トークン上限。質問文・選択肢・状態のすべてを合わせて96トークンに収める必要があり、超えると容量エラーになる。最速の数字が出ているのはこのANEバンドルなので、「速いほうを使う=入力を短くする制約を受け入れる」という交換になる。長い文脈を渡したいなら1024トークンの多言語モデルを選ぶ。
第二に較正温度の制限だ。上流のv0.3.5に合わせて、学習済みの較正温度が0.5から5.0の範囲に丸められるようになった。理由はREADMEに具体的に書かれている。出荷されている choice:11+ バケットの値は0.1006で、そのまま使うとロジットを約10倍に鋭くしてしまい、五分五分の判断をほぼ確実だと報告してしまう。確率を分岐条件に使う設計では致命的になりうる値だ。
この変更は丁寧に扱われている。元の生値は agent.temperature_raw と agent.temperature_by_options_raw から引き続き読め、読み込み時には制限がかかったバケットを名指しする RuntimeWarning が出る。値を書き換えつつ、書き換えたことを黙らせない作りだ。
較正温度の件が示すように、返ってくる確率の目盛りはチェックポイントと版に依存する。しきい値を決めて自動処理に流すなら、自分のタスクの質問セットで分布を見てから決めたほうがいい。W8バンドルについてもREADMEは「近似であり、パッケージサイズの削減は速度比ではない」と明示している。
同じ「生成せず選択させる」系統のOSSがどの層に何本あるかはJev対応OSS 11選|ブラウザ操作・MCP・コードレビュー・Claude Code文脈選別まで実測で見る使いどころに一覧がある。判定サーバを自前のGPUで立てる方向の選択肢としてはOpenJevとは|Jev互換のSystem One決定サーバを自前GPUで動かすOSSをソースで実測があり、Laya-CoreMLはそれを「サーバを立てず端末内で完結させる」側に振った実装だと位置づけられる。
移植の忠実さと、公開されなかった実験
本プロジェクトは元のLayaをApple向けに移したものだ。NOTICEにも「Convai Innovationsと貢献者によるLayaの独立した移植であり、MLX版の姉妹プロジェクトの上に構築されている。ConvaiやAppleの公式リリースではない」と書かれている。移植である以上、元と同じ答えを返すかどうかが最初の問いになる。
README はその検証結果を数字で出している。汎用のFP16チェックポイント3種は、上流が選ぶ答えと189問中189問で一致し、それぞれ100回の反復呼び出しに通る。ANE FP16のL96版は59問中59問の適合テストに通り、較正済み確率の最大ずれは0.002925。W8版は同じ範囲を、変更していない0.02の合格線に対してずれ0.014393で通っている。
P50 4.98ms・最速"] A -->|1024トークンまで| C["Multilingual 322M
CPU + GPU"] B --> D["容量を超えると
capacity error"] B -->|さらに省電力| E["ANE W8
近似・ずれ 0.014393"] C --> F["長文ANE版は
1問 約91.7ms"]
注目したいのは、通らなかった実験も書いてある点だ。6ビットと4ビットの実験は同じ合格線を越えられず、重みとして公開されていない。精度が落ちた版を「軽量版」として並べる選択をしていない、ということだ。README はさらに「これらは変換忠実度の固定テストであって、一般的なタスク精度の証明ではない」と釘を刺している。
長文側の数字も率直だ。別途書き出したFP16のANE L1024グラフは63問中63問の固定テストに通るが、実際に1024トークンの要求を出すと1問あたり約91.7ミリ秒かかる。短い判定での5ミリ秒という結果は、長い文脈でも速いことを意味しない、と明記されている。Snakeについても600ステップの対照確認で600手すべてが一致し死亡ゼロ・シールド介入ゼロだったうえで、「現在のANEアダプタは3回の逐次呼び出しを行うため、ゲーム全体としてコンパイル済みMLXより一貫して速いとは言えない」と書いている。
実装レベルの違いにも触れられている。通常のSDPA版Core ML書き出しとANEグラフは別実装で、通常版は制約なしのRangeDim GPU形状が局所的な忠実度検査に落ちたためCPU+GPUを既定にしている。デバイス設定を変えるだけではANEの結果は再現できない。ANE版はBC1Lの活性化・1×1の射影・ヘッドごとの注意に書き換えられており、実行計画と別途取得したInstrumentsのトレースがNeural Engine上での動作を裏づけているとされる。入出力の境界はCPUが担当する。
文書の構成にも同じ姿勢が出ている。導入とAPI、Snakeデモと媒体、リリース成果物と固定されたHubリビジョン、一般のCore MLベンチマーク、ANEの工学的実験、変換で起きた問題と対応形状、という並びに加えて、「10倍という目標の数学的検討」という文書が独立して置かれている。達成できなかった目標について、なぜ届かないのかを別立てで説明する構成だ。ベンチマークの数字だけを見て期待値を作らせない作りになっている。
自分で書き出したい場合の道も用意されている。laya-coreml[convert] を入れて laya-coreml convert laya-multilingual models/custom を走らせる形で、ANEの研究用変換・圧縮・ベンチマークのスクリプトはGitのチェックアウト側に置かれている。推論用のホイールには可搬なランタイムと任意のターミナルデモだけが入る、という分離になっている。
まとめ——Laya-CoreMLは誰に向くか
Laya-CoreMLの価値は、判定モデルをサーバから引き剥がして手元のチップに載せたことと、その効果を速度ではなく電力で語っていることの2点にある。1問あたり約5ミリ秒という数字自体より、同じ判定を2.78倍少ないエネルギーで返せるという測り方のほうが、実運用の判断材料として有用だ。
待ったほうがよい:Apple以外のプラットフォームが主戦場の場合(推論できない)。1問に長い文脈を渡したい設計(ANE版は96トークン)。確率の目盛りをそのまま信頼したい運用(較正温度の扱いを自分で確認する必要がある)
今回確かめられたのは、Apple機なしでも届く範囲までだ。導入と依存関係、同梱テスト66件の成功までは手元で再現できたが、Core MLでの推論そのものには触れていない。評価するなら、まずLinuxでもできるテスト実行で実装の健全性を見て、次にApple機で重みを落として自分の質問セットの確率分布を確認し、そのうえでANE版の96トークン制約に収まるかを設計側で判断する順序が現実的だろう。
参照ソース
・mizorewww/laya-coreml(公式リポジトリ) — README・LICENSE・pyproject.toml・tests(2026-09-22時点で確認)
・ANE_BENCHMARKS.md — 速度・電力・ハードウェアの測定条件
・laya-coreml(PyPI) — 配布版0.1.0と依存関係の確認