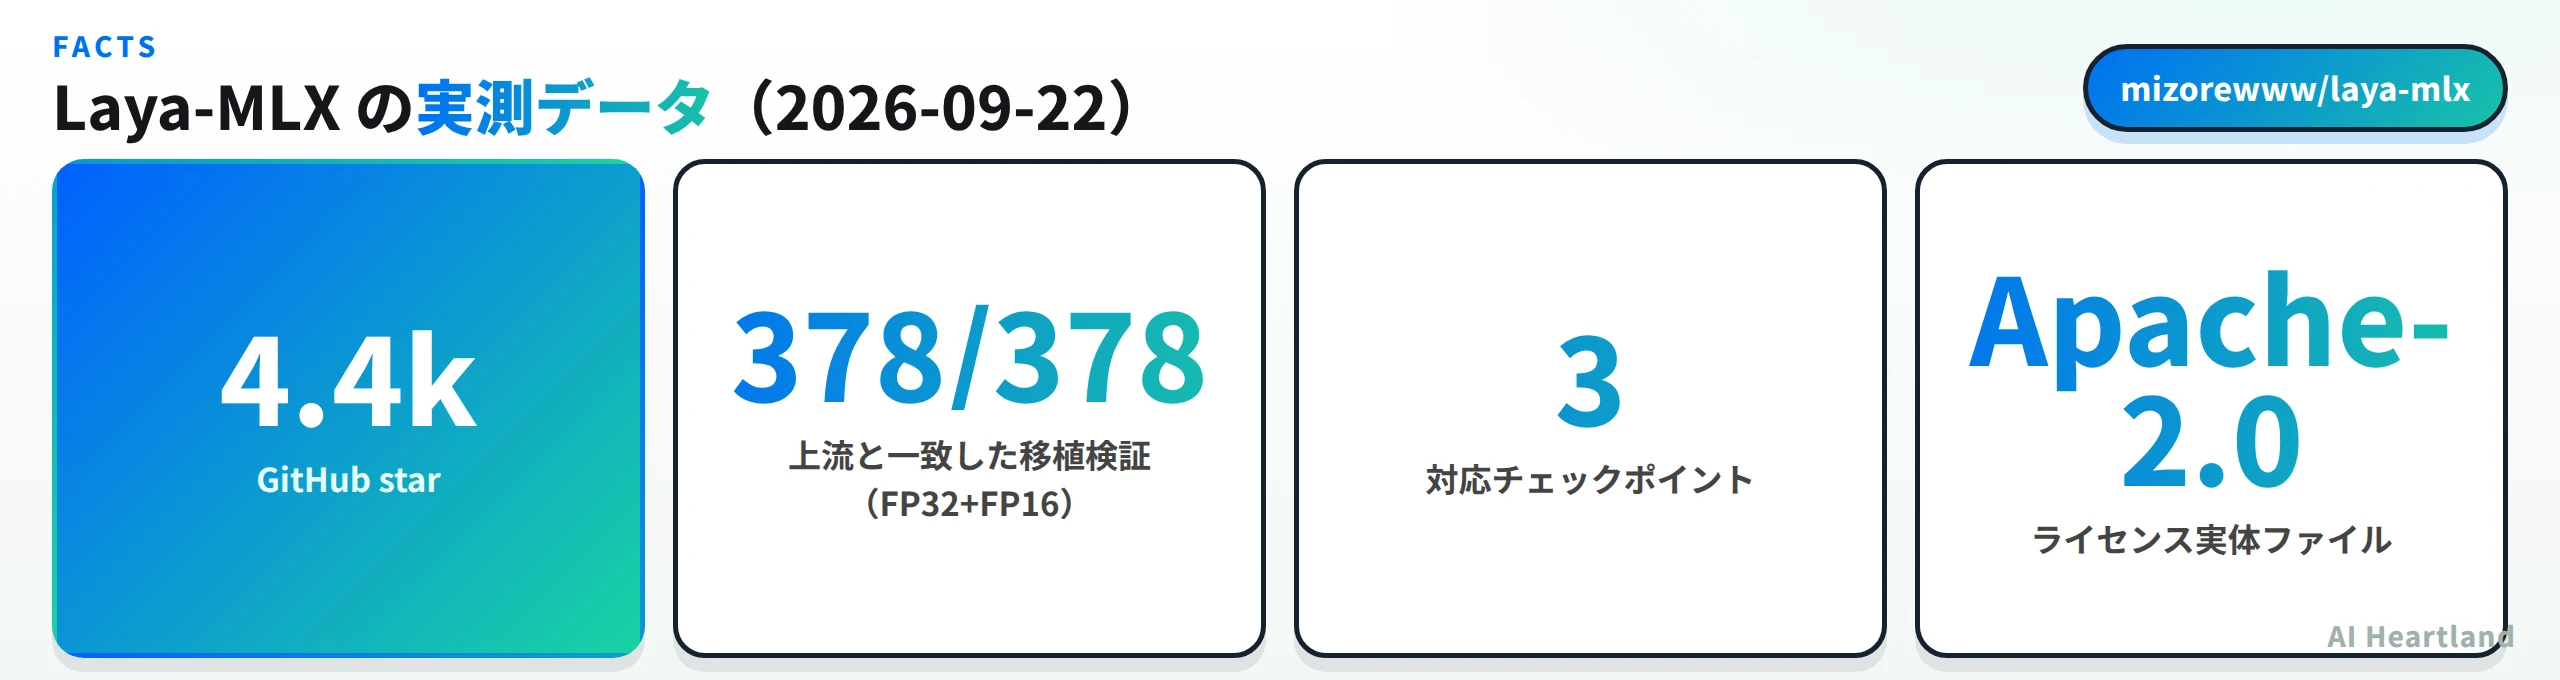
Laya-MLXは、型つき判定モデルLayaをApple SiliconのMLXで動かすApache-2.0の移植だ。選択・スコア・真偽の3種類の質問に確率だけを返し、文章は生成しない。READMEが掲げる数字は短い英語の判定1件で中央値13.4ミリ秒、多言語チェックポイントなら7.4ミリ秒、出力トークンは0。2026年9月22日時点でstar 4.4k・fork 302で、同じ作者のCore ML版(laya-coreml、star 1k)より大きく伸びている。本記事ではリポジトリとPyPIの両方を実際に触り、Linuxでどこまで入ってどこで止まるかを確かめたうえで、公称値がどんな条件で測られたのかを読む。
- ・正体:Layaの型つき判定をMLXで動かす独立移植。Apache-2.0・star 4.4k・PyPI版0.2.0
- ・何ができる:3つのチェックポイントを切り替えて、選択・スコア・真偽の判定を手元のGPUで返す
- ・実測:Linuxでも導入は通るがimportはmlx不在で失敗。依存の宣言まで含めて切り分けを確認した
- ・注意:Apple Silicon・macOS 14以上が前提。較正温度に制限が入る仕様変更が反映されたばかり
文章を返さない判定モデルという考え方はJevとは|文章を返さないSystem Oneモデルの正体を公式SDKのコードで実測し、Claude Codeで試すで扱った。ローカルでモデルを動かす選択肢の全体像はLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版にまとめている。
Laya-MLXとは——双方向エンコーダ1回で答える移植
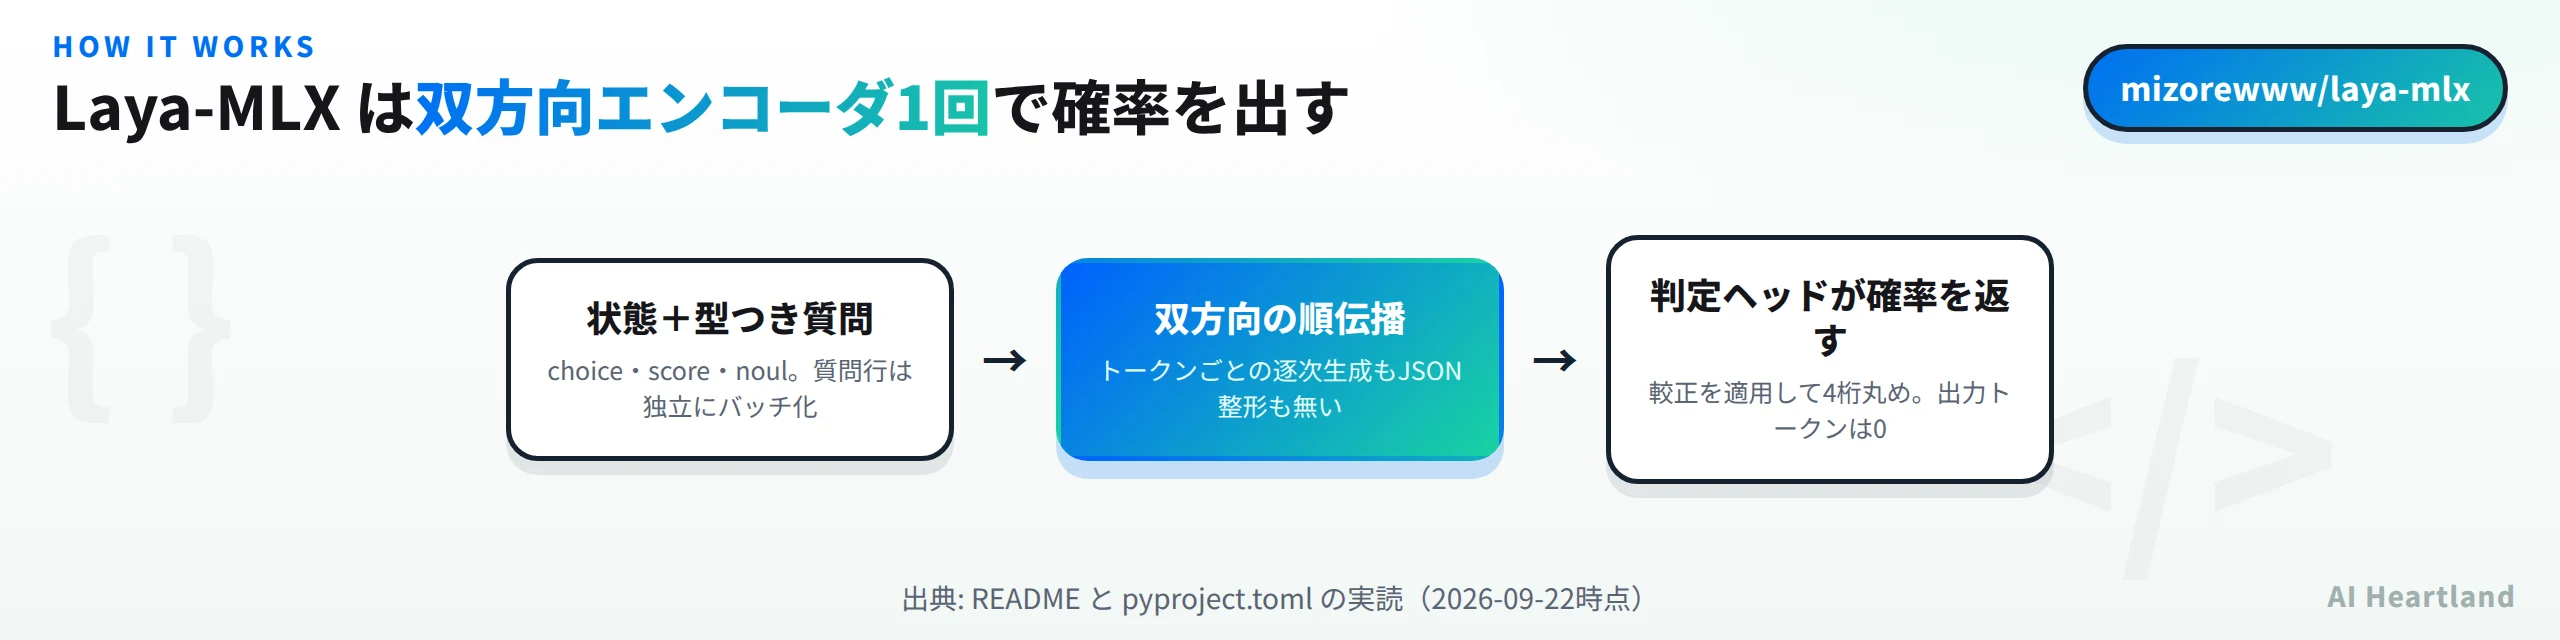
READMEの説明は短い。「ソフトウェアはしばしば、選択・ルーブリックのスコア・確率を必要とする。Layaはそうした制約つきの質問に、双方向の順伝播で答える。トークンごとのデコードも、生成されたJSONも無い」。
state + typed question → bidirectional encoder → decision heads → probabilities
質問の型は3つだ。choice は名前つき選択肢の上の確率、score は順序つきルーブリックの各段階の確率と期待値、noul は命題が真である確率を返す。呼び出し側のコードはこうなる。
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
    "I was billed twice. Please refund the duplicate.",
    {"department": {"type": "choice", "instructions": "Who should handle this?",
                    "criteria": ["billing", "technical", "sales"]}},
)
print(result["answers"]["department"])
実装の範囲も明記されている。エンコーダ・判定Transformer・スコアリングヘッド・アクションヘッドはすべてMLX上で動き、トークン化だけHugging FaceのRust実装を使う。元の学習済み重み・質問の整形・較正・出力スキーマはそのまま保たれる。学習や微調整は上流プロジェクトに残っており、このリポジトリが提供するのは推論と変換だけだ。
誠実だと感じたのは、性能の主張を自分で狭めている箇所だ。「質問行は独立にバッチ化される。双方向エンコーダの表現は状態と質問の両方に依存するため、このランタイムは状態を1度エンコードして任意の質問間で隠れ状態を再利用する、とは主張しない」。キャッシュが効きそうに見える構造で、効かない条件を先に書いている。
対応するチェックポイントは3つで、エンコーダも用途も違う。
| モデル | エンコーダ | パラメータ | 文脈上限 | 用途 |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | 英語 |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | 多言語入力 |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | 上流の型つき判定ワークフロー |
文脈上限には指示文・選択肢・状態のすべてが含まれる。英語版が512トークン、多言語版が1,024トークンなので、長い状態を渡したいなら小さいほうのモデルを選ぶという、直感と逆の関係になっている点は覚えておきたい。速度でも多言語版のほうが上なので、英語だけを扱う場合でも421Mを選ぶ理由は「英語に特化した重みを使いたい」ことに絞られる。FP16に変換済みの重みがHugging Faceに公開されており、公開36ファイルすべてが厳密なリモートチェックサム検証に通ったこと、固定したリビジョンと重みのハッシュが benchmarks/results/hub-publication.json に記録されていることまで書かれている。
公称値の読み方——13.42msと7.39msの条件
数字だけが独り歩きしやすい領域なので、測定条件を押さえておく。
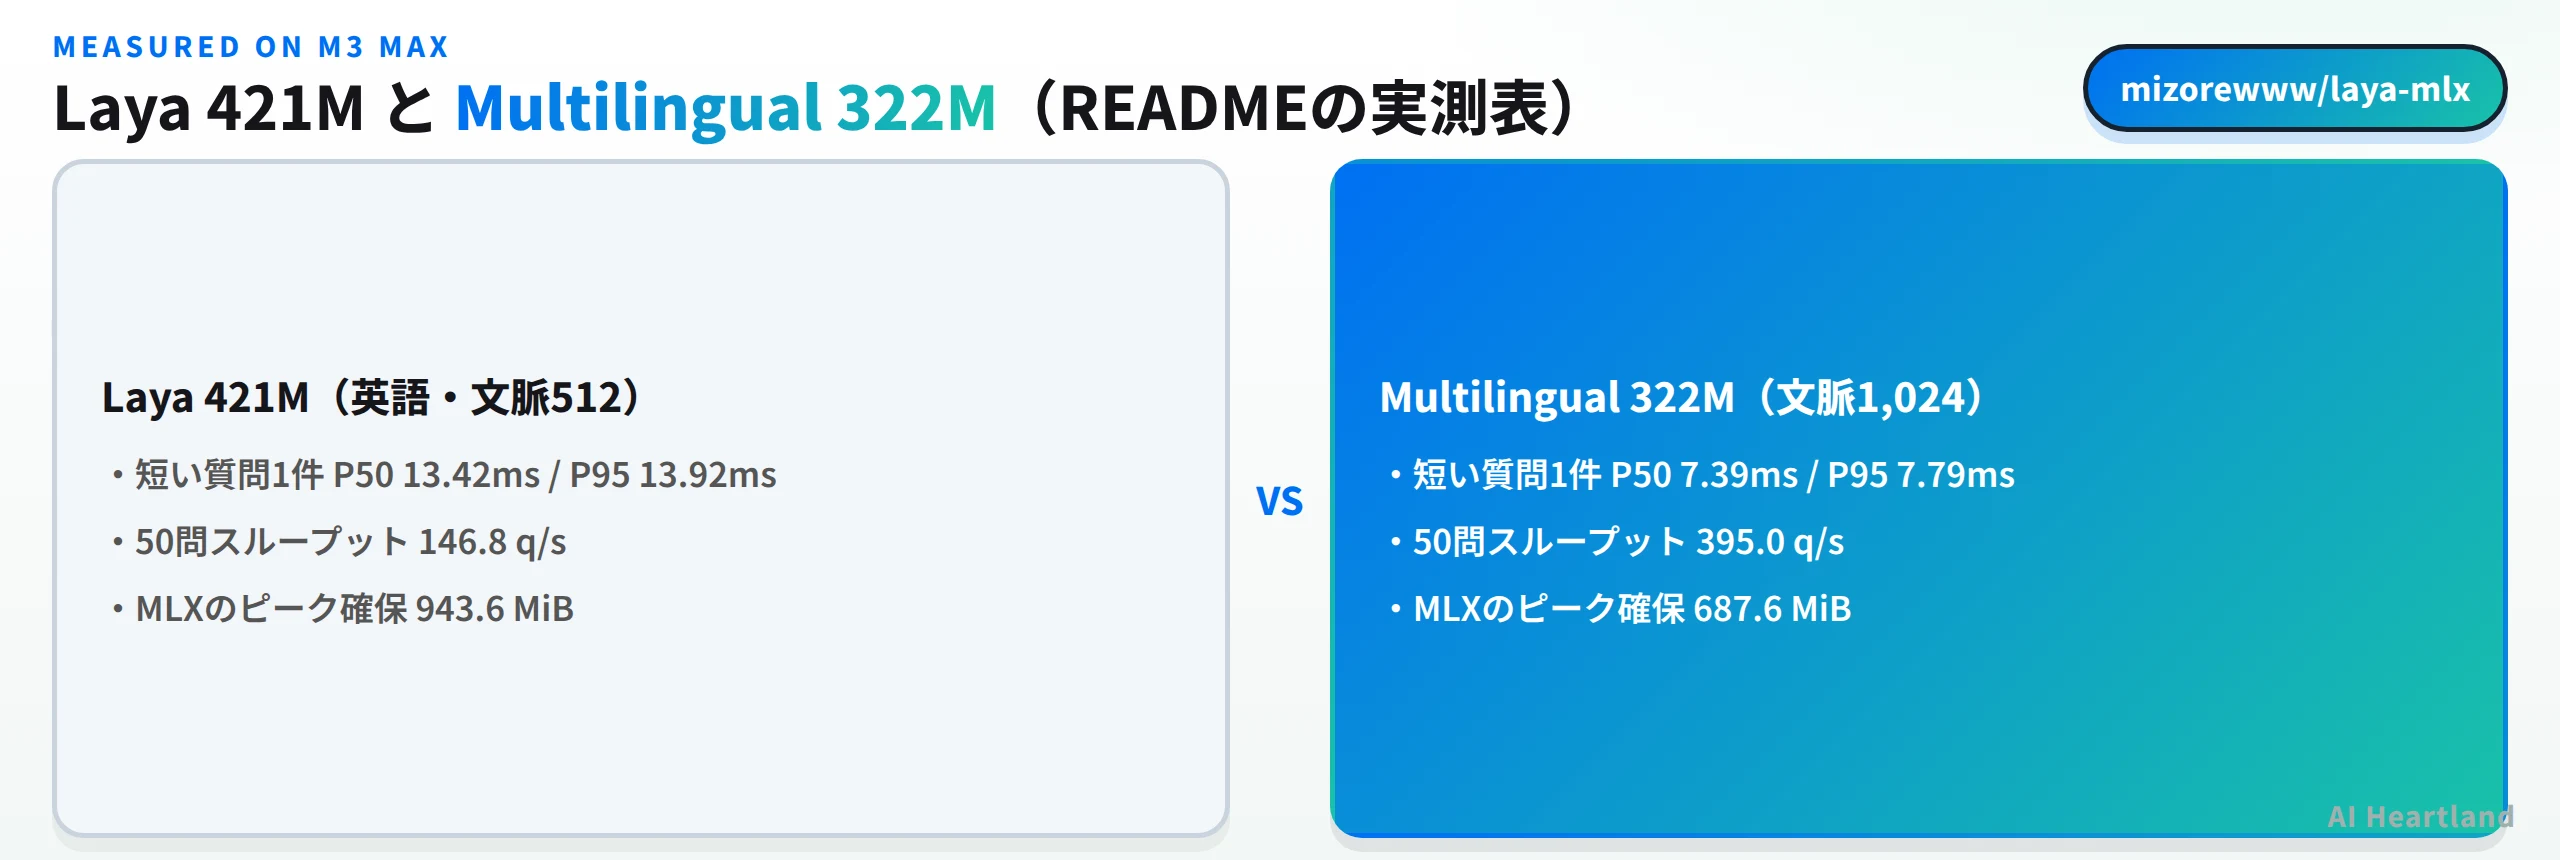
測定機はM3 Max(40 GPUコア・128GiB)、環境はmacOS 27.2・Python 3.12.13・MLX 0.32.2。READMEはさらに「そのMLXリリースはmacOS 14・15・26向けのホイールを供給しており、手元のインストーラは26のホイールを選んだ。それより古い対応macOSはこの機械では試していない」とまで書いている。動作環境の主張を実際に試した範囲に限定する書き方だ。時間にはプロンプト準備・トークン化・テンソル生成・同期推論・較正・結果整形が含まれ、モデル読み込みは除外されている。50問の測定は batch_size=64 で、APIの既定は16。READMEは「長さ・質問数・実行条件が変われば遅延も変わる」と添えている。
移植の一致度も数字で出ている。3つのチェックポイントすべてが、FP32とFP16の両方で上流の選んだ答えと63問中63問一致(合計378件の比較)。各構成とも100回の反復呼び出しが有限かつ決定的で、実効メモリの増加は測定されなかったとある。そのうえで「これは固定テスト上の忠実度であって、あらゆる質問における正確さではない」と釘を刺している。
Snakeのデモについても切り分けがある。GIFは実際のローカル実行を等速で描画したもので、1手ごとにLayaを呼び、目に見える循環回避の安全層が危険な提案を訂正しうる。そのうえで「上の遅延の数字は別途の1問APIベンチマークであって、3問を回すSnakeループのフレーム時間ではない」と明記される。--optimize --max-speed を付けた対照試験では2,400手で毎秒75.40手、死亡ゼロ・安全介入2回、同一実行内の素の対照より約6.5%速い、という粒度まで公開されている。
実測:Linuxで入れて、どこで止まるかを見る
ここからは2026年9月22日にLinux(x86_64・Apple機なし)で試した結果だ。Apple専用のパッケージがどう振る舞うかを確かめた。
python3 -m venv /tmp/lmlx-venv
/tmp/lmlx-venv/bin/pip install laya-mlx
/tmp/lmlx-venv/bin/python -c "import laya_mlx"
# ModuleNotFoundError: No module named 'mlx'  (laya_mlx/agent.py:8)
導入は成功し、importで止まる。理由は pyproject.toml を読むとはっきりする。
dependencies = [
  "mlx>=0.32.2,<0.33; sys_platform == 'darwin' and platform_machine == 'arm64'",
  "numpy>=1.26",
  "huggingface-hub>=0.34,<2",
  "tokenizers>=0.21,<1",
]
mlx に環境マーカーが付いているため、Linuxでは依存として解決されない。実際 pip show の Requires は huggingface-hub・numpy・tokenizers の3つだけだった。分類子にも Operating System :: MacOS と書かれている。テストも同様で、tests/conftest.py が mlx.core を読み込むため、Linuxでは収集の段階で止まる。
検証環境:Linux(x86_64・Apple Silicon機なし)/2026-09-22/laya-mlx 0.2.0(PyPI)とリポジトリ main(0a85951)。確認したのは導入・依存関係の実体・importの失敗地点・テスト収集の失敗地点の4点。推論・速度・Snakeデモはすべて未検証。記事中の数値はREADMEとベンチマーク資料の記載であり当方の測定ではない。
この設計自体は理にかなっている。MLXはApple Silicon専用のフレームワークなので、Linux向けのホイールを要求すれば導入そのものが失敗する。条件つき依存にしておけば、パッケージのメタデータを参照する用途やミラー作業は他のプラットフォームでも通る。とはいえ利用者から見ると「入ったのに動かない」状態なので、分類子の Operating System :: MacOS を先に見ておくのが早い。
姉妹プロジェクトのCore ML版と比べると、この点は対照的だ。あちらは coremltools が通常の依存なのでLinuxでも import が通り、Core MLを必要としないテストは動く。Laya-MLXはMLXに寄り切っている分、Apple機以外では検証の足場がほとんど無い。評価するならMacを用意する前提になる。
バージョンの整合は取れていた。PyPIの配布は0.2.0で、リポジトリの pyproject.toml も0.2.0。Core ML版がPyPI 0.1.0に対してリポジトリ0.1.1と先行していたのとは違い、こちらは一致している。
実務で効く機能——ルーティング・絞り込み・再現性
READMEには、単に速いだけではない運用向けの仕掛けがいくつか書かれている。いずれも未検証だが、設計の意図は読み取れる。
文脈512"] B -->|非英語のラテン文字を含む| D["Multilingual 322M
文脈1,024"] B -->|判定できない| D C --> E["選択肢が多い?"] D --> E E -->|はい| F["predict_shortlist で
上位k件に絞る"] E -->|いいえ| G["predict をそのまま実行"]
言語ルーティングは Router が担当する。3つのチェックポイントを常駐させる preload=True、明示的な lang= や model= の指定、再入可能ロックによるモデル生存管理(並行スレッドが同じAgentを共有し、重複読み込みを避ける)まで用意されている。判定の中身が印象的で、ルーマニア語・ポーランド語・チェコ語・トルコ語のような特定できないラテン文字の言語は、非英語の文字が含まれるという事実だけで多言語チェックポイントへ回す。黙って英語と決めつけない、という方針だ。detect_language() は language_undecided と diacritic_rate という根拠も返す。
選択肢が多い質問への対処もある。選択肢は1つのトークン予算を共有するため、ラベルが数百あると1件あたりの割り当てが数トークンに落ちる。predict_shortlist は状態と各ラベルを埋め込み、コサイン類似度で上位k件に絞ってから1回の predict を回す。既定では有効にならず、Agent.predict は与えられた基準をすべて採点する。READMEは「専用のバイエンコーダを embed_fn として渡したほうが、判定用チェックポイント自身のエンコーダより良い絞り込みになることが多い」とし、絞った場合の確率は残したラベルの上でのものだ、とも断っている。
再現性まわりも具体的だ。読み込み時に全パラメータの名前と形状を検証し、未対応のエンコーダや既定でないRoPEスケーリングは明示的に失敗する。ModernBERTのグローバルとローカルの注意パターン、スライディングウィンドウ境界の包含、ローカルとグローバルで異なるRoPEの基底、第1層の正規化挙動は保たれる、と書かれている。Hubのリビジョンを固定して読み込む例もそのまま載っている。
入力の受け取り方にも幅がある。system_one は predict の別名で、状態はテキストのほかJSONの辞書や会話のリストでも渡せる。choice は辞書でも一意なラベルのリストでも受け取り、score は0始まりのルーブリック段階の期待値、noul は真である確率を返す。結果には上流と同じ4桁丸め、action.act_probability、トークン使用量の項目が保たれる。既定の精度はFP16で、数値をより厳密に合わせたいときは dtype="float32" を指定する。ラベルの選択が一致していても確率が精度によって多少ずれる点は明記されており、BF16は要求できるが公開された検証マトリクスには含まれない。
繰り返しの負荷に向けた調整も用意されている。batch_size は1回の順伝播で扱う質問数の上限で既定16、超える分は分割して処理される。読み込み時に compile=True・pad_to_multiple=16・cache_prompts=True を選ぶと、コンパイルと前置きの再利用を使う経路に入る。プレフィックスキャッシュは128質問に上限が設けられ、CPU側の状態トークン化を共有する一方で質問ごとのエンコーダ計算は依然それぞれ走る。コンパイルには初回コストと形状特化があり、パディングは負荷によっては遅くなりうる、と断ったうえで3つとも既定は無効だ。速くなる可能性のある設定を既定で有効にしない判断は、この種の移植では好ましい。
コマンドラインからも使える。laya-mlx predict に状態ファイルと質問ファイルを渡す形と、laya-mlx convert で自前のMLXチェックポイントを書き出す形の2つが用意されており、書き出しには model.safetensors・エンコーダとエージェントの設定・トークナイザ一式・mlx_config.json が含まれる。
較正温度については、Core ML版と同じ変更が入っている。上流v0.3.5に合わせて0.5から5.0に制限され、出荷値の choice:11+ は0.1006でそのまま使うとロジットを約10倍鋭くし、五分五分の判断をほぼ確実と報告してしまう。生値は agent.temperature_raw から読め、読み込み時に該当バケットが RuntimeWarning で名指しされる。確率をしきい値で使う設計なら、この挙動は最初に確認しておきたい。
検証の出し方——「10倍は出ない」と書く移植
このリポジトリで一番参考になるのは、速さそのものより検証の設計かもしれない。
テストは上流をコミット 573e5b6 で固定して回す。単体テストは小さなランダムモデルを使い、Transformersおよび固定した上流の判定ヘッドとの直接比較を含む。実チェックポイントの検証では、トークン化・ロジット・較正済み確率・反復出力・実効メモリの増加を見る。ベンチマークはバックエンドとチェックポイントの組み合わせごとに新しいプロセスで走らせ、すべての計測サンプルを benchmarks/results に残す。
CIの範囲も正直に書かれている。GitHub Actionsで走るのはmacOS arm64ランナー上の小モデルCPUテストだけで、実チェックポイントのGPUベンチマークはローカル測定であってホスト型CIには含まれない。数字の出どころが誰の手元なのかを明示している。
性能研究は3本の文書に分かれている。実装上のボトルネックとMLXのカーネルディスパッチを扱う初期調査、演算量の予算・条件つき帯域の上界・実際の重みスペクトル・厳密な再利用・より小さいモデル設計を検討した数学的調査、そしてコンパイル・量子化・最終ヘッドの選択・自作Metalカーネル・代表的な行列積を実測した工学的調査だ。
結論は控えめだ。「現在の調査は、同じチェックポイントでのさらなる一律10倍の高速化を支持しない。選ばれた事例で対のある中央値としておよそ1.03〜1.08倍」。不確かさの区間や量子化の忠実度、自作カーネルの測定値は工学報告に置かれている。10倍という目標を掲げて到達しなかったことを、否定の形で3本の文書として残している。
変換まわりの説明も誤解を防ぐ書き方になっている。laya-mlx convert が行うのはパラメータ名とdtypeの変換であって、量子化でも再学習でもない。元のチェックポイントはすでにFP16で重みを持っているため、FP32を選んでも増えるのは演算の精度であって元の重みの精度ではない。出力先のディレクトリは決して上書きしない、という安全側の既定も明記されている。公開用の準備スクリプトは、書き出したすべてのテンソルを元のFP16と突き合わせて確認する。
帰属も明確だ。Layaと学習済み重みはConvai Innovationsと上流の貢献者によるもので、プロンプト構築・出力整形・言語ルーティング・メール向けユーティリティ・プリセットは上流の特定コミットから取り込み、ニューラルアーキテクチャはLayaとHugging FaceのModernBERTに従ってMLXで再実装した、と書かれている。どこまでが移植でどこからが原典かが1段落で分かる。
判定モデルを自前で持つという選択肢の広がりとしては、同じwire APIをGPUサーバとして提供するOpenJevとは|Jev互換のSystem One決定サーバを自前GPUで動かすOSSをソースで実測も近い位置にある。判定を呼ぶ側のツールがどの層に何本あるかはJev対応OSS 11選|ブラウザ操作・MCP・コードレビュー・Claude Code文脈選別まで実測で見る使いどころに一覧がある。
まとめ——Laya-MLXは誰に向くか
Laya-MLXは、判定モデルをクラウドから引き剥がしてApple Siliconに載せる移植だ。速度の主張は条件つきで書かれ、移植の一致は378件の比較で示され、キャッシュが効かない条件やSnakeの数字が別物であることまで自分から書いている。数字の出し方という点では、この種のリポジトリの中でも上のほうだ。
待ったほうがよい:Apple以外が主戦場の場合(importすら通らない)。学習や微調整まで手元でやりたい場合(上流の担当)。確率の目盛りをそのまま信頼したい運用
今回確かめられたのは、Apple機なしで届く範囲、つまり依存の宣言と失敗の出方までだ。推論そのものには触れていない。評価するなら、Macを用意したうえで pip install laya-mlx から始め、まず多言語チェックポイントで自分の質問セットの確率分布を見て、次に batch_size と compile の効き方を自分の負荷で測るのが順序として素直だろう。同じ作者のCore ML版は短い判定を省電力で回す方向に振られているので、用途が「短い判定を大量に、電池を気にしながら」ならそちらも併せて検討する価値がある。
参照ソース
・mizorewww/laya-mlx(公式リポジトリ) — README・LICENSE・pyproject.toml・tests(2026-09-22時点で確認)
・BENCHMARKS.md — 測定方法と数値パリティの検証
・laya-mlx(PyPI) — 配布版0.2.0と依存関係の確認